文章目录
- [一、Series 简介](#一、Series 简介)
- [二、Series 基本语法](#二、Series 基本语法)
-
- [2.1 Series 创建](#2.1 Series 创建)
- [2.2 Series 的属性](#2.2 Series 的属性)
- [2.3 访问数据](#2.3 访问数据)
- [2.4 缺失值统一处理](#2.4 缺失值统一处理)
- [三、Series 常用函数](#三、Series 常用函数)
- [四、Series 案例](#四、Series 案例)
一、Series 简介
Series 是 Pandas 中的 一维带标签数组 ,是 Pandas 两大核心数据结构之一(另一个是二维的 DataFrame)。Series 可理解为 一列数据,由两部分组成:
- values(值):存储实际数据,可以是数字、字符串、布尔值等,底层基于 NumPy 数组
- index(索引):数据对应的标签,用来定位元素。索引默认是从 0 开始的整数序列,也可以手动自定义标签
区别:普通 NumPy 一维数组只有位置编号;Series 自带索引标签,既可以用位置取数,也可以用标签取数,这是 Series 最核心的特点。
Series 结构如下:
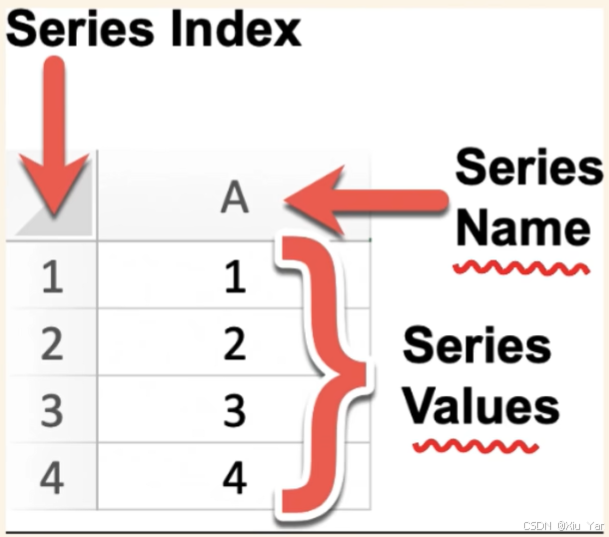
核心特点如下:
- 一维结构:只能存一列,不能多列;多列数据用 DataFrame
- 同类型数据:同一 Series 里元素一般是相同数据类型(int/float/string)
- 索引独立:索引可以自定义,不一定是 0,1,2;索引可以不连续
- 支持向量化运算:不用写循环,整列直接加减运算,继承 NumPy 优势
- 自带丰富方法:统计、缺失值处理、切片筛选等
注:DataFrame 的每一列本质上就是一个 Series。
后文演示默认引入 Pandas:import pandas as pd
二、Series 基本语法
2.1 Series 创建
python
# series创建
s = pd.Series([1, 2, 3, 4, 5])
# 自定义索引
s = pd.Series([1, 2, 3, 4, 5], index=['a', 'b', 'c', 'd', 'e'])
# 自定义name
s = pd.Series([1, 2, 3, 4, 5], index=['a', 'b', 'c', 'd', 'e'], name='月份')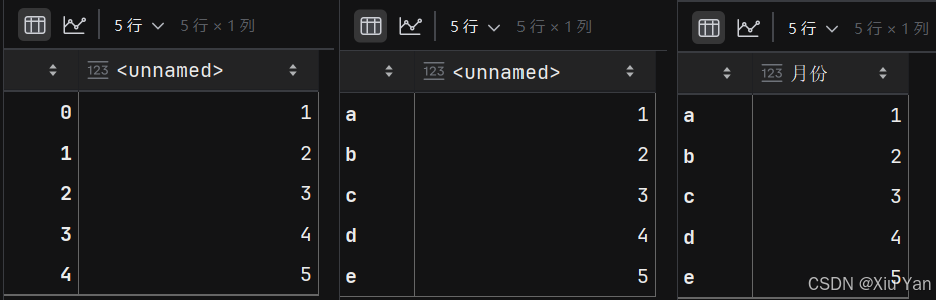
python
# 通过字典的方式创建
s = pd.Series({'a': 1, 'b': 2, 'c': 3, 'd': 4, 'e': 5})
print(s)
s1 = pd.Series(s, index=['a', 'b'])  # s基础上只取ab索引
print(s1)
s1 = pd.Series(s, index=["a", "b", "c"])  # s基础上只取abc索引
print(s1)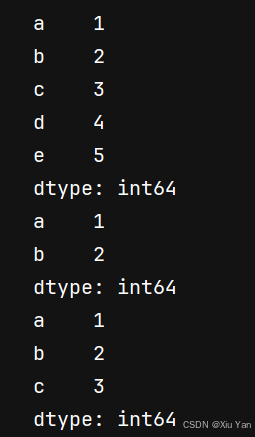
2.2 Series 的属性
| 属性 | 说明 | 属性 | 说明 |
|---|---|---|---|
index |
Series的索引对象 | loc[] |
显式索引,按标签索引或切片 |
values |
Series的值 | iloc[] |
隐式索引,按位置索引或切片 |
dtype、dtypes |
Series的元素类型 | at[] |
使用标签访问单个元素 |
shape |
Series的形状 | iat[] |
使用位置访问单个元素 |
ndim |
Series的维度 | ||
size |
Series的元素个数 | ||
name |
Series的名称 |
示例代码:
python
s = pd.Series([1, 2, 3, 4, 5], index=['a', 'b', 'c', 'd', 'e'], name='月份')  # 定义name
print(s.index)  # Index(['a', 'b', 'c', 'd', 'e'], dtype='str')
print(s.values)  # [1 2 3 4 5]
print(s.shape)  # (5,)
print(s.ndim)  # 1
print(s.size)  # 5
print(s.dtype, s.dtypes)  # int64 int64
print(s.name)  # 月份
print(s.loc['a'])  # 1,显示索引
print(s.iloc[0])  # 1,隐式索引
print(s.at['a'])  # 1,显示,访问单个元素,不支持切片
print(s.iat[0])  # 1,隐式
注: loc[标签切片]:闭区间 [start, end],包含结束标签;iloc[位置切片]:左闭右开 [start, end),不包含结束位置
python
 # 切片
print(s.loc['a':'c'])
# a    1
# b    2
# c    3
# Name: 月份, dtype: int64
print(s.iloc[0:2])
# a    1
# b    2
# Name: 月份, dtype: int64
另外:若传入列表形式 [[x,y,z]],不管 loc 还是 iloc,都是选取指定项,不存在区间问题。
python
print(s.loc[['a', 'b']])
# a    1
# b    2
# Name: 月份, dtype: int64
print(s.iloc[[0, 2]])
# a    1
# c    3
# Name: 月份, dtype: int64
2.3 访问数据
python
s = pd.Series([1, 2, 3, 4, 5, 6], index=['a', 'b', 'c', 'd', 'e', 'f'], name='月份')
print(s['a'])
print(s[s < 3])  # 布尔索引
# a    1
# b    2
# Name: 月份, dtype: int64
print(s.head())  # 默认前5个
print(s.tail())  # 默认后5个
print(s.head(2))  # 前2个
print(s.tail(1))  # 后1个
2.4 缺失值统一处理
python
# 缺失值统一处理
s = pd.Series([10, 2, np.nan, None, 3, 4], index=['a', 'b', 'c', 'd', 'e', 'f'])
print(s)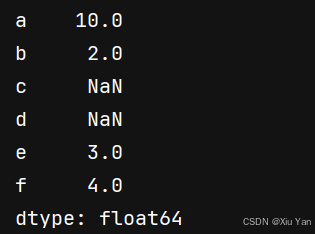
三、Series 常用函数
| 方法 | 说明 | 方法 | 说明 |
|---|---|---|---|
head() |
查看前 n 行数据,默认 5 行 | max() |
最大值 |
tail() |
查看后 n 行数据,默认 5 行 | var() |
方差 |
isin() |
判断元素是否包含在参数集合中 | std() |
标准差 |
isna() |
判断是否为缺失值(如 NaN 或 None) | median() |
中位数 |
sum() |
求和,自动忽略缺失值 | mode() |
众数(可返回多个) |
mean() |
平均值 | quantile(q) |
分位数,q 取 0~1 之间 |
min() |
最小值 | describe() |
常见统计信息(count、mean、std、min、25%、50%、75%、max) |
注:mean()、sum()、std()、var()、min()、max()、median() 默认都会自动忽略 NaN(缺失值),不会把 nan 或 None 参与计算。
示例代码1:
python
s = pd.Series([1, 2, 3, 4, 5, 6], index=['a', 'b', 'c', 'd', 'e', 'f'])
# head()、tail() 默认取5个
print(s.head())
print(s.tail())
print(s.head(2))
print(s.tail(1))
示例代码2:
python
s = pd.Series([1, 2, np.nan, None, 5], index=['a', 'b', 'c', 'd', 'e'])
print(s.isna())  # 检查series中元素是否为缺失值
print(s.isin([5]))  # 检查元素 5 是否在集合里
s.isin([1, 5])   # 检查 1、5 元素是否在集合里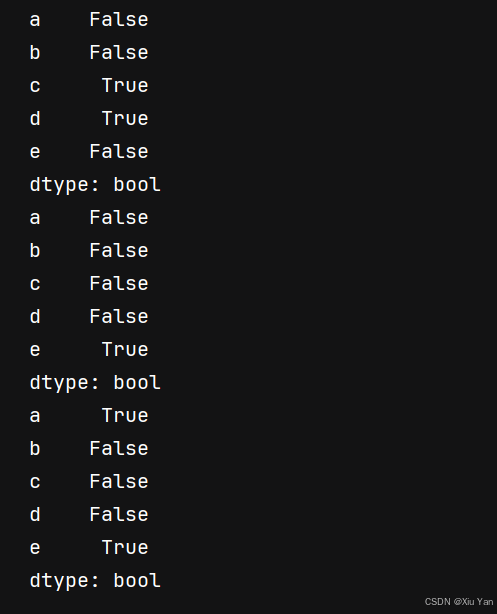
示例代码3:
python
s = pd.Series([1, 2, 3, 4, 5, np.nan], index=['a', 'b', 'c', 'd', 'e', 'f'])
print(s.mean())  # 3.0 平均值
print(s.sum())   # 15.0 总和,不包含nan
print(s.std())   # 1.5811388300841898 标准差
print(s.var())   # 2.5 方差
print(s.min())   # 1.0 最小值
print(s.max())   # 5.0 最大值
print(s.median())  # 3.0 中位数
print(s.mode())  # 众数
print(s.quantile(0.25))  # 2.0分位数

# 查看所有描述性信息
s.describe()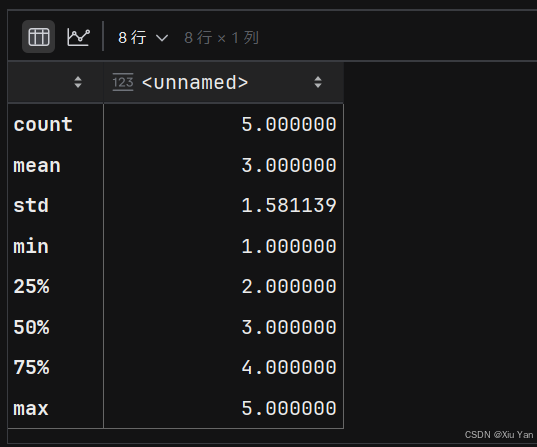
注:计算分位数时,Pandas 内部会先对 Series 的有效值自动排序,再计算对应分位数。并且默认自动忽略 Nan 或 None。
| 方法 | 说明 | 方法 | 说明 |
|---|---|---|---|
value_counts() |
每个唯一值的出现次数 | sort_values() |
按值排序 |
count() |
非缺失值数量 | replace() |
替换值 |
nunique() |
唯一值个数(去重) | keys() |
返回 Series 的索引对象 |
unique() |
获取去重后的值数组 | ||
drop_duplicates() |
去除重复项 | ||
sample() |
随机抽样 | ||
sort_index() |
按索引排序 |
示例代码4:
python
# 众数:出现最多次数的数
s = pd.Series([1, 2, 4, 4, 3], index=['a', 'b', 'c', 'd', 'e'])
print(s.sort_values())  # 排序,缺失值放在后面
print(s.sort_index(ascending=False)) # 按照索引排序注:ascending 代表升序的意思
示例代码5:
python
s = pd.Series([1, 2, 2, 4, 5, np.nan], index=['d','b','a','c','f','e'], name='data')

print(s.value_counts())  # 统计每个值出现次数
print(s.count())         # 5 非缺失值数量
print(s.replace(2, 99))  # 替换值
print(s.nunique())       # 4 唯一值个数(去重)
# 获取索引
print(s.keys())          # 方法
print(s.index)   	     # 属性 结果同上
# Index(['d', 'b', 'a', 'c', 'f', 'e'], dtype='str')

print(s.unique())        # 获取去重后的值数组
# [ 1.  2.  4.  5. nan]

print(s.drop_duplicates())  # 删除重复项
print(s.sample(2))          # 随机抽样
四、Series 案例
题目1:学生成绩统计
python
"""
题目1:学生成绩统计
创建一个包含10名学生数学成绩的Series,成绩范围在50-100之间。
计算平均分、最高分、最低分,并找出高于平均分的学生人数。
"""
import pandas as pd
import numpy as np

np.random.seed(42)  # 设置随机种子
values = np.random.randint(50, 101, 10)
index = []
for i in range(1, 11):
    index.append('学生' + str(i))
scores = pd.Series(values, index)
print(scores)

print('平均分:', scores.mean())
print('最高分:', scores.max())
print('最低分:', scores.min())
mean_score = scores.mean()
print('高于平均分的学生人数:', len(scores[scores >= mean_score]))  # 布尔索引
题目2:温度数据分析
python
'''
题目2:温度数据分析
给定某城市一周每天的最高温度Series,完成以下任务:
- 找出温度超过30度的天数
- 计算平均温度
- 将温度从高到低排序
- 找出温度变化最大的两天
'''
import pandas as pd
import numpy as np

temperatures = pd.Series([28, 31, 29, 32, 30, 27, 33], index=['周一', '周二', '周三', '周四', '周五', '周六', '周日'])

print('温度超过30度的天数:', len(temperatures[temperatures > 30]))
print('温度超过30度的天数:', temperatures[temperatures > 30].count())
print('温度超过30度的天数:', temperatures[temperatures > 30].size)

print('平均温度:', temperatures.mean())
print('将温度从高到低排序:')
print(temperatures.sort_values(ascending=False))  # ascending:升序
print('-------------------')

temp_diff = temperatures.diff()  # 计算series数组的变化的值
# print(temp_diff)
# 周一    NaN
# 周二    3.0
# 周三   -2.0
# 周四    3.0
# 周五   -2.0
# 周六   -3.0
# 周日    6.0
temp_diff_sort = temp_diff.abs().sort_values(ascending=True)  # 温度变化值排序
print('温度变化最大的两天:', temp_diff_sort.index[0], temp_diff_sort.index[1])
print('温度变化最大的两天:', temp_diff_sort.keys()[0:2].tolist())
# 温度变化最大的两天: ['周三', '周五']注:diff() 用于计算和上一个数据的变化差值
题目3:股票价格分析
python
'''
题目3:股票价格分析
给定某股票连续10个交易日的收盘价Series:
- 计算每日收益率(当日收盘价/前日收盘价-1)
- 找出收益率最高和最低的日期
- 计算波动率(收益率的标准差)
'''
import pandas as pd
import numpy as np

values = np.array([102.3, 103.5, 105.1, 104.8, 106.2, 107.0, 106.5, 108.1, 109.3, 110.2])
index = pd.date_range('2023-01-01', periods=10)
prices = pd.Series(values, index)
print(prices)
# 2023-01-01    102.3
# 2023-01-02    103.5
# 2023-01-03    105.1
# ...
print('-----------------------')
yields = prices.pct_change()  # 103.5/102.3-1
print('每日收益率:')
print(yields)
print('-----------------------')
print('收益率最高日期:', yields.idxmax())  # max()最大值,idxmax() 最大值的索引
print('收益率最低日期:', yields.idxmin())
print('波动率', yields.std())
注:
pct_change()可计算收益率(计算公式:当日收盘价/前日收盘价-1);idxmax()用于最大值的索引,idxmin()同理periods表示生成多少个时间点。如:periods=10表示创建 10 条日期。- 没有写
freq时,默认freq='D',也就是按天生成。
题目4:销售数据分析
python
'''
题目4:销售数据分析
某产品过去12个月的销售量
- 计算季度平均销量(每3个月为一个季度)
- 找出销量最高的月份
- 计算月环比增长率
- 找出连续增长超过2个月的月份
'''
import pandas as pd
import numpy as np

values = np.array([120, 135, 145, 160, 155, 170, 180, 175, 190, 200, 210, 220])
index = pd.date_range('2022-01-01', periods=12, freq='MS')
# freq='MS' 频率按照月生成,MS代表每个月开始,D代表天为频率
sales = pd.Series(values, index)
print(sales)
print('-----------------------')
print('季度平均销量:')
print(sales.resample('QS').mean())  # 按照季度重新采样,(120+135+145)/3
print('-----------------------')
print('销量最高的月份:', sales.idxmax())
print('计算月环比增长率:')
print(sales.pct_change())
print('-----------------------')

# sales.pct_change() > 0 # 检查连续3个是true的窗口
sales_rolling = (sales.pct_change() > 0).rolling(window=3)  # 大小为3的窗口
sales_rolling_sum = sales_rolling.sum()  # 窗口加和, True 等价于 1,False 等价于 0
print(sales_rolling_sum)
# 2022-01-01    NaN
# 2022-02-01    NaN
# 2022-03-01    2.0
# 2022-04-01    3.0
# 2022-05-01    2.0
# 2022-06-01    2.0
#...
print(sales_rolling_sum[sales_rolling_sum >= 3].keys().tolist())
# [Timestamp('2022-04-01 00:00:00'), Timestamp('2022-11-01 00:00:00'), Timestamp('2022-12-01 00:00:00')]-
freq取值频率:D:按天MS:MonthStart,每月月初ME:MonthEnd,每月月末YS:YearStart,每年年初YE:YearEnd,每年年末 -
resample():时间序列重采样 ,可对当前序列,重新按照制定规则取样。如:QS表示把高频时间数据(这里是月度)聚合为低频数据季度 。D:按天W:按周(默认周日结束)MS:每月月初ME:每月月末QS:季度初QE:季度末YS:每年年初YE:每年年末H:小时T:分钟 -
rolling(window=N):滚动窗口 。在序列上开一个固定大小的窗口,窗口沿着数据从上到下滑动,每次滑动一格。可对窗口内的数据执行聚合计算(sum /mean/max 等)。如:
window=3:窗口大小为 3,每次取当前位置 + 前面 2 个 ,一共 3 条数据。若不足窗口长度的位置,默认返回NaN
题目5:每小时销售数据分析
python
'''
题目5:每小时销售数据分析
某商店每小时销售额
- 按天重采样计算每日总销售额
- 计算每天营业时间(8:00-22:00)和非营业时间的销售额比例
- 找出销售额最高的3个小时
'''
import pandas as pd
import numpy as np

np.random.seed(42)  # 设置随机种子
values = np.random.randint(0, 100, 24)
index = pd.date_range('2025-01-01', periods=24, freq='h')
hours_sales = pd.Series(values, index)
# 2025-01-01 00:00:00    51
# 2025-01-01 01:00:00    92
# 2025-01-01 02:00:00    14
# 2025-01-01 03:00:00    71
# ...

# 按天重采样计算每日总销售额
day_sales = hours_sales.resample('D')
print(day_sales.sum())  # 或者 hours_sales.sum()

# 计算每天营业时间(8:00-22:00)和非营业时间的销售额比例

# 法1:使用between_time函数筛选一段时间的series
business_hours_sales = hours_sales.between_time('8:00', '22:00')
print(business_hours_sales.sum() / (day_sales.sum() - business_hours_sales.sum()))

# 法2:利用布尔索引
business_hours_sales = hours_sales[(hours_sales.index.hour >= 8) & (hours_sales.index.hour <= 22)]
print(business_hours_sales.sum() / (day_sales.sum() - business_hours_sales.sum()))

# 法3:也可利用drop去除营业时间段的销售
not_business_hours_sales = hours_sales.drop(business_hours_sales.index)
print(business_hours_sales.sum() / not_business_hours_sales.sum())

# 找出销售额最高的3个小时
print(hours_sales.nlargest(3).keys())
between_time(start_time, end_time):时间索引专用,筛选同一天内 指定时段,包含起止时刻。nlargest(n):取出数值最大 n 条,返回 Series,可使用.index/.keys()拿到对应索引。drop(索引):删掉指定索引对应的行,返回删掉之后新的 Series。
注:between_time('8:00','22:00'):只看时间(小时分钟),忽略日期,即:不管是哪一天,只要时间落在 8:00~22:00 就筛选出来。