你修过一个 AI Badcase:模型答错了,改了 Prompt,又补了检索,顺手清了 Memory,结果答案终于对了。问题也随之出现:到底是哪一层出了错?
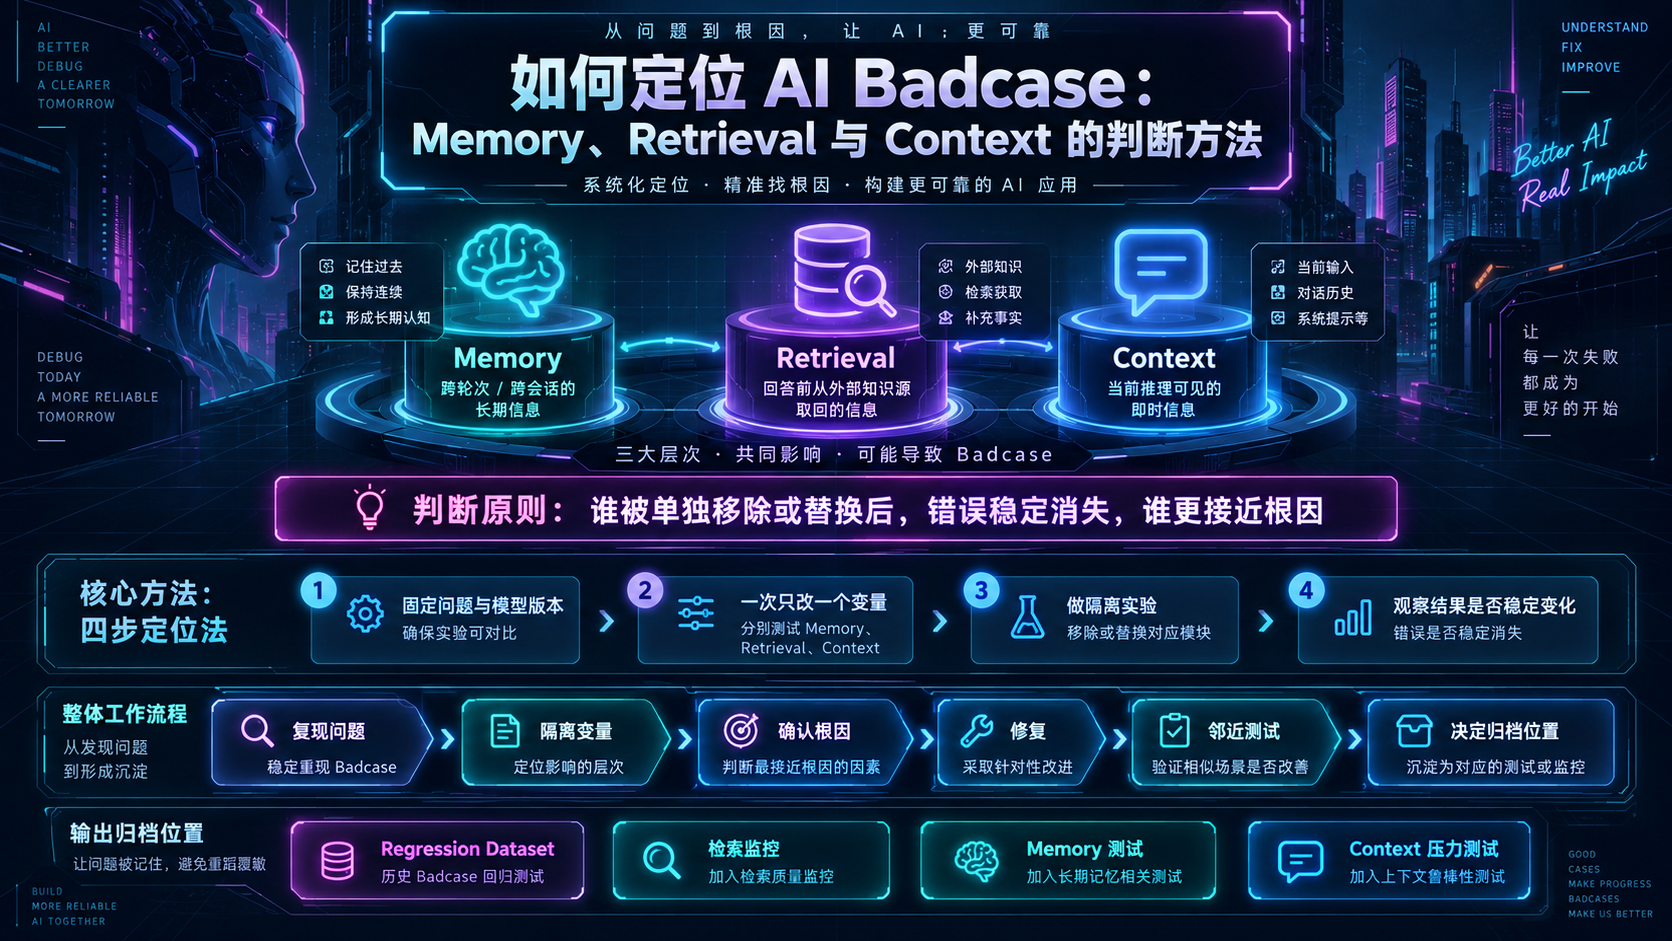
这件事比"把答案修对"更重要。因为如果根因判断错了,修复可能只是碰巧有效:今天这个样例通过,明天换个问法又失败。可靠的做法,是把 Memory、Retrieval、Context 当成三个可分别控制的变量,通过替换、删除和复现实验,找到哪一层改变时,结果才真正发生变化。
先别急着看答案,先看信息从哪里进来
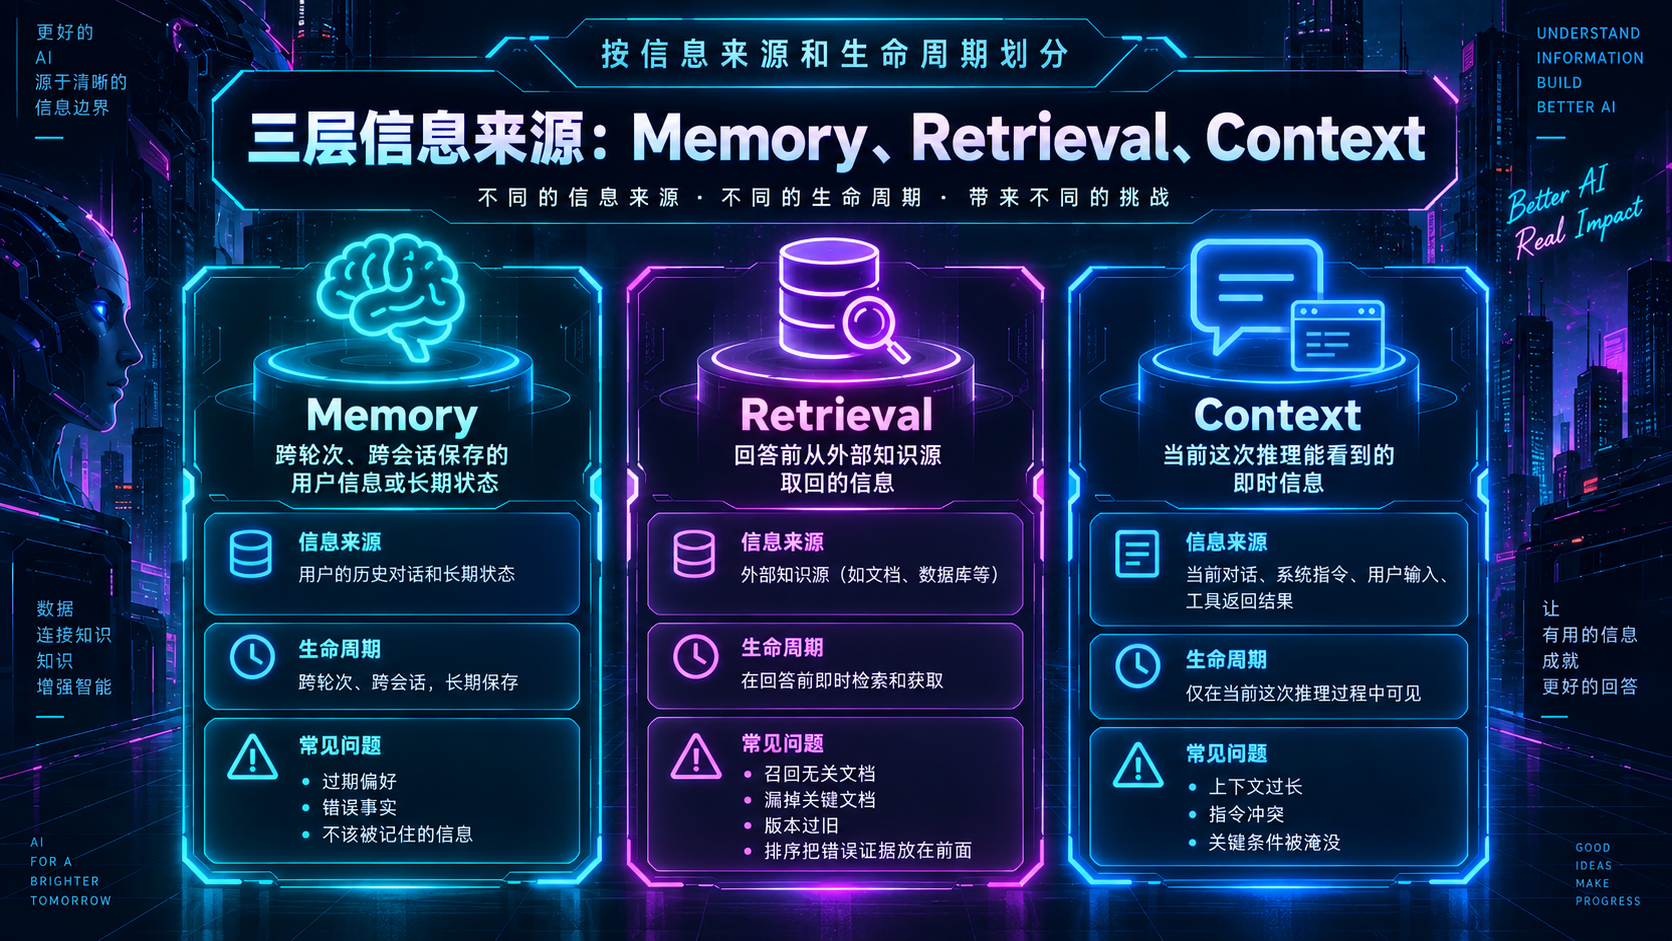
不同系统的实现并不完全一样,但排查时可以先按"信息来源和生命周期"划分。
Memory 指跨轮次、跨会话保存的用户信息或长期状态。比如系统记住"用户喜欢简洁回答",几天后仍然生效。如果错误来自过期偏好、错误事实或不该被记住的信息,关掉或替换这条 Memory 后,问题通常会消失。
Retrieval 指系统在回答前,从外部知识源取回的信息,例如文档库、搜索索引、数据库。它的典型问题不是"模型不会",而是"拿错了材料":召回无关文档、漏掉关键文档、版本过旧,或者排序把错误证据放在前面。
Context 是当前这次推理能看到的即时信息,包括当前对话、系统指令、用户输入、工具返回结果等。它往往只在当前会话有效。上下文过长、指令冲突、关键条件被淹没,都可能让模型在"材料都在眼前"的情况下仍然答错。
最有效的判断方法,是做三次"隔离实验"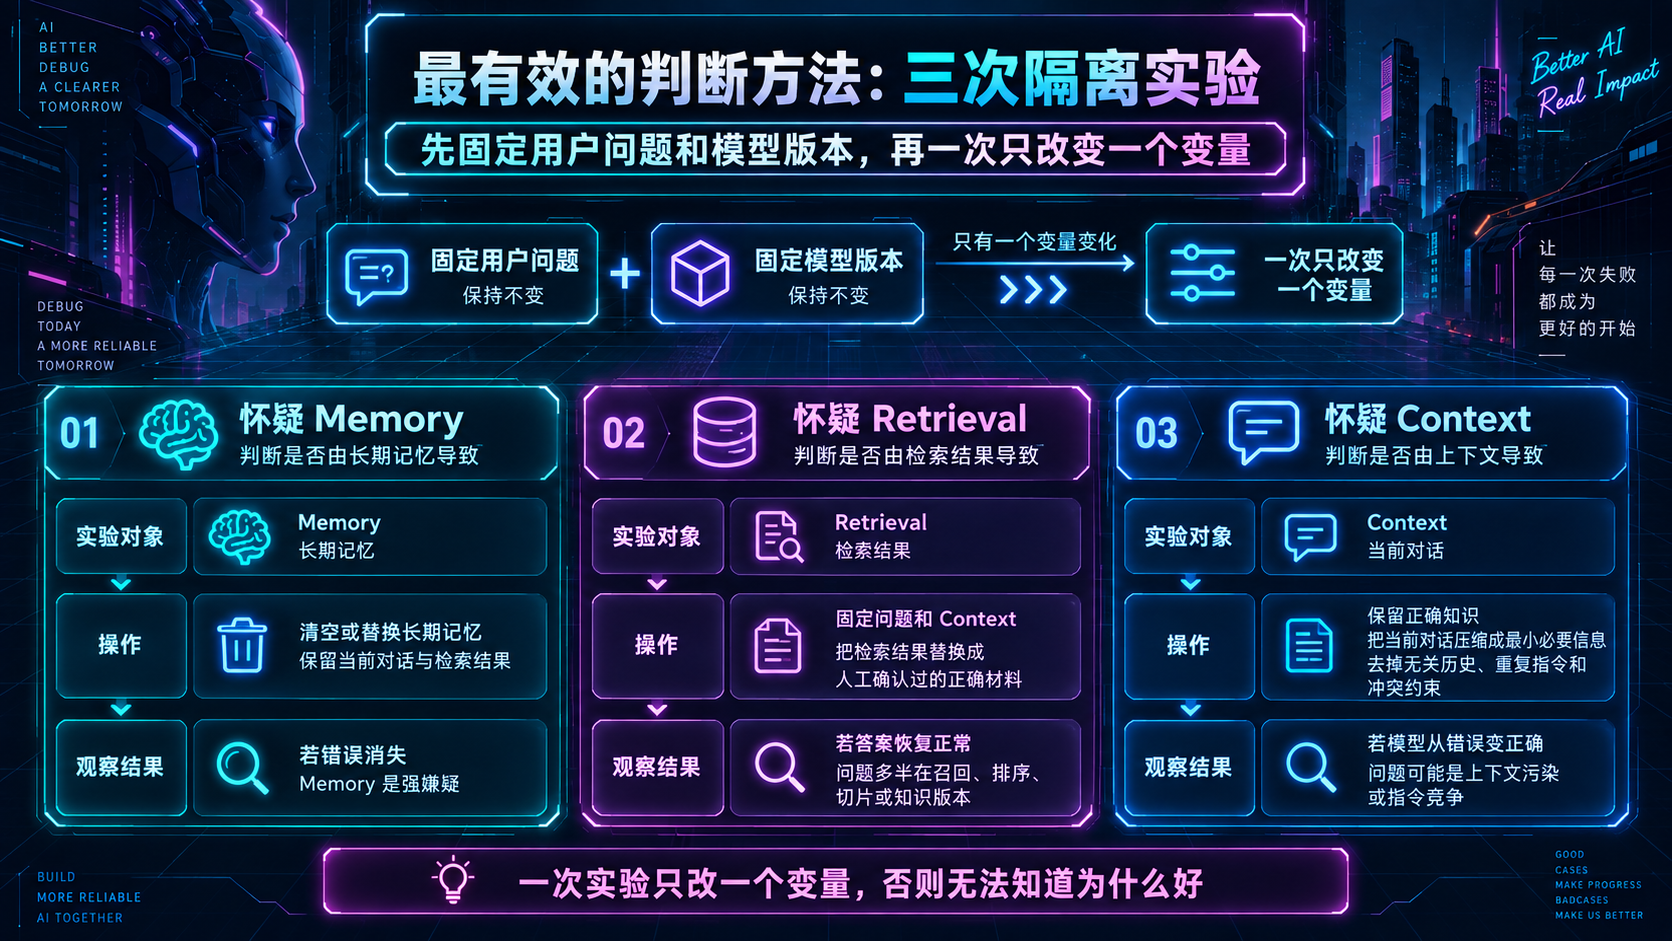
遇到 Badcase,不要先改 Prompt。先固定用户问题和模型版本,再一次只改变一个变量。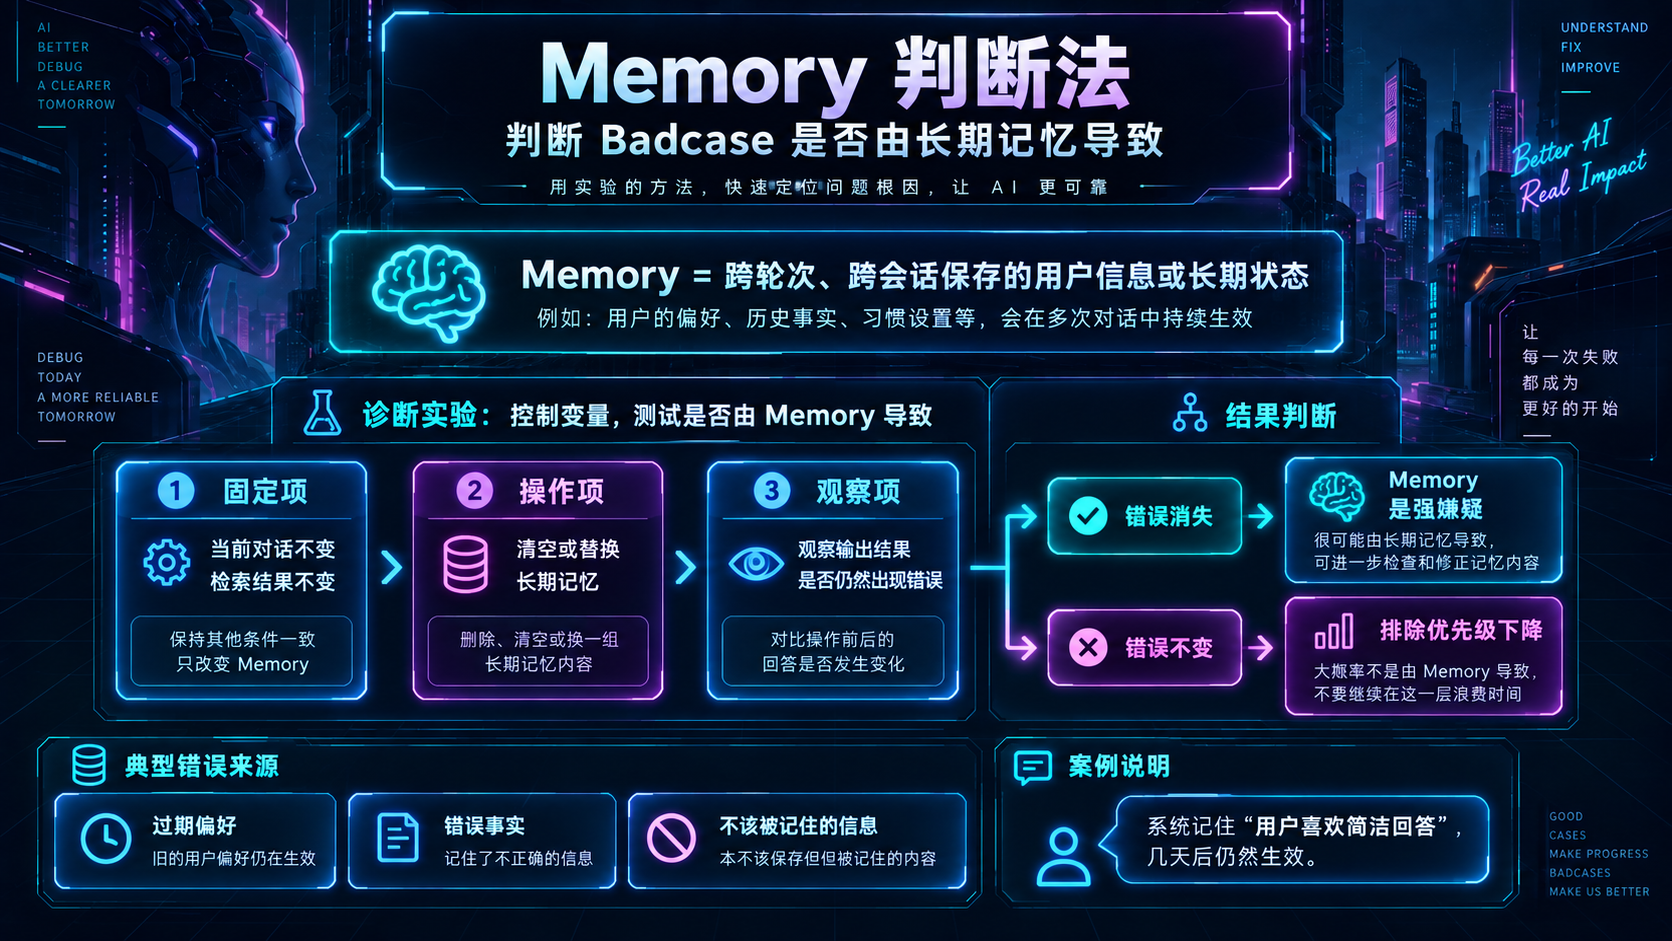
怀疑 Memory,就清空或替换长期记忆,保留当前对话与检索结果。如果错误随之消失,Memory 是强嫌疑;如果不变,就不要继续在这一层浪费时间。
怀疑 Retrieval,就固定问题和 Context,把检索结果替换成一组人工确认过的正确材料。如果答案恢复正常,问题多半在召回、排序、切片或知识版本。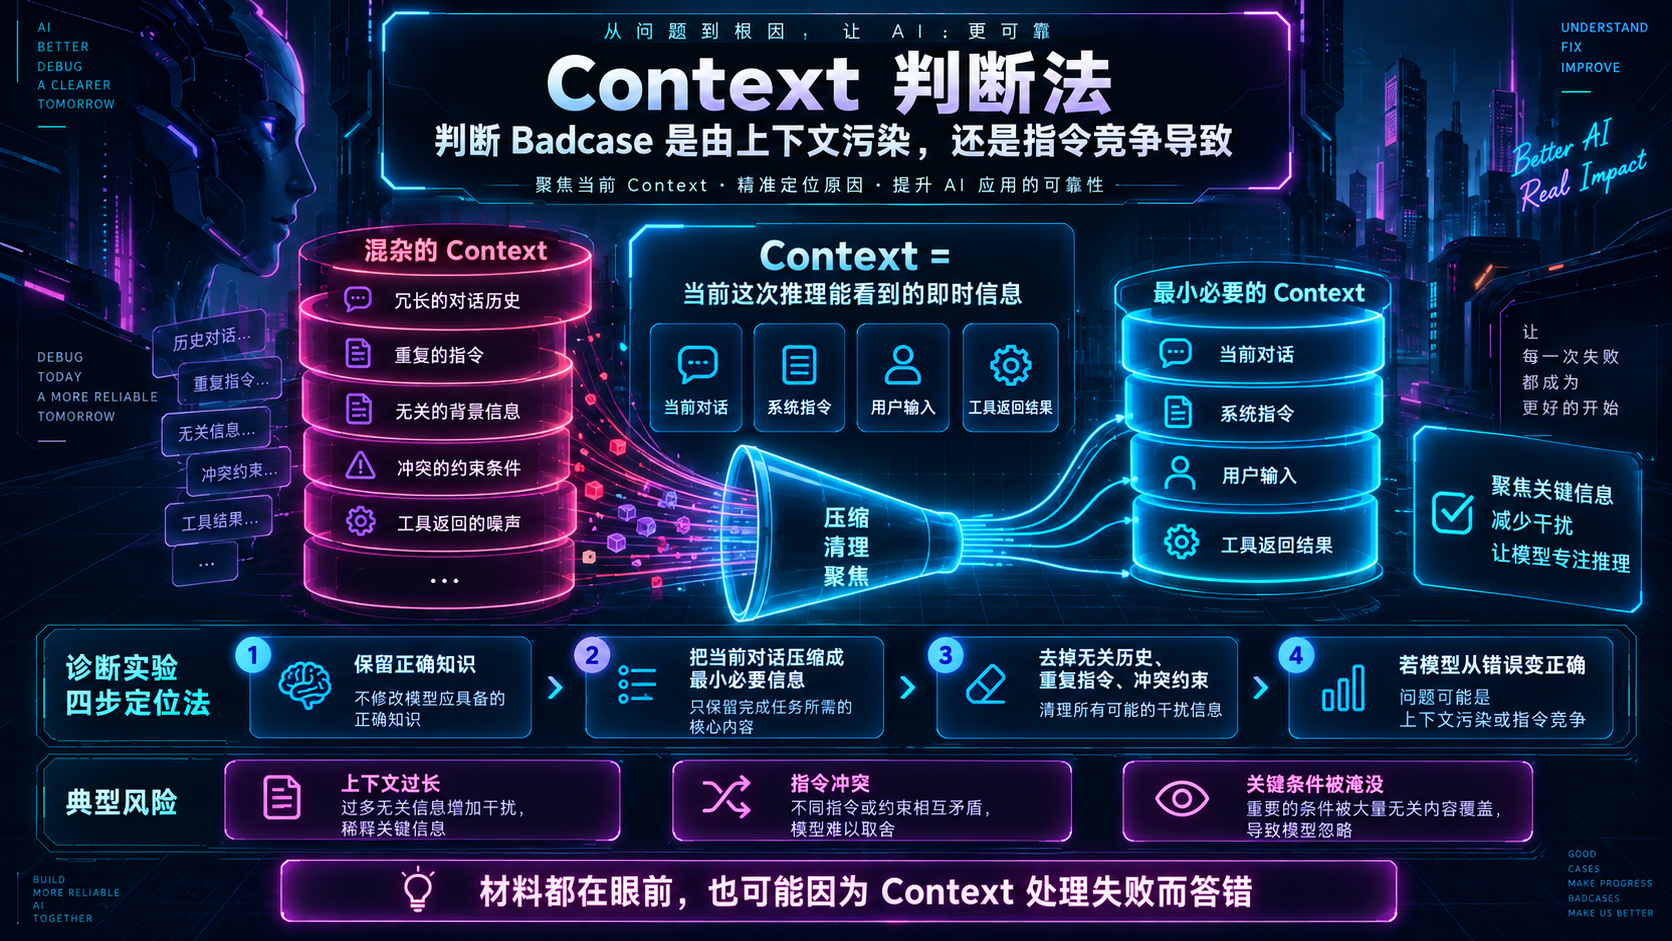
怀疑 Context,则保留正确知识,把当前对话压缩成最小必要信息,去掉无关历史、重复指令和冲突约束。如果模型从错误变正确,问题可能是上下文污染或指令竞争。
关键是一次实验只改一个变量。否则你同时清 Memory、换文档、改 Prompt,最后虽然"好了",却无法知道为什么好。
不要把"答案错了"直接等同于某一层错了
一个常见误区,是看到模型引用了错误内容,就立刻归因于 Retrieval。其实也可能是正确文档已经召回,只是 Context 太长,模型没有抓到关键句;也可能 Memory 中存在旧信息,覆盖了本轮证据。
反过来也一样。模型没有使用某条事实,不代表 Memory 没生效。它可能已经影响了偏好判断或检索查询,只是没有直接出现在最终文本里。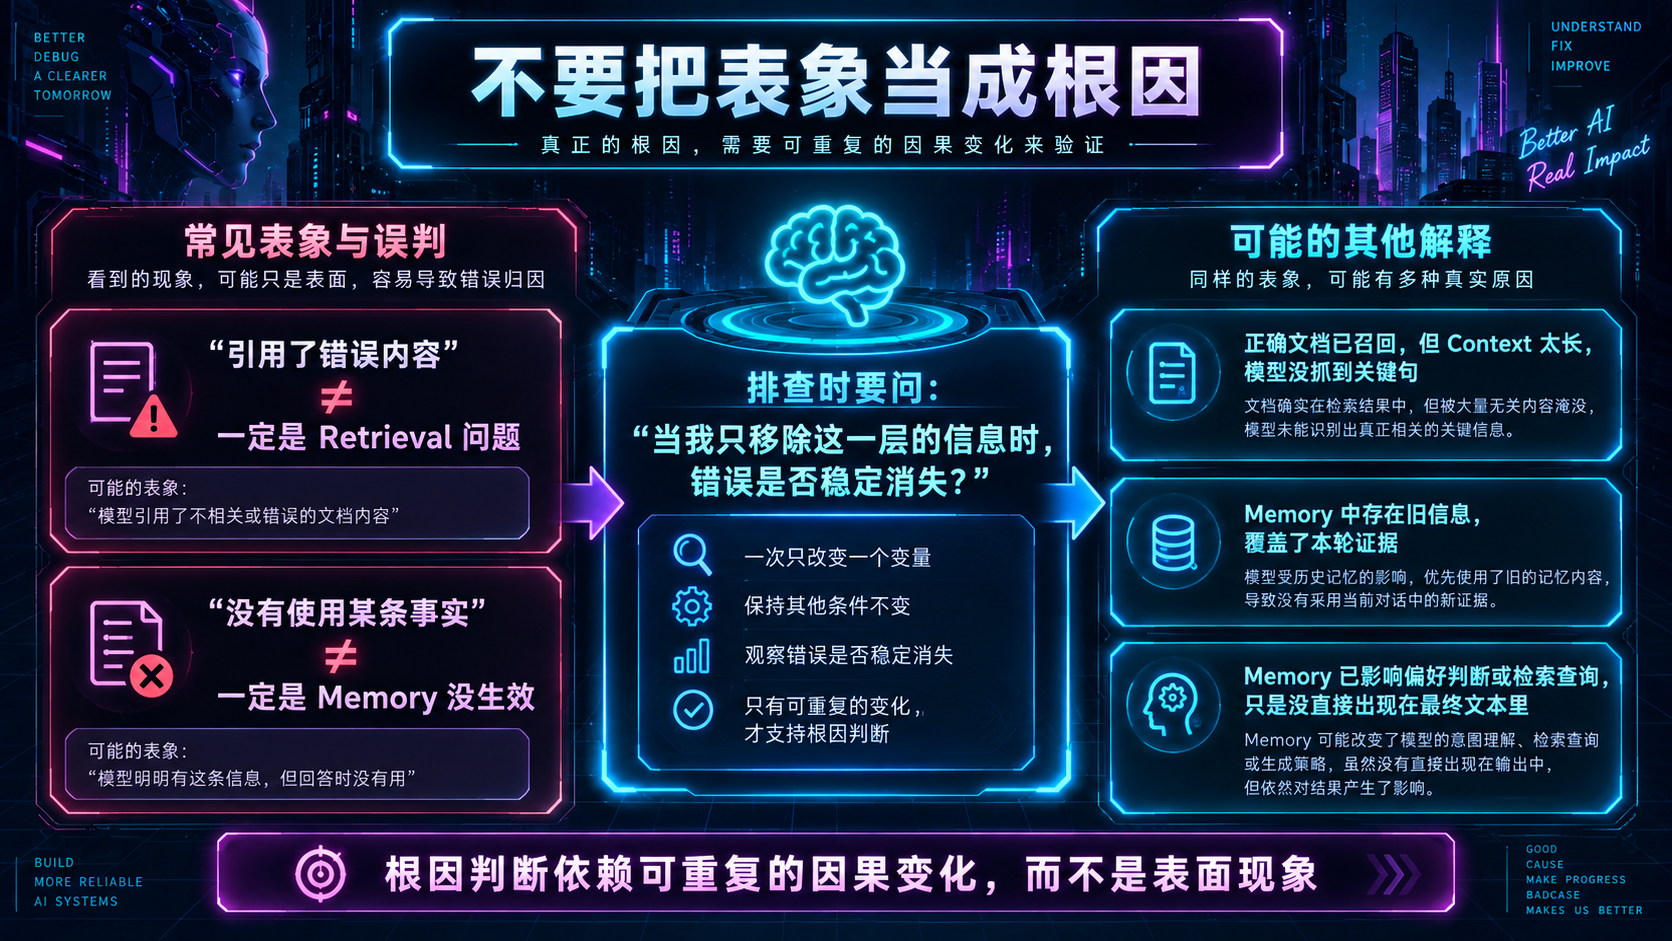
所以排查时要问的不是"它看起来像哪一类问题",而是:"当我只移除这一层的信息时,错误是否稳定消失?"根因判断依赖可重复的因果变化,而不是表面现象。
Badcase 修好后,真正重要的工作才开始
一个 Badcase 被修好,只代表当前样例通过。下一步要验证这次修复有没有副作用。
先保留一个最小复现样例:什么输入、什么 Memory、什么检索结果、什么 Context 会触发问题。然后补一组"邻近样例",例如换一种问法、换一个用户、替换相似文档、增加干扰信息。这样才能判断修复是在解决一类问题,还是只记住了一个答案。
再看修复发生在哪一层。若是 Retrieval,就检查召回、排序和知识版本;若是 Context,就测试长对话、冲突指令和信息压缩;若是 Memory,就测试写入、更新、覆盖和删除。修复应该对应根因扩展测试,而不是只增加同一个表述的样例。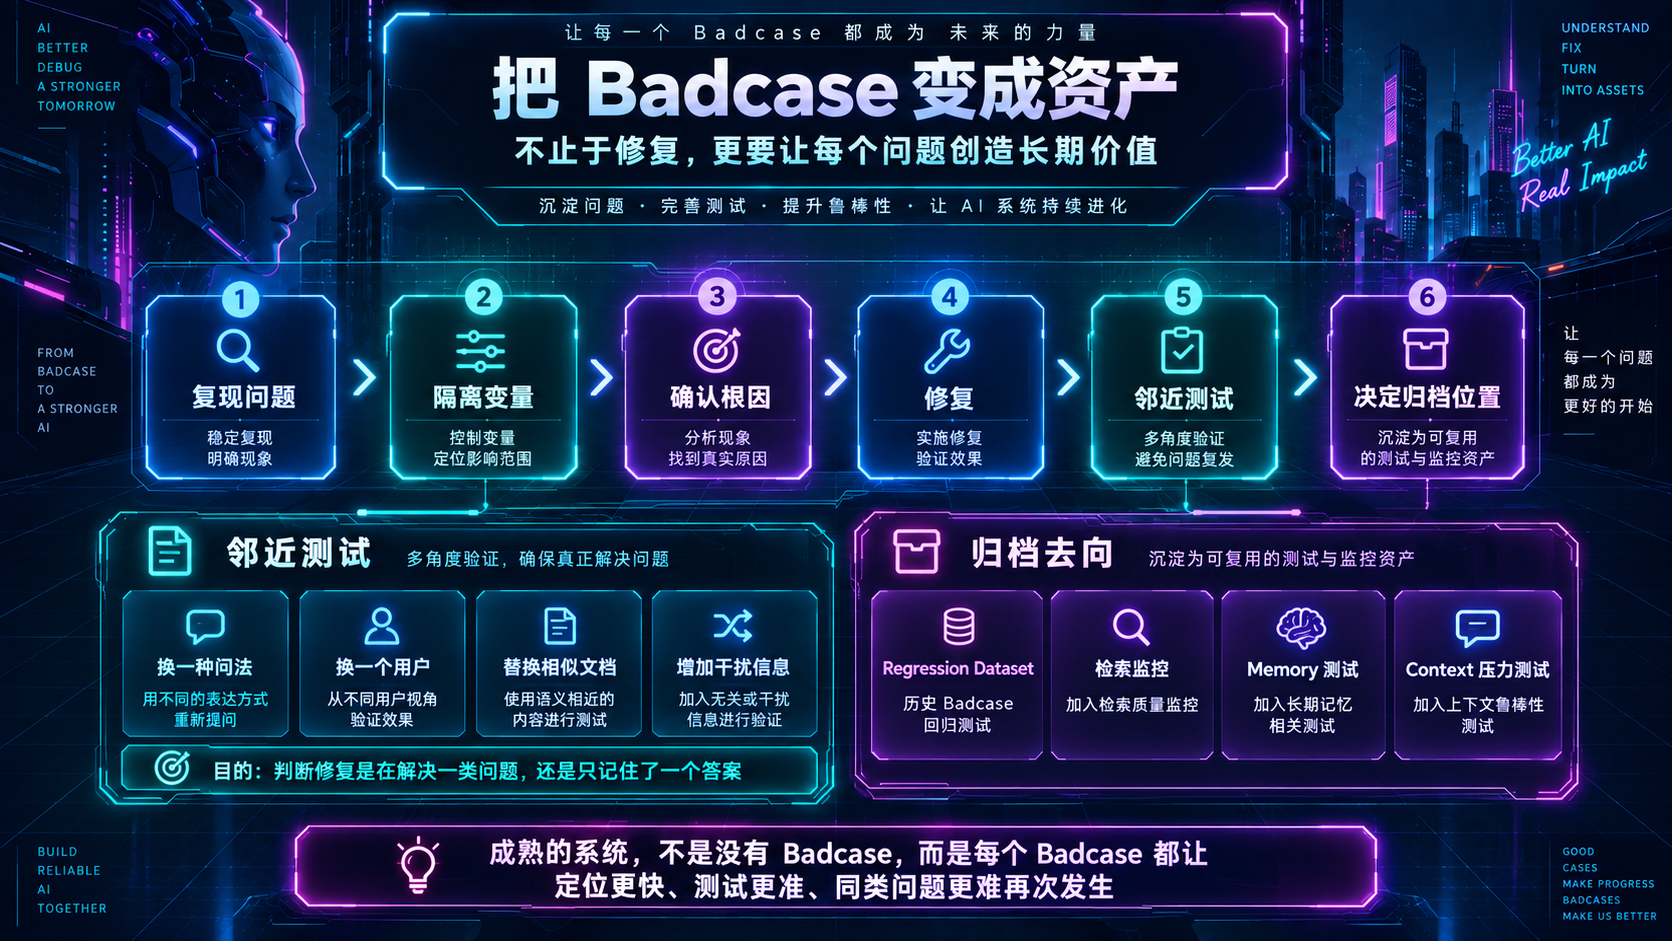
Regression Dataset 不该成为"Badcase 垃圾桶"
修好的案例有价值,但不代表每一个都应该直接加入 Regression Dataset。
适合进入回归集的案例,通常满足三个条件:问题曾真实发生,根因已经明确,而且未来仍可能再次出现。它最好还能代表某一类风险,而不是依赖一次性的时间、临时数据或偶然措辞。
例如"旧 Memory 覆盖用户本轮明确指令"很适合作为长期回归场景;但"某篇昨天更新的网页抓取失败"可能更适合进入检索监控或数据质量检查,而不是固定成生成模型回归题。
还要避免一个陷阱:把修复时见过的标准答案硬编码进系统,再用同一个样例证明修复成功。这样的回归测试只能证明系统记住了题目,不能证明能力真的变稳。
把 Badcase 变成资产,而不只是一次修补
面对 Memory、Retrieval 和 Context,最实用的判断原则只有一个:谁被单独移除或替换后,错误稳定消失,谁才更接近根因。
一个 Badcase 的生命周期也不该止于"修好了"。更完整的流程是:复现问题、隔离变量、确认根因、修复、做邻近测试,再决定它应该进入 Regression Dataset、检索监控、Memory 测试,还是 Context 压力测试。
真正成熟的系统,不是没有 Badcase,而是每出现一个 Badcase,都能让下一次定位更快、测试更准、同类问题更难再次发生。