文章目录
- [1. 概念](#1. 概念)
- [2. 过滤类](#2. 过滤类)
-
- [2.1 SimilarityPostprocessor](#2.1 SimilarityPostprocessor)
- [2.2 KeywordNodePostprocessor](#2.2 KeywordNodePostprocessor)
- [2.3 SentenceEmbeddingOptimizer](#2.3 SentenceEmbeddingOptimizer)
- [3. 重排序类](#3. 重排序类)
-
- [3.1 LongContextReorder](#3.1 LongContextReorder)
- [3.2 CohereRerank](#3.2 CohereRerank)
- [3.3 SentenceTransformerRerank](#3.3 SentenceTransformerRerank)
- [3.4 LLMRerank、](#3.4 LLMRerank、)
- [3.5 JinaRerank](#3.5 JinaRerank)
- [3.6 RankGPT](#3.6 RankGPT)
- [3.7 ColbertRerank](#3.7 ColbertRerank)
- [3.8 RankLLM](#3.8 RankLLM)
- [4. 上下文增强类](#4. 上下文增强类)
-
- [4.1 PrevNextNodePostprocessor](#4.1 PrevNextNodePostprocessor)
- [4.2 AutoPrevNextNodePostprocessor](#4.2 AutoPrevNextNodePostprocessor)
- [5. 内容改写与脱敏类](#5. 内容改写与脱敏类)
-
- [5.1 MetadataReplacementPostProcessor](#5.1 MetadataReplacementPostProcessor)
- [5.2 PIINodePostprocessor](#5.2 PIINodePostprocessor)
- [6. 业务规则类](#6. 业务规则类)
-
- [6.1 FixedRecencyPostprocessor](#6.1 FixedRecencyPostprocessor)
- [6.2 EmbeddingRecencyPostprocessor](#6.2 EmbeddingRecencyPostprocessor)
- [6.3 TimeWeightedPostprocessor](#6.3 TimeWeightedPostprocessor)
1. 概念
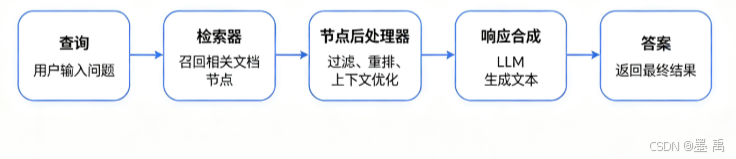
节点后处理器 (NodePostprocessor)是 RAG 流程里检索之后、生成之前的一个处理环节:拿到检索器返回的 NodeWithScore 列表,对它做过滤、重排、改写元数据 等二次加工,再把整理好的节点交给 LLM 生成答案。
在 LlamaIndex 中,节点后处理器最常用于查询引擎内部,执行时机位于节点检索步骤之后,回答合成步骤之前。
在流水线里的位置:
和元数据过滤的区别:
| 元数据过滤 | 节点后处理器 | |
|---|---|---|
| 发生时机 | 检索过程中(召回前缩小候选集) | 检索之后(对已召回结果加工) |
| 依据 | 节点的结构化 metadata(布尔条件) |
分数、关键词、模型打分等,任意逻辑 |
| 典型用途 | 权限/租户/类型隔离 | 分数截断、关键词过滤、重排、去重 |
LlamaIndex 提供多款开箱即用的节点后处理器,同时提供简洁的 API,支持开发者自定义后处理器。
2. 过滤类
核心目标 :按照规则剔除低质量、不相关节点,减少送入大模型的 token 数量。
2.1 SimilarityPostprocessor
用于剔除相似度分数低于阈值的节点。
代码示例:
python
from llama_index.core.postprocessor import SimilarityPostprocessor

postprocessor = SimilarityPostprocessor(similarity_cutoff=0.7)

postprocessor.postprocess_nodes(nodes)
2.2 KeywordNodePostprocessor
用于强制保留或剔除包含指定关键词的节点。
代码示例:
python
from llama_index.core.postprocessor import KeywordNodePostprocessor

postprocessor = KeywordNodePostprocessor(
    required_keywords=["word1", "word2"], exclude_keywords=["word3", "word4"]
)

postprocessor.postprocess_nodes(nodes)
2.3 SentenceEmbeddingOptimizer
该后处理器通过移除和查询无关的句子,减少 Token 消耗(依靠嵌入向量实现)。
百分位阈值用于保留排名前指定占比的高相关句子。也可以指定绝对相似度阈值,基于原始相似度筛选保留句子。
代码示例:
python
from llama_index.core.postprocessor import SentenceEmbeddingOptimizer

postprocessor = SentenceEmbeddingOptimizer(
    embed_model=service_context.embed_model,
    percentile_cutoff=0.5,
    # threshold_cutoff=0.7
)

postprocessor.postprocess_nodes(nodes)
完整教程 Notebook 查看此处
3. 重排序类
核心目标:基于语义相关性重新排序,把高相关文档前置,是 RAG 优化的核心手段。
3.1 LongContextReorder
大模型很难捕捉长文本中间位置的关键信息。一篇论文发现:把关键信息放在上下文的开头或末尾,通常能取得最好效果。而且即便原生支持长上下文的模型,随着输入文本变长,性能也会明显下降。
该模块会对检索出来的节点重新排序,在需要设置较大 top-k 的场景很有用。
python
from llama_index.core.postprocessor import LongContextReorder

postprocessor = LongContextReorder()

postprocessor.postprocess_nodes(nodes)
3.2 CohereRerank
调用 Cohere 的 ReRank 接口重排节点,返回 Top-N 节点。
python
from llama_index.postprocessor.cohere_rerank import CohereRerank

postprocessor = CohereRerank(
    top_n=2, model="rerank-v3.5", api_key="YOUR COHERE API KEY"
)

postprocessor.postprocess_nodes(nodes)
完整 Notebook 教程:点击查看
3.3 SentenceTransformerRerank
该后处理器借助嵌入向量,移除和查询无关的句子,从而减少 token 消耗。
- 百分位截断 (
percentile cutoff):保留相关性排名前指定百分比的句子。 - 阈值截断 (
threshold cutoff):也可以直接指定原始相似度阈值,用来筛选保留句子。
python
from llama_index.core.postprocessor import SentenceEmbeddingOptimizer

postprocessor = SentenceEmbeddingOptimizer(
    embed_model=service_context.embed_model,
    percentile_cutoff=0.5,
    # threshold_cutoff=0.7
)

postprocessor.postprocess_nodes(nodes)
完整 Notebook 教程看这里。
可查阅sentence-transformers官方文档,获取更多在速度/精度之间取舍的交叉编码器模型。
构造函数的model参数默认值为cross-encoder/stsb-distilroberta-base,该模型训练目标是文本语义相似度,并非段落重排 。检索场景强烈推荐使用经过 MS MARCO 数据集训练的模型,例如上面示例的 cross-encoder/ms-marco-MiniLM-L6-v2(上面示例是更小的 L2 版本),或者新版的 Qwen/Qwen3-Reranker-0.6B。
想要更强的多语种效果,可以替换为最新交叉编码器模型 Qwen/Qwen3-Reranker-0.6B:
python
from llama_index.core.postprocessor import SentenceTransformerRerank

postprocessor = SentenceTransformerRerank(
    model="Qwen/Qwen3-Reranker-0.6B", top_n=3
)
该模型依然本地运行,不需要 API 密钥;相比 MiniLM 基线,每次查询会消耗更多算力。
3.4 LLMRerank、
直接用大模型完成节点重排:让LLM输出相关文档并给出相关性打分,返回排名前 N 的节点。
python
from llama_index.core.postprocessor import LLMRerank

postprocessor = LLMRerank(top_n=2, service_context=service_context)

postprocessor.postprocess_nodes(nodes)
完整 Notebook 教程:Gatsby示例、Lyft 10K财报文档示例
3.5 JinaRerank
调用 Jina 的 ReRank 接口重排节点,返回 Top-N 节点。
python
from llama_index.postprocessor.jinaai_rerank import JinaRerank

postprocessor = JinaRerank(
    top_n=2,
    model="jina-reranker-v2-base-multilingual",
    api_key="YOUR JINA API KEY",
)

postprocessor.postprocess_nodes(nodes)
完整 Notebook 教程:点击查看
3.6 RankGPT
使用 RankGPT 智能体根据相关性对文档重排,返回 Top N节点。
python
from llama_index.postprocessor.rankgpt_rerank import RankGPTRerank

postprocessor = RankGPTRerank(top_n=3, llm=OpenAI(model="gpt-4o-mini"))

postprocessor.postprocess_nodes(nodes)
完整 Notebook 教程:点击查看
3.7 ColbertRerank
使用 Colbert V2 模型做重排器,基于查询 token 与段落 token 之间细粒度相似度重排文档,返回 Top N节点。
python
from llama_index.postprocessor.colbert_rerank import ColbertRerank

colbert_reranker = ColbertRerank(
    top_n=5,
    model="colbert-ir/colbertv2.0",
    tokenizer="colbert-ir/colbertv2.0",
    keep_retrieval_score=True,
)

query_engine = index.as_query_engine(
    similarity_top_k=10,
    node_postprocessors=[colbert_reranker],
)
response = query_engine.query(
    query_str,
)
完整 Notebook教程:点击查看
3.8 RankLLM
基于 rankLLM 项目提供的模型做文档重排,返回 Top N节点。
python
from llama_index.postprocessor.rankllm_rerank import RankLLMRerank

# RankZephyr重排器,返回top5候选
reranker = RankLLMRerank(model="rank_zephyr", top_n=5)
reranker.postprocess_nodes(nodes)
完整 Notebook 示例:点击查看
4. 上下文增强类
核心目标:召回一个节点时,自动加载关联邻近切片,丰富上下文信息。
4.1 PrevNextNodePostprocessor
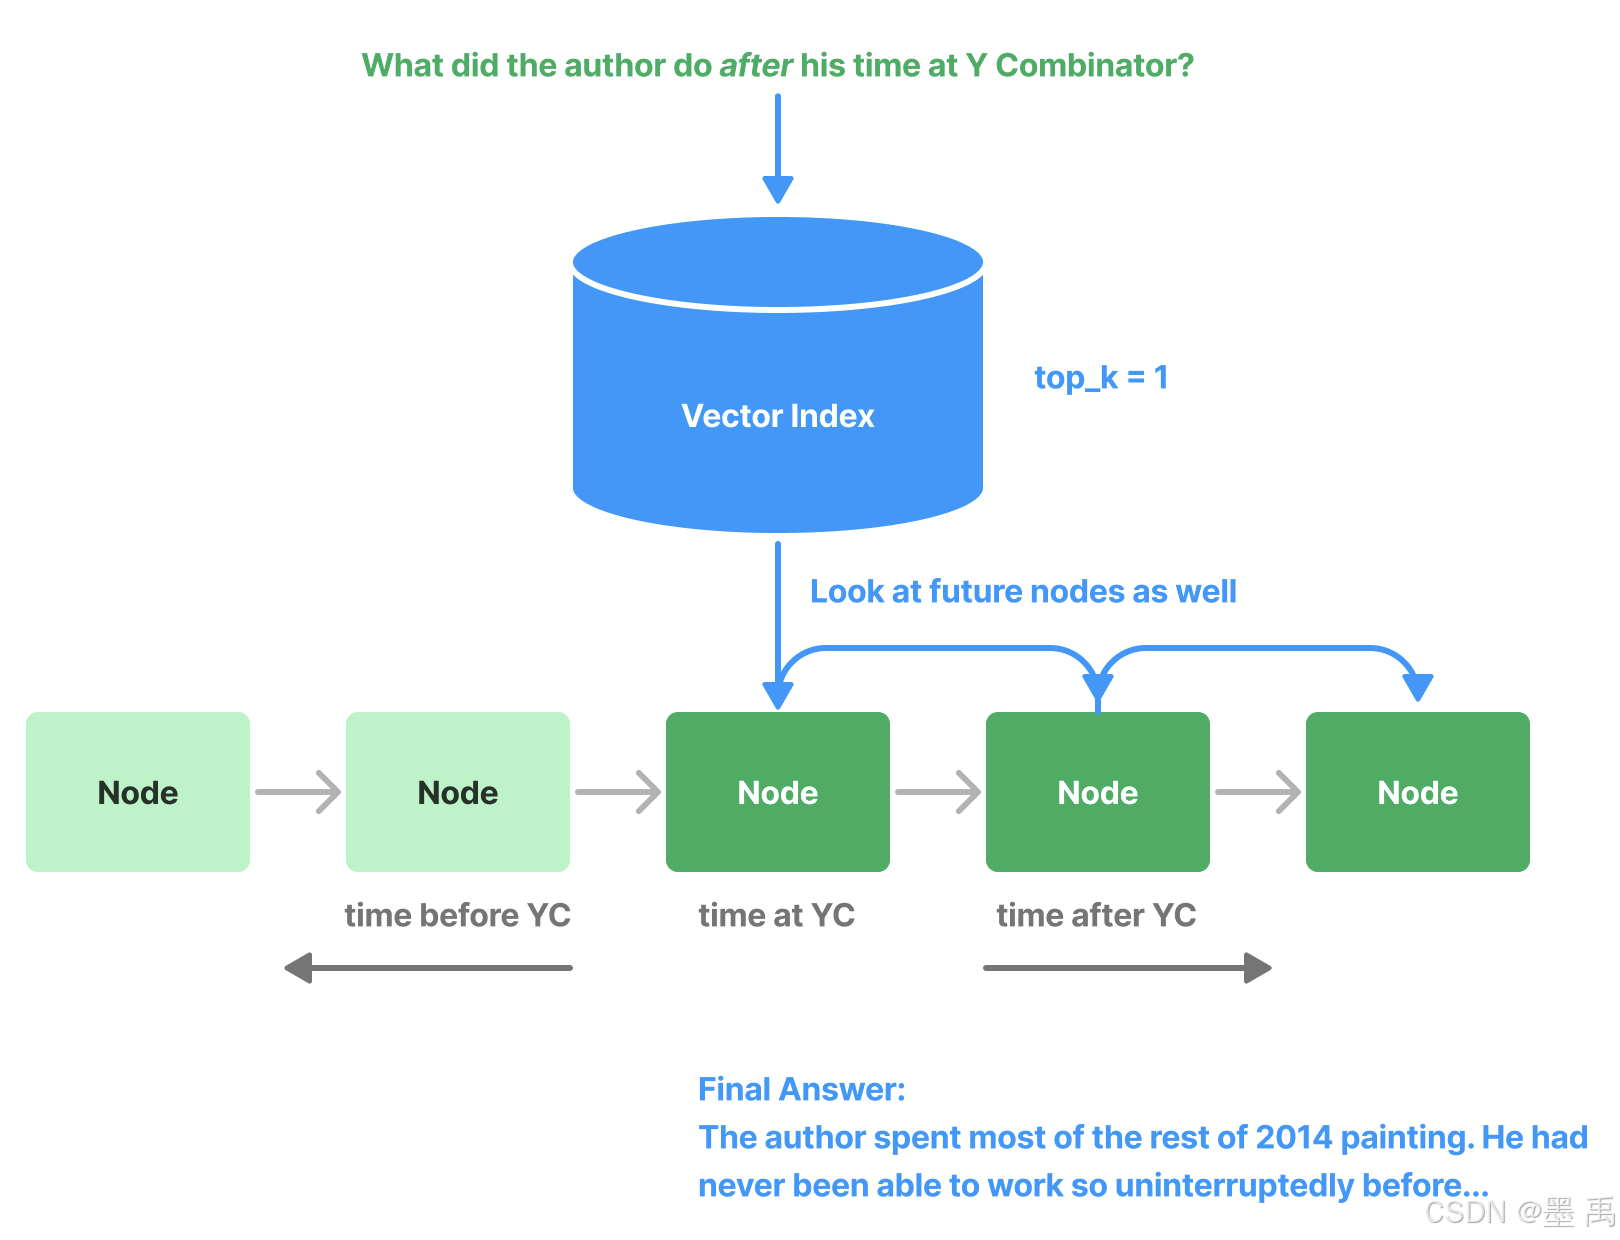
读取节点之间的关联关系,自动获取前置切片、后置切片,或者同时获取两者。
适用于:当召回某个节点时,需要补充读取前后关联的关键上下文一并传给大模型。
代码示例:
python
from llama_index.core.postprocessor import PrevNextNodePostprocessor

postprocessor = PrevNextNodePostprocessor(
    docstore=index.docstore,
    num_nodes=1,  # 向前/向后读取的节点数量
    mode="next",  # 可选值:next(后序)、previous(前序)、both(双向)
)

postprocessor.postprocess_nodes(nodes)
4.2 AutoPrevNextNodePostprocessor
功能与 PrevNextNodePostprocessor 一致,由大模型自行判断读取模式:读取上文、下文或者双向读取。
代码示例:
python
from llama_index.core.postprocessor import AutoPrevNextNodePostprocessor

postprocessor = AutoPrevNextNodePostprocessor(
    docstore=index.docstore,
    service_context=service_context,
    num_nodes=1,  # 向前/向后读取的节点数量
)
postprocessor.postprocess_nodes(nodes)
完整示例 Notebook 查看此处。
5. 内容改写与脱敏类
核心目标:修改节点原始文本,用于窗口检索、隐私脱敏等场景。
5.1 MetadataReplacementPostProcessor
使用节点元数据中的指定字段替换节点原文。如果元数据不存在该字段,则保留原始文本。该组件最常与 SentenceWindowNodeParser 搭配使用。
代码示例:
python
from llama_index.core.postprocessor import MetadataReplacementPostProcessor

postprocessor = MetadataReplacementPostProcessor(
    target_metadata_key="window",
)

postprocessor.postprocess_nodes(nodes)
5.2 PIINodePostprocessor
PII(个人身份敏感信息)后处理器用于移除存在安全风险的隐私数据,通过命名实体识别模型或者本地大模型实现。
大模型版本代码示例:
python
from llama_index.core.postprocessor import PIINodePostprocessor

postprocessor = PIINodePostprocessor(
    service_context=service_context  # 使用可信的大模型配置
)

postprocessor.postprocess_nodes(nodes)
NER 本地模型版本方案使用 Hugging Face 默认的命名实体识别流水线模型。
python
from llama_index.core.postprocessor import NERPIINodePostprocessor

postprocessor = NERPIINodePostprocessor()

postprocessor.postprocess_nodes(nodes)
两种方案的完整教程 Notebook 查看此处。
6. 业务规则类
核心目标:基于时间、版本等业务属性筛选,偏向业务场景定制。
6.1 FixedRecencyPostprocessor
该后处理器按照日期排序,返回时间最新的 K 条节点。要求每个节点的元数据中存在可解析的 date 字段。
代码示例:
python
from llama_index.core.postprocessor import FixedRecencyPostprocessor

postprocessor = FixedRecencyPostprocessor(
    top_k=1, date_key="date"  # 元数据中日期对应的键名
)

postprocessor.postprocess_nodes(nodes)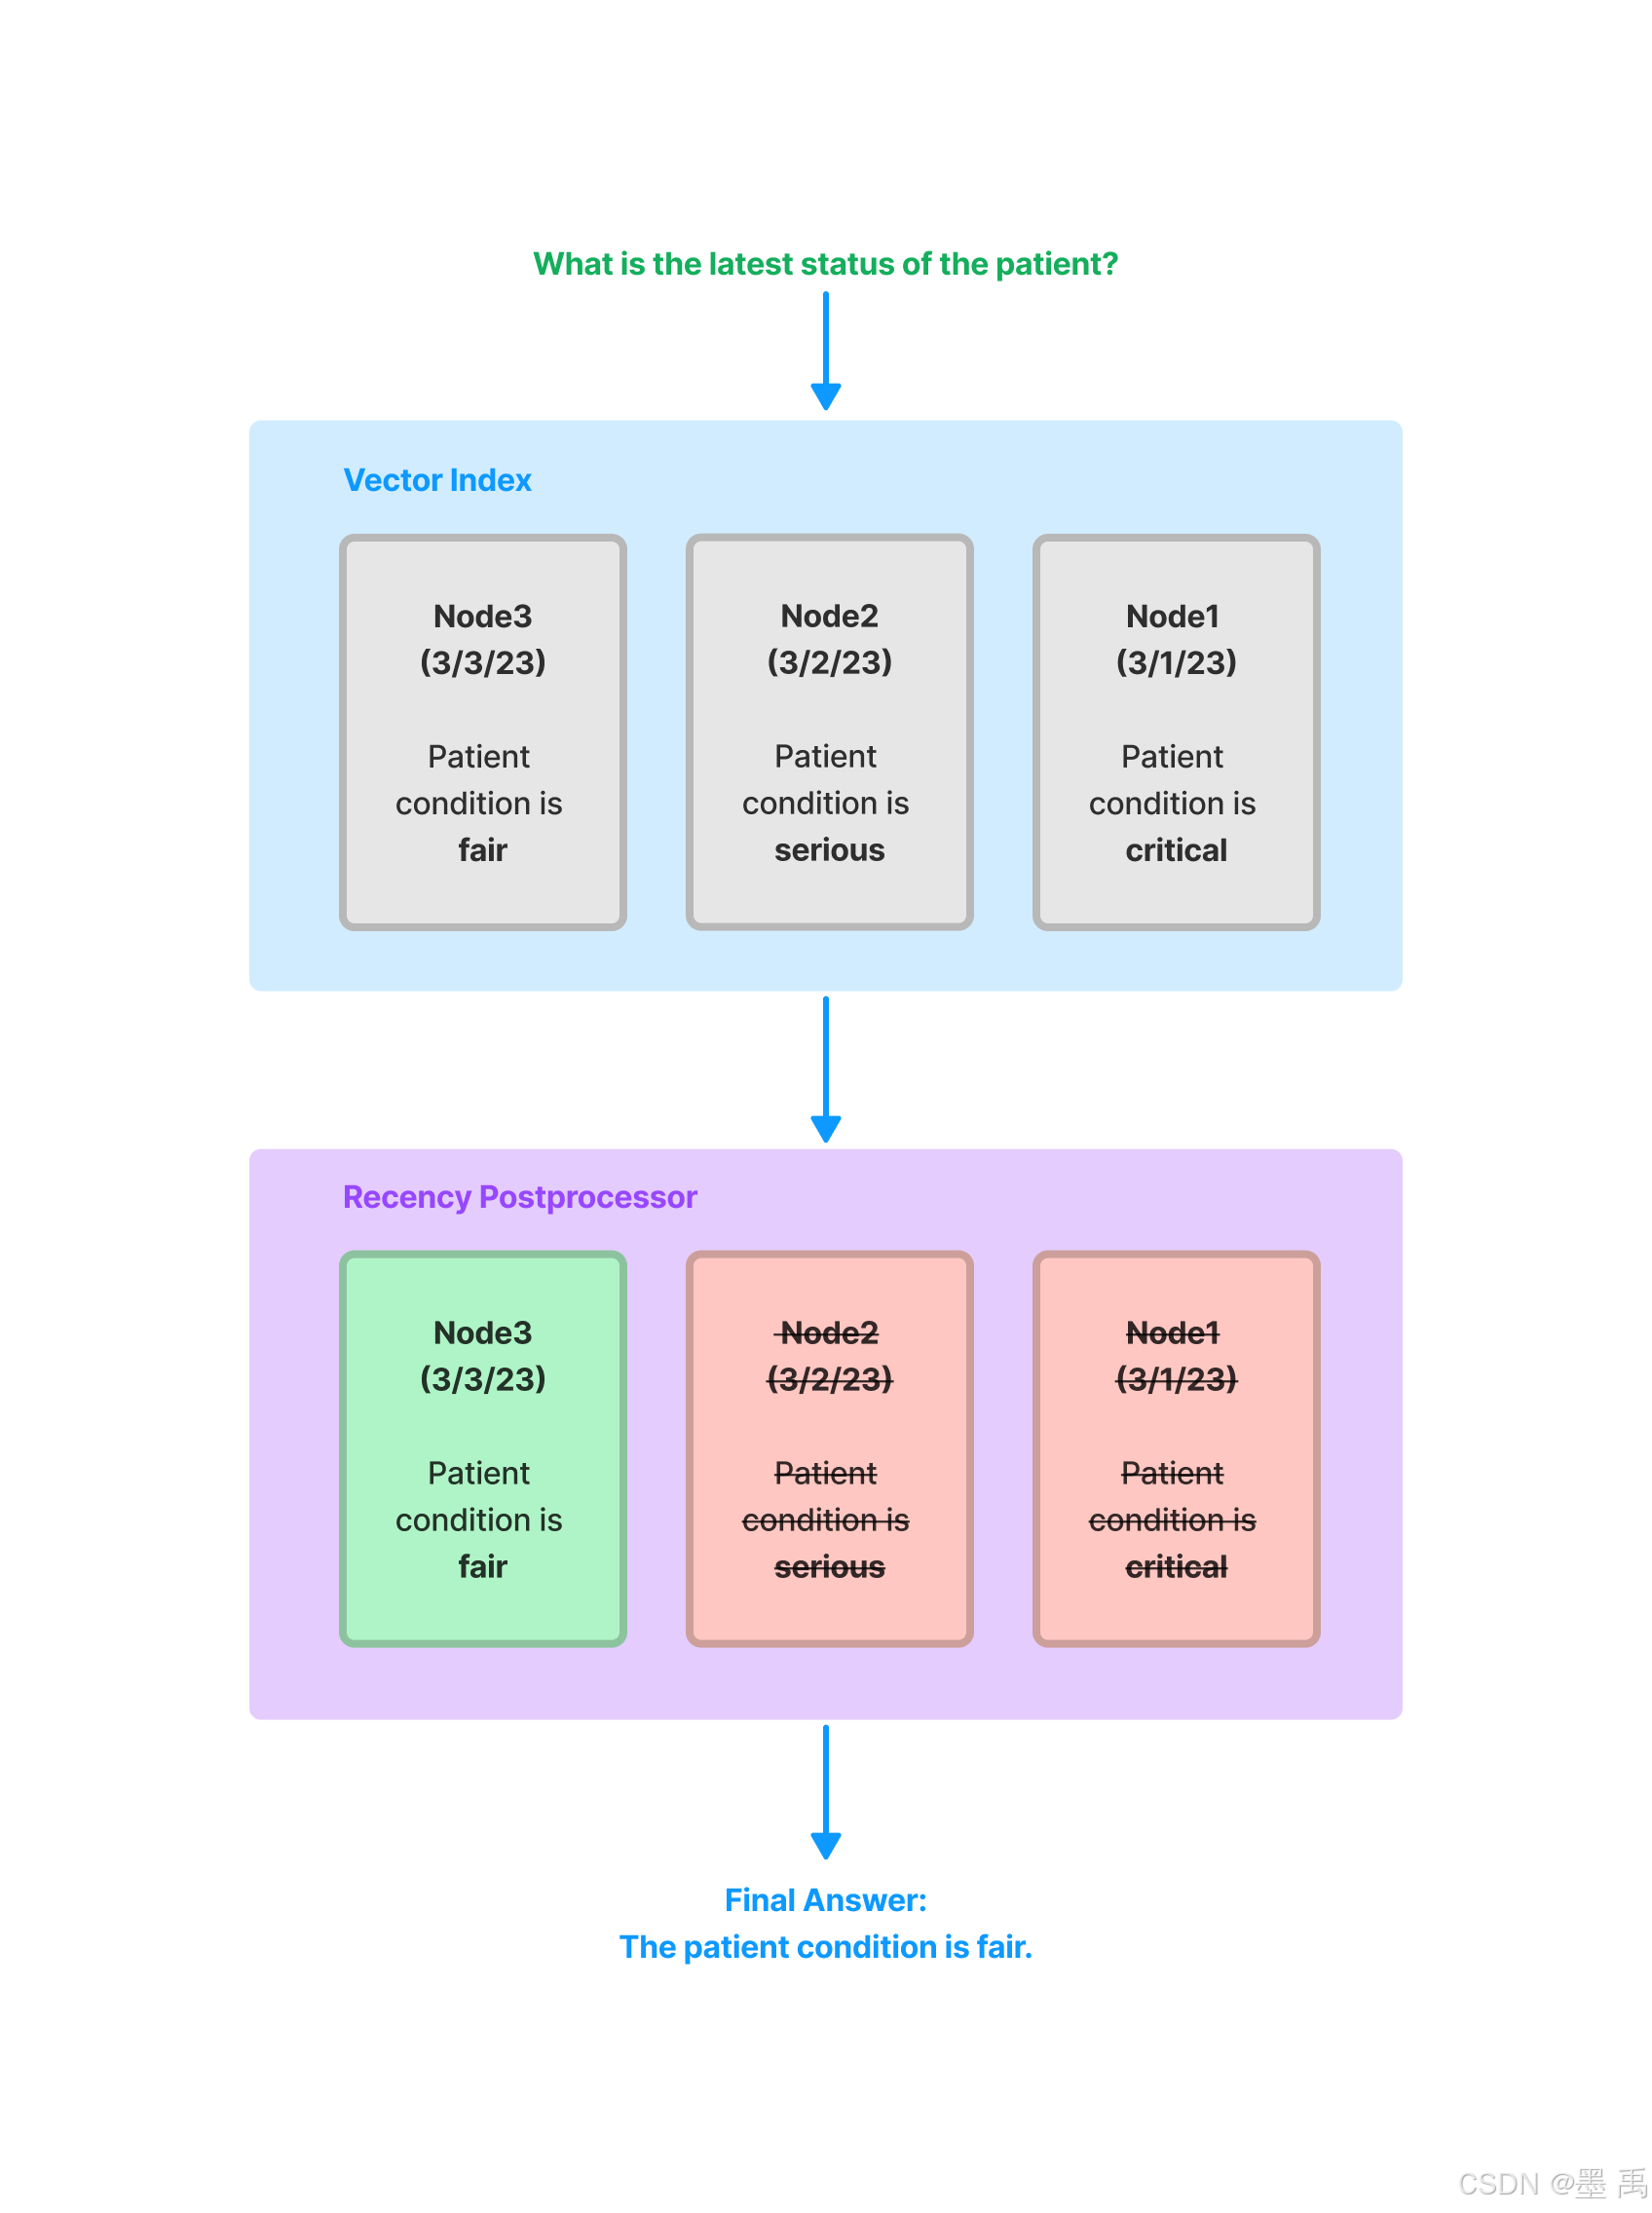
完整教程 Notebook 查看此处。
6.2 EmbeddingRecencyPostprocessor
先按日期排序,再通过向量相似度计算剔除内容高度相似的老旧文档,最终返回 Top‑K 节点。
代码示例:
python
from llama_index.core.postprocessor import EmbeddingRecencyPostprocessor

postprocessor = EmbeddingRecencyPostprocessor(
    service_context=service_context, date_key="date", similarity_cutoff=0.7
)

postprocessor.postprocess_nodes(nodes)
完整教程 Notebook 查看此处。
6.3 TimeWeightedPostprocessor
为每个节点施加时间衰减权重完成重排。每次节点被检索时会记录访问时间,使检索结果更偏向尚未被回答过的新内容。
代码示例:
python
from llama_index.core.postprocessor import TimeWeightedPostprocessor

postprocessor = TimeWeightedPostprocessor(time_decay=0.99, top_k=1)

postprocessor.postprocess_nodes(nodes)
完整教程 Notebook 查看此处。