2026 后端 AI 工程化:Spring AI 2.0、MCP 协议与 Agent 内嵌如何收进 Java 生产系统
2026 年的后端 AI 集成,已经从"能不能调通一个大模型接口"变成了"怎么把模型能力稳定地收进现有 Java 系统"的工程问题。一个熟练的后端工程师可以在半天内用几十行代码跑通一次对话调用;但要在已经承载核心业务的 Spring Boot 系统里长期运行,还必须回答一系列老问题:超时怎么设、失败怎么降级、限流按什么维度做、成本怎么核算到业务、写操作越权了谁负责。
社区把当前最密集的三个讨论变量归纳为 Spring AI 2.0、MCP(Model Context Protocol)与 Agent 内嵌 123,并提出了一个很有启发性的架构类比:大模型正在像数据库、消息队列一样,成为后端的一个基础设施层 3。需要说明的是,这一判断在现有素材中属于社区观点而非官方结论,本文把它当作论点而非事实使用。
同样需要先交代材料性质:本次可用素材主要来自 CSDN、掘金、Gitee、GitHub 的二手教程与聚合日报,采集记录中的热度指标全部缺失,无法用于排序或判断影响力;其中涉及版本号、接口形态、性能数字的表述,多数没有一手出处。因此本文的写法是:工程思路和决策框架给出确定结论,具体 API 签名、版本基线、性能数据一律标注为"需按官方文档核验",不把二手教程里的数字当事实转述。
一、先立框架:三个变量各自收编哪一层
把 AI 能力塞进 Java 生产系统,实际要在三个不同层面做标准化,而三个变量恰好对应这三层:
| 层次 | 变量 | 收编内容 | 仍然留给你的工程责任 |
|---|---|---|---|
| 能力层 | Spring AI | 多厂商调用、工具声明、RAG 链路的编程模型统一 | 超时预算、成本核算、输出校验、业务级降级 |
| 交互层 | MCP | 工具与资源的跨模型、跨框架声明、发现与调用 | 工具权限分级、调用审计、服务端版本治理 |
| 执行层 | Agent 内嵌 | 多轮规划与工具编排进入业务进程或业务链路 | 事务边界、幂等、人工确认点、执行轨迹 |
这个分层的意义在于避免概念混用:Spring AI 解决的是"用一套编程模型换厂商、换模型",MCP 解决的是"同一个工具能被不同模型、不同框架复用",Agent 内嵌解决的是"让自动决策进入业务执行路径"。三者都不替你保证 SLA,也不替你算账。
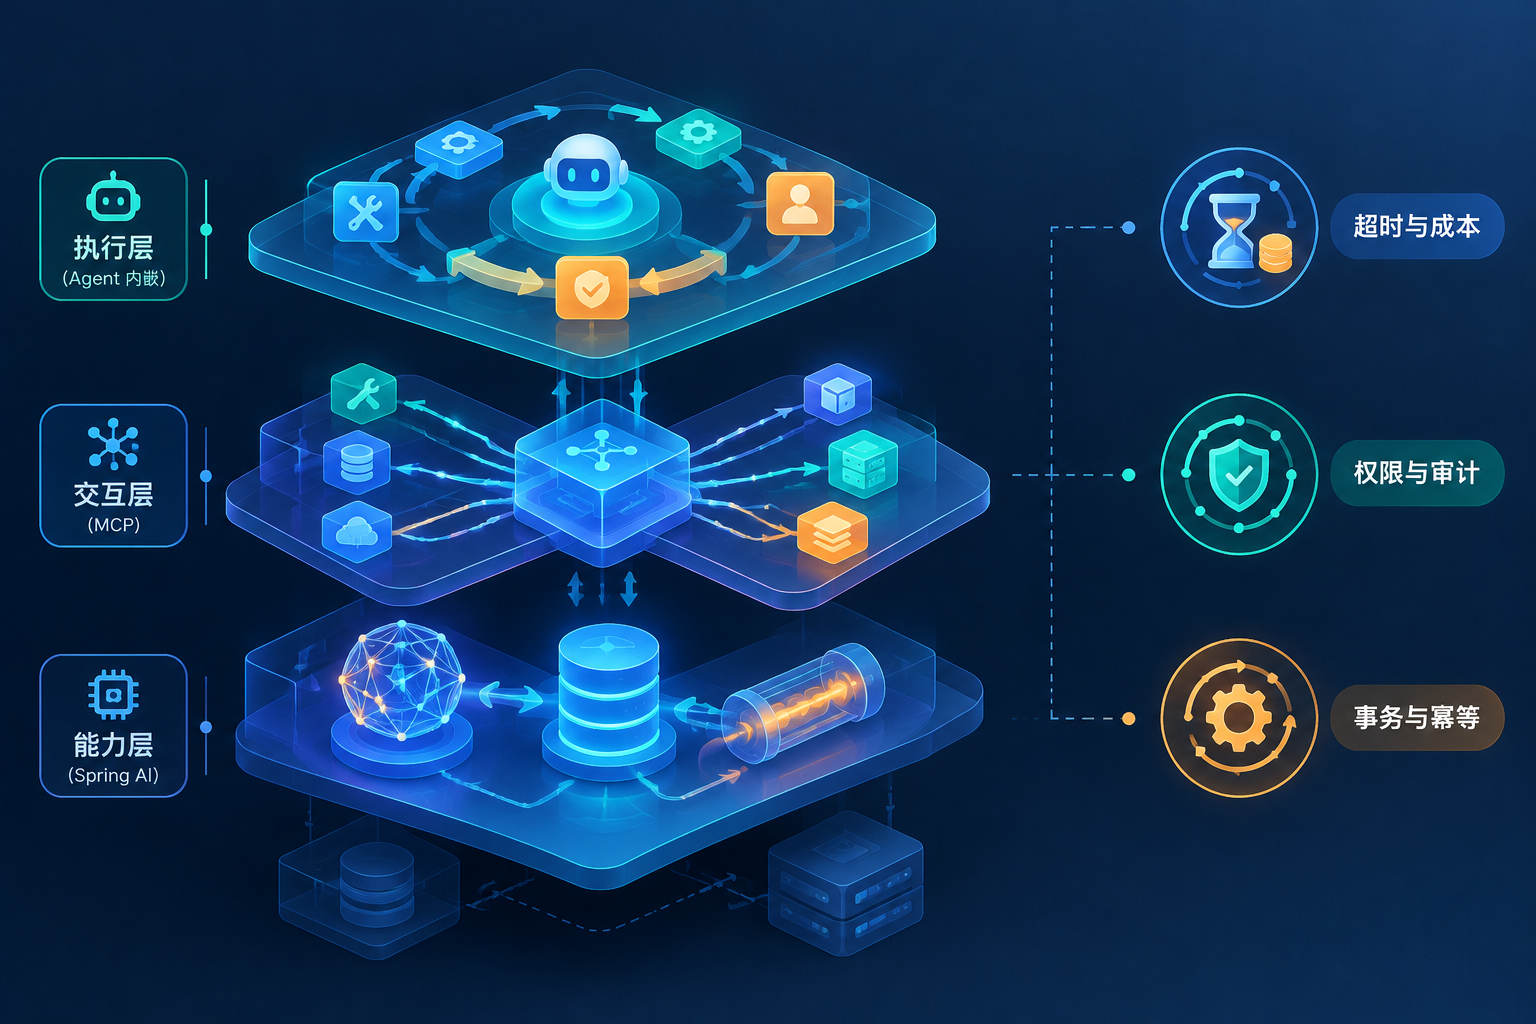
从落地顺序看,最稳的路径是先把一条 LLM 调用链路治理好(第四、六节),再做工具标准化(第二节),最后才在有限范围内内嵌 Agent(第三节)。反过来做------先上 Agent 再补治理------通常会在排障和成本失控上付出更大代价。
二、变量一:Spring AI 的能力层抽象解决了什么,没解决什么
2.1 三个落点:ChatClient、Tool Calling、RAG
Spring AI 的核心价值是把"厂商 SDK + HTTP 细节 + 提示词拼装"收敛到统一的编程模型上。三个最常用落点分别是:
- ChatClient:面向对话/补全的流式或非流式调用入口,屏蔽底层模型客户端差异;
- Tool Calling:以方法注解声明业务工具,由框架完成参数绑定、调用分发与结果回填;
- RAG 链路:把向量检索、文档切分、上下文注入组织成可组合的组件,而不是散落在业务代码里的一堆字符串拼接。
最小调用形态大致如下(示意代码,包名与方法签名需按你所使用版本的官方文档核验):
java
@Service
public class AssistService {

    private final ChatClient chatClient;

    public AssistService(ChatModel chatModel) {
        this.chatClient = ChatClient.builder(chatModel).build();
    }

    public String answer(String question) {
        return chatClient.prompt()
                .system("你是订单系统的内部助手,只依据工具返回结果回答,不做推测。")
                .user(question)
                .call()
                .content();
    }
}
工具声明的思路是把业务能力暴露为带描述、带类型的方法:
java
@Component
public class OrderTools {

    @Tool(description = "根据订单号查询订单状态,订单号格式为 ORD 开头")
    public OrderStatusView queryOrderStatus(
            @ToolParam("orderId") String orderId) {
        return orderQueryService.findByOrderNo(orderId);
    }
}
对比裸 HTTP 调用,抽象层带来的差异不在"能不能跑通",而在可测试性与可替换性 :业务代码依赖的是 ChatClient 与工具方法,而不是某个厂商的请求体结构;单测可以替换成固定的 ChatModel 实现,切换供应商时业务层几乎不动。
2.2 版本与依赖边界:本文最需要核验的一块
现有素材中有一篇教程声称"Spring AI 2.0 强制要求 Java 21、Spring Boot 4.0+"5,另一篇则按 Spring Boot 3.4.x、JDK 17+ 展示 DeepSeek 接入 4。两者并不自洽,而它们都属于二手教程,无法作为版本依据。可以确定的方向只有:
- Spring Boot 3.x 时代的 Java 基线是 17,Java 21 引入的虚拟线程在高并发阻塞式调用中有实际价值,这一点有官方 JDK 特性文档支撑(JEP 444)3;
- Spring AI 的起步依赖与自动配置坐标在不同版本间有过命名调整,例如 OpenAI 兼容模型的 starter 坐标出现过
spring-ai-openai-spring-boot-starter与spring-ai-starter-model-openai两种形态,必须以你锁定版本的官方发布说明为准; - 若计划升级到 Spring Boot 4.x / Spring Framework 7.x,需要单独评估 GraalVM 原生镜像、AOT 处理与既有中间件的兼容性,社区路线图类文章普遍把 2027 年作为评估窗口而非立即迁移时点 6。
实践建议:在 BOM 中显式锁定 Spring AI 版本,禁止让不同模块各自引用不同小版本;升级前先跑一遍"模型切换 + 工具调用 + 流式输出"的回归用例,这三类能力最能暴露 API 变更。
2.3 抽象层不替你做的事
以下清单是本文后续章节的主线,也是很多团队误以为"引入 Spring AI 就解决"的部分:
- 连接超时、首 token 超时、整体超时的分层预算;
- token 用量与费用的采集、归集、分摊;
- 输出结构化校验、越权内容过滤、审计留痕;
- 失败后的业务降级路径(换模型、换缓存、换规则、直接拒绝);
- 并发与容量控制,尤其是流式响应下的连接与线程占用;
- 多轮工具调用的步数上限与异常终止后的状态一致性。
简言之,Spring AI 降低的是接入与替换成本 ,它没有降低治理成本。
三、变量二:MCP:工具交互标准化的真实收益
3.1 MCP 解决的是哪一层问题
在没有统一协议之前,每个模型、每个框架都要重新声明一遍工具:名称、参数 schema、调用方式、返回结构各写各的。于是"查订单状态"这一个业务能力,可能在 A 框架写一次、B 框架写一次、C 产品再写一次,权限和审计也就跟着分裂。
MCP 把这段交互标准化为 client--server 形态:宿主应用持有 MCP client,通过协议连接一个或多个 MCP server,server 把工具(tools)与资源(resources)以统一方式暴露出来。它解决的是跨模型、跨框架的工具复用与治理,不是模型能力问题,也不是 OpenAPI 的替代品------OpenAPI 描述的是服务接口,MCP 描述的是"模型运行时如何发现并调用外部能力"。
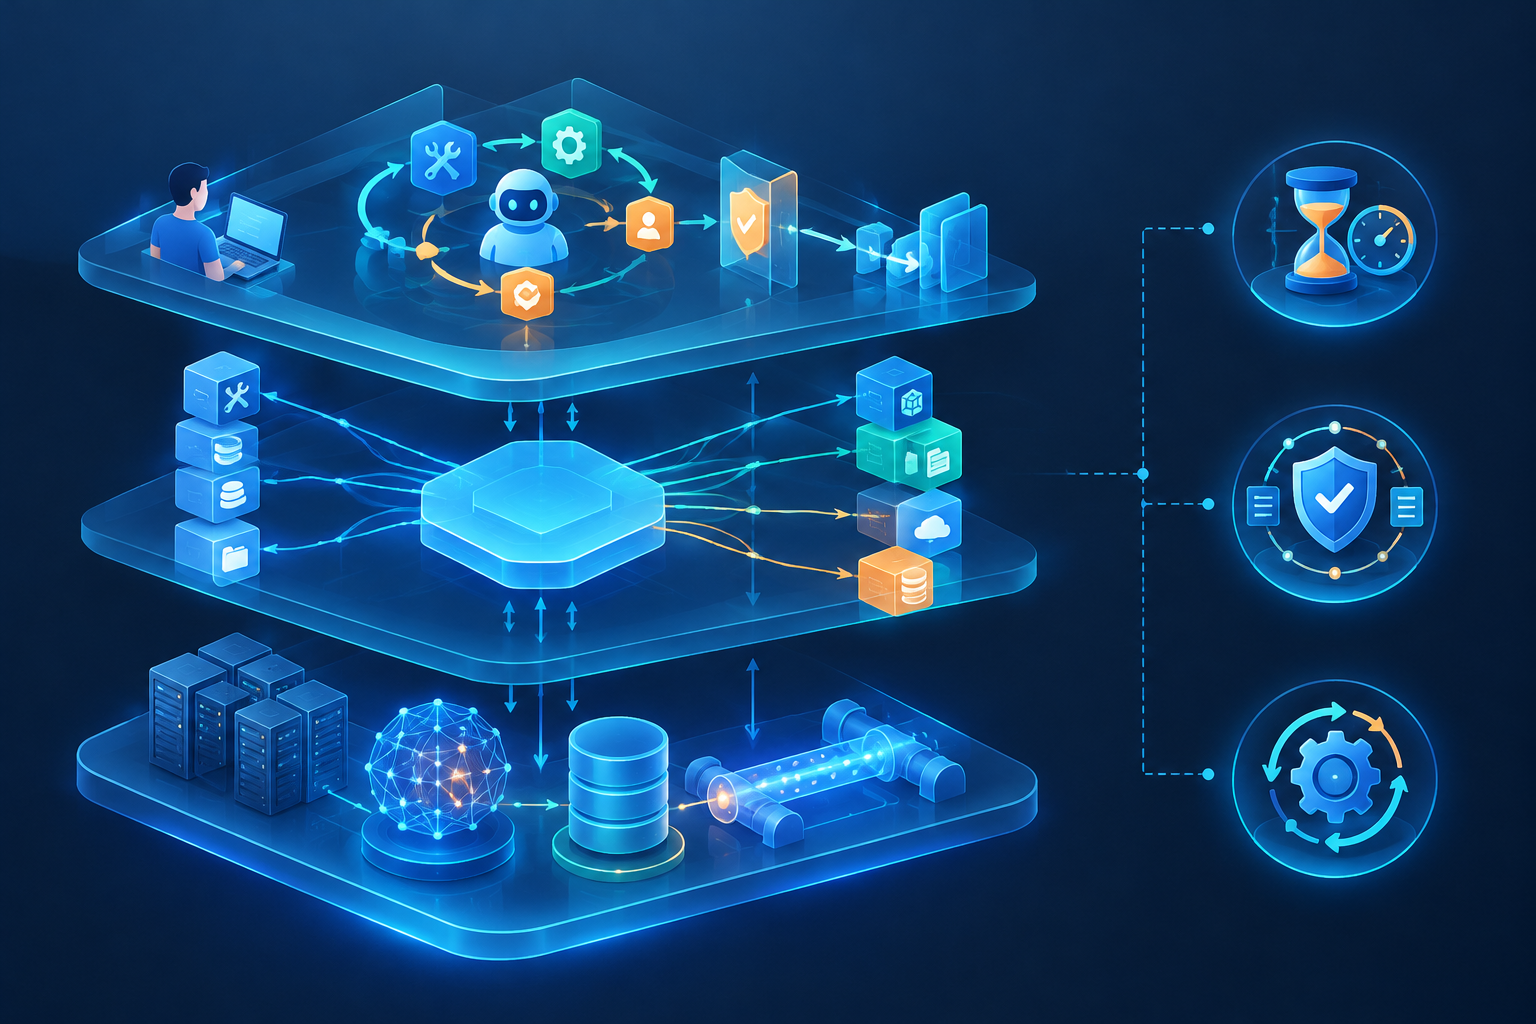
社区把 MCP 称为"2026 年最受关注的新趋势"2,这个说法来自单篇选型类文章,证据等级有限;更稳妥的表述是:在后端 AI 集成的讨论中,MCP 的出现频率明显上升,工具治理需求是主要推力。
3.2 Java 侧的接入形态
Java 侧通常有两条路径:
- 作为 client:业务系统连接已有的 MCP server,把这些工具纳入模型的可调用集合;
- 作为 server:把现有 Java 服务的内部能力封装成 MCP 工具,供多个 AI 宿主复用。
一个最小的工具暴露逻辑示意如下(具体注解、注册方式与 SDK 坐标需以官方文档与你锁定的 Spring AI 版本为准):
java
@Component
public class OrderMcpTools {

    private final OrderQueryService queryService;

    @Tool(description = "查询订单当前状态,返回 CREATED/PAID/SHIPPED/CLOSED")
    public OrderStatusView queryOrderStatus(@ToolParam("orderNo") String orderNo) {
        // 只读工具:不允许任何写副作用
        return queryService.getByOrderNo(orderNo);
    }

    @Tool(description = "发起退货申请,需人工确认后生效")
    public RefundApplyResult applyRefund(
            @ToolParam("orderNo") String orderNo,
            @ToolParam("reason") String reason,
            @ToolParam("idempotencyKey") String idempotencyKey) {
        return refundService.apply(orderNo, reason, idempotencyKey);
    }
}
注意第二个工具必须带幂等键,且默认不应让模型直接生效------这一点在下一节展开。
3.3 引入 MCP 的成本与不适用场景
MCP 不是免费的标准化,它带来新的进程、协议、版本与部署对象。以下场景通常不值得引入:
- 单体应用、单一模型、工具只有 2--3 个且不打算复用:直接用框架内的 function calling 更简单;
- 工具本质是内部方法调用,没有任何跨进程复用诉求;
- 团队还没有工具权限分级与调用审计能力:标准化会把风险暴露面一并放大。
引入后必须补的治理项:
| 治理项 | 要求 |
|---|---|
| 权限分级 | 只读 / 可写 / 需人工确认,按工具标注而非按接口模糊授权 |
| 调用审计 | 记录调用方、工具名、参数摘要、结果状态、耗时、幂等键 |
| 版本治理 | server 与工具 schema 版本化,参数变更走兼容策略 |
| 网络边界 | MCP server 与数据库、内网服务的可达范围按最小权限配置 |
| 超时预算 | 工具调用耗时计入 Agent 总预算,禁止无限等待 |
现有素材中出现过一个很典型的企业治理现象:智能体"报完工"但数据库状态并不认可 7。该报道为二手聚合内容,细节需回溯原始出处核验,但它提出的问题是真实的,也是 MCP 之后必须回答的问题:工具调用成功不等于业务状态变更成功。
四、变量三:Agent 内嵌:当智能体进入业务事务边界
4.1 内嵌式 Agent 的架构位置
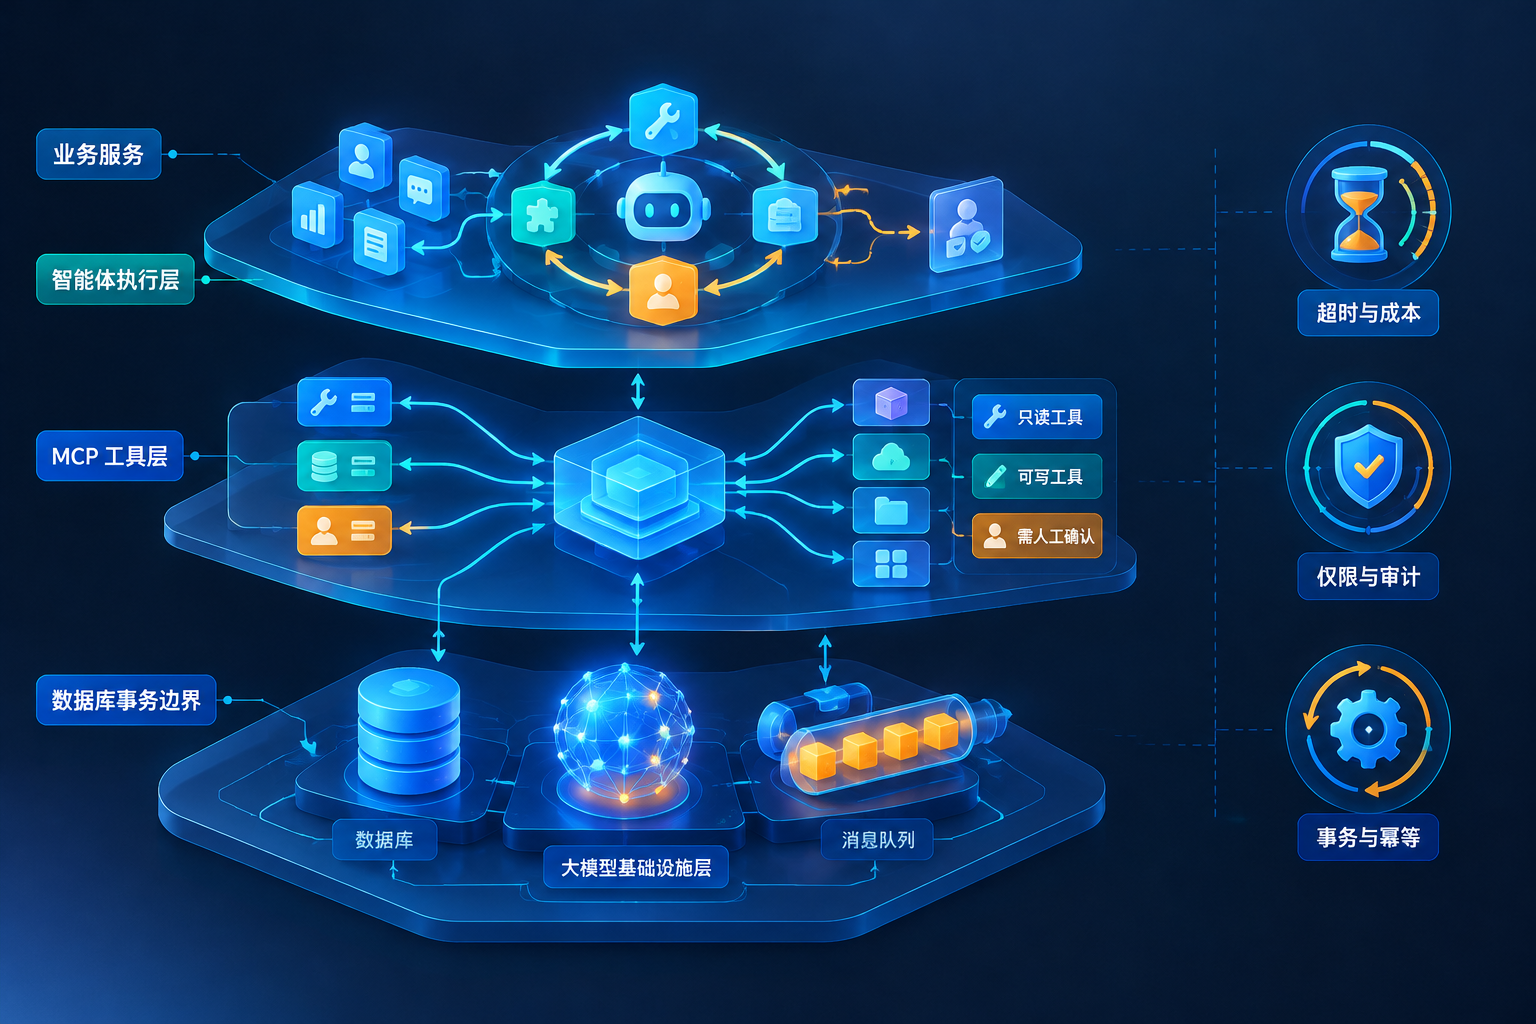
"Agent 内嵌"不是把一个独立 Agent 平台改名,而是让规划与工具编排进入业务链路的执行路径。两种典型形态:
| 形态 | 优点 | 风险 |
|---|---|---|
| 业务服务进程内嵌 | 延迟低、共享事务与上下文、部署简单 | 爆炸半径大,模型调用异常可能拖垮业务线程池 |
| 独立 Agent 服务 | 故障隔离、可独立扩缩容、便于灰度 | 跨服务事务、上下文传递、网络超时链路变长 |
推荐的起步形态是独立 Agent 服务 + 只读工具,等工具权限分级、审计、幂等都稳定后,再把部分可写工具逐步放开。MCP 在这里的角色很关键:工具即权限边界,Agent 能做什么完全取决于它被授权调用哪些工具。
4.2 事务、幂等与"报完工不认账"
Agent 的执行是多轮的:模型推理、工具调用、再次推理、最终输出。任何一轮失败,都可能出现"模型认为已经完成、业务状态没有变更"的不一致。工程对策有四条:
- 工具侧幂等键:所有写工具必须接受幂等键,重复调用返回同一结果而不是重复执行;
- 状态回读校验:写操作后必须通过只读工具或直接查询回读状态,禁止只依赖工具返回值判断成功;
- 补偿与人工确认点:跨系统、跨服务的写操作按补偿事务设计,高风险操作(退款、删除、权限变更)必须 human-in-the-loop;
- 步数与预算上限:限制最大工具调用轮次、最大 token 消耗、最大执行时长,超限强制终止并保留中间状态。
以一个虚构的"订单退换货审批 Agent"做推演(以下为设计推演,不代表真实客户案例):Agent 被授权调用 queryOrderStatus(只读)、checkReturnPolicy(只读)、applyRefund(需人工确认)。当模型决定退款时,系统不直接执行,而是生成待确认工单;人工确认后由业务服务以幂等键执行退款,并回读支付系统状态。Agent 的"完成"文案只能基于回读结果生成。这样即使模型输出措辞有误,业务状态仍然由既有事务与审批流保证。
4.3 Agent 的可运维性
- 执行轨迹(trace):每轮推理的输入摘要、决策、工具调用、返回结果、耗时都落盘或进入 OpenTelemetry 链路,才能复现排障 6;
- 回放能力:保留工具返回快照,支持离线回放同一任务,评估改动是否影响决策;
- 限步与熔断:Agent 层有自己的熔断,与底层 LLM 调用的熔断是两个维度,不能混为一层;
- 崩溃恢复:Agent 中断时,业务侧要能识别"半完成"状态并触发重试或人工处理,而不是留下孤儿数据。
五、实操链路 A:DeepSeek 接入 Spring Boot
5.1 最小可运行工程
DeepSeek 提供 OpenAI 兼容的 HTTP 接口形态,这是它能被 Spring AI 一类统一抽象层直接接入的前提;具体的 base URL、可用模型名、速率限制与超时建议必须以 DeepSeek 官方文档为准,素材中的教程同样无法替代官方说明 4。
依赖(坐标以你锁定的 Spring AI 版本核验后使用):
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-openai</artifactId>
</dependency>
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
</dependency>
配置:
yaml
spring:
  ai:
    openai:
      base-url: ${LLM_BASE_URL}
      api-key: ${LLM_API_KEY}
      chat:
        options:
          model: ${LLM_MODEL}
          temperature: 0.2
          max-tokens: 512

assist:
  timeout:
    connect: 2s
    read: 20s
    total: 30s
  budget:
    daily-token-quota: 2000000
服务与端点:
java
@RestController
@RequestMapping("/api/assist")
public class AssistController {

    private final AssistService assistService;

    public AssistController(AssistService assistService) {
        this.assistService = assistService;
    }

    @PostMapping
    public AssistResponse assist(@Valid @RequestBody AssistRequest request) {
        return assistService.assist(request.question(), request.bizId());
    }
}
5.2 从 demo 到生产:五处改造
- 超时分层:连接超时、读取超时、整体超时分别配置,不能只设一个总超时;流式响应还需要单独的首 token 超时。
- 重试边界:只有幂等请求才能重试。对话补全通常幂等,带工具调用的请求不幂等,重试必须结合幂等键与业务状态判断。
- 密钥外置:API Key 走环境变量或密钥管理服务,禁止写入配置仓库;日志中对密钥与用户输入做脱敏。
- 流式资源管理:SSE 连接、缓冲区、客户端断连都要有超时与释放逻辑,避免连接堆积拖垮容器。
- 输出结构化校验:要求 JSON 输出时用 schema 校验并给出重试或降级路径,不要把模型输出直接写库。
这五处改造正是抽象层留给业务的部分:框架给的是调用与替换的钩子,治理逻辑仍然要自己写。
六、实操链路 B:PyTorch → ONNX → Spring Boot
6.1 什么时候该走本地推理
本地推理与调用 LLM API 是两条不同性质的链路,不能用同一套判断标准:
| 判定维度 | LLM API | ONNX 本地推理 |
|---|---|---|
| 输入输出 | 自然语言、开放式 | 固定张量结构、任务固定 |
| 延迟 | 百毫秒到秒级,受网络影响 | 毫秒到几十毫秒,可控 |
| 数据合规 | 需评估出域 | 数据不出域 |
| 成本结构 | 按 token 计费,随调用量线性增长 | 算力与内存固定成本,边际成本低 |
| 模型迭代 | 换模型即生效 | 需重新导出、测试、发版 |
| 运维负担 | 供应商 SLA、配额、限流 | 服务资源、模型文件版本、并发约束 |
判断原则:高频、低延迟、输入输出固定、数据不出域、成本敏感的任务,优先本地推理;语义理解、开放生成、跨域知识任务,优先 LLM。素材中提到的"ONNX 内存占用比 Python 原生减少 37%"等数字没有一手出处,本文不予采用 5。
6.2 导出与 Java 侧加载
导出脚本要点是明确输入名、输出名与动态维度:
python
import torch

torch.onnx.export(
    model,
    (dummy_input,),
    "model.onnx",
    input_names=["input"],
    output_names=["logits"],
    dynamic_axes={"input": {0: "batch"}, "logits": {0: "batch"}},
    opset_version=17,
)

import onnxruntime as ort
sess = ort.InferenceSession("model.onnx")
print([i.name for i in sess.get_inputs()])
print([o.name for o in sess.get_outputs()])
opset 版本需要与目标算子集、ONNX Runtime 版本共同确认,不要照抄教程里的数字。
Java 侧封装核心是会话生命周期与张量释放:
java
@Service
public class OnnxInferenceService implements DisposableBean {

    private final OrtEnvironment env = OrtEnvironment.getEnvironment();
    private final OrtSession session;

    public OnnxInferenceService(@Value("${model.path}") String modelPath) throws OrtException {
        OrtSession.SessionOptions options = new OrtSession.SessionOptions();
        options.setIntraOpNumThreads(Runtime.getRuntime().availableProcessors() / 2);
        this.session = env.createSession(modelPath, options);
    }

    // OrtSession 本身可并发调用,但 OnnxTensor 必须显式释放
    public float[] infer(float[] data, long[] shape) throws OrtException {
        try (OnnxTensor input = OnnxTensor.createTensor(env, FloatBuffer.wrap(data), shape);
             OrtSession.Result result = session.run(Map.of("input", input))) {
            return ((float[][]) result.get(0).getValue())[0];
        }
    }

    @Override
    public void destroy() throws OrtException {
        session.close();
    }
}
ONNX Runtime Java 的当前稳定版本、OrtSession 与 OnnxTensor 的具体签名需以官方文档核验;素材中的版本号(1.17+)属于教程表述 5。
6.3 部署与资源治理
dockerfile
FROM maven:3.9-eclipse-temurin-21 AS build
WORKDIR /app
COPY pom.xml .
RUN mvn -q -B dependency:go-offline
COPY src ./src
RUN mvn -q -B -DskipTests package

FROM eclipse-temurin:21-jre
WORKDIR /app
COPY --from=build /app/target/app.jar app.jar
COPY models/model.onnx /models/model.onnx
ENV JAVA_OPTS="-XX:MaxRAMPercentage=70"
ENTRYPOINT ["sh","-c","java $JAVA_OPTS -jar app.jar"]
需要额外控制的点:模型文件随镜像版本化、内存上限与 JVM 堆设置匹配、CPU 并发数与推理线程数协调、冷启动时的模型加载耗时纳入健康检查。与 LLM 路径相比,本地推理没有 token 账单,但有显存/内存占用、模型发版与算力扩容成本,两套成本模型要分开核算。
七、把 LLM 当基础设施:超时、降级、限流、成本四件套
7.1 超时分层预算
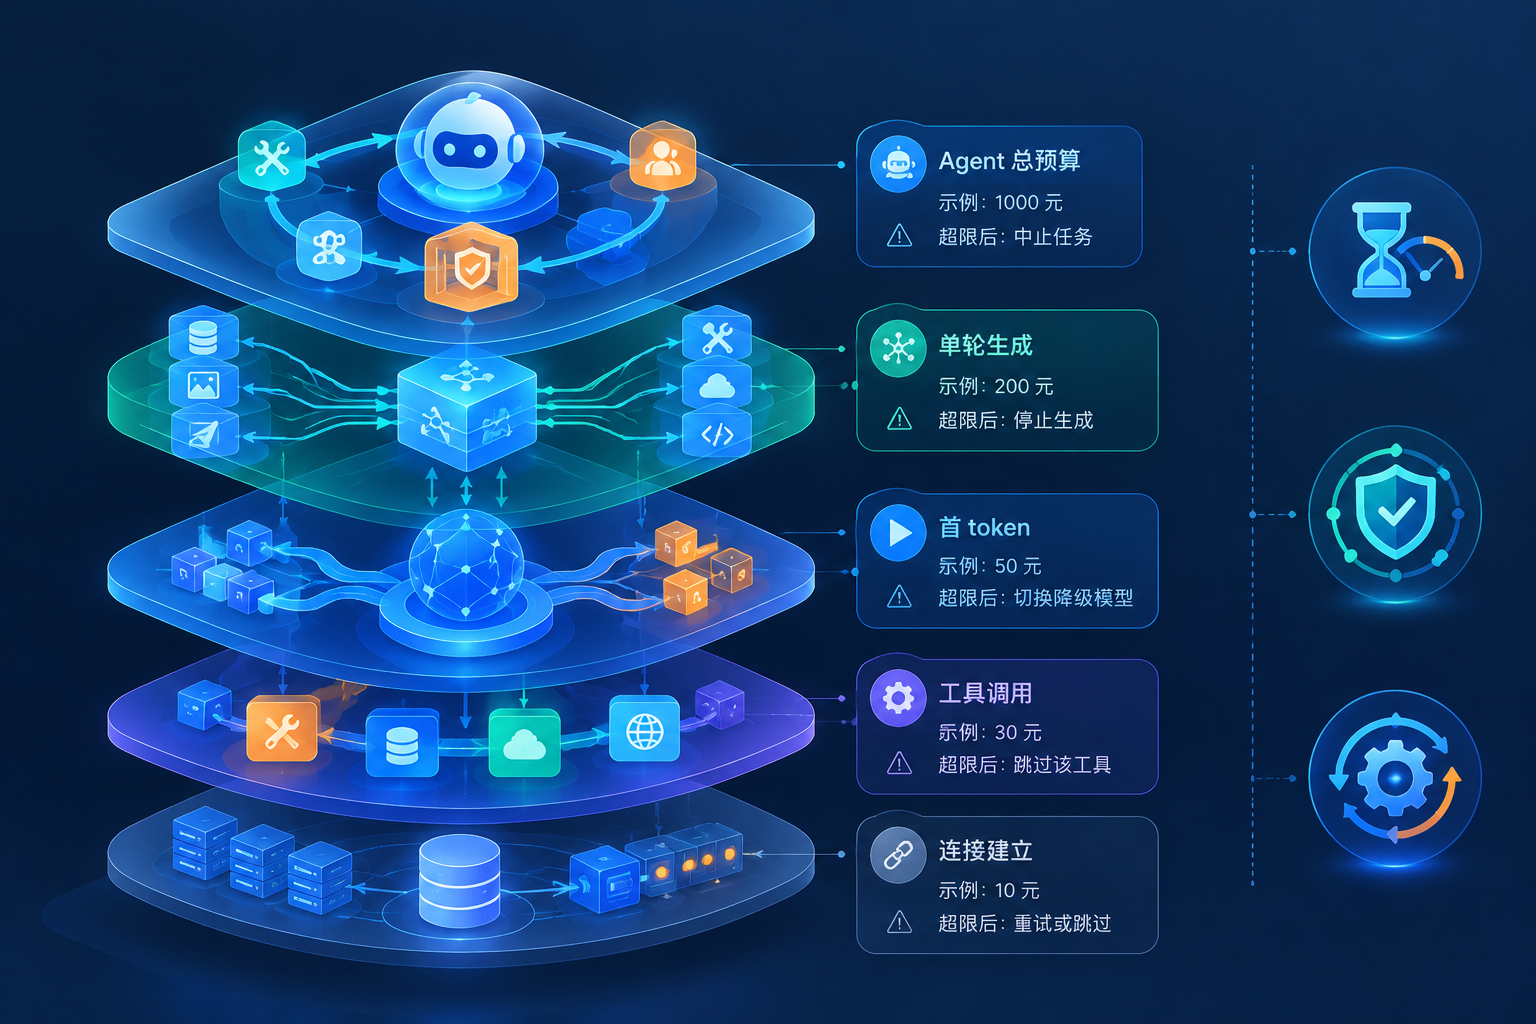
超时必须分层,且总预算要覆盖 Agent 的多轮调用。以下为模板值,不是实测数据:
| 层级 | 示例预算 | 说明 |
|---|---|---|
| 连接超时 | 1--2s | 网络与鉴权建立 |
| 首 token 超时(流式) | 5--10s | 反映模型排队与冷启动 |
| 单轮生成超时 | 20--30s | 非流式调用的读取超时 |
| 单次工具调用超时 | 2--5s | 业务工具自身 SLA |
| Agent 任务总预算 | 60--120s | 含所有轮次,超限强制终止 |
7.2 降级路径设计
降级不是"返回一个更差的答案",而是保住业务语义。推荐分四档:
- 换轻量模型:同一提示词、较小模型,适合摘要、分类、格式化类任务;
- 换缓存或预生成结果:高频重复问题命中缓存,注意缓存键包含模型版本与提示词版本;
- 换规则引擎或固定文案:把确定性逻辑交还给代码,返回可解释的固定结果;
- 显式拒绝并提示:宁可告诉用户当前不可用,也不要静默返回低质量内容。
这条链路的价值在于:有了能力层抽象,"换模型"这一档的成本很低;而"换规则"这一档要求团队提前把确定性分支写好,属于设计期投资。
7.3 限流与容量
限流维度至少包括:租户/用户、端点、模型、token 速率、并发数。并发控制尤其容易被忽略:虚拟线程降低了阻塞调用的线程成本,但不降低模型服务端的并发压力,必须用信号量或限流器约束在途请求数量。
与既有治理组件的结合可以沿用团队熟悉的方案,例如 Resilience4j 或 Sentinel 68;"某方案已成为默认选择"这类说法在素材中属于社区表述,选型时应按团队现状与组件成熟度判断,而不是按流行度。
yaml
resilience4j:
  timelimiter:
    instances:
      llmAssist:
        timeout-duration: 30s
        cancel-running-future: true
  ratelimiter:
    instances:
      llmAssist:
        limit-for-period: 20
        limit-refresh-period: 1s
        timeout-duration: 0
  circuitbreaker:
    instances:
      llmAssist:
        sliding-window-size: 20
        failure-rate-threshold: 50
wait-duration-in-open-state: 30s配置要点:TimeLimiter 管整体预算,RateLimiter 管准入,CircuitBreaker 管快速失败,三者作用在不同维度,不要合并成一个"重试三次"。
7.4 成本核算
没有成本字段,就没有成本治理。每次调用至少记录:
| 字段 | 用途 |
|---|---|
| 模型标识与版本 | 区分单价与能力差异 |
| input/output tokens | 直接成本来源 |
| 是否触发工具调用 | 解释耗时与额外 token |
| 端点、租户、功能标识 | 分摊口径 |
| 性能标记 | 延迟分位、失败类型、是否降级 |
| 预算归属 | 日/月配额与告警阈值 |
最小看板指标:每功能日 token 量、每请求平均成本、P95 延迟、降级率、失败率、缓存命中率。高并发系统的经验表明,异步化、缓存分层与限流是应对突发流量的基础手段 9,LLM 链路复用这套思路,只是把"数据库 CPU"换成了"token 与模型并发"。
八、选型边界:这个场景到底该不该上 LLM
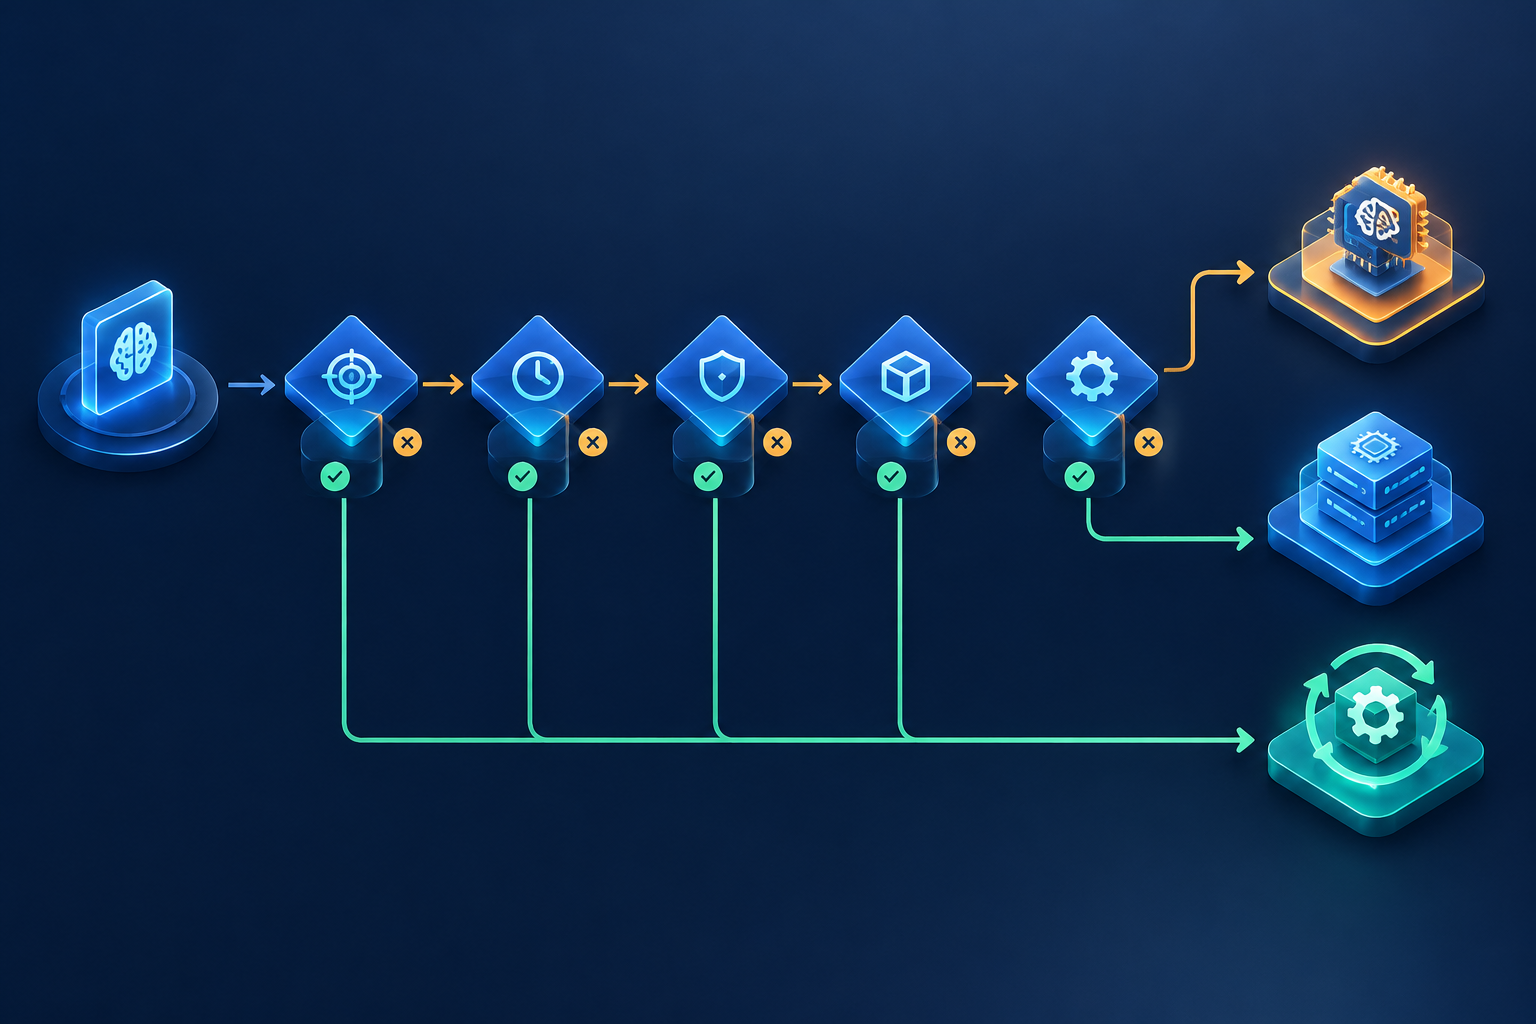
可以用五个维度做判定,任何一维给出强否定信号,就应当回到传统实现或本地推理:
| 维度 | 倾向 LLM | 倾向本地推理 / 规则 |
|---|---|---|
| 输出确定性要求 | 允许措辞变化 | 必须可复现、可审计 |
| 延迟预算 | 秒级可接受 | 毫秒级硬约束 |
| 数据合规 | 可接受出域或有专线 | 严格不出域 |
| 工具可复用性 | 多个宿主、多个模型共享 | 单体内部方法 |
| 团队运维能力 | 有预算、审计、降级实践 | 缺乏治理与告警体系 |
几条反向结论同样重要:
- 确定性规则能解决的问题不上 LLM:校验、计价、权限判断交给代码;
- 工具不复用时不引 MCP,避免为标准化付出部署与版本成本;
- 事务写操作密集的流程不整段交给 Agent,只让 Agent 做决策建议与材料准备;
- 高频固定结构任务走 ONNX 本地推理,LLM 负责语义层;
- 没有成本字段与降级路径之前,不上面向外部用户的生成功能。
案例推演一:客服话术草拟------输出允许措辞变化、延迟秒级、可用缓存与轻量模型降级,适合 LLM。推演二:风控规则判定------结果必须可解释可复现,适合规则引擎,LLM 最多用于解释文案生成。推演三:高频图像分类------输入输出固定、延迟敏感,适合 ONNX 本地推理。以上为设计推演,不是真实项目数据。
九、落地路线图与风险提示
一个已有 Spring Boot 系统,建议分三阶段收编:
| 阶段 | 目标 | 验收标准 | 回滚条件 |
|---|---|---|---|
| 一:治理一条链路 | DeepSeek 接入 + 超时、降级、限流、成本字段 | 有完整监控与成本看板,降级演练通过 | 成本超预算或 P95 超 SLA 即回退到非 AI 路径 |
| 二:工具标准化 | 只读工具接入 MCP,权限分级与审计落地 | 工具调用可审计、可回放、可版本化 | 发现越权调用或审计缺失即关闭工具 |
| 三:有限内嵌 Agent | 只读工具起步,可写工具走人工确认 | 步数与预算可控,状态回读校验通过 | 出现状态不一致或无法归因的失败即降级为辅助模式 |
主要风险清单:
- 版本演进快:Spring AI 与 MCP 生态仍在快速变化,API、坐标与兼容基线需要持续以官方发布说明核验,二手教程只能作为线索 125;
- 成本失控:流式长输出、Agent 多轮调用、重试放大是三大成本来源,必须有硬预算;
- Agent 越权:工具权限分级和人工确认点是底线,不能依赖提示词约束;
- 供应商与模型锁定:能力层抽象降低了切换成本,但提示词、工具 schema、评测集仍然是资产,需要随应用一起版本化;
- 可观测性不足:没有 trace 与回放,Agent 类问题几乎无法定位 6。
最后回到本文的核心判断:Spring AI、MCP 与 Agent 内嵌收编的是接口与协议,收编不了的是工程责任。模型能力越强,越需要用后端工程师熟悉的方式去约束它------超时、降级、限流、成本、权限、审计、幂等。谁先把这些做完,谁才有资格把大模型当成基础设施来运维。
参考资料
1 《2026 后端 AI 集成实战:Spring AI 2.0、MCP 协议与 Agent 内嵌的三条落地路径》,CSDN,https://blog.csdn.net/m0_74899094/article/details/166905088
2 《2026 年 AI 后端开发终极指南:Spring AI 2.0 vs LangChain vs NestJS,生产级项目到底怎么选?》,CSDN,https://blog.csdn.net/weixin_44705473/article/details/163311682
3 《从云原生到 AI 原生:2026 后端架构"三驾马车"(事件驱动、虚拟线程、AI Agent 内嵌)演进解析》,CSDN,https://blog.csdn.net/m0_74899094/article/details/167081020
4 《【2026 最新】Spring Boot 3.x 集成 DeepSeek 大模型:构建智能 REST API 助手》,CSDN,https://blog.csdn.net/m0_62292232/article/details/161205290
5 《Java AI 工程化:PyTorch On Java + SpringBoot 微服务部署(2025-2026 最新实战)》,CSDN,https://blog.csdn.net/HHX_01/article/details/159805388
6 《2026 年 Java 微服务架构终极指南:从 Spring Boot 3 到云原生,百万并发下的服务治理与性能调优》,CSDN,https://blog.csdn.net/ZDQ58818/article/details/162374195
7 《微软技术日报 2026-10-06:智能体报完工数据库不认账,26H2 管理模板与 Excel Canvas 落地》,CSDN,https://blog.csdn.net/qq_39427511/article/details/167163264
8 《SpringBoot3 + Nacos + Sentinel 微服务完整实战(Java17/21 适配)》,掘金,https://juejin.cn/post/7655245911812620334
9 《论高并发系统的设计与性能优化实践(软考系统架构师论文 2026-5)》,掘金,https://juejin.cn/post/7692882780166963243
10 《Spring Cloud Alibaba 2026 实战------微服务架构搭建与高可用优化全指南》,CSDN,https://blog.csdn.net/weixin_44096133/article/details/160836796
11 《2026 年第 40 周 GitHub 趋势周报:AI 热度降温,本地优先与自托管工具领跑》,CSDN,https://blog.csdn.net/weixin_31822733/article/details/167424291
12 《多模数据库深度解读:从"多库拼装"到"一库多能"的架构演进》,掘金,https://juejin.cn/post/7677410227797229622
13 RuoYi-Cloud:基于 Spring Boot、Spring Cloud & Alibaba 的分布式微服务架构权限管理系统,Gitee,https://gitee.com/GiteeOS/RuoYi-Cloud
14 backend-benchmark:后端技术读写与静态端点性能对比,GitHub,https://github.com/abdelaziz-mahdy/backend-benchmark
注:文中涉及 Spring AI、MCP、DeepSeek API、ONNX Runtime Java 的官方 API 签名、版本基线与接口地址,本次采集素材未提供官方文档链接,需在实施前自行查阅对应官方文档核验;本文所有超时、成本相关数值均为配置模板值,非实测数据。