遇到算子约束怎么办?一套从"报错"到"可验证方案"的排查方法
模型部署到 BPU 时,最常见的问题之一是:PyTorch 里能正常运行的算子,在量化、导出或编译阶段却报错。
这并不一定意味着模型无法部署。很多情况下,问题出在算子的输入维度、数据类型、参数范围或输入输出组合不满足 BPU 约束。正确的处理方式不是立刻大改网络,而是先把"算子约束"翻译成明确的问题,再选择合适的改法。
先看约束,再看报错
遇到报错时,建议先记录四类信息:
- 报错算子名称,例如 interpolate、grid_sample、reshape、softmax
- 实际输入 shape、dtype 和关键参数
- 当前阶段:QAT prepare、导出、转换还是 HBM 编译
- 目标平台和工具链版本
官方约束表通常会给出以下信息:
- 支持哪些数据类型
- 支持哪些输入布局和维度
- 参数范围,例如 kernel、stride、axis、scale
- 是否有量化方式限制
- 是否存在 Eager 模式下的替代算子
因此,"算子支持"不等于"任意输入都支持"。同一个算子在不同输入 shape、dtype、模式下,结论可能不同。
一个典型现象:算子本身可用,但当前调用方式不满足约束
以插值为例。
某个模型需要把特征从:
csharp
[1, 256, 5, 26, 26]放大到:
csharp
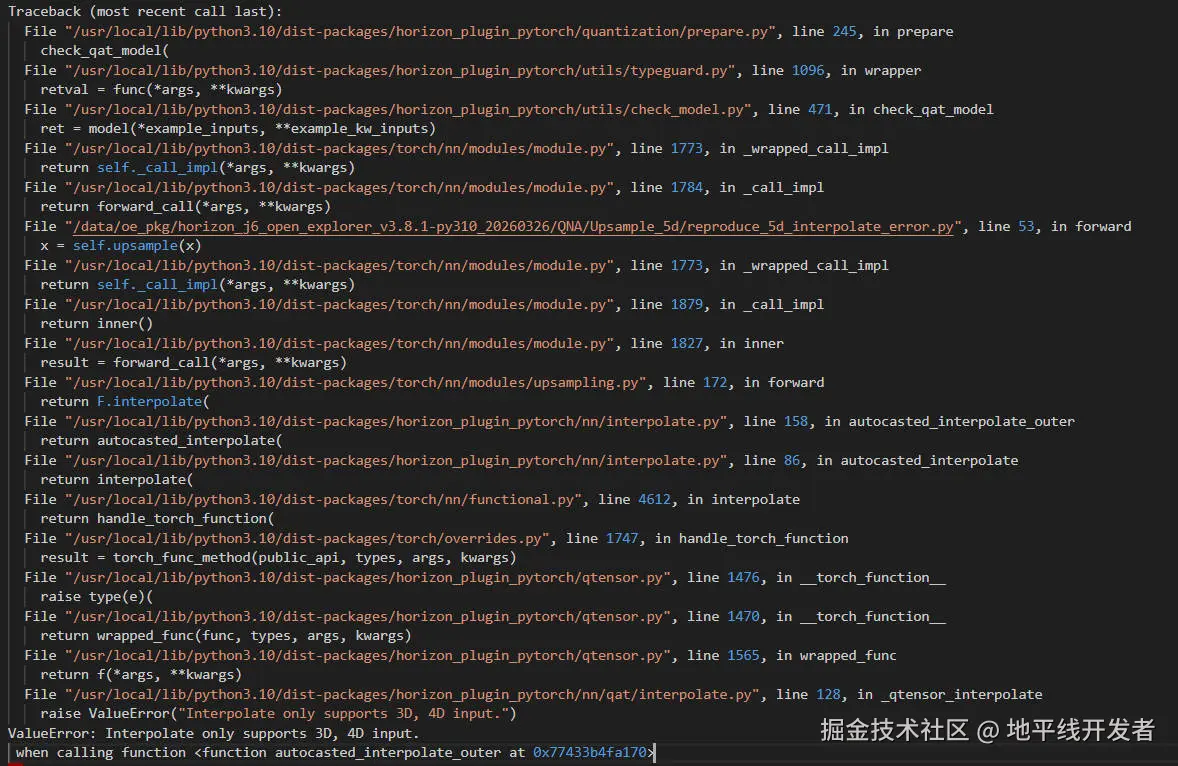
[1, 256, 10, 52, 52]浮点 PyTorch 中,5D 输入可以使用 trilinear 插值完成目标。但在 QAT prepare 阶段,量化插值算子只接受 3D 或 4D 输入,5D 输入会触发报错:
lua
ValueError: Interpolate only supports 3D, 4D input.这个问题的重点不是"插值算子完全不支持",而是:
当前模型把三维空间插值一次性交给了只支持二维输入的量化算子。"5D 特征N,C,D,H,W" -->"一次 trilinear 插值"-->"QAT 插值算子"-->"5D 输入不满足约束prepare 报错"
处理算子约束的四种思路
不是所有算子约束都适合同一种改法。通常可以从下面四个方向选择。
1. 使用工具链提供的等价算子
有些 PyTorch 函数形式的算子,在量化流程中需要替换为模块形式,或替换为 horizon_plugin_pytorch.nn 中对应的算子。
这类问题的关键不是"换一个名字",而是确认替换后的算子是否满足:
- 当前工具链版本支持
- 当前目标平台支持
- 当前输入 dtype 和 shape 满足约束
- QAT、导出和编译阶段都能识别
2. 将一个大操作拆成多个受支持的小操作
当原始操作的目标可以拆开实现时,可以把不满足约束的计算转换为若干个受支持的步骤。
上面的 5D 插值案例采用的就是这种思路:
css
原始目标:
[N,C,D,H,W] → [N,C,2D,2H,2W]

拆分后:
先完成 H/W 方向的 2D 插值
再完成 D 方向的 2D 插值
中间通过维度变换把每次插值的输入保持为 4D"N,C,D,H,W" --> "调整维度得到 4D 输入"-->"2D 插值放大 H/W"-->"调整维度得到另一组 4D 输入"-->"2D 插值放大 D"-->"N,C,2D,2H,2W"
这类改法的核心原则是:
先确认原始计算能否分解,再确认分解后的每一步都满足 BPU 约束。
不能因为 reshape 可以消除报错,就直接认为方案正确。必须确认拆分后的数学含义与原始操作一致。
3. 调整网络表达方式
有些问题并非只能通过拆分解决,也可以改用等价的网络表达方式。例如:
- 用模块形式替代函数形式
- 用支持的 pooling、卷积或查表算子替代原始表达
- 调整输入布局或维度组织方式
- 将不必要的动态逻辑改为静态逻辑
这一类改动需要特别注意:不要只看代码能否运行,还要确认训练、量化和部署的语义保持一致。
4. 将不适合 BPU 的部分放到部署边界之外
并非所有计算都必须放进 BPU 子图。
如果某段逻辑属于后处理、结果格式整理、可视化或业务规则,并且不影响主干网络部署,可以考虑将该逻辑放在模型部署边界之外执行。
但这不是"遇到问题就放 CPU"的通用答案。需要评估:
- 该操作是否允许放在模型外
- 是否影响端到端时延
- 是否增加数据搬运开销
- 是否影响最终接口和部署架构
修改后,至少完成三层验证
完成改动后,不要只以"不报错"作为结论。建议按以下顺序验证。
| 验证层级 | 需要确认的内容 |
|---|---|
| 浮点验证 | 输出 shape 是否正确;与原始实现的误差是否在可接受范围内 |
| QAT 验证 | prepare 是否通过;模型检查是否存在 qconfig 或算子异常 |
| 部署验证 | 导出、转换、HBM 编译是否成功;是否存在 CPU 算子;板端精度和性能是否满足要求 |
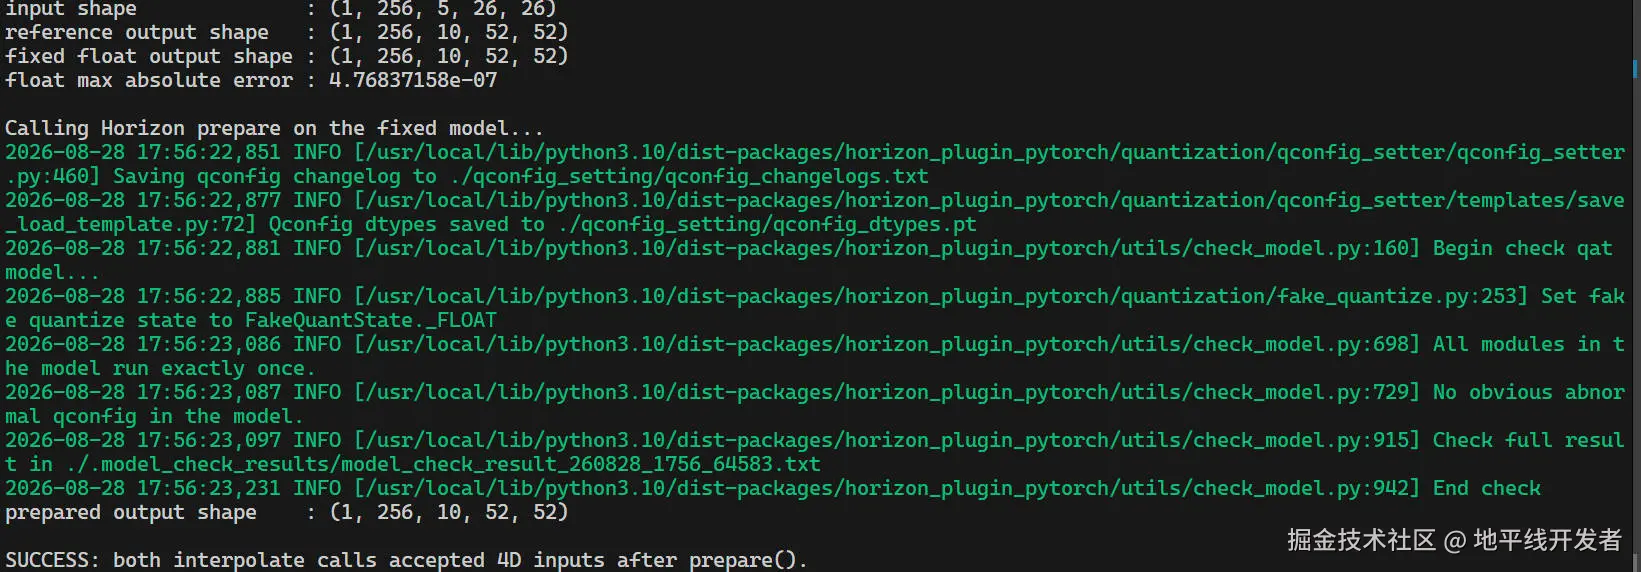
在前述插值案例中,首先验证了输出 shape:
css
[1,256,5,26,26] → [1,256,10,52,52]随后对比了拆分实现与原始 trilinear 的浮点输出,最大绝对误差为:
4.76837158e-07最后,QAT prepare 通过,模型检查结果显示所有模块正常执行,且没有明显 qconfig 异常。
不要忽略版本和平台差异
算子支持和约束与以下条件直接相关:
- OpenExplorer 版本
- 目标芯片平台,例如 J6P/H、J6E/M、J6B
- PTQ 或 QAT 流程
- 输入 dtype 和量化配置
- 算子参数及输入 shape
因此,排查时应始终使用与实际部署环境一致的约束文档。文章中的插值案例只说明了一种"通过等价拆分规避输入维度约束"的思路,不代表所有受限算子都适合使用相同方法。
总结
遇到算子约束时,可以按下面的顺序处理:
定位报错算子
→ 查询对应平台、对应版本的约束文档
→ 明确不满足的是维度、dtype、参数还是量化组合
→ 选择替代、拆分、重构或边界外执行
→ 先做最小浮点验证
→ 再完成 QAT、导出、编译和板端验证
算子约束不是简单的"支持"或"不支持"。真正需要解决的问题是:如何在不改变目标功能的前提下,把模型表达成目标平台能够正确执行的形式。
J6P/H 的 Torch 算子约束可以从官方文档查询:J6P/H Torch 算子 BPU 约束列表。