一、排序的概念及运用
1.1 概念
所谓排序,就是一串记录,按照其中的某个或某些关键字的大小,递增或递减的排列起来的操作。
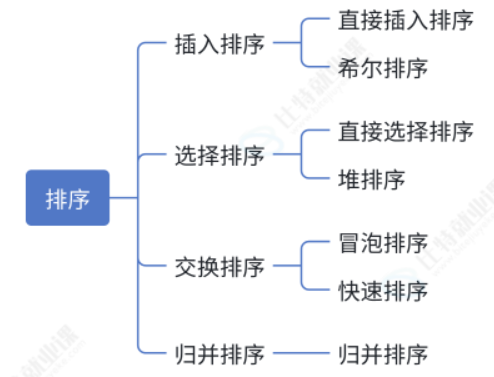
1.2 常见的排序算法
二、常见的排序算法的实现
int a[]={5,6,8,1,9,7,2,3,4}2.1 插入排序
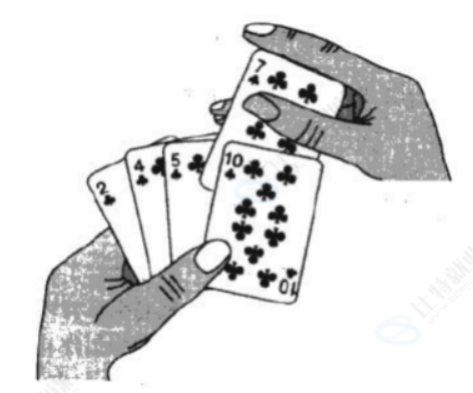
直接插入排序是⼀种简单的插⼊排序法,其基本思想是:把待排序的记录按其关键码值的大小逐个插入到⼀个已经排好序的有序序列中,直到所有的记录插⼊完为⽌,得到⼀个新的有序序列 。
2.1.1 直接插入排序
当插入第i(i>=1)个元素时,前面的arr0,arr1,...,arri-1已经排好序,此时用arri的排序码与arri-1,arri-2,...的排序码顺序进行比较,找到插入位置,将arri插入,原来位置上的元素顺序后移。
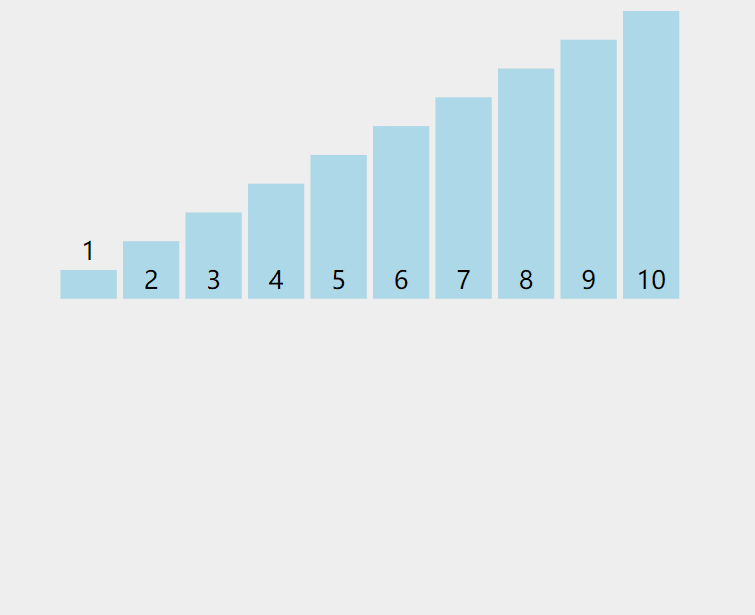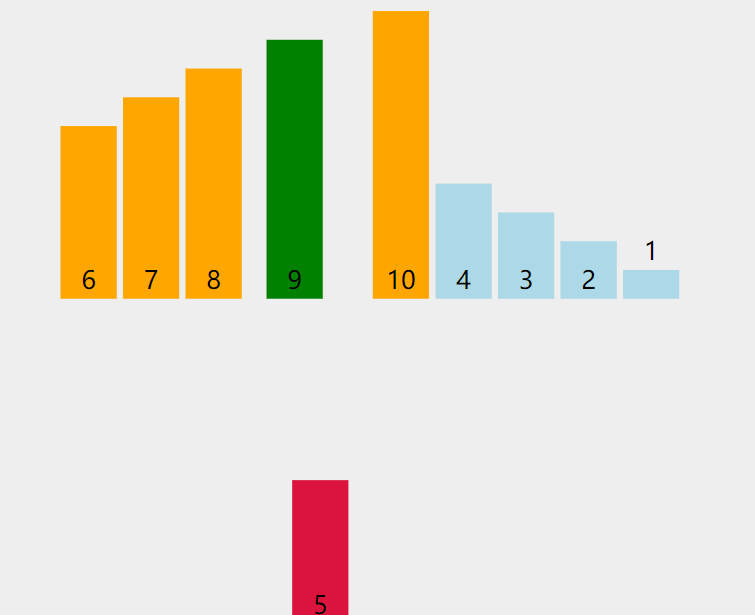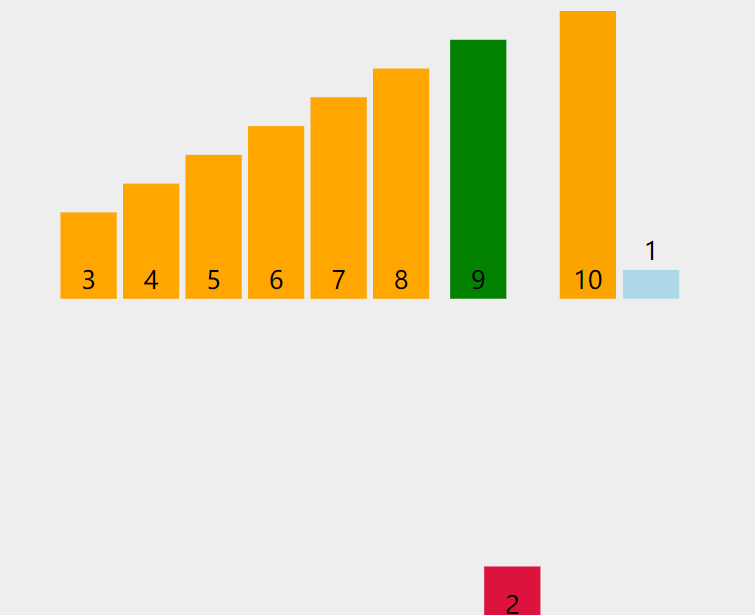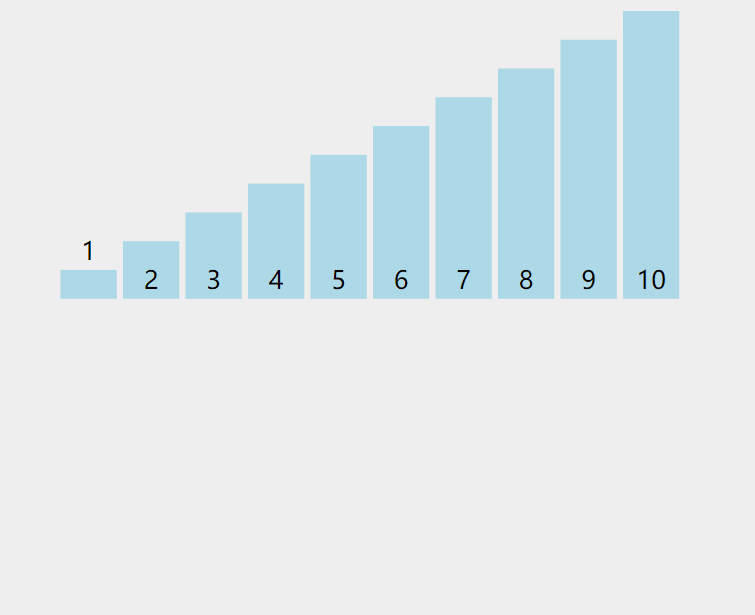
//直接插入排序
void InsertSort(int* arr, int n)
{
	for (int i = 0; i < n-1; i++)
	{
		int end = i;
		int tmp = arr[end + 1];
		while (end>=0)
		{
			if (arr[end] > tmp)
			{
				arr[end + 1] = arr[end];
				end--;
			}
			else
			{
				break;
			}
		}
		arr[end + 1] = tmp;
	}
}

元素集合越接近有序,直接插入排序算法的时间效率越高
时间复杂度:O (N^2)
空间复杂度:O (1)
2.1.2 希尔排序
希尔排序法又称缩小增量法。希尔排序法的基本思想是:先选定一个整数(通常是gap =n/3+1),把待排序文件所有记录分成各组,所有的距离相等的记录分在同一组内,并对每一组内的记录进行排序,然后gap=gap/3+1得到下一个整数,再将数组分成各组,进行插入排序,当gap=1时,就相当于直接插入排序。它是在直接插入排序算法的基础上进行改进而来的,综合来说它的效率肯定是要高于直接插入排序算法的。
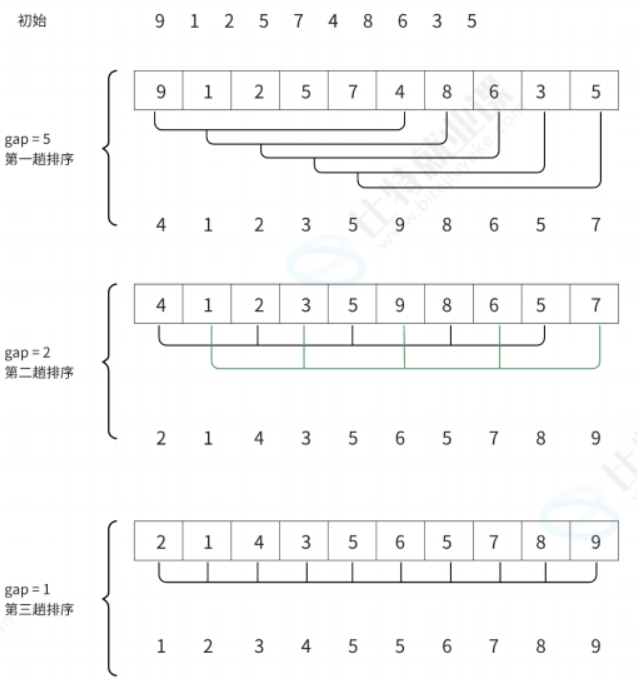
//希尔排序
void ShellSort(int* arr, int n)
{
	int gap = n;
	while (gap > 1)
	{
		gap = gap / 3 + 1;
		for (int i = 0; i < n - gap; i++)
		{
			int end = i;
			int tmp = arr[end + gap];
			while (end >= 0)
			{
				if (arr[end] > tmp)
				{
					arr[end + gap] = arr[end];
					end-=gap;
				}
				else
				{
					break;
				}
			}
			arr[end + gap] = tmp;
		}
	}
}

希尔排序是对直接插⼊排序的优化。
当 gap > 1 时都是预排序,⽬的是让数组更接近于有序。当 gap == 1 时,数组已经接近有序
的了,这样就会很快。这样整体⽽⾔,可以达到优化的效果。
2.1.2.1希尔排序时间复杂度
希尔排序的时间复杂度估算:
外层循环:
外层循环的时间复杂度可以直接给出为:O(log2 n)或者O(log3 n),即O(log n)
内层循环:
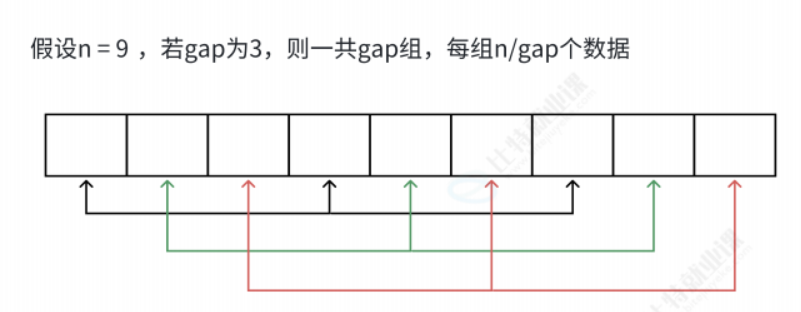
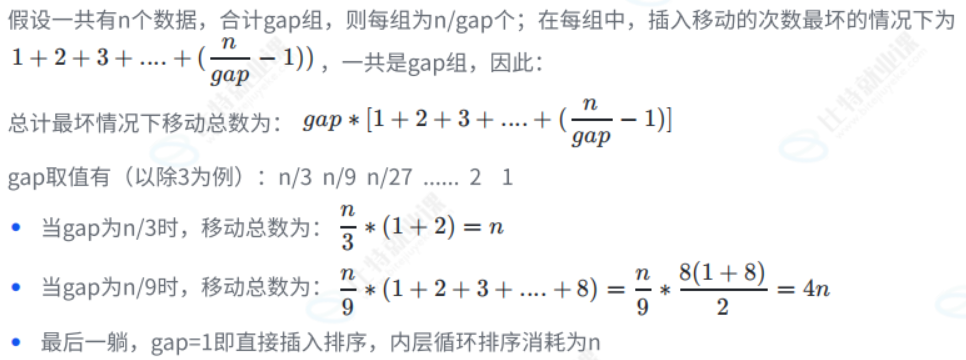
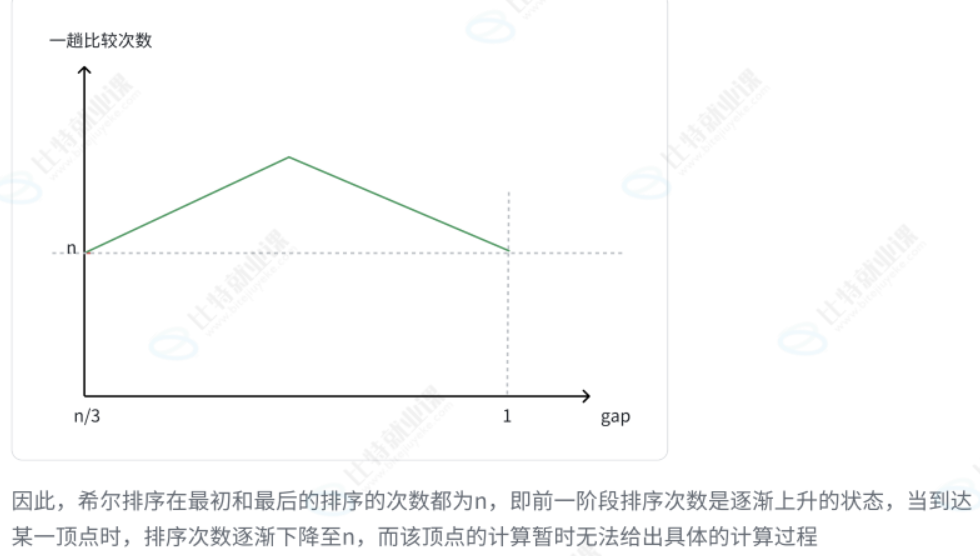
希尔排序时间复杂度不好计算,因为gap的取值很多,导致很难去计算。因此很多书中给出的希尔排序的时间复杂度都不固定。
2.2 选择排序
每一次从待排序的数据元素中选出最小(或最大)的一个元素,存放在序列的起始位置,直到全部待排序的数据元素排完。
2.2.1 直接选择排序
1.在元素集合arri--arr n-1中选择关键码最大(小)的数据元素
2.若它不是这组元素中的最后一个(第一个)元素,则将它与这组元素中的最后一个(第一个)元素交换
3.在剩余的arr i--arr n-2(arr i+1--arr n-1)集合中,重复上述步骤,直到集合剩余1 个元素
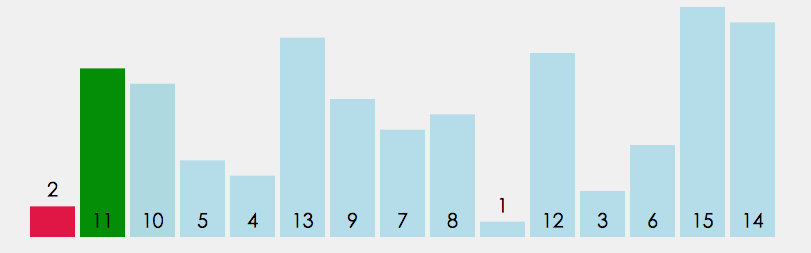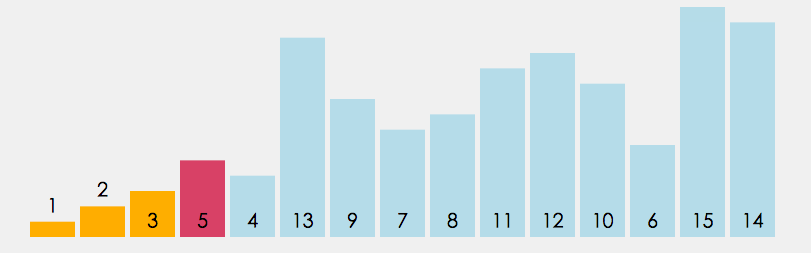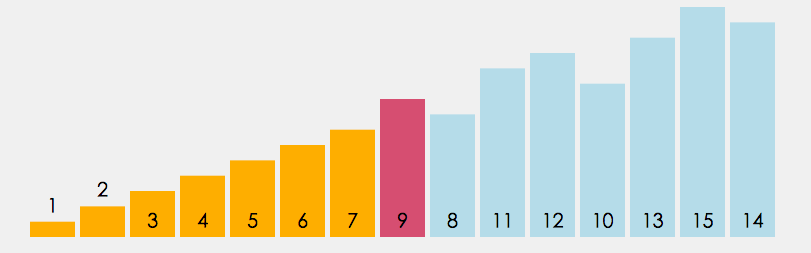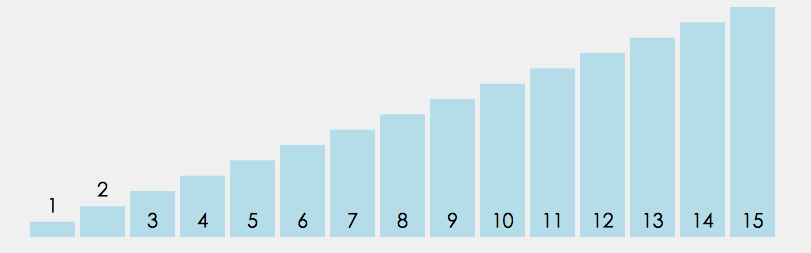
Swap(int* x, int* y)
{
	int tmp = *x;
	*x = *y;
	*y = tmp;
}

//直接选择排序
void SelectSort(int* arr, int n)
{
	int begin = 0;
	int end = n - 1;
	while (begin<end)
	{
		int maxi = begin;
		int mini = begin;
		for (int i = begin + 1; i <= end; i++)
		{
			if (arr[i] < arr[mini])
			{
				mini = i;
			}
			if (arr[i] > arr[maxi])
			{
				maxi = i;
			}
		}
		if (maxi == begin)
		{
			maxi = mini;
		}
		Swap(&arr[mini], &arr[begin]);
		Swap(&arr[maxi], &arr[end]);
		begin++;
		end--;
	}
}

直接选择排序思考非常好理解,但是效率不是很好。实际中很少使用
时间复杂度:O (N^2)
空间复杂度:O (1)
2.2.2 堆排序
二叉树章节已经实现。
2.3交换排序
所谓交换,就是根据序列中两个记录键值的比较结果来对换这两个记录在序列中的位置
交换排序的特点是,将键值较大的记录向序列的尾部移动,键值较小的记录向序列的前部移动。
2.3.1 冒泡排序
冒泡排序是一种最基础的交换排序。之所以叫做冒泡排序,因为每一个元素都可以像小气泡一样,根据自身大小一点一点向数组的一侧移动。
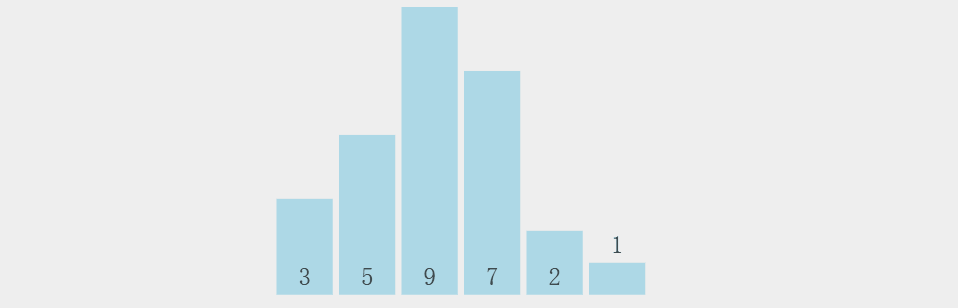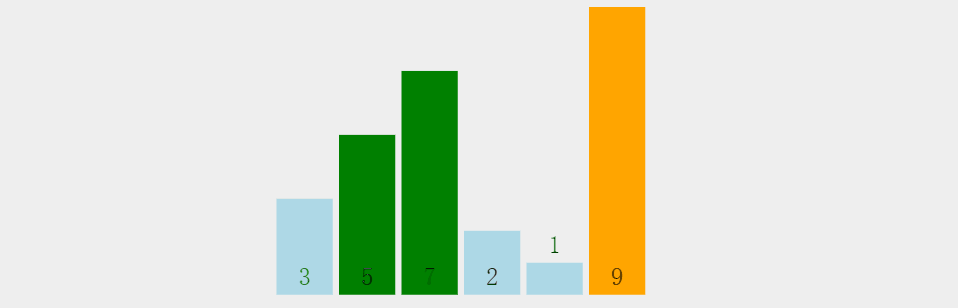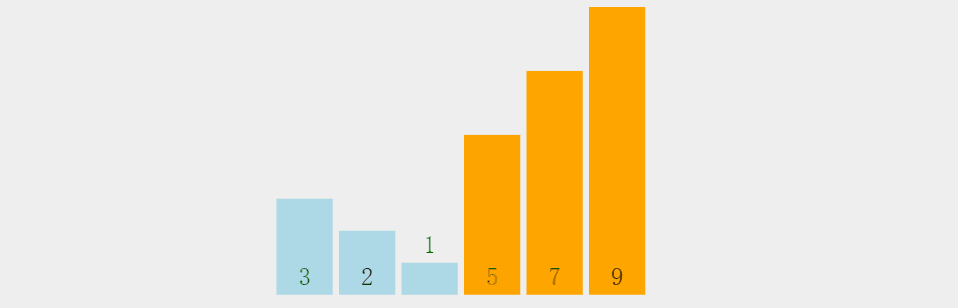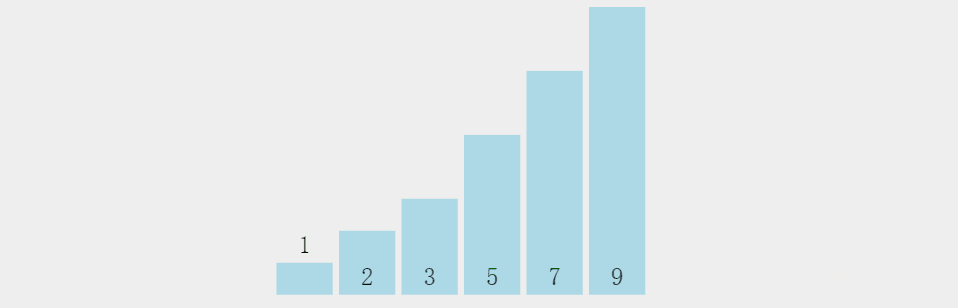
void BubbleSort(int* a, int n)
{
	int exchange = 0;
	for (int i = 0; i < n; i++)
	{
		for (int j = 0; j < n - i - 1; j++)
		{
			if (a[j] > a[j + 1])
			{
				exchange = 1;
				swap(&a[j], &a[j + 1]);
			}
		}
		if (exchange == 0)
		{
			break;
		}
	}
}

时间复杂度:O (N^2)
空间复杂度:O (1)
2.3.2 快速排序
快速排序是Hoare于1962年提出的一种二叉树结构的交换排序方法,其基本思想为:任取待排序元素序列中的某元素作为基准值,按照该排序码将待排序集合分割成两子序列,左子序列中所有元素均小于基准值,右子序列中所有元素均大于基准值,然后最左右子序列重复该过程,直到所有元素都排列在相应位置上为止。
void QuickSort(int* arr, int left, int right)
{
	if (left >= right)
	{
		return;
	}
	//找基准值
	int keyi = _QuickSort(arr,left,right);
	//left keyi right
	// 左序列[left, keyi-1] 右序列[keyi+1,right]
	QuickSort(arr, left, keyi - 1);
	QuickSort(arr, keyi + 1, right);
}
2.3.2.1 hoare版本
right:从右往左走,找比基准值小的数据
left:从左往右走,找比基准值大的数据
当left<=right,找到之后,让left和right交换
当left>right,key和right数据交换
//hoare版本找基准值
int _QuickSort(int* arr, int left, int right)
{
	int keyi = left;
	++left;
	while (left <= right)
	{
		//right:从右往左走,找比基准值小的
		while (left <= right && arr[right] > arr[keyi])
		{
			right--;
		}
		//left:从左往右走,找比基准值大的
		while (left <= right && arr[left] < arr[keyi])
		{
			left++;
		}
		if (left <= right)
		{
			Swap(&arr[left++], &arr[right--]);
		}
	}
	Swap(&arr[keyi], &arr[right]);
	return right;
}
2.3.2.2 挖坑法
创建左右指针。首先从右向左找出比基准小的数据,找到后立即放入左边坑中,当前位置变为新的"坑",然后从左向右找出比基准大的数据,找到后立即放入右边坑中,当前位置变为新的"坑",结束循环后将最开始存储的分界值放入当前的"坑"中,返回当前"坑"下标(即分界值下标) 。
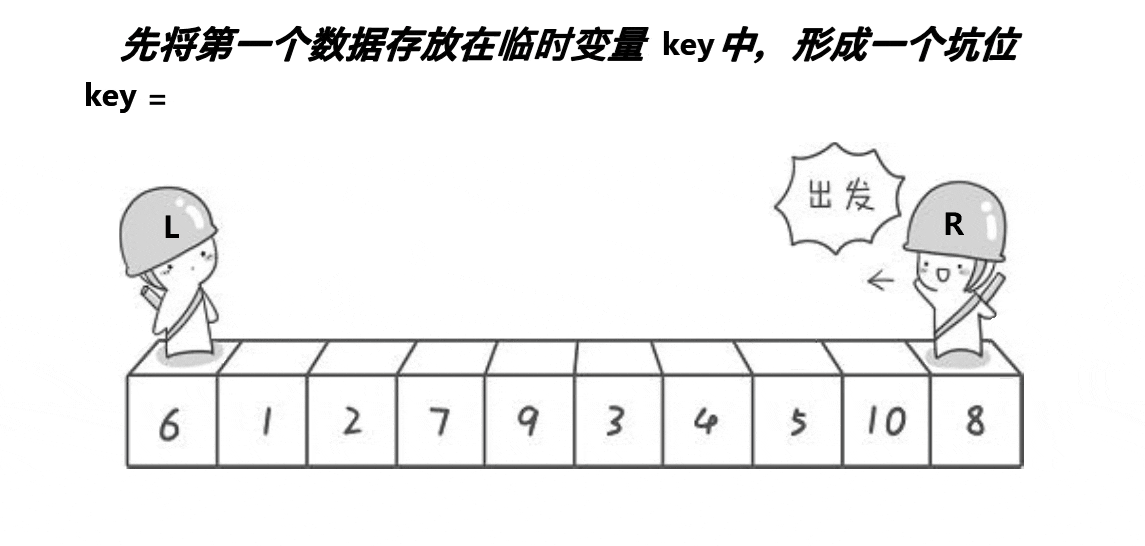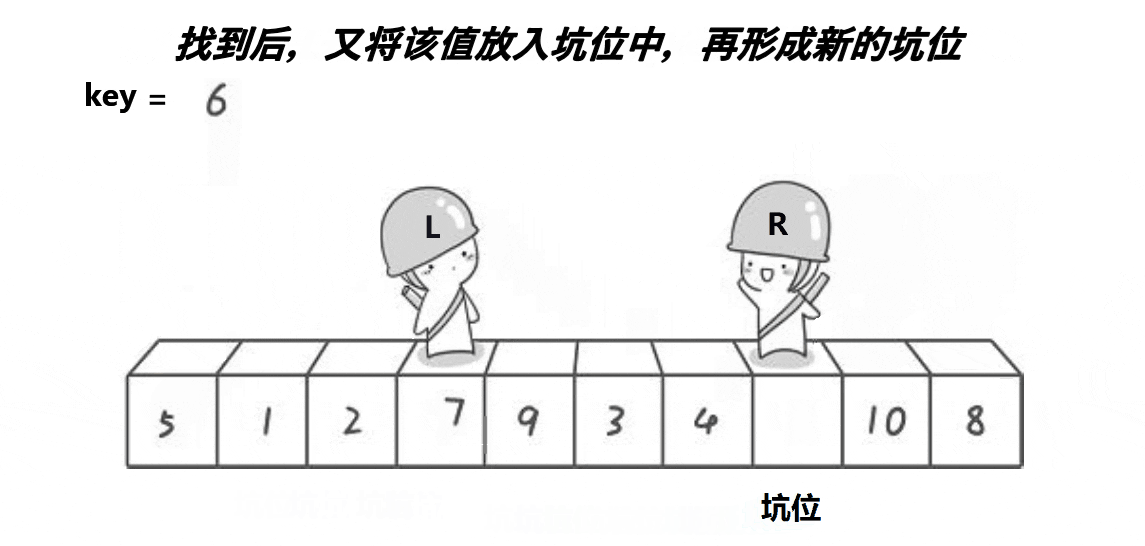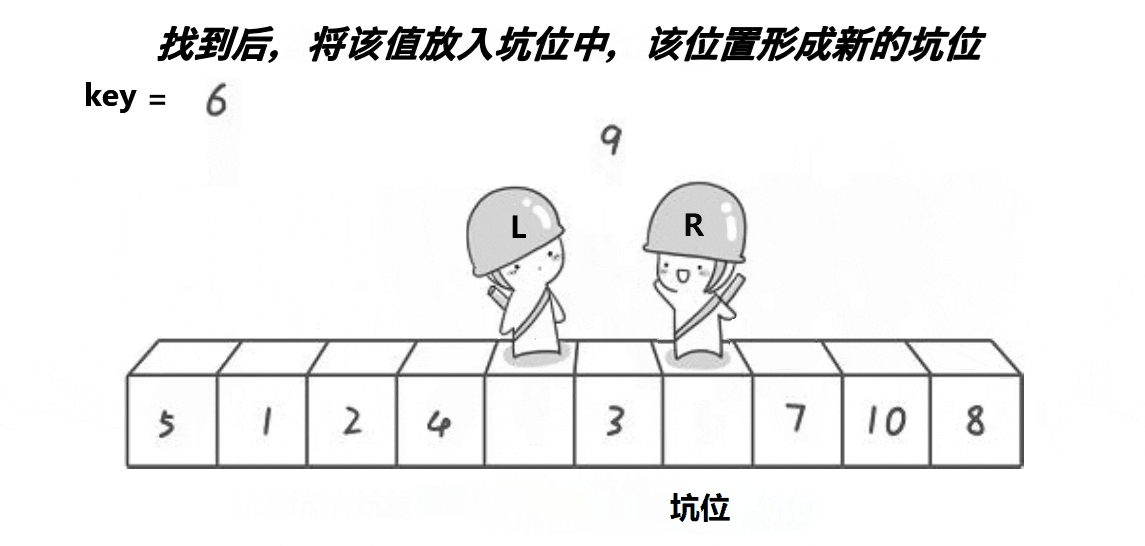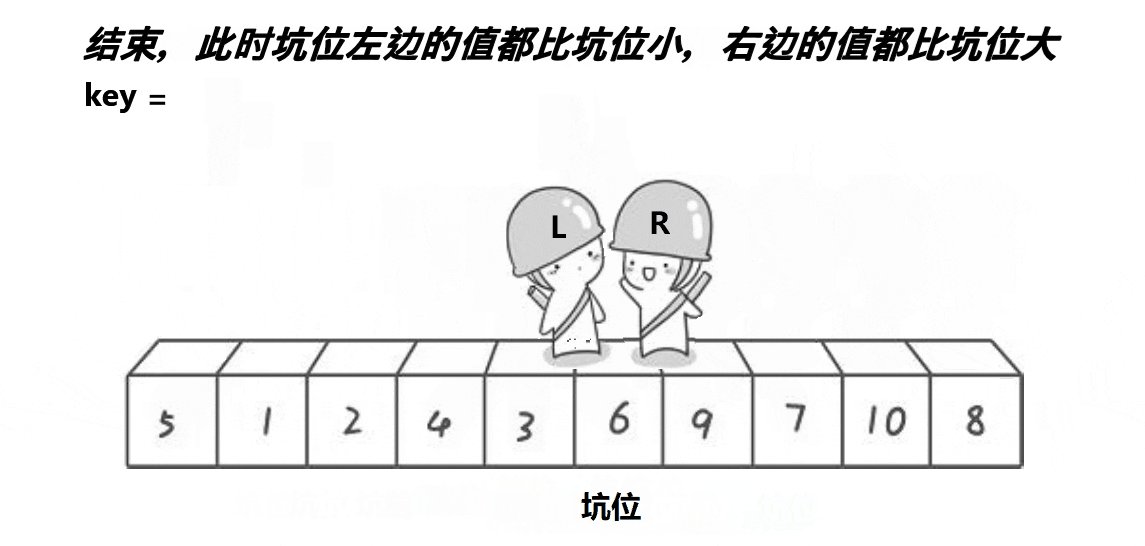
//挖坑法
int _QuickSort(int* a, int left, int right)
{
	int hole = left;
	int key = a[hole];
	while (left < right)
	{
		while (left < right && a[right] > key)
		{
			--right;
		}
		a[hole] = a[right];
		hole = right;
		while (left < right && a[left] < key)
		{
			++left;
		}
		a[hole] = a[left];
		hole = left;
	}
	a[hole] = key;
	return hole;
}
还是不能处理重复的数据,会死循环,内层循环改成=号,不会死循环,但是快排递归次数可能会变成n^2。挖坑法用到的情形很少。
2.3.2.3 lomuto前后指针
创建前后指针,从左往右找基准值小的进行交换,使得小的都排在基准值的左边。
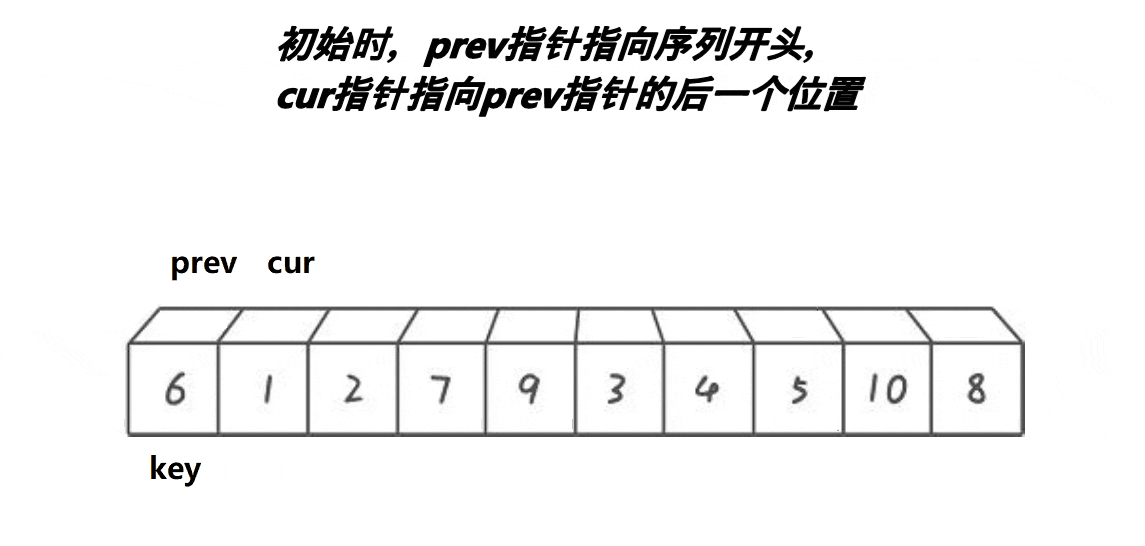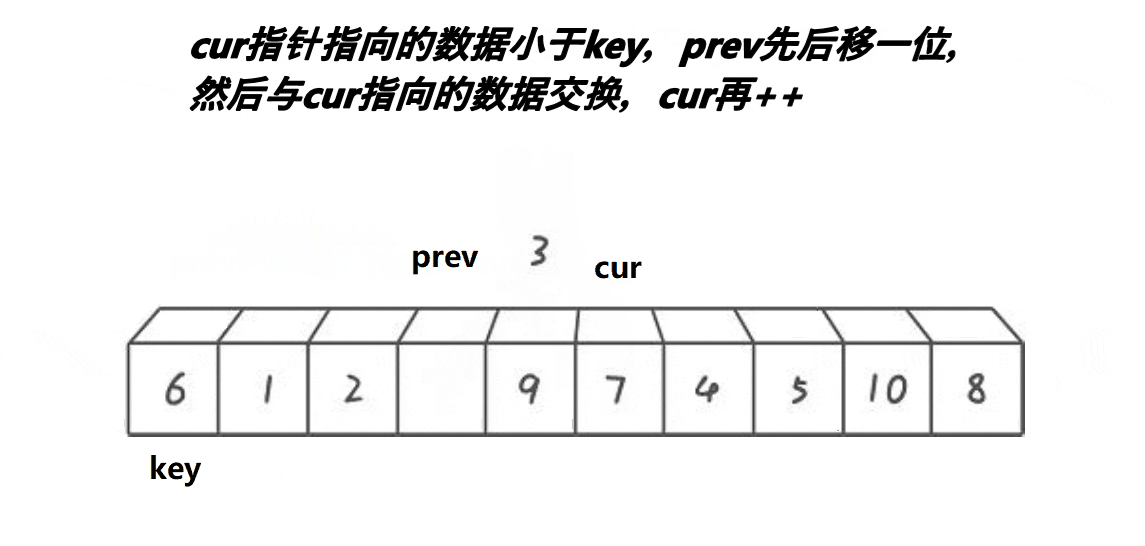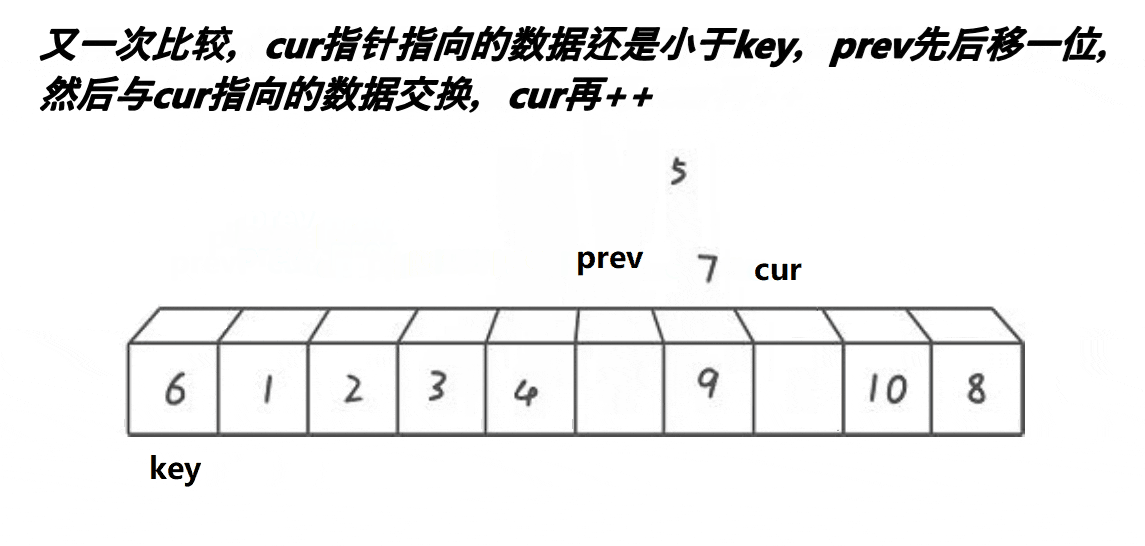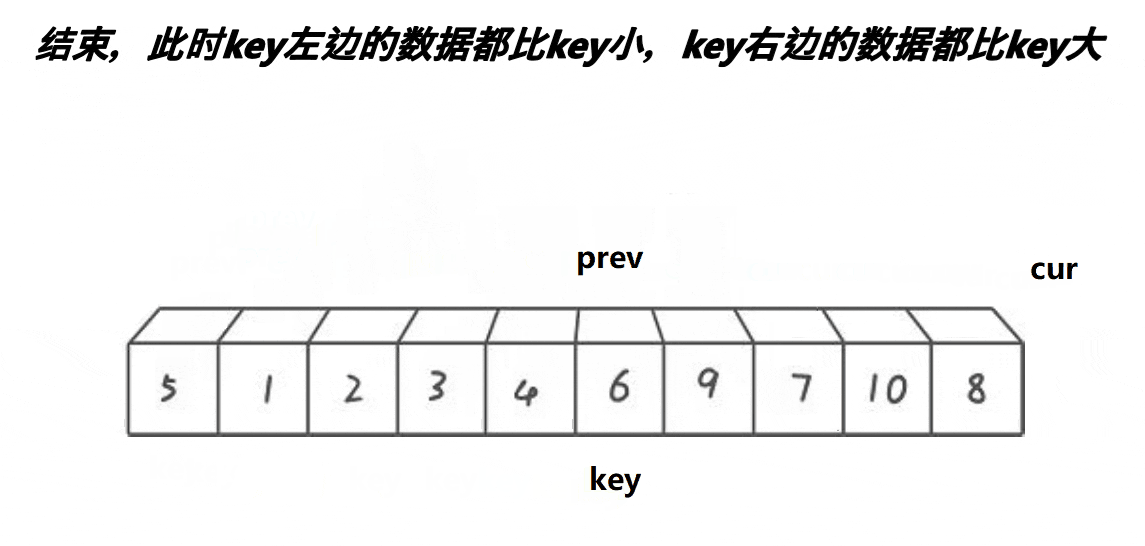
//lomuto前后指针
int _QuickSort(int* a, int left, int right)
{
	int prev = left, cur = left + 1;
	int key = left;
	while (cur <= right)
	{
		if (a[cur] < a[key] && ++prev != cur)
		{
			swap(&a[cur], &a[prev]);
		}
		++cur;
	}
	swap(&a[key], &a[prev]);
	return prev;
}

时间复杂度:O (nlogn)
空间复杂度:O (logn)
2.3.2.4 非递归版本
非递归版本的快速排序需要借助数据结构:栈
//快速排序非递归
void QuickSortNonR(int* a, int left, int right)
{
	ST st;
	STInit(&st);
	STPush(&st, right);
	STPush(&st, left);

	while(!STEmpty(&st))
	{
		int begin = STTop(&st);
		STPop(&st);

		int end = STTop(&st);
		STPop(&st);

		// 单趟
		int keyi = begin;
		int prev = begin;
		int cur = begin + 1;

		while(cur <= end)
		{
			if(a[cur] < a[keyi] && ++prev != cur)
				swap(&a[prev], &a[cur]);
			    ++cur;
		}

		Swap(&a[keyi], &a[prev]);
		keyi = prev;

		// [begin, keyi-1] keyi [keyi+1, end]
		while(keyi + 1 < end)
		{
			STPush(&st, end);
			STPush(&st, keyi + 1);
		}

		while(begin < keyi - 1)
		{
			STPush(&st, keyi - 1);
			STPush(&st, begin);
		}
	}
	STDestroy(&st);
}
2.4 归并排序
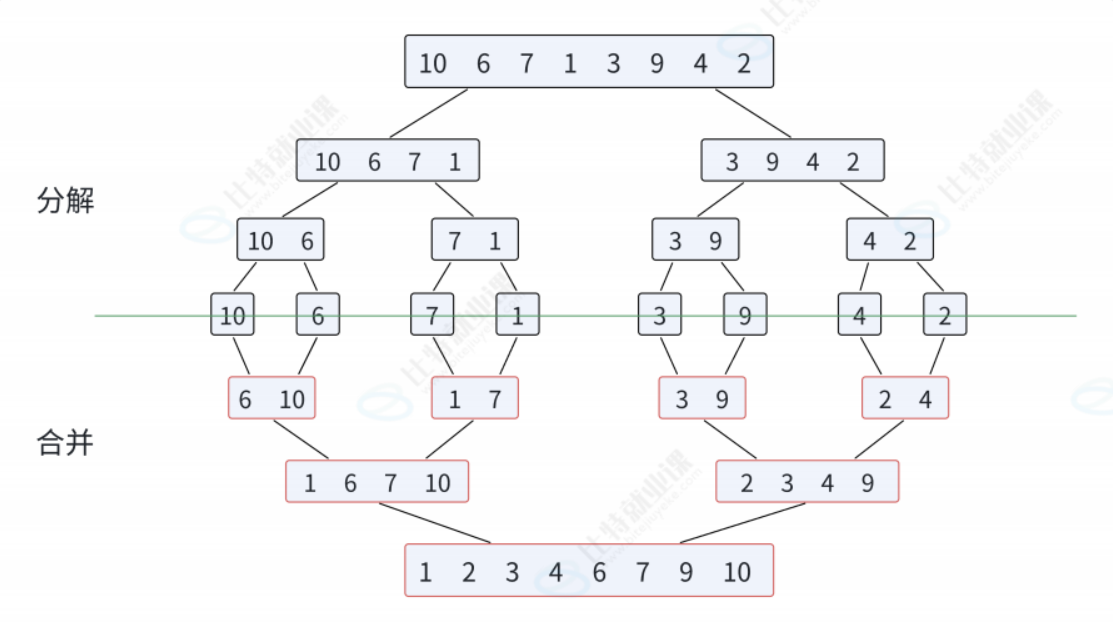
归并排序(MERGE-SORT)是建立在归并操作上的一种有效的排序算法,该算法是采用分治法(Divide and Conquer)的一个非常典型的应用。将已有序的子序列合并,得到完全有序的序列;即先使每个子序列有序,再使子序列段间有序。若将两个有序表合并成一个有序表,称为二路归并。
//归并排序
void MergeSort(int* arr, int n)
{
	int* tmp = (int*)malloc(sizeof(int) * n);
	_MergeSort(arr, 0, n - 1, tmp);
	free(tmp);
	tmp = NULL;

}

void _MergeSort(int* arr, int left, int right,int* tmp)
{
	if (left >= right)
	{
		return;
	}
	int mid = (left + right) / 2;
	//根据mid划分左右两个序列:[left,mid] [mid+1,right]
	_MergeSort(arr, left, mid,tmp);
	_MergeSort(arr, mid+1, right,tmp);

	//合并两个有序的序列
	int begin1 = left, end1 = mid;
	int begin2 = mid + 1,end2 = right;
	int index = begin1;

	while (begin1 <= end1 && begin2 <= end2)
	{
		if (arr[begin1] <= arr[begin2])
		{
			tmp[index++] = arr[begin1++];
		}
		else
		{
			tmp[index++] = arr[begin2++];
		}
	}
	while (begin1 <= end1)
	{
		tmp[index++] = arr[begin1++];
	}
	while (begin2 <= end2)
	{
		tmp[index++] = arr[begin2++];
	}
	//tmp中有序的数据导入原数组中
	for (int i = left; i <= right; i++)
	{
		arr[i] = tmp[i];
	}
}

时间复杂度:O (nlogn)
空间复杂度:O (n)
2.5 测试代码:排序性能对比
void TestOP()
{
	srand(time(0));
	const int N = 100000;
	int* a1 = (int*)malloc(sizeof(int) * N);
	int* a2 = (int*)malloc(sizeof(int) * N);
	int* a3 = (int*)malloc(sizeof(int) * N);
	int* a4 = (int*)malloc(sizeof(int) * N);
	int* a5 = (int*)malloc(sizeof(int) * N);
	int* a6 = (int*)malloc(sizeof(int) * N);
	int* a7 = (int*)malloc(sizeof(int) * N);
	for (int i = 0; i < N; ++i)
	{
		a1[i] = rand();
		a2[i] = a1[i];
		a3[i] = a1[i];
		a4[i] = a1[i];
		a5[i] = a1[i];
		a6[i] = a1[i];
		a7[i] = a1[i];
	}
	int begin1 = clock();
	InsertSort(a1, N);
	int end1 = clock();

	int begin2 = clock();
	ShellSort(a2, N);
	int end2 = clock();

	int begin3 = clock();
	SelectSort(a3, N);
	int end3 = clock();

	int begin4 = clock();
	HeapSort(a4, N);
	int end4 = clock();

	int begin5 = clock();
	QuickSort(a5, 0, N - 1);
	int end5 = clock();

	int begin6 = clock();
	MergeSort(a6, N);
	int end6 = clock();

	int begin7 = clock();
	BubbleSort(a7, N);
	int end7 = clock();

	printf("InsertSort:%d\n", end1 - begin1);
	printf("ShellSort:%d\n", end2 - begin2);
	printf("SelectSort:%d\n", end3 - begin3);
	printf("HeapSort:%d\n", end4 - begin4);
	printf("QuickSort:%d\n", end5 - begin5);
	printf("MergeSort:%d\n", end6 - begin6);
	printf("BubbleSort:%d\n", end7 - begin7);

	free(a1);
	free(a2);
	free(a3);
	free(a4);
	free(a5);
	free(a6);
	free(a7);
}
2.6 非比较排序
2.6.1 计数排序
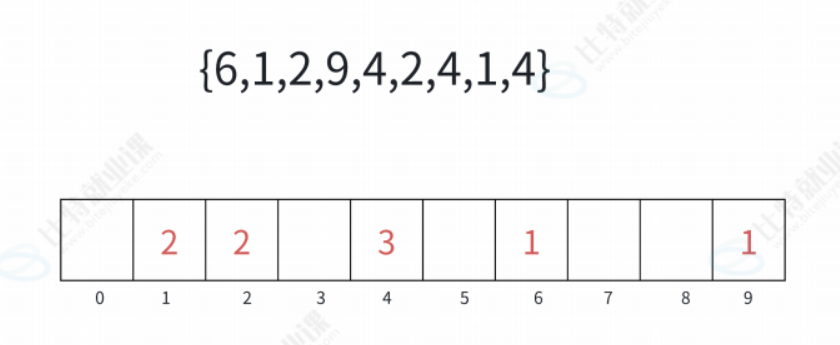
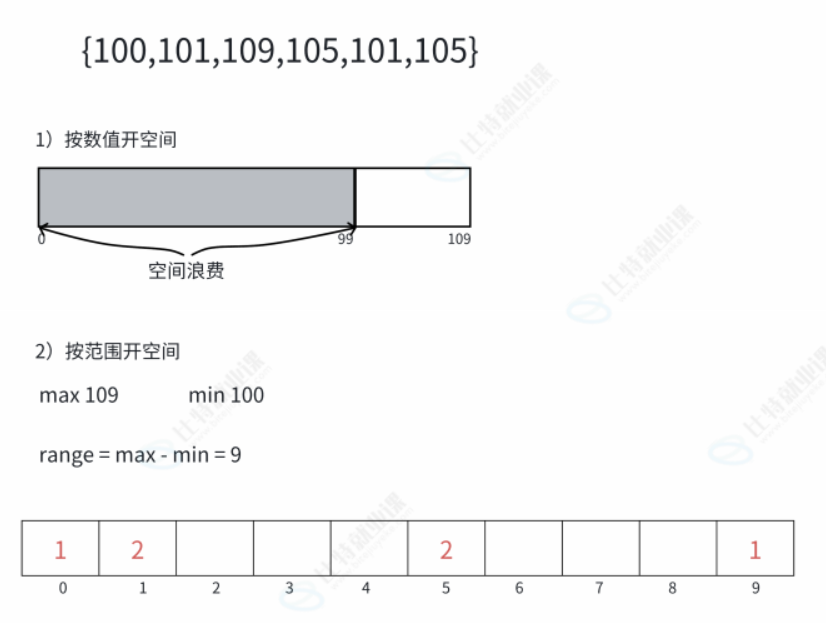
计数排序又称鸽巢原理,是对哈希直接定址法的变形应用。
1.统计相同元素出现次数
2.根据统计的结果将序列回收到原来的序列中
//计数排序
void CountSort(int* arr, int n)
{
	//找最大值和最小值
	int min = arr[0], max = arr[0];
	for (int i = 1; i < n; i++)
	{
		if (arr[i] < min)
		{
			min = arr[i];
		}
		if (arr[i] > max)
		{
			max = arr[i];
		}
	}
	//max-min+1确定count数组的大小
	int range = max - min + 1;
	int* count = (int*)malloc(sizeof(int) * range);
	//初始化用calloc
	memset(count, 0, sizeof(int) * range);
	for (int i = 0; i < n; i++)
	{
		count[arr[i] - min]++;
	}
	//将count数组还原到原数组中,使其有序
	int index = 0;
	for (int i = 0; i < range; i++)
	{
		while (count[i]--)
		{
			arr[index++] = i + min;
		}
	}
}

计数排序在数据范围集中时,效率很高,但是适用范围及场景有限。
时间复杂度:O (N +range)
空间复杂度:O (range)
三、排序算法复杂度及稳定性分析
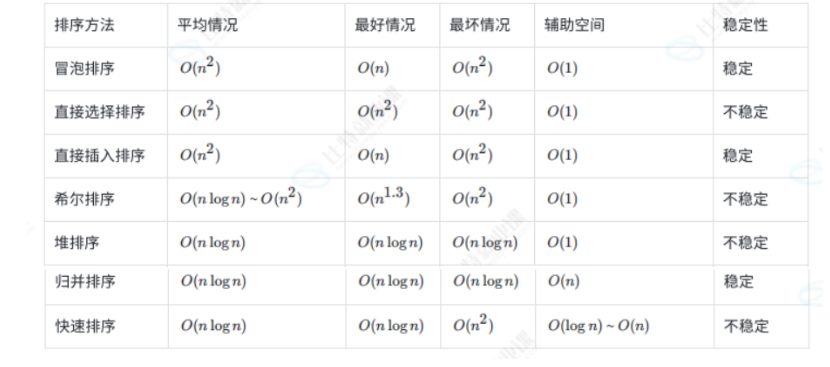
稳定性:假定在待排序的记录序列中,存在多个具有相同的关键字的记录,若经过排序,这些记录的相对次序保持不变,即在原序列中,r i=r j,且r i在r j之前,而在排序后的序列中,r i仍在r j之前,则称这种排序算法是稳定的;否则称为不稳定的。