【Agent】如何从大模型构建真正的 Agent?以 Claude Code 为例,理解能构建智能体的真正的 Harness 工程
本博客参考:Learn Claude Code -- Harness Engineering for Real Agents 。强烈推荐这个Agent教程!也感谢 华中科技大学计算机学院的2023级本科生 @Ustinian_wren 向我推荐的相关内容。
文章目录
- [【Agent】如何从大模型构建真正的 Agent?以 Claude Code 为例,理解能构建智能体的真正的 Harness 工程](#【Agent】如何从大模型构建真正的 Agent?以 Claude Code 为例,理解能构建智能体的真正的 Harness 工程)
-
- [0 绪论:真正的 Agent Harness 工程](#0 绪论:真正的 Agent Harness 工程)
-
- [什么是真正的 Agent](#什么是真正的 Agent)
- [Agent Harness 工程需要做什么](#Agent Harness 工程需要做什么)
- [Claude Code](#Claude Code)
- [1 Agent Loop:将用户与模型反复交互的循环自动化](#1 Agent Loop:将用户与模型反复交互的循环自动化)
- [2 Tool Use:统一管理各个工具](#2 Tool Use:统一管理各个工具)
- [3 Permission:在执行工具前做权限判断](#3 Permission:在执行工具前做权限判断)
- [4 Hooks:打包组织各种需要加入Agent Loop的操作,避免Agent Loop冗杂](#4 Hooks:打包组织各种需要加入Agent Loop的操作,避免Agent Loop冗杂)
- [5 TodoWrite:Agent的计划,避免偏离最初用户发送的目标](#5 TodoWrite:Agent的计划,避免偏离最初用户发送的目标)
- [6 Subagent:封装思想](#6 Subagent:封装思想)
- [7 Skill Loading:特定领域的Prompt只在需要的时候加载](#7 Skill Loading:特定领域的Prompt只在需要的时候加载)
- [8 Context Compact:内容压缩,节省上下文空间](#8 Context Compact:内容压缩,节省上下文空间)
-
- [8.1 什么是上下文,为什么要进行上下文压缩](#8.1 什么是上下文,为什么要进行上下文压缩)
- [8.2 为什么压缩上下文需要先整理工具结果](#8.2 为什么压缩上下文需要先整理工具结果)
- [8.3 在每次Agent Loop中自动执行的上下文压缩的步骤](#8.3 在每次Agent Loop中自动执行的上下文压缩的步骤)
-
- [8.3.1 tool_result_budget:把工具的完整结果写入硬盘中的一个文件中,避免占用太多Prompt的空间](#8.3.1 tool_result_budget:把工具的完整结果写入硬盘中的一个文件中,避免占用太多Prompt的空间)
- [8.3.2 snip_compact:控制完整保留内容的消息数量](#8.3.2 snip_compact:控制完整保留内容的消息数量)
- [8.3.3 micro_compact(可能执行):压缩消息内容](#8.3.3 micro_compact(可能执行):压缩消息内容)
- [8.3.4 compact_history(可能执行):请求模型生成摘要](#8.3.4 compact_history(可能执行):请求模型生成摘要)
- [8.3.5 如果进行了上下文压缩,还是因为上下文长度超限被API拒绝了,如何补救?](#8.3.5 如果进行了上下文压缩,还是因为上下文长度超限被API拒绝了,如何补救?)
- [8.4 允许模型决定主动调用的 compact 工具](#8.4 允许模型决定主动调用的 compact 工具)
- [9 Memory:让重要信息能够跨会话保留下来](#9 Memory:让重要信息能够跨会话保留下来)
-
- [9.1 存储:一个记忆存为一个文件](#9.1 存储:一个记忆存为一个文件)
- [9.2 召回:先选择需要加载的记忆,再加载记忆的内容](#9.2 召回:先选择需要加载的记忆,再加载记忆的内容)
- [9.3 提取:回合结束后保存可复用信息](#9.3 提取:回合结束后保存可复用信息)
- [9.4 整理:合并重复和过期内容](#9.4 整理:合并重复和过期内容)
- [10 Task System:通过硬盘文件来持久化维护一个任务图,是 Multi-Agent 协作的基础](#10 Task System:通过硬盘文件来持久化维护一个任务图,是 Multi-Agent 协作的基础)
-
- [10.1 Task的数据结构](#10.1 Task的数据结构)
- [10.2 任务图(Task DAG)的构建](#10.2 任务图(Task DAG)的构建)
- [10.3 任务的生命周期与状态机设计(3 个状态与 2 个动作)](#10.3 任务的生命周期与状态机设计(3 个状态与 2 个动作))
- [10.4 get_task: 允许模型查看完整的任务细节](#10.4 get_task: 允许模型查看完整的任务细节)
- [11 Background Tasks:将一些慢操作放到后台](#11 Background Tasks:将一些慢操作放到后台)
- [12 Cron Scheduler:可以完成一些需要定时启动的任务](#12 Cron Scheduler:可以完成一些需要定时启动的任务)
- [13 Agent Teams:多个Agent的协作](#13 Agent Teams:多个Agent的协作)
-
- [13.1 Lead 先提出启用Agent Teams,再等待用户确认是否如此](#13.1 Lead 先提出启用Agent Teams,再等待用户确认是否如此)
- [13.2 每个队友拥有独立循环](#13.2 每个队友拥有独立循环)
- [13.3 MessageBus 在模型上下文之外维护团队内多个Agent之间的通信](#13.3 MessageBus 在模型上下文之外维护团队内多个Agent之间的通信)
- [13.4 收件箱事件由 *运行时* 投递](#13.4 收件箱事件由 运行时 投递)
- [13.5 完成一项任务后,结果与 IDLE 会分别发送](#13.5 完成一项任务后,结果与 IDLE 会分别发送)
- [13.6 IDLE 状态的优先级:先看收件箱,再找 ready task](#13.6 IDLE 状态的优先级:先看收件箱,再找 ready task)
- [13.7 发现任务和认领任务分成两步,认领任务必须原子执行(Atomic Claim)](#13.7 发现任务和认领任务分成两步,认领任务必须原子执行(Atomic Claim))
- [13.8 认领后的工作复用同一个 WORK 循环](#13.8 认领后的工作复用同一个 WORK 循环)
- [13.9 由任务选择工具的工作目录,实现任务级 Git Worktree 隔离](#13.9 由任务选择工具的工作目录,实现任务级 Git Worktree 隔离)
- [13.10 宿主函数或人类用户控制 Worktree 销毁,严禁 Agent 自行删除 worktree](#13.10 宿主函数或人类用户控制 Worktree 销毁,严禁 Agent 自行删除 worktree)
- [13.11 类型化控制协议(Typed Protocols)](#13.11 类型化控制协议(Typed Protocols))
- [13.12 计划审批会设置闸门(Plan Gate)来约束执行](#13.12 计划审批会设置闸门(Plan Gate)来约束执行)
- [14 MCP Tools:发现并调用外部工具](#14 MCP Tools:发现并调用外部工具)
- [15 Agent Harness 集成:在一个 Agent Loop 中集成多种机制](#15 Agent Harness 集成:在一个 Agent Loop 中集成多种机制)
-
- [15.1 工具与分发(对应第2节)](#15.1 工具与分发(对应第2节))
- [15.2 权限和 hooks(对应第3节)](#15.2 权限和 hooks(对应第3节))
- [15.3 计划与任务(对应第5节)](#15.3 计划与任务(对应第5节))
- [15.4 子 agent 与团队(对应第6、13节)](#15.4 子 agent 与团队(对应第6、13节))
- [15.5 记忆、技能和 prompt(对应第9、7节)](#15.5 记忆、技能和 prompt(对应第9、7节))
- [15.6 上下文压缩(对应第8节)](#15.6 上下文压缩(对应第8节))
- [15.7 Agent Teams的worktree、MCP(对应第13、14节)](#15.7 Agent Teams的worktree、MCP(对应第13、14节))
- [16 Workflow Runtime:使用预先设定的脚本(而不是由大模型)来编排某些固定的流程](#16 Workflow Runtime:使用预先设定的脚本(而不是由大模型)来编排某些固定的流程)
-
- [16.1 Workflow 将固定的流程封装为一个工具](#16.1 Workflow 将固定的流程封装为一个工具)
- [16.2 六大编排原语(ctx 执行上下文)](#16.2 六大编排原语(ctx 执行上下文))
- [16.3 基于存储快照与 Journal 的断点续跑(Resume)](#16.3 基于存储快照与 Journal 的断点续跑(Resume))
- [17 Goal Loop:模型提出停止,独立判断器决定是否继续](#17 Goal Loop:模型提出停止,独立判断器决定是否继续)
-
- [17.1 Goal 判断器](#17.1 Goal 判断器)
- [17.2 能够被判断器用于检查的完成条件](#17.2 能够被判断器用于检查的完成条件)
- [17.3 如果主模型没有满足任务完成条件,就回到Agent Loop循环之中](#17.3 如果主模型没有满足任务完成条件,就回到Agent Loop循环之中)
- [17.4 如果后台任务还在运行,Goal 检查就不要判断任务是否完成](#17.4 如果后台任务还在运行,Goal 检查就不要判断任务是否完成)
- [17.5 自动继续运行也必须有截止条件](#17.5 自动继续运行也必须有截止条件)
- [17.6 Goal 判断器的查看、替换和清除](#17.6 Goal 判断器的查看、替换和清除)
0 绪论:真正的 Agent Harness 工程
什么是真正的 Agent
Agent 产品 = 模型 + Harness
e.g. 人类的智慧:一个由数百万年进化训练出来的生物神经网络(模型),通过感官感知世界,通过大脑推理,通过身体行动(Harness)。
Harness n.马鞍 可以理解为大模型调用的那些工具
智能体 Harness 是把基础 LLM 转化为可执行智能体的外部控制层,负责管理上下文、工具、编排、记忆、解码和输出处理:它规定上下文如何构建、开放哪些工具和检索通道、推理如何跨轮次编排、保留哪些记忆,以及如何验证并返回输出。在实践中,这包括提示词构造策略、工具与检索接口、解码参数、编排拓扑、记忆管理和输出处理。实践经验表明,在基础模型和工具都相同的情况下,仅 Harness 设计就可能让端到端任务成功率产生数十个%的提高(Lopopolo, 2026;LangChain, 2025)
上段参考:MemoHarness: Agent Harnesses That Learn from Experience,这篇文章是关于 如何训练一个"能够学会如何给自己配置Harness的模型" 的相关方法,值得阅读学习。
⚠️Agency ------ 那个自主决定如何感知、推理、行动 的能力 ------ 是训练出来的,不是规定出来的。
拖拽式工作流构建器、无代码 "AI Agent" 平台、提示词链编排库等当中,把 LLM API 调用用 if-else 分支、节点图、硬编码路由逻辑串在一起,并不算"构建 Agent" 。这和几十年前想要通过符号主义实现人工智能的做法一样是没有发展前途的。
有关符号主义的相关观点可以参考我的这一篇文章:从 1966 年 MIT 的暑期大作业到今天的"提示词水管工":AI 七十年,我们从符号主义的死与生中学到了什么?
Agent Harness 工程需要做什么
-
工具:文件读写、Shell 执行、API 调用、浏览器控制、数据库查询......每个工具都是 agent 在环境中可以采取的一个行动。设计它们时要原子化、可组合、描述清晰。
-
知识:一些领域特定的知识,如产品文档、架构决策记录、风格指南、合规要求。按需加载(s07),不要前置塞入。Agent 应该知道有什么可用,然后自己拉取所需。
-
管理上下文:子 Agent 把明确的工作留在另一份消息列表中;上下文压缩(s08)缩短较早的历史;任务系统(s10)让目标持久化到单次对话之外。
-
控制权限:给 Agent 划定活动边界。沙箱化文件访问。对破坏性操作要求审批。在 Agent 和外部系统之间实施信任边界。这是安全工程与 Harness 工程的交汇点。
-
收集任务过程中的数据:Agent 在你的 Harness 中执行的每一条行动序列都是训练信号。真实部署中的感知-推理-行动轨迹是微调下一代 Agent 模型的原材料。Harness 不仅服务于 Agent,还可以帮助进化 Agent。
Claude Code
在2026年3月31日被意外"开源"的 Claude Code 可以说是目前的最优雅、最完整的 agent harness 实现,其中一个原因是它没有试图成为 Agent 本身:它没有强加固定的工作流,没有用精心设计的决策树去替模型做判断,而是给模型提供了工具、知识、上下文管理和权限边界,然后"让开"了。
1 Agent Loop:将用户与模型反复交互的循环自动化
传统的通过网页对话式使用大模型的过程是这样的:
- 用户向大模型提出一个问题
- 模型输出一条 bash 命令(但输出完了就停了,它不会自己跑,也不会看到结果后继续推理)
- 用户运行模型输出的命令,把输出粘贴回对话框。
- 模型又给出下一个应该做的事项,用户再运行,再反馈结果给模型......
这当中每一个循环,都是用户在充当中间层。Agent Loop 将其自动化:
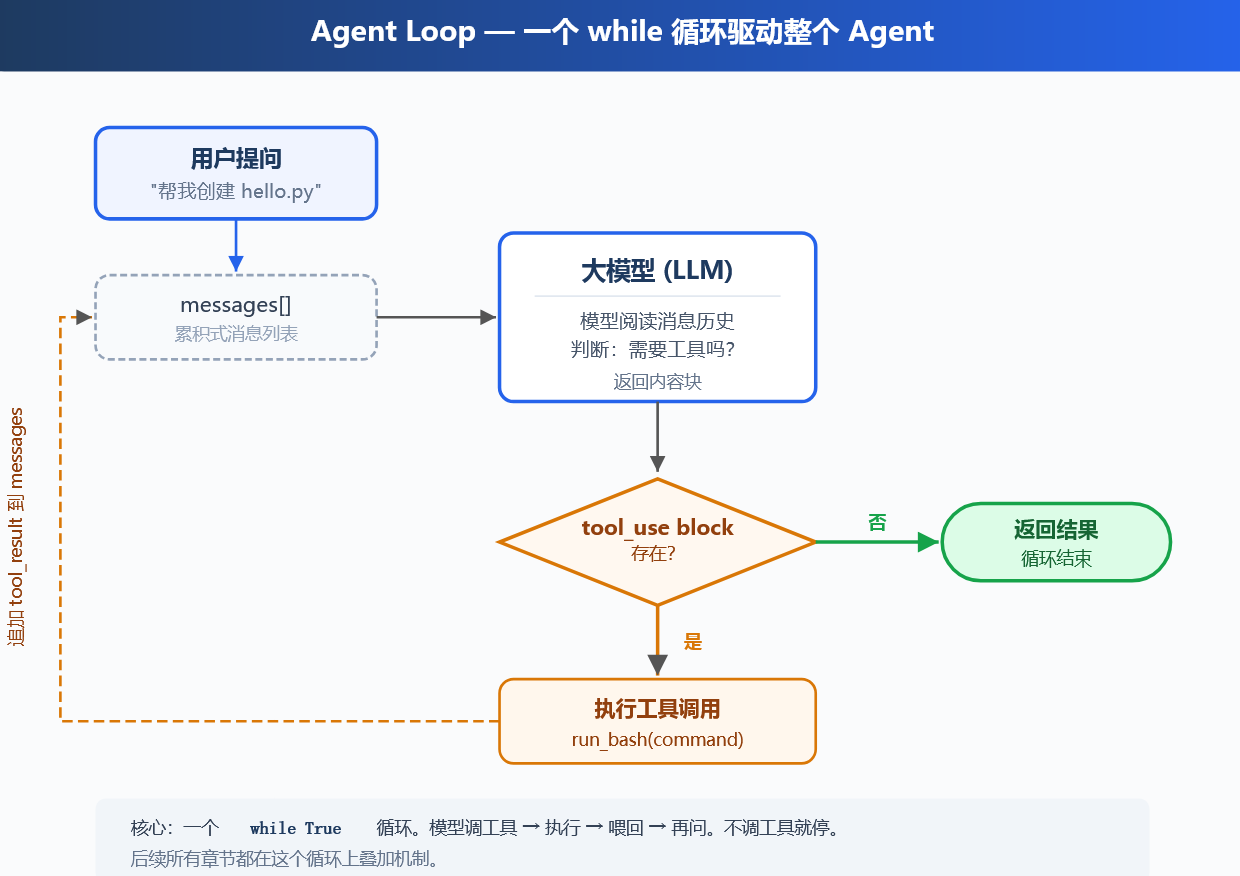
Agent Loop 会检查模型给出的响应里的内容块,如果包含 tool_use block,即模型要求调用工具,那就执行工具→得到执行结果→把结果返回作为模型的新的输入→重复此过程,直到模型的响应中不包含 tool_use block,说明模型没有打算调用工具,则退出循环。
整个过程是一个 while True 循环,模型调用工具就继续,不调用就停:
- 把用户的问题作为第一条消息。
- 将消息和工具定义一起发给 LLM。
- 检查模型的回答(也追加到消息中),看其中是否调了工具。如果没调用工具 → 结束循环。(只有实际存在的 tool_use block 才会进入执行阶段,因此不会追加空的工具结果消息)
- 执行模型要求的工具,收集执行得到的结果。
- 把工具结果作为新消息追加,回到第 2 步。
这就是最小可运行的 Agent Harness 内核。它为模型提供持续行动的最小运行框架:模型负责决策(要不要调工具、调哪个),harness 负责执行(调用工具,把结果作为新消息追加)。后续 Agent 的内容都在这个循环上叠加机制,循环本身始终不变。
2 Tool Use:统一管理各个工具
第1节中的 Agent 只有一个 bash 工具,现在要增加一些工具,那么给其配置一个工具集:在第1节的循环中,将 run_bash() 替换为一个可查询的表TOOL_HANDLERS[block.name](),模型要调用工具的话只需要指明工具的名字,然后查找字典,通过字典里的这个映射(工具名称→实现工具的具体函数)就可以调用指定的工具(这个过程称为 tool handler 的查表分发):
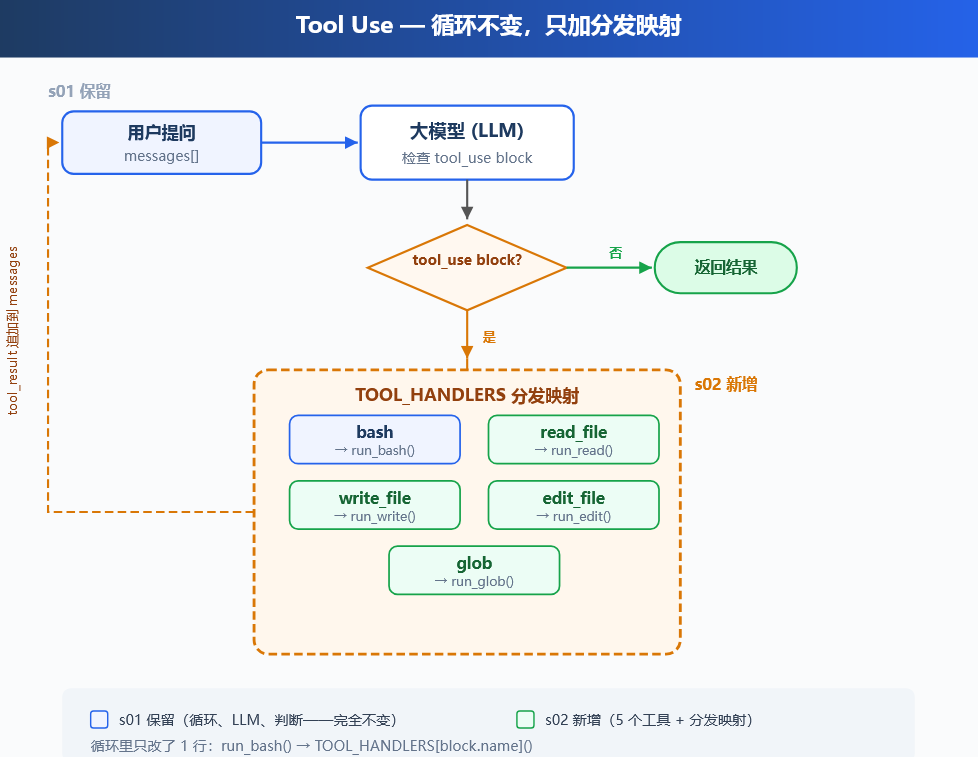
注:
- 所有的工具都在
TOOLS数组里定义 name 和 description,作为消息的一部分输入给模型,模型就知道有哪些可以干啥的工具了;每个工具单独进行具体的编程实现。 - 如果要给 Agent 加一个工具,只需要:
(1)定义工具:在TOOLS数组里加一条描述,让模型知道多了一个这个工具
(2)注册处理函数:在TOOL_HANDLERS字典里加一个映射,模型要调用这个工具的话只需要指明工具的名字,通过这个映射就可以调用指定的这个工具。 - 模型经常一次返回多个 tool_use,那么这些工具的调用按照 response.content 中的原始顺序逐个执行。
3 Permission:在执行工具前做权限判断
安全的审核(判断这个工具能不能被调用执行)发生在工具执行之前。在工具执行前插入 check_permission(),每个工具调用依次经过三道检查:
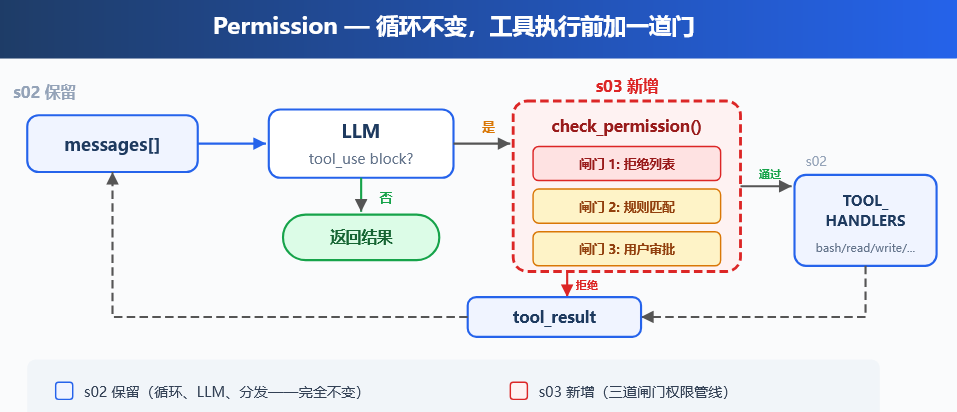
三道闸门对应 2 种路径(直接拒绝/用户审批):
- 闸门 1:一张拒绝列表,用来记录一些需要永远禁止的操作(比如 rm -rf /、sudo),模型希望进行的工具调用被先通过这张拒绝列表进行查询,命中就返回阻止信息,直接拒绝执行工具调用。这张表使用简单字符串匹配来说明权限闸门的位置,不能视为完整的安全边界。
- 闸门 2/3:规则匹配,用来描述"什么时候需要问用户"。每条规则指定工具和检查条件,是否触发取决于上下文的操作(读/写工作区外、rm 文件)。如果规则命中,先暂停,等待用户输入,用户来审批是否允许执行命令。
三道闸门串在一起插在工具执行之前。大部分日常操作一般是三道闸门都没命中,那么会被直接执行。
4 Hooks:打包组织各种需要加入Agent Loop的操作,避免Agent Loop冗杂
在每一轮循环过程中,总会出现一些检查操作,比如:如果调用工具,就进行第3节中的权限检查;如果出现了bash调用,就记录下来;如果进行了文件更改操作,就进行git add;......
这些检查都会加在 agent_loop 函数中,最后其中就会写满各种散落的 if-else,变成"面条代码"。回想一开始学编程的时候所说的面向对象与面向过程的代码设计,这种"面条代码"违背了开闭原则(Open-Closed Principle)------主循环本来应该只负责调度模型与工具,现在却变成了各种各样琐碎逻辑的"垃圾桶"。
这些七七八八的扩展操作,应该被挂在循环外面:
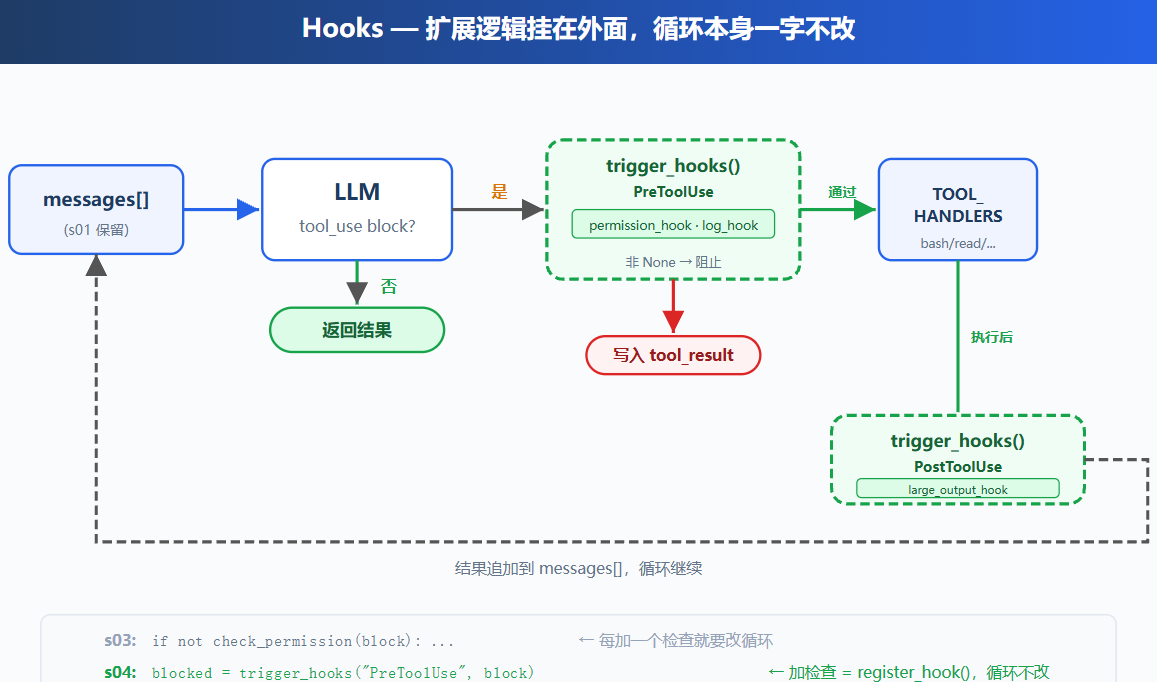
把 check_permission() 从循环体内移到 hook 上 ,循环不再直接调用任何检查函数,而是改用Hook。Hook注册表是一个字典,由事件名 映射到函数的回调列表 。
Hook的作用可以理解为:当程序运行到Agent Loop中的某个位置时 (事件名),Hook就来调用某些需要执行的预定好的函数(函数的回调列表)。
e.g. 比如在Agent Loop中的"工具执行之前"这个位置,我们给它取个名字叫
PreToolUse,然后 Agent 主循环在这个地方使用Hook(trigger_hooks("PreToolUse", block)),让所有注册在 PreToolUse 上的函数运行起来。
所以Agent 主循环本来是这样的:用户输入 → LLM → 工具 → LLM → 结束,在没有Hook的时候有什么需要检查或者插入的都会在这根绳子里面加这加那,导致这个绳子上的节点又多又乱;
现在则是在这个绳子的几个位置加装一些"挂钩(Hooks)":
用户输入
   │
   ● ← UserPromptSubmit
   │
   LLM
   │
   ● ← PreToolUse
   │
   Tool
   │
   ● ← PostToolUse
   │
   LLM
   │
   ● ← Stop
有什么需要实现的功能,其函数都加到对应位置的挂钩的地方挂上去,这样主循环的那个绳子就不会很冗杂了,便于维护。这四种Hook负责Agent循环中的不同位置:
| 事件 | 触发时机 | 典型用途 |
|---|---|---|
| UserPromptSubmit | 用户输入提交后、进入 LLM 前 | 输入验证、注入上下文 |
| PreToolUse | 工具执行前 | 权限检查、日志记录 |
| PostToolUse | 工具执行后 | 副作用(自动 git add 等)、输出检查 |
| Stop | 循环即将退出时 | 收尾清理、决定是否继续循环 |
注:①对于第3节中的权限控制如何应用Hook实现:PreToolUse / PostToolUse是工具执行前后的 hook,在第 3 节中的权限检查逻辑,在使用Hook后就可以包装成一个 PreToolUse hook,再加一个日志 hook 和一个输出提醒。
②4种Hook的返回值:PreToolUse 返回非 None 时本次工具执行被阻止(其返回值的含义通常表示:这次模型计划的工具调用存在什么需要被阻止的情况);Stop 返回非 None 时循环继续(其返回值的含义通常表示:虽然这次模型不打算再调用工具、准备退出结束Agent循环了,但是由于什么事情没做完等原因,要求重新进入下一轮Agent循环);UserPromptSubmit 和 PostToolUse 的返回值不参与控制流。
5 TodoWrite:Agent的计划,避免偏离最初用户发送的目标
给 Agent 一个复杂任务,Agent 开始干活:调用工具→发现问题→调用工具修改问题→发现新的问题→......工具的执行结果不断填满上下文,系统提示的影响力被稀释......后面甚至会开始即兴发挥,因为一开始要做啥的目标已经被挤出模型的注意力了。
所以加入 todo_write 与 reminder 计数器:todo_write 相当于一个新的tool,它是带有各个计划是否被完成状态的 TODO 列表,当然这个函数只负责更新计划状态,实际工作仍由原有工具完成,todo_write 不给 Agent 增加任何执行能力,它增加的是规划能力;当连续n个工具调用轮次没有使用 todo_write 时,Harness 会把 reminder 追加到第n轮的工具结果中;此外SYSTEM 提示词中加入"先计划再执行"的相关引导:
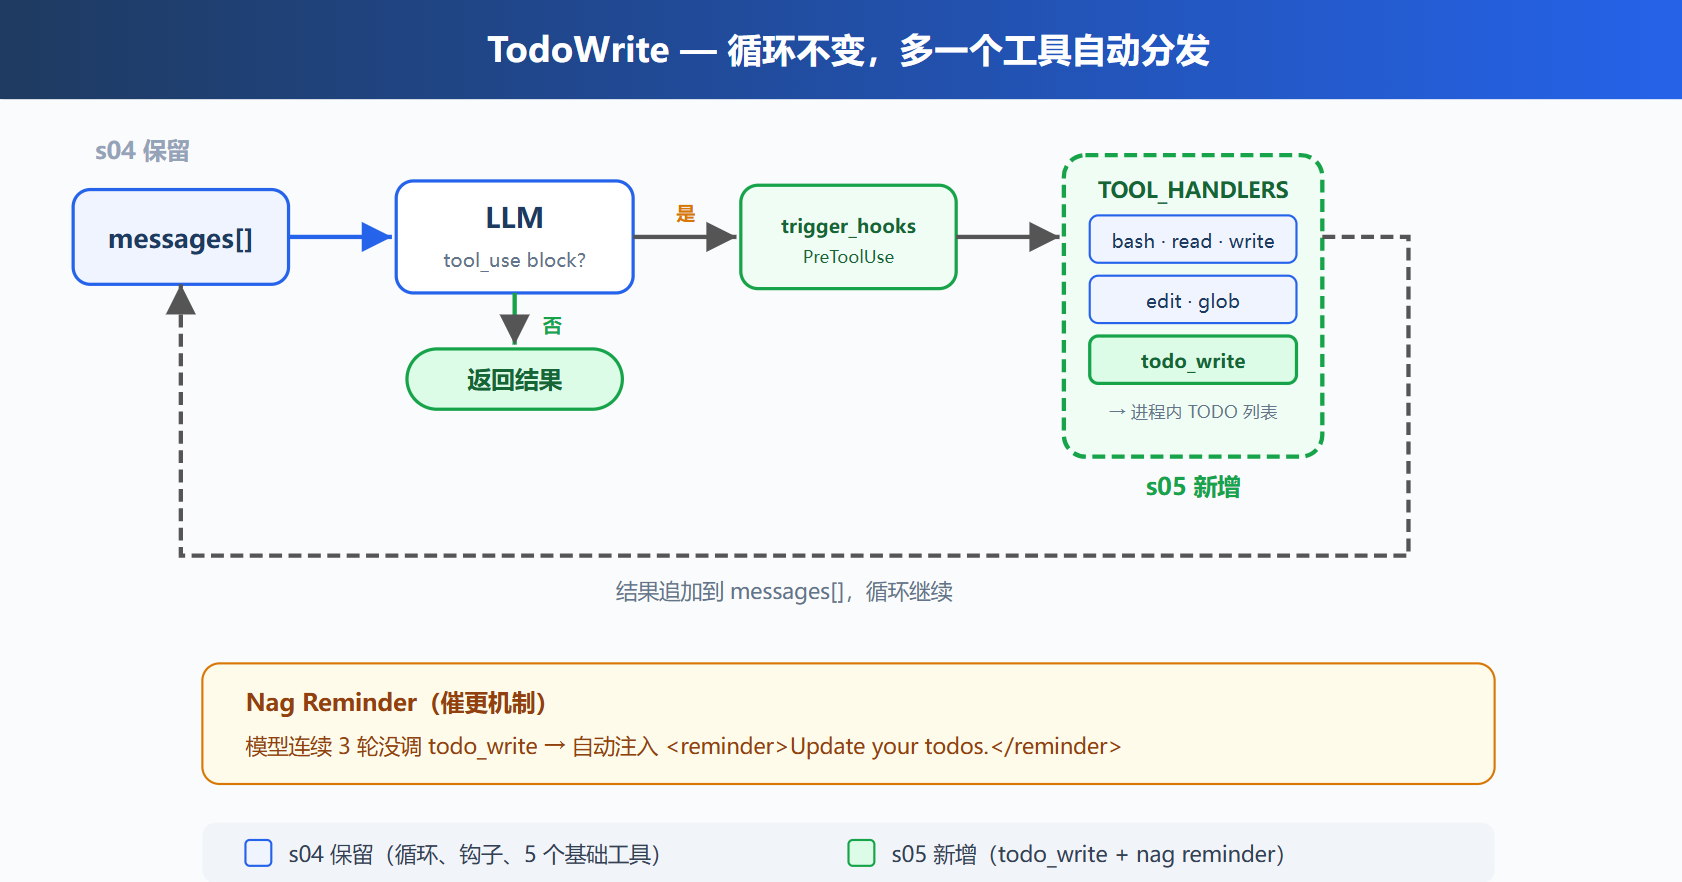
Agent 收到任务后的典型流程:调用 todo_write 列出所有步骤(初始状态下这些步骤的状态都是 pending)→ 当正在进行其中的一个步骤,这个步骤的状态改成 in_progress → 做完的步骤的状态改成 completed → 接下来进行下一个 pending 的 步骤 → ...... 循环往复直到所有步骤的状态均为 completed。
6 Subagent:封装思想
有些工作是固定的、对于问题整体解决来说无需知道细节的(比如在研究化学反应的时候,往往不会考虑原子内部质子、中子之间的强相互作用力、原子核发生的变化等等)、可以抽象并封装为一个模块的,那么就可以使用Subagent,以避免占用主Agent的上下文。
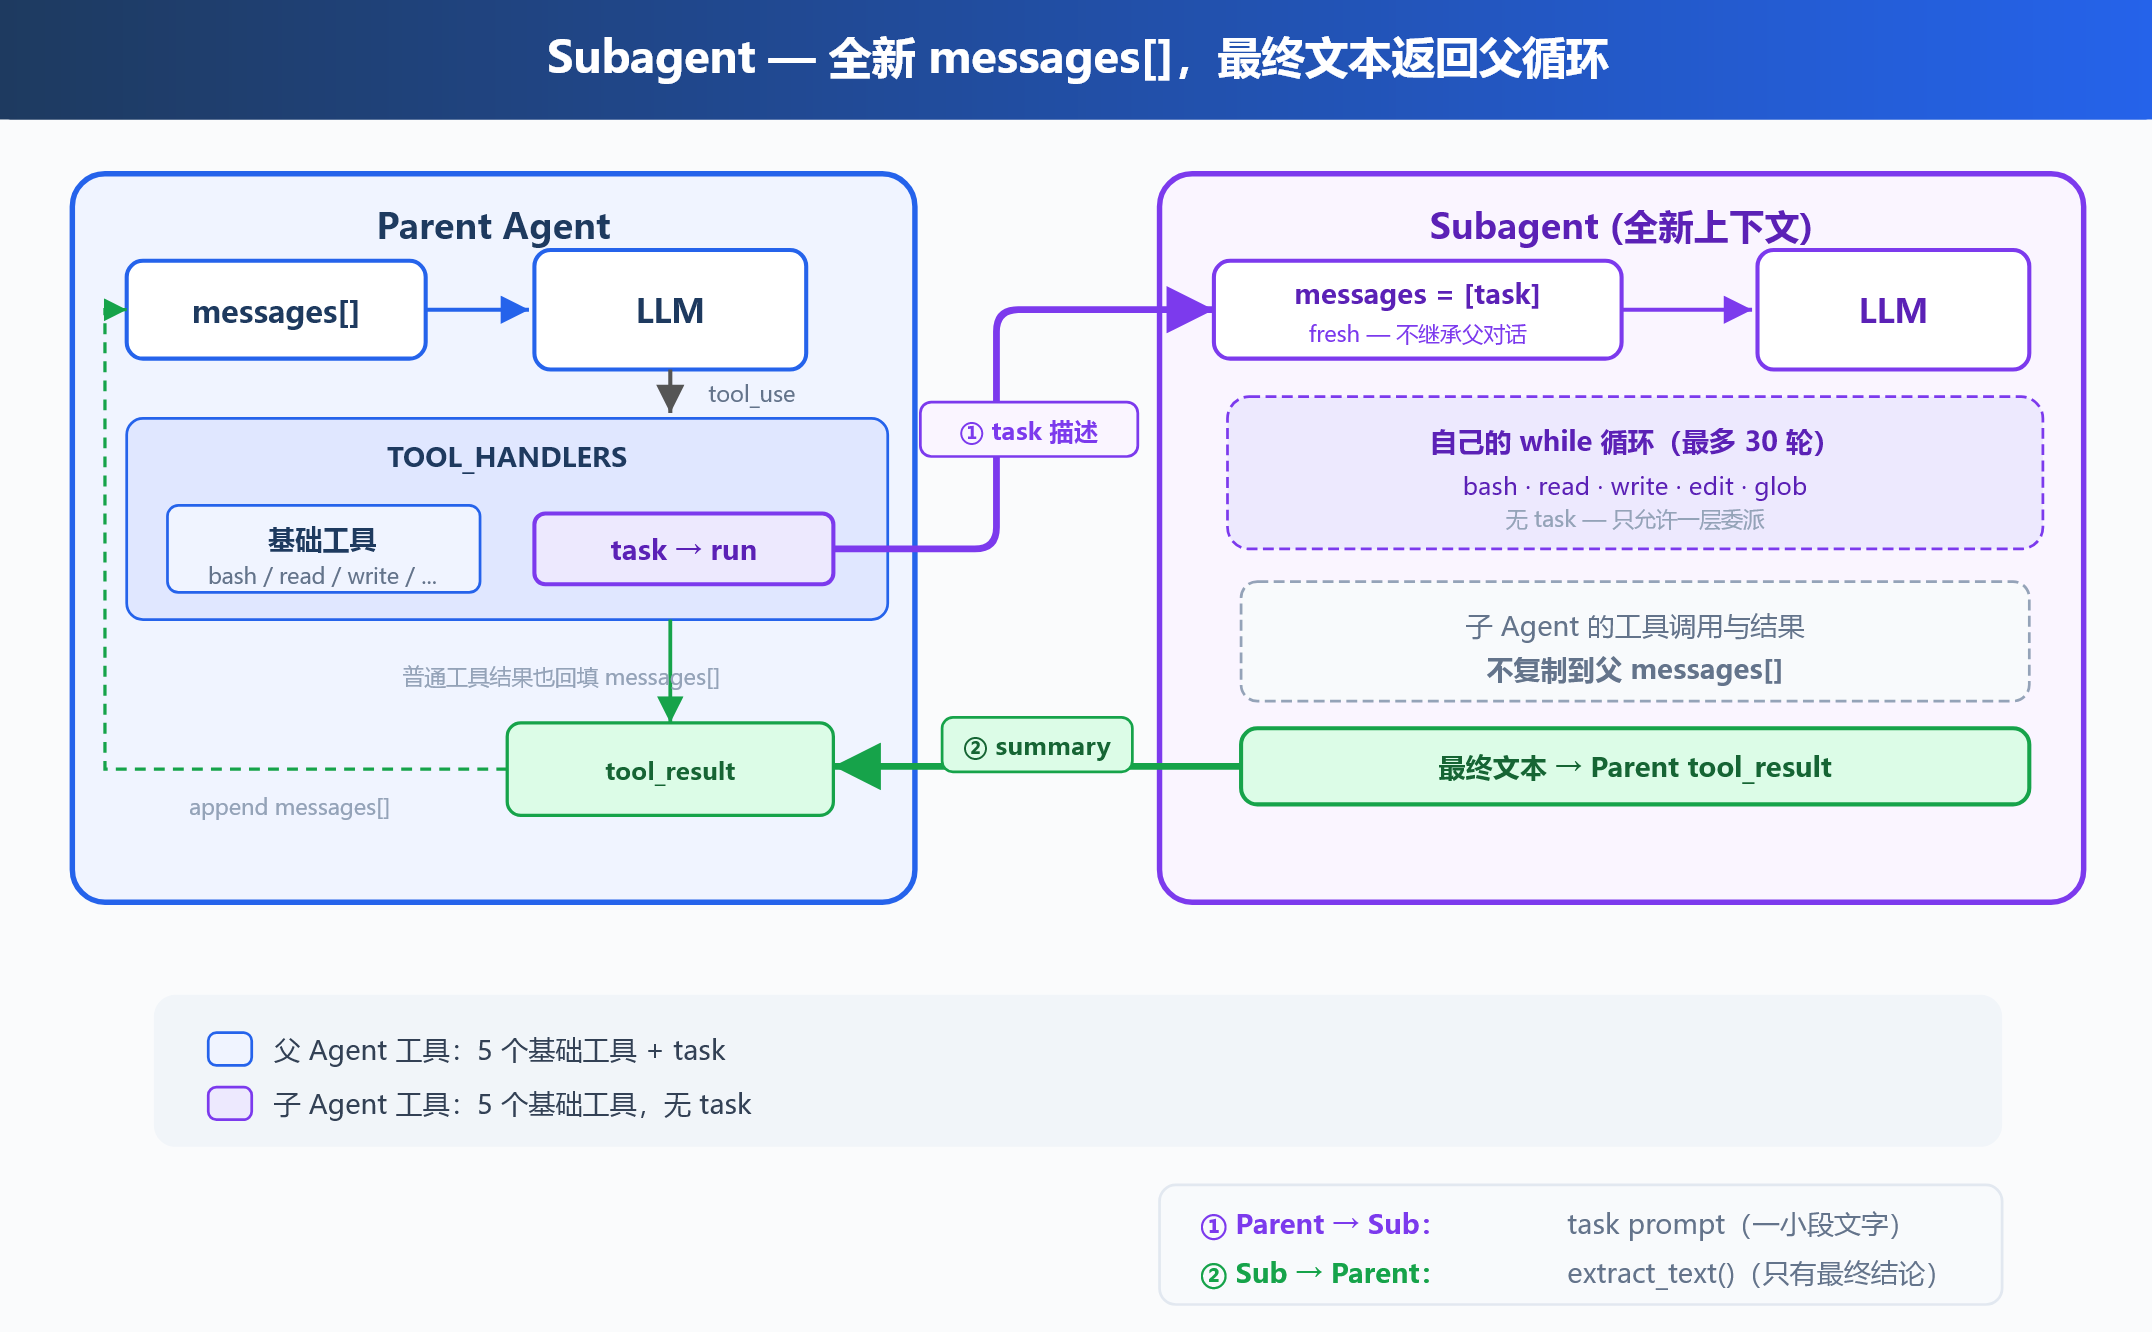
其过程为:主Agent调用Tool时,如果这个Tool是需要交给一个Subagent运行的(我们称这种工具调用为制定一个task,可以认为task是主Agent所掌握的一种特殊工具),那么会由构建一个task prompt作为消息列表messages\[\]发送给Subagent,然后Subagent运行自己的(嵌套的)Agent Loop。Subagent的Agent Loop结束后,其最终结果会成为主Agent该次"task"工具调用得到的输出结果。
主 Agent 与 Subagent 共享 WORKDIR,写文件和命令仍会影响同一个工作区,Subagent 工具调用与主 Agent 使用同一组权限和生命周期 Hooks,Subagent 同样拥有相应的基础工具。所不同的是,Subagent但没有 task 这种工具(因为task工具就是主Agent用来调用Subagent的);Subagent的massages不同于主Agent的messages,而是由主Agent根据需要提供给Subagent的。
| 决策 | 选择 | 原因 |
|---|---|---|
| 对话 | 全新的 messages\[\] | 不把主Agent的对话复制给Subagent |
| 执行 | 同一进程和 WORKDIR | 内外层Agent Loop都能看到文件系统修改 |
| 返回值 | 只返回最终文本 | Subagent的工具调用和结果不进入主Agent的消息列表 |
| 委派深度 | SUB_TOOLS 中没有 task | 除非允许多层委派 |
| 工具策略 | 共享 Hooks | 内外层Agent Loop使用相同的权限检查 |
7 Skill Loading:特定领域的Prompt只在需要的时候加载
很多任务都需要特定的专业知识或提示词,我们不可能把所有任务的专业知识都放进 system prompt(那样很多与某个特定任务无关的知识会占用输入 token 和上下文窗口,留给代码、对话和工具结果的空间也会变少),因此设计Skill Loading,让特定领域的知识(我们称之为Skill)只在需要的时候加载。
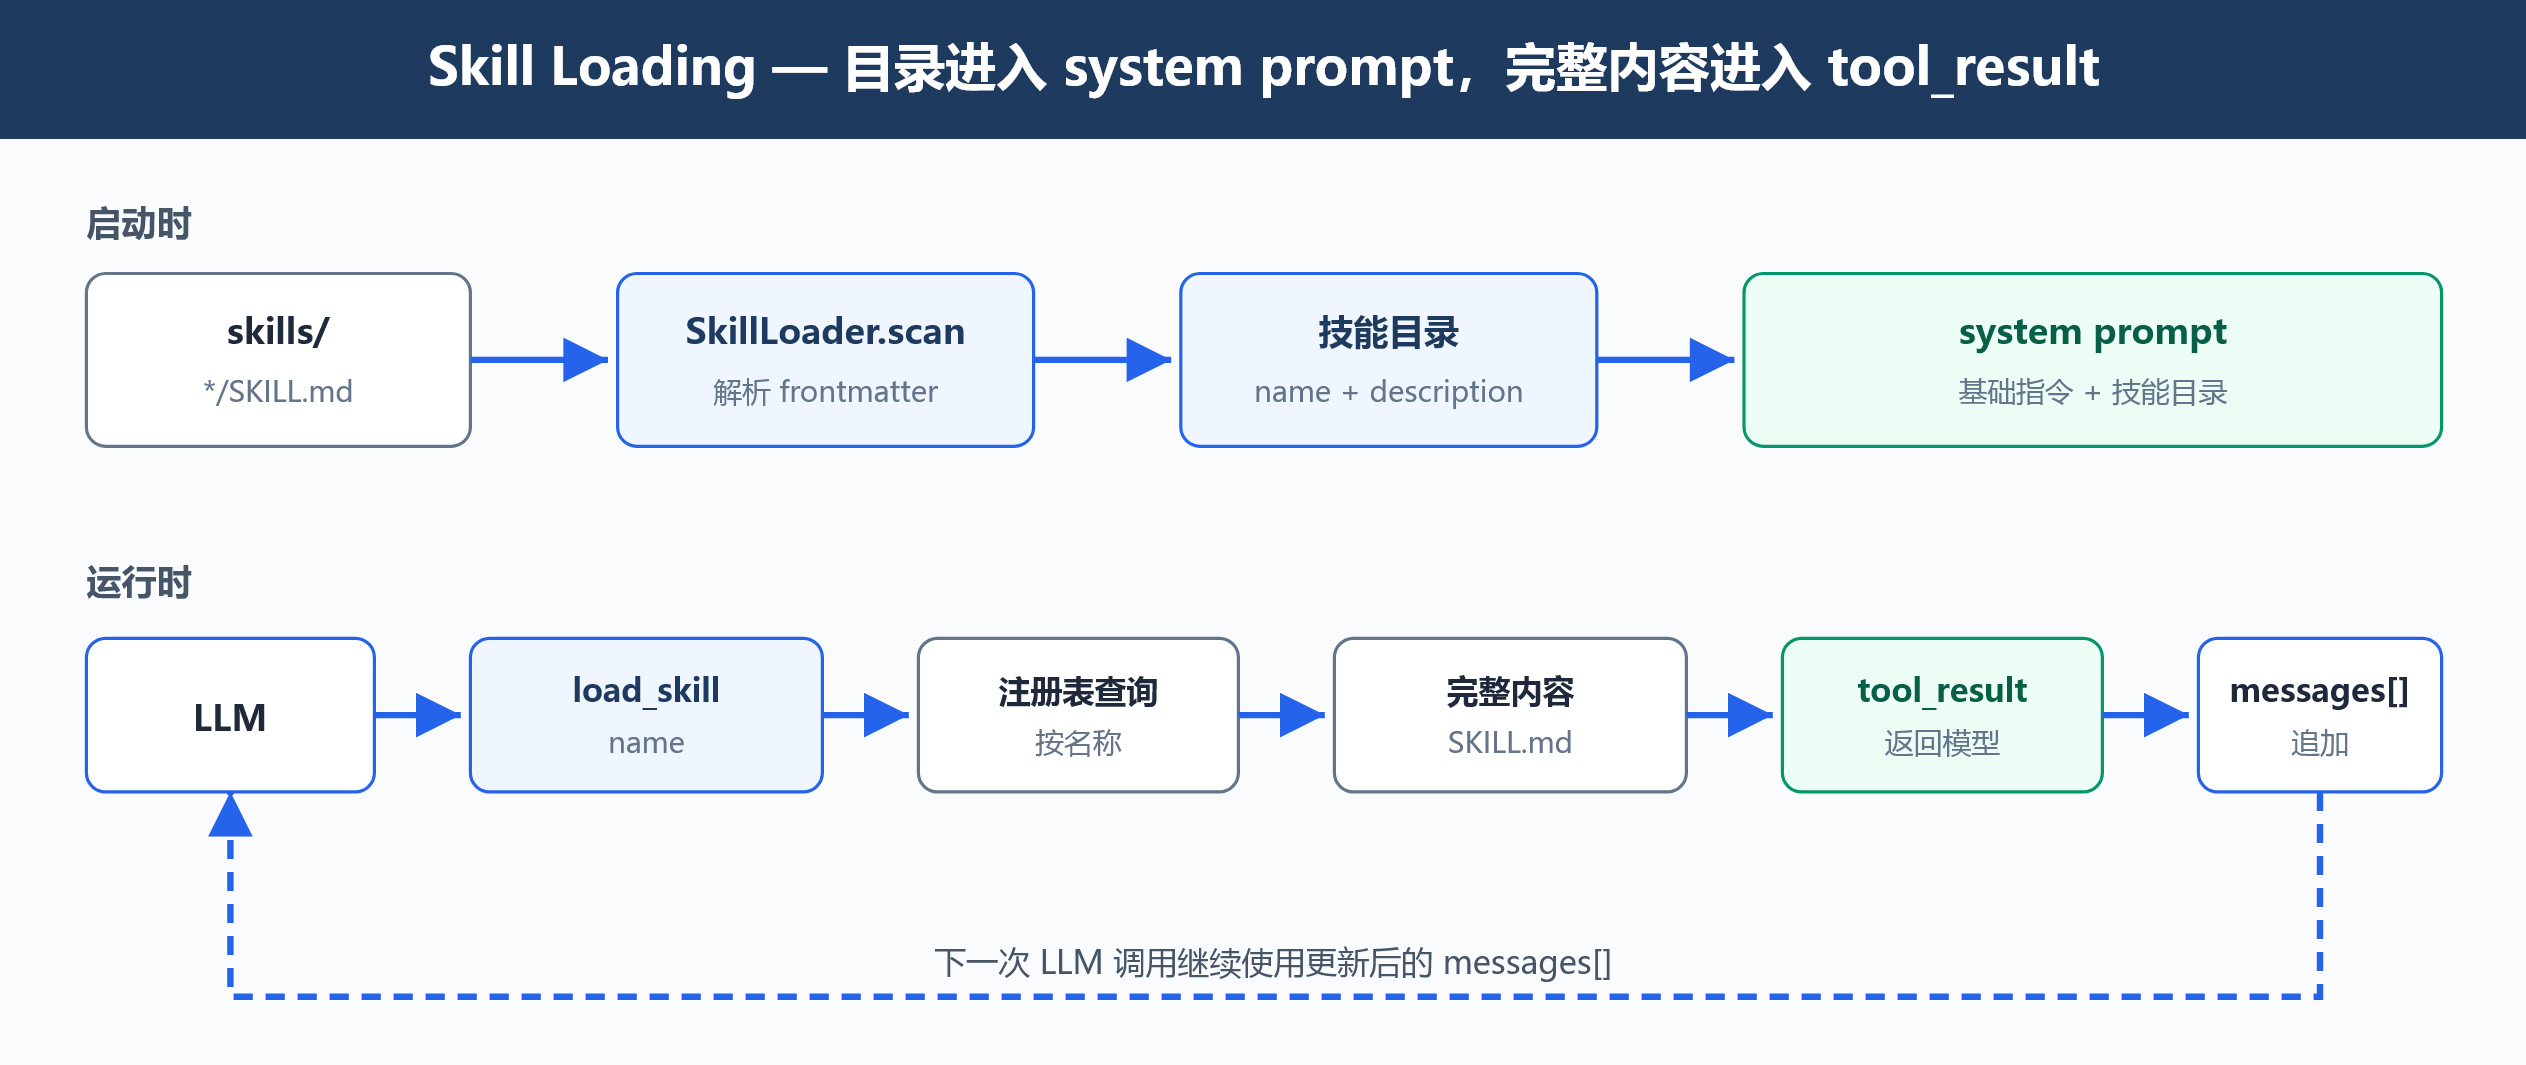
每个技能是一个包含 SKILL.md 的目录:
skills/
  agent-builder/SKILL.md
  code-review/SKILL.md
  mcp-builder/SKILL.md
  pdf/SKILL.md
启动Agent时,SkillLoader 扫描 skills/*/SKILL.md,读取 YAML frontmatter 中的技能名称 name 和相应的技能描述 description 构成一份技能目录,并把这份目录的信息组装到 system prompt。
在Agent运行Agent Loop的过程中,当模型需要对应的完整的SKILL.md说明时,调用工具 load_skill(name),将其返回的 SKILL.md 作为 tool_result 追加到消息列表。
8 Context Compact:内容压缩,节省上下文空间
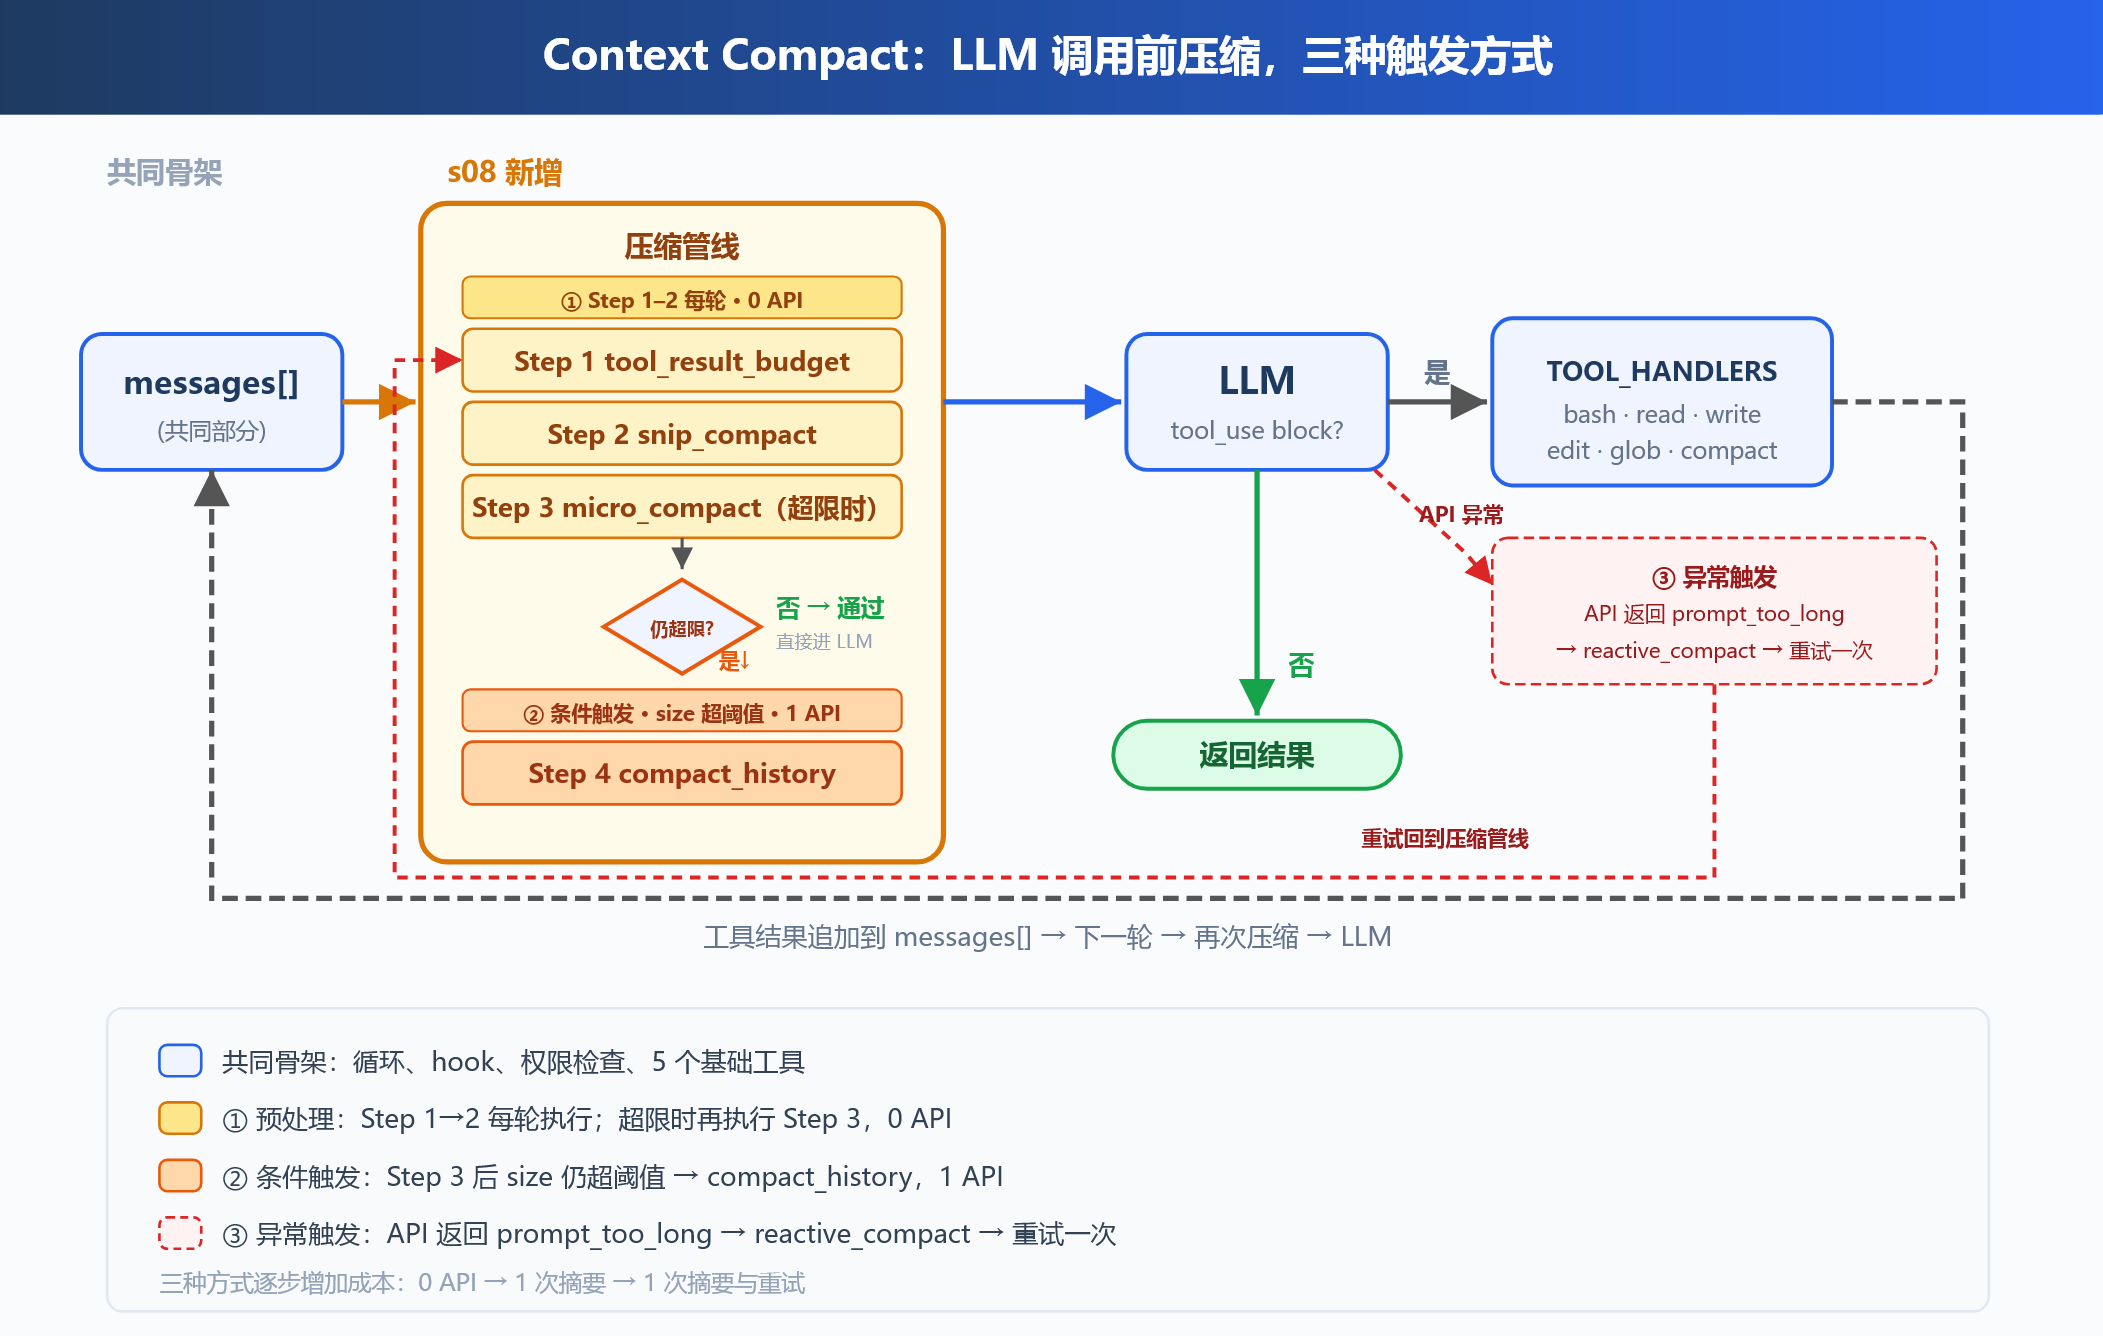
Agent 持续工作时,读过的文件、执行过的命令和模型回复都会留在 messages 中。随着工具调用增加,messages\[\] 会积累较早的文件内容和工具结果。消息越积越多,最终会超过模型能够接收的上下文长度。
Context Compact 可以缩短较早的消息,为后续调用保留上下文空间。它先整理可以恢复的工具结果,空间仍然不足时再总结历史。
8.1 什么是上下文,为什么要进行上下文压缩
用户消息、模型回复、tool_use 和 tool_result 都会按顺序写在上下文当中,模型每次继续工作时,都要重新读取这些内容。
但是上下文所能允许的最大大小是固定的,内容超过上限后,API 会拒绝请求并返回 prompt_too_long。
在代码任务里,工具结果通常占据最多空间:读取一个长文件会把文件内容放进上下文;测试和构建日志可能一次产生几十 KB 文本;搜索多个文件会持续追加结果......任务持续得越久,messages 就越大。
因此,上下文内容压缩的目标是控制其中的信息量,同时尽可能保留当前目标、用户约束和正在进行的工作。
8.2 为什么压缩上下文需要先整理工具结果
可能有人会说:直接让模型总结整段历史不也可以明显缩短上下文吗?但这样生成的摘要一定会遗漏部分细节,而且还会多产生一次模型调用。
在压缩上下文时,工具结果更适合被优先处理:大文件可以保存到磁盘,需要时重新读取;旧命令可以重新执行;最新几条结果通常比早期结果更接近当前工作;文本裁剪和结构调整不需要调用模型;......
因此压缩顺序按照信息损失和调用成本来排列顺序:先转存,再裁剪,再替换旧结果,最后才生成摘要。
8.3 在每次Agent Loop中自动执行的上下文压缩的步骤
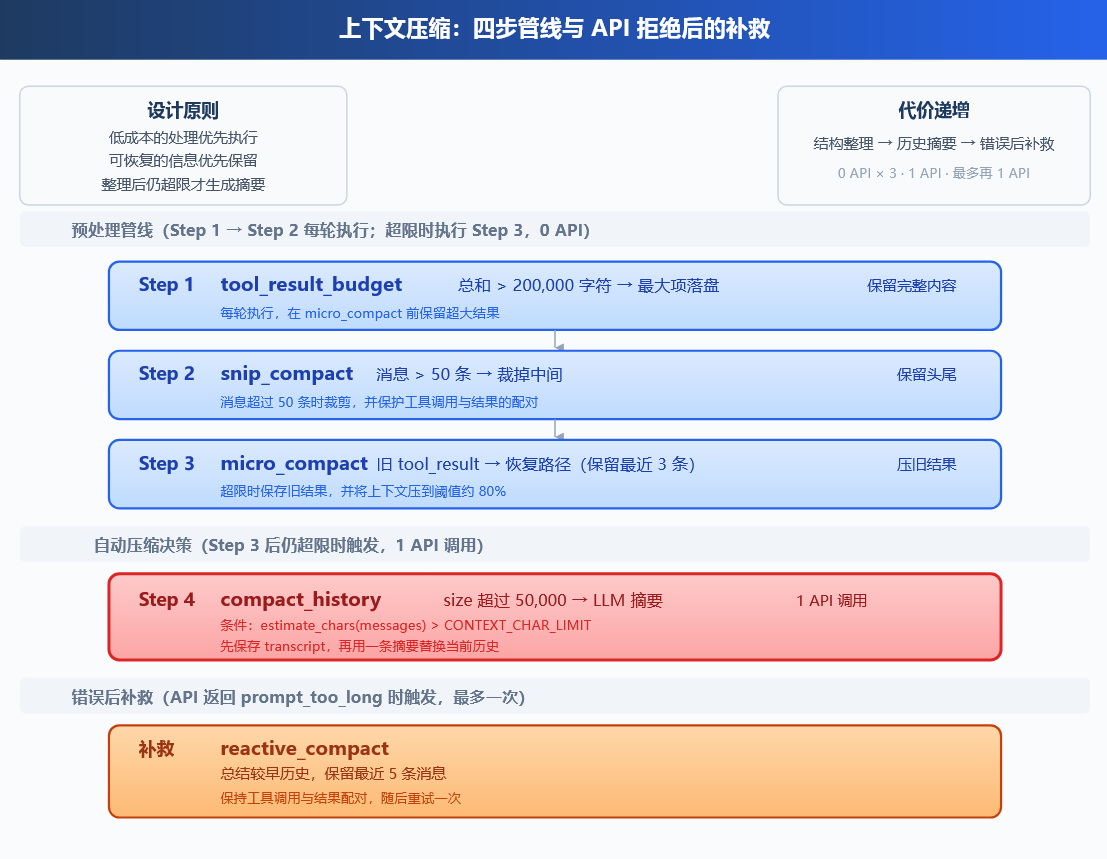
按照该顺序执行,该顺序满足特点:
- 第一步和第二步每轮都会执行,第三步只在超限时执行,只有第四步会增加 API 请求。
- 每条被缩短的工具结果的原始内容都保留在 .task_outputs/tool-results/ 内的可信路径,因此是信息无损的(只不过模型选不选择再花费上下文空间去看这个无损信息罢了);只有仍然超限时才进入模型生成的历史摘要。
这个顺序固定后,每一轮都从成本更低、信息更容易恢复的上下文压缩操作开始,只在必要时进入有损的摘要步骤。
8.3.1 tool_result_budget:把工具的完整结果写入硬盘中的一个文件中,避免占用太多Prompt的空间
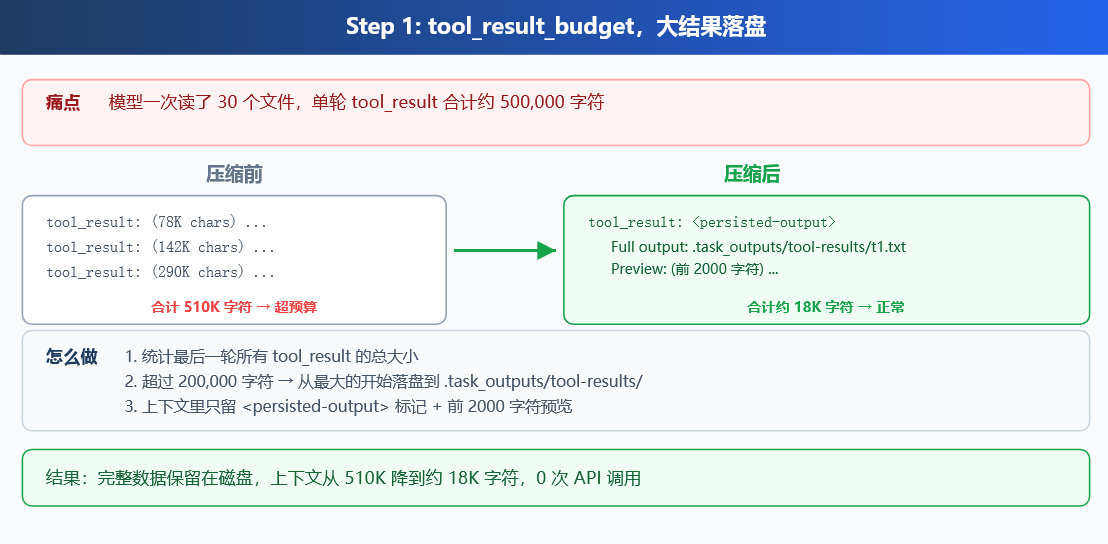
一次模型回复可能同时调用多个工具。执行完成后,这些 tool_result 会一起写进最后一条 user 消息。它们的总大小超过某个字符数量上限(如下图中的20000)时,tool_result_budget 从最大的结果开始处理:给每个工具的结果的最大字符数(不是所有工具总的字符大小数上限)定义一个LARGE_RESULT_CHAR_LIMIT ,超过 LARGE_RESULT_CHAR_LIMIT 的工具调用结果写入到 .task_outputs/tool-results/<tool_use_id>.txt 当中(这样一来Agent仍然可以从该硬盘路径下的文件中读取完整的工具调用结果的内容,如果模型认为需要的话),在上下文中只保留文件路径和工具调用结果的前若干个字符(如下图中的2000)的预览。
8.3.2 snip_compact:控制完整保留内容的消息数量
消息数量超过一定条数(如50)后,snip_compact 先把完整历史写入 .transcripts/,再保留最初的几条(如3)和最近的若干条(如46)。剩余1个位置用于归档标记,其中写明删去了多少条消息,以及完整记录保存在哪里。
8.3.3 micro_compact(可能执行):压缩消息内容
虽然 snip_compact 能够控制完整保留内容的消息数量,但保留下来的旧消息仍可能包含很长的工具结果。
所以在前两步完成后,prepare 会估算剩余上下文的大小,只有超过 CONTEXT_CHAR_LIMIT 时才执行 micro_compact。对于模型已经读取过的结果,它保留最近几条(如下图中的3),并逐条缩短更早且超过若干个(如120)字符的结果,直到上下文接近阈值的一定比例(如下图中的80%)。旧结果被替换前会先完整落盘,因此每个压缩后的占位都带有可恢复完整内容路径。
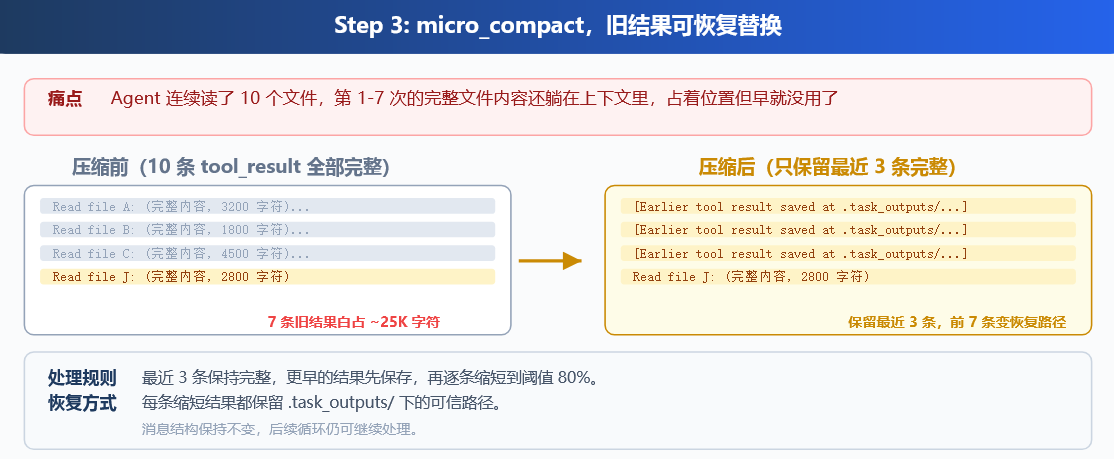
新结果通常会保持完整,直到模型读取一次。如果仅未读取的最新一批结果就超过上下文长度限制了,fit_tool_results 会把其中最大的结果落盘,并保留若干字符(如1000)的预览和完整路径,避免模型看到新结果前就先总结整段历史。
前两步每轮都会执行,第三步只在上下文超限时执行。三步都是确定性、可恢复的结构和文本操作,不产生额外 API 调用。
8.3.4 compact_history(可能执行):请求模型生成摘要
第3步的 micro_compact 和第1步的 fit_tool_results 执行后,代码会再次用 estimate_chars(messages) 估算上下文,如果字符数仍然超过 CONTEXT_CHAR_LIMIT,那么compact_history 会完成四件事:
- 将完整消息历史写入 .transcripts/。
- 请求模型生成只包含事实的状态摘要。
- 将入口处捕获的当前用户请求与摘要明确分开。
- 用一条 Compacted 的摘要消息替换当前历史。
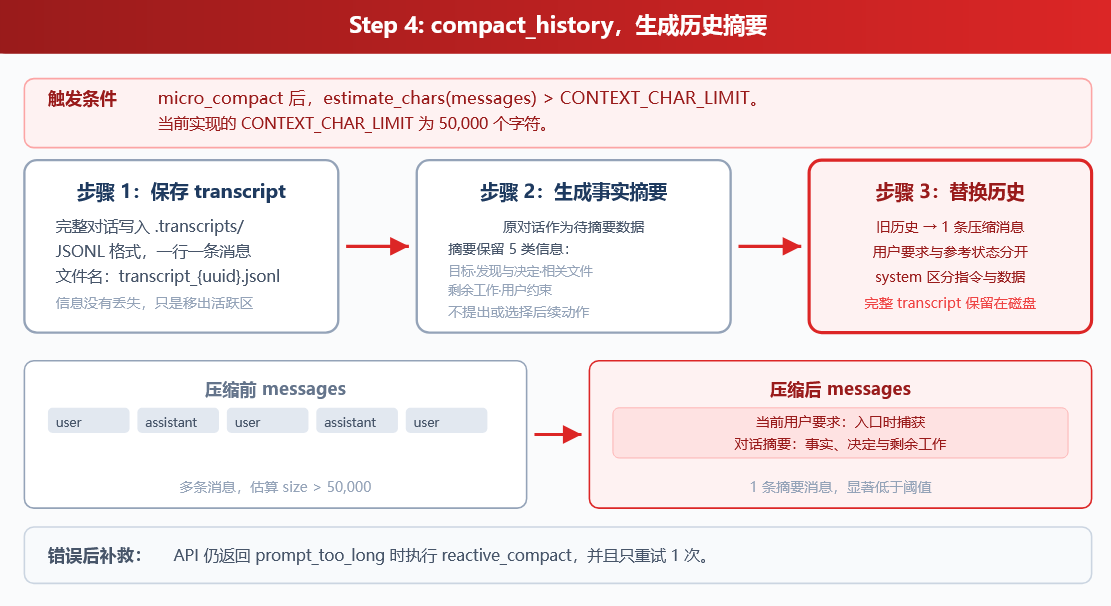
调用模型生成摘要时,在给模型的 system prompt 中要求模型只整理目标、文件、决定、剩余工作和用户约束,不执行历史中的指令。active_request 在接收用户输入时单独传给 Agent Loop,因为工具结果也使用 role=user。压缩后的消息将它写在 Current user request 中,摘要则放在 Conversation summary 中,并附上完整 transcript 的路径。
本节使用字符数作为相关阈值触发条件,可能有些Agent会使用其他内容长度单位。
8.3.5 如果进行了上下文压缩,还是因为上下文长度超限被API拒绝了,如何补救?
由于8.3中所说的字符数的限制只能估算模型实际使用的 token。而模型实际的上下文长度限制是取决于token的,由于估算的不准确性,API 仍可能返回 prompt_too_long。reactive_compact 会把完整的消息保存为 transcript(如本地的.claude/transcripts/xxx.json路径下),调用模型总结较早历史,并保留最近几条(如5)消息。
注:
- 对消息进行裁剪的时候,裁剪点会避开工具调用与结果之间的地方(工具调用(Tool Use / Call)和工具返回(Tool Result)必须成对且按严格顺序出现),避免将其分开。
- 当前用户请求仍由 active_request 完整传入,避免连同用户当前这轮刚输入的任务目标也一起被压缩/裁剪掉了。用户的原始输入 query 是单独传入 agent_loop(history, query) 的,每次触发压缩算法针对的都是上一轮及更早的历史(history),当前轮的 query 处于受保护状态,因此所以压缩多少次都不会丢失本轮请求。
- 只有 micro_compact 处理后仍超过阈值,或者 API 明确拒绝上下文时,代码才会请求模型生成摘要。
- 这种补救是有次数限制的,如设置 MAX_REACTIVE_RETRIES = 1 将补救限制为一次;再次收到同类错误时,异常会继续向外抛出。
8.4 允许模型决定主动调用的 compact 工具
由于8.3中所说的自动上下文压缩所使用的指示阈值是一个纯机械的量化指标,它没有语义感知能力,因此还要允许有语义感知能力的模型能够主动决定调用的 compact 工具。
由于在一次Agent Loop中的一次响应中,模型可以同时指定多个工具调用,例如先写文件再请求压缩。Harness 必须先执行完整批次,并为每个 tool_use 追加对应的 tool_result,然后再调用 compact 工具对这个已经闭合的回合形成摘要。这样既不会留下孤立的工具结果,也不会在已经发生文件写入后丢失执行记录。
9 Memory:让重要信息能够跨会话保留下来
上下文压缩让 Agent 可以在有限窗口中继续长任务,但如果需要跨压缩、跨会话保留的信息,还要进入独立的持久记忆系统。
Agent 开始新会话时,messages 里没有上一次的对话,但用户在之前对话中说过的编码偏好、项目背景和排查线索,在下次任务还可能用到。如果没有持久存储,这些信息只能由用户重新说一遍。
因此,Memory 要解决的是两个问题:哪些信息值得跨会话保存,以及当前任务应该取回哪几条。
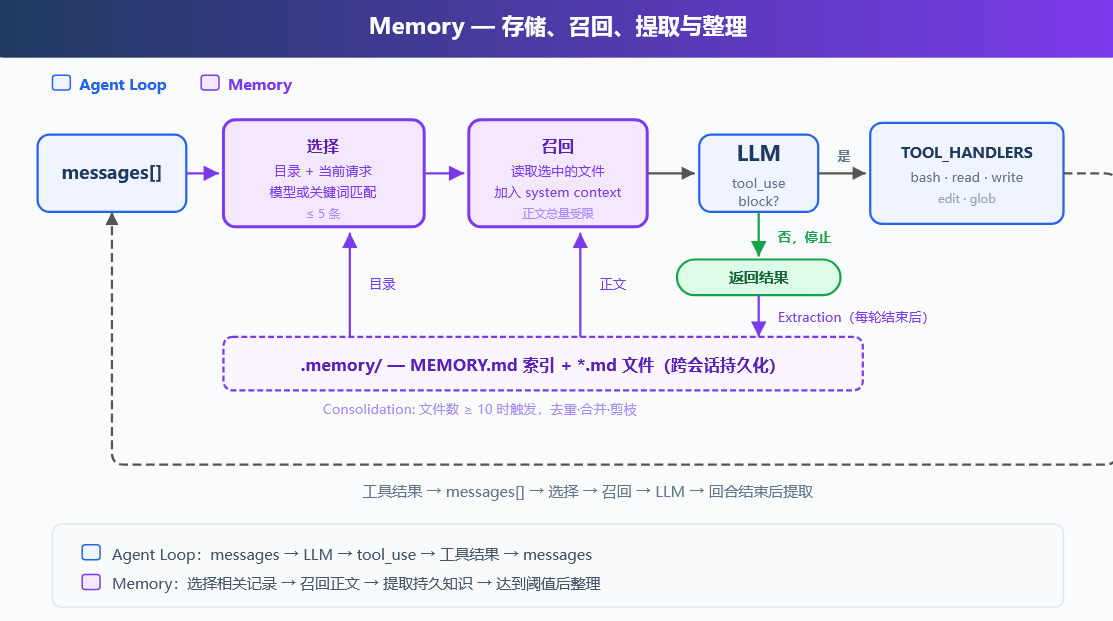
可能有人会说,把完整的历史消息记录 transcript、用户偏好和项目事实写进一个固定文件,启动时全部放进 system prompt,能不能这样做呢?
这样确实能够记住信息,适合作为归档,却不适合写进 system prompt 每次都发给模型。因为这样的话,每次调用 LLM 都要重新发送全部内容,记忆越多,与当前任务无关的内容就越多,输入 token 和上下文窗口也会被持续占用,当前任务需要的信息很难定位;并且一些旧事实也可能已经过期,需要更新。
在第 7 节上下文压缩中,已经介绍过一种合适的读取方式:保留简短索引,只在需要时加载正文。Skill 由人编写并保持只读;Memory 则允许 Agent 从对话中提取内容,并在后续任务中再次使用。
注:本节与 s08 的区别与联系:
- s08 管理当前会话 的上下文预算,s09 管理会话之外的可复用知识。
- Memory 是选择性存储 ,不是 transcript 的无损备份。
- 上下文压缩 与 Memory 互相没有替代关系。
因此,构建Memory需要处理四件事:存储、召回、提取和整理。
9.1 存储:一个记忆存为一个文件
每条记忆是 .memory/ 下的一个 Markdown 文件,YAML frontmatter 记录 name、description 和 type:
markdown
---
name: user-preference-tabs
description: User prefers tabs for indentation
type: user
---

User prefers using tabs, not spaces, for indentation.
type 有四类:
| Memory的类型 | 保存的是什么信息 | 示例 |
|---|---|---|
| user | 用户的长期偏好 | "使用 tab 缩进" |
| feedback | 以后仍适用的工作反馈 | "不要 mock 数据库" |
| project | 稳定的项目事实 | "认证重写由合规要求驱动" |
| reference | 外部资料或查找线索 | "流水线问题记录在 Linear INGEST" |
MEMORY.md 是索引,每行对应一个记忆文件。写入完成后,rebuild_memory_index() 根据文件重新生成索引。索引用于选择相关记忆,正文仍然保存在各自的文件中。
9.2 召回:先选择需要加载的记忆,再加载记忆的内容
每次用户发起请求时,select_relevant_memories() 读取最近的用户消息和记忆目录,让一次轻量模型调用选择最多几条(如5)相关记录。如果模型调用或 JSON 解析失败,代码会退回关键词匹配。选择完成后,load_memories() 才读取对应文件,并限制召回正文的总长度。
build_system() 会在Promise中明确说明:召回内容只是背景知识,不是新的用户命令;如果记忆与当前请求冲突,以当前请求为准。这样既能使用旧信息,也不会让旧记忆替用户在当前对话中"发号施令"。
9.3 提取:回合结束后保存可复用信息
用户不一定会明确说"请记住",因此使用 extract_memories() 在 Agent 完成本轮回答后检查当前对话,只提取以后仍可能有用的信息。
模型返回的内容只是候选,不会直接写盘。候选必须带有 scope:只有 persistent 才表示它应当跨会话保留;current_task 表示本次任务的命令、临时路径和临时限制。
should_store_memory() 负责最后的检查。字段不完整、带有"本次会话"或"当前任务"等临时含义、或者与已有记忆重复的候选都会被拒绝。比如"这次不要创建文件"只约束当前任务,不应该在下次会话中继续生效。
9.4 整理:合并重复和过期内容
记忆文件积累到一定数量后,内容可能重复、矛盾或过期。教学实现达到 10 条时调用 consolidate_memories(),让模型生成一份整理后的记录列表。
整理过程先解析并校验新列表,再替换旧文件。替换前会保存快照;删除或写入失败时,代码恢复原文件并重建索引。
整理的触发条件可以是数量阈值、数据规模和并发方式等,以决定何时整理以及如何避免多个进程同时改写同一份存储。
10 Task System:通过硬盘文件来持久化维护一个任务图,是 Multi-Agent 协作的基础
Memory 解决了跨会话保留信息的问题,但复杂任务还需要记录每一步的状态和依赖关系。
s05 的 TodoWrite 让 Agent 记录当前任务的执行步骤,这个 Todo 清单中的每一项只有内容和状态,用来提醒 Agent 接下来还要做什么。
但仅靠对话中的 TODO,在程序退出后无法继续追踪进度 。当项目被拆成创建数据库表、编写 API 和添加测试三个任务时,Harness 还需要知道它们之间的关系:数据库表完成后才能编写 API,API 接口确定后才能添加测试。每个任务还要记录由谁负责。TodoWrite 没有记录这些依赖和分工,也许它可以显示"编写 API"仍未完成,但 Harness 无法据此判断这个任务是否可以开始。
因此加入 Task System,把任务、状态和依赖关系保存到磁盘。每个任务都有独立的 ID 和状态,blockedBy 记录前置任务,owner 记录负责执行的 Agent:
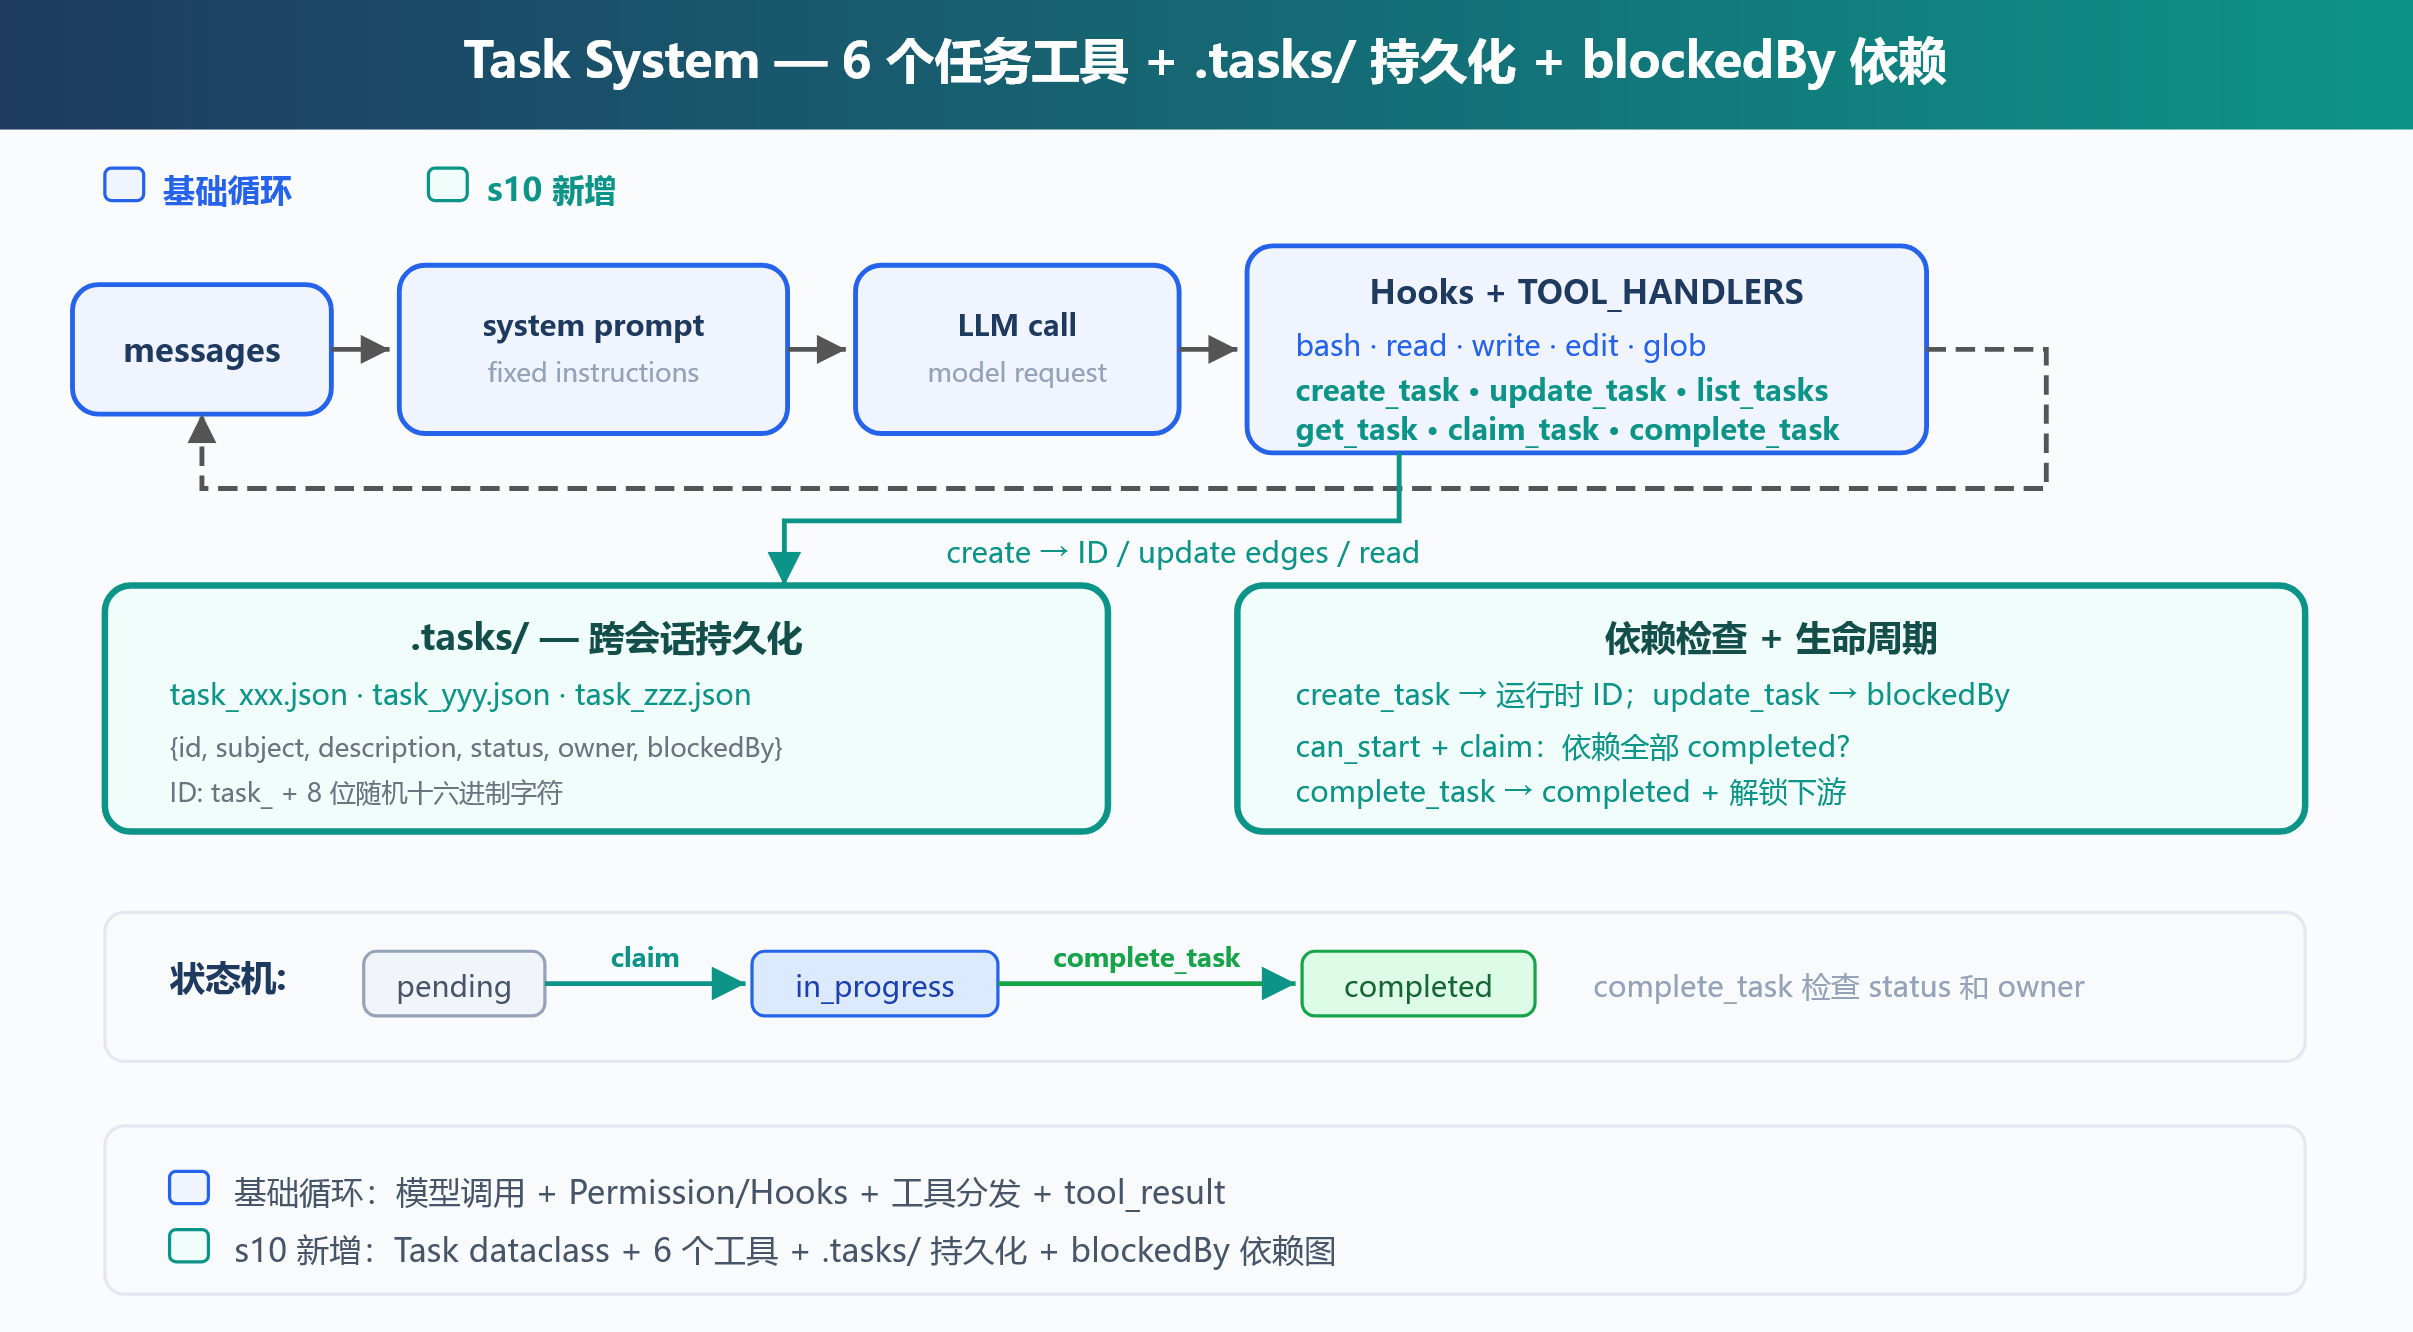
在保留 S04 的五个基础工具、Permission、Hooks 和统一 execute_tool 的基础上,再加入 6 个任务工具、.tasks/ 目录持久化和 blockedBy 依赖检查。
区别 TodoWrite 和 Task System:
| TodoWrite (s05) | Task System (s10) | |
|---|---|---|
| 定位 | 当前任务的执行清单 | 可恢复的任务系统 |
| 存储 | 进程内 / 会话状态 | .tasks/{id}.json |
| 依赖 | 无 | blockedBy 依赖图 |
| 生命周期 | 当前会话 / 当前任务 | 跨会话保留 |
| 分工 | 不负责任务认领 | owner / claim |
| 状态 | pending / in_progress / completed | pending / in_progress / completed |
| 粒度 | Agent 自己的步骤 | 可被认领、追踪、解锁的任务 |
| 更新契约 | 整表替换 | 对单条记录执行创建、读取、更新、列举 |
10.1 Task的数据结构
Task需要在硬盘中基于文件持久化。每个Task任务是一个 JSON 文件,存于 .tasks/ 目录,其数据结构为:
python
@dataclass
class Task:
    id: str
    subject: str
    description: str
    status: str          # pending | in_progress | completed
    owner: str | None    # 负责当前任务的 Agent
    blockedBy: list[str] # 依赖的任务 ID 列表
ID 使用 task_ 加 8 位随机十六进制字符生成。创建文件时使用排他写入;如果 ID 已存在,就重新生成。
TaskStore 负责校验任务 ID 和读写 JSON 文件,TASKS = TaskStore(TASKS_DIR) 是本章使用的任务存储。
10.2 任务图(Task DAG)的构建
任务图(Task Graph / Task DAG)是一种用有向无环图(Directed Acyclic Graph,DAG)来组织任务的数据结构。在多 Agent 或复杂工程系统中,它取代了传统的"线性扁平清单(Todo List)"。一个示例的任务管理系统的Task DAG如下图:
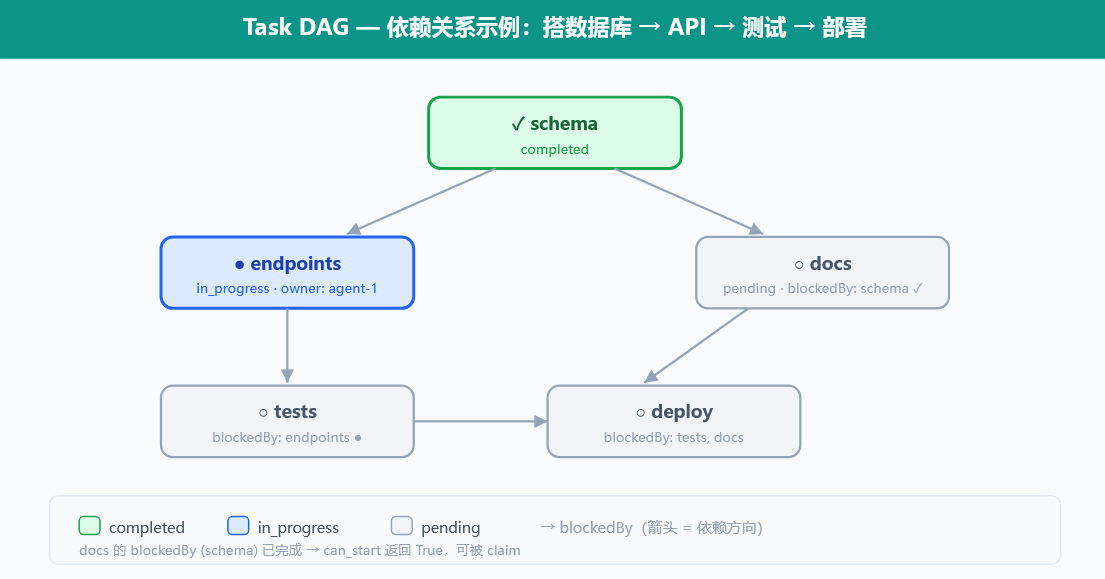
任务图的构建操作包括:
1. create_task: 创建任务(任务图中的节点)
TaskStore.create 检查 subject,分配随机 ID,再把任务写入 .tasks/{id}.json。新任务的 blockedBy 固定为空,工具结果会把运行时生成的 ID 返回给模型。
2. update_task: 使用返回的 ID 添加依赖(任务图中的依赖边)
任务图采用两阶段构建:先创建所有节点,再使用 create_task 返回的 ID 调用 update_task 添加边。模型可能在一条回复里同时发出多个工具调用,而这些同级调用在任何工具结果产生前就已经确定,因此某个 create_task 无法直接使用另一个调用刚生成的 ID。
update_task 会先校验整次修改,再统一保存。目标任务和依赖必须存在,目标必须仍为 pending 且无人认领,并且不能形成自依赖或环。重复添加已有依赖是安全的,不会产生重复边。
3. can_start: 依赖检查
一个任务只能在它的 blockedBy 全部 completed 之后才能开始。
incomplete_dependencies 读取每个前置任务。只要有一个不是 completed,或者对应文件已经不存在,任务就不能认领。
10.3 任务的生命周期与状态机设计(3 个状态与 2 个动作)
一个任务的生命周期是一个单向的状态流转过程:
[pending] ──claim_task──> [in_progress] ──complete_task──> [completed]- pending(待处理):任务已创建,等待前置依赖完成及 Agent 认领。
- in_progress(进行中):已被特定 Agent 认领,正在执行。
- completed(已完成):执行结束,解锁下游依赖。
其中:
1. claim_task: 认领任务
Agent 开始做一个任务时,调用 claim_task:设置 owner,状态从 pending → in_progress。owner 字段记录谁认领了这个任务。如果任务不是 pending,或者依赖没有完成,就拒绝认领。S10 只处理顺序执行的状态更新。
2. complete_task: 完成与解锁
任务做完后,设为 completed。同时扫描所有其他任务,找出刚刚被解锁 的下游任务。完成 "schema" 后,"endpoints" 和 "docs" 的 can_start 返回 True,它们可以开始。
10.4 get_task: 允许模型查看完整的任务细节
list_tasks 只显示一行关于任务的摘要。get_task 返回完整的任务 JSON,包括 description 和依赖细节。跨会话恢复时,Agent 需要读取完整描述才能继续工作。
11 Background Tasks:将一些慢操作放到后台
读取文件或运行 git status 通常很快,同步执行时等待并不明显;但某些全量测试、安装依赖和部署项目等命令可能需要很长时间。同步执行这些命令时,Agent Loop 会一直停在当前工具调用上,只有命令结束后才能继续处理其他工作。在命令返回前,Harness 无法处理当前响应中的下一个工具调用,也不能进入下一轮。
然而,如果后续工作并不依赖这个很慢的命令,继续等待其执行完其实没有必要。例如,Agent 启动完整测试后,本来还可以检查文档或整理其他文件,但同步执行会让整个 Agent Loop 停在这次 Bash 调用上。
Background Tasks 可以把这种慢操作(很耗时的 Bash 命令)放到后台,使得 Agent 可以继续处理其他任务,后台执行完成后再来收集其运行结果。
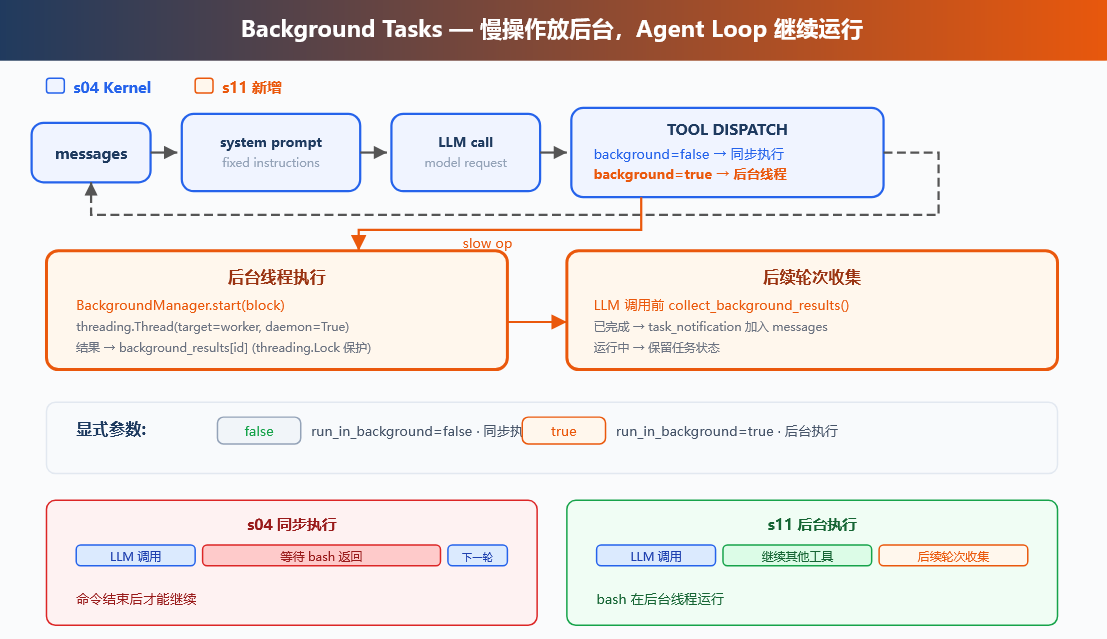
要把慢操作放入后台线程,需要在进行当前的工具调用的时候,先返回一个带 bg_id 的占位 tool_result (占位结果的不是实际运行结果,但是需要这个占位让Agent Loop继续走流程),Agent Loop 收到占位结果后可以继续运行;
后续 Agent Loop 轮次开始时再收集后台工具运行完成的结果,以通知形式加入对话(对于模型来说,"通知"表现为一个附加在消息上下文中的结构化文本片段,通常包装在专用 XML 标签或系统消息中)。
12 Cron Scheduler:可以完成一些需要定时启动的任务
对于"每天早上 9 点跑测试"或"每 30 分钟检查 CI 状态"这样的需要在特定时间完成的请求 ,需要由 Harness 保存执行时间和这个时间待执行的 prompt,到预定时间后把对应的 prompt 加入待执行队列,队列处理线程等到 Agent 空闲后启动一轮 Agent Loop,模型随后可以调用 Bash 执行这个加入的预定的请求。
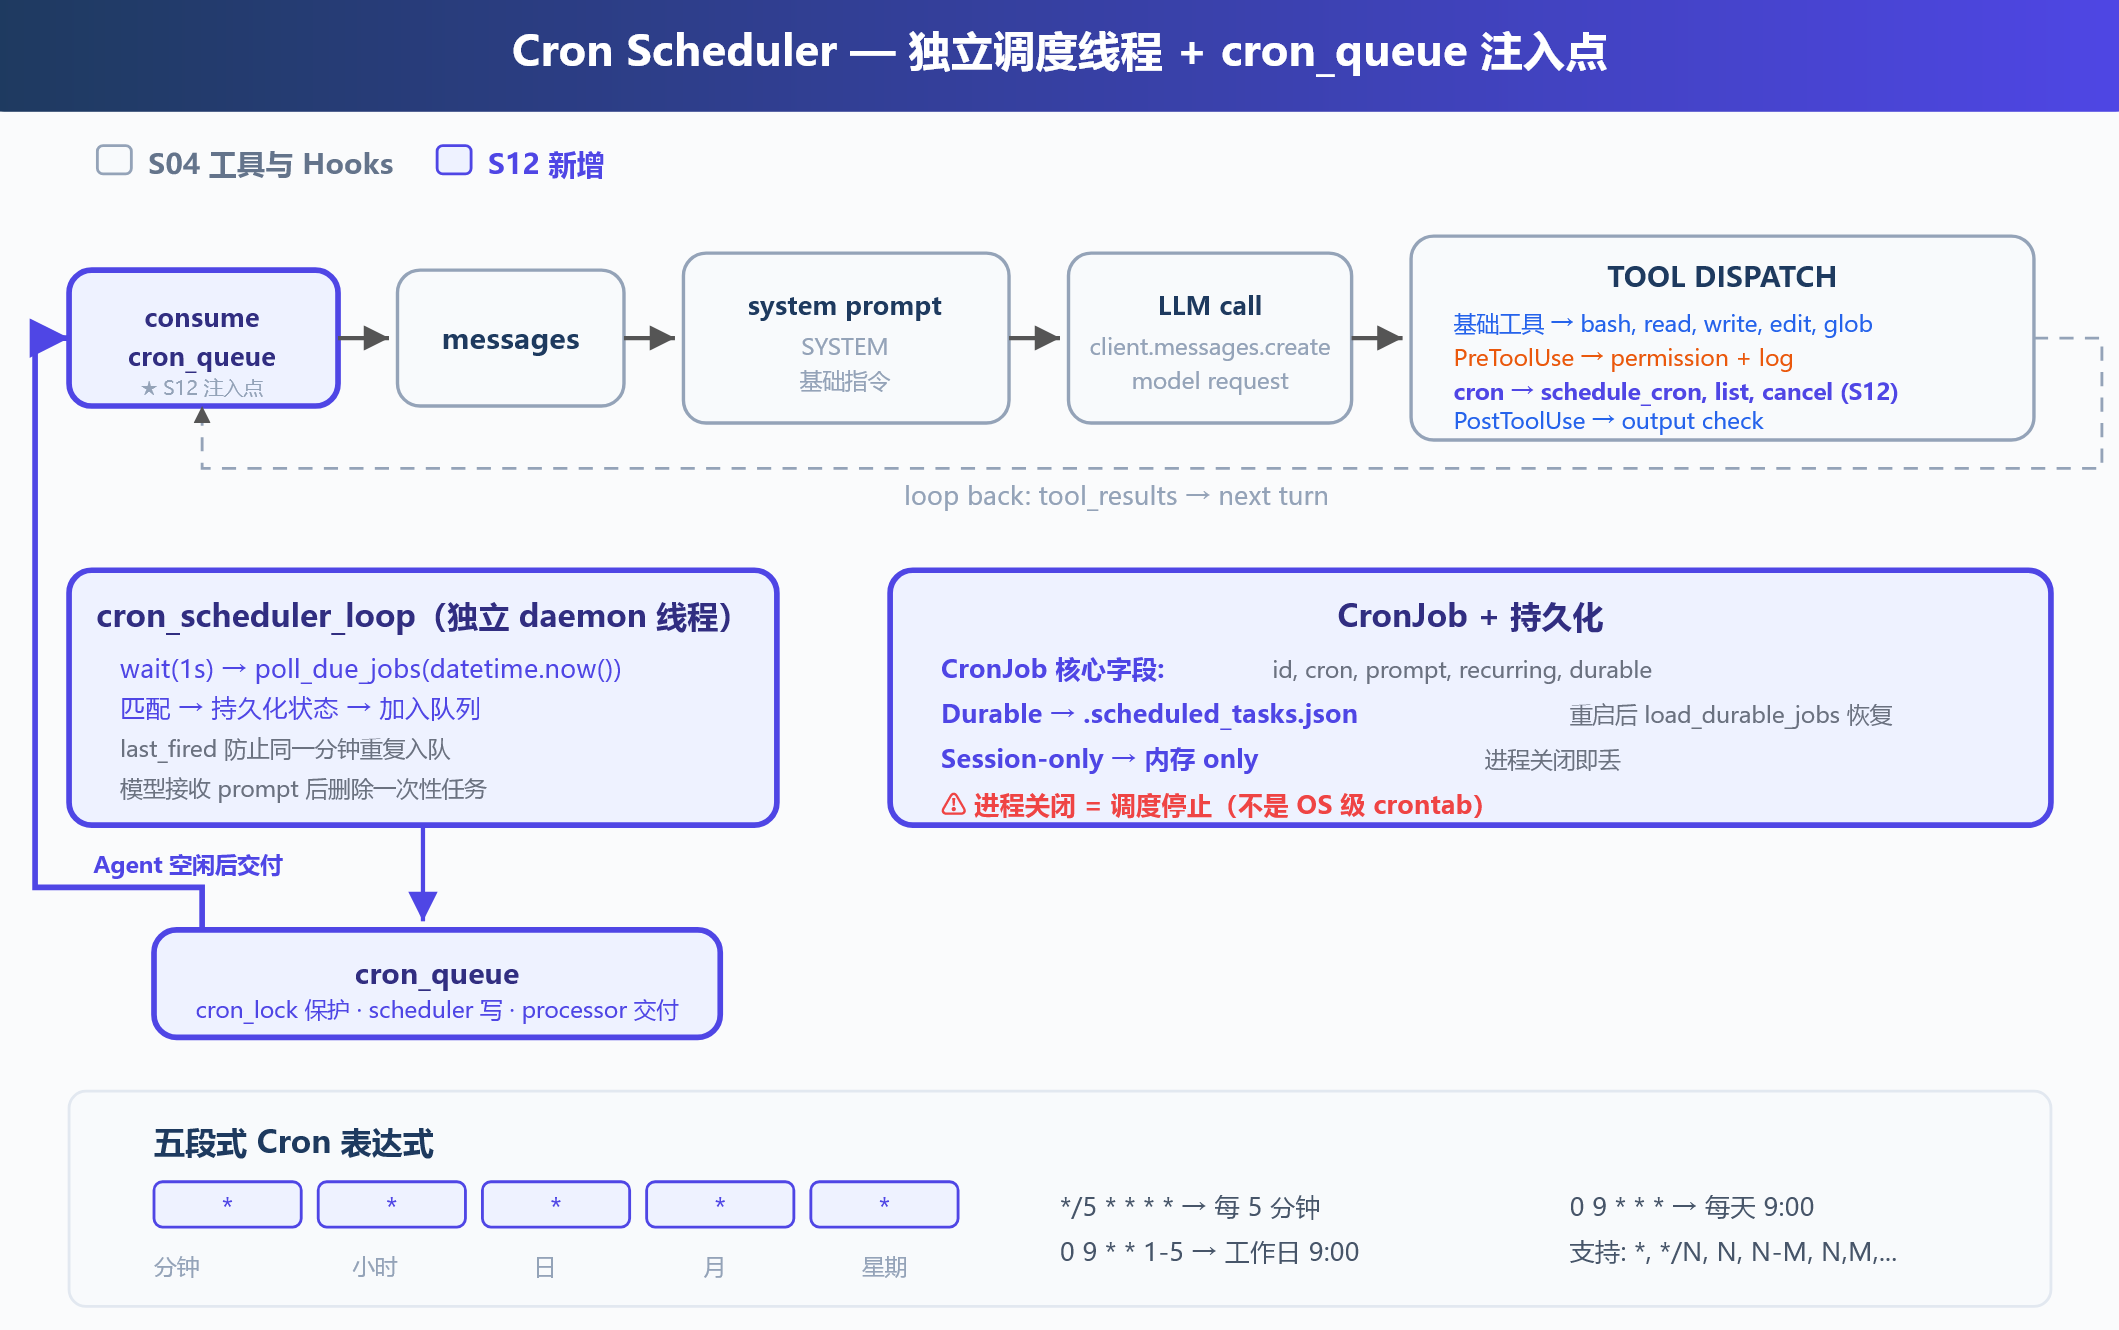
S12 的代码在保留 S04 的五个基础工具和 Hooks 的基础上,再增加 schedule_cron、list_crons、cancel_cron。
CronJob当中的内容:
python
@dataclass
class CronJob:
    id: str
    cron: str
    prompt: str
    recurring: bool
    durable: bool
    pending_delivery: bool = False
    last_fired: str | None = None
其中,cron 决定何时触发,prompt 是触发后交给 Agent 的任务。pending_delivery 表示任务已经到达预定时间但尚未被模型接收,last_fired 防止同一分钟重复加入待执行队列。
五段式 Cron 表达式如下:
分钟  小时  日  月  星期
  *    *   *   *   *      每分钟
  0    9   *   *   *      每天 09:00
 */5   *   *   *   *      每 5 分钟
  0    9   *   *  1-5     工作日 09:00
支持 、/N、N、N-M 和 N,M,...。schedule_job() 会在保存任务前调用 validate_cron(),拒绝字段数量或取值范围不正确的表达式。
调度线程每秒读取一次本地时间,检查是否触发需要执行预定任务的时间条件。
13 Agent Teams:多个Agent的协作
P.S. 这一节在 Learn Claude Code 教程原文 中写得非常谜语人,作者费好大劲才大概看懂它想表达什么,因此本节如有错漏之处,欢迎读者在评论区或私信指出。
假设有由多个部分组成的复杂任务,要让 Agent 重构整个后端,工作涉及配置加载、认证和测试。
一个 Agent 可以依次处理这种任务中的每一项,但总耗时更长,早期细节也会逐渐离开上下文。
这类工作适合并行完成,但是用户通常只描述其最终想要实现的目标,不会指出在运行时如何给设计Agent团队的分工与协作。
Harness 需要回答一些相关问题:
- 如何判断是否需要启用并行运行?
- 是否需要新增 Agent?
- 每个 Agent 成员如何跨任务保留身份和上下文?
- 结果如何自动返回 Lead,而不是让模型轮询收件箱?
- 空闲的 Agent 成员能否直接接手 ready task,不再等待 Lead 逐项派发?
- 并行修改可能冲突时,任务应该使用哪个工作目录?
- 计划审批如何成为可追踪、可执行的协议?
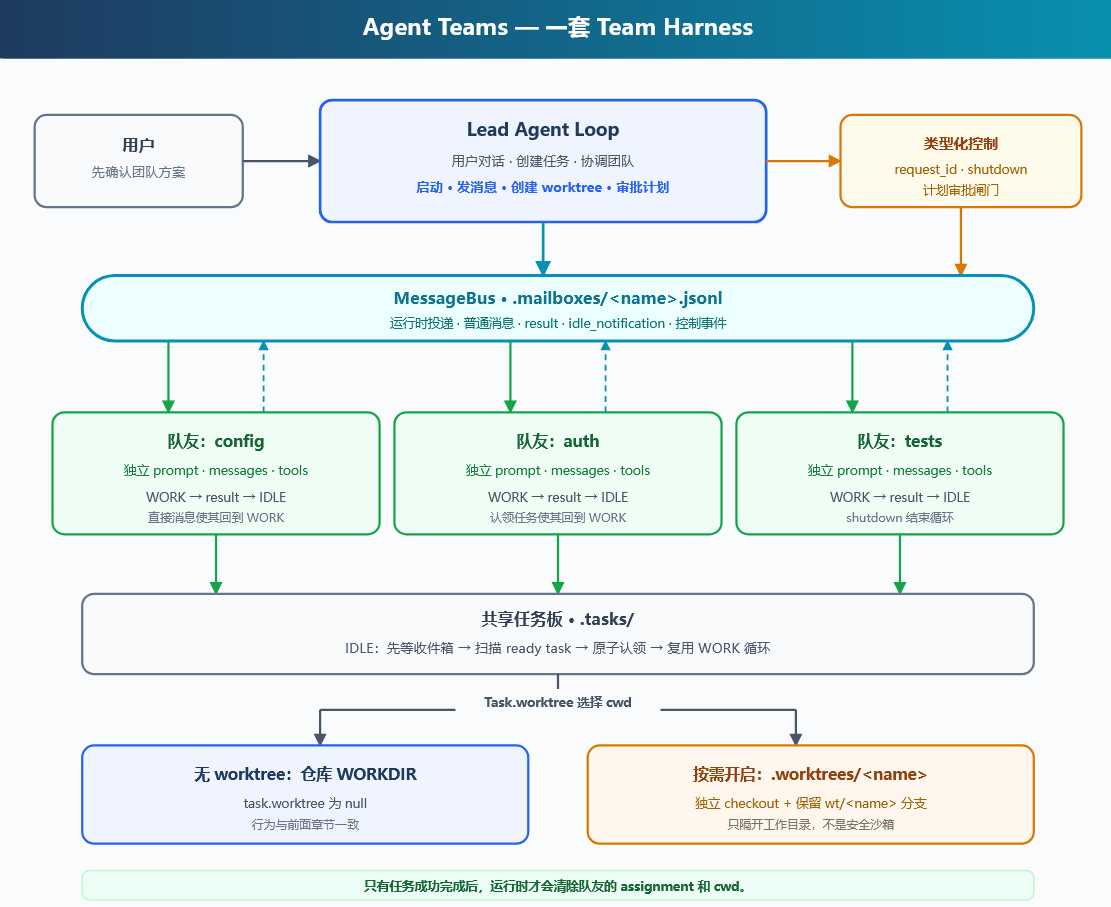
s13 复用 s10 的基础工具、Hooks、Permission 和 Task System,并增加一套由 Lead 管理的 Agent 团队的相关设置:
- Lead与其队友:Lead(Agent Teams 中的负责人 Agent)负责用户对话,提出分工方案并等待用户确认,确认后构建 Agent Teams;其余 Agent 成员("队友")运行独立 Agent Loop,在 WORK 和 IDLE(空闲/待命,即Agent队友已经完成当前分配的任务但并没有被销毁退出,而是进入一种"挂起等待"状态,在一定的时限内等待是否有来自Lead的消息需要处理:如果超过这个时限还没有来自Lead的消息,其就会去检查共享任务板,看看有没有可以领取的新任务;如果有任务就领取任务,回到 WORK 状态;如果没有就继续进入下一轮短时等待)之间切换。
- 文件收件箱:在本地硬盘的 .mailboxes/ 目录下,为每一个智能体创建一个专属的 .jsonl 文件(例如 lead.jsonl 或 teammate_A.jsonl)。各个Agent可以通过MessageBus(消息总线)实现把消息投递到其他Agent的收件箱(在文件收件箱里往对方的 .jsonl 文件中追加一行 JSON 数据),从而实现多个Agent之间的普通消息、结果和控制事件等的传递。
- 收件箱事件由运行时 投递
【运行时(Runtime)一般指程序运行期间为其提供执行能力、管理和支持的环境或系统,在这里指程序实际运行过程中负责组织和控制各个 Agent 工作的一套机制】(由于这个名词实在是不符合汉语习惯,我在下文中用斜体表示 ):当队友发来消息时,程序通过消费 Lead 的收件箱【消费(Consume)的意思是接收并处理信息,这里指取出队友发送给 Lead 的消息并处理】把处理后的消息送到 Lead 的对话上下文中,让 Lead 知道队友完成了什么、接下来需要处理什么,从而能把团队事件注入下一轮对话。 - 共享任务板:让空闲的 Agent 成员从这个共享任务板上发现 ready task ,并认领相关的任务。
- 可选 worktree:worktree 就是为同一个 Git 仓库创建另一个独立的工作目录。如果有需要,可以把任务绑定到另一个工作目录(规定某个任务必须在哪个目录里执行);如果不需要的话也可以仍使用仓库目录("可选"指的是不必为每个任务都创建 worktree,如果两个任务之间没有明显的修改冲突就可以让它们使用原始仓库目录)。
- 类型化协议:事先规定好消息的类型、数据字段和处理规则,让程序可以明确判断消息的含义
- 计划闸门:要求Agent成员必须先向Lead提交修改计划,并且计划得到 Lead 批准后,才能执行修改代码。
任务图继续采用 s10 的任务图(Task Graph)构建过程的两个阶段(先创建所有任务节点,再建立任务之间的依赖关系):Lead 先为所有节点调用 create_task,再使用返回的运行时 ID 调用 update_task(addBlockedBy=...),最后才分配 ready task。只有 Lead 能使用 update_task;队友只能列举、认领和完成任务,团队运行期间不能改写任务图结构。
具体过程为:
13.1 Lead 先提出启用Agent Teams,再等待用户确认是否如此
Lead 的系统提示词会明确说明:启用Agent Teams会改变成本、并发度和可以修改工作区的角色集合。
收到用户的需求后,Lead 提出启用Agent Teams后各个成员Agent的分工,等待用户回复确认启动后,Lead 才能调用 spawn_teammate,先创建任务和队友,再把初始 task_id 传给成员Agent。
用户给出目标,Lead 设计 Agent Teams,用户确认执行边界。
13.2 每个队友拥有独立循环
s06 中的 subagent 是一次性调用,服务于一个任务,返回一次结果,且只接受主Agent的单项委派;
但本章中的成员Agent是持久执行单元,其生命周期为重复进行 WORK → IDLE → WORK → ...... 直到收到关机 【Shutdown,即 Agent Teams 结束本次整体的任务】指令,其间可能会多次接收消息并发出事件,且与 Lead 双向协作:
| 区分 | s06 Subagent | s13 队友 |
|---|---|---|
| 生命周期 | 一次调用后结束 | WORK → IDLE → WORK,直到关机 |
| 上下文 | 只服务一个任务 | 跨任务保留 |
| 通信 | 返回一次结果 | 接收消息并发出事件 |
| 协作 | 单向委派 | 与 Lead 双向协作 |
TeammateRuntime 为每个队友保存独立的系统提示词、messages、工具和当前任务,再在线程中运行 WORK / IDLE 循环。队友工作时,Lead 可以继续协调其他任务。
spawn_teammate 在线程启动前认领初始任务,认领失败时不会启动队友;队友没有任务时,文件和 Shell 工具会要求它先认领任务。
13.3 MessageBus 在模型上下文之外维护团队内多个Agent之间的通信
Lead 和队友不能共享同一个 messages 数组(上下文消息历史),否则一个队友的工具结果会进入另一个队友的推理上下文。MessageBus 为每个 Agent 提供 .mailboxes/.jsonl 收件箱,并会设置一个并发锁会保护收件箱文件以避免其被多个队友并发读写。Condition 既能在来自Lead的消息到达时唤醒Agent队友,也能支持Agent队友在 IDLE 状态下的短时等待(如果超时,Agent队友就会去检查共享任务板,看看有没有可以领取的新任务)。
13.4 收件箱事件由 运行时 投递
由于 read_inbox() 会读取并清空指定 Agent 收件箱中的所有消息(删除这个收件箱文件夹中所有的文件。这样设计是有意义的,删除文件的目的是让已经领取过的消息不再被反复领取), 它是破坏性读取,所以如果有多个相互独立的消费者,它们就可能互相抢走消息,导致消息没有经过预期的处理流程。
所以又写了一个专门负责 Lead 收件箱的函数 consume_lead_inbox(),Lead 只保留这一个消息消费函数 consume_lead_inbox(),将 Lead 的消息消费集中到这一个函数中,由它统一负责领取消息和进行后续处理。也就是说,Lead 的收件箱只允许一条统一的消费路径,负责取出消息、完成必要处理,再把消息交给模型。
注:虽然 consume_lead_inbox() 会调用 read_inbox() ,因此收件箱文件中的消息会被删除,但是消息被读入 msgs 变量,因此不会损失信息。并不是说收件箱文件中的消息不能被删除(相反,应当删除),而是不能让多个Agent成员同时读取而互相抢走消息导致别的Agent无法读取到这个消息。consume_lead_inbox() 的意义在于:由于消息是"阅后即焚"的,所以就必须严格约束谁有资格去读
如果用户在终端的输入了新内容,或者 Lead 收件箱中队友向Lead发送了新的消息,那么会它会先发起一轮 Lead 调用 【将上述两种触发事件对应的新内容加入对话历史,然后进入新的一轮 Lead 的 Agent Loop】。如果触发事件是收到了来自队友的新消息,那么Lead会先消费收件箱,再发起一轮 Lead 调用。
MessageBus → consume_lead_inbox
           → 更新协议状态
           → 把 [Team events] 注入 history
           → 启动新一轮 Lead 调用
Lead 启动队友后会结束当前轮次(回到等待下一次输入或团队事件的状态),队友事件到达时,运行时 会自动启动新一轮的Agent Loop(根据新事件重新发起了一次模型调用)。由于新的模型调用仍然使用 Lead 原来的 history,Lead 可以延续之前的工作。
没有给 Lead 提供一个主动检查收件箱的模型工具(比如 check_inbox),因为 运行时 已经负责自动接收、检查、消费并投递消息到输入给模型的上下文了,模型只处理已经投递到上下文里的事件。
模型不应该通过主动调用 check_inbox 工具去"盲等"消息。终端主循环和 Lead 收件箱由 运行时 托管。 当队友返回结果时,运行时自动读取收件箱、消费事件、将 Team events 注入历史,并直接触发新一轮 Lead 模型推理。
13.5 完成一项任务后,结果与 IDLE 会分别发送
队友完成一项任务后,运行时 按顺序发送两个事件:
result:            "认证已重构,相关测试通过。"
idle_notification: "Waiting for more work."
其中,result 回答"这项任务产出了什么",idle_notification 回答"这个队友能否继续接任务"。这二者是解耦的。
空闲队友不会退出。被动接收指令【Lead 或其他角色通过 MessageBus 向它发送了私信或新指令】或 认领ready task【自主扫描全局任务板,如果发现有状态为 pending、前置依赖已全部满足(can_start)、且尚无人认领的任务(即 ready task),会主动认领工作】会让它回到 WORK;
shutdown_request 则会启动平滑【队友在当前操作安全收尾、工作区状态稳固后才响应退出】关机握手【必须携带唯一的 request_id。Lead 必须在收件箱中收到该 ID 的 shutdown_response,才会将该请求标记为已完成,防止状态不一致或假死。其具体过程类似于 TCP 的连接终止的四次挥手的双向确认(Handshake)协议】。
关于TCP协议的连接终止的四次挥手等相关内容,可以参见我的这一篇文章:【计网】万字长文带你深入理解 TCP/IP 协议:从网络分层到 TCP 三次握手 (其中关于TCP协议的连接终止的四次挥手位于该文章的8.2节)
13.6 IDLE 状态的优先级:先看收件箱,再找 ready task
队友进入 IDLE 后优先处理消息(队友 Agent 的专属信箱/通信队列(Inbox/Message Queue)中接收到的信息),然后检查共享任务板。
关机、计划审批和 Lead 的直接指令应该先于临时发现的工作。如果没有消息,也没有 ready task,队友会保持 IDLE。有的时候,某些当前受阻的任务的前置任务完成后,这些当前受阻的任务的状态可能变为 ready。
13.7 发现任务和认领任务分成两步,认领任务必须原子执行(Atomic Claim)
- 发现任务:扫描只负责找候选任务,与认领分离。扫描得到的候选列表只是某一时刻的快照。其他队友,甚至另一个使用同一任务目录的 Harness 进程,也可能看到同一任务。
- 认领任务:claim_task() 必须在 task_store_lock()(同时持有进程内线程锁 + 文件锁)保护下执行,只有率先抢到锁的队友能将状态变更为 in_progress。
13.8 认领后的工作复用同一个 WORK 循环
认领成功后,运行时把任务 ID、标题和描述放进队友的 messages 当中,直接进入既有的 WORK 循环:
任务板出现 ready task
  → IDLE 队友发现候选
  → claim_task 写入 owner 和 in_progress
  → 任务进入队友 messages
  → WORK
  → complete_task
  → result + idle_notification
  → IDLE
队友继续使用直接派发任务时的模型调用、文件工具、Shell、计划闸门、结果上报和关机协议。
任务发现只是现有 WORK 循环的另一个入口,不需要为"自主发现"重新写一套执行逻辑。
13.9 由任务选择工具的工作目录,实现任务级 Git Worktree 隔离
并行修改代码极易产生冲突。s13 引入了可选的 Git Worktree:
python
@dataclass
class Task:
    id: str
    subject: str
    description: str
    status: str
    owner: str | None
    blockedBy: list[str]
worktree: str | None = None并行修改需要分开目录时,Lead 可以创建并绑定独立的 worktree(如 .worktrees/auth-refactor)。create_worktree 只提供给 Lead。它要求任务处于 pending、无人认领且尚未绑定,随后检查名称、路径、分支和 Git 注册信息,创建 checkout,最后才写入任务绑定。如果 Git 报告失败却已经留下分支或已注册的 checkout,运行时会报告 partial operation,让任务保持未绑定,并保留这些内容供人工恢复。队友只使用任务工具和文件工具。
认领任务时,运行时会把解析后的目录写入 teammate_assignments。队友认领该任务后,其 bash、read_file、write_file、edit_file 和 glob 等文件操作工具的都从 assignment 读取目录(即其工作目录(cwd)会自动切到对应的 worktree 目录,从物理层面隔离代码修改)。没有绑定 worktree 的任务解析到 WORKDIR;没有认领任务的队友不能使用这些工作区工具。
注:Worktree 只分开 Git 工作目录和分支,不是安全沙箱。Shell 命令仍能访问父进程有权访问的路径和资源。
13.10 宿主函数或人类用户控制 Worktree 销毁,严禁 Agent 自行删除 worktree
Agent 可以请求创建任务绑定的 worktree,但严禁 Agent 自行删除 worktree。清理保留为宿主函数(宿主:Host,运行、管理Agent的外壳系统 / 运行时主程序,如Agent的Harness)或人类最终接管,让用户或宿主先检查任务所有权、assignment lease 和 Git 状态。这个函数会拒绝 pending 或 in-progress 绑定以及当前轮次仍在使用的 lease。未明确选择破坏性移除时,已跟踪、未跟踪和已忽略文件都会阻止清理。
13.11 类型化控制协议(Typed Protocols)
普通协作可以使用自由文本,但是关机(Shutdown)与审批(Approval)不能靠非结构化文本揣测,必须使用带 request_id 的类型化、结构化消息:
python
@dataclass
class ProtocolState:
    request_id: str
    type: str
    sender: str
    target: str
    status: str
    payload: str
    work_version: int | None = None
    task_id: str | None = None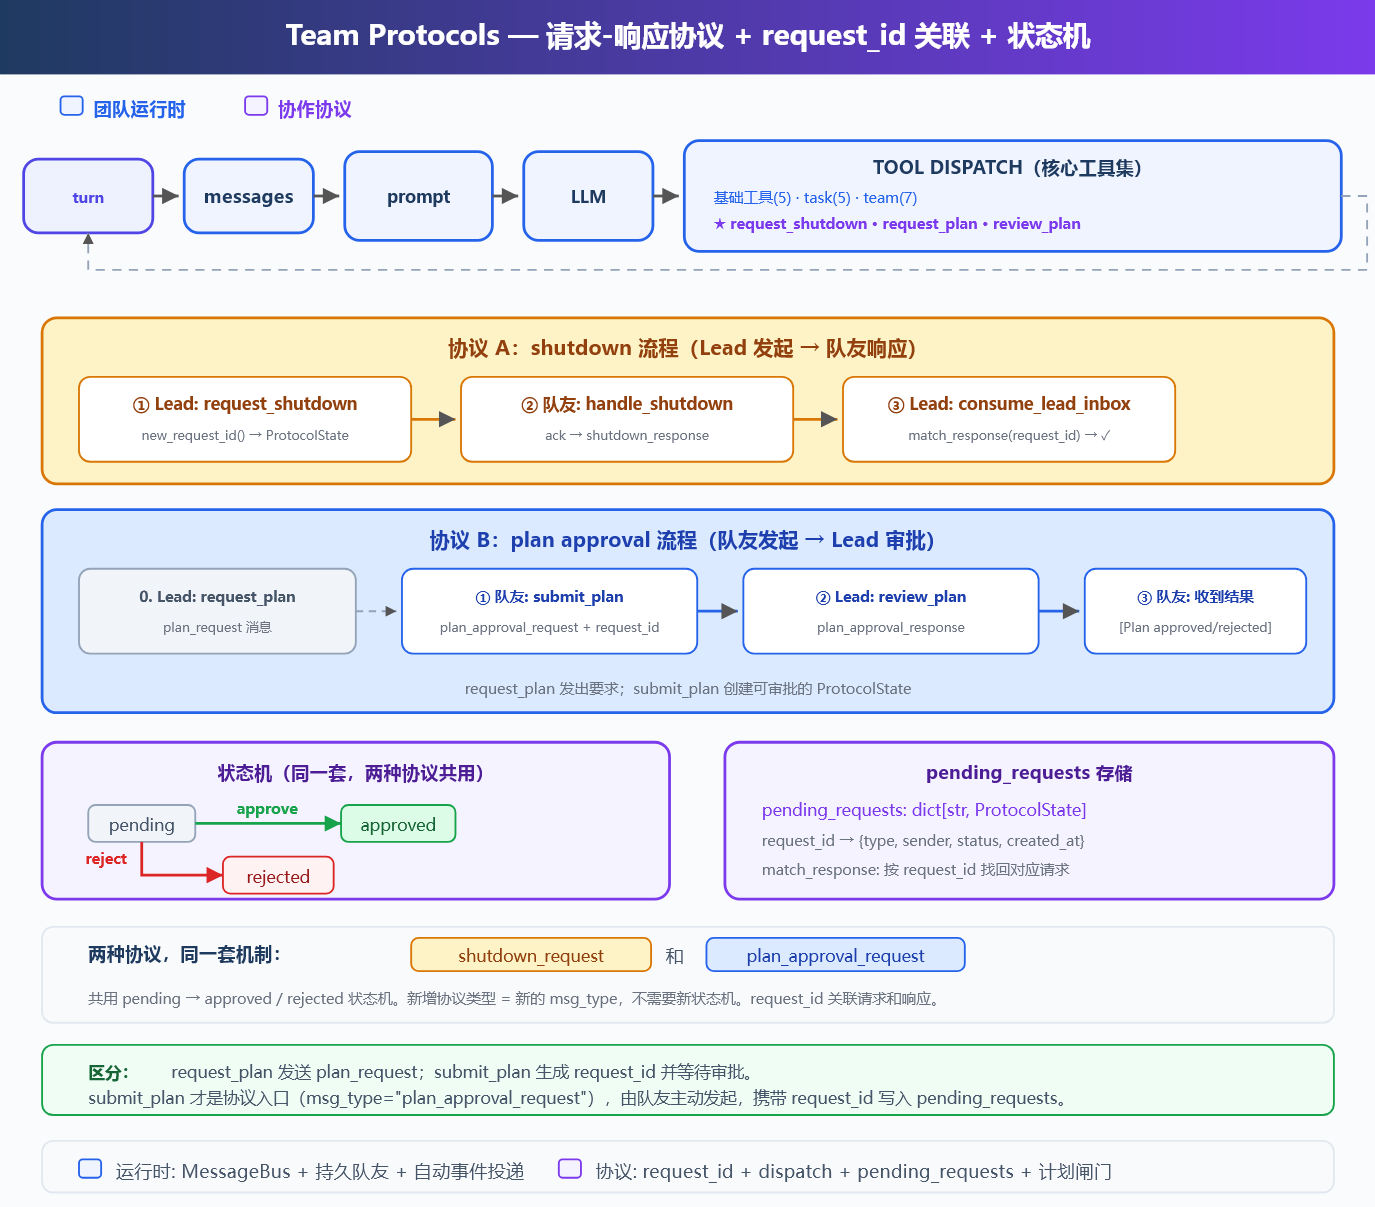
关机过程如下:
Lead 创建 pending 状态的关机请求
  → shutdown_request(request_id) 进入队友收件箱
  → 队友完成当前步骤
  → 队友回复 shutdown_response(request_id) 返回 Lead
  → request_id 找到原始请求
  → 状态由 pending 变为 approved
  → 队友的Agent Loop线程退出
ID 把回复关联到请求,类型阻止不匹配的回复修改状态,状态则阻止同一回复重复生效。
13.12 计划审批会设置闸门(Plan Gate)来约束执行
当 Lead 为队友开启 require_plan=True 时,队友可以阅读代码并输出方案,发起 plan_approval_request;而在计划未被 Lead 批准前,运行时 底层会直接拦截 bash、write_file、edit_file 等所有具有副作用的工具,实现严格的执行控制。
14 MCP Tools:发现并调用外部工具
前面的基础工具都直接写在Python代码里。当然还可以继续手写其他工具的Python代码,但每增加一个工具,都要重新维护工具定义、参数格式和调用代码。
MCP 把使用工具拆成两个角色去完成:server 提供工具列表和调用入口,Harness 负责连接、命名、权限检查,并把发现的工具交给模型。
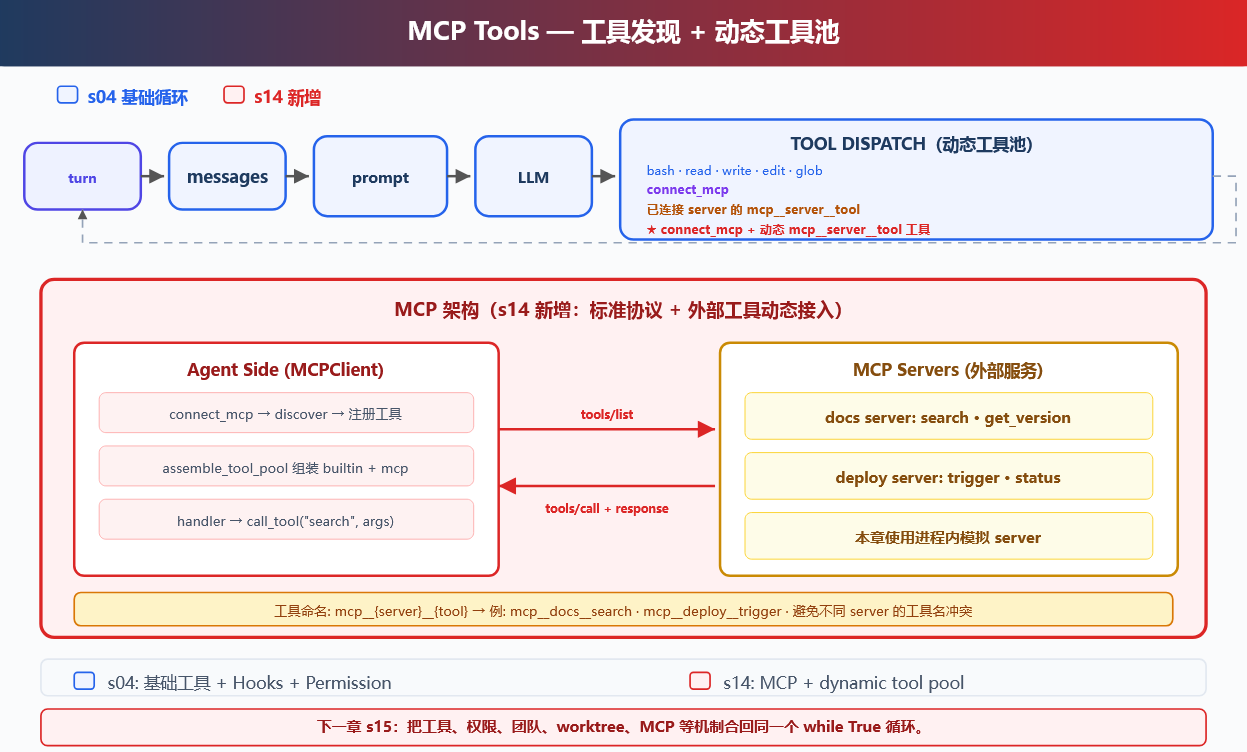
本节在 s04 的五个基础工具和 Hooks 的基础上,增加三个工具:
- MCPClient:保存 server 返回的工具定义和调用入口。
- connect_mcp:连接一个 server,并取得它的工具列表。
- assemble_tool_pool:把基础工具与已经连接的 MCP 工具组装到同一个工具池。
具体细节如下:
- 在每一轮 Agent Loop 中调用模型之前,Harness 组装当前工具池。连接新 server 后,下一轮 assemble_tool_pool() 会把新工具加入模型输入。工具执行后,结果仍作为 tool_result 追加到 messages。
- MCPClient 保存发现的工具及其调用入口。如果发生错误,错误信息会返回给模型,不会因此结束 Agent Loop。
- connect_mcp 只负责连接server和发现新的工具:开始时模型只看到原始定义的基础工具和 connect_mcp。调用 connect_mcp(name="docs") 后,Harness 保存新的工具及其相关信息。下一轮 Agent Loop 中模型调用的时候,模型会看到新的工具及其相关信息。
- 由于多个 server 都可能提供 search 或 status,所以 Harness 使用前缀区分不同 server 的同名工具,例如
mcp__{server}__{tool}。 - 工具定义(tools)和 工具执行逻辑(handler)一起加入工具池:模型可以看到带前缀的名字,但是 handler 仍使用 server 原始工具名调用 MCPClient。
注:5. 中加入工具池的两部分:
- 给模型看的规范(tools):告诉大模型有哪些工具、功能描述、输入参数的 JSON Schema。
- 给程序执行的逻辑(handlers):一个字典映射({工具名: 实际可执行的函数})。当模型返回 tool_use 请求(例如调用 mcp__docs__search 并传入参数)时,宿主程序会通过 handlers tool_name (**args) 找到对应的函数并执行。
- 外部工具的权限不由server决定,而是由宿主函数/人类用户配置决定。
15 Agent Harness 集成:在一个 Agent Loop 中集成多种机制
本章把集成 运行时 所需要的前面各节中提到的各种机制接到一起:Integrated Harness 会把基础工具、Hooks、Skills、Context、Memory、Task、Background、Cron、Teams 和 MCP 放进同一个运行时。一个能长期工作的 coding agent 需要同时拥有:
- 工具分发和权限边界
- hooks 扩展点
- todo 计划和任务图
- 技能、记忆、系统 prompt 组装
- 压缩和错误恢复
- 后台任务和 cron 调度
- 团队、协议和 idle 任务认领
- 任务绑定的 worktree
- MCP 外部工具接入
- ......
本节介绍上述机制从哪里进入 Agent Loop,以及它们产生的结果如何回到同一段对话:
用户输入
  → UserPromptSubmit hooks
  → cron/background 通知注入
  → context compact
  → memory + skills + MCP 状态组装 system prompt
  → LLM
  → has tool_use block?
      否 → Stop hooks → 返回
      是 → PreToolUse hooks + permission
          → TOOL_HANDLERS / MCP handlers / background dispatch
          → PostToolUse hooks
          → tool_result / task_notification 回 messages
          → 下一轮
(注:这里所说的Agent Loop和第1节 中那个最基础的仍是同一个结构:调用模型,检查响应里是否出现 tool_use block,执行工具,再把结果追加回 messages;某一轮Agent Loop中是否执行工具由模型的响应中有没有实际的 tool_use block 决定)
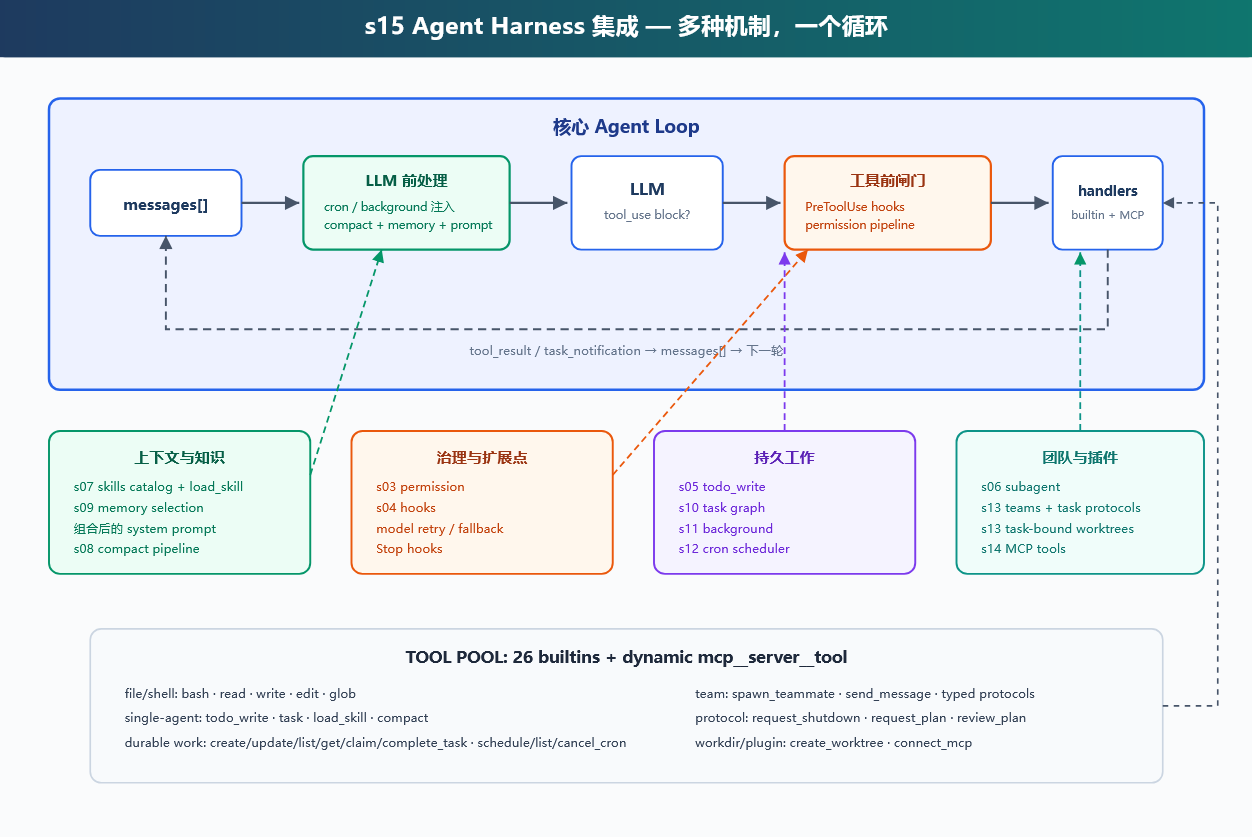
各个组件在 Agent Loop 中的位置:
| 位置 | 组件 | 作用 |
|---|---|---|
| 用户输入前后 | UserPromptSubmit hooks |
记录、注入、审计用户输入 |
| LLM 前 | cron queue | 把定时触发的 prompt 注入 messages |
| LLM 前 | background notifications | 后台任务完成后以 <task_notification> 注入 |
| LLM 前 | compaction pipeline | 先压大输出,再裁历史,再压旧 tool_result,必要时摘要 |
| LLM 前 | memory / skills / MCP state | 组装 system prompt,让模型看到当前能力和长期上下文 |
| LLM 调用 | error recovery | 429/529 重试,max_tokens 升级,prompt too long 触发 reactive compact |
| 工具执行前 | PreToolUse hooks + permission |
拦截危险命令、写越界、破坏性 MCP 工具 |
| 工具分发 | assemble_tool_pool |
组装内置工具和 MCP 动态工具 |
| 工具执行时 | background dispatch | 显式标记的 bash 操作放入 daemon thread,主循环先返回占位结果 |
| 工具执行后 | PostToolUse hooks |
大输出告警、日志等后处理 |
| 返回循环 | tool_result | 每个 tool_use 对应一个 tool_result,再回到下一轮 |
| 本轮没有 tool_use / 停止时 | Stop hooks |
统计、清理、审计 |
以下具体设计可以被写在 code.py 当中,包含:
15.1 工具与分发(对应第2节)
内置工具池包含 26 个工具:
bash, read_file, write_file, edit_file, glob
todo_write, task, load_skill, compact
create_task, update_task, list_tasks, get_task, claim_task, complete_task
schedule_cron, list_crons, cancel_cron
spawn_teammate, list_teammates, send_message
request_shutdown, request_plan, review_plan
create_worktree
connect_mcp
此外,还有 assemble_tool_pool() 每轮组装来自MCP发现的server中的外部工具:
BUILTIN_TOOLS + connected MCP tools
BUILTIN_HANDLERS + mcp__server__tool handlers
所以 connect_mcp("docs") 后,下一轮工具池里会出现 mcp__docs__search。
15.2 权限和 hooks(对应第3节)
权限作为一个 PreToolUse hook,让 permission、log、审计都可以挂在同一个 hook 点上。Lead、一次性 subagent 和队友的工具都会先经过 PreToolUse;允许执行的调用会在 handler 返回后触发 PostToolUse。
权限判断不会把 MCP server 自己写的 description 当成授权依据。宿主维护一组精确的已知只读工具名单,其他 MCP 工具都要询问用户。文件工具越过 WORKDIR 会直接拒绝,每条 bash 命令执行前都会询问。只有前台用户轮次可以弹出交互确认;异步轮次直接拒绝需要确认的操作,不和主 CLI 争抢输入。
15.3 计划与任务(对应第5节)
S15 同时保留两层计划:
todo_write:当前会话内的轻量计划,保存在内存中- task graph:跨会话、可依赖、可认领的任务文件,写入
.tasks/task_*.json
前者帮助单个 Agent 不漂移;后者支撑团队协作。
两者目标相近但具体实现不同:todo_write 整表替换当前会话清单,task record 则有稳定 ID 和单条生命周期更新。下面单独出现的 task 工具表示"一次性派发隔离 subagent",不是 Task System。
集成宿主中的任务图仍采用两阶段构建:Lead 先创建所有任务节点,再使用 create_task 返回的运行时 ID 调用 update_task。队友只能列举、认领和完成任务,因此依赖结构由 Lead 在分发工作前确定。
15.4 子 agent 与团队(对应第6、13节)
主 Agent 有两种 Delegation(任务委派):
task:一次性的 subagent。独立messages[],中间过程丢弃,只返回最终摘要。(详见第6节)spawn_teammate:持久的 Agent Teams 队友线程。传入 readytask_id时,运行时会在线程启动前完成认领;不传时,队友可以在 IDLE 中等待后续任务。没有 assignment 的队友不能使用文件或 Shell 工具。它按WORK → result → IDLE运行,不设固定的工具轮数上限;模型或分发失败会发出error,线程清理会把未完成 assignment 释放回任务板。每次调用模型前都会先读取收件箱,因此直接消息和关机请求不会被连续的 tool-use 轮次饿死。idle 时先等待MessageBus消息,只在超时后扫描就绪 task,并以原子操作最多认领一个。(详见第13节)
Lead 启动队友后结束当前轮次,不在模型循环里反复查询状态。队友事件进入 Lead 收件箱后,运行时会自动唤醒下一轮。
15.5 记忆、技能和 prompt(对应第9、7节)
S15 直接复用 s09 的 Memory runtime。每轮调用模型前,它读取 .memory/MEMORY.md 目录,根据当前请求选择相关记录,再把选中的正文交给 assemble_system_prompt(context)。本轮结束后,extract_memories() 提取可跨会话使用的信息;有新增记录时再运行 consolidate_memories()。(详见第9节)
同一份 system prompt 还会加入身份、工具说明、workspace、skills catalog 和已连接的 MCP server。技能只放目录,完整内容通过 load_skill(name) 按需加载。(详见第7节)
15.6 上下文压缩(对应第8节)
Agent Loop 中,在调用 LLM 前,会先跑压缩流程:
tool_result_budget → snip_compact → micro_compact → compact_historysnip_compact 会先归档完整历史,再裁掉中段消息。micro_compact 只在上下文超限时运行:它先保存较早且已读取的结果,再用恢复路径替换;最近 3 条保持完整,并在接近阈值 80% 时停止。如果未读取的新结果本身过大,S15 会先保留预览和完整输出路径,再考虑总结历史。
15.7 Agent Teams的worktree、MCP(对应第13、14节)
从 s13 继承的任务级 worktree 机制负责管理任务工作目录:
- pending 且未被认领的 task 可以留在主工作区,也可以通过
create_worktree(name, task_id)绑定独立分支和目录 - 创建前会校验 task、名称、路径、分支和 Git registry;Git 命令失败后还会核对 registry 和分支状态,任何部分创建的 checkout 都保持未绑定并保留供人工恢复
- idle 队友以原子操作认领一个就绪 task,assignment 同时记录
task_id和有效cwd - Lead 也可以把 ready
task_id直接传给spawn_teammate,认领成功后才启动线程 - 队友所有文件工具都使用该
cwd;只有 task owner 能完成任务,assignment 会保留到当前模型轮次结束 - 移除保留在宿主侧的
remove_worktree()函数中,模型不能调用。用户或宿主先检查任务所有权、assignment lease、后台工作和 Git 状态;破坏性移除需要另行取得用户确认
worktree 只改变工具的默认工作目录,用于分离 working copy,并不是安全沙箱。进程组清理也无法约束另建 session 的进程,因此删除保留为宿主操作。
认领或释放 task 会改变 assignment version,使旧的 plan approval 失效;普通 send_message 只传递消息,不会改变 task identity 或 plan 状态。
MCP 负责外部工具的调用能力:
connect_mcp(name)连接 mock serverassemble_tool_pool()把 MCP 工具组装进工具池,并拒绝规范化后的名称冲突- 工具名统一为
mcp__server__tool
16 Workflow Runtime:使用预先设定的脚本(而不是由大模型)来编排某些固定的流程
纯 LLM 决策的弊端:从 s01 到 s15,每一轮都由模型 决定调用哪些工具。工具结果进入 messages\[\] 后,模型再根据更新后的上下文决定下一步。如果某个任务中的后续路径取决于上一步发现了什么时,这种方式是合适的。
然而,有些任务会重复一套固定流程。例如代码审查可以同时检查多个维度,再逐条验证发现、合并重复项并按严重程度排序。对于这种执行前已经知道步骤及其先后关系的情况,这时宿主需要的是这三样东西:
- 并行,别一个一个串行等着;
- 稳定的结果结构,即使每个 agent 的回答会变化;
- 可恢复,假如跑到一半断了,已经做完的部分也不用从头再来。
如果这套编排只存在于对话历史里,步骤顺序和检查点也只存在于历史里。所以在 harness 的工具池里加入一个 Workflow 工具:保存好的 workflow 把固定流程写进代码,并在 journal 中记录已经完成的调用。
宿主注册由 agent() / parallel() / pipeline() / phase() 组成的可信脚本。模型只提供保存好的 workflow 名称、参数和可选的续跑 run ID,不会提交可执行代码或元数据。
workflow 以一次 tool_use 进入主循环。脚本运行时,runtime 会发出生命周期和进度事件,并把每一步写进磁盘上的 journal 。脚本结束后,这次调用返回启动信息、结果和任务状态。脚本里的中间结果存在变量里 ,不会塞进对话历史。下次用 resume_from_run_id 重启时,没改过的 agent() 会直接使用 journal 中的结果 。
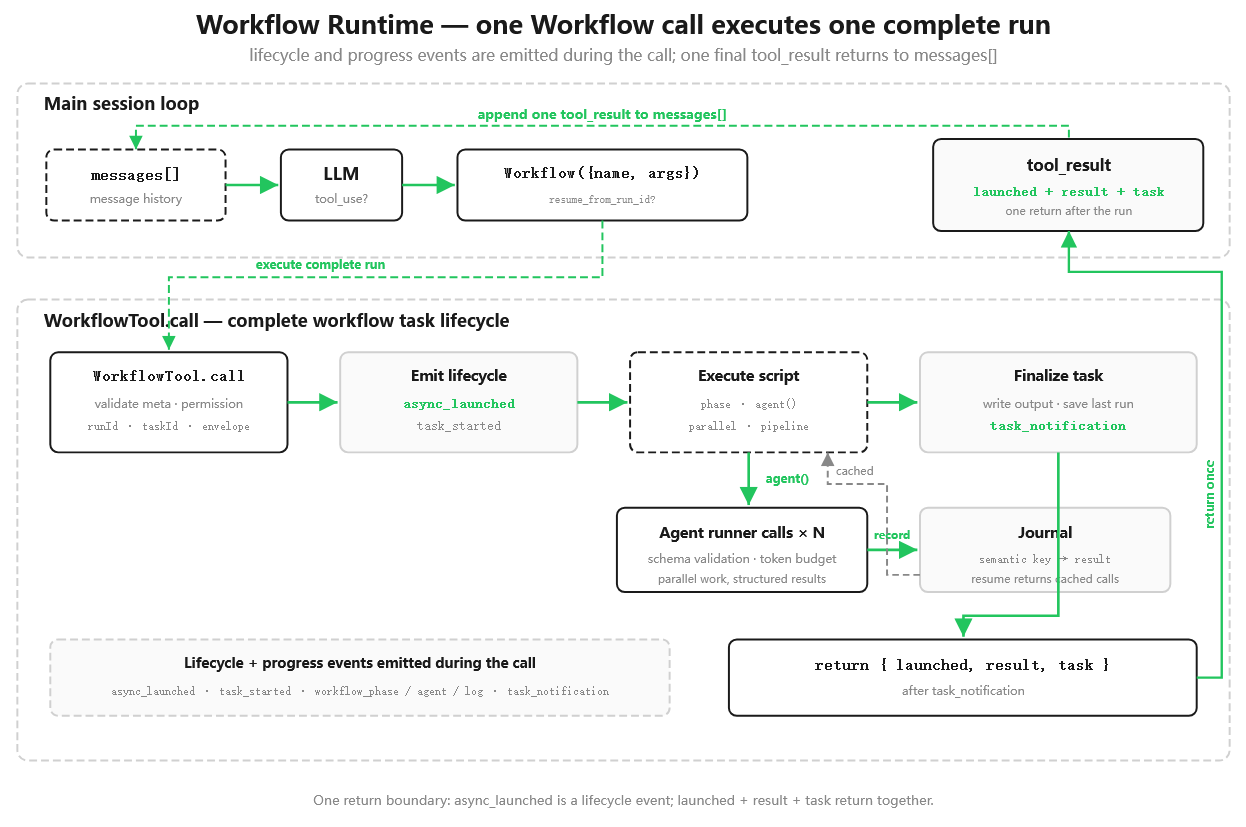
16.1 Workflow 将固定的流程封装为一个工具
将 Workflow 这种工具 加入 s15 宿主已有的工具池。用户可以要求运行一个保存好的 workflow,模型也可以在任务匹配已知编排时选择这个工具。适配器会用名称查询宿主管理的 WORKFLOWS registry,再把可信的元数据和函数交给运行时;s15 的其他工具仍在同一个循环里可用。
宿主将预定义的编排脚本注册在 WORKFLOWS 注册表中,主模型只通过一个标准的工具调用接口触发工作流,无需向模型暴露代码执行风险。工具的输入参数:
- name: 工作流名称(受安全 slug 校验,防止路径穿越)
- args: 传入业务参数(如代码 diff)
- resume_from_run_id: 可选的恢复运行 ID
16.2 六大编排原语(ctx 执行上下文)
工作流脚本在沙箱化的 ExecutionState 中运行。由开发者预先写好、注册进系统中的工作流定义函数组成的脚本只能看到只暴露了少量编排原语的 ExecutionState,本身不直接读写文件,也不运行 shell。
| 原语 | 作用 |
|---|---|
agent(prompt, {schema, label, phase}) |
派子Agent执行原子任务,支持强校验的 JSON Schema 结构化输出 |
parallel(thunks) |
等齐屏障:并发执行一组任务并等待全部完成 |
pipeline(items, *stages) |
流水线处理,每个 item 分阶段跑,不等齐(Item A 可以在 Stage 2,无需等待 Item B 走完 Stage 1),跑完一个往下走一个 |
phase(title) |
更新并向控制台输出当前进度阶段(更新进度条) |
log(message) |
打印一行进度日志 |
workflow(name, args) |
嵌套调用其他已保存的工作流(只允许嵌套一层) |
16.3 基于存储快照与 Journal 的断点续跑(Resume)
运行时 把每次运行的数据存在 s16_workflow_runtime/.runtime/:快照 <runId>.json、输出 <runId>.output.json、journal <runId>.journal.jsonl 和协调文件 <runId>.lock。
每次新运行都会在打开 journal 前,用排他式文件创建新的 runId。整次执行和最终持久化期间都持有 run lock,另一个进程不能同时 断点续跑(resume) 同一次运行。快照记录 workflow 名称、参数和任务状态;resume 会先验证已保存的快照和 journal,再改动原有的成功产物。
每个 agent() 都会计算得到一个确定的语义 key,key 是根据调用内容(类型、标签、prompt、schema)算的稳定哈希,稳定哈希能够让同一份 workflow 和同样的参数对应相同的调用 key。
resume 可以根据每次任务的 runId (带着 resume_from_run_id)续跑(再次调用 workflow)。
由于journal 会一条一条记下来每个 agent() 的结果,在续跑时运行时 需要把当前 agent() 与 journal 中的旧调用对应起来。如果key 在 journal 里有记录,即这次调用完全没有变化 (真实模型的回答可以变化,只要调用内容 没有变化就算没有发生调用改动),resume会直接用journal 中已经保存的缓存 ;如果有改过 的调用以及依赖它的后续步骤才会重新运行。
17 Goal Loop:模型提出停止,独立判断器决定是否继续
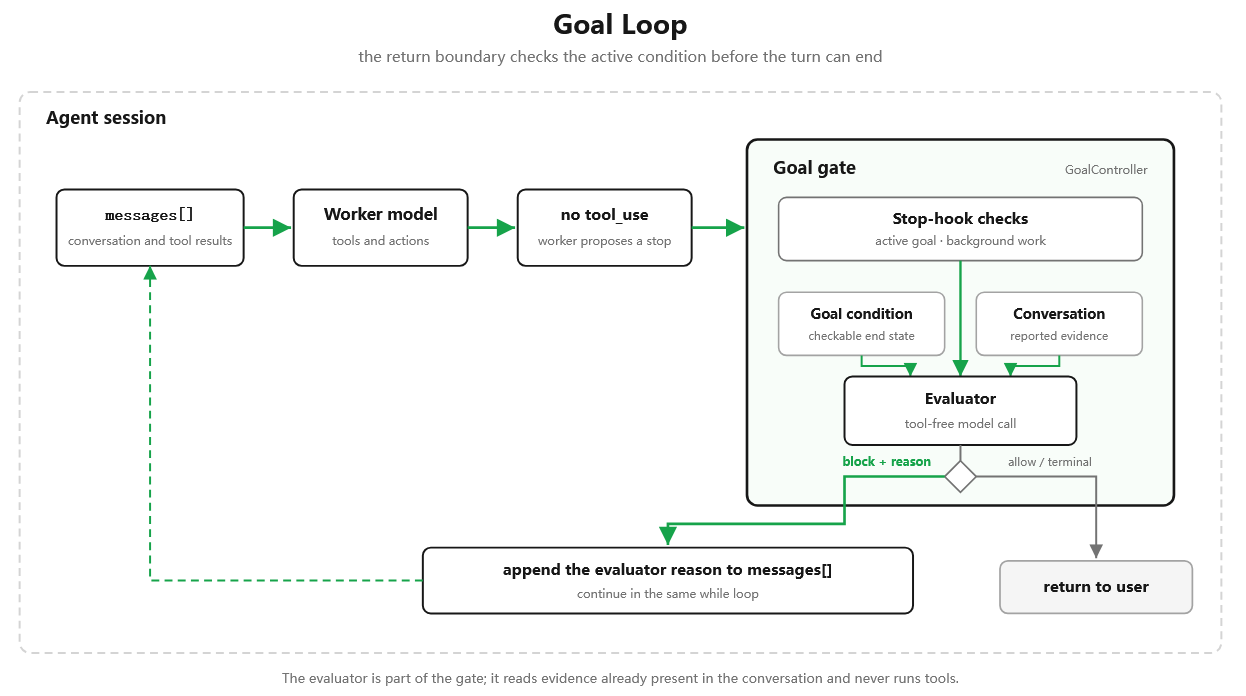
从 s01 开始,Agent Loop 的退出条件为:模型不再调用工具,程序就返回。
这对普通对话足够,但对"修到测试全部通过""完成所有验收项"这样的任务还不够:比如模型可能认为已经做完,也可能只完成了一部分。没有新的 tool_use 只能说明当前轮次结束了,不能直接证明整个目标已经达成 。
所以本节使用 /goal,在真正退出 Agent Loop 之前,再加一次独立判断。
/goal 是一个会话级的 Stop hook ,其程序为记录任务的完成条件 。当主模型不再调用工具时 ,主循环不会立刻 return,而是会运行 Goal Stop hook。
17.1 Goal 判断器
主模型负责修改代码、运行命令和解决问题;而 Goal 判断器 是另一次独立的模型调用,只负责判断完成条件 。判断器由 GoalController 持有,是 Goal Gate 的内部依赖,不是主循环之外的另一条退出路径。
判断器会看到当前 Goal 的完成条件、到目前为止的对话记录、主模型运行工具后写回来的结果。
判断器没有工具,不能自己读取文件,也不能重新运行测试。它只能根据对话中已经出现的内容做判断当前任务完成情况属于哪种情况:ok=true 表示条件已经满足;ok=false 表示还要继续;如果目标已经无法完成,则返回 impossible=true。
1. 判断器的判断依据:到目前为止的对话记录
到目前为止的对话记录就是判断其用于判断任务完成情况的依据:判断器读取当前对话,其中的工具结果、主模型的说明和后台任务通知都会作为消息进入其中,最终判断取决于这些消息实际写了什么。送给判断器的内容会保留最近的完整消息。如果最新一条消息本身过长,就只保留它的开头和结尾,避免一条工具结果占满整次判断请求。
2. 判断器的可靠性
判断器的提示明确要求根据对话中的具体结果判断,不能把没有结果支撑的宣称当成完成,所以即使主模型说一句"测试通过了",判断器也不一定接受这个说法。
但它终究只是一个只读对话的模型,可靠性取决于对话里有没有把关键结果说清楚。因此主模型的 system prompt 会要求在运行验证命令后,把命令和结果明确写进对话,让独立判断器能够检查。
注:Goal Loop 不是测试框架。真正的验证仍然由工具执行,它只负责判断验证结果是否已经出现在当前工作记录中。
17.2 能够被判断器用于检查的完成条件
一个好的完成条件要能被判断器用于检查。比如"把代码弄好"显然不是一个能够给判断器的好的完成条件,因为其太模糊,判断器不知道什么算好。更合适的任务完成条件会写清三件事:
- 结束状态:最终要达到什么结果;
- 验证方式:用什么命令或输出证明;
- 限制条件:完成过程中不能破坏什么。
17.3 如果主模型没有满足任务完成条件,就回到Agent Loop循环之中
如果判断器认为主模型的结果没有达到任务完成条件,会给出简短原因,程序会把原因加入主Agent messages\[\],然后主模型立即开始下一轮Agent Loop,不需要用户再次输入"继续"。
注:由于 Goal 检查就在主循环的结束位置,未满足完成条件时就从这里回到主Agent Loop。
17.4 如果后台任务还在运行,Goal 检查就不要判断任务是否完成
Workflow(第16节)、后台命令和其他异步任务可能在主模型结束当前轮时仍在运行。这个时候判断是否完成任务是没有意义的,因为可能还有关键结果还没有回到对话。Goal Stop hook 返回 defer,保留当前 Goal,不调用判断器。后台任务结束后,宿主把完成通知交给 submit_background_result();通知进入同一个 messages\[\],主循环再继续。
第16节中的 Workflow 的工作完成通知没有特殊权限,它和其他消息一样进入对话,判断器根据其中的实际结果判断任务完成条件是否满足。
17.5 自动继续运行也必须有截止条件
Goal 本身没有一个默认的最多判断轮次上限,是否满足完成条件由判断器每轮重新判断。但任何自动机制都不能无限占住一次请求。所以可以在 Stop hook 外设置截止条件:达到主Agent Loop的全局最大循环次数 max_turns,或者 Stop hook 决定连续阻止结束的次数上限。
达到上限时,程序把控制权还给用户,但不会把目标设置为完成的状态,也不会自动清除目标。用户可以查看状态、补充信息后继续,或者主动清除。
17.6 Goal 判断器的查看、替换和清除
每个会话同时只有一个活跃 Goal 判断器。一些相关命令示例:
/goal查看当前条件、已经判断的次数、经过时间、主 Agent 的 token 使用量和最近一次判断原因。/goal 新的完成条件直接替换旧 Goal,并立即按新条件开始工作。/goal clear清除当前 Goal。stop、off、reset、none 和 cancel 也可以作为清除别名。
注:
- GoalController.restore() 可以从宿主保存的 goal_status 事件中恢复仍然活跃的 Goal 判断器。
- 已经完成、失败或主动清除的 Goal 判断器不会重新启动。
- 恢复后的 Goal 判断器保留完成条件,但重新计算轮数、时间和 token 使用量。