read函数
读磁盘
读磁盘时,如果缓冲区没有数据了,read不阻塞,直接返回0。可以把read的返回值作为循环退出的条件。
读管道/设备/socket
读管道、设备、socket时候,如果缓冲区没有数据了,read阻塞。不可以把read的返回值作为循环退出的条件。
while里面不能写阻塞式的read
改造成非阻塞的
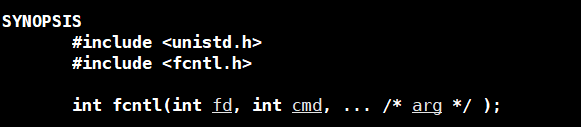
永久改造
cmd 填 F_GETFL 获取文件状态
cmd 填 F_SETFL ...要填一个 int 参数,设置 fd 的文件状态
csvoid setNOnblock(int fd){ int f1 = fcntl(fd,F_GETFL);//获取当前文件状态 fd |= O_NONBLOCK;//在原本文件状态的基础上新增一个非阻塞状态 fcntl(fd,F_SETFL,f1);//设置新的文件状态 }
sockfd临时非阻塞
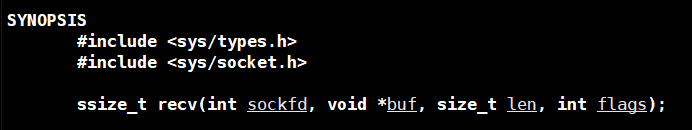
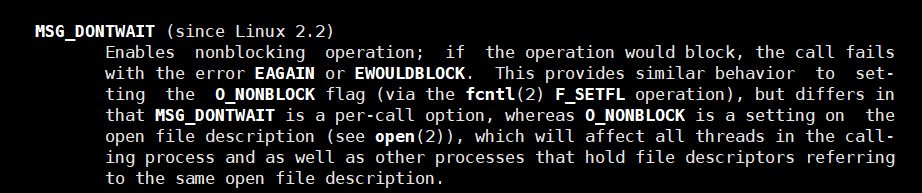
五种IO模型
参考书《Unix网络编程》
同步阻塞模型
cswhile(1){ recv(fd1); do sth1...... recv(fd2); do sth2...... ...... }recv()默认情况下是阻塞的。
同步非阻塞模型
cswhile(1){ recv(fd1,MSG_DONTWAIT); if(ready){ do sth1...... } recv(fd2,MSG_DONTWAIT); if(ready){ do sth2...... } }不会出现前面资源没有就绪导致后面已就绪资源阻塞。但是此时是用户在轮询,占用cpu
同步IO多路复用模型
cswhile(1){ epoll_wait/select if(ready){ do sth...... } }轮询交给内核,只要有资源就绪就可以运行,比同步非阻塞模型性能更好。
两种异步模型
异步模型
csvoid func(){ aio_read(fd1,callback1); do sth1...... aio_read(fd1,callback2); do sth2...... }aio_read()不会阻塞,会在一瞬间完成,将来有一天数据到达后,由操作系统调用callback。收到数据和do sth没有明确的关系。理论上,异步模型比IO多路复用模型性能更好,实际上两者差不多,但是异步模型比IO多路复用更复杂、使用较少。
信号驱动IO模型
将callback调用换成发信号。
epoll触发方式
水平触发、边缘触发。
默认的epoll_wait()是水平触发。
更改为边缘触发:
csevent.data.fd = netfd; event.events = EPOLLIN | EPOLLET; epoll_ctl(epfd,EPOLL_CTL_ADD,&event);现在边缘触发不好,可能会有数据残留问题,可以将一次recv换成多次recv,recv循环如下:
cswhile(1){ recv(netfd,buf,sizeof(buf),MSG_DONWAIT); }
水平触发(LT - Level-Triggered)
触发条件: 只要文件描述符处于就绪状态(即满足监听的条件,例如 socket 接收缓冲区中有数据可读,或者发送缓冲区有空间可写),
epoll_wait就会持续报告该事件。行为: 想象一个水平放置的水杯(状态)。只要水位高于某个标记(就绪状态),系统就会不断提醒你:"水杯有水!水杯有水!"。
后果:
- 如果你收到一个读就绪通知(
EPOLLIN)后,没有一次性把接收缓冲区里的所有数据读完(缓冲区里还有数据),下一次调用epoll_wait时,它仍然会再次通知你该 fd 可读。- 如果你收到一个写就绪通知(
EPOLLOUT)后,没有一次性把数据写完(发送缓冲区还有空间),下一次调用epoll_wait时,它仍然会再次通知你该 fd 可写(只要缓冲区没满)。优点:
- 编程模型相对简单。应用程序不必担心一次没有处理完所有事件而导致事件丢失。你可以选择处理部分数据,下次
epoll_wait还会提醒你处理剩余的数据。缺点:
- 如果应用程序处理事件的速度较慢,或者故意不处理完,可能会导致
epoll_wait不断返回同一个就绪的 fd,造成不必要的系统调用和 CPU 开销("惊群效应"的一种表现形式,尤其在 fd 很多但活跃度不高时)。
边缘触发(ET - Edge-Triggered)
diyic边缘触发必须使用非阻塞IO。
触发条件: 仅在文件描述符的状态发生改变时(从未就绪变为就绪),
epoll_wait才会报告一次该事件。行为: 想象一个电灯开关的边缘(变化)。只有当你按下开关的瞬间(状态从关变为开),系统才会提醒你一次:"灯开了!"。之后灯一直开着,系统不会再提醒你。
后果:
- 如果收到一个读就绪通知(
EPOLLIN),你必须一次性把接收缓冲区里的所有数据读完,直到发生EAGAIN或EWOULDBLOCK错误(表示内核缓冲区暂时空了)。如果你只读了一部分数据,那么即使缓冲区里还有数据,下次epoll_wait也不会再通知你这个 fd 可读,直到有新的数据到达(触发下一次状态从未就绪到就绪的变化)。- 同理,对于写就绪(
EPOLLOUT),如果你收到通知后没有一次性写满发送缓冲区(或者没有新数据要写),那么之后即使发送缓冲区有空位,epoll_wait也不会再通知你(除非你之前写操作返回了EAGAIN/EWOULDBLOCK导致 fd 变为未就绪,然后缓冲区空出空间时才会再次触发状态变化)。优点:
- 减少了不必要的通知次数,尤其是在高并发、活跃连接很多但每个连接数据量不大的场景下,可以显著减少
epoll_wait返回的次数和系统调用开销,理论上性能更高。- 更接近底层硬件中断(如网络接口卡)的工作方式。
缺点:
- 编程模型更复杂,要求应用程序必须一次处理完所有可用数据(循环读取/写入直到
EAGAIN),否则会丢失事件。- 强制要求使用非阻塞(non-blocking) I/O。因为你需要在一个通知内循环读写直到
EAGAIN,如果是阻塞 I/O,在读完所有数据前就可能阻塞住线程,导致其他事件无法处理。- 更容易出错,例如忘记循环读取导致数据积压在缓冲区而得不到处理。
水平触发vs边缘触发
旧版本的epoll只支持边缘触发。
性能问题:
场景一:epoll_wait和recv是同一个线程,为了更容易发现残留数据,优先使用水平触发。
场景二:epoll_wait和recv不是同一个线程,为了避免重复唤醒,优先使用边缘触发。
服务端框架
服务端应用,一个应用程序需要管理多个连接同时收发数据。
同时的实现思路:
- 依赖于多进程或多线程的并发性
- IO多路复用
基于线程或基于进程
一开始只有一个主线程或者主进程;这时候有一个客户端俩姐主线程或主进程,随后fork()或者pthread_creat(),由这个线程或者进程处理连接,由子线程或者进程处理服务端业务。由于线程,进程之间的互斥,有良好的性能。
优势:
- 代码简洁
- 业务开发简单,一个线程阻塞不影响其他线程
劣势:性能特别差
- 每一个连接要占用一个线程或者进程,在总内存一定时,连接量少,并发量低
- 线程数量远多于cpu数量,上下文切换很频繁
- 调整资源分配策略很麻烦
Apache、旧版的Tomcat采用的这种方式,QPS2000以内。QPS(Queries Per Second)是每秒查询率,用于衡量系统、服务或数据库每秒能够处理的查询请求数量。
C10K问题
最初的服务器是基于进程/线程模型。新到来一个TCP连接,就需要分配一个进程。假如有C10K,就需要创建1W个进程,可想而知单机是无法承受的。
使用IO多路复用解决,同时也解决了C100K问题。
C10M问题由DPDK解决。
AI 瓶颈:数据不够复杂,没有足够对应难度复杂的数据用来训练 AI ,需要大量的高水平人才喂 AI 数据。而不是算力上面的瓶颈。
事件驱动模型
我们将
cswhile(1){ select/epoll_wait; do sth...... }称为事件循环。(event loop 事件循环)。
优势:
- 每一个连接一个文件对象,高并发量
- 线程只有一个,没有CPU切换开销
- 资源分配由用户代码决定
事件驱动模型可以解决C10K问题。
cswhile(1){ select(); if(fd1 ready){ recv1 --> recv2 --> recv3...... } }当有一个业务需要连续recv时,中间的recv可能会卡住,在单线程情况下,阻塞后面所有recv()。在每个select()之间越短越快,因此,在做任何事要就绪以后再执行。
cswhile(1){ select(); if(fd1){ recv1 -- > flag } if(fd2){ recv2 -- > flag } if(fd3){ recv3 -- > flag } }缺点:
- 在单线程情况下,一个业务卡住了,会阻塞所有人。
服务端集群
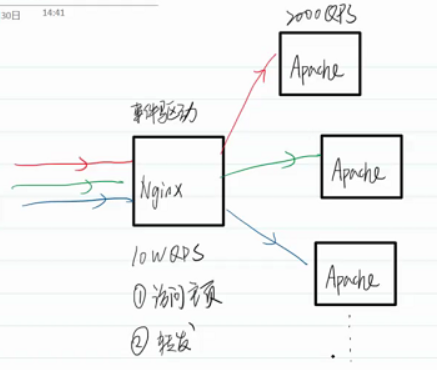
事件驱动模型有局限性
目前的事件驱动模型只有一个线程,不能充分地利用多核CPU。
若是16核心cpu,推荐选择线程数为 16~32 之间。此时16线程适合于cpu密集型应用,线程需要经常占有CPU;32线程(2倍于核心)适用于IO密集型,IO密集型会频繁切换占有CPU,比如网盘类业务。
进程池、线程池
池 Pool
在应用程序启动时候去申请资源,在运行过程中,不申请也不释放资源。如果使用资源,则使用已经申请的,使用完以后不释放,以便后续直接重用。
几种常见的池:
- 内存池
- 连接池
- 进程池
- 线程池
进程池:提前创建很多进程,进程数量和CPU核心数相关
一种事件驱动模型与进程池结合的模型
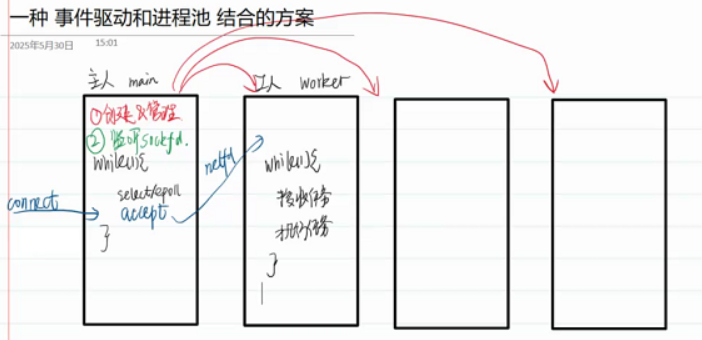
主人进程的职责
- 创建并管理工人进程
- 用epoll去监听sockfd,一旦就绪要执行accept得到netfd
- 得到的netfd交给工人进程,后续的业务由工人进程完成
工人进程的职责
无休止的循环
- 等待任务的到来(主人发送netfd)
- 根据netfd执行业务
如何书写一个"大"项目
大:不只有一个.c项目
多个.c编译完成后,链接成一个可执行文件。其中,必须有一个main()函数作为入口,不能有多个同名函数的定义。
一、构建目录和文件结构
- 新建目录,把相关的文件建好。
- 弄清楚各个文件的依赖关系(编译、链接)
- 写出Makefile
二、设计数据结构
把人类所理解的产品图转化成计算机能够理解的 struct 。
先写头文件
捋清楚工人、主人之间的业务逻辑关系
三、书写业务代码
从数据结构出发,设计业务代码。将产品的业务逻辑转换成数据结构的增删改查。
写函数要注意的事情:
函数不是一个人的事情
- 用轮子的人------调用者
- 造轮子------函数定义的实现者
开发前的第一件事情就是定接口(函数声明)。包括:
- 函数名(动词加名词,比如makeWorker)
- 返回值(一律用int ,可以显示调用成功还是失败)
- 参数(数据依赖传入传出参数传递,先设计传入参数,再设计传出参数)
多个程序员一起合作的时候,面向接口编程,而不是面向实现编程 。
在编写程序时,最好使用增量编译,写一个小模块,测试一下,再解决相应问题,而不是等到写差不多了再编译测试。
sendmsg和recvmsg函数(不重要)
当直接在进程之间传递文件描述符 int 时,接收到的进程并不能使用该文件描述符直接打开文件进行操作,此时就需要用到sendmsg和recvmsg。
sendmsg和recvmsg函数除了可以发一般的数据,还可以发送内核数据结构,比如文件对象。
socketpair可以在进程之间建立全双工通信的socket,socketpair的用法几乎和pipe的用法几乎一致;
pipe的限制:fd0只能读,fd1只能写
socketpair没有这个限制,fd0、fd1可读可写
要求:
- 传输介质必须是socket,不能是管道
- 消息必须放在msghdr里面
- msg_name和msg_namelen都填NULL和0
- msg_iov和msg_iovlen,这是消息的正文,必选项
- msg_control、msg_controllen这是消息的控制字段,可选项
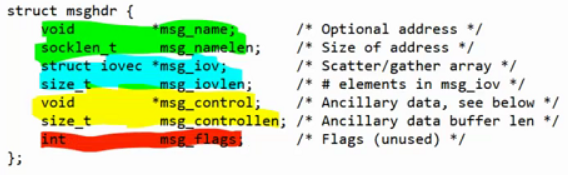
消息的正文
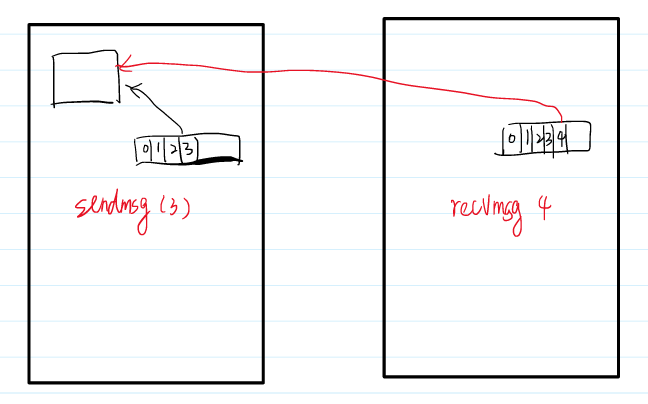
send_msg的特殊之处,可以发送一片离散的数据。每个离散的数据一定有它的起始地址和长度,send_msg记录下首地址和长度
- msg_iov是数组的名字
- msg_iovlen是数组的长度
msg_iovi记录了每个碎片的首地址和长度。
消息的控制字段
使用 <man cmsg> 查看
柔性数组:结构体的最后一个成员是一个不确定长度的数组。因此不能定义在栈上,栈上的数据在编译时确定大小,所以只能申请在堆上。
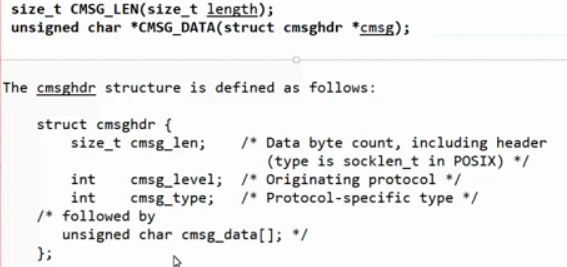
传输文件对象
cmsg_data里面放一个int(指向目标文件对象的fd)
可以用CMSG_LENGTH 求整个结构体长度,随后在堆上申请空间,在得到结构体的首地址后,使用CMSG_DATA求cmsg_data的地址。
代码实现:
sendmsg
csint sendfd(int sockfd,int fdtosend){ //准备号一个 struct msghdr hdr; bzero(&hdr,sizeof(hdr)); //准备正文 char buf[] = "hello"; struct iovec vec[1];//离散区域只有一个碎片 vec[0].iov_base = buf;//碎片首地址 vec[0].iov_len = 5;//碎片长度 hdr.msg_iov = vec;//将离散区域和hdr扯上关系 hdr.msg_iovlen = 1; //准备控制字段 struct cmsghdr *cmsg = (struct cmsghdr *)malloc(CMSG_LEN(sizeof(int))); cmsg->cmsg_len = CMSG_LEN(sizeof(int));//已知data 长度长4,求整个结构体长度 cmsg->cmsg_level = SOL_SOCKET; cmsg->cmsg_type = SCM_RIGHTS;//这个选项说明要发送的数据结构是文件对象 *(int *)CMSG_DATA(cmsg) = fdtosend;//找到data 的首地址,强转成int *,再解引用,再赋值 hdr.msg_control = cmsg; hdr.msg_controllen = CMSG_LEN(sizeof(int)); sendmsg(sockfd,&hdr,0); return 0; }recvmsg
csint recvfd(int sockfd,int *pfdtorecv){ struct msghdr hdr; bzero(&hdr,sizeof(hdr)); char buf[6] = {0}; struct iovec vec[1]; vec[0].iov_base = buf; vec[0].iov_len = 5; hdr.msg_iov = vec; hdr.msg_iovlen = 1; struct cmsghdr *cmsg = (struct cmsghdr *)malloc(CMSG_LEN(sizeof(int))); cmsg->cmsg_len = CMSG_LEN(sizeof(int)); cmsg->cmsg_level = SOL_SOCKET; cmsg->cmsg_type = SCM_RIGHTS; hdr.msg_control = cmsg; hdr.msg_controllen = CMSG_LEN(sizeof(int)); recvmsg(sockfd,&hdr,0); printf("buf = %s, fdtorecv = %d\n",buf,*(int *)CMSG_DATA(cmsg)); *pfdtorecv = *(int *)CMSG_DATA(cmsg); return 0; }
sendmsg和recvmsg效果
实现了跨越进程的dup。假如使用send_msg传递fd = 4到子进程,子进程并不是直接使用fd = 4,而是将最小可用的文件描述符赋给fd,此时父子进程的fd指向同一个文件
示例
现在有一对父子进程,父进程打开file1,然后写入数据,使用sendmsg和recvmsg将文件对象发给子进程,随后子进程需要继续往后面写入数据
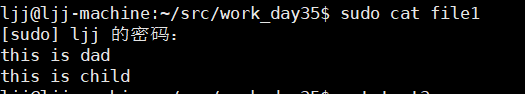
csint main(int argc, char *argv[]){ int fds[2]; socketpair(AF_LOCAL,SOCK_STREAM,0,fds); pid_t pid = fork(); if(pid>0){ //father close(fds[0]); int fd = open("file1",O_RDWR|O_CREAT); ERROR_CHECK(fd,-1,"open"); char buf[] = "this is dad\n"; write(fd,buf,sizeof(buf)); sendfd(fds[1],fd); wait(NULL); } else if(pid ==0){ close(fds[1]); int fd; recvfd(fds[0],&fd); printf("child fd = %d\n",fd); char buf[] = "this is child\n"; write(fd,buf,sizeof(buf)); } return 0; }结果:
零拷贝技术
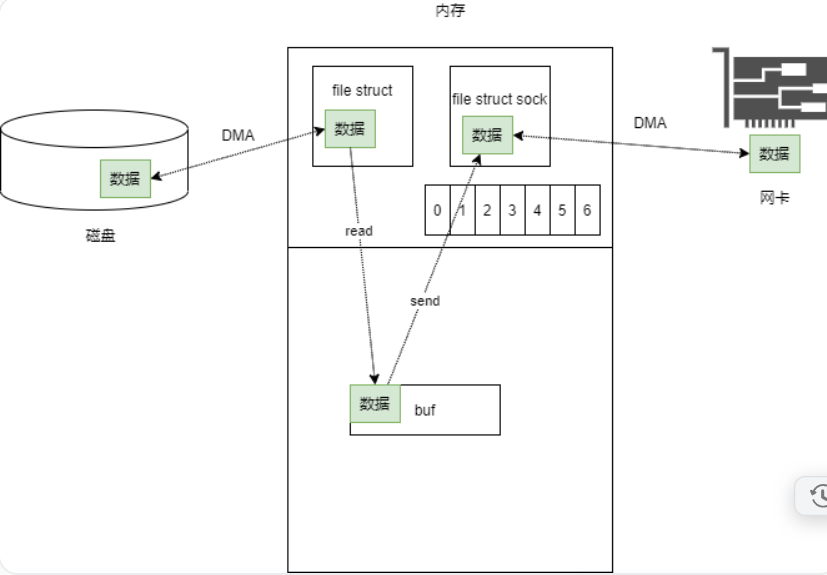
零拷贝技术是尽量减少内核态和用户态之间的数据拷贝
性能优化的流程
- 不能过早优化(正确性 > 可读性 > 性能,能做到"代码即注释"就是好代码)
- 性能优化的前提是做压力测试,看是否有瓶颈
- 只对瓶颈做优化
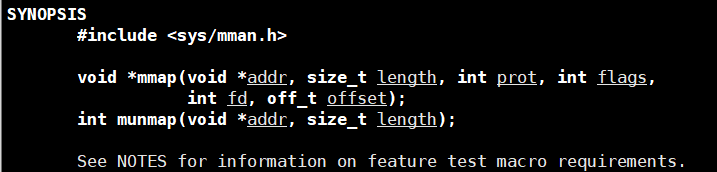
mmap内存映射
- addr : 填NULL
- length : 文件长度(在此之前要调用ftruncate)
- port : PROT_READ|PROT_WRITE (open O_RDWR)
- flags : MAP_SHARED
- fd : 文件对象
- offset : 填0
客户端知道文件大小
客户端知道文件的边界,可以不用TLV协议
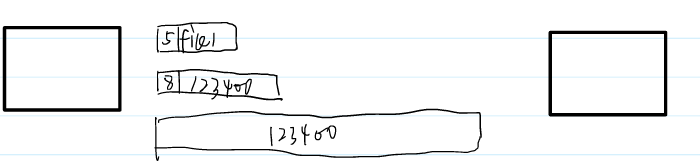
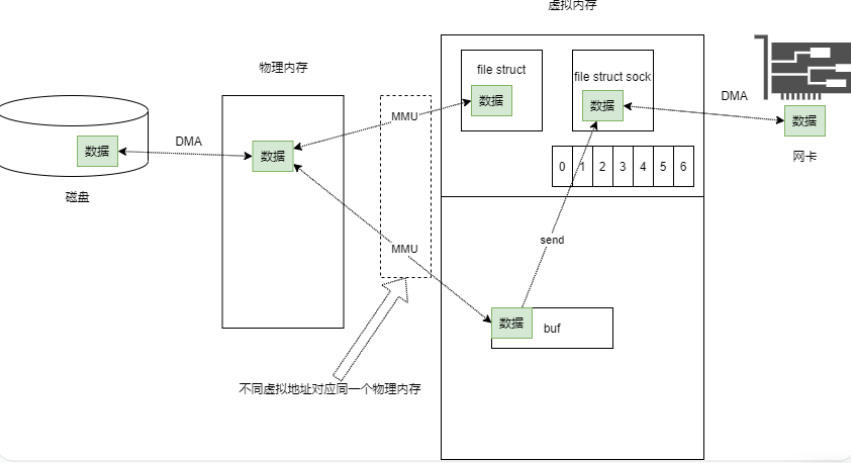
使用mmap发送,可以不用内核态用户态之间的拷贝转换。要准备一篇足够大的内存,文件大小超过2G不适合mmap。
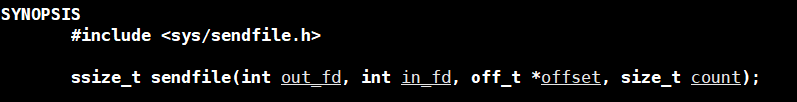
零拷贝传输sendfile
- out_fd: 可写,一般是socket。
- in_fd: 可读,不能是socket,只能是磁盘文件。
使用sendfile数据的流向是定死的,是从磁盘到网卡。
进程池的有序退出
在通知进程池终止之后,先做完一些必要工作(保存数据、清理资源),再终止。
在线更新
起一个新的服务器,等旧服务器的进程全部退出
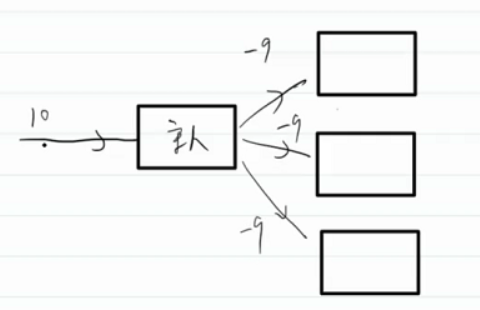
主人进程收到10号信号,然后发送9号信号,杀死其他进程,等待wait回收资源, 实现进程池的退出。
信号
10)SIGUSR1,
handler的参数是定死的,所以工人进程数量和每个进程的pid必须是全局的,现在希望少一点全局变量。
异步拉起同步
- 准备一个全局管道
- 注册信号,信号产生的时候,往管道里面写入
- 用epoll_wait监听管道的读端
- 信号产生会导致epoll_wait就绪,在epoll_wait就绪后可以处理退出逻辑(回收资源、保存数据等等)
准备一个全局管道
cs
int exitPipe[2];注册10号型号量,在headler里面往管道写入
cs
void handler(int signum){
    printf("signum = %d",signum);
    write(exitPipe[1],"1",1);//写入内容不重要,相当于发了一个通知
}
/* Usage:  */
int main(int argc, char *argv[]){

    pipe(exitPipe);
    if(fork()){
        close(exitPipe[0]);
        signal(SIGUSR1,handler);
        wait(NULL);
        printf("parent is going to exit\n");
        exit(0);
    }
    close(exitPipe[1]);