📌 前言
在自然语言处理(NLP)的入门学习中,构建一个语言模型来预测下一个词是非常经典的实战任务。本文将基于一道人工智能大赛的真题("AI报道"文本预测),带大家从零实现一个基于词嵌入(Embedding)的神经网络语言模型 。我们的目标是:输入文件中的任意连续4个单词,模型输出第5个单词。
🛠️ 环境准备
在开始之前,请确保你的环境中安装了以下依赖:
bash
pip install torch numpy tqdm📂 一、 数据预处理与词表构建
首先,我们需要读取 data/task5/AI 报道.txt 文件,并进行文本预处理。这里的核心是将文本转换为机器可以理解的数字索引(Tokenization & Vocabulary Mapping)。
python
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from tqdm import tqdm
import numpy as np

# 1. 读取数据并预处理
with open("data/task5/AI 报道.txt", "r", encoding="utf-8") as f:
    # 转换为小写,按空格切分
    raw_text = f.read().lower().split()

# 2. 构建词表 (Vocabulary)
vocab = set(raw_text) # 使用集合去重
vocab_size = len(vocab)

# 建立单词与索引的双向映射
word_to_idx = {word: i for i, word in enumerate(vocab)}
idx_to_word = {i: word for i, word in enumerate(vocab)}
💡 知识点 :神经网络无法直接处理字符串,必须建立 词 -> 索引 的映射。使用 .lower() 可以避免 "The" 和 "the" 被当成两个不同的词。
🧠 二、 构建训练数据集(滑动窗口机制)
题目要求"前4个词预测第5个词",我们可以利用滑动窗口 思想来构建 (输入, 目标) 数据对。
python
CONTEXT_SIZE = 4 # 输入连续4个词
data = []

# 遍历文本,构建数据集
for i in range(len(raw_text) - CONTEXT_SIZE):
    context = raw_text[i : i + CONTEXT_SIZE] # 截取连续4个词作为输入
    target = raw_text[i + CONTEXT_SIZE]      # 第5个词作为目标
    data.append((context, target))

# 将单词列表转换为张量
def make_context_vector(context, word_to_ix):
    idxs = [word_to_ix[w] for w in context]
    return torch.tensor(idxs, dtype=torch.long)
💡 知识点:这里的滑动窗口类似一个大小为5的窗口在文本上滑动,每次取前4个作为特征(X),第5个作为标签(Y)。
🏗️ 三、 定义 CBOW 神经网络模型
本题推荐使用 Embedding 搭建模型。我们参考经典的 CBOW (Continuous Bag of Words) 架构,并对输入进行均值融合。
python
device = "cuda" if torch.cuda.is_available() else "cpu"

class CBOW(nn.Module):
    def __init__(self, vocab_size, embedding_dim):
        super(CBOW, self).__init__()
        # 1. 词嵌入层
        self.embeddings = nn.Embedding(vocab_size, embedding_dim)
        # 2. 全连接隐藏层
        self.proj = nn.Linear(embedding_dim, 128)
        # 3. 输出层 (维度映射回词表大小)
        self.output = nn.Linear(128, vocab_size)

    def forward(self, inputs):
        # inputs: [4] -> embedding后: [4, embedding_dim] -> 求平均: [embedding_dim]
        embeds = torch.mean(self.embeddings(inputs), dim=0).view(1, -1)
        out = F.relu(self.proj(embeds))
        out = self.output(out)
        # 使用 log_softmax 输出对数概率
        nll_prob = F.log_softmax(out, dim=-1)
        return nll_prob
💡 知识点:
-
Embedding(词嵌入):将离散的单词映射到低维连续向量空间,让语义相近的词在空间中距离更近。
-
torch.mean:将4个词的词向量求平均,融合成一个上下文特征向量。
-
LogSoftmax :比普通 Softmax 数值稳定性更好,常与
NLLLoss搭配使用。
🚀 四、 模型训练
定义损失函数和优化器,开始 200 轮的训练。
python
model = CBOW(vocab_size, 10).to(device)
optimizer = optim.Adam(model.parameters(), lr=0.001)
loss_function = nn.NLLLoss()

losses = []
model.train()
print("开始训练模型...")
for epoch in tqdm(range(200)):
    total_loss = 0
    for context, target in data:
        context_vector = make_context_vector(context, word_to_idx).to(device)
        target_tensor = torch.tensor([word_to_idx[target]]).to(device)

        # 前向传播
        train_predict = model(context_vector)
        loss = loss_function(train_predict, target_tensor)

        # 反向传播与优化
        optimizer.zero_grad()  # 梯度清零
        loss.backward()        # 计算梯度
        optimizer.step()       # 更新参数

        total_loss += loss.item()
    losses.append(total_loss)
💡 知识点 :optimizer.zero_grad() 是必须的,因为 PyTorch 的梯度默认会累加,每次迭代前必须手动清零。
🔍 五、 模型测试与预测
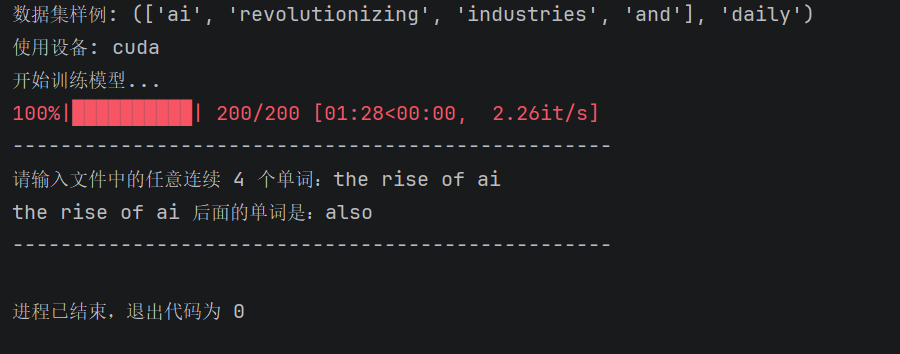
训练完成后,我们输入题目要求的测试用例 ["the", "rise", "of", "ai"] 来验证模型效果。
python
# 题目要求的测试格式
test_context = ["the", "rise", "of", "ai"]
context_vector = make_context_vector(test_context, word_to_idx).to(device)

# 预测
model.eval() # 切换到评估模式
with torch.no_grad(): # 禁用梯度计算,节省显存
    predict = model(context_vector)
    max_idx = predict.argmax(1).item()
    predicted_word = idx_to_word[max_idx]

print("-" * 50)
print(f"请输入文件中的任意连续 4 个单词:{' '.join(test_context)}")
print(f"{' '.join(test_context)} 后面的单词是:{predicted_word}")
print("-" * 50)
💡 知识点 :model.eval() 和 torch.no_grad() 是推理阶段的标准操作。argmax(1) 用于取出概率最大的那个词的索引。
🎯 运行结果展示
在控制台运行上述代码后,模型经过 200 轮训练,最终输出结果如下(截图区域):
📝 总结
本文通过一道实战题,完整演示了N-gram语言模型 的构建过程。从文本预处理、滑动窗口构建数据集,到基于 Embedding 的 CBOW 模型搭建、训练与预测。
核心思想在于:通过神经网络学习词向量(Embedding),并将上下文词向量融合,最终通过全连接层映射到词表空间进行分类预测。