Skill 为什么不同于 Tool?Agent 技能库的自演进与动态加载机制
作 者:吴佳浩(Alben)
公众号:全栈架构师笔记
系列专栏:《企业级 Agent 实战指南---------MCP 与 Agent Tools 工程化落地实战》· 第 04 篇
导读
很多开发者分不清 Tool 和 Skill:Tool 只是螺丝刀,Skill 才是告诉你先拧哪颗螺丝的装配手册。
Tool 是没有业务上下文的通用原子能力,Skill 是经过人类专家固化、带有企业业务 SOP(标准作业程序)的复合经验包。
给 Agent 堆砌 50 个 Tool 只会让它眼花缭乱并引发死循环;按需路由并挂载高质量的 Skill,才是解决长流程复杂任务的唯一正道。
在自研 Agent 的中后期,团队常常会遇到一个极其尴尬的现象: 为 Agent 开发了数十个甚至上百个精密的 MCP Tools(涵盖 Git 操作、K8s 调度、数据库 CRUD、网络探测)。但当给 Agent 下发一个真实的业务任务------"排查线上用户登录延迟变高的原因并生成复盘报告"时,Agent 却经常出现以下三种典型崩溃:
| 绝境现象 | 具体翻车表现 | 架构根因 |
|---|---|---|
| 1. 工具选择瘫痪 | 面向 50 个候选工具时,模型频繁 | Tool 数量暴增导致 Prompt 参数 |
| (Tool Paralysis) | 选错工具或生成无效的参数格式 | 描述相互干扰,注意力严重稀释 |
| 2. 缺乏业务作业范式 | 拥有查日志工具,但不知道先查网关 | 只有原子执行能力,没有专家级 |
| (Lack of SOP) | 还是先查数据库,瞎子摸象式乱试 | 排错与诊断的工作流(SOP)引导 |
| 3. 经验无法沉淀 | 这一次排查成功的复杂链路,下次 | 工具调用是无状态的一次性动作, |
| (No Skill Evolving) | 遇到同类问题依然从零开始探索 | 缺乏经验固化与技能自演进机制 |
要解决这三大问题,架构上必须引入 Skill(技能) 这一层抽象。
Tool 与 Skill 的本质边界在哪里?为什么说 Skill 是 Agent 程序性记忆(Procedural Memory)的代码化落地?
一、Tool vs. Skill:本质边界与正交矩阵
我们必须在系统概念层面将 Tool 和 Skill 进行彻底解耦:
| 对比维度 | Tool (原子工具) | Skill (专家技能 / SOP) |
|---|---|---|
| 本质定位 | 没有业务语义的原子操作指令 | 包含领域知识与执行规程的经验包 |
| 典型载体 | 可执行函数 / MCP Server API | Markdown 规程、Prompt + 脚本 |
| 认知层级 | 手和脚 (Execution) | 肌肉记忆与操作范式 (Cognition) |
| 状态与演进 | 静态不变,由工程师硬编码 | 动态沉淀,可由 Agent 自主演进 |
| 复杂度与范围 | 单点动作 (如 exec_sql(query)) |
多步闭环 (如 DB 慢查询治理 SOP) |
| 隐喻类比 | 手术刀、缝合线 | 完整的心脏搭桥手术指南与步骤 |
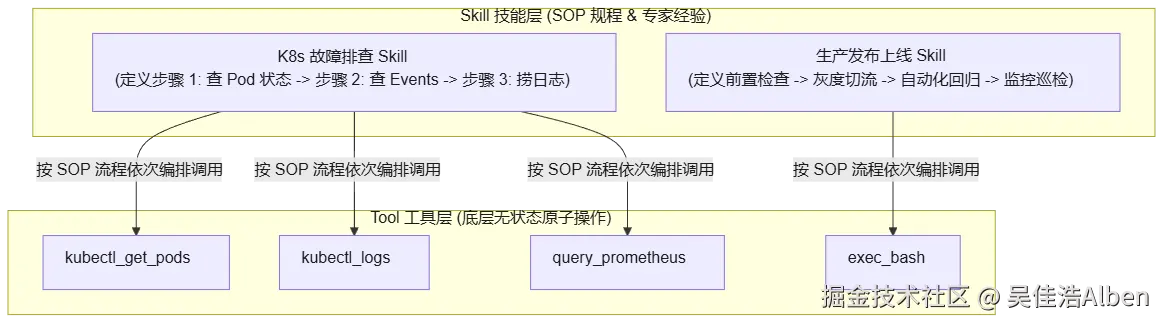
- 🔸 Tool 是原子操作 :它不知道业务目标,只负责输入 A 返回 B;
- 🔸 Skill 是领域规程:它指导 Agent 在遇到特定场景(Trigger)时,如何分阶段、按顺序、有针对性地组合调用 Tool,并提供避坑指南(Pitfalls)与验收标准。
一句话总结这一章的核心观点:
Tool 提供了"能做什么",Skill 规范了"该怎么做"。
二、标准 SKILL.md 规范与动态按需装载架构
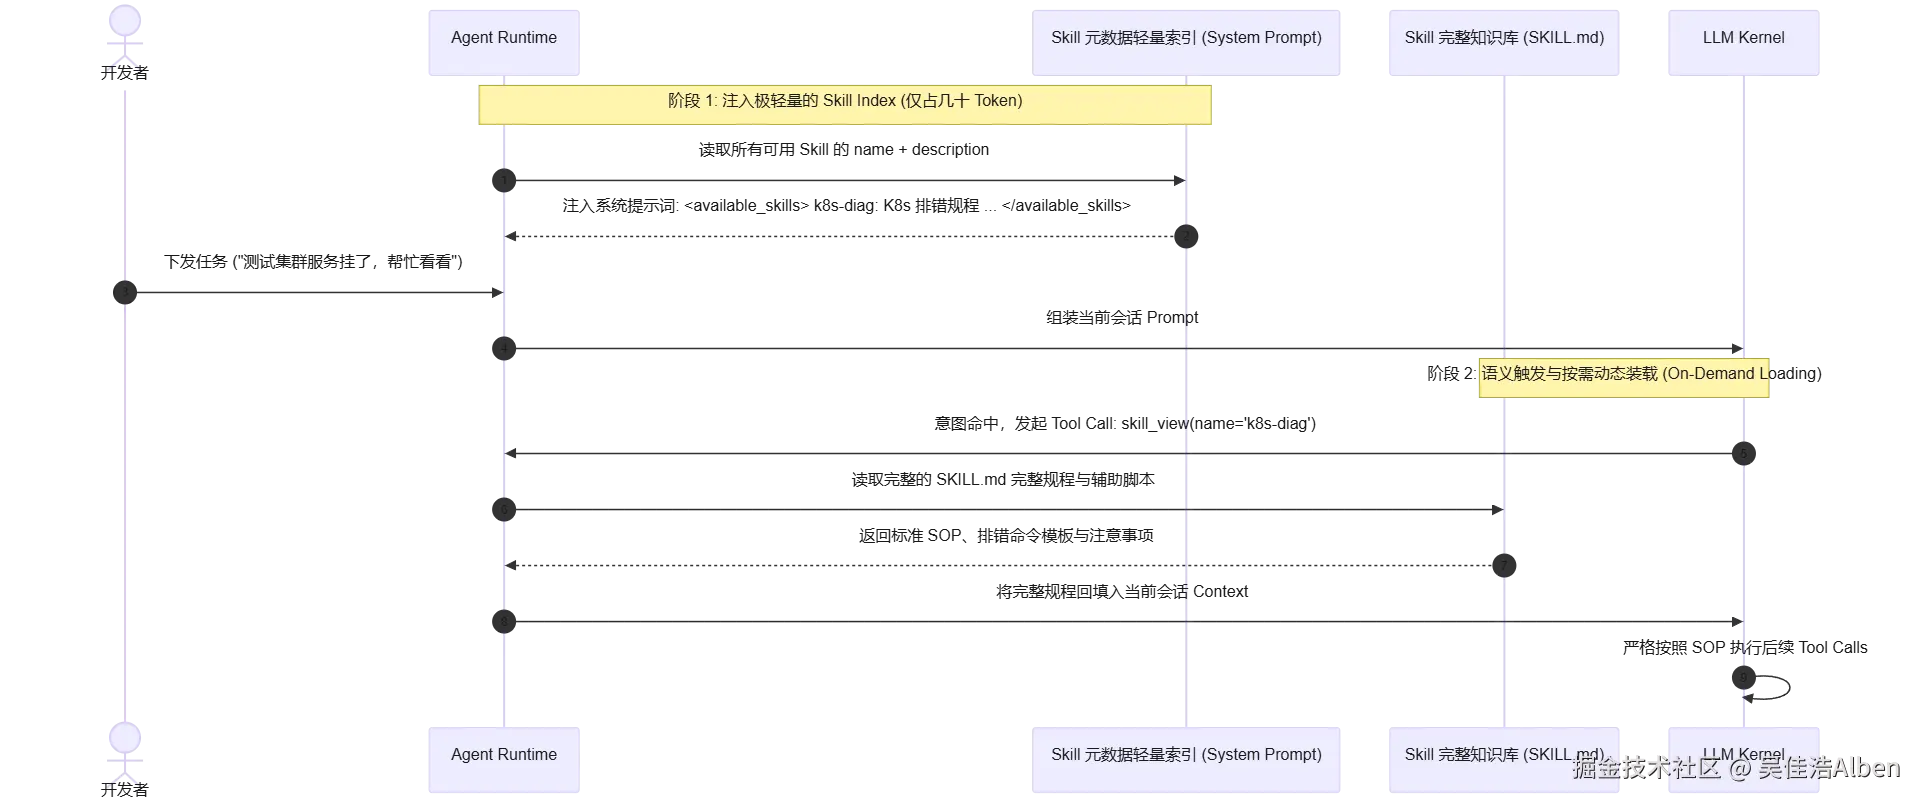
在企业级 Agent(如 Hermes Agent、Claude Code)的设计中,Skill 绝不能无脑全量注入 Prompt。必须采用 双层按需装载(Two-Phase Dynamic Loading) 机制:
标准 SKILL.md 工业级模板结构
markdown
---
name: k8s-pod-troubleshooting
description: "Use when K8s pods are in CrashLoopBackOff, Pending, or OOMKilled states."
version: 1.0.0
author: 吴佳浩(Alben)
category: devops
---

# K8s Pod 故障排查标准作业规程 (SOP)

## 适用场景 (Trigger)
当用户反馈集群服务异常、Pod 频繁重启、健康检查失败时加载本技能。

## 标准执行步骤 (Standard Operating Procedure)
1. **状态初筛**:调用 `run_bash("kubectl get pods -n <ns> -o wide")` 确认异常 Pod;
2. **事件溯源**:优先调用 `run_bash("kubectl describe pod <pod_name>")` 查看 Events 报错;
3. **日志定位**:若状态为 CrashLoop,调用 `run_bash("kubectl logs <pod_name> --previous --tail 100")` 捕获退出前的 Panic 栈;
4. **资源核验**:若为 OOMKilled,比对 Pod Limits 与 Prometheus 内存水位。

## 典型避坑指南 (Pitfalls)
- 🔸 严禁在未确认副本数的情况下直接执行 `kubectl delete pod`;
- 🔸 遇到滚动发布卡死,优先检查 ReadinessProbe 探针配置。

## 验收标准 (Verification)
执行修复操作后,必须连续观察 Pod 状态 30 秒,确认 `READY 1/1` 且 `Restarts` 计数不再增长。
一句话总结这一章的核心观点:
索引常驻保持敏捷,规程按需装载控制预算。这是支撑成百上千 Skill 扩展的核心架构。
三、生产级代码实战:Skill 动态管理与自演进引擎
以下为基于 Python 3.11+ 构建的 Skill 动态生命周期引擎,支持轻量元数据索引提取、按需规程装载与排错成功后的经验自沉淀:
python
"""
skill_runtime_engine.py

生产级 Skill 动态装载与自演进管理器
包含:
- YAML Frontmatter 解析
- 轻量索引生成
- 按需规程加载
"""

import os
import re
from typing import Dict, Optional

import yaml
from pydantic import BaseModel


class SkillMetadata(BaseModel):
    """Skill 元数据"""

    name: str
    description: str
    version: str = "1.0.0"
    category: str = "general"
    file_path: str


class SkillRuntimeManager:
    """企业级 Skill 运行时生命周期总控"""

    def __init__(self, skills_dir: str):
        self.skills_dir = skills_dir
        self.skill_cache: Dict[str, SkillMetadata] = {}
        self._scan_and_index_skills()

    def _scan_and_index_skills(self) -> None:
        """扫描目录并构建轻量级索引缓存(仅解析 YAML Frontmatter)"""

        self.skill_cache.clear()

        if not os.path.exists(self.skills_dir):
            os.makedirs(self.skills_dir, exist_ok=True)
            return

        for root, _, files in os.walk(self.skills_dir):
            for filename in files:
                if not filename.endswith(".md"):
                    continue

                full_path = os.path.join(root, filename)
                meta = self._parse_frontmatter(full_path)

                if meta:
                    self.skill_cache[meta.name] = meta

    def _parse_frontmatter(self, file_path: str) -> Optional[SkillMetadata]:
        """解析 Markdown Frontmatter"""

        try:
            with open(file_path, "r", encoding="utf-8") as f:
                content = f.read()

            match = re.match(
                r"^---\s*\n(.*?)\n---\s*\n(.*)$",
                content,
                re.DOTALL,
            )

            if not match:
                return None

            fm_data = yaml.safe_load(match.group(1))

            return SkillMetadata(
                name=fm_data.get(
                    "name",
                    os.path.splitext(os.path.basename(file_path))[0],
                ),
                description=fm_data.get("description", ""),
                version=str(fm_data.get("version", "1.0.0")),
                category=fm_data.get("category", "general"),
                file_path=file_path,
            )

        except Exception as e:
            print(f"Failed to parse skill at {file_path}: {e}")
            return None

    def generate_system_prompt_index(self) -> str:
        """
        生成常驻 System Prompt 的轻量索引,
        避免把完整 Skill 全部塞进 Prompt。
        """

        if not self.skill_cache:
            return ""

        lines = ["<available_skills>"]

        for name, meta in self.skill_cache.items():
            short_desc = (
                meta.description[:60] + "..."
                if len(meta.description) > 60
                else meta.description
            )

            lines.append(f"  - {name}: {short_desc}")

        lines.append("</available_skills>")
        lines.append(
            "Use 'skill_view(name)' to load full SOP when the task matches a skill trigger."
        )

        return "\n".join(lines)

    def load_skill_content(self, skill_name: str) -> str:
        """按需装载完整 Skill"""

        meta = self.skill_cache.get(skill_name)

        if not meta:
            return f"Error: Skill '{skill_name}' not found."

        try:
            with open(meta.file_path, "r", encoding="utf-8") as f:
                return f.read()

        except Exception as e:
            return f"Error reading skill file: {e}"

    def auto_crystallize_skill(
        self,
        name: str,
        description: str,
        sop_body: str,
        category: str = "custom",
    ) -> str:
        """
        经验自沉淀:
        将成功完成任务后的 SOP 自动固化成新的 Skill。
        """

        skill_file = os.path.join(self.skills_dir, f"{name}.md")

        full_doc = (
            "---\n"
            f"name: {name}\n"
            f'description: "{description}"\n'
            "version: 1.0.0\n"
            f"category: {category}\n"
            "---\n\n"
            f"{sop_body}\n"
        )

        with open(skill_file, "w", encoding="utf-8") as f:
            f.write(full_doc)

        # 刷新索引
        self._scan_and_index_skills()

        return (
            f"Successfully crystallized skill '{name}' "
            f"to {skill_file}."
        )
本篇总结
- 🔸 Tool 是手术刀,Skill 是手术指南:必须将通用执行动作与业务 SOP 规程彻底解耦;
- 🔸 轻量索引常驻 + 完整规程按需装载:彻底解决 50+ 工具带来的 Prompt 膨胀与注意力瘫痪;
- 🔸 标准 SKILL.md 四要素:适用场景、标准步骤、避坑指南与验收标准;
- 🔸 经验自沉淀机制:让 Agent 在排错成功后具备自动沉淀程序性记忆的自进化能力。
筒子们本篇为《企业级 Agent 实战指南》· 第二章的第 4 篇,至此,我们的**第二章《MCP 与 Agent Tools 工程化落地实战》(共 4 篇)**全部圆满落盘! 后续续会更新完整的agent的开发的全部过程,如果你对Agent开发感兴趣不妨关注一下本合集。
接下来,我们将正式开启第三章节:《Multi-Agent 架构设计:从单体 ReAct 到群智协同》,带你拆解多智能体系统的通信协议、共享黑板与死锁治理!