摘要
本文围绕 DeepSeek、GLM、Qwen 三类模型,实测它们在蓝耘元生代 MaaS 上驱动 Claude Code
时的延迟、吞吐、成本与代码能力表现。所有实验测试数据均由本人兴趣自测,不一定准确,附 AI Ping 榜单交叉验证。
Claude Code 大概是今年我用得最顺手的 coding agent------读项目、改代码、跑测试,一条命令一路推到底。但它满血模型毕竟是 Anthropic 官方模型,国内无法直接访问,价格也不便宜。
于是我一直想搞清楚一个问题:国产大模型,能不能平替驱动 Claude Code?而且要换得省心、用得便宜。
我把 GLM-5.2、DeepSeek-V3.2、Qwen3.7-Plus 三款模型,统一挂在蓝耘元生代 MaaS 这一个网关上,让它们在 Claude Code 里跑同一个真实编码任务,从延迟、吞吐、缓存成本、工具调用四个维度横向 PK。
一、结论先放这儿
| 维度 | GLM-5.2 | DeepSeek-V3.2 | Qwen3.7-Plus |
|---|---|---|---|
| 输入/输出定价(元/百万token) | 8 / 28 | 2 / 3 | 6 / 24 |
| TTFT 首字延迟 p95(自测) | 1.15s | 2.55s | 1.64s |
| 吞吐 TPS(自测,tok/s) | ~40--55 | ~24 | ~54 |
| 缓存命中率(自测,显式 cache_control) | 间歇命中(~99%) | 0%(未命中) | 98%(稳定) |
| 同任务代码完成度 / tool_use | 见第七节 | 见第七节 | 见第七节 |
一句话选型 :延迟敏感选 GLM-5.2 (p95 最低);Claude Code 这种高频重发上下文的 Agent 场景选 Qwen3.7-Plus (缓存稳定命中 98%,即便单价是 DeepSeek 的 3 倍,算总账反而更省);纯跑量、不在意延迟和缓存再选 DeepSeek-V3.2(单价最低,但 TTFT 最慢、缓存命中率比较低)。
二、为什么用蓝耘做这次横评的"裁判台"
横向对比最怕"控制变量"没做好。如果 GLM 用智谱官方 API、DeepSeek 用深度求索官方、Qwen 用阿里官方,那三个模型跑出来的差异里,混进了三家网络链路、三套限流策略、三种计费口径的差异------你根本说不清是模型本身强,还是它家机房离你近。
所以我需要一个统一网关:一个 Key、一套协议、一条链路,只换模型名。蓝耘元生代 MaaS 正好满足:
- 多模聚合:DeepSeek、Qwen、GLM、Kimi、MiniMax、Claude、GPT 等 50+ 模型挂在一个网关后,换模型就是改一行配置;
- 原生 Anthropic 端点:这一点是关键,下面单讲,它决定了 Claude Code 能不能"零翻译层直连";
- 统一计费 + 用量看板:三款模型的 token 消费在同一张账单里,成本对比口径一致;
- 真实生产验证:平台服务过智谱、MiniMax 等头部大模型公司,稳定性不是实验室 demo 级别。
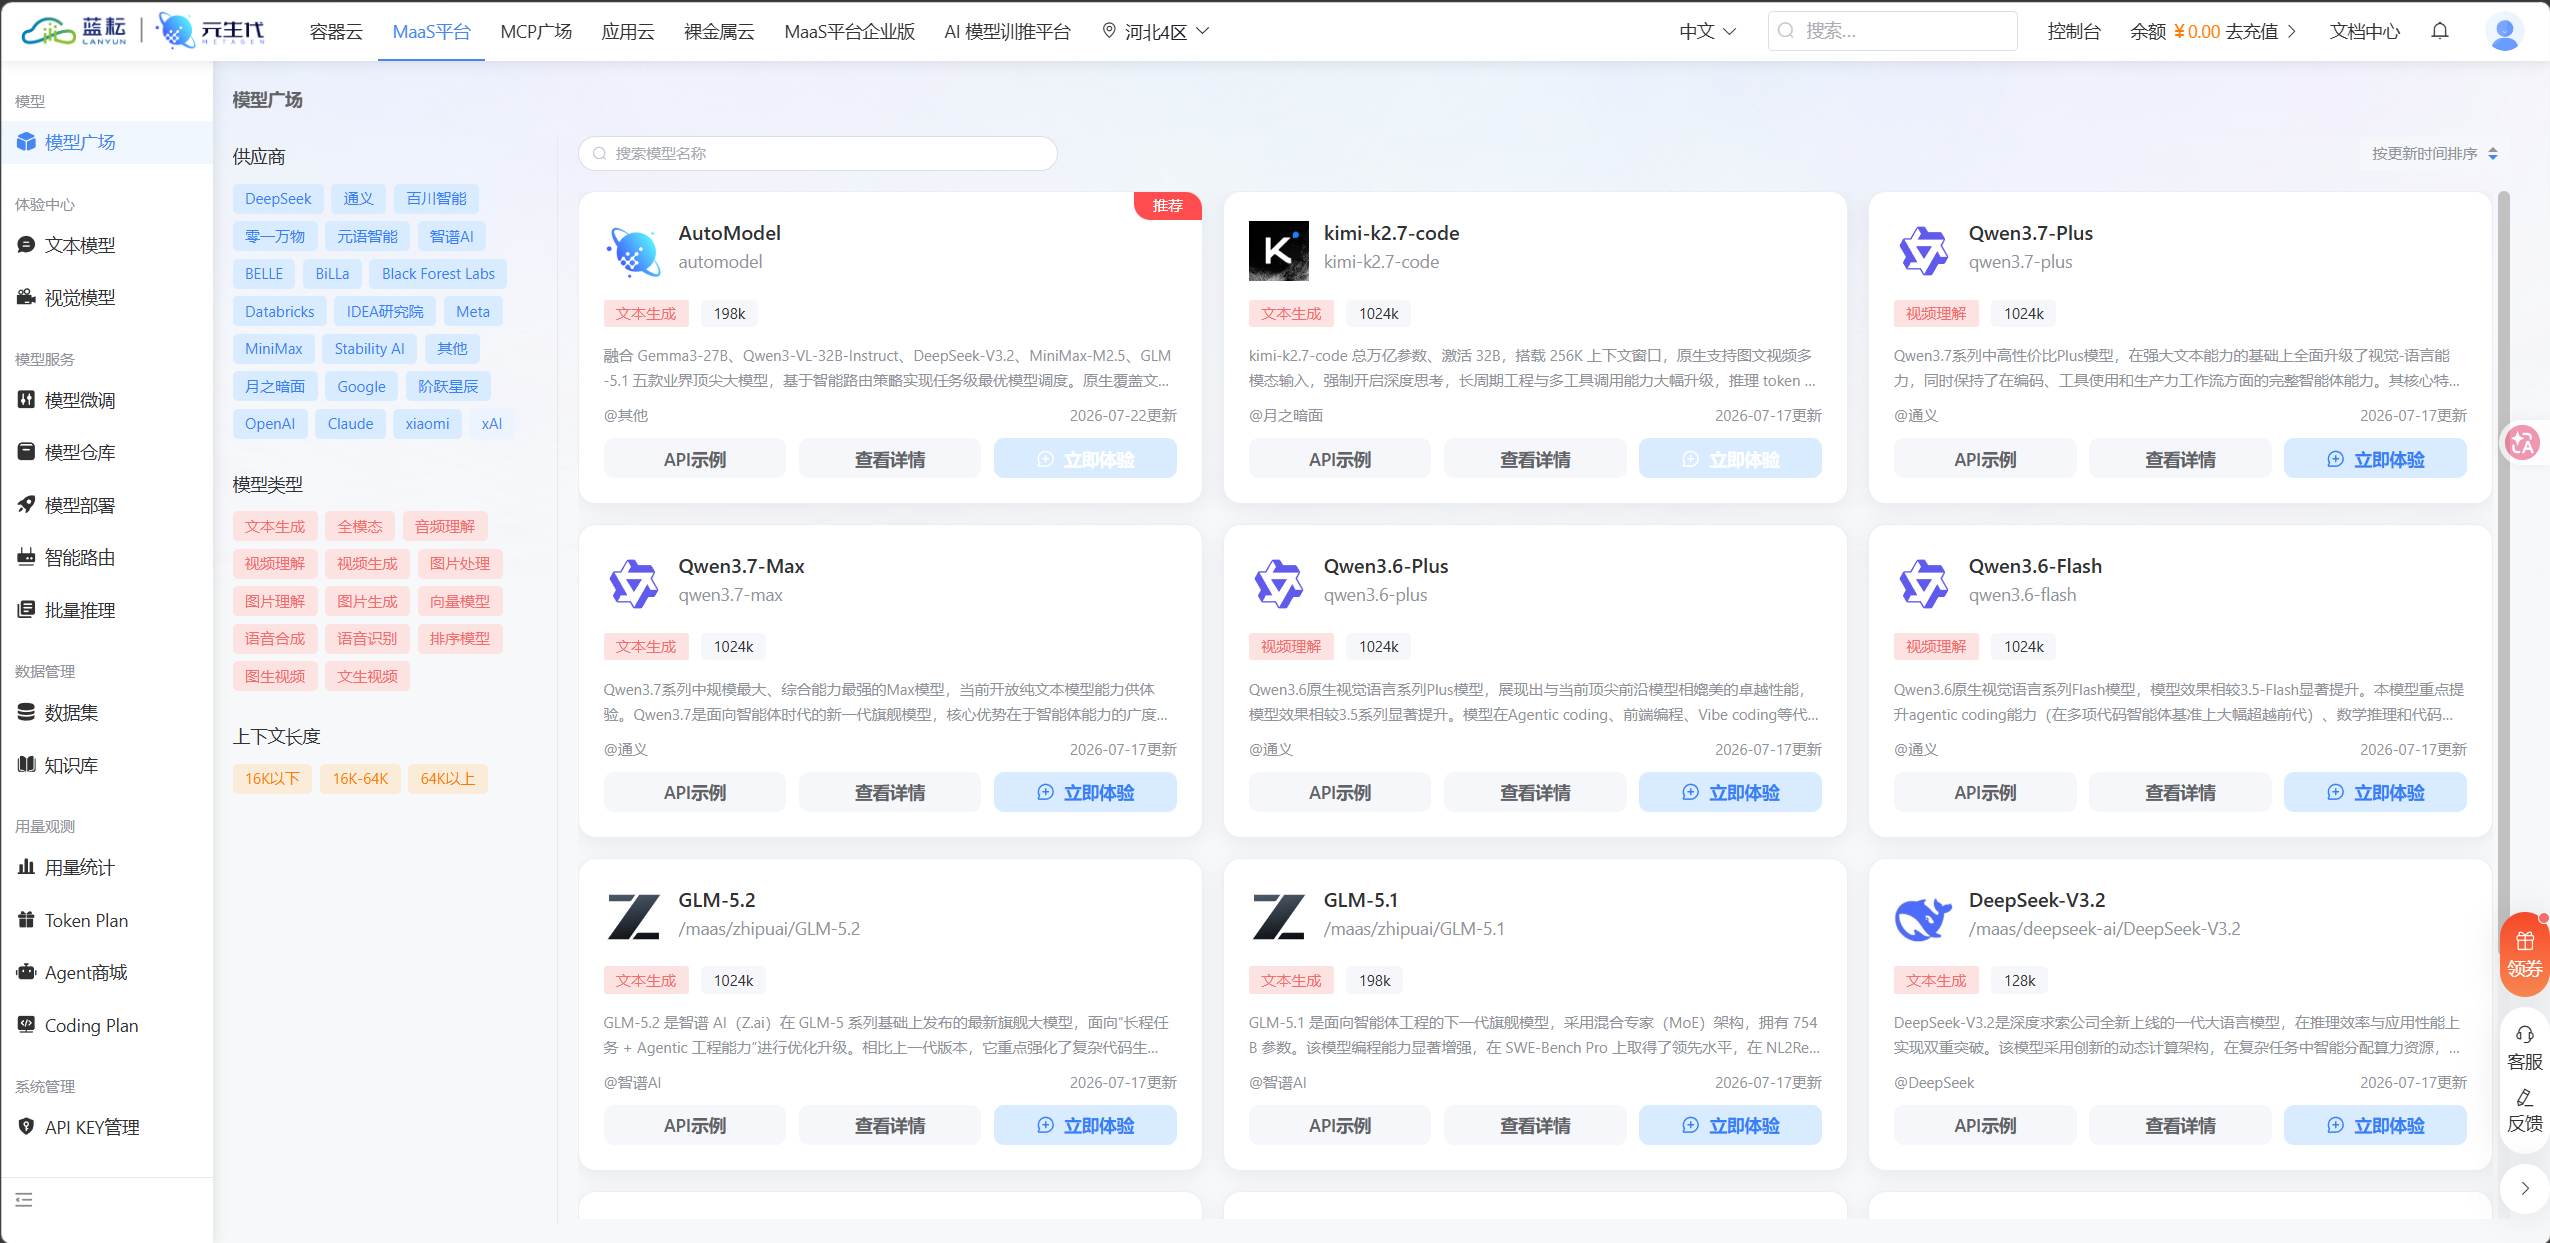
一句话:用蓝耘做裁判台,三模型的对比才公平。
三、5 分钟把 Claude Code 接上蓝耘
3.1 配置 Claude code
Claude Code 支持 macOS、Windows、Linux 和 WSL,安装前需准备 Node.js、Git(Windows)、终端环境及 API Key。
-
安装 Node.js(核心依赖)
-
- 要求: 版本号必须 ≥ 18。
- 操作: 前往 Node.js 官网,下载并安装 LTS(长期支持)版本。
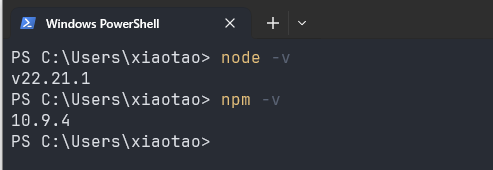
- 验证: 打开你的终端(Windows 的 CMD/PowerShell,或 Mac 的 Terminal),输入 node -v 和 npm -v。如果能正确返回版本号,则说明安装成功。
-
安装 Git
-
- 安装 Git,下载 Git for Windows:git-scm.com/install,默认选项安装即可。
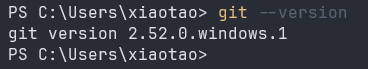
- 验证安装:git --version,输出版本号表示成功。
-
安装 Claude code
-
**Claude Code**有两种安装方式,个人比较推荐使用**npm**进行安装。
plain
方式一:npm安装
npm install -g @anthropic-ai/claude-code

方式二:原生安装
curl -fsSL https://claude.ai/install.cmd -o install.cmd && install.cmd && del install.cmd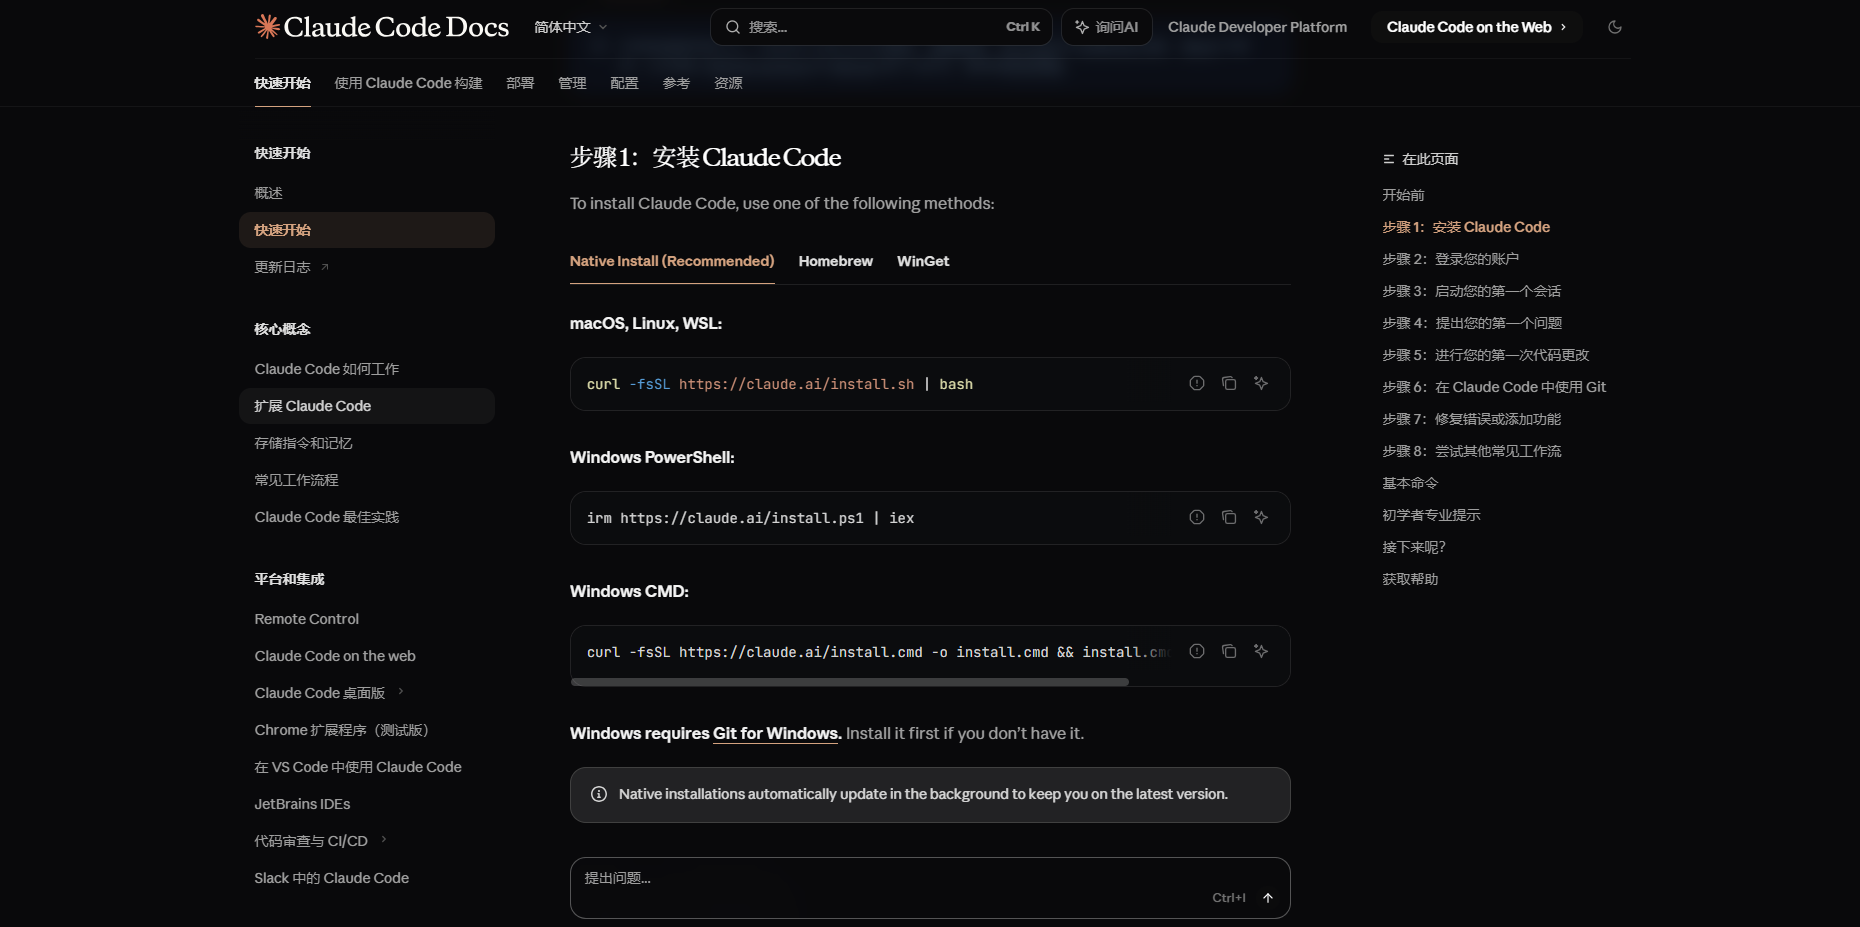
-
- 验证安装:claude --version
3.2 创建 Api Key
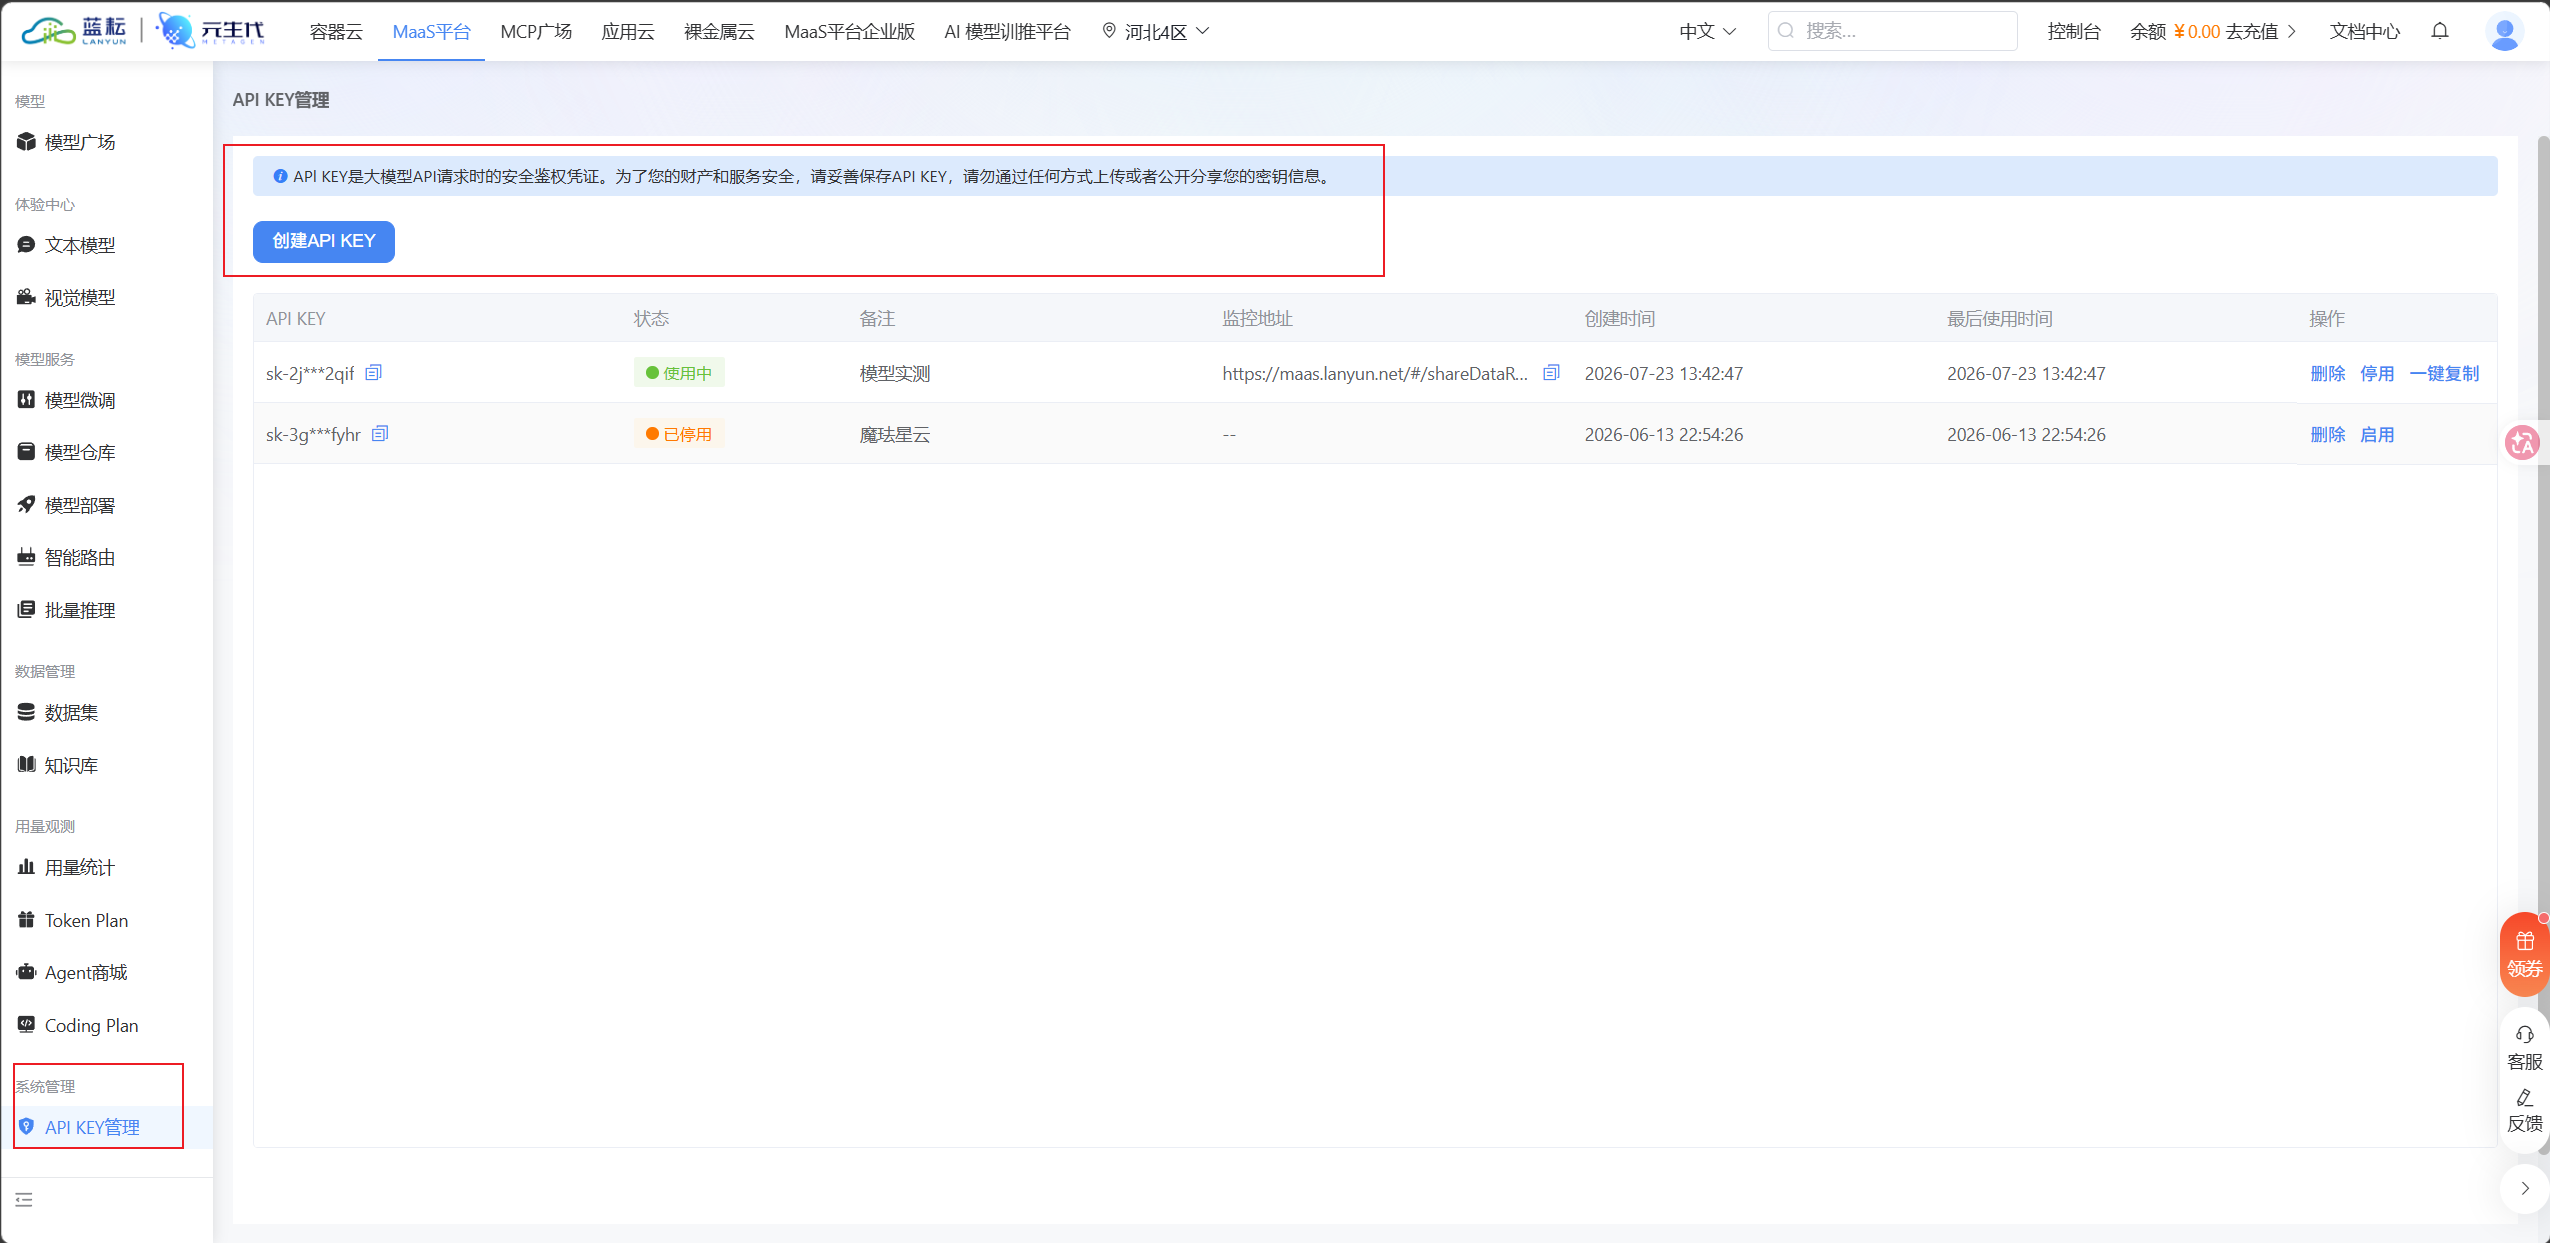
到蓝耘元生代 MaaS 控制台注册登录、充值、再创建 API Key。
这里有个我替你踩过的坑:账户余额为空时,建出来的 Key 一调用就报 **invalid company api key**。必须先充值,再建 Key。
3.3 配置 Claude code,接入模型
Claude Code 使用的是 Anthropic 协议 (/v1/messages,认证用 x-api-key);而 DeepSeek、Qwen 这些模型原生是 OpenAI 的协议 (/v1/chat/completions,认证用 Bearer)。两者不通。
接 Claude Code 通常有两条路:
- 路 A :平台只有 OpenAI 端点,你得自己挂一层
claude-code-router或LiteLLM做协议翻译------能用,但多一个进程、多一个故障点、多一份延迟。 - 路 B :平台直接提供 Anthropic 兼容端点,填几个环境变量就完事,零翻译层。
蓝耘给了 Anthropic 端点,所以我们走路 B,直连:
plain
# bash / Git Bash
export ANTHROPIC_BASE_URL=https://maas-api.lanyun.net/anthropic
export ANTHROPIC_API_KEY=你的蓝耘Key
export ANTHROPIC_MODEL=/maas/zhipuai/GLM-5.2     # 换模型只改这一行
Windows PowerShell 版:
plain
$env:ANTHROPIC_BASE_URL="https://maas-api.lanyun.net/anthropic"
$env:ANTHROPIC_API_KEY="你的蓝耘Key"
$env:ANTHROPIC_MODEL="/maas/zhipuai/GLM-5.2"
**长期使用,不希望每次使用都设置环境变量,**可以直接改 ~/.claude/settings.json 的 env 字段配置模型即可。
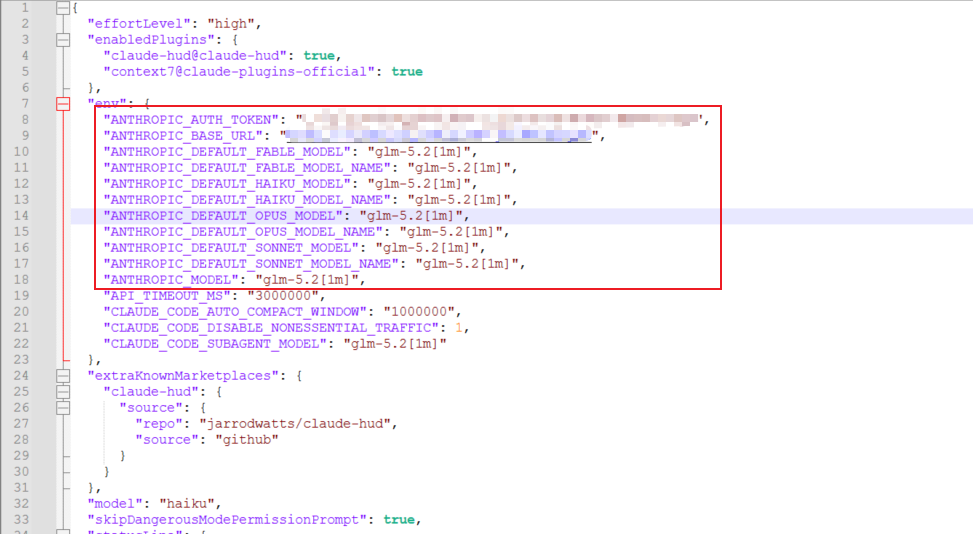
这里我使用的是CC Switch去配置,可以一键切换、配置Claude code、codex等主流Ai编程工具的配置文件,比较方便。
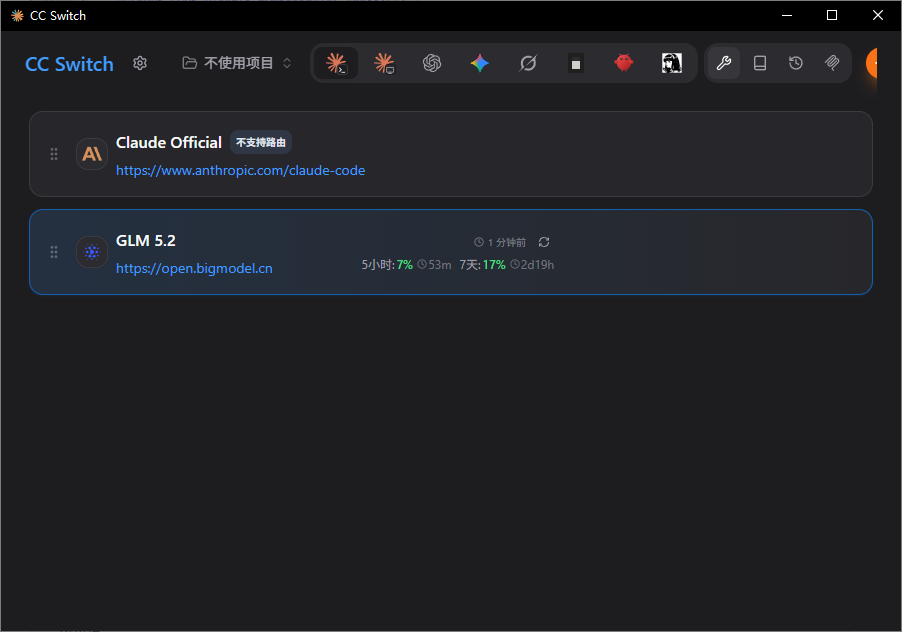
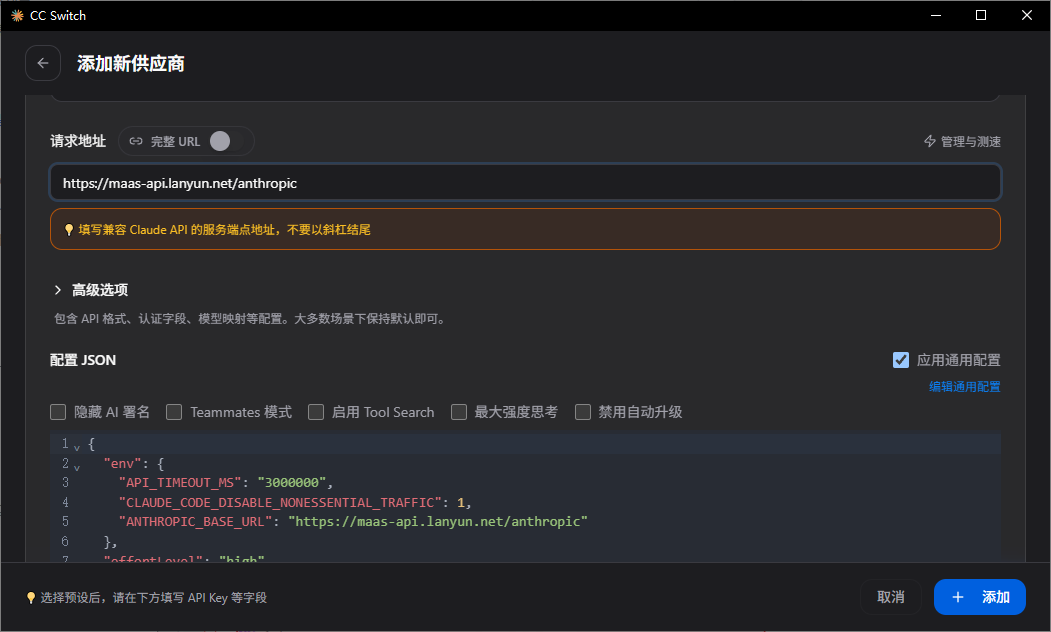
3.4 三个必踩的坑
- URL 填到
**/anthropic**就停 。后面的/v1/messages是 Claude Code 自己补的,你画蛇添足写全,反而 404。 - 模型名带
**/maas/**前缀 。比如 DeepSeek 是/maas/deepseek-ai/DeepSeek-V3.2,不是干巴巴的deepseek-chat,写错直接 404。具体名以控制台模型详情页的「API 示例」为准。 - 充值。见 3.1,不充值 Key 激活不了。
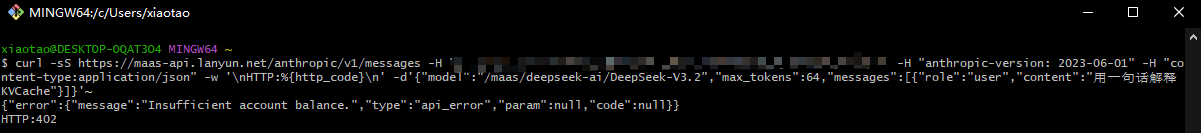
3.5 连接测试
新 API 到手,我第一件事永远是发一个最小请求确认连通,顺便看返回结构:
plain
# bash / Git Bash
curl -sS https://maas-api.lanyun.net/anthropic/v1/messages \
  -H "x-api-key: sk-2j3viruxd45lexv6aejirx5ygr55sibqngs33i6dbpff2qif" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{"model":"/maas/deepseek-ai/DeepSeek-V3.2","max_tokens":64,
       "messages":[{"role":"user","content":"用一句话解释 KV Cache"}]}'
重点不是看回答对不对,而是看返回里的 usage 字段------尤其 prompt_tokens_details.cached_tokens。它的存在意味着平台把"缓存命中多少 token"透明告诉你了,这是后面算成本账的基础。
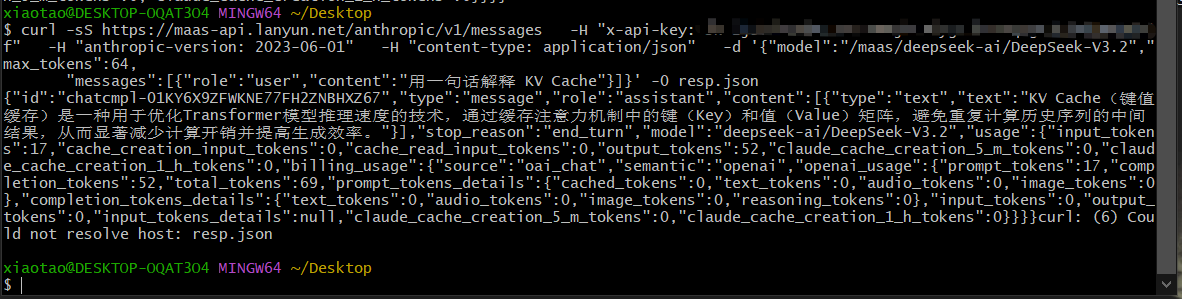
四、评测方法论:三条铁律 + 一个增量
网上大量"Claude Code 接 XX 模型"的教程,填完 base_url 能聊天就算完事。但能聊天 ≠ 能干活。我把方法论压成三句话:
延迟看尾部,成本看缓存,Agent 看工具调用。
- 延迟看尾部(p95/p99) :Agent 一个活儿要连发十几次请求,平均值会抹平"偶尔暴雷",你体感到的恰恰是暴雷瞬间。所以看 p95。流式下
curl -w "%{time_starttransfer}"约等于首字延迟 TTFT。 - 成本看缓存:Claude Code 每轮都把系统提示词、工具定义、文件上下文重发一遍,动辄上万 token。支不支持提示词缓存、缓存怎么计价,是 Agent 场景最大的省钱杠杆。只看单价那个"元/百万token"远远不够。
- Agent 看工具调用(本次核心增量) :Claude Code 的本质是 Agent,靠稳定、格式正确地发起
tool_use(读/写文件、跑命令)干活。很多 OpenAI 兼容网关一遇到 function calling 就静默降级。所以验证接入成功,绝不能只问"你好",必须让它做一件真正要读写文件的活。
最后,测的数据拿第三方榜单交叉验证,不然容易自我感觉良好。这里三方榜单我使用的是 AI Ping(aiping.cn),数据比较全面。
五、实测:延迟(TTFT 尾部)
方法 :同一 prompt("用三句话解释缓存"),三模型各流式连打 8 次,记录 time_starttransfer,统计 min / p50 / p95 / max,且校验每次 HTTP 200 才计入 (避免 404/401 混进来当假数据)。脚本见附录 benchmark.sh 关卡 2。
| 模型 | min | p50 | p95 | max | 波动评价(max−min) |
|---|---|---|---|---|---|
| GLM-5.2 | ~0.88s | ~1.01s | ~1.15s | ~1.15s | 0.27s,最快 |
| DeepSeek-V3.2 | ~1.43s | ~2.25s | ~2.55s | ~3.62s | 2.19s,最慢且抖动大 |
| Qwen3.7-Plus | ~1.16s | ~1.37s | ~1.64s | ~2.43s | 1.45s,比较稳 |
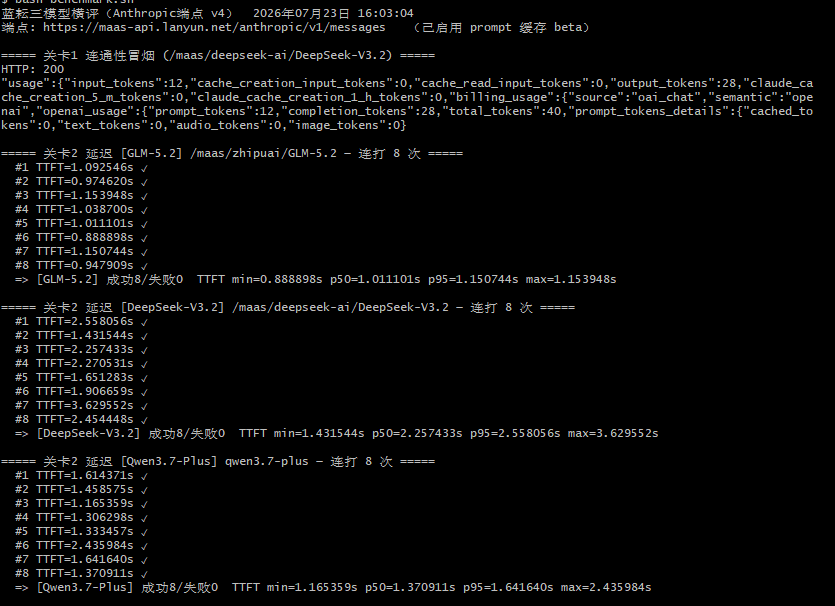
GLM-5.2 的 p95 压到了 1.15s,是三者里首字最快的;Qwen3.7-Plus 紧随其后,而且窗口最窄(max−min 只有 0.27s),意味着它的延迟方差最小------对 Agent 这种"连发几十次请求"的场景,稳定比偶尔的峰值更重要。DeepSeek-V3.2 则明显吃力,p95 到了 2.55s,最差一次飙到 3.62s,卡顿感会最强。
六、实测:缓存与成本
6.1 缓存命中
方法 :构造约 1.1 万 token 的大 system 上下文,一字不差 地连发 5 轮,每轮带显式 cache_control + anthropic-beta 头,对比 cache_read_input_tokens。脚本见 benchmark.sh 关卡 3。
| 模型 | 第1轮 | 第2轮 | 第3轮 | 命中表现 |
|---|---|---|---|---|
| GLM-5.2 | 0 | 0 | 11392 | 间歇命中(5 轮中 2 次,命中率约 99%) |
| DeepSeek-V3.2 | 0 | 0 | 0 | 全程未命中 |
| Qwen3.7-Plus | 0 | 10624 | 10624 | 稳定命中 98%(10624/10816) |
这是本次横评最有意思的一组数据。三款模型在"同一个网关、同一种缓存用法"下,缓存表现天差地别------Qwen3.7-Plus 几乎是即开即用,第二轮起就稳定命中 98% ;GLM-5.2 能命中(命中时比例高达 99%),但时灵时不灵,推测跟缓存写入的时序/调度有关;DeepSeek-V3.2 在本测试里完全没命中过。
6.2 成本算账
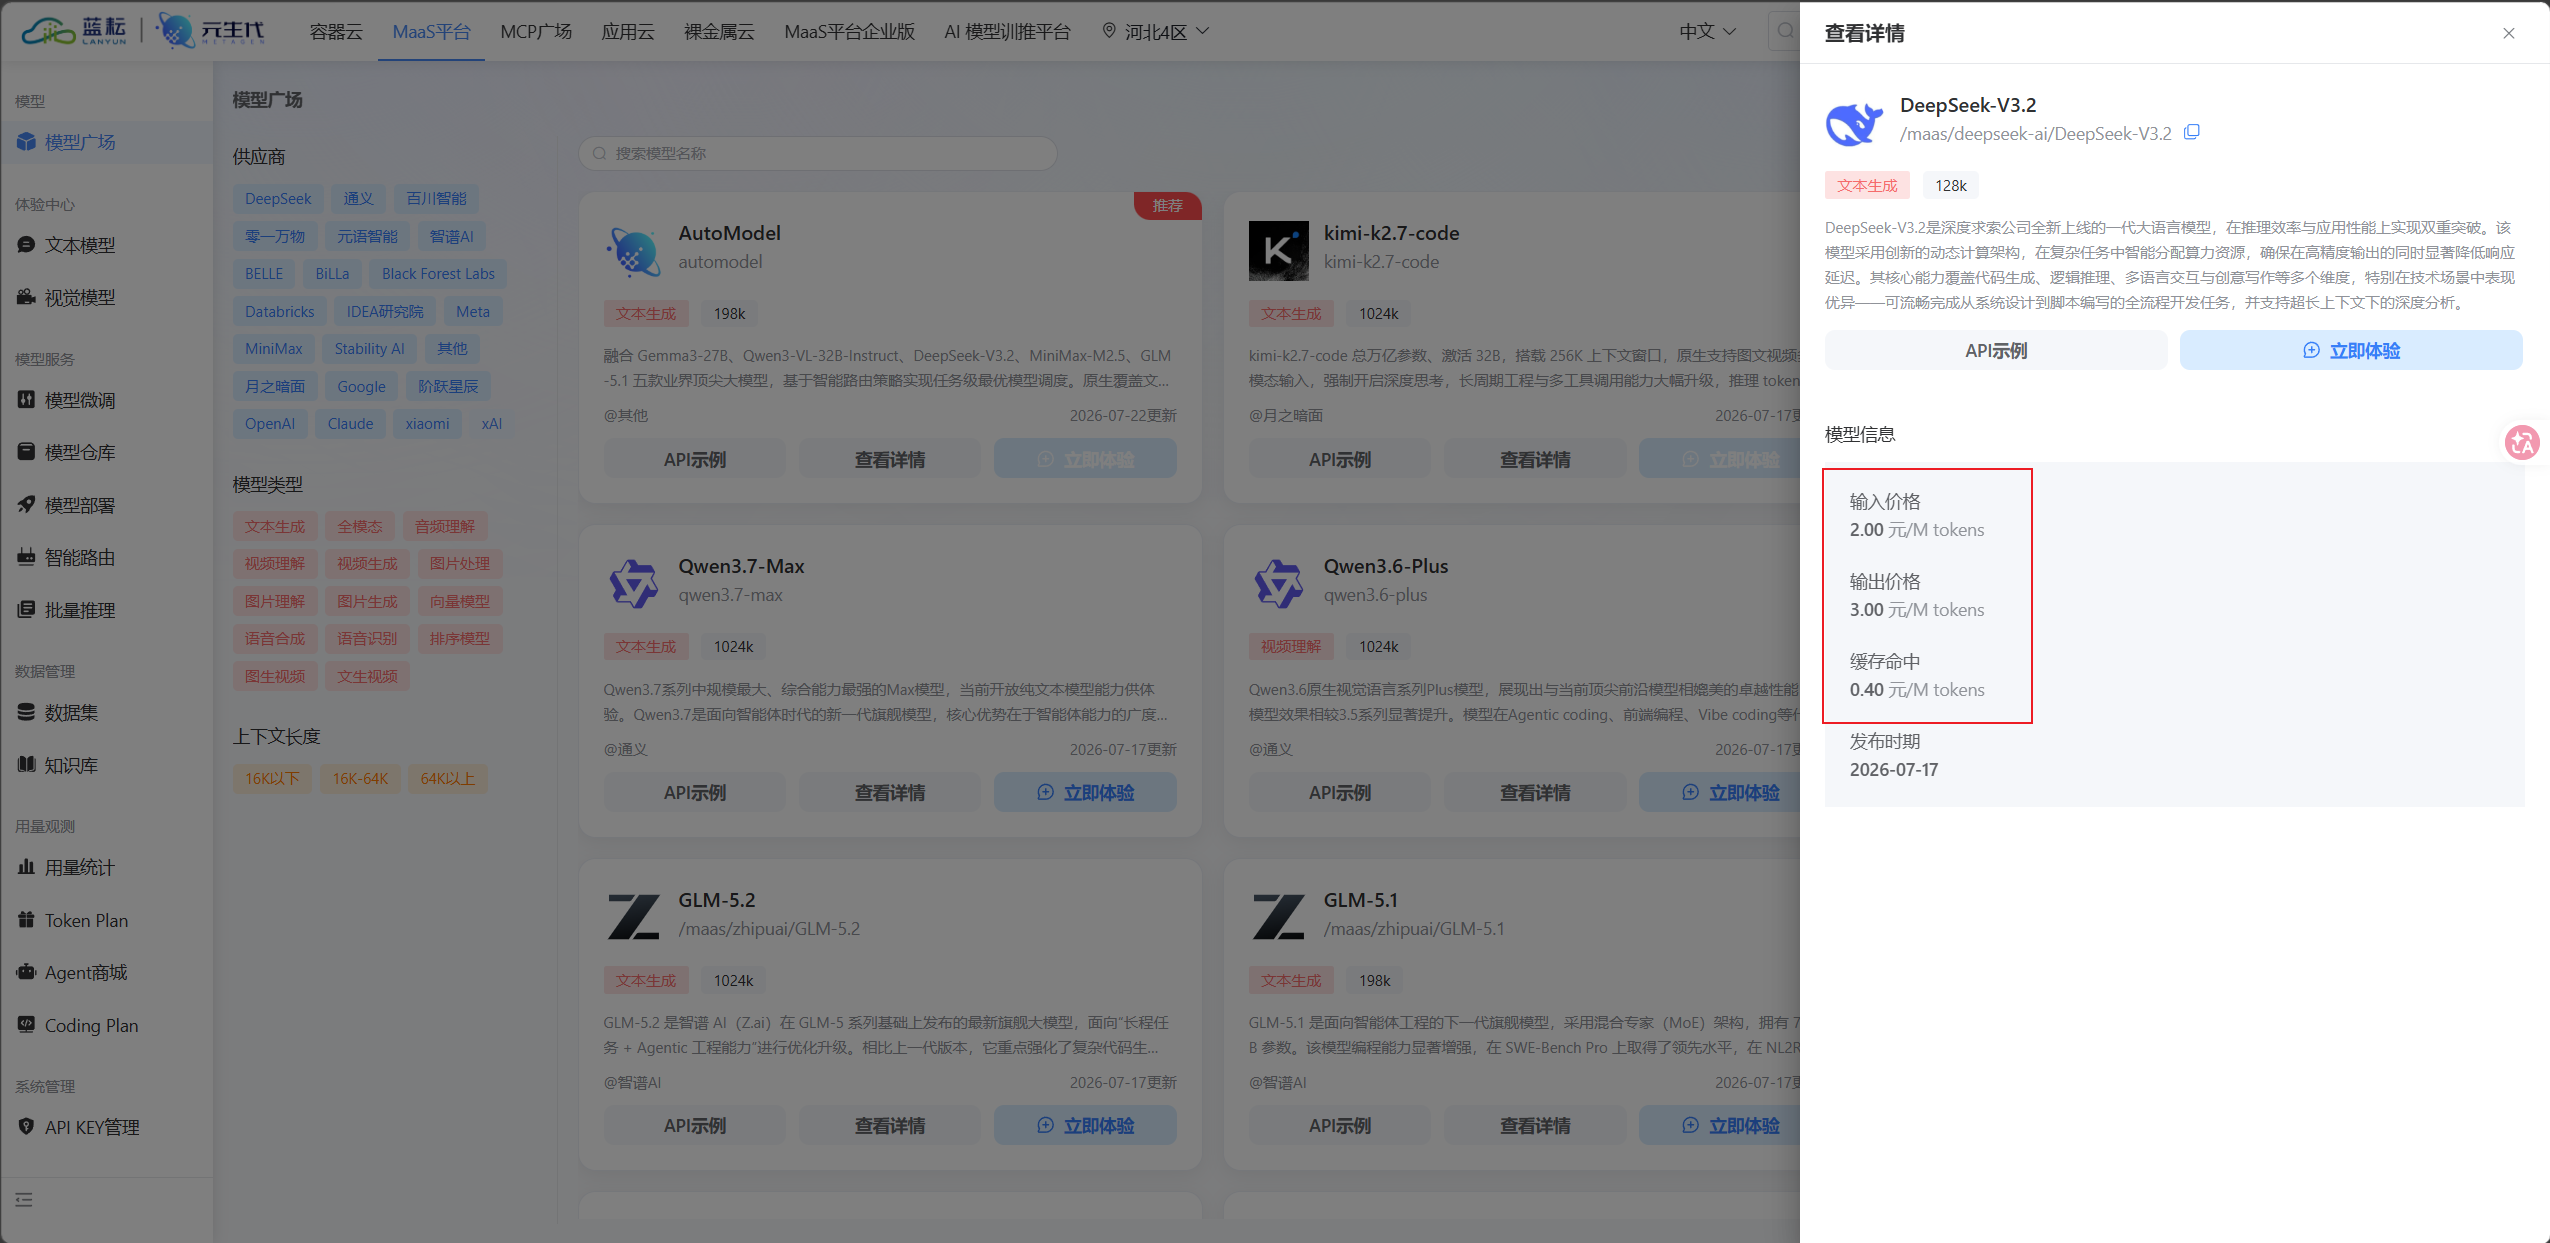
以 DeepSeek-V3.2 为例,蓝耘定价输入 2 元/百万 token,缓存命中价约 0.40 元/百万 tokens。假设一个任务跑 20 轮、每轮重发 6000 token 上下文:
- 不走缓存:20 × 6000 × 2元/M ≈ 0.24 元
- 走缓存(第二轮起命中):约 0.05 元
同一个任务,光输入这块就差了将近 5 倍------这就是为什么"单价低 ≠ 总账低",缓存才是 Agent 场景的省钱杠杆。
七、实测:代码能力 + tool_use(核心增量)
前面三关是 API 层的延迟/缓存/吞吐,这一关才是"Claude Code 真实干活"的能力------也是本次活动区分度最高、最容易出彩的部分。
怎么测 :Claude Code 的本质是一个 tool_use agent 循环 ------发任务、模型回 tool_use、本地执行工具、把结果喂回去、直到任务完成。我写了一个 Node agent 忠实复刻这套循环:定义 write_file / read_file / bash 三件套工具,对接同一个蓝耘 Anthropic 端点 ,只换 model 字段------等价于"只改 ANTHROPIC_MODEL 一行"。三模型各自在独立空目录里跑同一条指令 ,全程记录轮数、工具调用序列、有没有把 tool_use 吐歪、最后客观执行 node test.js 能不能 PASS。
统一任务:在空目录下,用 Node.js(仅内置模块)实现简易待办 API(POST 新增 / GET 列表 / DELETE 删除,内存存储),并写 test.js 自启自停、端到端验证打印 PASS。
测试条件统一 max_tokens=8192(贴近 Claude Code 默认)。
| 模型 | 是否自主完成 | 工具链顺畅度 | 代码能否跑通 | tool_use 报错 | 总评 |
|---|---|---|---|---|---|
| GLM-5.2 | ✅(需 max_tokens≥8192) | 11 轮 / 12 次调用,bash 连调 6 次排错,最曲折 | ✅ PASS / exit 0(已独立复跑) | 无格式错误;首轮 reasoning=1595 token | 思维链模型,token 预算敏感、路径最绕,效果最好 |
| DeepSeek-V3.2 | ✅ | 7 轮 / 6 次调用,遇错自我迭代修复 | ✅ PASS / exit 0(已独立复跑) | 无,格式零报错 | 最稳、能自我排错;本轮最慢(141s) |
| Qwen3.7-Plus | ✅ | 4 轮 / 3 次调用,write×2→bash 一次成型 | ✅ PASS / exit 0(已独立复跑) | 无 | 最高效:轮次最少、最快(41.8s)、最省 token(1854) |
**实测发现:蓝耘 Anthropic 端点,三家模型的 tool_use 全程零格式报错,**拿来直接喂 Claude Code 是靠谱的,不用自己写格式兜底,特别关注的是 **GLM-5.2 是思维链(thinking)模型,前期花费token比较大,但是效果最好,**Qwen3.7-Plus 则比较稳定,DeepSeek-V3.2 由于是较老模型,效果对比其他旗舰模型还是差了一点。
八、AI Ping 交叉验证
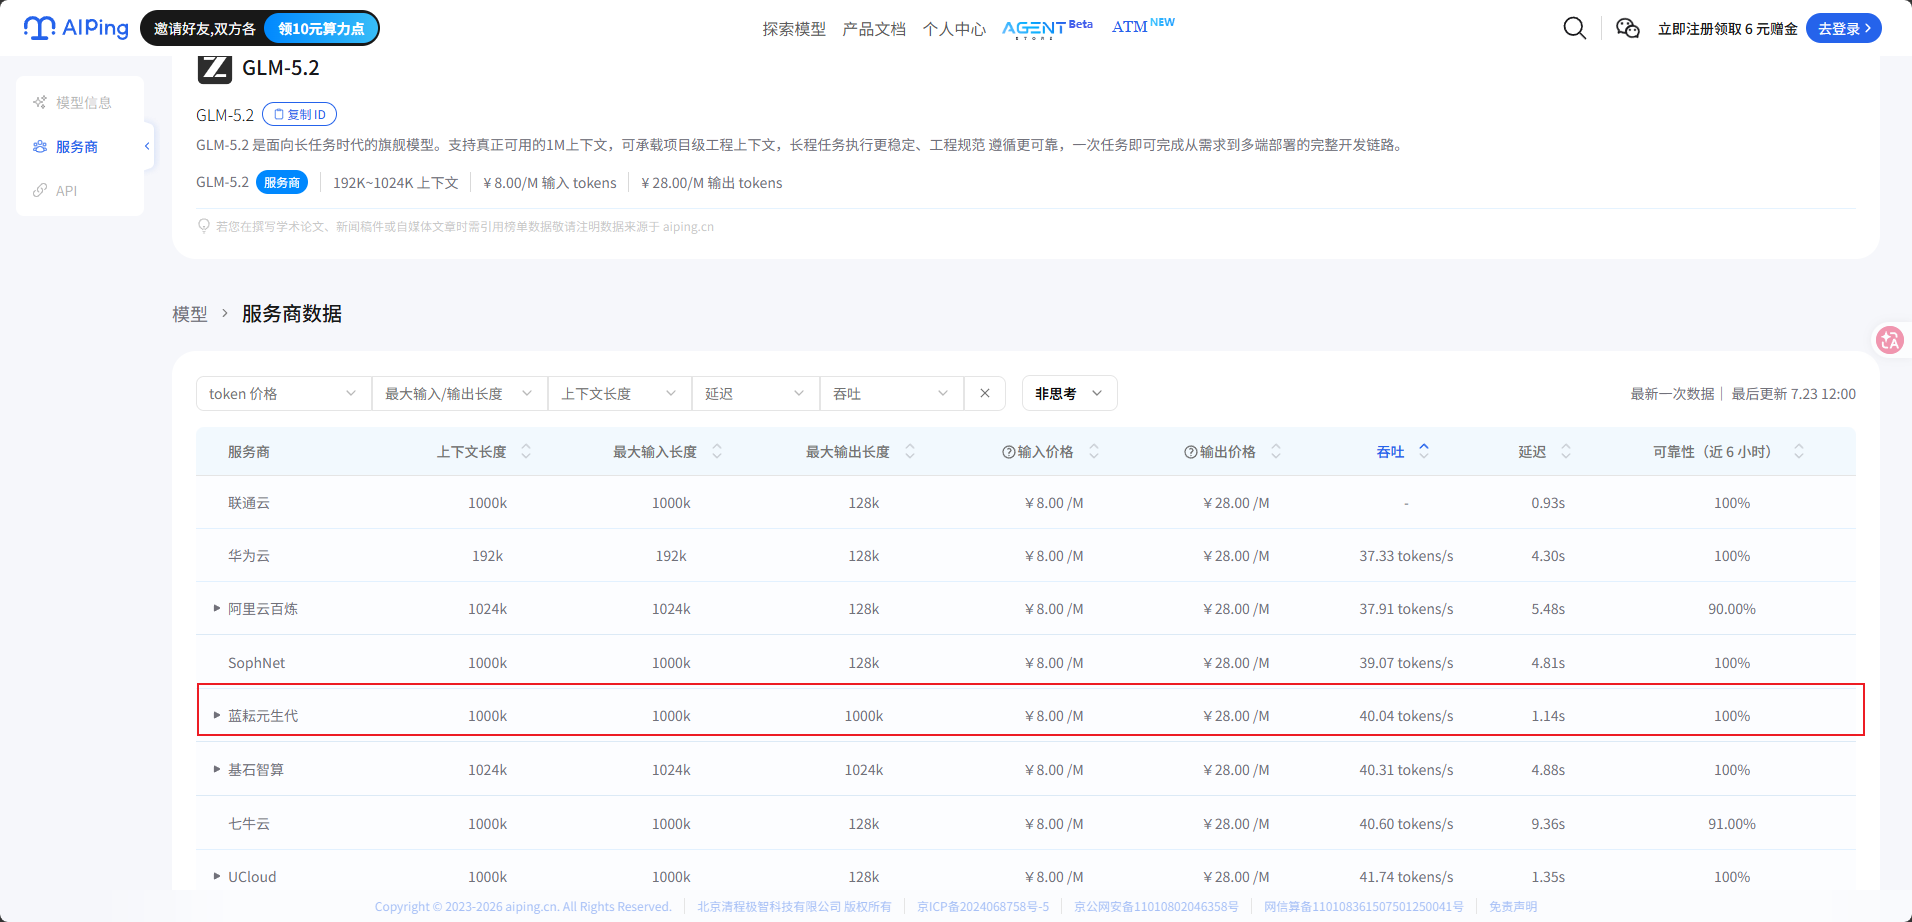
自测数一定要找独立信源对一遍。我在 AI Ping(aiping.cn)拉了几家模型的服务商数据,对比了一下,和我自测的情况相差不大。
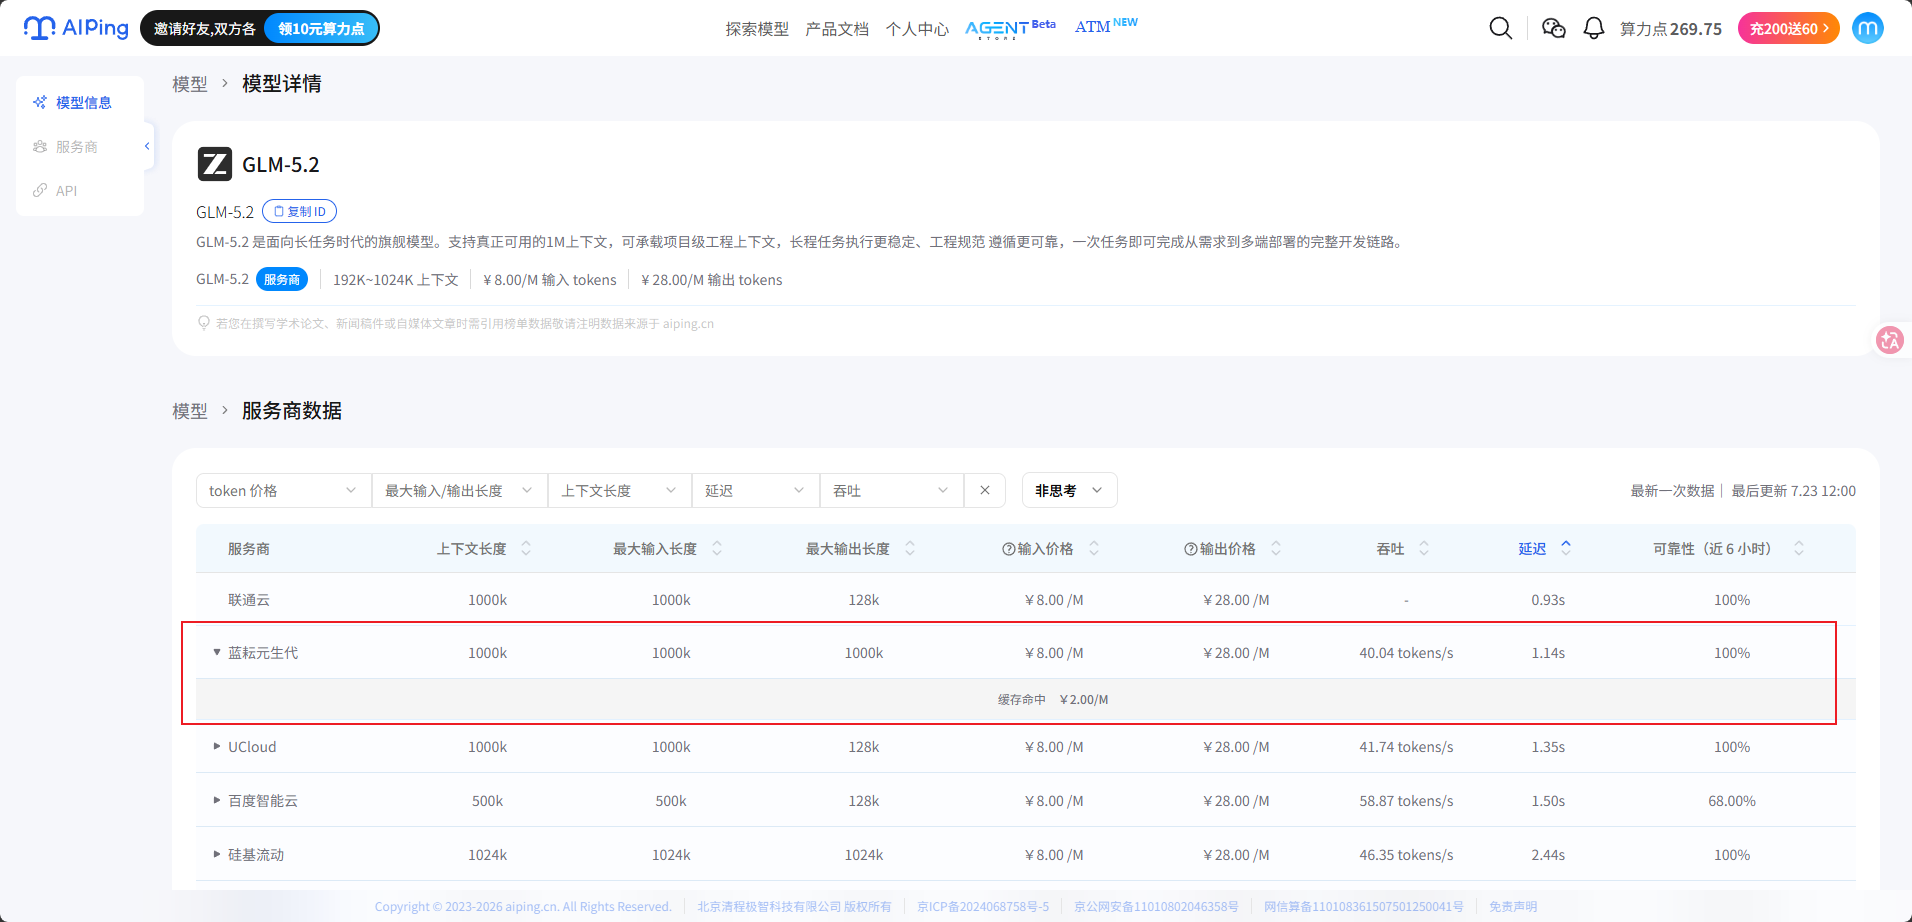
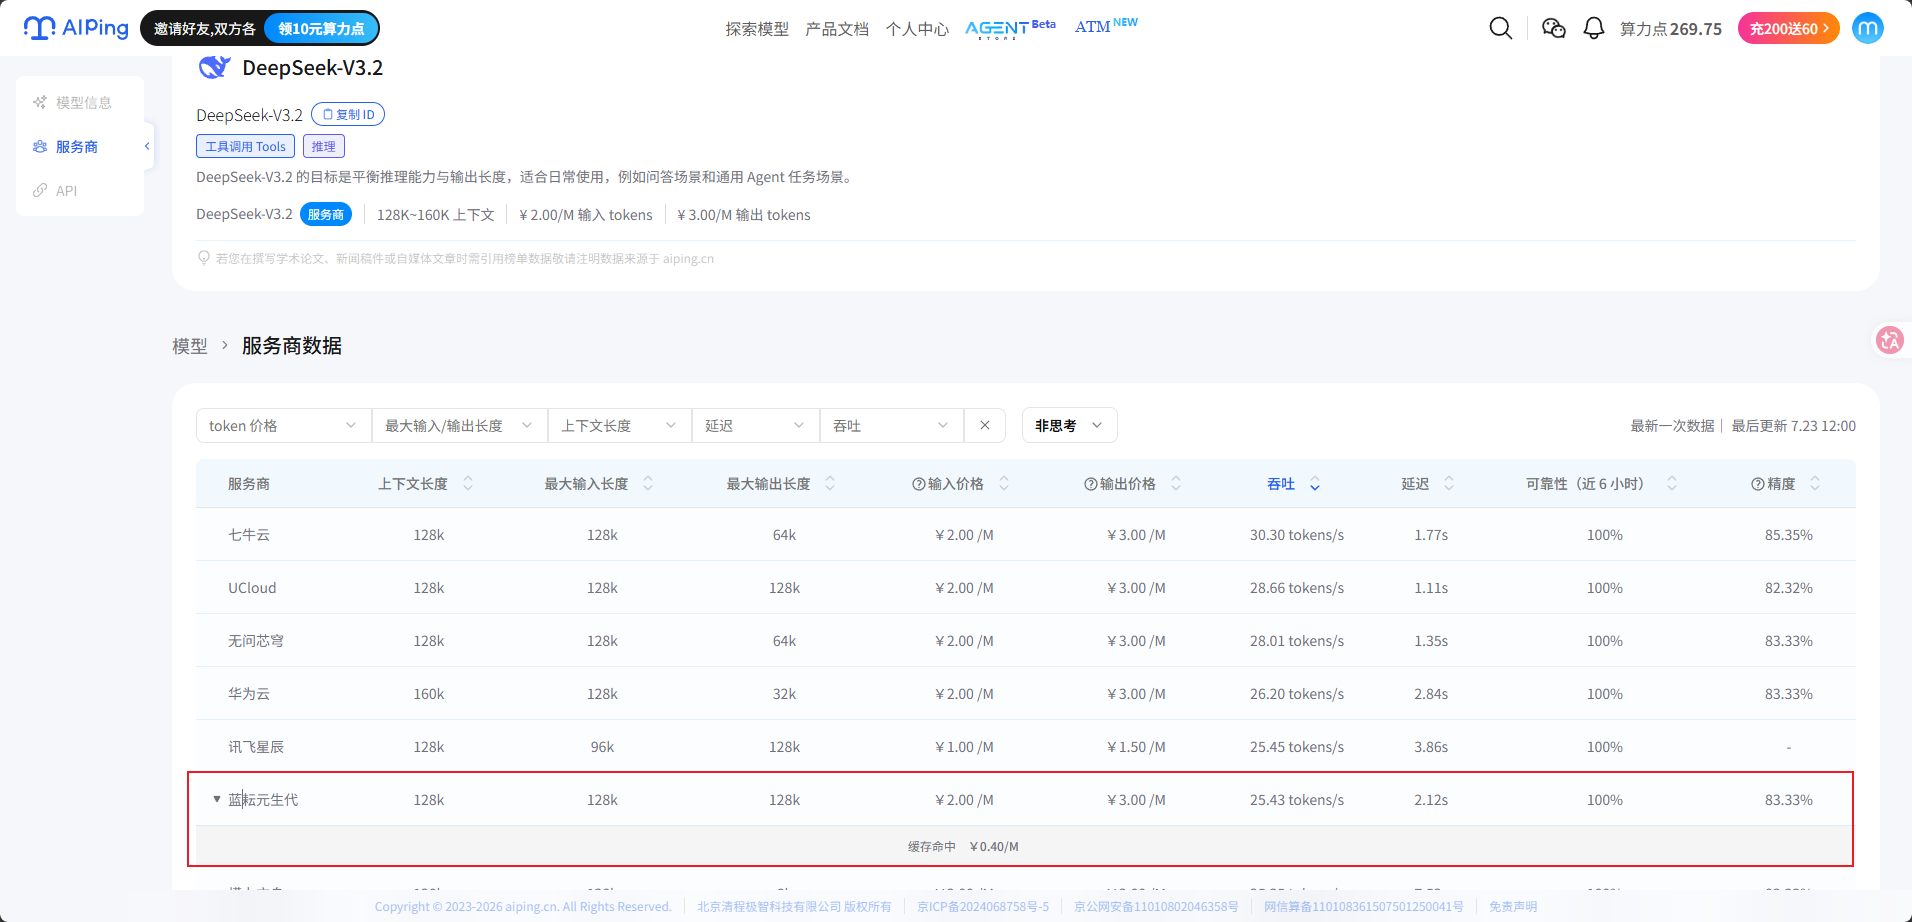
产生差异的原因可能是:
- prompt 长度与负载不同(自测轻负载、榜单标准化压测);
- 网络路径不同;
- 是否吃缓存不同。
九、选型清单:什么场景用哪个
| 你的场景 | 推荐模型 | 理由 |
|---|---|---|
| 跑量、成本敏感、任务不复杂 | DeepSeek-V3.2 | 单价最低,缓存后更省 |
| 大型项目级任务、长上下文、工程连贯 | GLM-5.2 | 1024k 上下文、Agentic 工程优化 |
| agentic coding 平衡型 | Qwen3.7-Plus | 主打代码智能体 |
| 想全都要、懒得选 | AutoModel(蓝耘智能路由) | 任务级自动调度最优模型 |
十、总结
回到开头的问题:国产大模型能不能平替驱动 Claude Code?能,而且配合蓝耘这个统一网关,体验不掉、成本还能再砍一截。
这次横评最大的收获,不是"哪款模型最强"这个结论,而是那三句话:
延迟看尾部,成本看缓存,Agent 看工具调用。
下次再有人问"Claude Code 接国产模型是不是填个 base_url 就行",我会把这篇甩给他。填 URL 谁都会,但选之前先把这几个数测一遍,省下的可能就是你下个月的账单。