一、官方demo跑通流程
参考文档
配置
源码 tag v1.6.0
Python 3.8
Conda 环境 rknndemo
Toolkit2 1.6.0
rknn_model_zoo v1.6.0
Runtime 1.6.0
rknn_api.h 1.6.0
GCC 7.5.0
Driver 0.8.2
Kernel 4.19.232
Board IDO-Purple Pi OH RK3566-V1
(1)准备开发环境
1.安装调试工具(主机端)
对于板端是Linux或Android使用 adb ,板端是 OpenHarmony 则使用 hdc
HDC(HarmonyOS Device Connector,鸿蒙设备连接器),是 OpenHarmony(开源鸿蒙)官方标准调试工具,相当于安卓的 ADB
bash
# 验证adb,打印设备编号
adb devices

# 检查板端系统
C:\Users\19412>adb shell getprop ro.build.version.release
/bin/bash: getprop: command not found

# 确认板端系统架构
C:\Users\19412>adb shell uname -a
Linux ido 4.19.232 #8 SMP Sat Jun 3 11:04:34 CST 2023 aarch64 aarch64 aarch64 GNU/Linux
2.下载 rknn model zoo(虚拟机端)
下载 zoo 后也要切换到与toolkit2仓库相同的版本
bash
git clone https://github.com/airockchip/rknn_model_zoo.git
cd rknn_model_zoo
git checkout v1.6.0
3.安装 rknn-toolkit2 (虚拟机端)
为了实现一次 clone 仓库多版本使用 rknn-toolkit2 通过切换不同tag的方式切换不同release版本,切换tag后再创建虚拟环境
clone rknn-toolkit2.git 仓库命令如下
bash
git clone https://github.com/rockchip-linux/rknn-toolkit2.git
cd rknn-toolkit2
查看仓库状态、当前所在分支以及版本支持情况如下
bash
# 查看仓库当前工作状态显示在master分支
git status
# 打印结果:
On branch master
Your branch is up to date with 'origin/master'.

Untracked files:
  (use "git add <file>..." to include in what will be committed)
        rknn-toolkit2/examples/pytorch/resnet18/check0_base_optimize.onnx
        rknn-toolkit2/examples/pytorch/resnet18/check2_correct_ops.onnx
        rknn-toolkit2/examples/pytorch/resnet18/check3_fuse_ops.onnx
        rknn-toolkit2/examples/pytorch/resnet18/pytorch_resnet18_0.npy
        rknn-toolkit2/examples/pytorch/resnet18/resnet18.pt
        rknn-toolkit2/examples/pytorch/resnet18/resnet_18.rknn

nothing added to commit but untracked files present (use "git add" to track)
# 列出仓库中所有版本标签(所有release版本)并只输出最后几行
git tag | tail
# 打印结果:
v1.4.0
v1.5.0
v1.5.2
v1.6.0
v2.0.0-beta0
v2.1.0
v2.2.0
v2.3.0
v2.3.2
# 打印当前所在分支

git branch --show-current
# 打印结果:
master

# 基于最近的 tag 来描述当前 commit ,打印表示v2.3.2是距离当前代码最近的 tag 版本,-1 表示在这个 tag 后又有一次 commint
git describe --tags --always
打印结果:
v2.3.2-1-g59a913d
在 rknn-toolkit2目录下执行 tag 切换如下
bash
git checkout v1.6.0
# 验证切换成功打印版本号
git describe --tags --always
4.安装python并创建虚拟环境(虚拟机端)
miniconad安装教程在官方文档中
切换到合适的rknn-toolkit2版本后创建虚拟环境如下
bash
conda create -n rknndemo python=3.8 -y
conda activate rknndemo
创建虚拟环境后安装依赖
检查python版本
bash
python --version输出为 Python 3.8.20
进入 rknn-toolkit2/rknn-toolkit2/packages/x86_64(当前是在这个 Docker/服务器环境里运行 RKNN-Toolkit2) 找到python3.8对应的依赖文件和whell
bash
pip install -r requirements_cp38-1.6.0.txt
pip install ./rknn_toolkit2-1.6.0+81f21f4d-cp38-cp38-linux_x86_64.whl
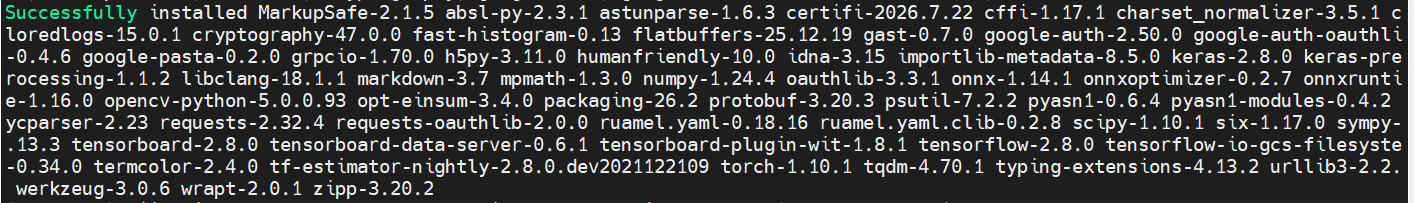
安装结果如下

5.安装cmake(虚拟机端)
bash
sudo apt update
sudo apt install cmake
6.安装gcc交叉编译器(虚拟机端)
bash
# 安装gcc交叉编译器
wget https://hf-mirror.com/csukuangfj/sherpa-ncnn-toolchains/resolve/main/gcc-linaro-7.5.0-2019.12-x86_64_aarch64-linux-gnu.tar.xz
# 解压
tar -Jxf gcc-linaro-7.5.0-2019.12-x86_64_aarch64-linux-gnu.tar.xz
# 验证
./gcc-linaro-7.5.0-2019.12-x86_64_aarch64-linux-gnu/bin/aarch64-linux-gnu-gcc --version
# 设置环境变量
export GCC_COMPILER=/home/ljiahui/toolchains/gcc-linaro-7.5.0-2019.12-x86_64_aarch64-linux-gnu/bin/aarch64-linux-gnu
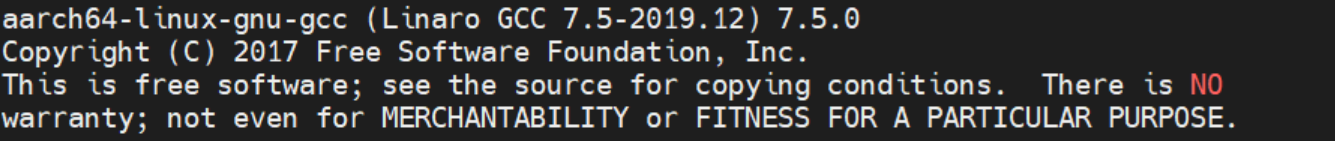
验证结果打印版本如下图
7.安装RKNPU2环境(板端)
板端执行下面命令查询RKNPU2驱动版本
bash
dmesg | grep -i rknpu如下图所示版本为 0.8.2
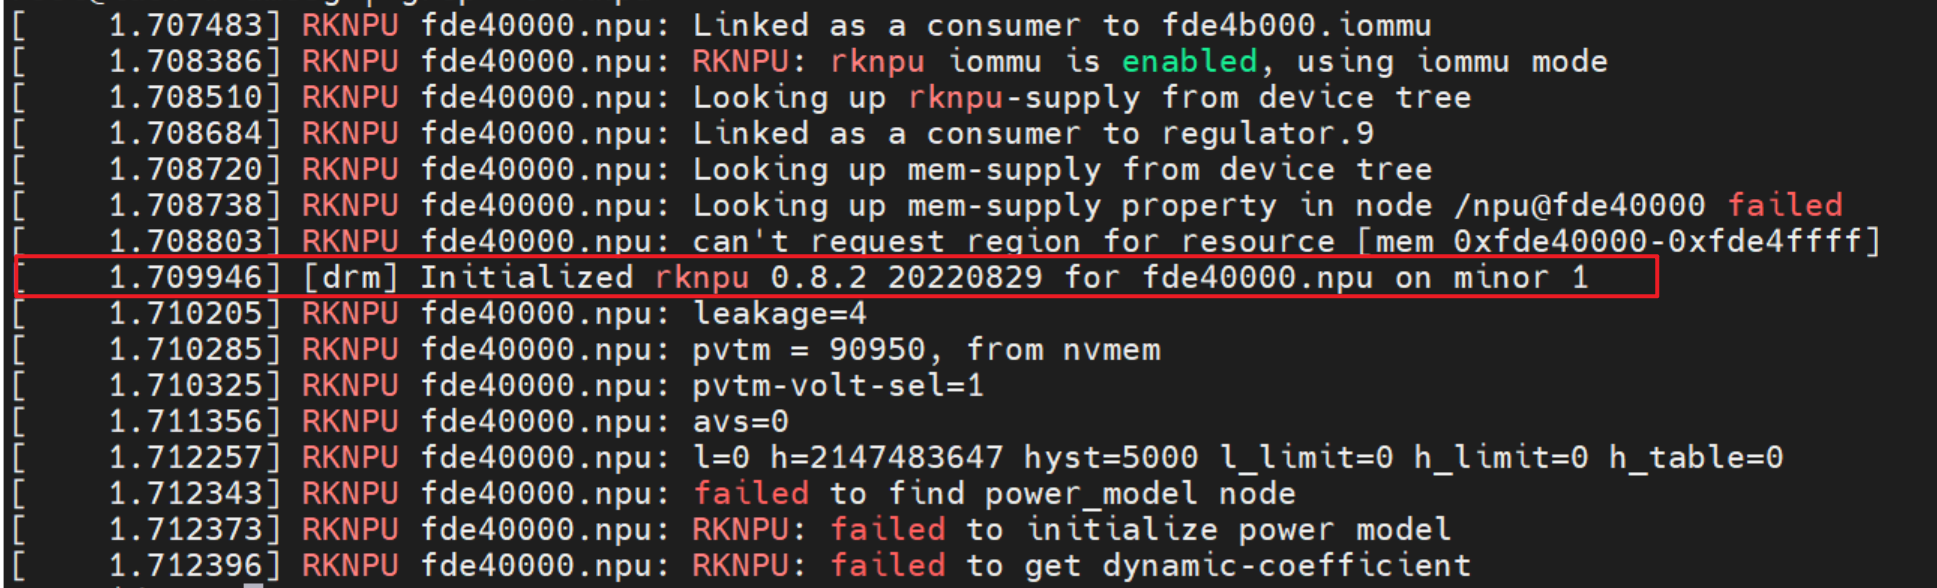
Rockchip 开发板的官方固件均自带 RKNPU2 驱动。若以上命令查询不到 NPU 驱动版本,则可能使用的是第三方固件,其中可能没有安装 NPU 驱动。如果有固件源码,可以在 kernel config 中将 CONFIG_ROCKCHIP_RKNPU 选项的值改成 y 以集成 NPU 驱动,然后重新编译内核驱动并烧录。建议 RKNPU2 驱动版本 >= 0.9.2
我是直接ssh登录服务器中的dockor,所以在传输文件时需要先将dockor中的文件传送到windows,再使用adb传送到板端。
在dockor中创建目录rknnout 用于存放要传输的文件,在windows使用scp远程下载
将所需传送到板端的文件cp到rknnout目录如下
bash
(rknndemo) ljiahui@546bbc4a33d9:~/rknn-toolkit2/rknpu2/runtime/Linux/librknn_api/aarch64$ cp librknnrt.so ~/rknnout
(rknndemo) ljiahui@546bbc4a33d9:~/rknn-toolkit2/rknpu2/runtime/Linux/rknn_server/aarch64/usr/bin$ cp ./* ~/rknnout
在Windows下使用scp下载文件如下
powershell
scp -P 9427 ljiahui@10.82.3.211:/home/ljiahui/rknnout/librknnrt.so D:\rknnout\在Windows使用adb传到板端如下
powershell
C:\Users\19412>adb push D:\rknnout\librknnrt.so \usr\lib
C:\Users\19412>adb push D:\rknnout\restart_rknn.sh \usr\bin
C:\Users\19412>adb push D:\rknnout\rknn_server \usr\bin
C:\Users\19412>adb push D:\rknnout\start_rknn.sh \usr\bin
(2)RKNN C Demo 使用流程
1.准备模型
download_model.sh 脚本会下载一个可用的yolov8 onnx模型到model目录下,脚本中老的下载链接失效了,从公开镜像下载模型
bash
# 给脚本添加可执行权限
(rknndemo) ljiahui@546bbc4a33d9:~/rknn_model_zoo/examples/yolov8/model$ chmod +x download_model.sh
# 执行脚本下载 .onnx
(rknndemo) ljiahui@546bbc4a33d9:~/rknn_model_zoo/examples/yolov8/model$ ./download_model.sh
# HF镜像地址
wget -O mobilenetv2-12.onnx https://hf-mirror.com/onnxmodelzoo/mobilenetv2-12/resolve/main/mobilenetv2-12.onnx
2.模型转换
在rknn_model_zoo/examples/mobilenet/python目录下执行转换脚本mobilenet.py,在rknn_model_zoo/examples/mobilenet/model目录生成对应的.mobilenet_v2.rknn
bash
python3 mobilenet.py --model ../model/mobilenetv2-12.onnx --target rk35663.编译
编译过程以及命令参数在rknn_model_zoo/examples/mobilenet/README中有详细说明
bash
cd ~/rknn_model_zoo
export GCC_COMPILER=/home/ljiahui/toolchains/gcc-linaro-7.5.0-2019.12-x86_64_aarch64-linux-gnu/bin/aarch64-linux-gnu
./build-linux.sh -t rk3566 -a aarch64 -d mobilenet
编译产物及位置如下图

将rknn_mobilenet_demo整个目录传到板端
4.运行demo
设置依赖库
bash
# 进入 mobilenet 目录
cd /tmp/rknn_mobilenet_demo
# 设置依赖库环境
export LD_LIBRARY_PATH=./lib
# 添加可执行权限
chmod +x rknn_mobilenet_demo
# 运行可执行文件
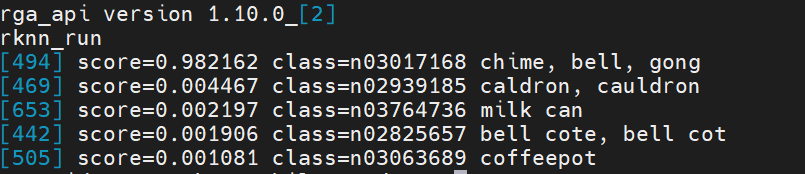
./rknn_mobilenet_demo model/mobilenet_v2.rknn model/bell.jpg
结果如下
(3)遇到的问题
rknpu2、rknn-toolkit2 仓库版本、板上 rknpu 驱动和 rknn_model_zoo 仓库版本需要匹配
(4)demo的工程构建流程
1.由.onnx转为.rknn
rknn_model_zoo/examples/mobilenet/python/mobilenet.py模型转换脚本
转换主线
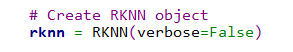
1.创建RKNN对象
2.rknn.config 配置模型参数
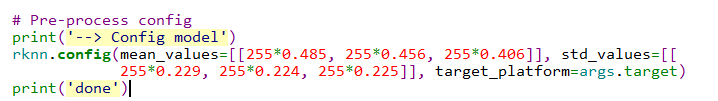
config的内容决定了这个 ONNX 模型之后要按什么输入规范、面向哪个 NPU 平台来转换,将这些内容告知 Toolkit2
3.rknn.load_onnx 把onnx模型导入toolkit2
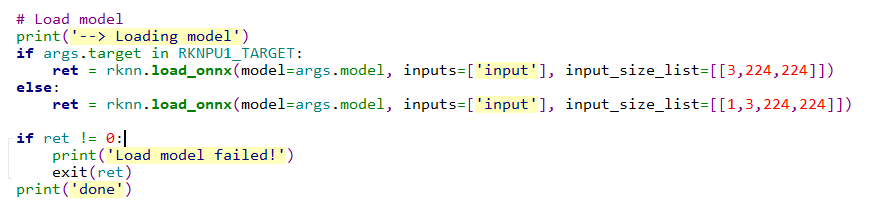
由上述代码可知对于rk3566N=1、C=3、H=224、W=224 ,这一步 Toolkit2 读取并解析 ONNX 模型形成 Toolkit2 内部计算图(需要用到哪些算子)
4.rknn.build() 才是真正的"模型构建"
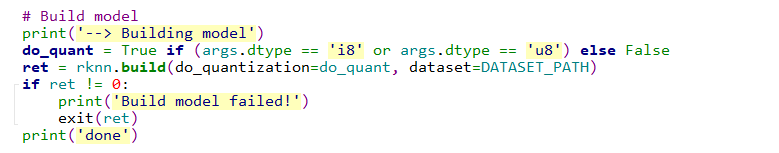
在这了会做 ONNX 计算图、图优化、算子融合、算子适配、量化校准最后生成针对 RK3566 NPU 的内部表示,dataset不是训练数据也不是推理结果,而是用于估计给层Tensor的数据分布从而确定scale和zero point这些量化参数
5.rknn.export_rknn():真正生成 .rknn
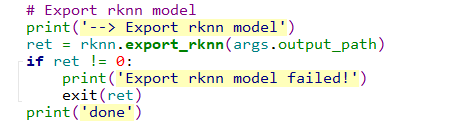
测试主线
5.rknn.init_runtime初始化推理环境
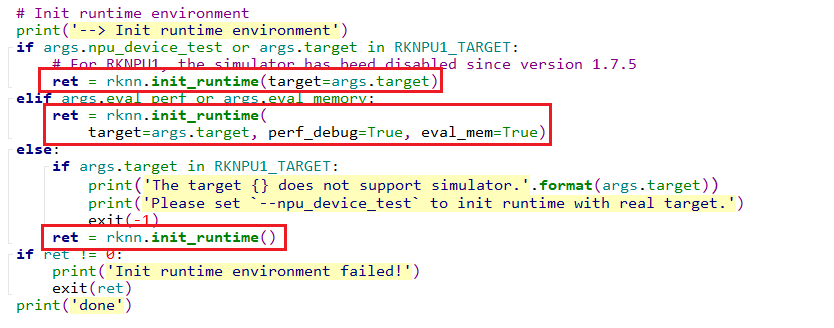
如果在执行脚本时添加参数--npu_device_test会尝试连接真实NPU设备否则是PC模拟推理如上图
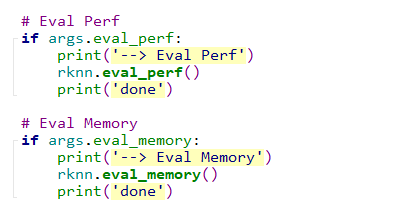
eval_perf() 用于模型推理性能评估,主要关注推理耗时;eval_memory() 用于模型运行内存评估。二者属于模型转换完成后的 Runtime 性能分析功能,不参与 ONNX→RKNN 模型转换,添加参数后使用
6.rknn.inference开始推理
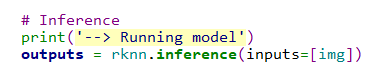
其实这个python接口中就是封装了C API中的 rknn_inputs_set()、rknn_run()、rknn_outputs_get()
7.后处理
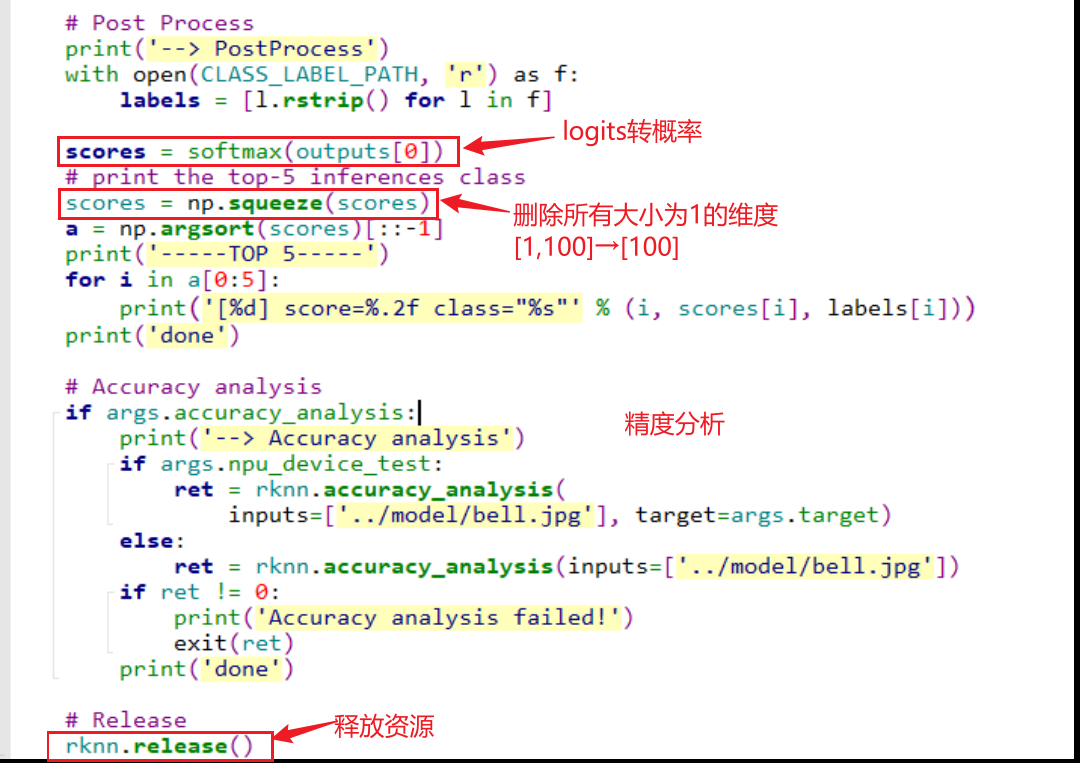
2.build_linux.sh
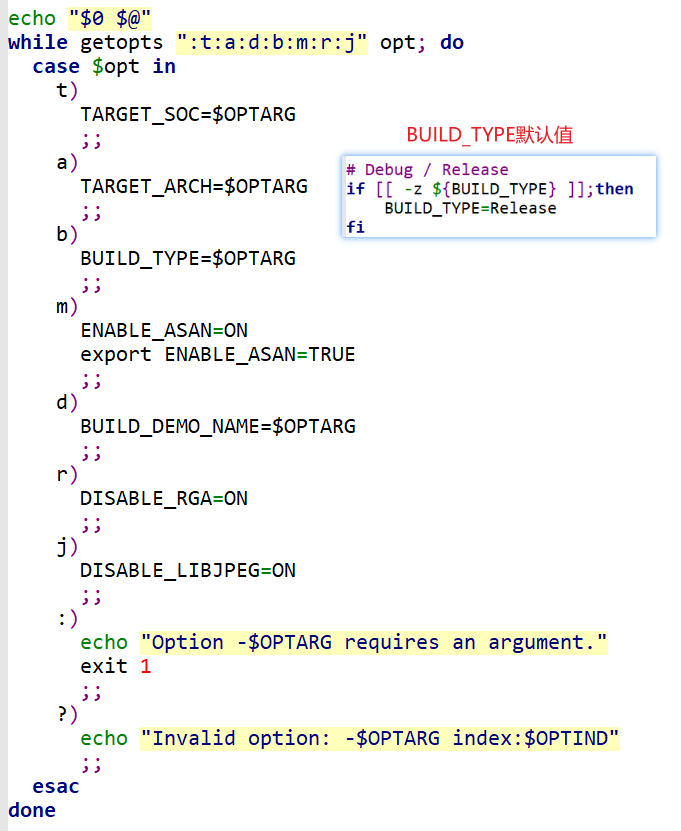
1.参数解析
执行./build-linux.sh -t rk3566 -a aarch64 -d mobilenet命令赋值变量TARGET_SOC=rk3566,TARGET_ARCH=aarch64,BUILD_DEMO_NAME=mobilenet,默认BUILD_TYPE=Release,相关脚本如下
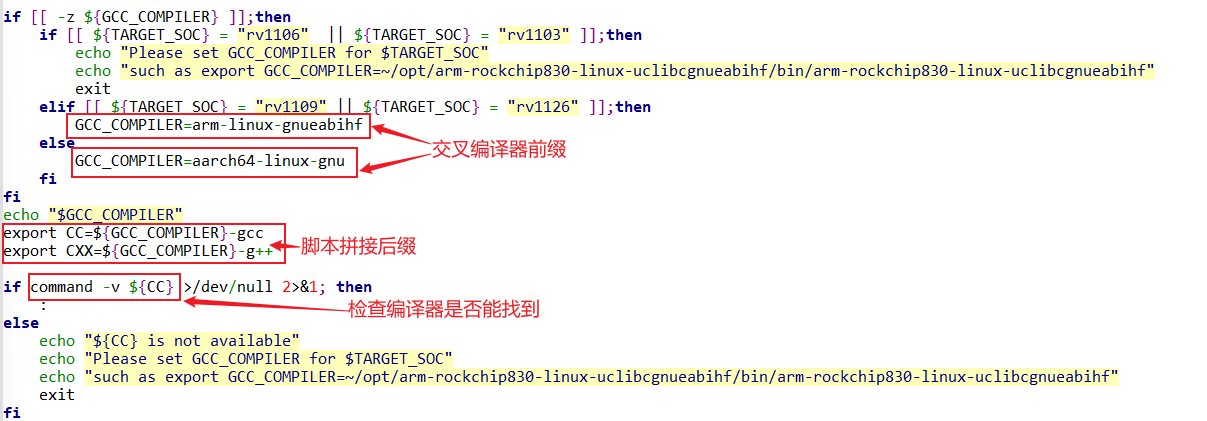
2.交叉编译器
提前指定了交叉编译器前缀export GCC_COMPILER=/home/ljiahui/toolchains/gcc-linaro-7.5.0-2019.12-x86_64_aarch64-linux-gnu/bin/aarch64-linux-gnu
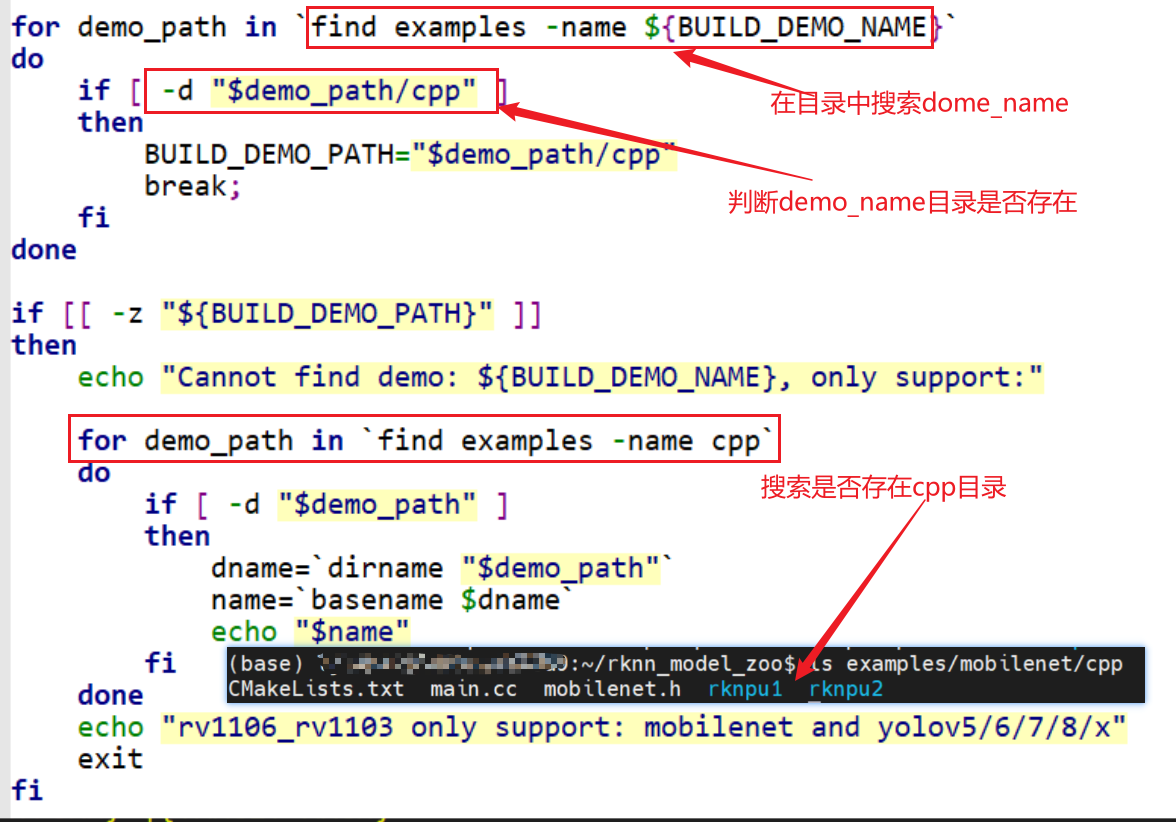
3.找到指定的demo源码
cpp目录中保存了源码
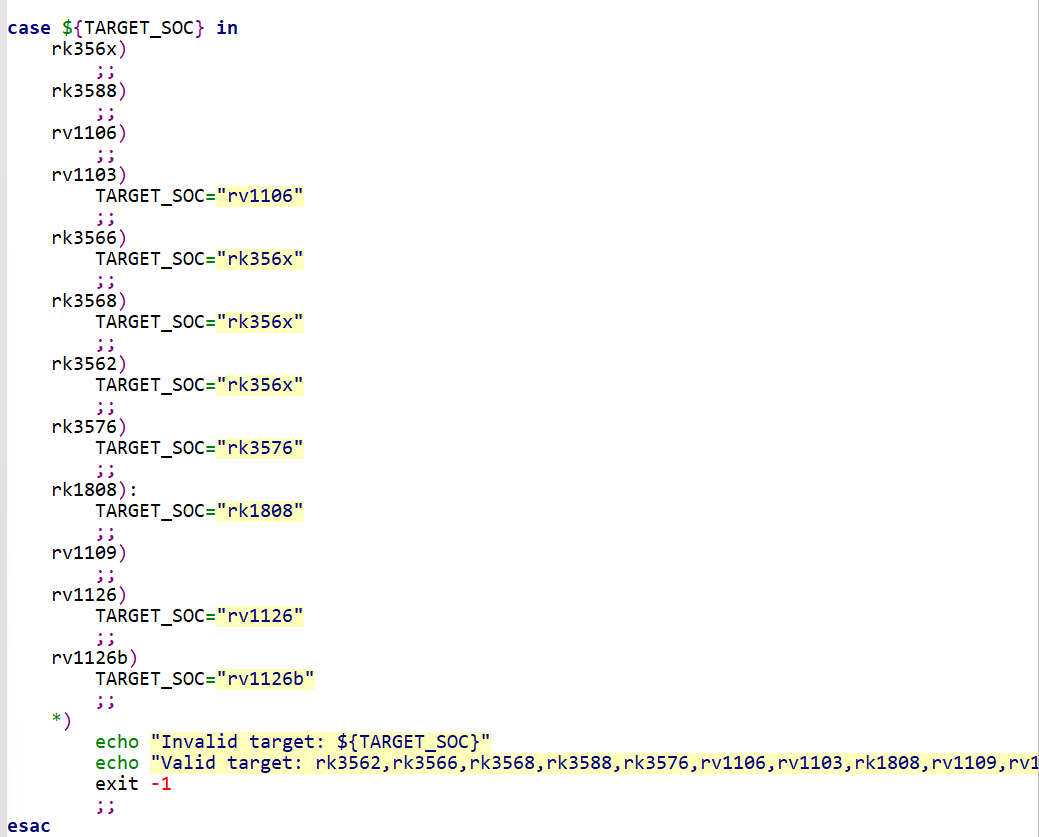
4.脚本归一化
RK3562 / RK3566 / RK3568 在这套 Demo 构建体系里共用一套 RKNPU2 平台资源,TARGET_SOC 统一为 rk356x
5.生成 build 目录和 install 目录

执行到此,BUILD_DIR= rknn_model_zoo/build/build_rknn_mobilenet_demo_rk356x_linux_aarch64_Release(编译过程中的临时/中间文件)、INSTALL_DIR= rknn_model_zoo/install/ rk356x_linux_aarch64/ rknn_mobilenet_demo (最终给板子部署的文件)
6.进入cmake构建与编译阶段
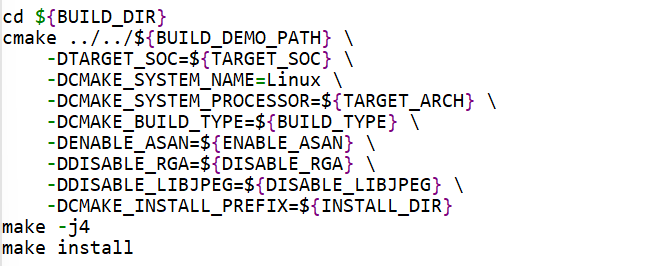
带入真实值如下,先进入${BUILD_DIR}是为了将cmake的编译产物存放在其中方便管理
cmake ../../examples/mobilenet/cpp \
    -DTARGET_SOC=rk356x \
    -DCMAKE_SYSTEM_NAME=Linux \
    -DCMAKE_SYSTEM_PROCESSOR=aarch64 \
    -DCMAKE_BUILD_TYPE=Release \
    -DENABLE_ASAN=OFF \
    -DDISABLE_RGA=OFF \
    -DDISABLE_LIBJPEG=OFF \
-DCMAKE_INSTALL_PREFIX=.../install/rk356x_linux_aarch64/rknn_mobilenet_demo传递这些参数给CMake,告诉 CMake:源码在 examples/mobilenet/cpp,我要为 Linux/aarch64/rk356x 生成一个 Release 构建系统,最终安装到指定目录
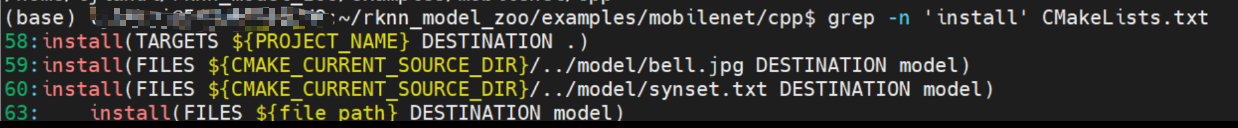
make是真正的编译命令,make install是按照规则将可执行程序、动态库、模型、图片、标签文件,规则如下
3.cmake构建
接下来研究 CMake 如何把源码、第三方库、RKNN Runtime 和资源文件组织成最终 demo
rknn_model_zoo/examples/mobilenet/cpp/CMakeLists.txt内容分析如下
1.根据SOC选择正确的mobilenet.cc
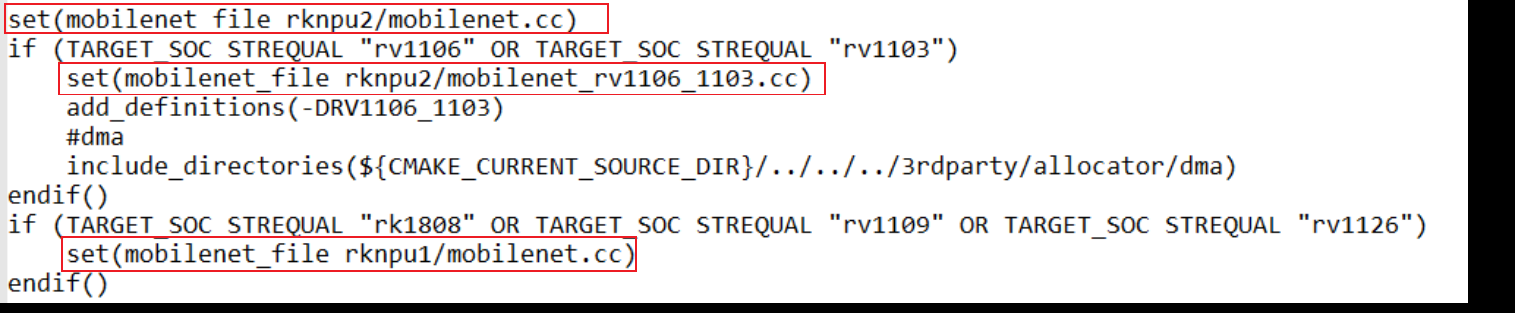
默认变量 mobilenet_file=rknpu2/mobilenet.cc使用RKNPU2平台如上图所示
2.引入公共依赖 3rdparty 和 utils

上图内容表示当前 MobileNet 工程自己不负责定义所有公共库,再去执行 3rdparty/CMakeLists.txt 和 utils/CMakeLists.txt ,目录位置如下

3.定义可执行文件由哪些源码组成
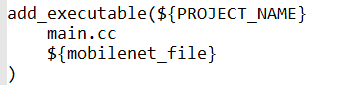
定义目标与依赖文件如上图
4.链接 fileutils / imageutils / librknnrt
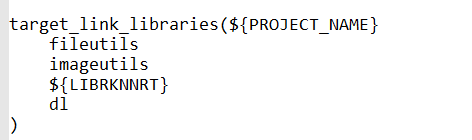
链接动态库如上图,最终rknn_mobilenet_demo要链接fileutils、imageutils、librknnrt、libdl这四个库,其中上面提到的核心API就是来自librknnrt.so
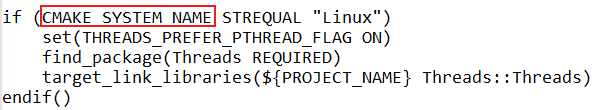
在build_linux.sh中传入了参数CMAKE_SYSTEM_NAME=Linux给cmake,所以还会链接线程库
5.指定头文件路径
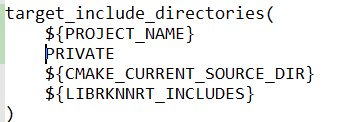
指定编译器应该到哪里找 .h ,编译阶段找的是 .h ,链接阶段找的是 .so库实现 ,这就是为什么头文件找到了链接还报 undefined reference 的原因
6.把可执行文件、模型和测试资源安装到部署目录
# 把 rknn_mobilenet_demo 可执行文件安装到根目录
install(TARGETS ${PROJECT_NAME}
        DESTINATION .)
# 安装测试图片
install(FILES ${CMAKE_CURRENT_SOURCE_DIR}/../model/bell.jpg
        DESTINATION model)
# 安装分类标签
install(FILES ${CMAKE_CURRENT_SOURCE_DIR}/../model/synset.txt
		DESTINATION model)
#
set(file_path ${CMAKE_CURRENT_SOURCE_DIR}/../model/mobilenet_v2.rknn)
# 检查 .rknn 文件是否存在再执行安装命令
if (EXISTS ${file_path})
	install(FILES ${file_path}
			DESTINATION model)
安装结果如下图


二、C API 调用链
(1)核心API
rknn_init
c++
int rknn_init(rknn_context* context, void* model, uint32_t size, uint32_t flag, rknn_init_extend* extend);rknn_init 初始化函数将创建 rknn_context 对象、加载 RKNN 模型以及根据 flag 和 rknn_init_extend 结构体执行特定的初始化行为,rknn_context是RKNN Runtime 模型实例句柄,后续用这个句柄继续操作
rknn_query
c++
int rknn_query(rknn_context context, rknn_query_cmd cmd, void* info, uint32_t size);rknn_query 函数能够查询获取到模型输入输出信息、逐层运行时间、模型推理的总时间、SDK 版本、内存占用信息、用户自定义字符串等信息。
rknn_inputs_set
c++
int rknn_inputs_set(rknn_context context, uint32_t n_inputs, rknn_input inputs[]);把应用层输入 Tensor 告诉 Runtime ,通过 rknn_inputs_set 函数可以设置模型的输入数据(Tensor) 。该函数能够支持多个输入,其中每个输入是 rknn_input 结构体对象,在传入之前用户需要设置该对象, inputs 数组的元素是 rknn_input 结构体对象
rknn_run()
c++
int rknn_run(rknn_context context, rknn_run_extend* extend);rknn_run 函数将执行一次模型推理,调用之前需要先通过 rknn_inputs_set 函数或者零拷贝的接口设置输入数据
rknn_outputs_get()
c++
int rknn_outputs_get(rknn_context context, uint32_t n_outputs, rknn_output outputs[], rknn_output_extend* extend);rknn_outputs_get 函数可以获取模型推理的输出数据。该函数能够一次获取多个输出数据。其中每个输出是 rknn_output 结构体对象,在函数调用之前需要依次创建并设置每个rknn_output 对象。
对于输出数据的 buffer 存放可以采用两种方式:一种是用户自行申请和释放,此时结构体 rknn_output 对象的 is_prealloc 需要设置为 1,并且将 buf 指针指向用户申请的 buffer;另一种是由 rknn 来进行分配,此时 rknn_output 对象的 is_prealloc 设置为 0 即可,函数执行之后 buf将指向输出数据。(注:RV1106/RV1103 不支持该接口)
rknn_outputs_release()
c++
int rknn_outputs_release(rknn_context context, uint32_t n_ouputs, rknn_output outputs[]);rknn_outputs_release 函数将释放 rknn_outputs_get 函数得到的输出的相关资源, outputs 为要销毁的 rknn_output 数组
rknn_destroy()
c++
int rknn_destroy(rknn_context context);rknn_destroy 函数将释放传入的 rknn_context 及其相关资源
(2)数据结构
rknn_init_extend
c++
typedef struct _rknn_init_extend {
    rknn_context ctx;                                    /* 已初始化的 rknn_context 对象 */
    int32_t      real_model_offset;                      /* 真正的 RKNN 模型数据,在整个 .rknn 文件里的起始偏移量 */
    uint32_t     real_model_size;                        /* 真正的 RKNN 模型数据,在整个 .rknn 文件里所占的大小 */
    uint8_t      reserved[120];                          /* 预留的空间 */
} rknn_init_extend;
该结构体是一个已加载的 RKNN 模型实例描述信息
rknn_input
c++
typedef struct _rknn_input {
    uint32_t index;                                     /* 这个 rknn_input 对应模型的第几个输入节点,对应rknn_inputs_set()的可多输入特性 */
    void* buf;                                          /* 输入数据的指针 */
    uint32_t size;                                      /* 输入数据所占内存大小 */
    uint8_t pass_through;                               /* t 设置为 1 时会将 buf 存放的输入数据直接设置给
模型的输入节点,不做任何预处理。 */
    rknn_tensor_type type;                              /* 输入数据的类型(数据精度) */
    rknn_tensor_format fmt;                             /* 输入数据的格式(多维 Tensor 在内存里按照什么维度顺序排列,Tensor布局) */
} rknn_input;
结构体rknn_input表示模型的一个数据输入,用来作为参数传入给rknn_inputs_set函数
rknn_output
c++
typedef struct _rknn_output {
    uint8_t want_float;                                 /* 标识是否需要将输出数据转为 float 类型输出,runtime会将输出转换为float方便后续处理 */
    uint8_t is_prealloc;                                /* 输出数据的存放方式,设置为1则由用户自主申请和释放buffer;设置为0则下面的*buf指向输出数据 */
    uint32_t index;                                     /* 这个 rknn_output 对应模型的第几个输出节点,对应rknn_outputs_get()的可多输出特性 */
    void* buf;                                          /* 输出数据的指针 */
    uint32_t size;                                      /* 输出数据所占内存大小 */
} rknn_output;
结构体rknn_output表示模型的一个数据输入,用来作为参数传入给rknn_outputs_get函数
rknn_tensor_attr
cpp
typedef struct _rknn_tensor_attr {
    uint32_t index;                                     /* 表示这是第几个输入\输出 Tensor */

    uint32_t n_dims;                                    /* 表示 Tensor 有几维 */
    uint32_t dims[RKNN_MAX_DIMS];                       /* Tensor 各维度值 */
    char name[RKNN_MAX_NAME_LEN];                       /* Tensor 名称 */

    uint32_t n_elems;                                   /* 表示 Tensor 一共有多少个元素(每一维数字相乘) */
    uint32_t size;                                      /* 表示这个 Tensor 占多少字节(结合type计算) */

    rknn_tensor_format fmt;                             /* 每个Tensor的布局 */
    rknn_tensor_type type;                              /* 每个Tensor的类型 */
    rknn_tensor_qnt_type qnt_type;                      /* 量化方式(涉及 zero point \ scale 缩放比例) */
    int8_t fl;                                          /* fractional length for RKNN_TENSOR_QNT_DFP. */
    int32_t zp;                                         /* zero point for RKNN_TENSOR_QNT_AFFINE_ASYMMETRIC. */
    float scale;                                        /* scale for RKNN_TENSOR_QNT_AFFINE_ASYMMETRIC. */

    uint32_t w_stride;                                  /* 宽方向实际步长,由于NPU/内存对齐可能需要补齐(padding),出现与Tensor的逻辑尺寸不一致,若 w_stride = 0 则表示不需要额外padding */
    uint32_t size_with_stride;                          /* 表示考虑 stride 后 Tensor 真正需要的内存大小(size_with_stride > size) ,这在零拷贝、rknn_set_io_mem() 时尤其重要 */

    uint8_t pass_through;                               /* 若为 TRUE 则表示你提供的 buffer 已经完全符合模型输入节点需要的格式,Runtime 不再帮你转换 */
    uint32_t h_stride;                                  /* 表示高度方向的步长和 w_stride 同理 */
} rknn_tensor_attr;
struct rknn_tensor_attr 是 Tensor 的属性说明,不是 Tensor 本身
(3)main API 调用链路
rknn_model_zoo\examples\mobilenet\cpp\rknpu2\mobilenet.cc
rknn_model_zoo\examples\mobilenet\cpp\main.cc
main函数的接口调用
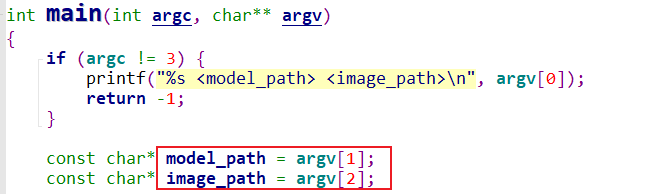
#define IMAGENET_CLASSES_FILE "./model/synset.txt"
read_lines_from_file(IMAGENET_CLASSES_FILE, &line_count);// 读取分类标签文件,将每一行标签字符串保存到字符串指针数组 lines 中,并通过索引实现模型类别 ID 到类别名称的映射

init_mobilenet_model(read_data_from_file)
	→read_data_from_file(model_path, &model);	// 加载 .rknn
	→rknn_init(&ctx, model, model_len, 0, NULL);	// 创建context对象
	→rknn_query(ctx, RKNN_QUERY_IN_OUT_NUM, &io_num, sizeof(io_num));	// 获取输入输出数量信息
	→rknn_query(ctx, RKNN_QUERY_INPUT_ATTR, &(input_attrs[i]), sizeof(rknn_tensor_attr));	// 获取模型输入 Tensor 属性		→rknn_query(ctx, RKNN_QUERY_OUTPUT_ATTR, &(output_attrs[i]), sizeof(rknn_tensor_attr));	// 获取模型输出 Tensor 属性
在 init_mobilenet_model()的最后如下图
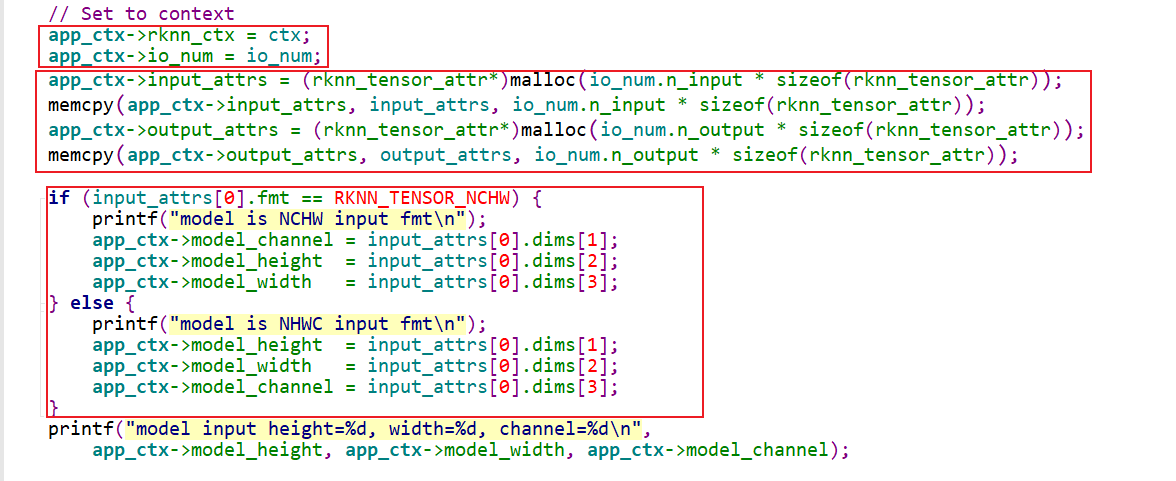
把 RKNN 模型句柄、输入输出属性等信息保存到 app_ctx,并根据输入 Tensor 的 NCHW/NHWC 格式解析出模型输入尺寸,供后续预处理和推理使用
malloc + memcpy:原来的input_attrs / output_attrs 是局部变量,必须复制到堆上才能在 init_mobilenet_model() 返回之后继续使用
接着分析main.cc如下
read_image(image_path, &src_image);	// 读入图片
inference_mobilenet_model(&rknn_app_ctx, &src_image, result, topk);	//完整的板端推理流程
	→ convert_image(src_img, &img, NULL, NULL, 0);	//预处理:先创建一张"符合模型输入要求"的目标图片,再用这个函数将原图转换成模型要求的尺寸和格式,**这一步主要是为了满足模型对输入数据的要求**
	→rknn_inputs_set(app_ctx->rknn_ctx, 1, inputs);	// 设置输入:先构造 struct rknn_input ,然后把这份输入交给 RKNN Runtime
	→rknn_run(app_ctx->rknn_ctx, nullptr);	// 执行推理:让NPU执行一次前向计算,执行后模型输出已经产生,但应用程序还没把结果取回来
	→rknn_outputs_get(app_ctx->rknn_ctx, 1, outputs, NULL);	 // 获取输出:把模型第 0 个输出取出来,outputs[0]是该类别的得分,outputs[0].buf 中就是模型正真的输出
	→softmax((float*)outputs[0].buf, app_ctx->output_attrs[0].n_elems); // 后处理:先把模型输出 logits 转成概率
	→get_topk_with_indices((float*)outputs[0].buf, app_ctx->output_attrs[0].n_elems, topk, out_result);	// 后处理:选出概率最大的前 topk 个类别
	→rknn_outputs_release(app_ctx->rknn_ctx, 1, outputs);// 释放 Runtime 分配的输出 buffer,
	→最后还要释放预处理图片的内存 free

release_mobilenet_model(&rknn_app_ctx);
	→释放(free)应用自己 malloc 的输入/输出属性数组(rknn_tensor_attr)
	→rknn_destroy(app_ctx->rknn_ctx);	// 释放传入的 rknn_context 及其相关 Runtime/NPU 资源
(4)Tensor流向
struct rknn_tensor_attr 是 Tensor 的属性说明,不是 Tensor 本身
磁盘上的 bell.jpg
        ↓
read_image()
        ↓
src_image.virt_addr
        ↓
convert_image()
        ↓
img.virt_addr
        │
        │  此时数据已经变成模型需要的
        │  width × height × channel
        │  UINT8 + NHWC
        ↓
rknn_input.buf = img.virt_addr
        ↓
rknn_inputs_set()
        ↓
RKNN Runtime 接收输入 Tensor
        ↓
Runtime 根据 type / fmt 做必要转换
        ↓
送入模型输入节点
        ↓
rknn_run()
        ↓
NPU 执行整张计算图
        ↓
模型输出 Tensor
        ↓
rknn_outputs_get()
        ↓
outputs[0].buf
        ↓
softmax()
        ↓
概率数组
        ↓
get_topk_with_indices()
        ↓
class index + score
        ↓
lines[class index]
        ↓
最终分类名称
关键区分三个buffer
第一块是:
cpp
src_image.virt_addr这是原始图片数据。
第二块是:
cpp
img.virt_addr这是预处理完成、真正准备喂给模型的数据。
第三块是:
cpp
outputs[0].buf这是模型推理完成后返回的输出 Tensor 数据。