一、为什么需要 Triton
一个典型的算法团队,线上跑的模型往往不止一个:CV 类、NLP 类、推荐类、自研 PyTorch 模型。最常见的"朴素部署"是:
模型A → Flask 进程1 (GPU 0)
模型B → Flask 进程2 (GPU 0)   # 抢同一张卡
模型C → Flask 进程3 (GPU 1)
问题立刻来了:
-
GPU 利用率低:每个进程各自占显存,小模型空闲时整张卡被占着
-
没有动态批处理:客户端单次请求,GPU 算力被浪费
-
并发调度混乱:多个进程抢卡,互相拖累
-
运维成本高:N 个模型 N 套部署代码、N 个健康检查
Triton 的定位就是:一个服务进程,统一托管所有模型,把 GPU 利用率、批处理、并发调度全部做对 。它不是某个模型的专属加速(那是 vLLM/TensorRT-LLM 的活),而是模型服务的"操作系统"。
二、整体架构
Triton 的核心是一个 C++ 主进程,内部按职责分三层:
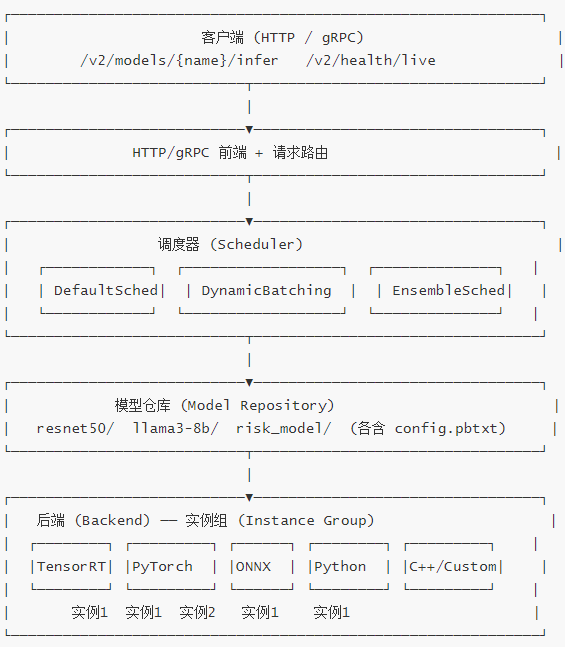
四个关键点:
-
模型仓库 :每个模型一个目录,含
config.pbtxt描述输入输出、后端类型、实例数 -
调度器:决定请求怎么聚合成 batch、哪个实例处理
-
后端(Backend):真正执行推理的引擎,支持 TensorRT / PyTorch / ONNX / Python / 自定义 C++
-
实例组(Instance Group):一个模型可以起多个副本(甚至跨多卡),Triton 自动负载均衡
三、核心机制:Dynamic Batching 源码走读
这是 Triton 吞吐高的根本原因。
3.1 原理
动态批处理不要求客户端主动组 batch。客户端照常发单条请求,Triton 在服务端把时间窗口内到达的多个请求自动拼成 batch:
时刻 t:   req1(bs=1)  req2(bs=1)  req3(bs=1)  req4(bs=1)
                    │
                    ▼  Dynamic Batcher 聚合成
            batched_infer(bs=4)  ──▶ GPU 一次算完 ──▶ 拆回 4 个结果
GPU 最怕 bs=1 的小请求------算力利用率可能不到 10%。拼成 bs=32 一次算,利用率直接拉满。
3.2 源码位置与逻辑
核心在 src/core/scheduler.cc 的 DynamicBatchScheduler:
objectivec
// 伪代码:动态批处理调度核心循环
void DynamicBatchScheduler::SchedulerThread() {
while (!stop_) {
std::vector<InferenceRequest*> requests;
// 1. 从队列取请求,直到达到 max_batch_size 或 queue_delay 超时
GetRequestsUntilTimeout(
&requests,
config_.max_batch_size(), // config 里配置的批上限
dynamic_batching_.max_queue_delay_microseconds());
if (requests.empty()) continue;
// 2. 把多个请求拼成 batch,复用同一块输入 tensor
auto batched = ComposeBatch(requests);
// 3. 交给某个空闲的模型实例执行
std::shared_ptr<ModelInstance> inst =
GetIdleInstance();
inst->Execute(batched, [requests](Status s, Response resp) {
// 4. 执行完把 batch 结果拆回给各个原始请求
ScatterResponse(resp, requests);
});
}
}两个关键参数(都在 config.pbtxt 里):
-
max_batch_size:一个 batch 最多塞多少请求 -
max_queue_delay_microseconds:最多等多久凑 batch(延迟 vs 吞吐的旋钮)
四、实战:双模型部署
假设我们要同时托管 ResNet50(图像)和 Llama-3-8B(文本)。
4.1 模型仓库结构
objectivec
model_repo/
├── resnet50/
│   ├── config.pbtxt
│   └── 1/
│       └── model.onnx
└── llama3-8b/
    ├── config.pbtxt
    └── 1/
        └── model.onnx   # 或用 tensorrtllm 后端
4.2 ResNet50 的 config.pbtxt
Puppet
name: "resnet50"
platform: "onnxruntime_onnx" # 用 ONNX Runtime 后端
max_batch_size: 32 # 动态批处理上限
input [
{
name: "input"
data_type: TYPE_FP32
dims: [ 3, 224, 224 ]
}
]
output [
{
name: "output"
data_type: TYPE_FP32
dims: [ 1000 ]
}
]
# 动态批处理:最多等 100us 凑批
dynamic_batching {
max_queue_delay_microseconds: 100
}
# 起 2 个实例,跨 GPU 0/1 提升并发
instance_group [
{
count: 2
kind: KIND_GPU
gpus: [ 0, 1 ]
}
]4.3 Llama-3 的 config.pbtxt(关键片段)
Puppet
name: "llama3-8b"
platform: "tensorrtllm" # 用 TensorRT-LLM 后端,复用前面文章优化
max_batch_size: 8
input [ { name: "prompt" , data_type: TYPE_STRING, dims: [ 1 ] } ]
output [ { name: "completion", data_type: TYPE_STRING, dims: [ 1 ] } ]
dynamic_batching { max_queue_delay_microseconds: 200 }
instance_group [ { count: 1, kind: KIND_GPU, gpus: [ 0 ] } ]4.4 启动服务
bash
docker run --gpus all -p 8000:8000 -p 8001:8001 -p 8002:8002 \
  -v $(pwd)/model_repo:/models \
  nvcr.io/nvidia/tritonserver:24.08-py3 \
  tritonserver --model-repository=/models
健康检查:
bash
curl http://localhost:8000/v2/health/live   # 返回 200 即存活
curl http://localhost:8000/v2/models         # 列出已加载模型
4.5 Python 客户端
python
import tritonclient.http as httpclient
import numpy as np
client = httpclient.InferenceServerClient("localhost:8000")
inputs = [httpclient.InferInput("input", [1, 3, 224, 224], "FP32")]
outputs = [httpclient.InferRequestedOutput("output")]
img = preprocess("cat.jpg").astype(np.float32)
inputs[0].set_data_from_numpy(img)
# 客户端始终发单条请求,Triton 后端自动凑批
result = client.infer("resnet50", inputs, outputs=outputs)
print(result.as_numpy("output").argmax())五、性能实测
环境:1×A100 80G,Triton 24.08,对比"裸 PyTorch + Flask 单请求服务"。
测试方式 :用 perf_client(Triton 自带压测工具)发 100 并发、持续 60 秒。
| 指标 | 裸 Flask 服务 | Triton (动态批处理) | 提升 |
|---|---|---|---|
| ResNet50 吞吐 (img/s) | 410 | 2580 | 6.3× |
| P50 延迟 | 24 ms | 9 ms | --- |
| P99 延迟 | 180 ms | 45 ms | --- |
| GPU 利用率(平均) | 18% | 87% | --- |
| 同时托管 2 模型 | 需 2 进程 | 1 进程 | 运维↓ |
动态批处理把 GPU 利用率从 18% 拉到 87%,这就是吞吐差 6 倍的本质原因。
六、Triton vs vLLM vs TorchServe
容易混淆,一次讲清边界:
| 维度 | Triton | vLLM | TorchServe |
|---|---|---|---|
| 定位 | 多模型服务"操作系统" | LLM 专属推理引擎 | PyTorch 模型服务 |
| 批处理 | 通用动态批处理 | Continuous Batching | 简单动态批 |
| 多后端 | ✅ TRT/PyTorch/ONNX/Python | ❌ 仅 LLM | ✅ 但弱 |
| LLM 优化 | 靠 tensorrtllm 后端 | 原生 PagedAttention | ❌ |
| 适用 | 多模型混合生产 | 大模型高并发 | 快速起 PyTorch 服务 |
结论:大模型高并发用 vLLM;多个异构模型统一托管用 Triton;Triton 里跑 LLM 建议走 tensorrtllm 后端,性能和 vLLM 接近。
七、踩坑记录
| 问题 | 现象 | 解决 |
|---|---|---|
| max_batch_size=0 却开动态批 | 启动报错 | 动态批要求 max_batch_size>0 |
| 多实例抢同一张卡 OOM | 加载失败 | instance_group 的 gpus 分散到不同卡 |
| Python 后端冷启动慢 | 首个请求 3s+ | 在模型 __init__ 里预热 |
| 客户端 batch 维度错 | 推理报错 | 输入 dims 不含 batch 维,由 Triton 拼 |
| GPU 利用率仍低 | 请求太稀疏 | 调大 max_queue_delay 凑更多批 |
| 模型更新不生效 | 旧版本在跑 | 用 model_control 显式 unload/load |
八、总结
-
Triton 把"多模型统一服务化"的工程难题一次性解决:模型仓库 + 调度器 + 多后端
-
动态批处理是吞吐核心,源码上就是"凑批 → 复用 tensor → 拆结果"三步
-
config.pbtxt 一个文件搞定输入输出、批处理、实例数、跨卡
-
和 vLLM 不冲突:大模型走 vLLM,异构模型混部走 Triton(LLM 用 tensorrtllm 后端)
下一篇:我们已经有了高并发推理服务(vLLM / Triton),但 AI Agent 怎么编排多个模型协作?周三的文章我们用 LangGraph vs AutoGen 把多 Agent 框架彻底讲透。
往期回顾: