✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
本系统名为《基于大数据的信用等级数据分析与可视化》,面向信用场景下的多维度数据展开分析与展示。系统整体采用 Hadoop 与 Spark 作为大数据处理核心,借助 HDFS 完成原始信用数据的存储,通过 Spark SQL 与 Spark 计算引擎对信用等级信息、违约概况、年龄结构、收入负债、逾期行为、信贷结构、家庭负担以及风险洞察等维度进行清洗、聚合与统计,并将处理结果落库至 MySQL 供后端调用。开发语言支持 Python 与 Java 两个版本,Python 版本采用 Django 作为后端框架,Java 版本采用 Spring Boot 框架,前端使用 Vue 配合 ElementUI、ECharts 以及 HTML、CSS、JavaScript、jQuery 完成页面渲染与图表展示。系统共包含系统首页、信用等级信息、违约概况分析、年龄结构分析、收入负债分析、逾期行为分析、信贷结构分析、家庭负担分析、风险洞察分析九个功能模块,用户可通过可视化图表直观查看不同信用等级下的分布特征与风险表现,为信用评估相关分析提供一定的数据参考。
选题背景
信用体系在不断完善的过程中,积累下来的信用数据规模越来越大,单靠传统方式去统计和分析已经很难满足需求。以往很多信用相关的分析系统,数据处理能力有限,面对大批量信用记录时,往往只能做简单汇总,像违约概况、逾期行为、收入负债、家庭负担这些维度很难放在一起综合查看。随着 Hadoop、Spark 这类大数据技术逐渐成熟,把海量信用数据先存入 HDFS,再借助 Spark 和 Spark SQL 做分布式计算,已经变成一种比较常见的处理思路。计算机专业的学生在做毕业设计时,也需要一个能体现大数据处理流程的题目,而信用等级数据分析正好贴合这个方向。本课题就是在这种背景下提出的,尝试用 Hadoop 加 Spark 的方式,对信用等级相关数据做多维度分析与可视化展示,让数据本身的结构和规律能够被更清楚地看到。
选题意义
从实际角度看,这个系统能把信用等级信息、违约概况、年龄结构、收入负债、逾期行为、信贷结构、家庭负担和风险洞察这几个维度集中到一个平台里展示,省去了来回翻表格、分别统计的麻烦,对需要了解信用分布情况的人来说,查看起来会方便一些。从学习角度看,做这个毕设能把 Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy 这些大数据相关技术真正用一遍,也能顺带熟悉 Django 或 Spring Boot 后端以及 Vue、ECharts 前端的配合方式,对个人动手能力的提升有一定帮助。从参考价值看,系统本身规模不算大,功能也谈不上复杂,更多是作为一个大数据入门级的实践案例存在,能给后面想做类似方向的同学提供一点思路。整体来说,它算不上多完善,但作为毕业设计,能把一个完整的数据分析与可视化流程走通,已经达到了锻炼的目的。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
- 基于大数据的信用等级数据分析与可视化界面展示:
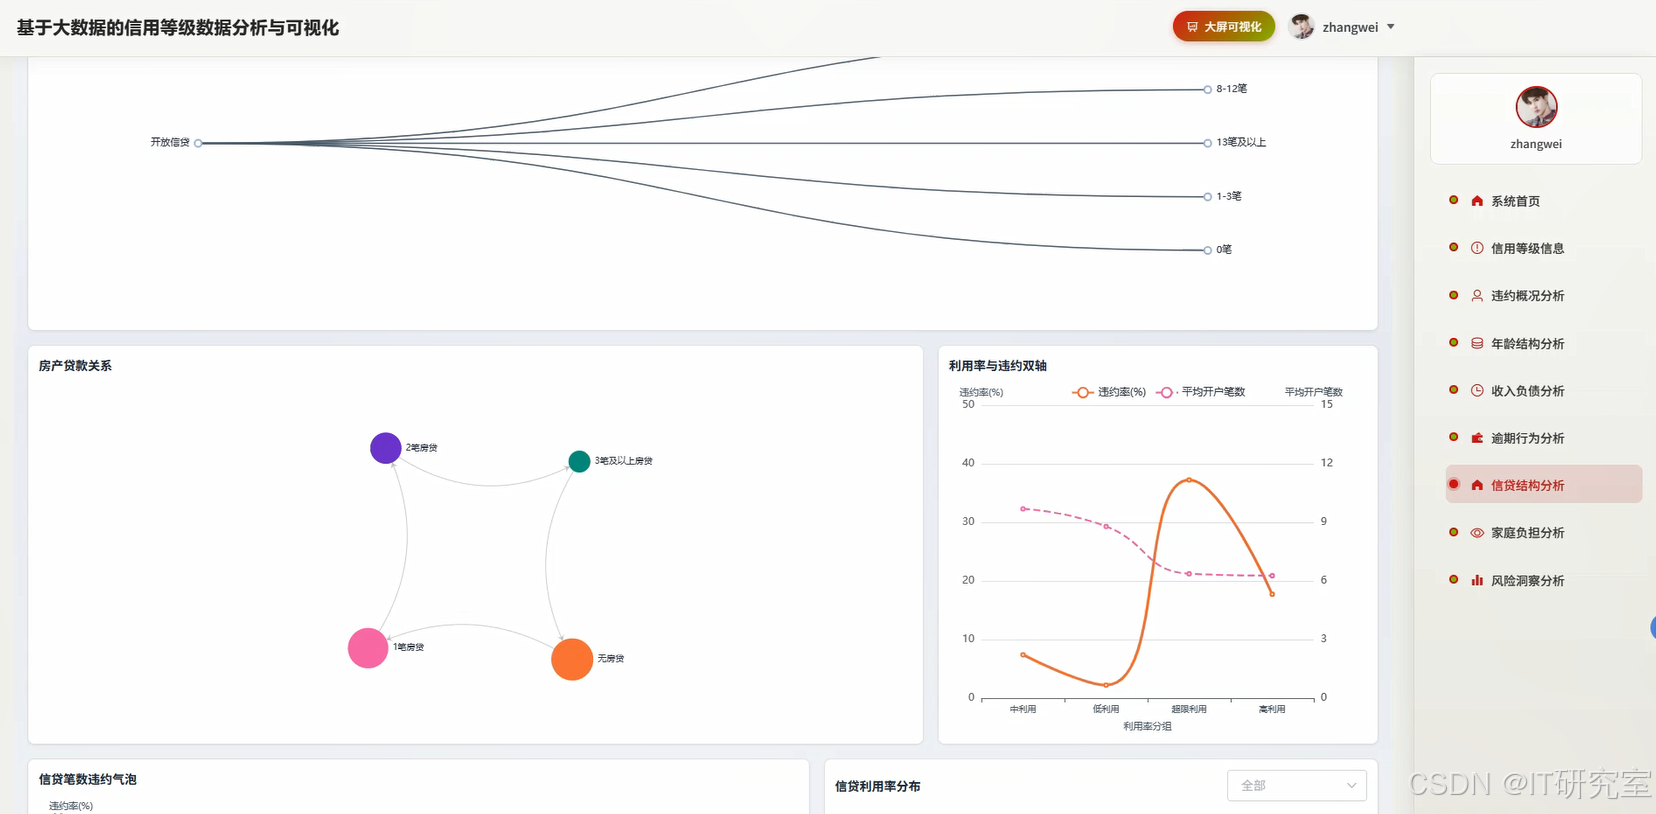
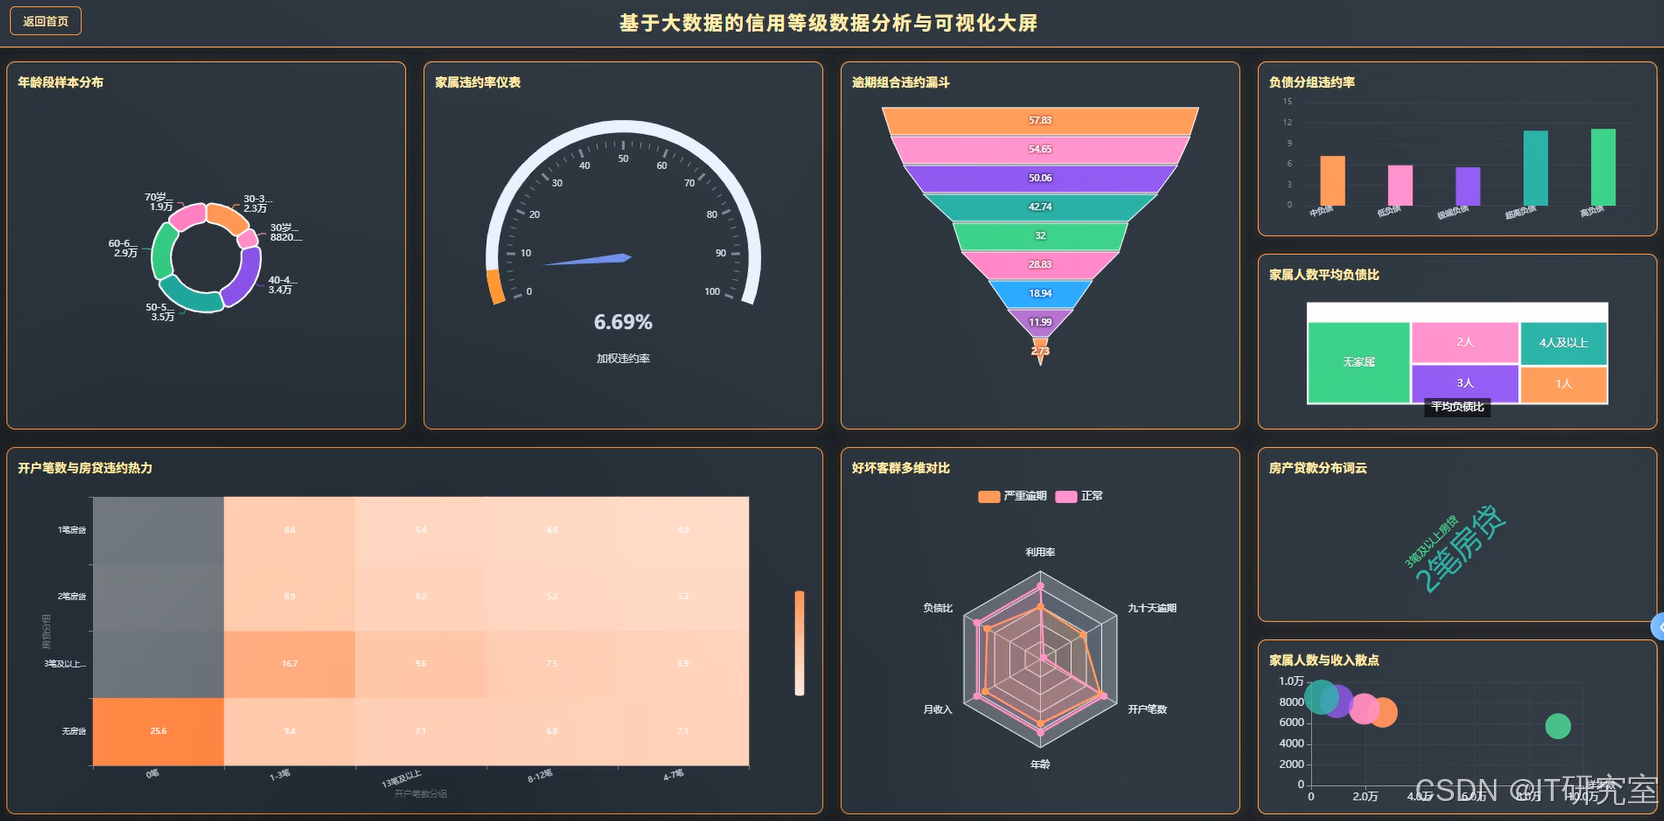
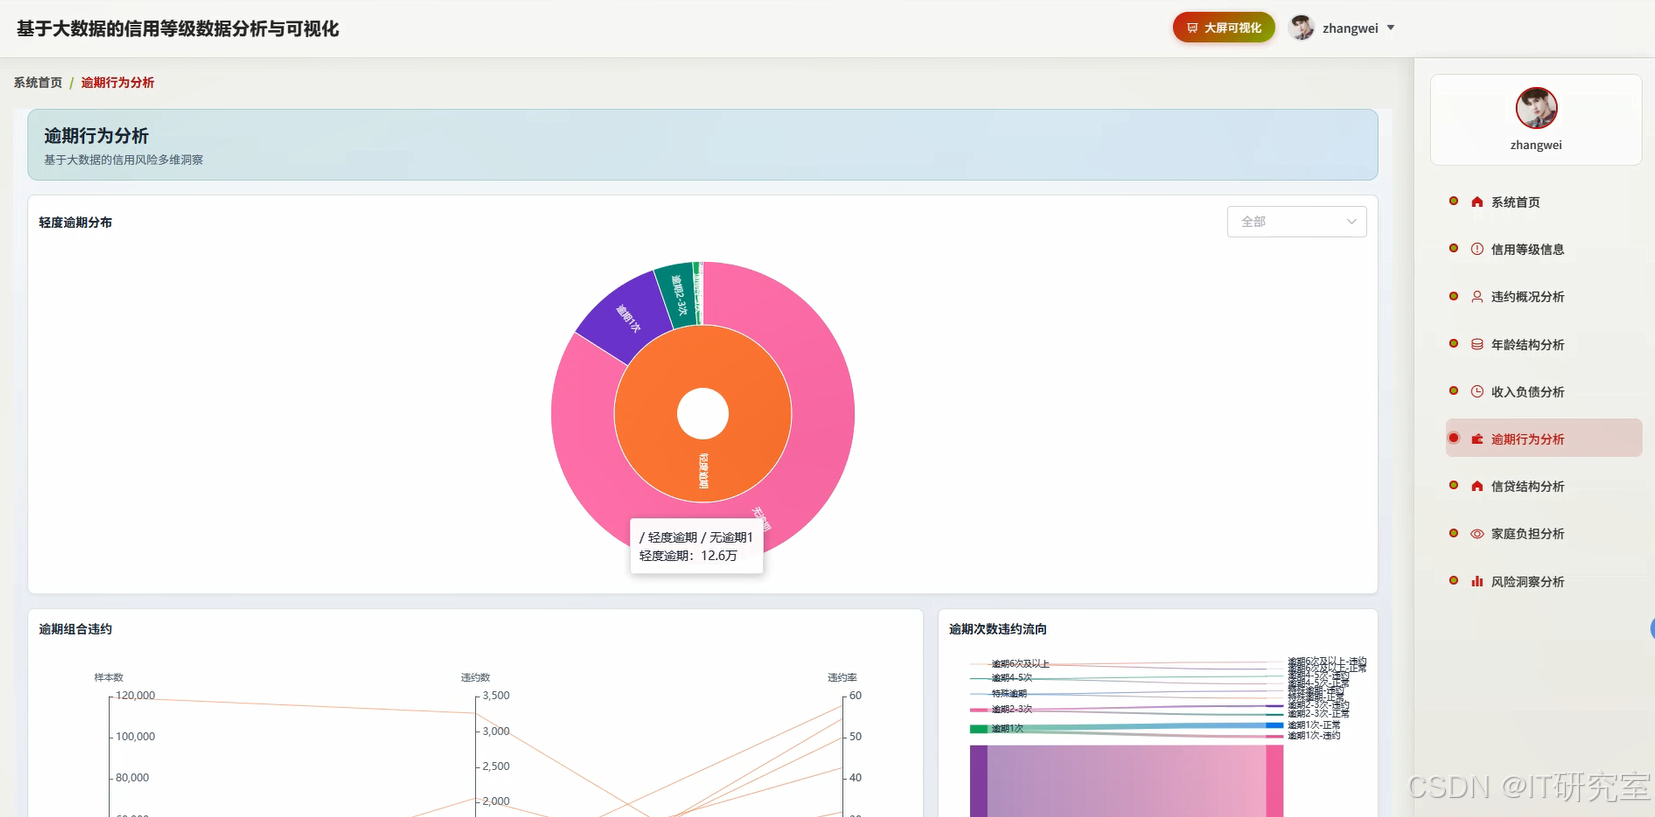
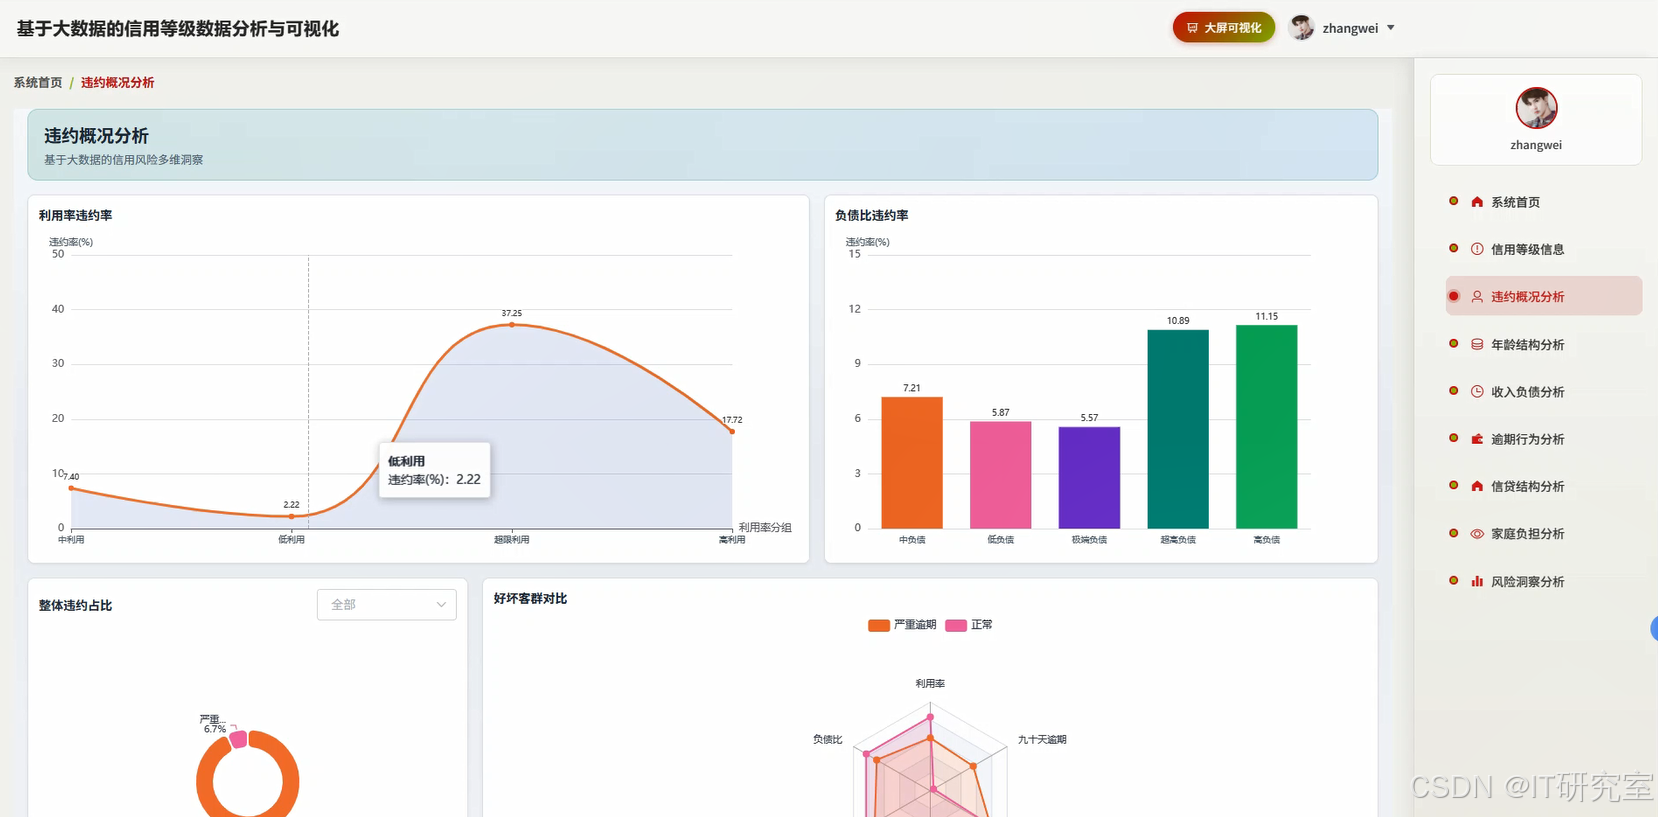
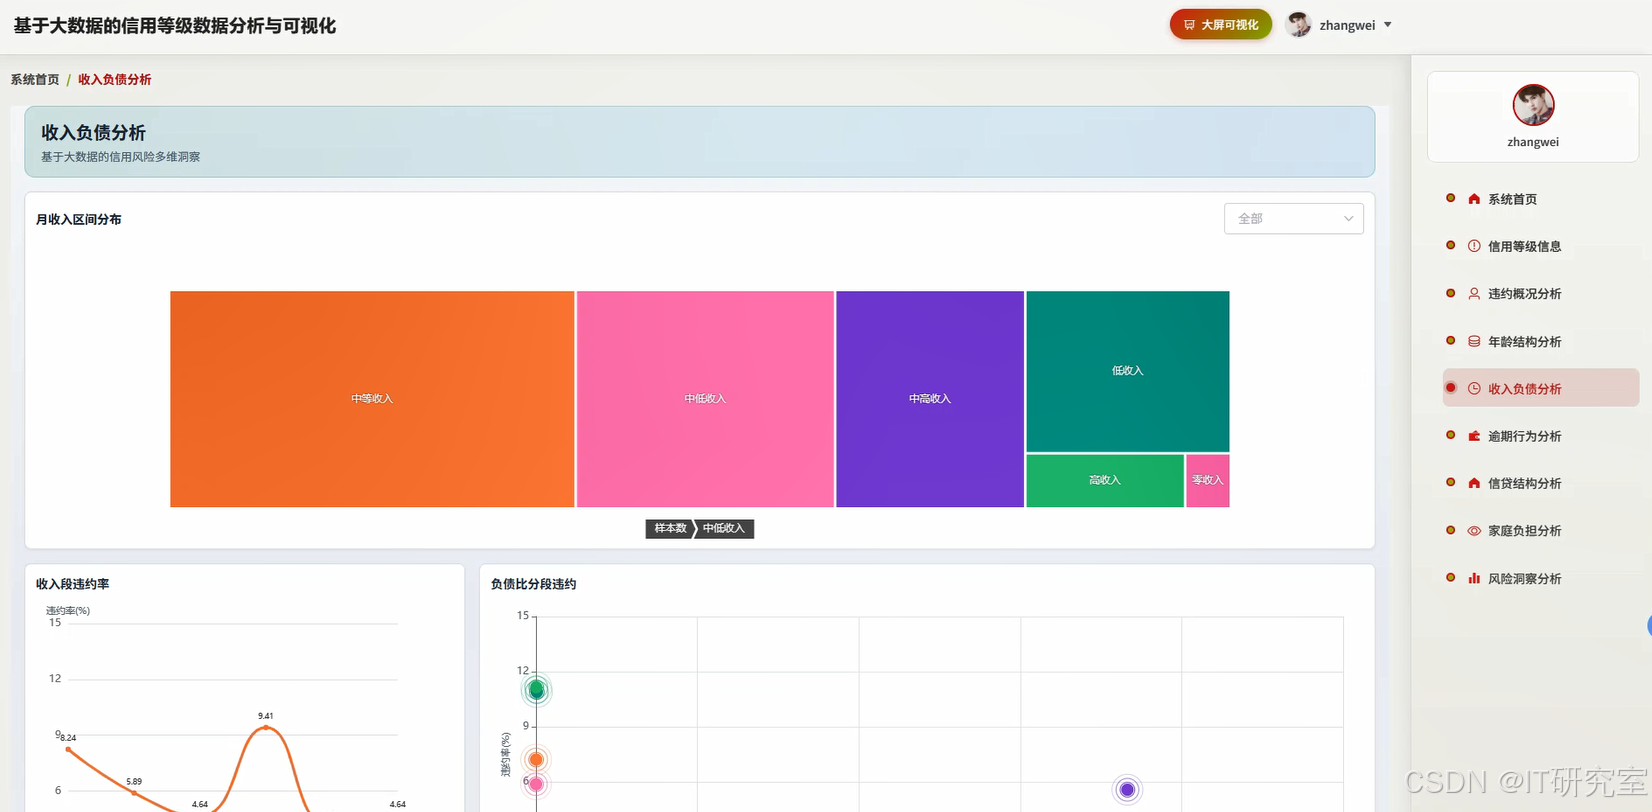
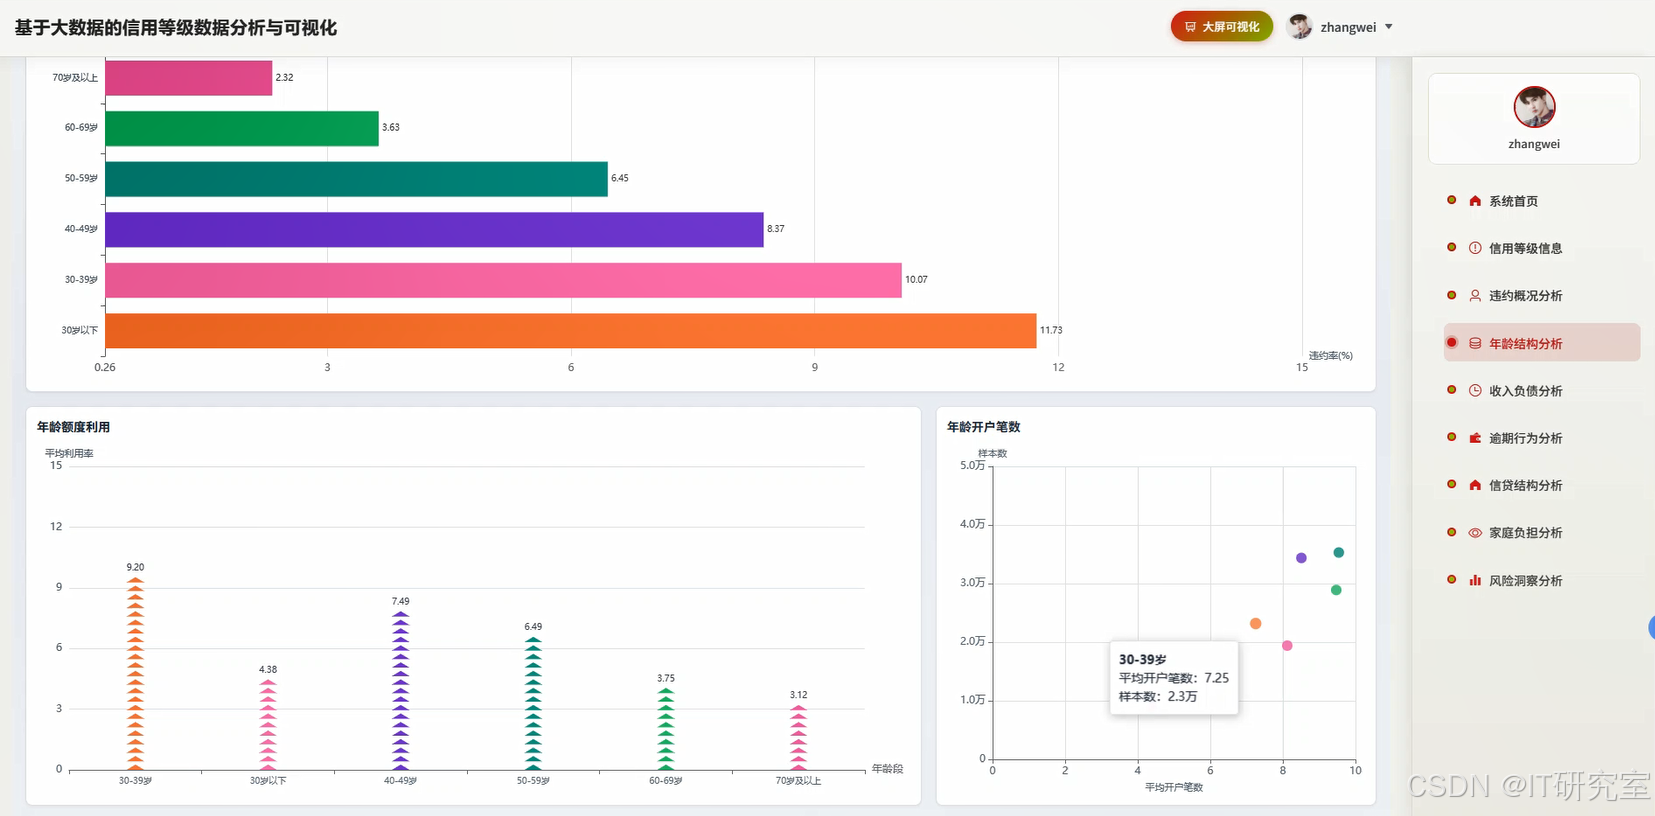
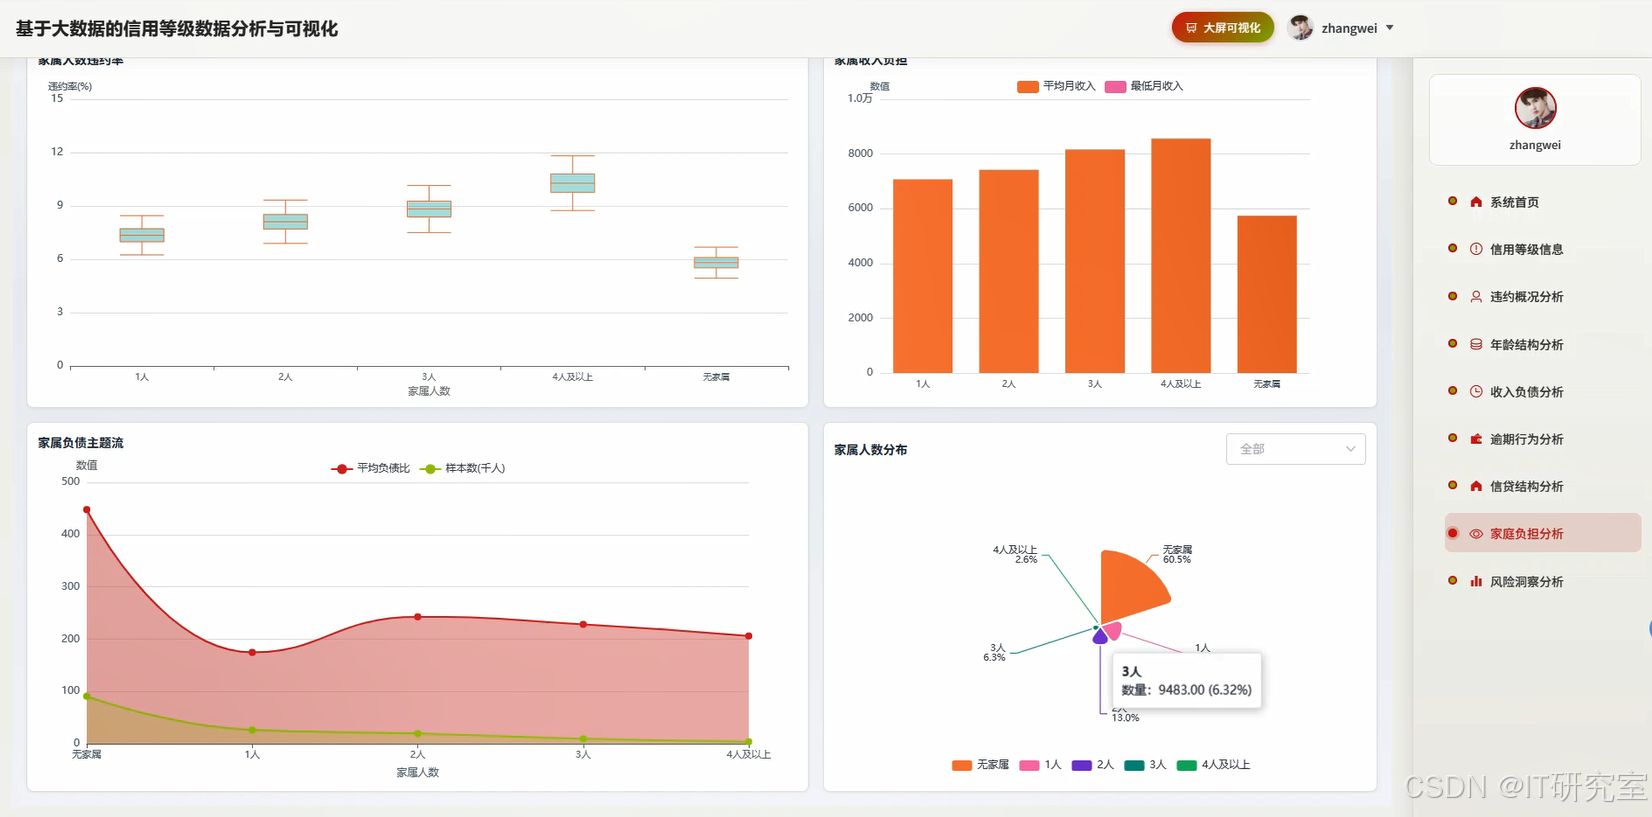
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
spark = SparkSession.builder.appName("CreditLevelAnalysis").master("local[*]").config("spark.sql.warehouse.dir", "/user/hive/warehouse").enableHiveSupport().getOrCreate()
def analyze_credit_level(spark, hdfs_path):
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(hdfs_path)
    df.createOrReplaceTempView("credit_info")
    credit_level_df = spark.sql("SELECT credit_level, COUNT(*) AS total_count, AVG(credit_score) AS avg_score FROM credit_info GROUP BY credit_level ORDER BY total_count DESC")
    credit_level_df.cache()
    result_list = credit_level_df.collect()
    credit_result = []
    for row in result_list:
        credit_result.append({"credit_level": row["credit_level"], "total_count": row["total_count"], "avg_score": round(row["avg_score"], 2)})
    credit_level_df.unpersist()
    return credit_result
def analyze_default_situation(spark, hdfs_path):
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(hdfs_path)
    df.createOrReplaceTempView("default_info")
    default_df = spark.sql("SELECT default_status, COUNT(*) AS default_count, SUM(loan_amount) AS total_loan FROM default_info GROUP BY default_status")
    default_df.cache()
    rows = default_df.collect()
    default_result = []
    for row in rows:
        default_result.append({"default_status": row["default_status"], "default_count": row["default_count"], "total_loan": float(row["total_loan"])})
    total = sum(item["default_count"] for item in default_result)
    for item in default_result:
        item["ratio"] = round(item["default_count"] / total * 100, 2)
    default_df.unpersist()
    return default_result
def analyze_overdue_behavior(spark, hdfs_path):
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(hdfs_path)
    df.createOrReplaceTempView("overdue_info")
    overdue_df = spark.sql("SELECT overdue_days, COUNT(*) AS overdue_count, AVG(overdue_amount) AS avg_overdue_amount FROM overdue_info WHERE overdue_days > 0 GROUP BY overdue_days ORDER BY overdue_days")
    overdue_df.cache()
    rows = overdue_df.collect()
    overdue_result = []
    for row in rows:
        overdue_result.append({"overdue_days": row["overdue_days"], "overdue_count": row["overdue_count"], "avg_overdue_amount": round(row["avg_overdue_amount"], 2)})
    overdue_df.unpersist()
    return overdue_result
五、系统视频
基于大数据的信用等级数据分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的信用等级数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇