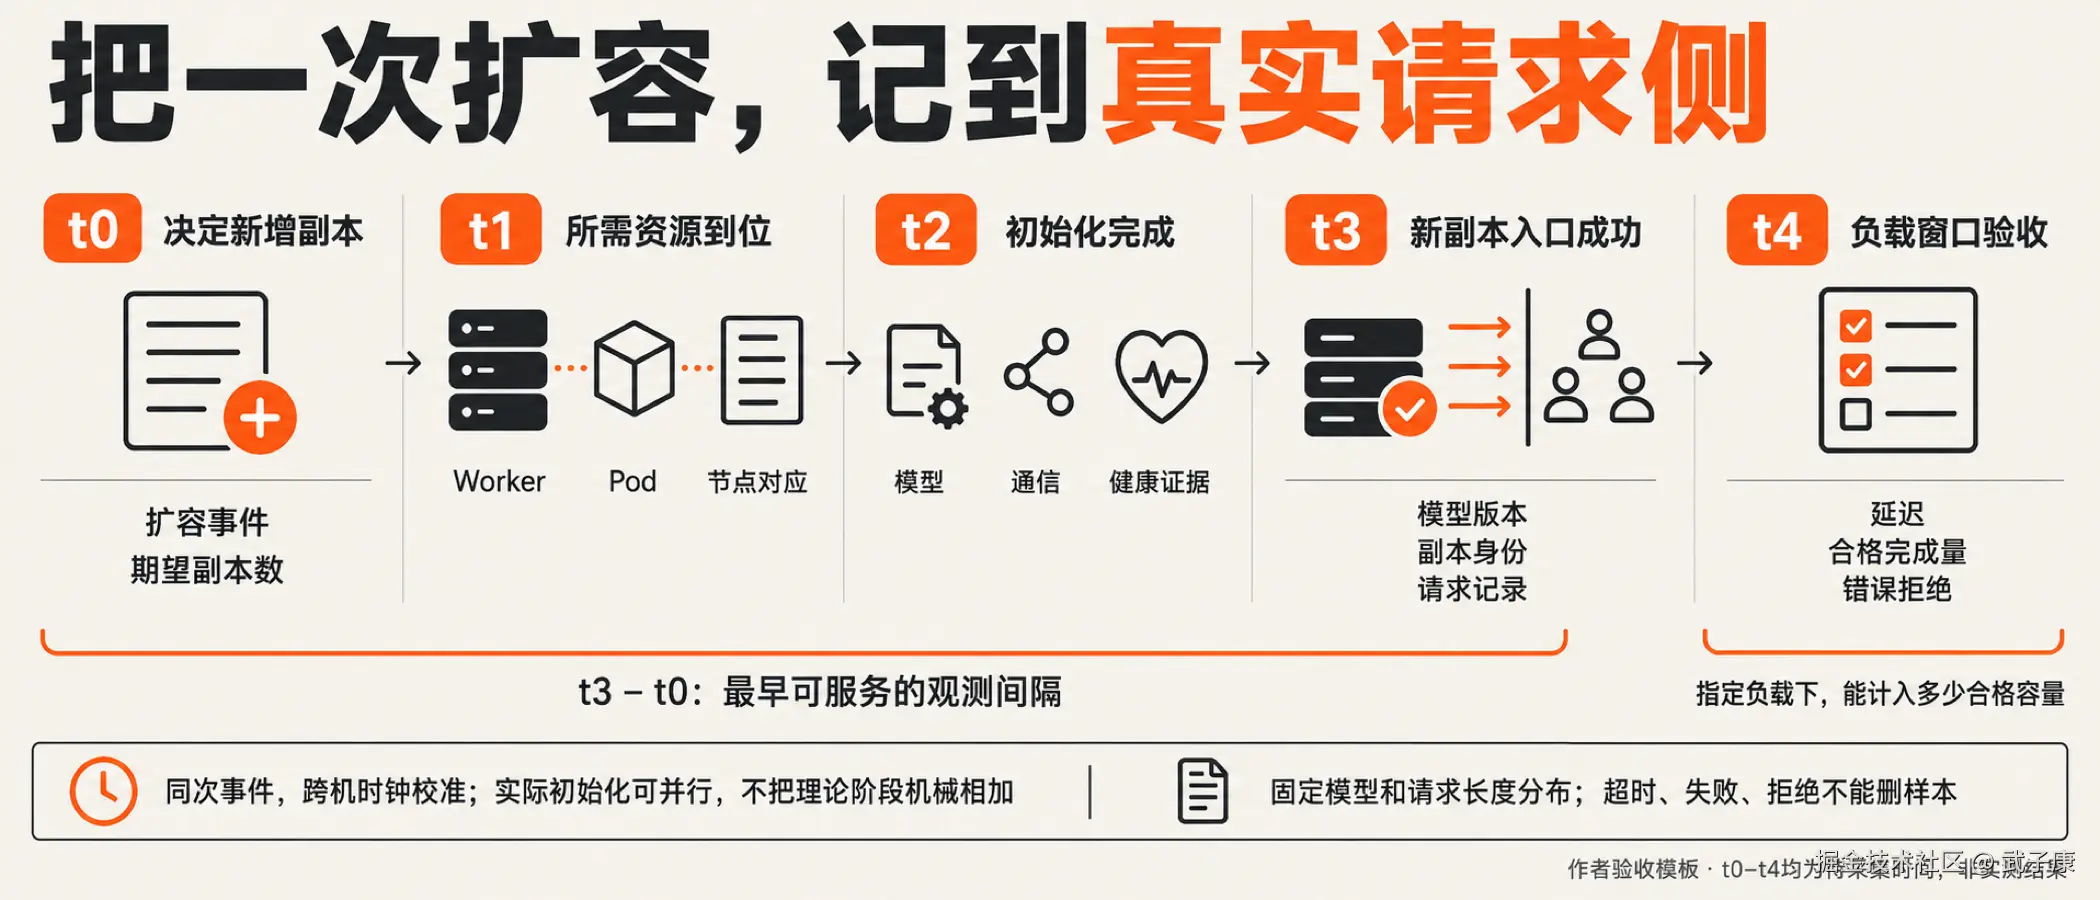
GPU Pod 已经 Running,为什么扩容还没变成推理容量?
流量升高,模型服务开始排队。扩容已经触发,新建的两个 GPU Worker Pod 也显示 Running,但请求的首 token 等待仍在增长。
这时继续增加副本数,可能只会得到更多正在启动的进程。要判断扩容有没有生效,必须找到另一个时刻:新增的完整模型副本,什么时候开始通过真实入口,持续完成符合要求的请求?
假设服务已采用 Ray Serve 与 KubeRay,新增一个跨两个 GPU Worker 的固定 TP/PP 模型副本。本文沿这一次扩容追踪,不再比较是否应该选择 Ray。vLLM 相关行为限定 v0.28.0;Ray 官方页面按 2026-09-08 展示的 2.58.0 文档核验,2026-09-12 再核对 Pod 状态与扩容文档。这个场景没有对应的 GPU 实验,也不构成这些组件任意组合的兼容性保证。
Running 记录的是进程,不是新增吞吐
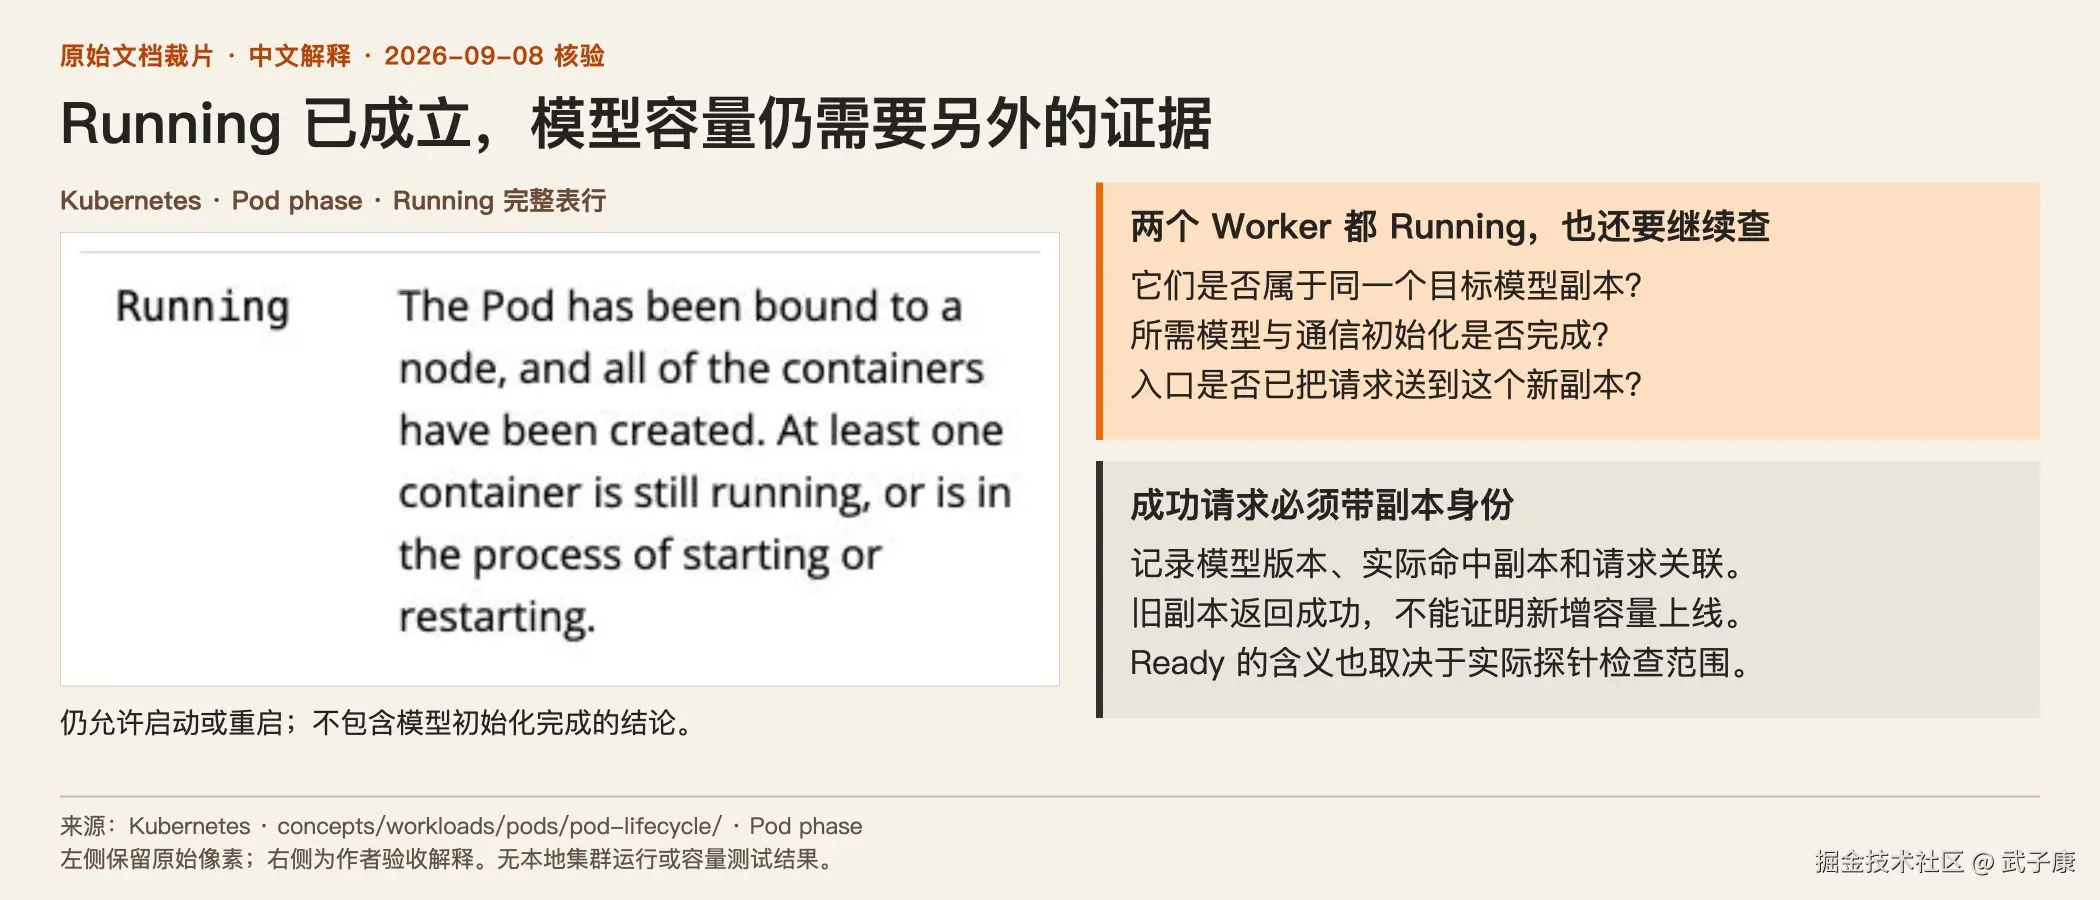
Kubernetes 对 Pod 的 Running 阶段给出的定义中,包含这句话:
At least one container is still running, or is in the process of starting or restarting.
也就是说,Pod 已绑定节点、容器已创建,但至少一个容器仍在运行、启动或重启。这个阶段本来就不是对应用是否可服务的完整汇总。Kubernetes Pod phase
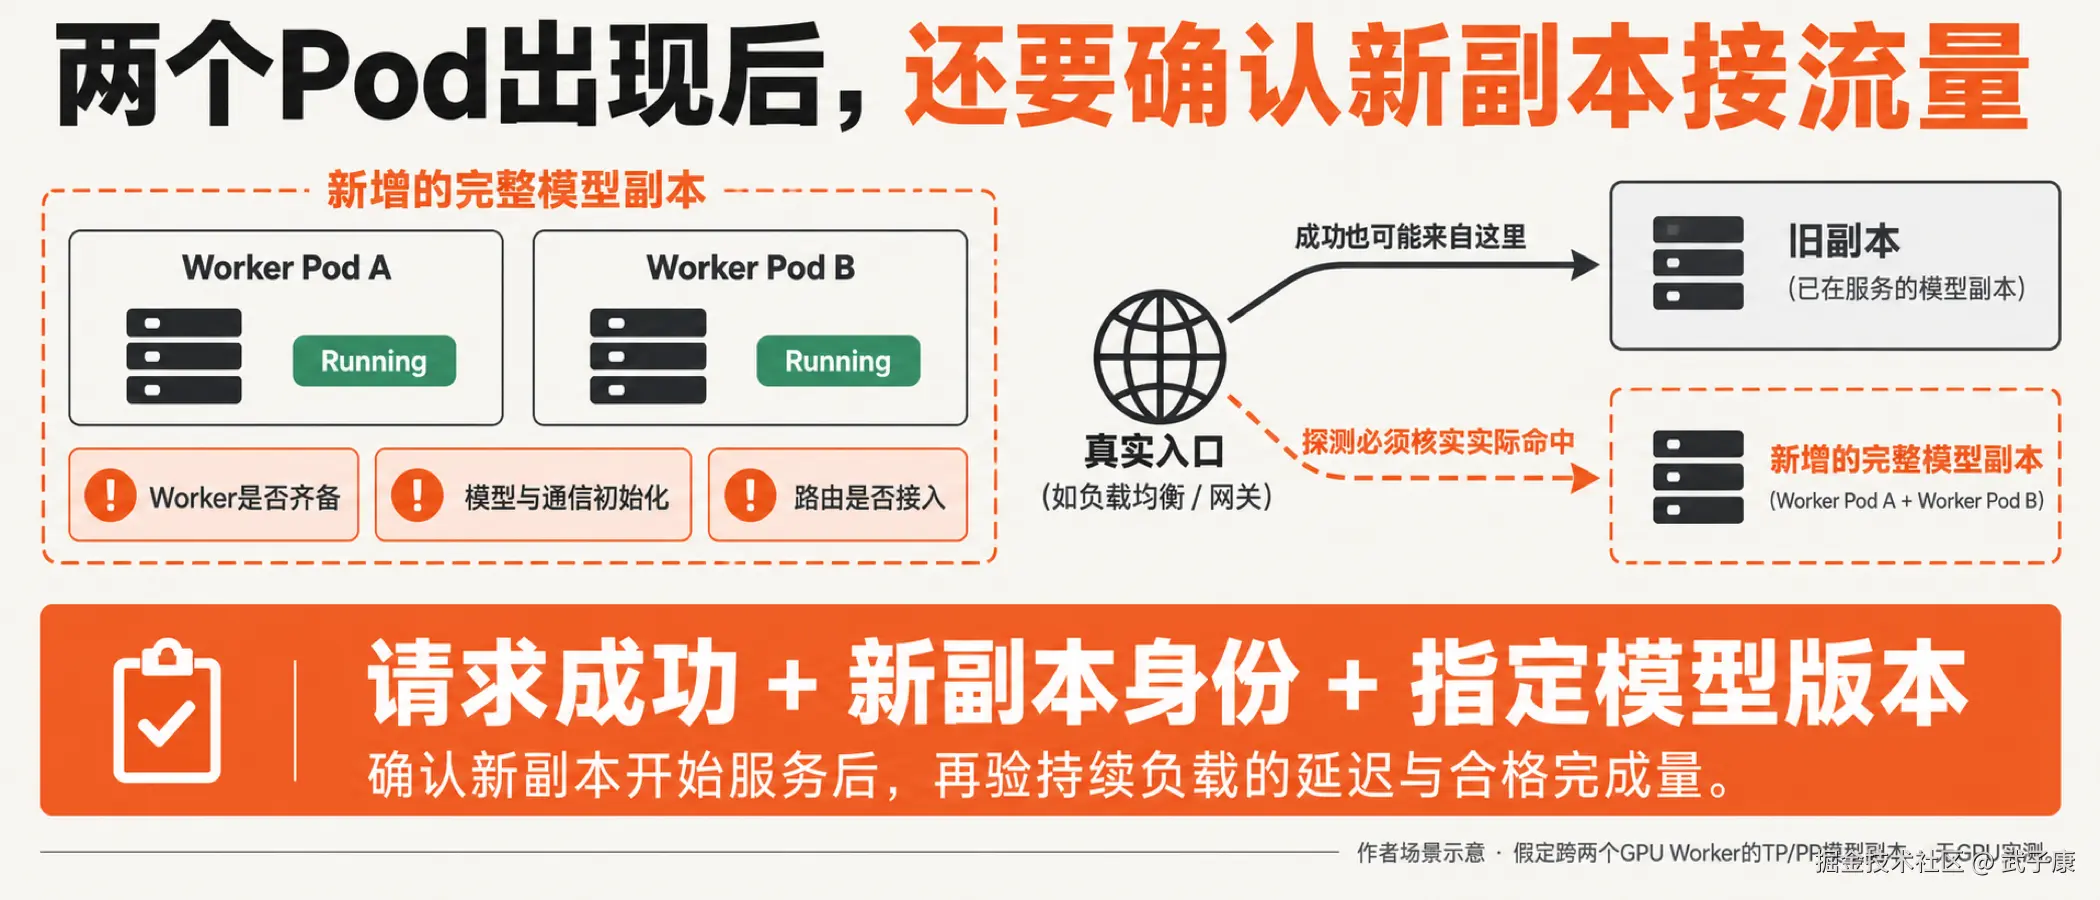
对新增模型副本而言,两个 Pod 都 Running,只能作为两个进程环境已经推进到某个阶段的证据。它没有回答:两个 Worker 是否都加入了目标副本,模型是否完成初始化,分布式通信是否可用,请求是否确实被送到这个新副本。
把 Running 改成 Ready 也不能自动补上全部答案。Kubernetes readiness probe 是否通过,取决于实际配置的检查;它可以用于等待加载、连接建立等初始化工作,但若探针只检查一个健康端点,就不能擅自解释为"完整模型已经通过代表性负载验收"。startup probe 则用于给慢启动留出时间,避免启动过程被不合适的存活检查反复打断。Kubernetes 探针职责
这里还隔着一层路由:Ray Worker Pod 可以承载多个 Actor,Serve 又有自己的副本和代理。不能直接把某个 Worker Pod 的 Ready 状态当作某个 vLLM 副本已能接流量。Serve 提供副本健康检查,也允许自定义应用级检查;检查覆盖到哪里,需要查当前部署的实现。Serve 副本健康检查
因此,第一次成功探测应带上实际命中的模型版本和副本标识。否则请求可能仍由旧副本完成,你得到的是"服务还有一个能工作的副本",而不是"新增容量已经上线"。
GPU 忙起来,并不直接产生更多 Worker Pod
沿扩容记录往前追,还可能发现另一个误判:GPU 利用率很高,所以 Ray 应该自动加节点。
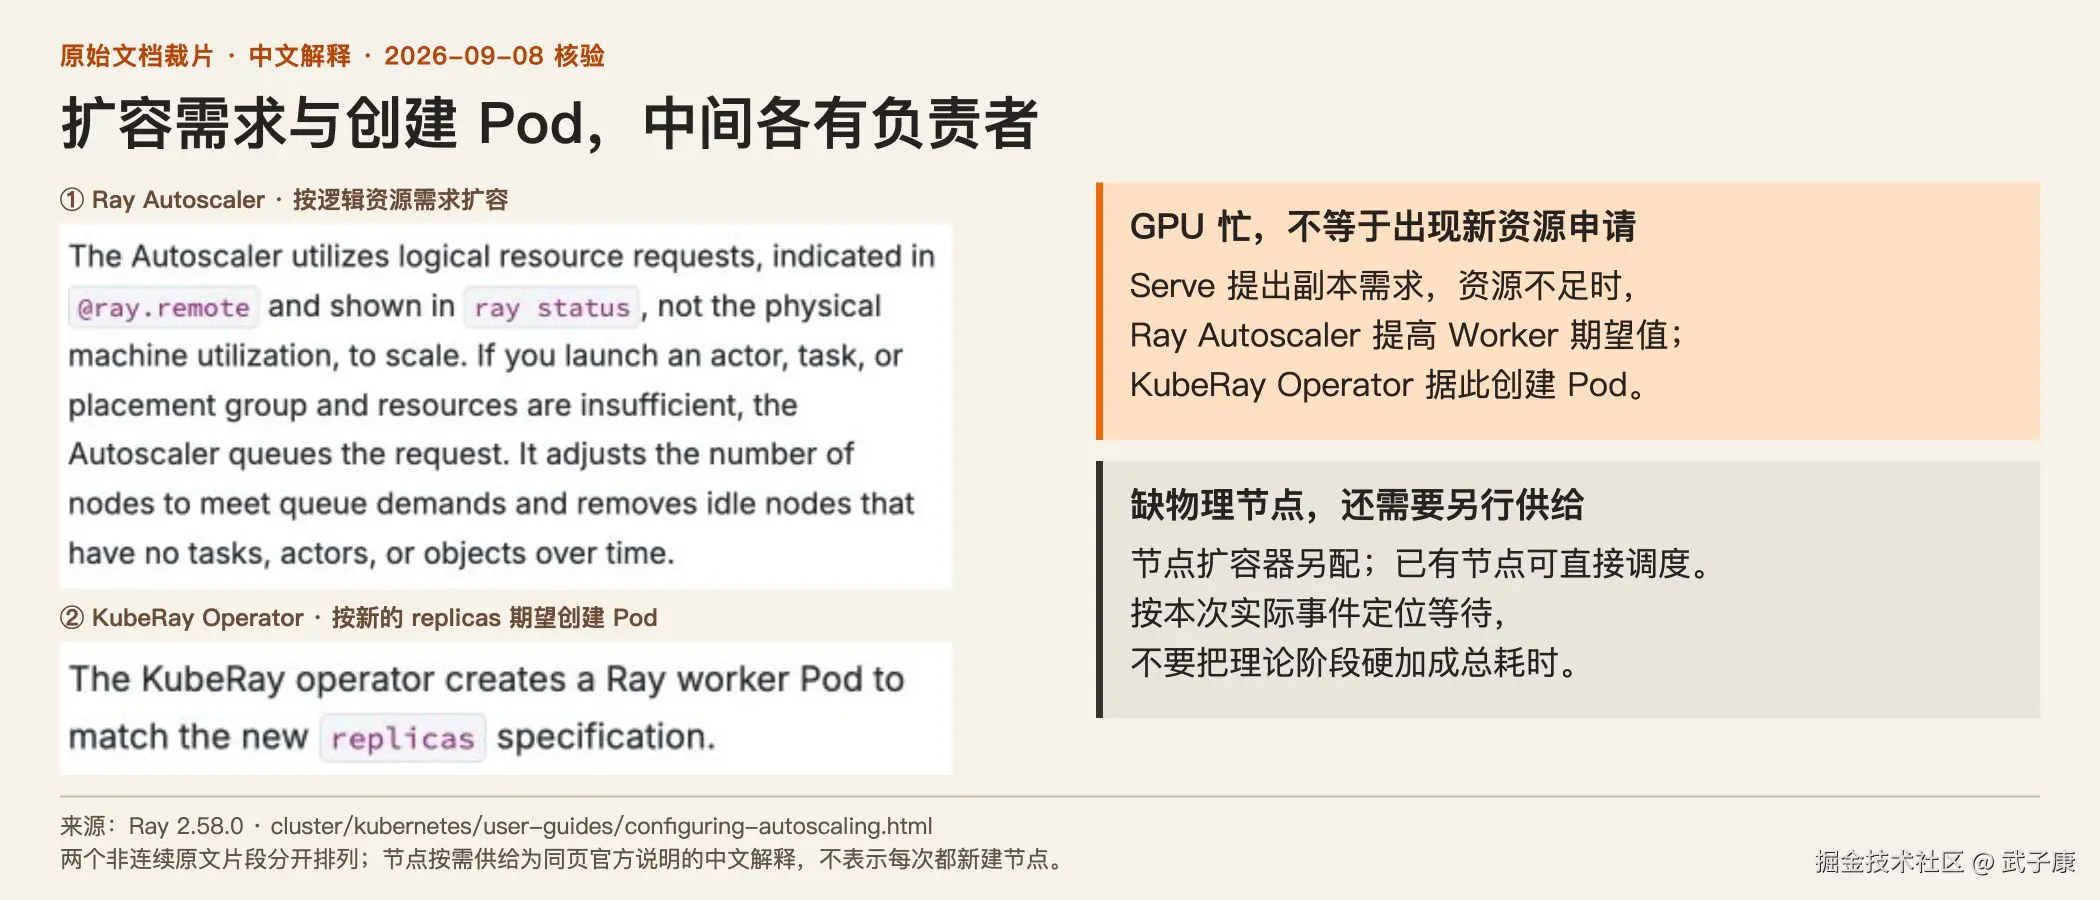
KubeRay 文档明确指出,Ray Autoscaler 使用的是逻辑资源申请:
not the physical machine utilization
它处理 Actor、Task 或 placement group 提出的资源需求。物理 GPU 忙碌,本身不等于又出现了一个待满足的资源申请。KubeRay Autoscaling
在本文已配置 Serve 自动扩容的场景中,需求通常先从服务层产生:Serve 根据副本正在处理和排队的请求情况决定是否增加副本,新副本再提出资源申请。随后才可能因资源不足需要更多 Ray Worker Pod。Serve 的副本上限、触发阈值与扩容延迟都可能影响这个过程,不能只观察 GPU 图表。Serve 扩缩容参数
KubeRay 的工作也不是直接变出物理服务器。文档展示的过程是 Ray Autoscaler 修改 RayCluster 的 Worker 副本期望值,KubeRay Operator 据此创建 Pod。若 Kubernetes 已有合适节点,Pod 可以在那里调度;若没有,还需要另行配置的 Kubernetes 节点自动扩容器提供节点。KubeRay 的扩容过程
这条依赖关系决定了下一步该看哪里。Serve 期望副本没变,先查服务层是否触发;期望值已增加但 Ray 资源申请在等,查资源是否能被满足;Pod 已创建却未调度,再看 Kubernetes 调度事件和节点供给。只有后者确实发生,才把等待归到节点扩容。
这些事件不一定是完全串行的:已有空闲节点时不会经历新建节点,预拉取镜像或模型缓存也会改变关键路径。应记录本次实际发生的事件,而不是给每个理论阶段硬填一段耗时。
通信日志通过,也还差一个服务结论
现在把视线移回已经 Running 的两个 Worker。若副本停在初始化阶段,需要把 Worker 加入、模型加载和通信初始化的日志放到同一副本下查看,找出最后一个有完成证据的步骤。
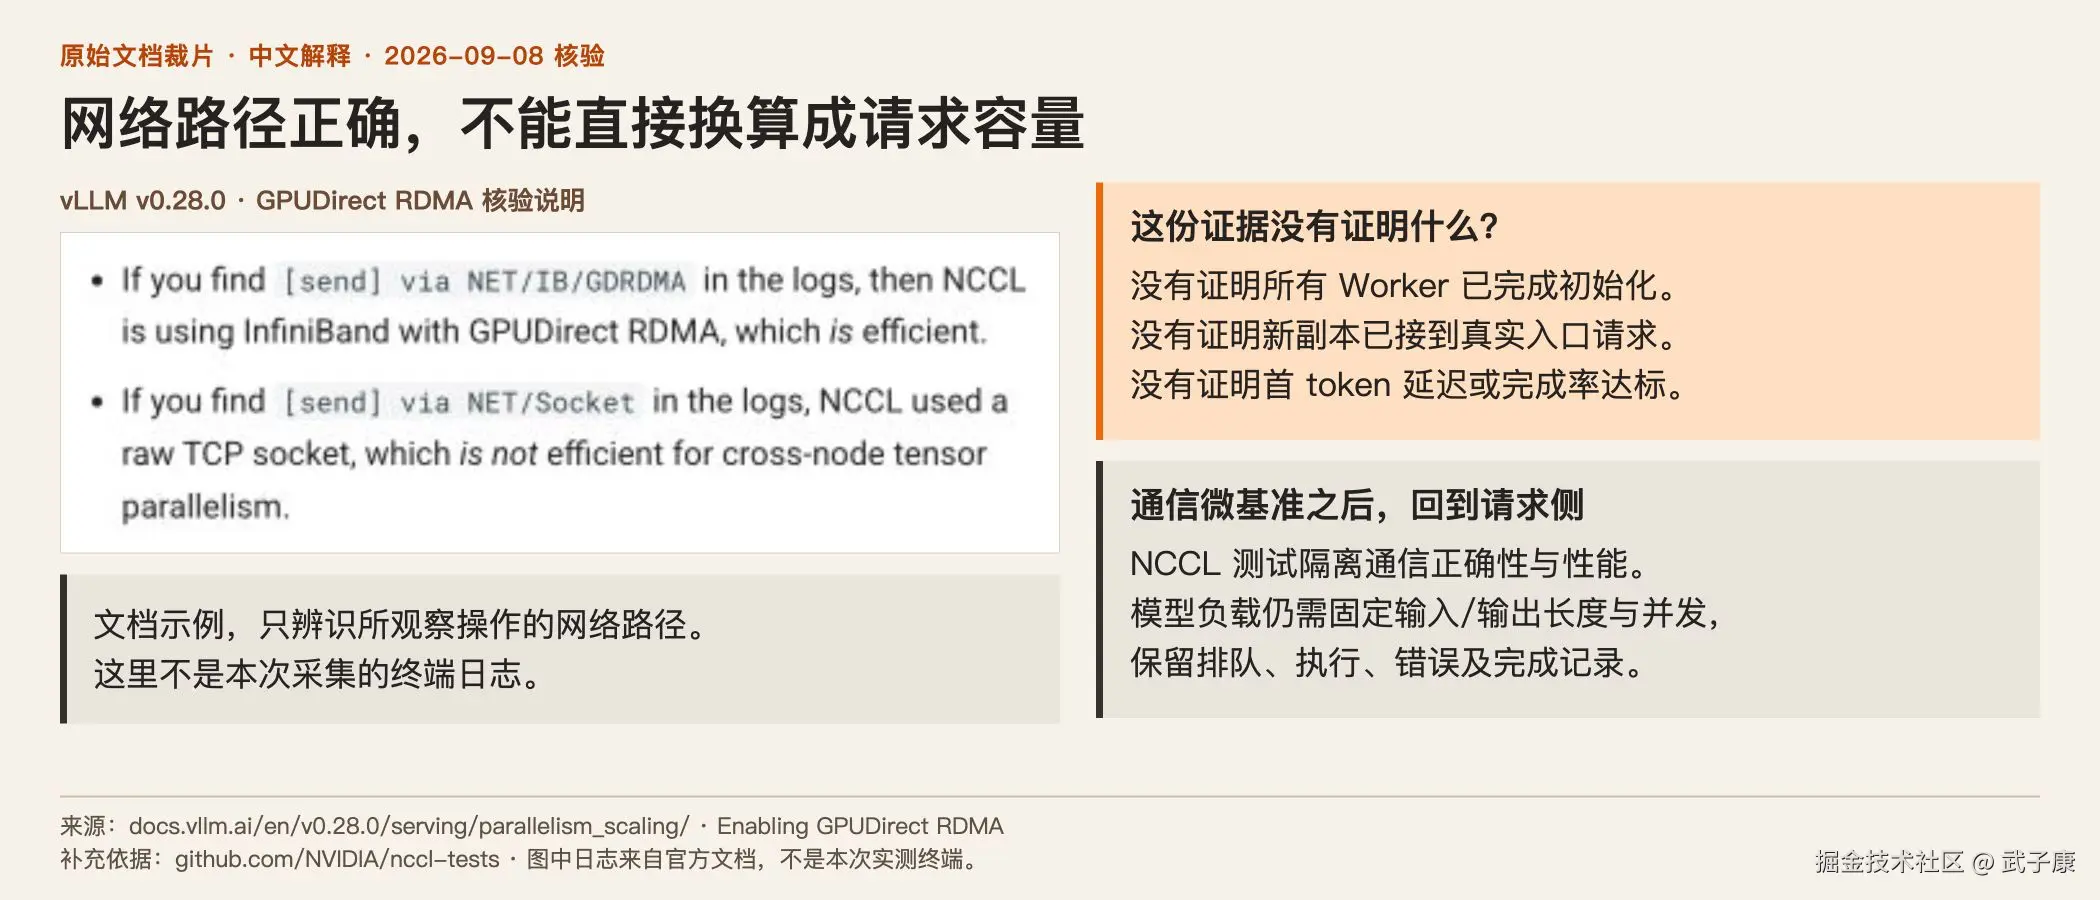
跨机通信尤其容易拿错证据。vLLM v0.28.0 文档用下面两种日志片段帮助识别实际网络路径:
text
[send] via NET/IB/GDRDMA
[send] via NET/Socket
前者表示使用 InfiniBand 与 GPUDirect RDMA,后者表示使用原始 TCP socket。这是文档中的路径辨识示例,不是本次服务的真实日志。如果部署预期使用前一种路径,却只看到后一种,应核对相应的网络、设备和容器配置;不能因为节点互相能通信,就认为预期的 GPU 数据路径已经成立。vLLM GPUDirect RDMA 核验说明
不过,看到期望的字符串,只能证明所观察操作的路径。它不能证明所有 Rank 都已完成模型初始化,更不能推出首 token 延迟达标。
NVIDIA 对 nccl-tests 的定位也很明确:检查 NCCL 操作的正确性与性能。它适合在指定 GPU 分组、消息大小和通信操作下隔离底层问题。NVIDIA nccl-tests
由此得到的工程用法是:保留测试的拓扑、操作类型、消息范围和并发条件,用它回答"这条通信路径是否存在异常"。不要把一次 AllReduce 带宽结果直接填写进"新增副本能承接多少在线请求"的结论中。在线请求还经过模型计算、排队、路由与输出,负载中的输入长度和输出长度也必须一致才有比较意义。
如果模型已能完成探测,但加入流量后仍慢,就回到实际请求的等待和执行记录。继续反复跑一条已经正常的通信微基准,不会替你验证服务入口的表现。
把一次扩容填成记录,再找最早没有完成的步骤
下面是一份作者设计的教学记录,不是真实集群日志,也不代表 KubeRay 的默认配置。假设一个部署中的每个完整模型副本使用两个 GPU Worker,保持前文同一固定 TP/PP 布局,模型 revision 和精度相同;旧副本正在提供服务,已有节点上还有满足这组布局要求的可申请 GPU。我们只追一次新增副本,从需求被看见到真实入口使用它。节点新建耗时不在这份样例中,换到需要新开云节点的环境必须把那一段加回来。
记录前先约定身份:旧副本为 replica-old,新副本为 replica-new;新副本的两个 GPU执行进程分别记录对应的Actor身份,并运行在 Pod worker-new-0 与 worker-new-1 中。这里的简称是教学代号。真实环境应保存不可混淆的协调进程与Worker的Actor ID、Pod UID、模型 revision 和请求 ID,不能只保存可能被重用的 Pod 名称。哪些关联由现成日志提供,哪些需要应用补采,要在记录里写明;下面不宣称所有字段都可从一个默认指标接口拿到。
| 扩容事件 | 教学相对时刻 | 可以确认的事实 | 仍不能确认的事 |
|---|---|---|---|
| 入口开始持续排队,触发副本需求 | 0秒 | 有新增服务能力的需求 | 资源申请是否已产生 |
| 本例服务控制层将目标副本数增为2 | 1秒 | 期望状态已改变 | 新Actor能否安排 |
| 两个新GPU Worker Pod均进入Running | 5秒 | Pod已启动到该状态 | 新模型能否接受请求 |
| 协调端记录完整模型副本初始化结束 | 25秒 | 核对Worker身份后,这个完整副本完成了初始化 | 外部请求是否会到它 |
| 真实入口关联到新副本的一次请求完成 | 29秒 | 至少一条真实路径能使用新副本 | 新副本可持续承载多少流量 |
这些相对时刻只是用来演算先后关系。生产排障时要用统一采集基准,或记录各系统时钟偏差;客户端的等待时长在客户端自身时钟计算。不要直接拿一台机器的单调时钟减另一台机器的时间戳,制造精确却没有意义的"24 秒"。
现在回看第 6 秒的一次巡检:入口探测返回200,Pod又已经Running,是否可以结束扩容告警?不能。假设这次探测的请求记录最终关联到 replica-old,那么它只证明旧路径还能回答。即使返回内容完全正确,也没有覆盖 replica-new。接下来应按该次请求的副本身份检查,而不是再提高探测频率,收集更多来自旧副本的成功结果。
第 25 秒看到新模型初始化完成,也不能直接把外部请求的失败归咎于模型本身。先用一条受控请求确认它经真实入口选择到新副本,保存该请求ID、Actor归属、模型revision和最终响应。若受控请求明确进入 replica-new 对应的执行链,但结果失败,再追模型执行;若请求一直进入旧副本,应先解释路由选择和副本是否已参与服务,而不是重复加载权重。无归属证据时,结论停在"尚未证明新路径可用"。
第 29 秒的新副本请求成功,使定位向前走了一步。此时至少可以排除"新副本永远收不到任何真实入口请求"和"这个请求在该条件下无法完成"两个假设,但不能推断新副本能达到目标吞吐,更不能从一个成功响应估出p99。下一步仍是固定输入/输出长度和到达节奏,观察新副本持续完成的请求、失败、超时与排队变化。应把新旧副本分开看,避免旧副本承担大部分流量而总指标掩盖新副本的问题。
如果某次事件停在第 5 秒之后,记录的用途是找出下一条缺失证据。新副本执行进程还没有开始初始化,就先检查相应资源安排和相关Actor状态;已经开始但长时间未结束,才追模型下载、加载、通信或初始化错误。这里不能以某条日志没出现就断言某个组件故障:先确认日志采集覆盖、副本/Actor身份和日志保留窗口。恢复动作应针对最早未确认的步骤,不同时重建Pod、改NCCL参数和修改模型配置。
这份教学记录里,服务层决定扩容对应 t0=1 秒,新副本首次经入口完成请求对应 t3=29 秒,差值为 28 秒。Pod 在第 5 秒 Running,不能把随后剩余 24 秒省略,也不能把这 24 秒全部归因于同一个组件:它还跨过模型初始化与路由接入。所需 Worker 资源获得时点 t1,应从资源与 Actor 记录补齐,不能只由 Running 时间反推;固定负载验收窗口结束时点 t4 尚未给出。
t3 只回答新路径最早何时可用,t4 才回答可以计入多少达标容量。固定模型、输入输出长度分布和入口负载,按事先约定的延迟与成功标准统计完成量,保留超时、失败和拒绝;不能把请求变短带来的提升归给新增副本。
新副本上线时,突发请求可能已经等不起
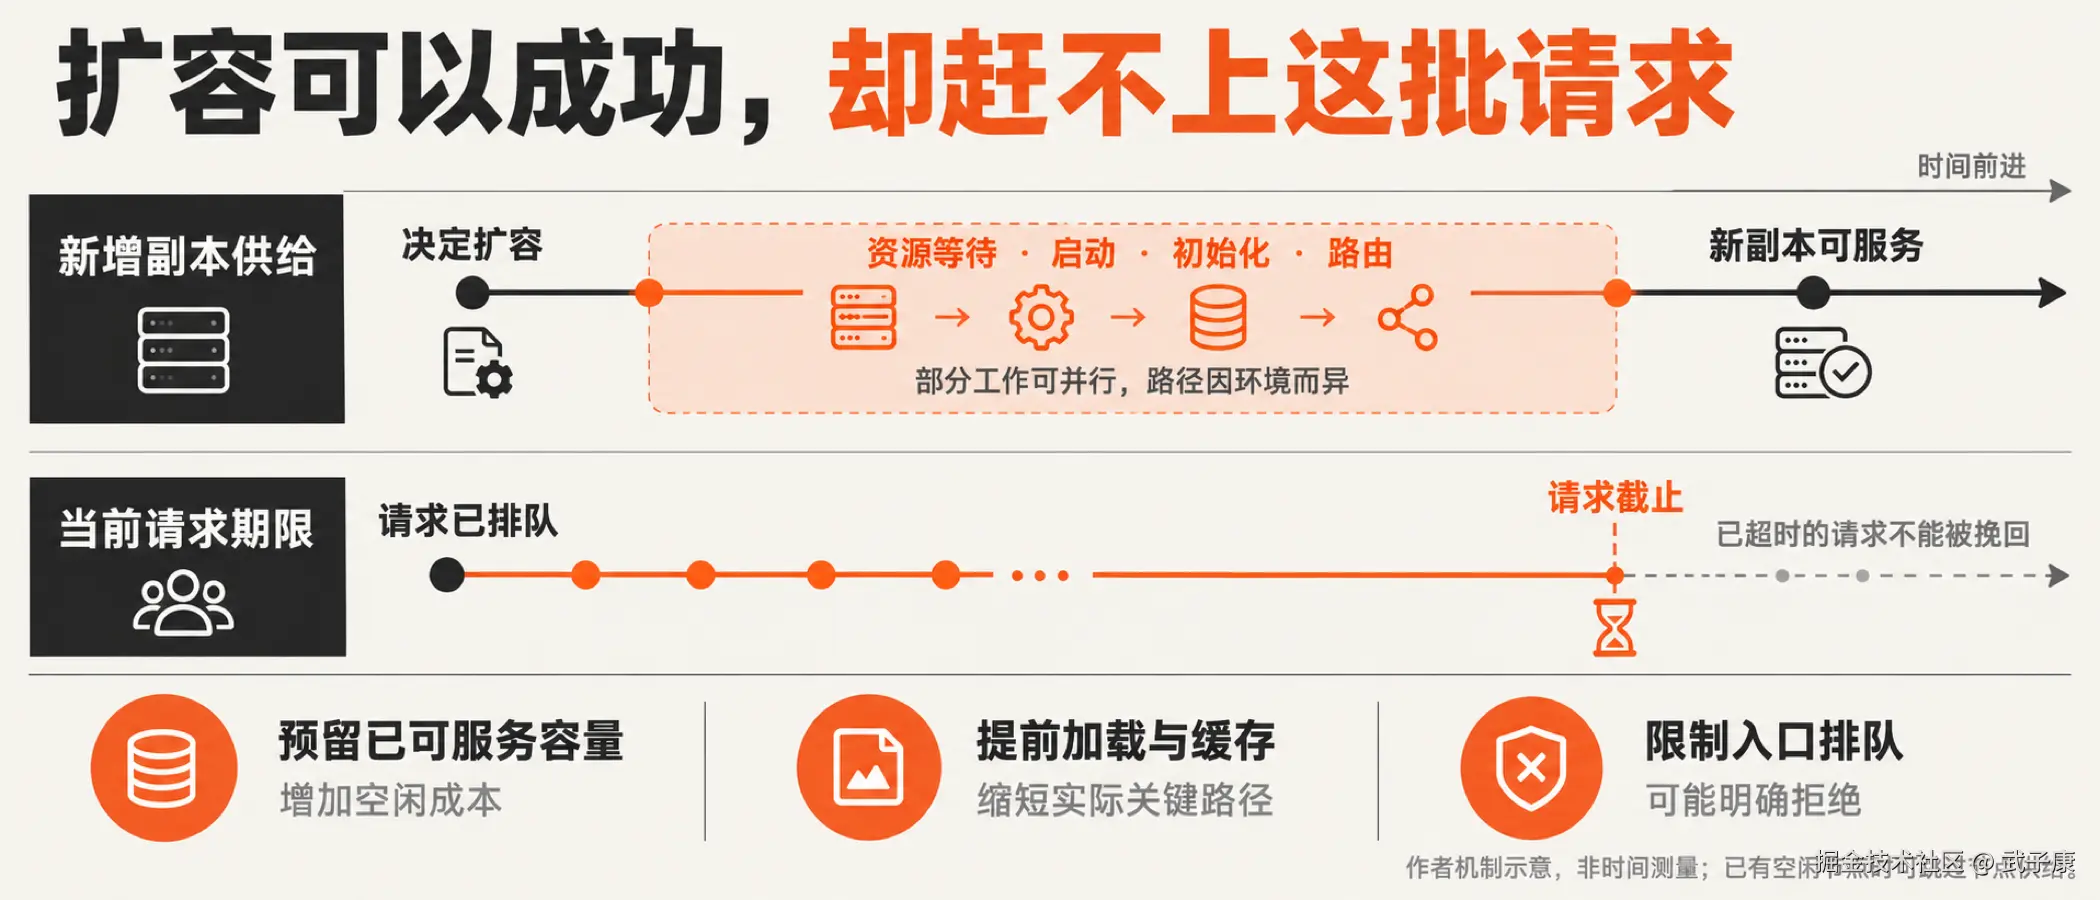
即使每一步都没有故障,扩容也不一定来得及缓解眼前的洪峰。
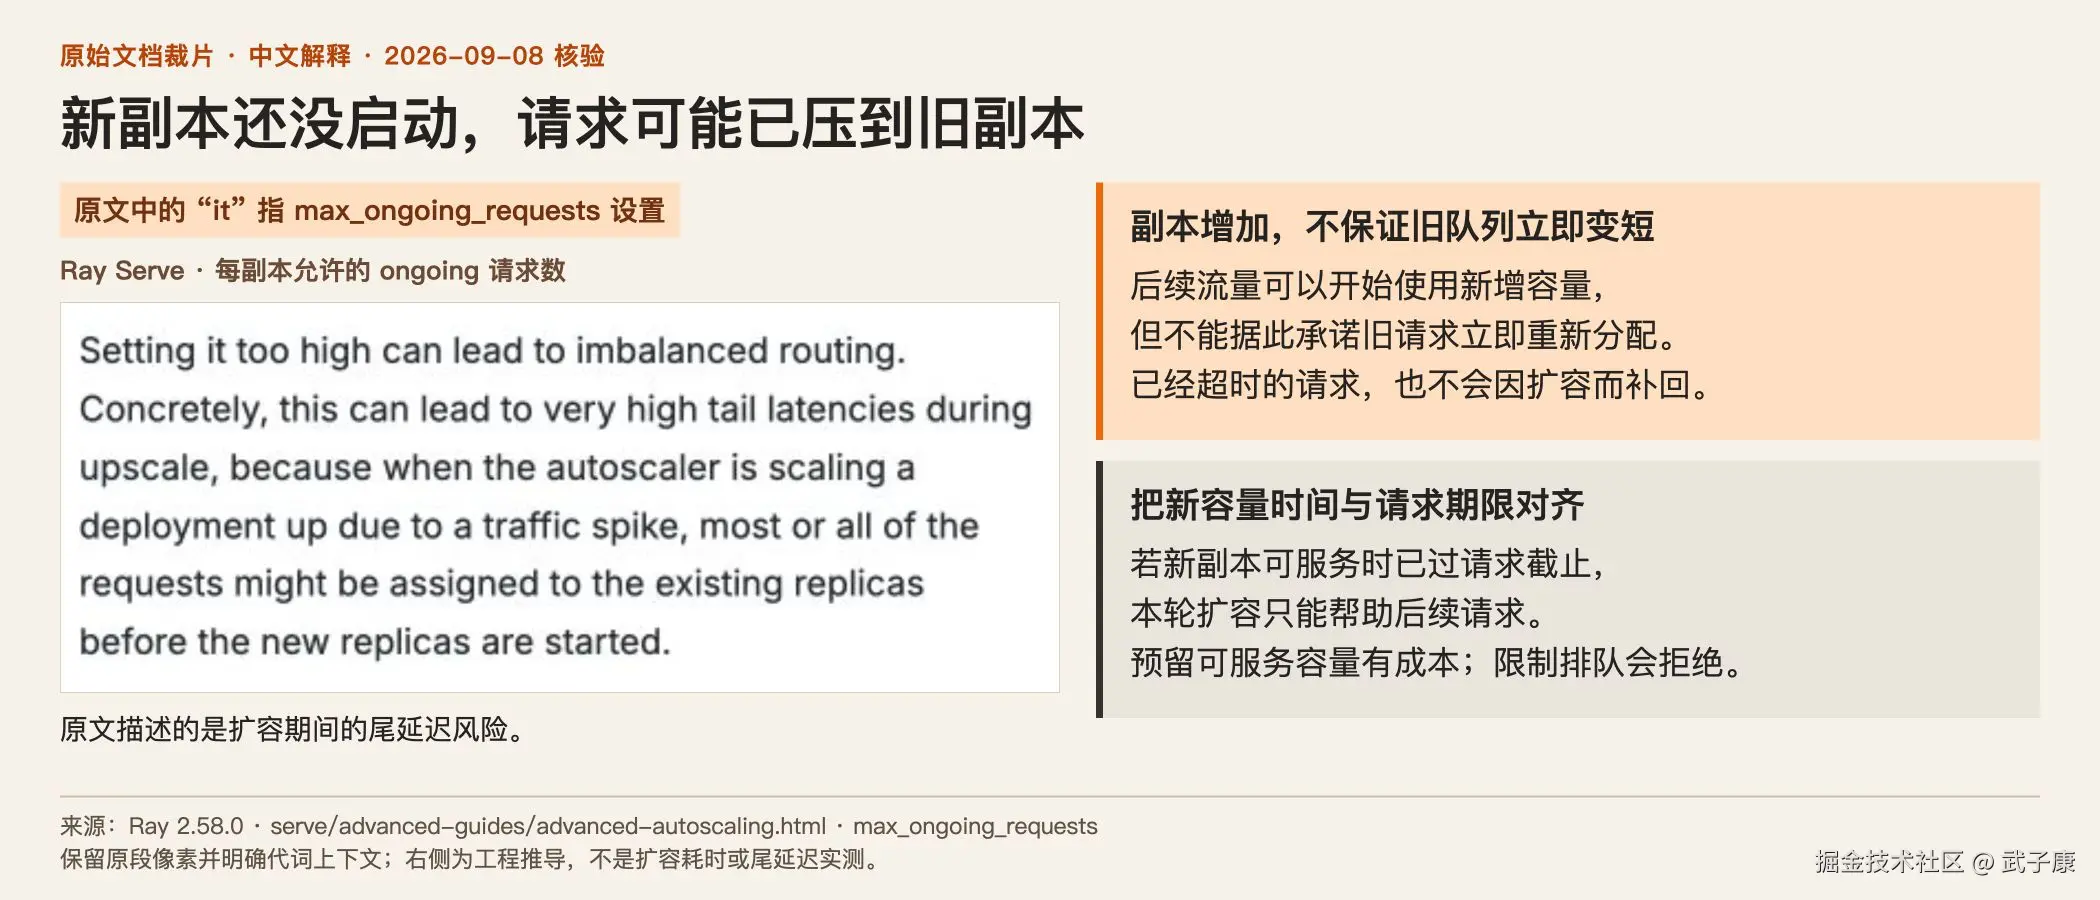
Ray Serve 文档提醒,将最小副本数设为零会增加冷启动等待。它还指出,每副本允许的 ongoing requests 设置过高时,突发期间的大量请求可能在新副本启动前就被分配给旧副本,带来很高的尾延迟。Serve 的冷启动与扩容期排队
这说明"副本增加了"和"旧队列立即变短"之间没有必然关系。新副本可以开始接收后续流量,但不能据此保证已经压在旧副本上的请求立即重新分配,更无法挽回已经超时的请求。
沿用上面的教学时刻,再加一条业务条件:一组请求在第2秒到达,客户端的整请求截止时间是8秒,因此最晚第10秒就应结束等待。新副本直到第29秒才被证明可以通过真实入口完成请求。对这组已经过期的请求,后来的扩容成功不会把已经返回的超时改成成功。
这也是为什么扩容后必须分别回答两件事:第29秒以后新增能力是否可用,以及之前那批用户请求最终得到什么结果。不能把它们放在一个累计完成数里,用随后完成的新请求掩盖前一批超时。
假设旧请求超时后,客户端立刻原样重试三次,而服务端没有及时停止原任务,那么新副本刚上线时,系统里就可能同时积压尚未停止的旧尝试和新增重试。扩容速度没有变,需求却被重试放大了。真实判断需要用逻辑任务ID与每次请求尝试ID区分,核对取消是否送达和旧计算是否结束;不能从客户端已经不再显示回答推导出服务端已经释放资源。
因此,这次扩容的完成记录应写成两条独立结论:一条记录"新副本在本次条件下已被真实入口使用,持续容量仍待固定负载验证";另一条记录"此前请求在各自截止时间内成功、失败或超时的数量,以及取消和重试是否产生残留工作"。前一条指导继续验收新增容量,后一条决定是否需要改善接纳、排队与重试策略。
如果新增容量每次都晚于突发请求的可等待时间,单纯增加扩容后的最大副本数不会缩短前面的初始化过程。可以分别验证预留热容量、提前触发扩容或限制入口等待等方案的成本与效果;每次只改变明确的一项,并保留同一到达轨迹。这里提出的是下一轮待验证选择,不保证任何一种设置能覆盖所有负载,也不能把拒绝掉的请求从业务达标率分母里删除。
故障恢复也要验证完整模型副本
Worker 故障恢复可以复用同一个终点。Serve 会尝试重建失败的副本 Actor,KubeRay 负责相应的 Pod 恢复;有空余资源时,部分恢复也可能发生在其他健康节点上。Serve 的 Worker 恢复过程
但本文的模型副本跨多个 Worker,不能把"还活着的另一个 Worker"当作独立健康副本来承接请求。应从故障发生开始重新计时,验证完整模型副本重建后何时又能通过真实入口服务,并另记在途流式请求的结局。Ray Serve 架构文档也明确,某类 Actor 所在机器故障会丢失连接、内部请求队列等瞬态数据。Serve 故障状态边界
这样,扩容报告的最后一句就可以是"新副本在 t3 首次经真实入口完成请求,并在 t4 的指定负载窗口达到约定目标",而不只是"两个 GPU Pod 已经 Running"。两句话之间,正是需要被测量和维护的生产能力。