在模型训练过程中,我们发现参数paramenter越多,训练集和测试集的loss差别越大,反而越容易过拟合,这节课主要来看如何确定参数的数量保证最佳训练结果
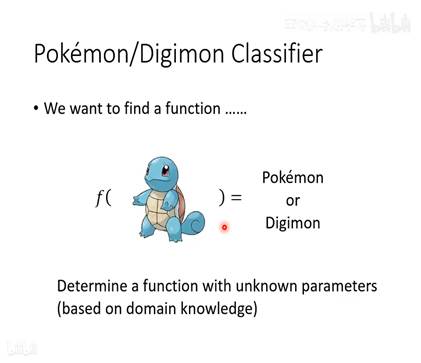
上图显示,机器学习首先要定义一个带有未知参数的function,这个参数需要根据已有知识确定
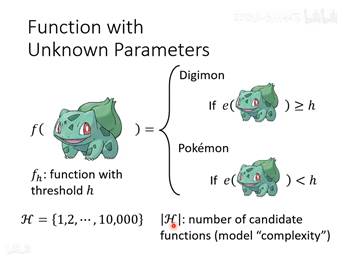
H是分别指各个参数的可能性的数量,加绝对值是指所有参数可以选择的数目,也就是我们常说的模型复杂度
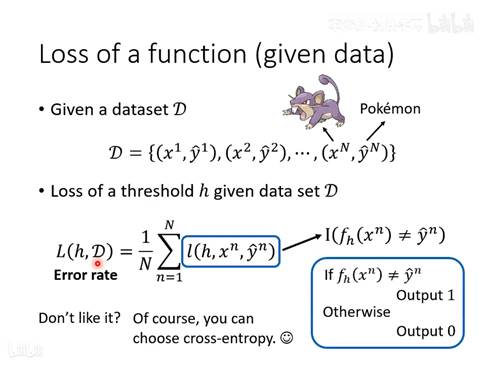
分类问题损失函数的设置:
h是指设置的参数,D是指数据集设置,预测值与真实值相同输出0,预测值与真实值不同输出1,然后取均值,最终输出错误率,但是我们之前讲过对于分类问题使用使用cross-entropy,这里错误率显示更直观,loss function 其实影响不大,后续会继续讨论
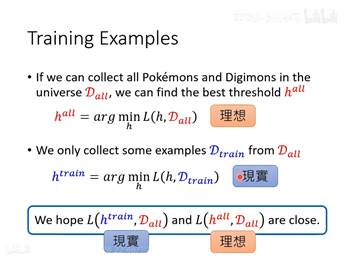
损失函数的function定好了,下面要看如何优化,理想的样本来自所有数据,但是实际上我们可能只有其中的一些样例
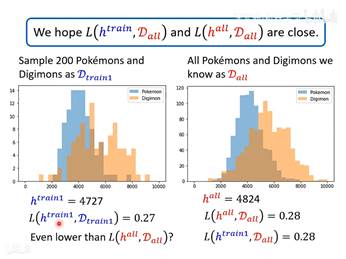
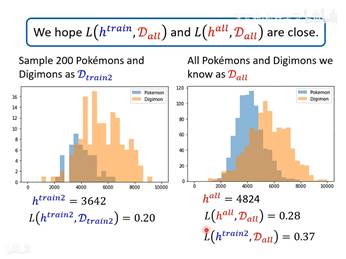
上面两张图可以看到,训练结果的好坏和sample 数据的质量有很大的关系
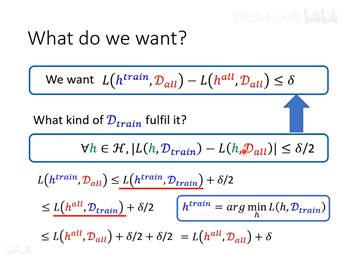
如何将训练的loss贴合全部训练的结果loss,选择其中的任意一组参数,使得它的训练结果无限贴近全部训练结果
下面的讨论可以用于多种情景下,不仅仅用于loss function,也适用于其他情况
上面我们已经提到,sample数据的质量可以很大程度影响loss的训练结果,那么下面我们继续讨论sample到一组坏的数据的几率有多大
train数据被某一个参数h弄坏的几率有一个上界:
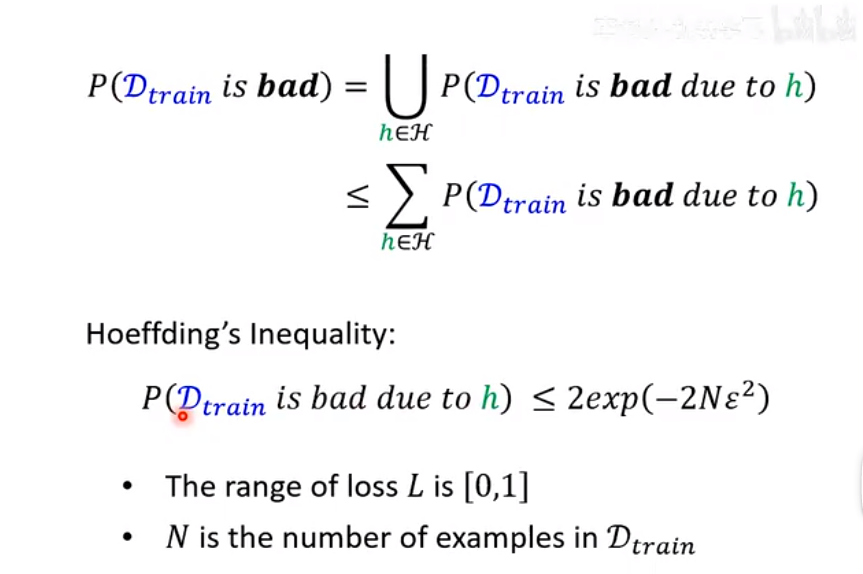
总结:
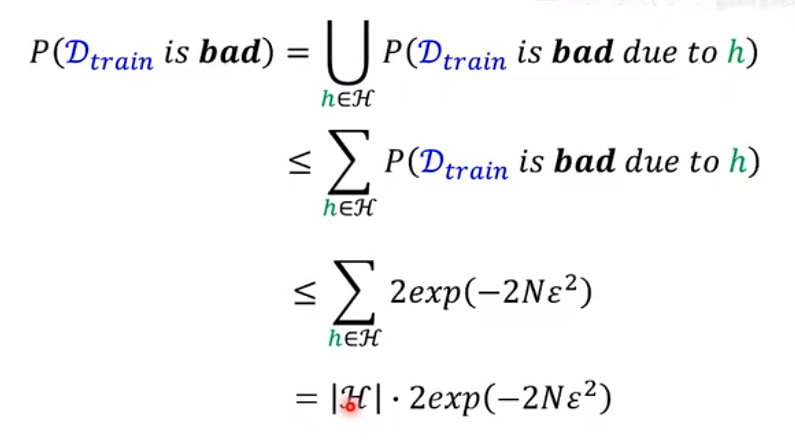
H是可以选择的function的数目,那么sample到的date是坏的几率被我们用公式表示出来了,N是训练资料的数目
下面要考虑如何把这个几率变小
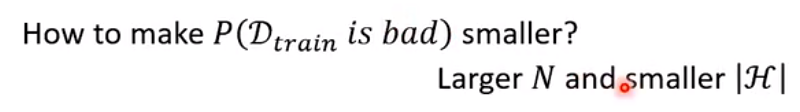
把N调大,每个h可以弄坏的训练资料变少了
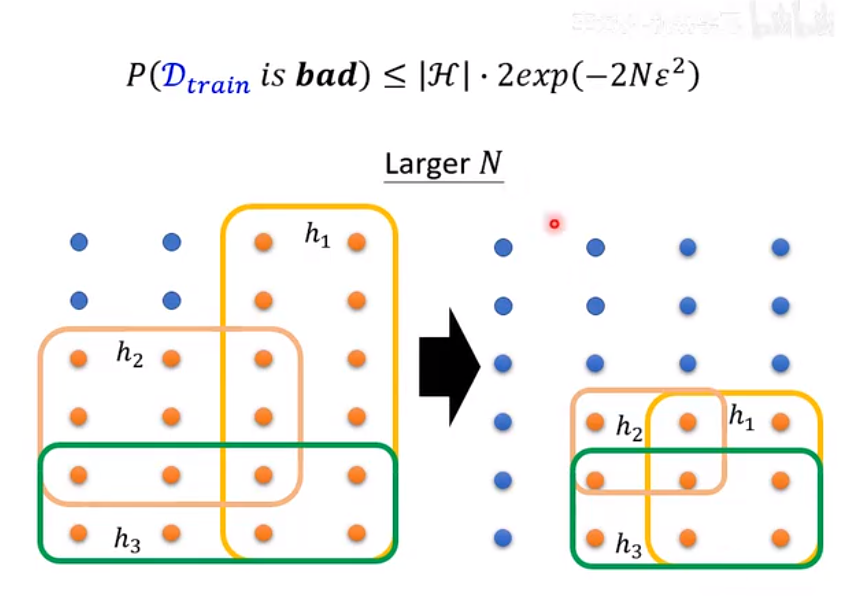
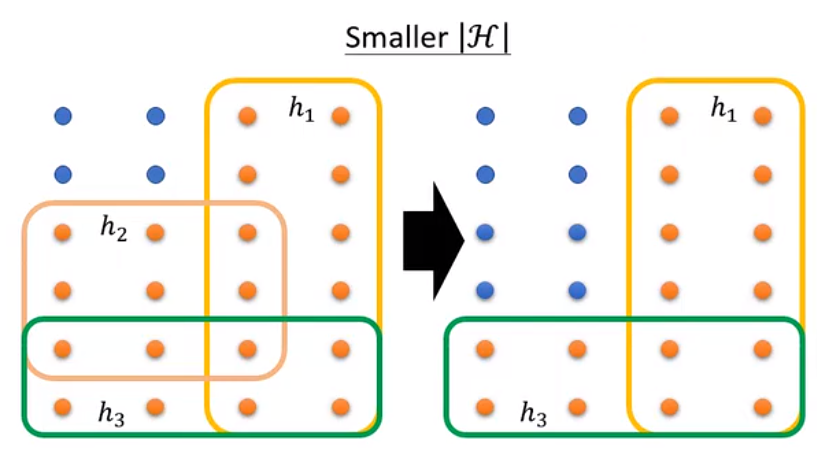
H的数量变小:
下面的例子可以看到随着训练资料N的增加,sample到坏的数据的几率越来越小
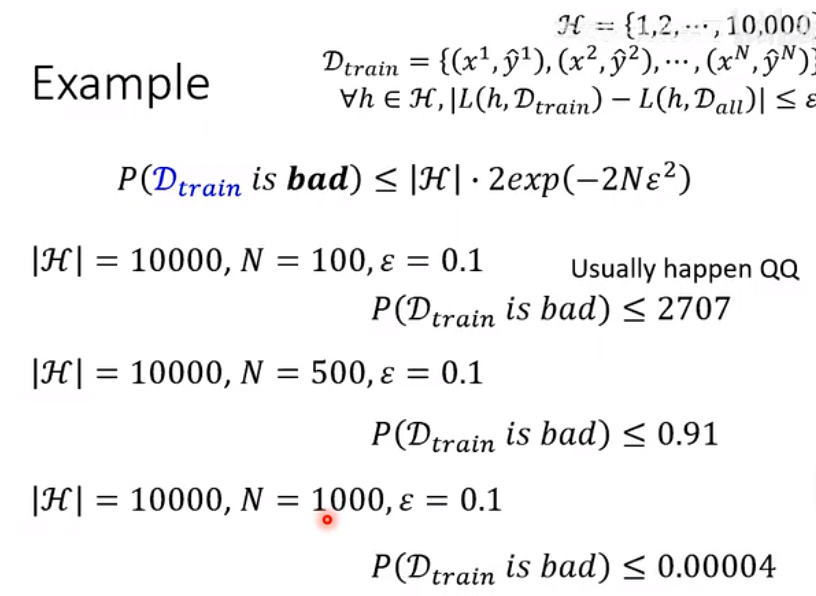
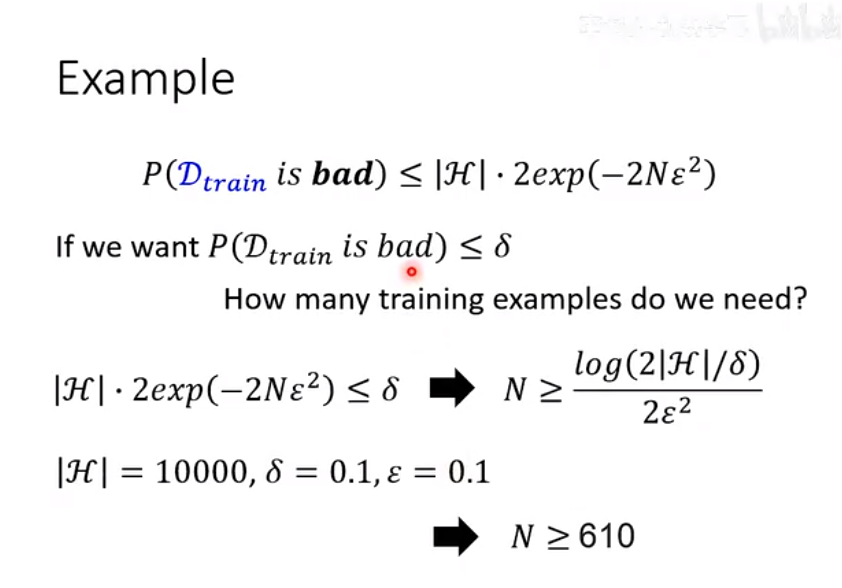
出现问题:我们说function中参数的变化是连续的,那么H(function)的数值就可以变得无限大,那么带入原来的公式就没有意义了,我们用两个方向解释:1,计算机上有一个最小的单位,不可能是连续的 2,有一个专门的vc-dimension指标用来衡量模型的复杂度
但是H可不可以尽量小呢?
不能
如下图所示,当H数量足够小,htrain和hall几乎没什么区别效果都不好(因为function 的数量太少),就算h train尽量的靠近h all,但是效果也不会好的
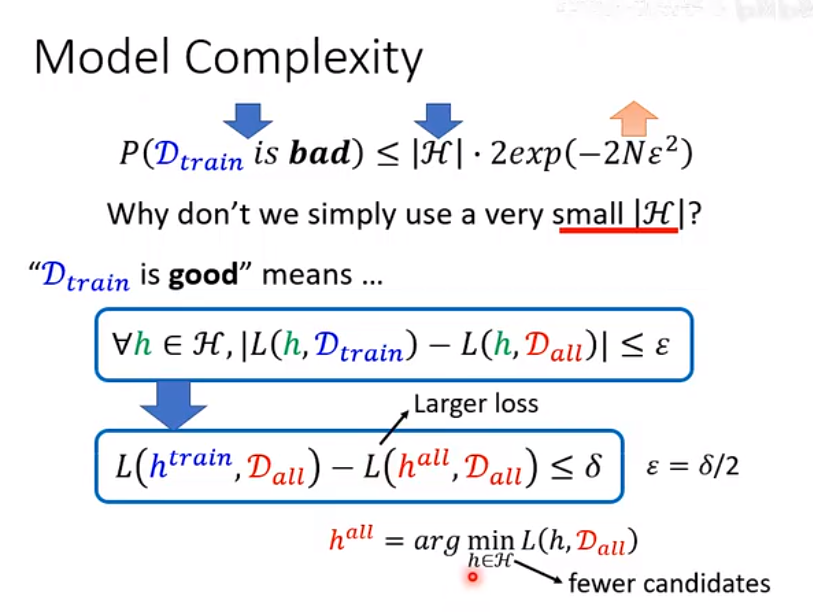
怎么样在保证h train和h all尽量接近的情况下同时不削减h all的效果呢?答:可以利用及深度学习,后面我们会详细介绍