CrossLinear:即插即用的跨相关嵌入,让线性模型也能用好外生变量
|----------|-------------------------------------------------------------------------------------------------------------|
| 论文题目 | CrossLinear: Plug-and-Play Cross-Correlation Embedding for Time Series Forecasting with Exogenous Variables |
| 作者 | Pengfei Zhou, Yunlong Liu, Junli Liang, Qi Song, Xiangyang Li |
| 机构 | 中国科学技术大学;德清阿尔法创新研究院 |
| 会议 | KDD 2025(第31届ACM知识发现与数据挖掘大会,2025年8月3--7日,多伦多) |
| 代码 | https://github.com/mumiao2000/CrossLinear |
| 关键词 | 深度学习;外生变量;时间序列预测 |
相关链接
论文原文(KDD 2025):https://doi.org/10.1145/3711896.3736899
开源代码:https://github.com/mumiao2000/CrossLinear
数据集:https://doi.org/10.5281/zenodo.15482271
讲解视频:https://space.bilibili.com/51422950?spm_id_from=333.1007.0.0
摘要
带外生变量的时间序列预测是一个关键但充满挑战的**多对一(many-to-one)**范式,传统模型难以刻画内生变量与外生变量之间独特的依赖关系,容易导致欠拟合或过拟合。
本文提出CrossLinear :一个基于线性、可即插即用的跨相关嵌入(cross-correlation embedding) 模块,它轻量地捕捉变量依赖、并无缝整合进现有神经网络。具体用一维卷积捕捉时不变的变量依赖,同时缓解欠拟合与过拟合;再配合patch嵌入与全局线性头分别捕捉短期处理与长期全局模式。在12个真实数据集上,CrossLinear在短期与长期预测中都取得优越表现,消融实验验证了跨相关嵌入的有效性,泛化研究也表明它是一个有价值的即插即用模块。
Q1:这篇论文试图解决什么问题?
核心问题是:在带外生变量的多对一预测中,如何有效建模内生变量与外生变量之间的依赖,把外生信息整合进目标变量,同时既不欠拟合也不过拟合。
多对一范式指:给定历史观测,只预测作为目标的内生变量,而历史中同时包含内生变量与多个外生变量。例如节假日会影响人们出行、交通流量又受天气影响;风电功率受风速影响;城市道路上重型车辆增多会加剧路面磨损。这类外生影响往往是预测成败的关键,但多对一建模也容易引入无效的外生变量。
作者指出现有两类思路都有明显不足:
1. **通道独立(CI):**把每个变量单独送入网络、不显式建模变量依赖,只靠嵌入层隐式捕捉,因而无法刻画外生变量与目标变量之间的跨变量相关性。
2. **通道依赖(CD):**用自注意力、交叉注意力或图卷积显式建模变量关系,结构复杂,在数据稀疏时容易过拟合,还会引入外生变量彼此之间不必要的交互、增加模型复杂度。
具体到模型:Crossformer等Transformer/CD模型并非专为多对一设计,无法区分内生与外生变量;TimeXer虽面向该范式,却需要额外引入跨注意力机制;DLinear、RLinear等简单线性模型基于CI假设、没有显式纳入外生到外生的信息,在多对一范式下表现并不好。
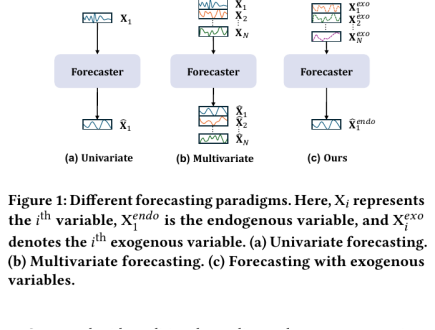
图注: 三种预测范式对比:(a)单变量预测;(b)多变量预测;(c)本文关注的带外生变量预测(Ours),历史含内生变量与多个外生变量,只预测内生变量。
Q2:有哪些相关研究?
论文围绕"通道独立还是依赖"与"外生变量预测"两条线梳理工作:
1. **通道独立还是依赖:**CD方面,Crossformer等Transformer用自注意力同时建模时间与变量依赖;TSMixer通过转置多元序列捕捉依赖,FourierGNN用超变量图做全面建模。CI方面,PatchTST通过patch提升效率,DLinear、RLinear依靠时频分解取得有竞争力的结果,而Autoformer、TimesNet在CD设定下面对变化的变量周期性存在挑战。CD理论上表达力更强,但缺乏变量依赖先验,在训练数据有限时容易过拟合。
2. **带外生变量预测:**统计模型中ARIMA的变体ARIMAX、SARIMAX通过加入回归项来增强预测;深度学习中TiDE同时建模静态与动态外生变量,但其点级依赖建模方式存在困难;TimeXer用自注意力与交叉注意力应对,但其variate-wise嵌入限制了变量依赖建模、在缺失数据下表现较差。
CrossLinear则用一维卷积捕捉依赖、适应领先-滞后(lead-lag)效应,通过保持内生与嵌入变量等长来确保对缺失数据的鲁棒,并且整个跨相关嵌入模块可以无缝集成进现有模型。
Q3:论文如何解决这个问题?
CrossLinear的总体思路是"只增强输入表示、不改网络架构":用一维卷积生成跨相关嵌入,再配合patch嵌入与线性头,主干网络保持简单线性结构。
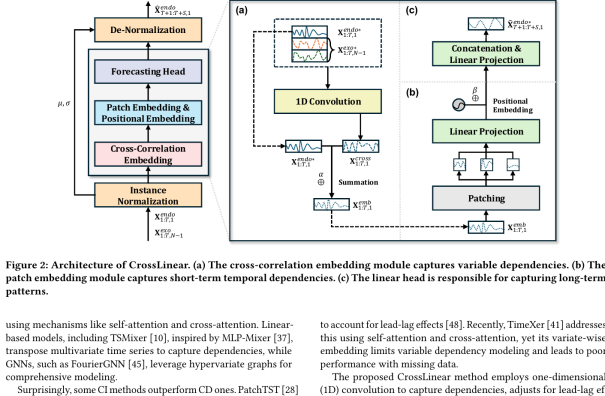
图注: CrossLinear整体架构:(a)跨相关嵌入模块用一维卷积捕捉变量依赖并以门控加权求和融合;(b)patch嵌入模块捕捉短期时间依赖;(c)线性头负责捕捉长期模式;另用RevIN做归一化与反归一化。
① 归一化与反归一化(RevIN)
为处理非平稳性,引入参数无关的RevIN实例归一化与反归一化,使输入在进入主干前分布稳定,并在输出端还原,这一做法已被TimeXer、iTransformer、RLinear等广泛采用。
② 跨相关嵌入(核心)
把内生变量与外生变量在时间维度上堆叠,用一个单层一维卷积捕捉时不变的变量依赖,得到跨相关表示X_cross;随后引入残差结构,用sigmoid门控α做加权求和融合:X_fuse = α·X_endo +(1−α)·X_cross。采用加权求和而非拼接,既保留内生变量的关键信息、又把外生依赖整合进来,单层设计在显著缓解过拟合的同时只引入极小开销。
③ patch嵌入与位置嵌入
借鉴PatchTST,对序列做patch化以捕捉短期时间依赖、并缓解变量混杂;同时引入可学习位置嵌入增强鲁棒性,按P_endo = β·Projection(P)+(1−β)·PE融合,再把各patch拼接后经线性投影,转换到d维空间。
④ 线性头
把拼接后的patch表示送入线性头(Concatenation & Linear Projection),由它负责捕捉长期模式并生成预测。
⑤ 多变量扩展与损失
扩展到多变量时,跨相关嵌入模块会针对每个内生变量分别调整,使其能处理不同的外生变量;训练中在patch嵌入、位置嵌入与预测头上采用权重共享,兼顾训练与推理效率。模型训练采用L2损失;在多变量任务中,为同时保证内生与外生变量的预测精度,损失会对内生与外生两部分同时约束。
Q4:论文做了哪些实验?
实验覆盖12个数据集:长期预测使用ECL、Weather、ETTh1、ETTh2、ETTm1、ETTm2、Traffic共7个真实世界数据集;短期预测使用EPF数据集的5个子集NP、PJM、BE、FR、DE,涵盖电力、天气、交通等多个领域。
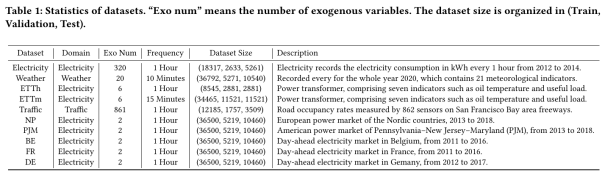
图注: 12个数据集统计:列出领域、外生变量数量(Exo Num)、采样频率、(训练/验证/测试)规模与描述;ECL与Traffic分别含320、861个外生变量,规模最大。
对比10个先进基线,包括Transformer类的TimeXer、iTransformer、PatchTST、Autoformer,线性类的SparseTSF、RLinear、DLinear、TiDE,CNN类的TimesNet与GNN类的MSGNet。长期固定回看窗口T=96、预测长度S取{96,192,336,720};短期T=168、S=24,评价指标为MSE与MAE。
主结果
在带外生变量任务中,CrossLinear在30个MSE、29个MAE场景取得第一名,整体优于最强的Transformer基线TimeXer。需要说明Weather数据集的异常值未做预处理,因此误差整体偏小。论文还观察到:CNN类的TimesNet、GNN类的MSGNet难以稳定捕捉变量依赖;两个CD模型TimeXer与iTransformer优于CI模型,但过度复杂的依赖建模会损害泛化;而遵循CI的SparseTSF、RLinear、DLinear因缺乏显式机制而表现较弱。在多变量(many-to-many)任务中,CrossLinear同样在31个MSE、28个MAE场景排名第一,仅在Traffic上因外生变量众多、iTransformer凭借更大参数容量占优。
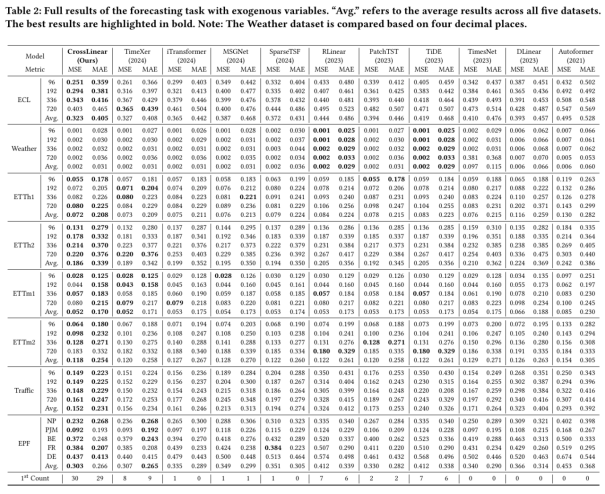
图注: 带外生变量预测的完整结果:加粗为最优;CrossLinear(Ours)在绝大多数数据集与预测长度上MSE/MAE最低,底部1st Count统计其合计30次MSE、29次MAE第一。
消融实验
为检验融合机制,设计四种整合方式对比:Endo Only(仅内生,α=1)、Cross Only(仅跨相关,α=0)、Concat(内生与跨相关拼接)以及本文的Sum(sigmoid门控加权求和)。结果显示Sum在所有评价指标上均优于其他三种;Concat虽保留全部原始信息,却会因维度增加引入额外复杂度。这说明把内生与外生变量一视同仁反而不利于学习,门控加权求和能让模型自适应平衡两类信息,在样本有限时尤为有效。
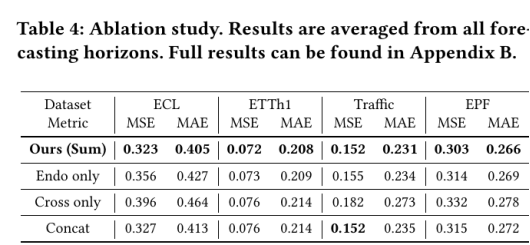
图注: 融合方式消融(跨所有预测长度平均):Ours(Sum)在ECL、ETTh1、Traffic、EPF上的MSE/MAE均低于Endo only、Cross only与Concat。
泛化能力:即插即用
跨相关嵌入集成复杂度低,可在不做重大修改的情况下加到现有预测模型上。论文把它分别加入SparseTSF、RLinear、PatchTST、DLinear、Autoformer五个主干,结果全部取得性能提升:加到SparseTSF时,MSE在ECL、ETTh1、Traffic、EPF上分别降低5.9%、1.3%、5.2%、2.8%;加到RLinear时降幅更大,分别为8.6%、4.8%、27.8%、15.5%,其中Traffic数据集误差降低27.8%最为显著,印证了模块在处理外生变量与目标复杂关系上的作用。
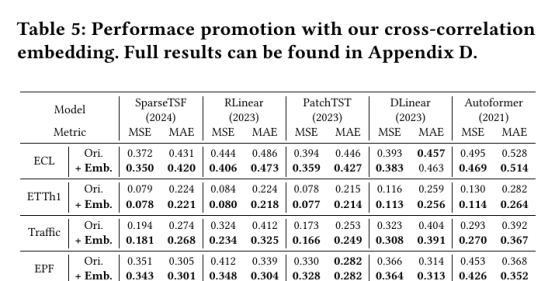
图注: 跨相关嵌入的即插即用效果:Ori为原始结果、+Emb为加嵌入后结果,五个主干在ECL/ETTh1/Traffic/EPF上MSE与MAE几乎全部下降。
缺失值实验
论文模拟缺失场景,分别对内生或外生变量随机mask,并用零或正态分布N(0,1)随机值替换。一个有趣发现是:Traffic数据集上随机mask掉一定数量外生变量反而略微提升性能,类似一种数据增强;而ETTh1因外生变量仅6个、mask外生的影响很小。整体上,即使内生数据全部缺失,模型仍能通过跨相关嵌入利用外生变量信息、把误差控制在可管理范围;但当外生变量全部缺失时性能显著下降,凸显了外生变量集成对精确预测的关键作用。
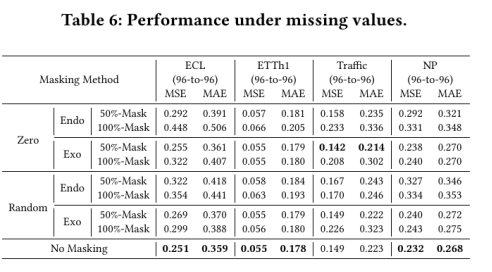
图注: 缺失值下的表现:Zero/Random两种替换、Endo/Exo两类mask;外生全部缺失(Exo 100%-Mask)时MSE/MAE上升最明显。
超参数敏感性
论文考察回看窗口T以及门控系数α、β三个超参数。研究发现更大的回看窗口并不必然带来更好结果,但外生变量较多的数据集往往更能从大窗口中受益,这与"久远历史对当前预测帮助有限"的经验一致;此外α、β在初始取值更接近1时表现更好,因为较大的初始α、β会在训练早期优先保留内生变量,从而带来更稳定的优化过程与更好的收敛。
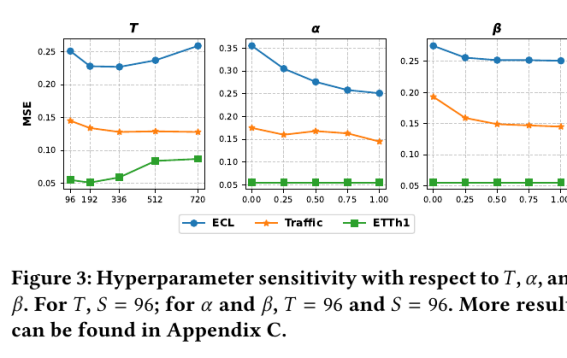
图注: 超参数敏感性:T、α、β三组曲线(ECL、Traffic、ETTh1);模型对α、β在较大范围内整体平稳,T需结合外生变量数量选择。
变量相关分析与效率
CrossLinear用一维卷积权重作为变量依赖的指示器,在多变量预测中把权重矩阵MatWeight沿最后一维聚合可视化:蓝色区域表示正依赖、红色表示负依赖、颜色深浅表示强弱。例如实际气压(VPact)与气压(p)正相关,最大风速(max.wv)与短波向下辐射(SWDR)负相关,而风向(wd)与露点温度(Tdew)没有显著关系,这些发现与现有研究一致、也验证了模型识别变量级依赖的能力。效率方面,跨相关嵌入复杂度为O(T)、patch嵌入为O(T/p)、整体仍为O(T);相比TimeXer、PatchTST的O((T/p)²)与Autoformer的O(T log T),CrossLinear在更短训练时间内取得更高精度,每次迭代耗时明显更低。
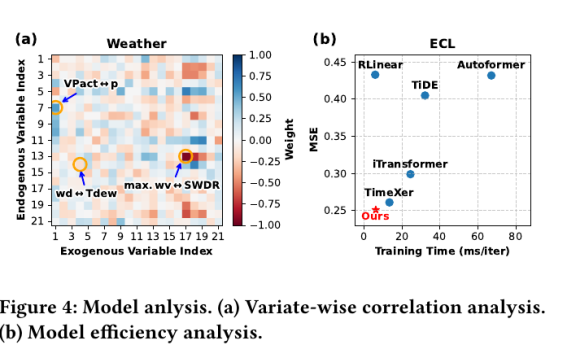
图注: (a)Weather变量相关权重热力图(蓝正红负);(b)ECL上模型效率对比,CrossLinear(Ours,红星)位于左下角,训练时间短、MSE低。
Q5:有什么可以进一步探索的点?
论文在结论中给出了方向,也可结合方法与实验进一步延伸:
**1.**把跨相关嵌入用于时间序列预测以外的任务,如异常检测、分类等,检验其跨任务适用性;
**2.**把扩散模型(diffusion models)集成进当前框架,探索生成式建模带来的增益;
**3.**将即插即用模块推广到金融、气象等外生变量更密集的领域与更多主干网络;
**4.**显式建模外生变量的领先-滞后(lead-lag)关系,并研究卷积核大小与多尺度依赖的自适应选择。
Q6:总结一下论文的主要内容
CrossLinear针对带外生变量的多对一预测 中内生与外生依赖难以刻画、容易欠拟合或过拟合的问题,提出一个即插即用的跨相关嵌入模块 :用单层一维卷积轻量捕捉时不变变量依赖,以sigmoid门控加权求和把外生信息整合进内生变量,再配合patch嵌入捕捉短期模式、线性头捕捉长期模式,并以RevIN处理非平稳。
在12个短期与长期数据集上,CrossLinear在带外生任务中30个MSE、29个MAE第一,多变量任务31个MSE、28个MAE第一,还能一致增强SparseTSF、RLinear、PatchTST、DLinear、Autoformer五类主流模型,且整体复杂度仅O(T)。它给出的核心启示是:在外生变量显著但建模困难的场景,不必堆叠复杂的跨注意力,一个轻量、可门控融合的卷积嵌入就能把外生信息有效用好。