文章目录
内容补充
常见的神经网络输入:向量、矩阵/张亮、序列
常见的神经网络输出:回归、分类、生成
矩阵分解
矩阵分解的主要目的
- 简化计算:将大矩阵转化为小矩阵,降低计算复杂度和存储空间需求5。
- 揭示数据结构:通过分解,可以提取数据中隐藏的特征或规律(即"隐因子")5。
- 数据降维与压缩:保留数据中最核心的信息,剔除冗余或噪声6。
- 提高数值稳定性:某些分解方法在计算机求解时能减少误差的累积。
常见的矩阵分解方法
矩阵分解有多种形式,针对不同的需求有不同的算法:
- LU分解(三角分解):将方阵分解为一个下三角矩阵和一个上三角矩阵。主要用于简化线性方程组的求解、计算行列式或求逆矩阵。
- QR分解:将矩阵分解为一个正交矩阵和一个上三角矩阵。常用于求解线性最小二乘问题。
- 奇异值分解(SVD):一种极其可靠且通用的分解法,将任意矩阵分解为两个正交矩阵和一个对角矩阵的乘积。它在数据降维(如主成分分析PCA)、图像压缩、推荐系统和信号处理中有着极其广泛的应用6。
- 非负矩阵分解(NMF):要求分解后的矩阵元素均为非负数。常用于文本挖掘和图像处理,能发现数据的局部特征,结果具有较好的可解释性。
具体应用举例
1. 推荐系统中的电影评分预测
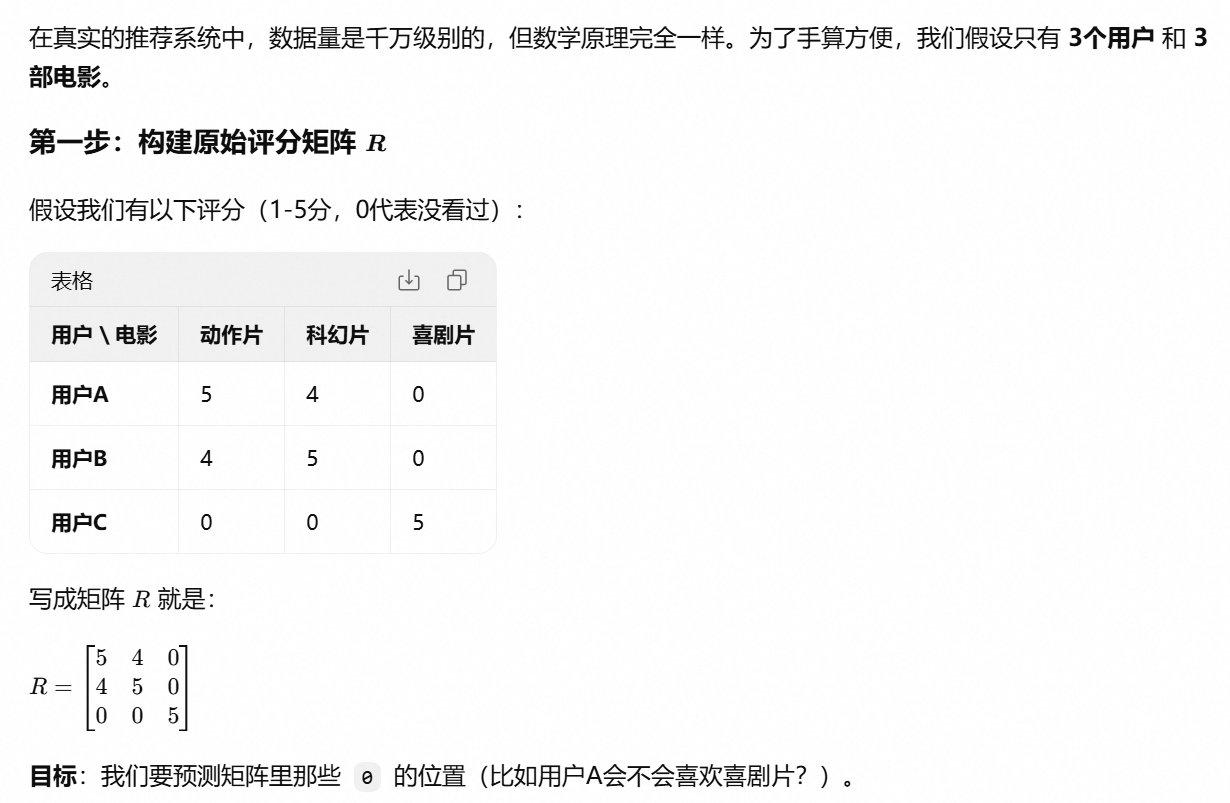
在视频或电商平台的推荐系统中,通常会构建一个庞大的"用户-电影评分矩阵",其中行代表用户,列代表电影,单元格是用户的打分。由于用户看过的电影有限,这个矩阵中会存在大量空白(未评分项)5。
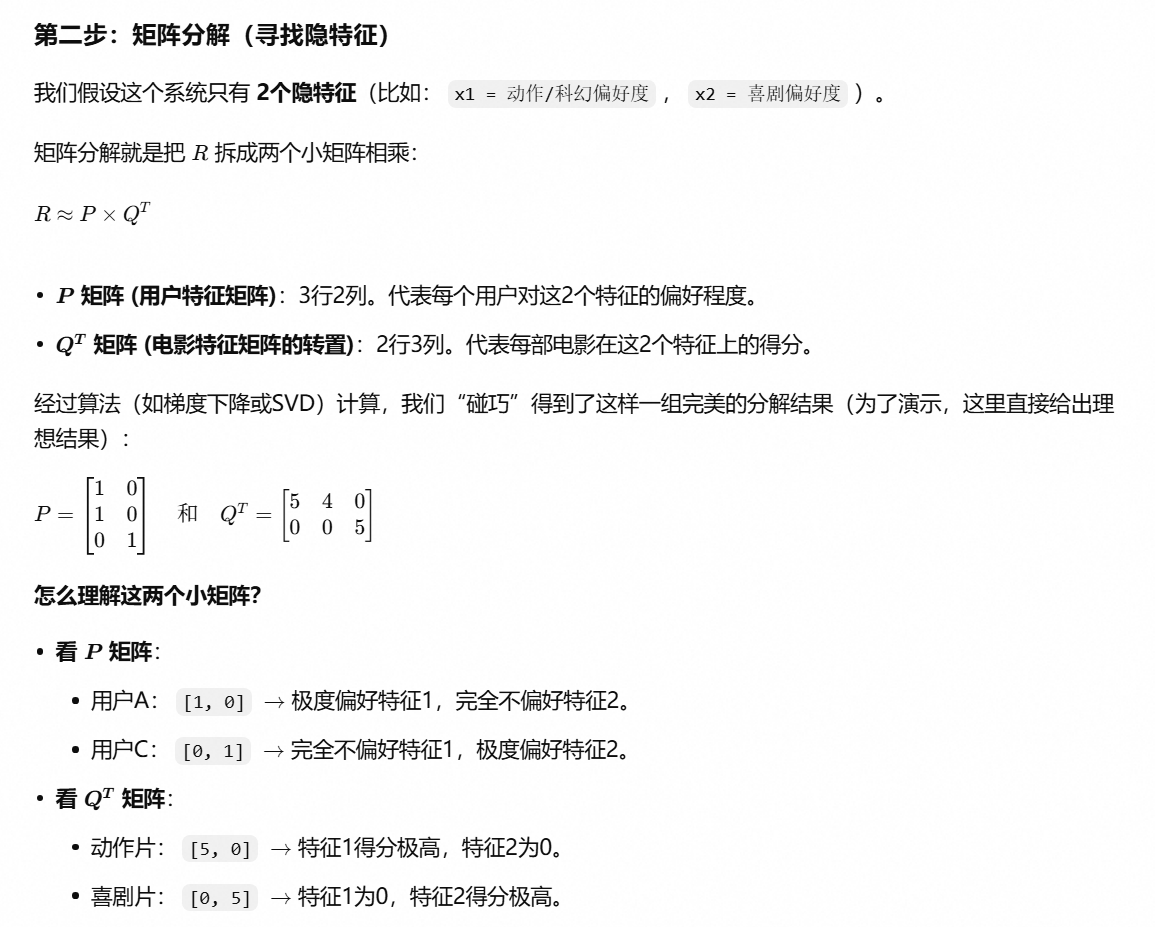
- 分解过程:利用矩阵分解,可以将这个大矩阵拆解为两个低秩的小矩阵:一个是"用户-隐特征矩阵",另一个是"电影-隐特征矩阵"5。这里的"隐特征"是算法自动提炼出的隐藏属性,比如"偏爱动作片程度"或"怀旧程度"5。
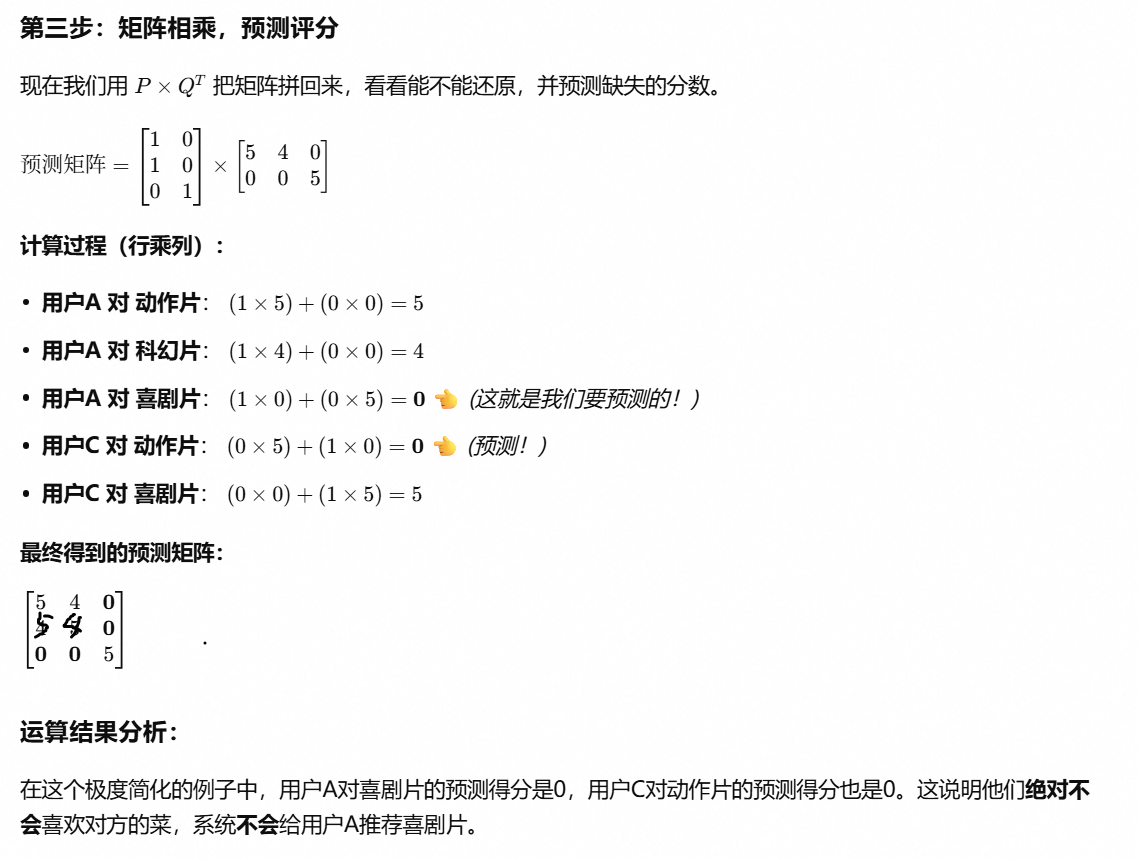
- 应用结果:通过将用户向量与电影向量相乘,系统可以预测出用户对那些尚未看过的电影的评分。剔除已看影片后,将预测分数最高的几部电影推荐给用户,从而实现个性化推荐5。
2. 图像压缩与降噪
图片在计算机中本质上也是由像素值组成的矩阵46。
- 分解过程:对图像矩阵进行奇异值分解(SVD)后,会得到一个包含特征大小(奇异值)的对角矩阵。这些奇异值从左到右依次减小,代表了图像中信息的重要性46。
- 应用结果:我们只需保留前几十个最大的奇异值及其对应的向量,就可以重构出原图像。例如,一张原本包含777个特征值的图片,仅保留前50个特征值进行重构,虽然丢失了部分细节,但依然能保持极高的清晰度,且存储数据量可能缩减至原来的12%左右,从而实现高效的图像压缩4。此外,因为图像噪声通常对应较小的奇异值,丢弃这些小值还能达到一定的降噪效果6。
SVD的解释
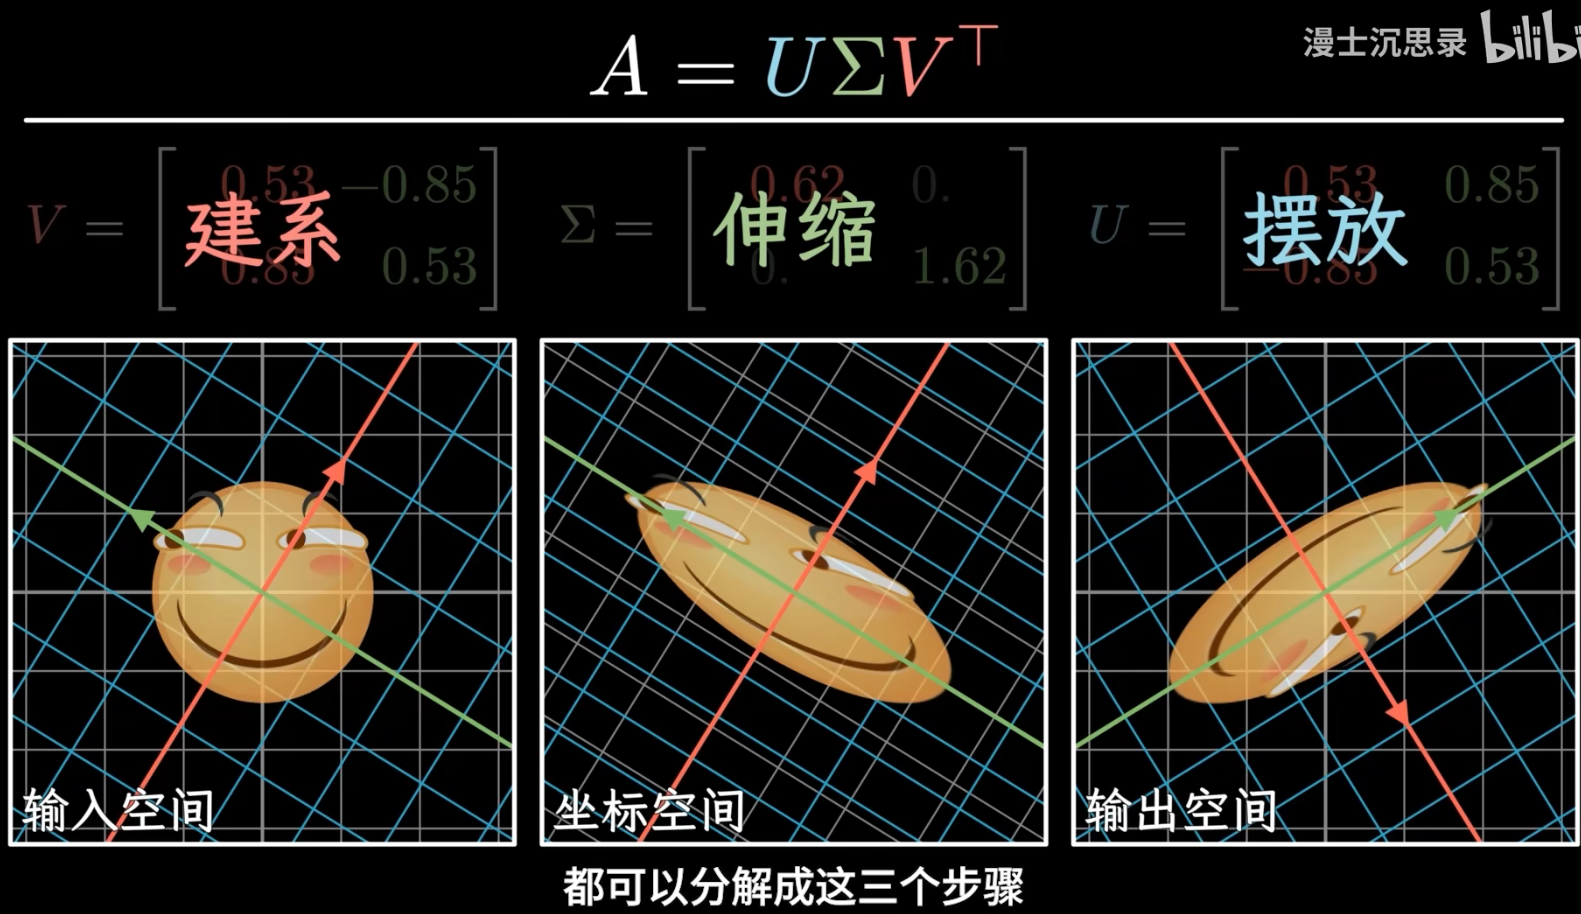
SVD的几何意义:https://zhuanlan.zhihu.com/p/55840836
一个矩阵稍微进行一点点的变换,就会导致矩阵秩的变换,理论上映射是可逆的,这个矩阵其和原来相差无几,如果真的求逆就会发生非常病态的行为,它将会变得非常离谱。
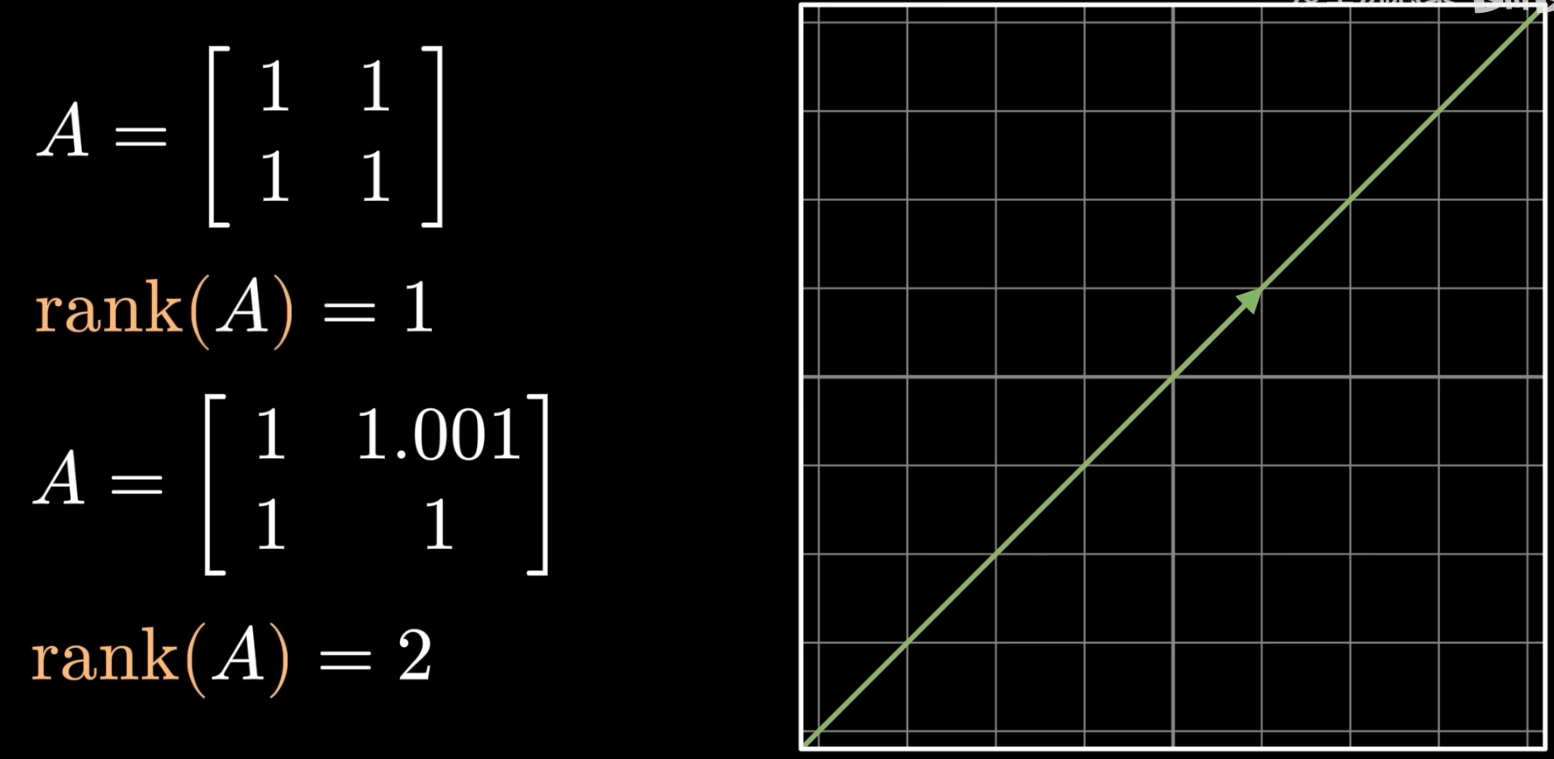
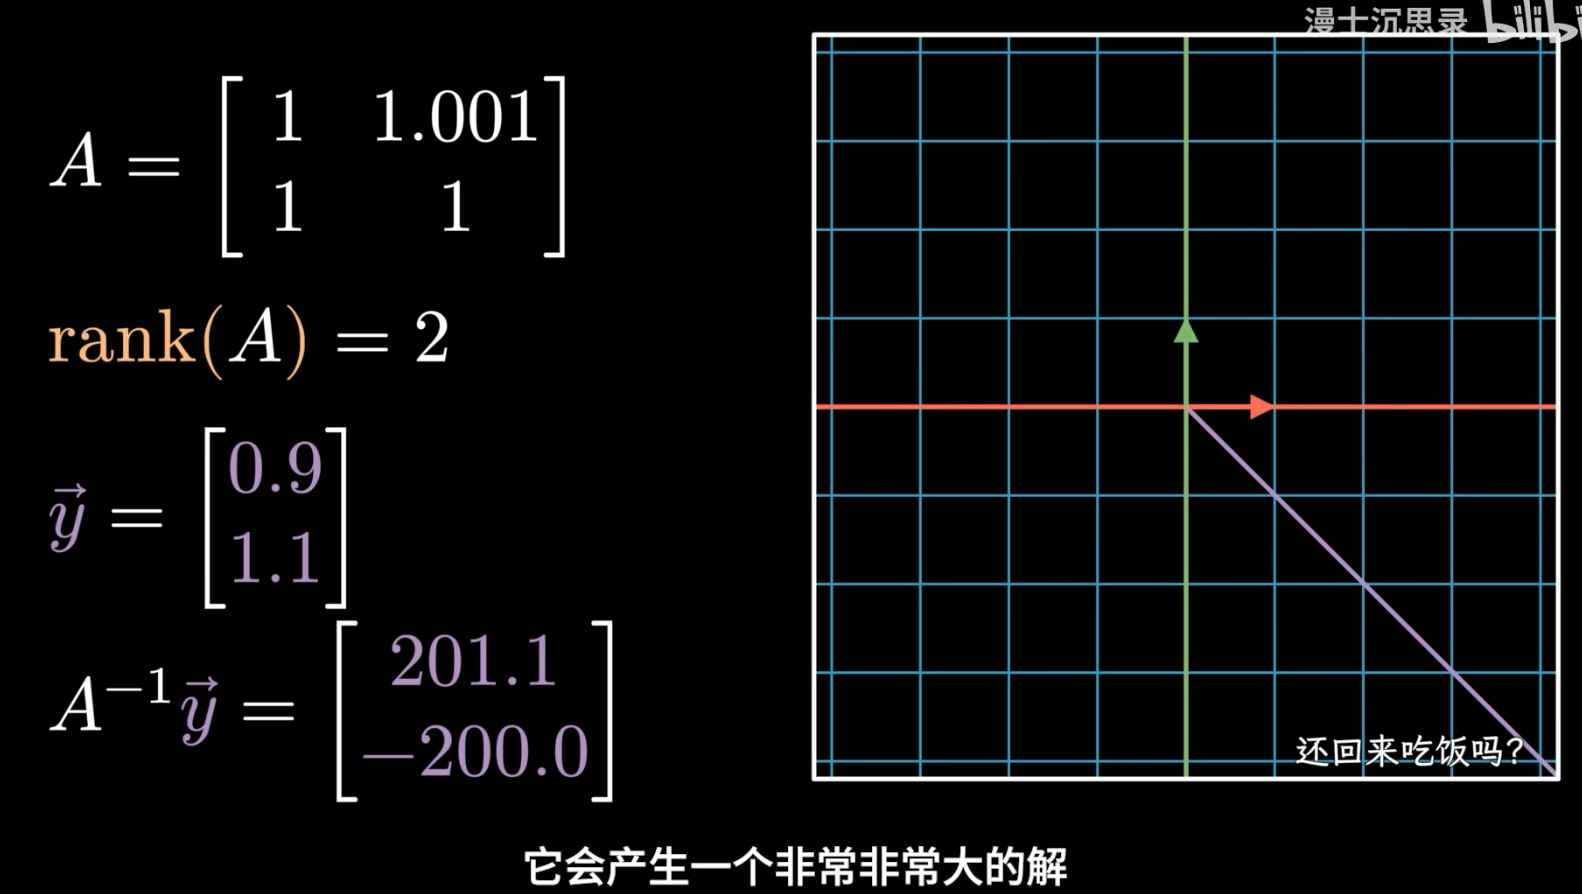
在很多方向上数据被压缩的很严重,奇异值就是用来检验这个的,下面这个就是意味着他是一个不可逆的矩阵。
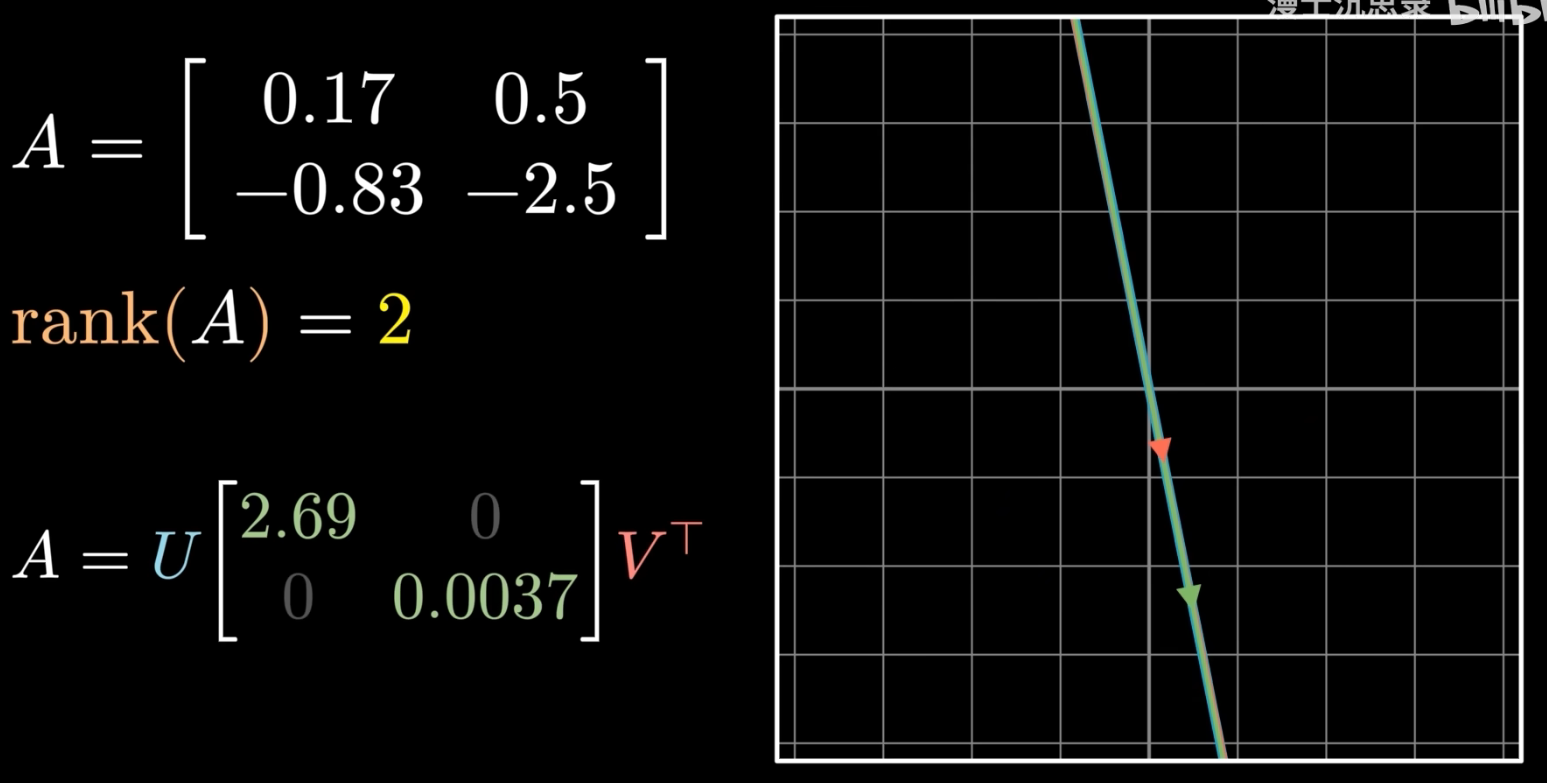
在机器学习和工程应用中,经常会去分析一个矩阵的奇异值,把它由大到小排成一排构成的数列,就叫做矩阵的谱,它矩阵的秩近乎等于2.
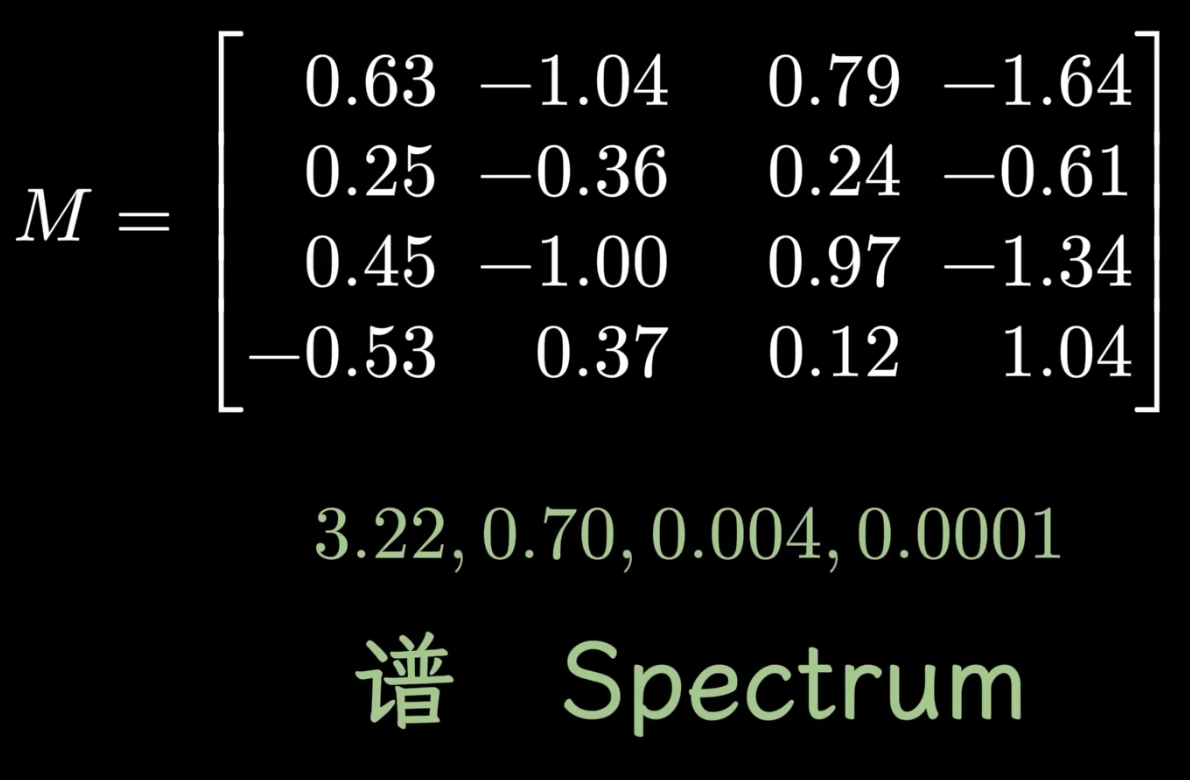
谱的意义(奇异值分解的作用)
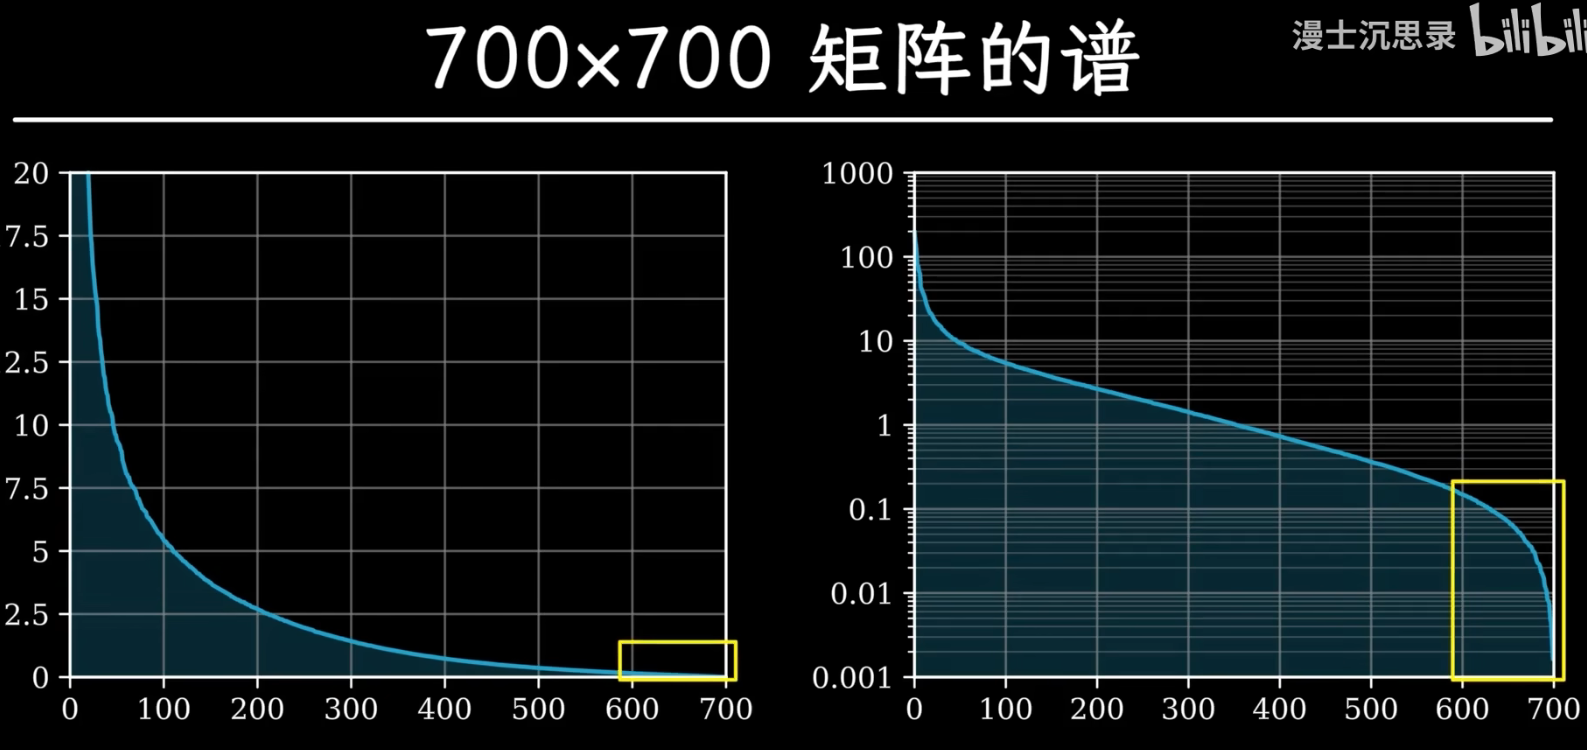
谱的尾巴上有一些很小的奇异值,虽然不是0,但也很接近0。在这些奇异值对应的坐标轴vi上,几乎可以认为矩阵就是彻底把空间压平了,把坐标乘以了0。
数据压缩
把复杂的矩阵拆解为一层层的,从主要部分到次要部分的信息叠加,基于这一点就可以轻松的完成数据压缩。
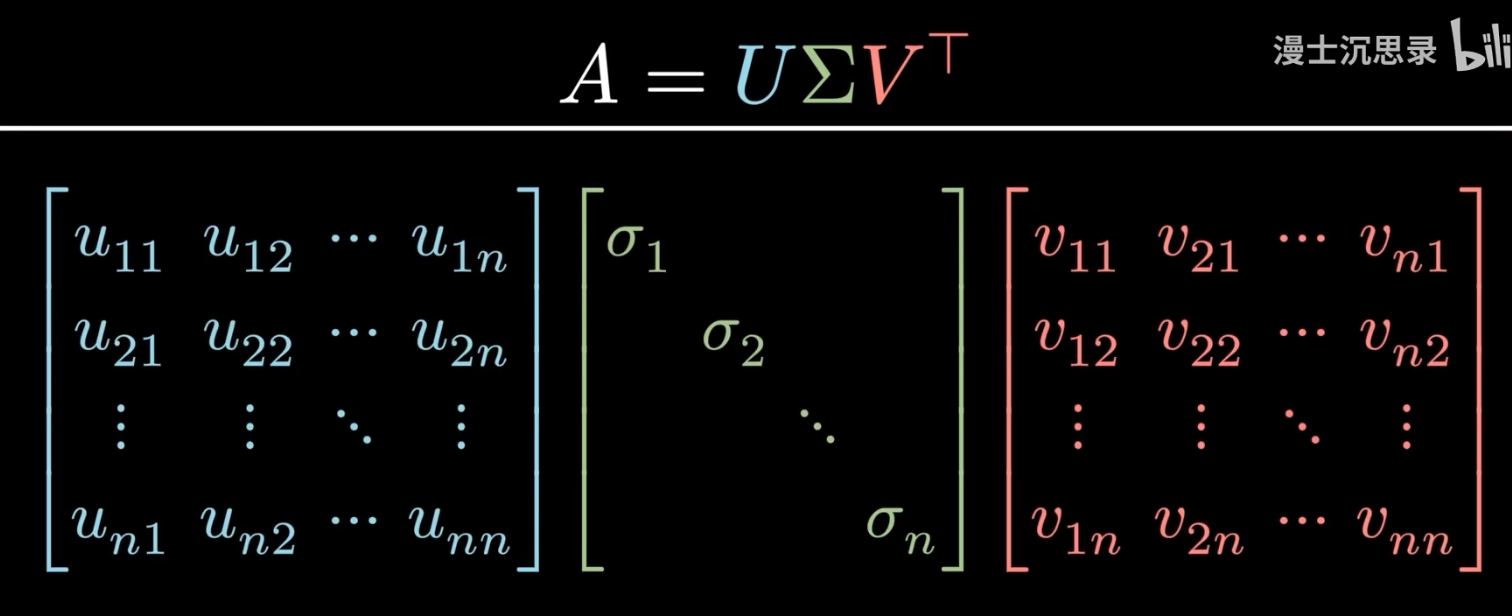
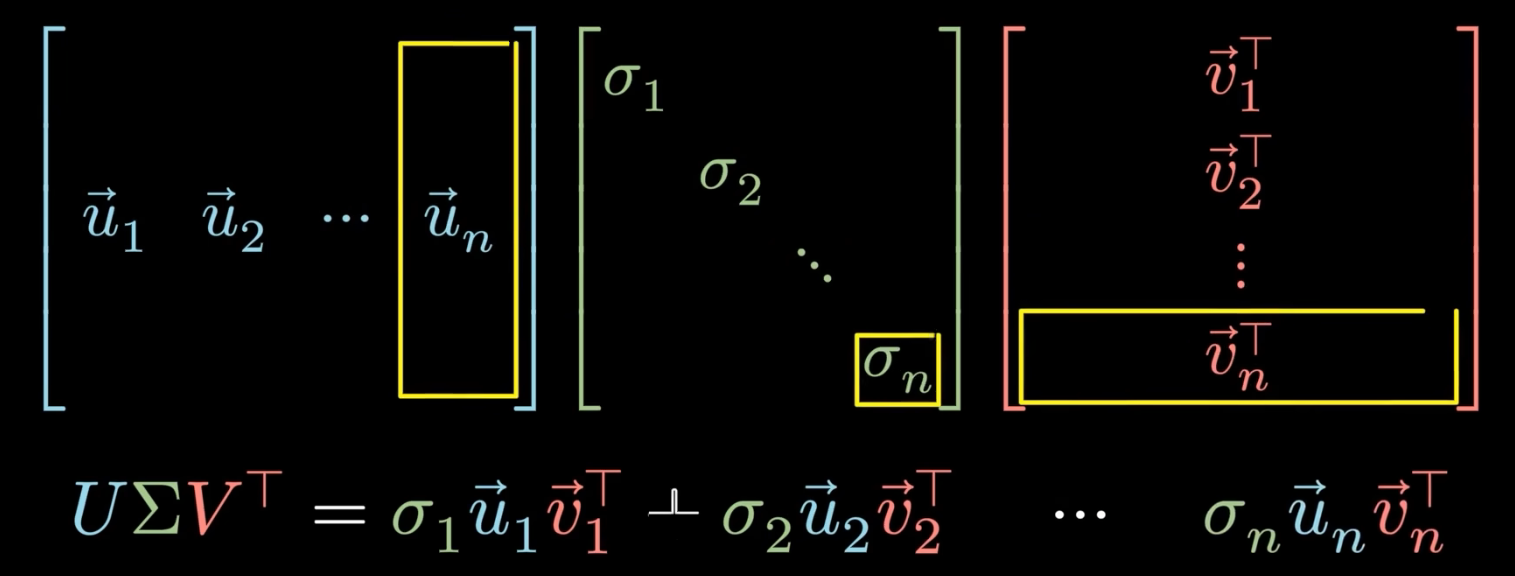
这样就把一个大的矩阵像洋葱一样一层一层拨开,分为切片,根据奇异值就可以看到一个矩阵作用时的主次之分,从大到小排序,前面就包含了这个矩阵的主要信息,而后面的就是就是奇异值比较小,甚至时噪音
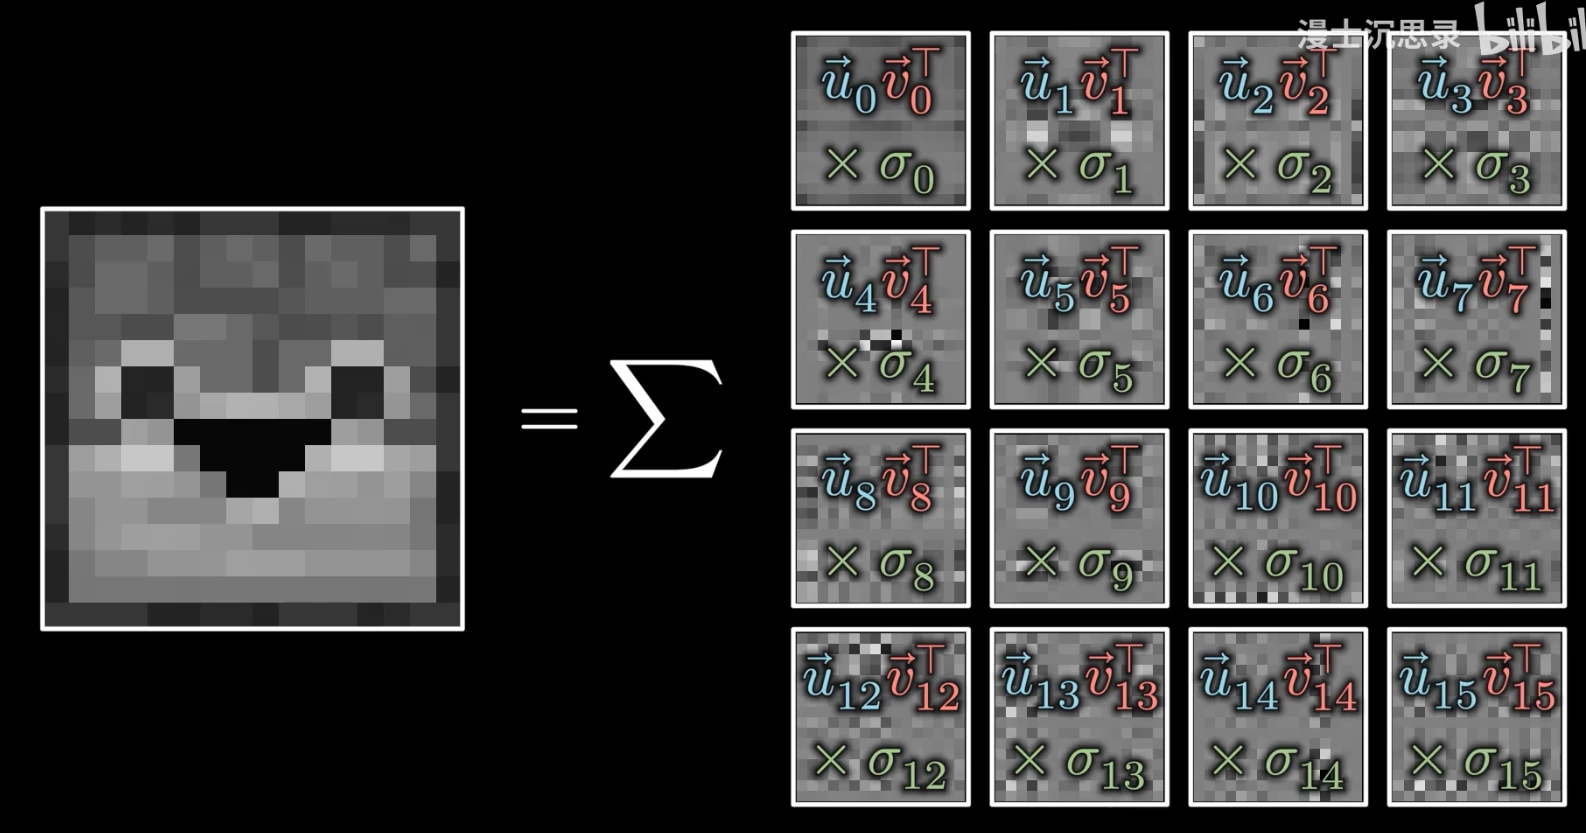
当一个图片被放大,看到类似马赛克一样的东西,那就是奇异值分解下的过分压缩。
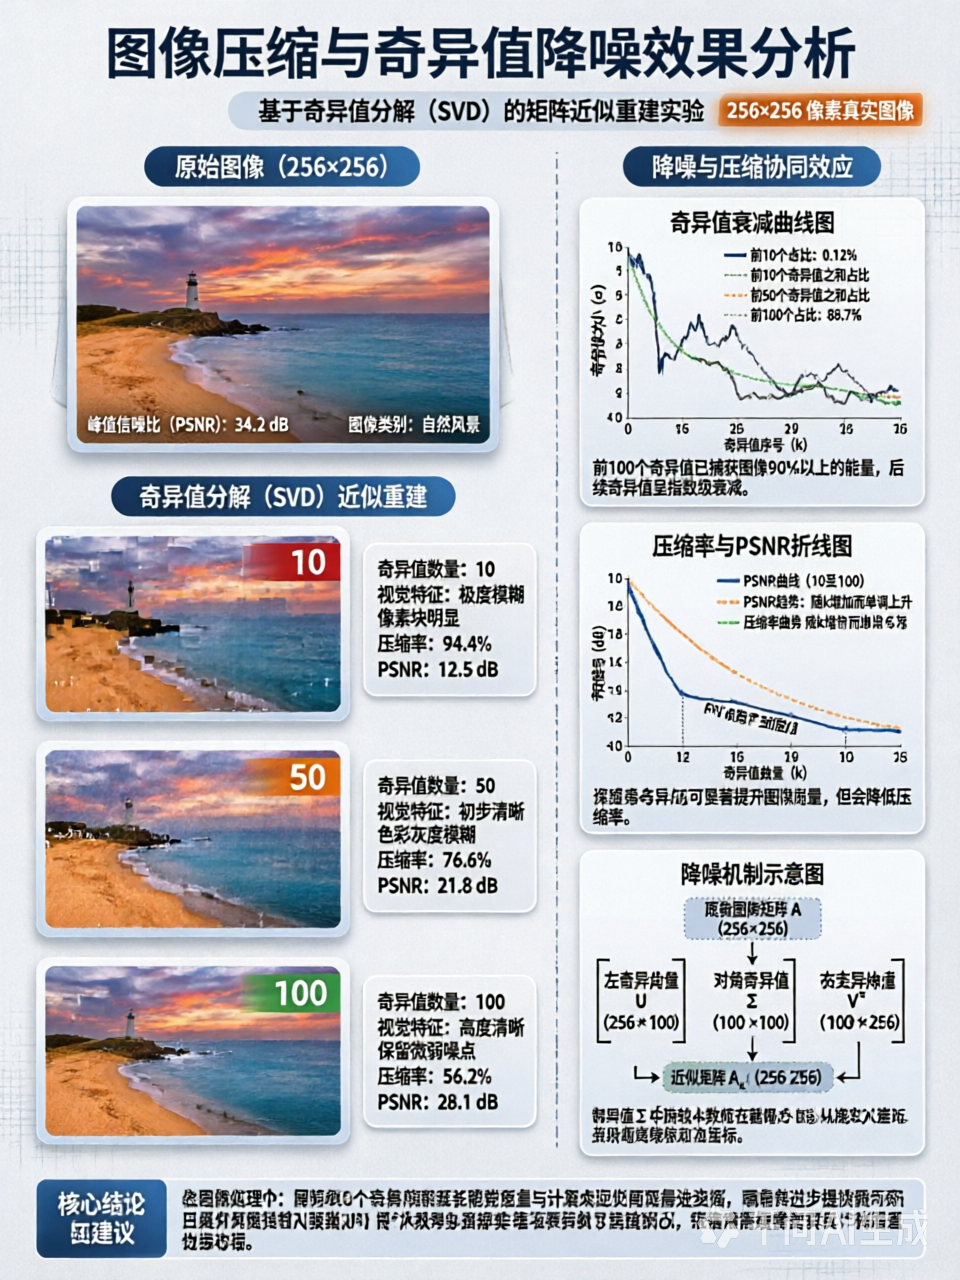
低秩近似/数据压缩:矩阵本身的维度(行数和列数)并没有改变,我们只是用一个"秩更低的矩阵"去近似原矩阵。比如一个 256×256 的图片矩阵,经过 SVD 截断后,仍然是 256×256,但它的"有效信息量"(秩)变小了。
矩阵求导
https://zhuanlan.zhihu.com/p/263777564
https://zhuanlan.zhihu.com/p/273729929
最小二乘法是线性回归的基础,而线性回归又是几乎所有机器学习算法的起点。在深度学习中,均方误差(MSE)损失函数本质上就是最小二乘准则。
坐标变换与矩阵变换
| 维度 | 矩阵变换(线性变换) | 坐标变换(基变换) |
|---|---|---|
| 坐标系 | 不动 | 在动 |
| 点/向量 | 在动(物理位置改变) | 不动(只是描述方式改变) |
| 本质 | 把点从一个位置映射到另一个位置 | 换一种语言描述同一个点 |
| 类比 | 把人从北京搬到上海 | 人还在北京,但你从"中文描述"切换到"英文描述" |
用公式看清楚
假设有一个向量 𝑣 ,在标准基下的坐标是 𝑥 ,在新基下的坐标是 𝑥′,过渡矩阵(基变换矩阵)是 𝑃 。
坐标变换(被动视角)
𝑥=𝑃𝑥′ 或 𝑥′=𝑃−1𝑥。向量本身没动,只是换了个坐标系来描述它。
线性变换(主动视角)
𝑦=𝐴𝑥向量从 𝑥 变成了 𝑦 ,坐标系没动,但向量的物理位置变了。