(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群 ,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:HunyuanOCR-1.5: Making Lightweight OCR VLMs Faster and Better
论文作者:中国科学院信息工程研究所、腾讯混元、南开大学
发表时间:2026年7月6日
目录
本文要点
(1)HunyuanOCR-1.5是中科院信工所、腾讯混元和南开2026年7月发布的1B端到端OCR模型,现行论文为9月17日的v3。
(2)vLLM单请求整页平均延迟从3.032秒降到1.408 秒,加速比2.14× ,对照组里最快。
(3)骨架沿用1.0,分辨率提到4K、上下文提到128K,解码加速靠约90.7M参数的DFlash块扩散草稿。
(4)OmniDocBench v1.6端到端组94.74,总榜已被PaddleOCR-VL-1.6和后来的OvisOCR2超过。CHAOS-Bench页均召回14.15,绝对值仍低。
(5)文末附官方模型卡的Transformers、vLLM、DFlash服务和llama.cpp命令。
中科院信工所、腾讯混元和南开大学在2026年7月6日放出HunyuanOCR-1.5的技术报告。我把报告、GitHub README和Hugging Face模型卡对了一遍,现行版本是9月17日的v3。
端到端OCR慢在解码。密文档、表格、公式要吐很长一段结构化文本。报告没重做骨干,输入抬到4K和128K,解码靠DFlash。vLLM单请求从3.032秒降到1.408 秒,吞吐从466.9 token/s升到1002.3 token/s,加速比2.14×。Transformers朴素对照是6.37×,线上更该看vLLM。
一、Hunyuan-ViT升到4K与128K上下文
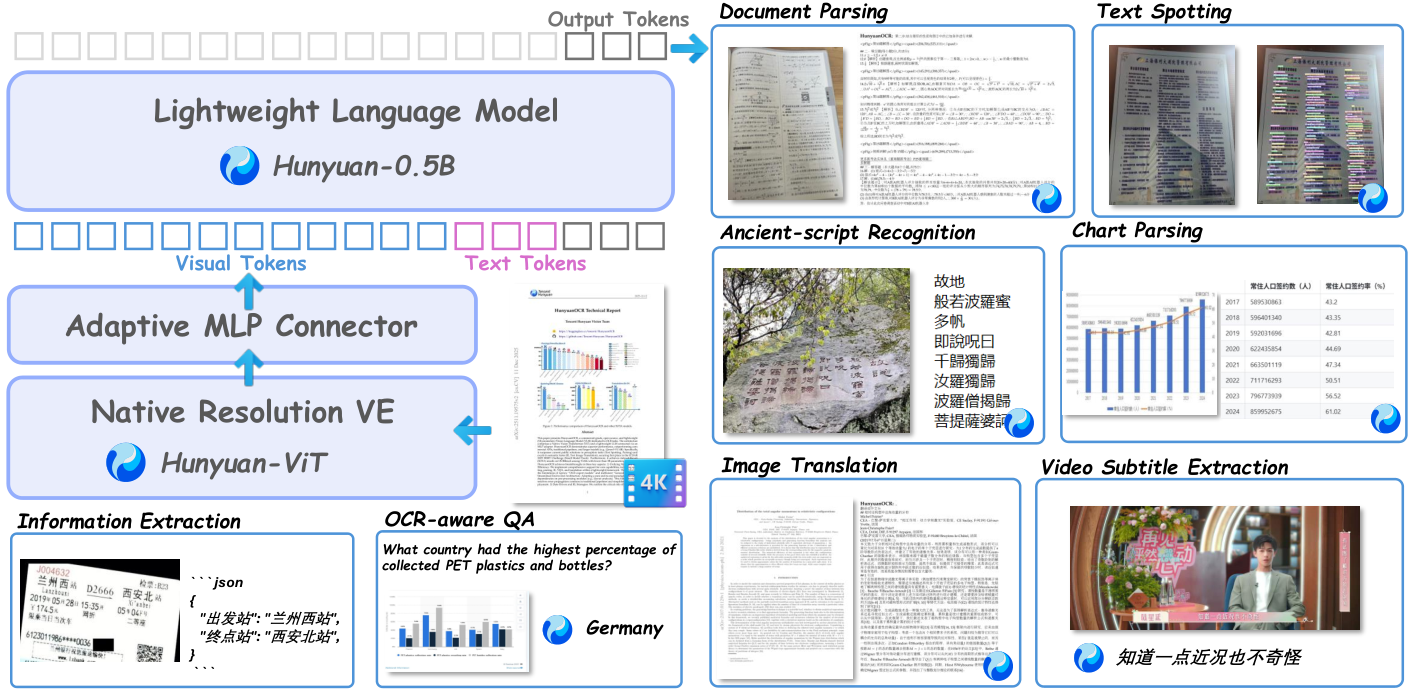
HunyuanOCR-1.0已经验证过这条轻量端到端路线,1.5沿用同一套三件套。最底下是原生分辨率视觉编码器Hunyuan-ViT,中间是自适应MLP连接器,上面是带XD-RoPE的Hunyuan-0.5B语言模型。评测表里整模按1B计。
1.5在骨干上几乎只动了一处。视觉输入上限从2K提到4K ,上下文窗口提到128K。高分辨率用来保住密排文档、超大表和复杂图的细节,长窗口用来接多页、多图和长结构化输出。
连接器把高分辨率特征压成更短的视觉token,输出直接是Markdown、HTML表格或LaTeX公式,没有任务专用后处理。宽高比按原图走。XD-RoPE按文本、高、宽、时间四个维度编位置,多图和视频字幕靠这一项接进同一套语言器。
二、DFlash用块扩散一次起草16个token
端到端OCR的延迟,大头在自回归解码。投机解码让小草稿模型先猜一段候选,目标模型一次核对,接受最长合法前缀,输出分布不变。
很多投机方法的草稿仍是逐token写的,候选越长草稿越贵。DFlash换成块扩散,一次前向吐出整块B=16,目标模型并行验证。
训练时目标模型冻结,只优化草稿。每条序列先跑一遍目标模型缓存隐状态,再随机抽K=16个锚点,K块拼在一次前向里训,注意力用FlexAttention的块对角掩码。
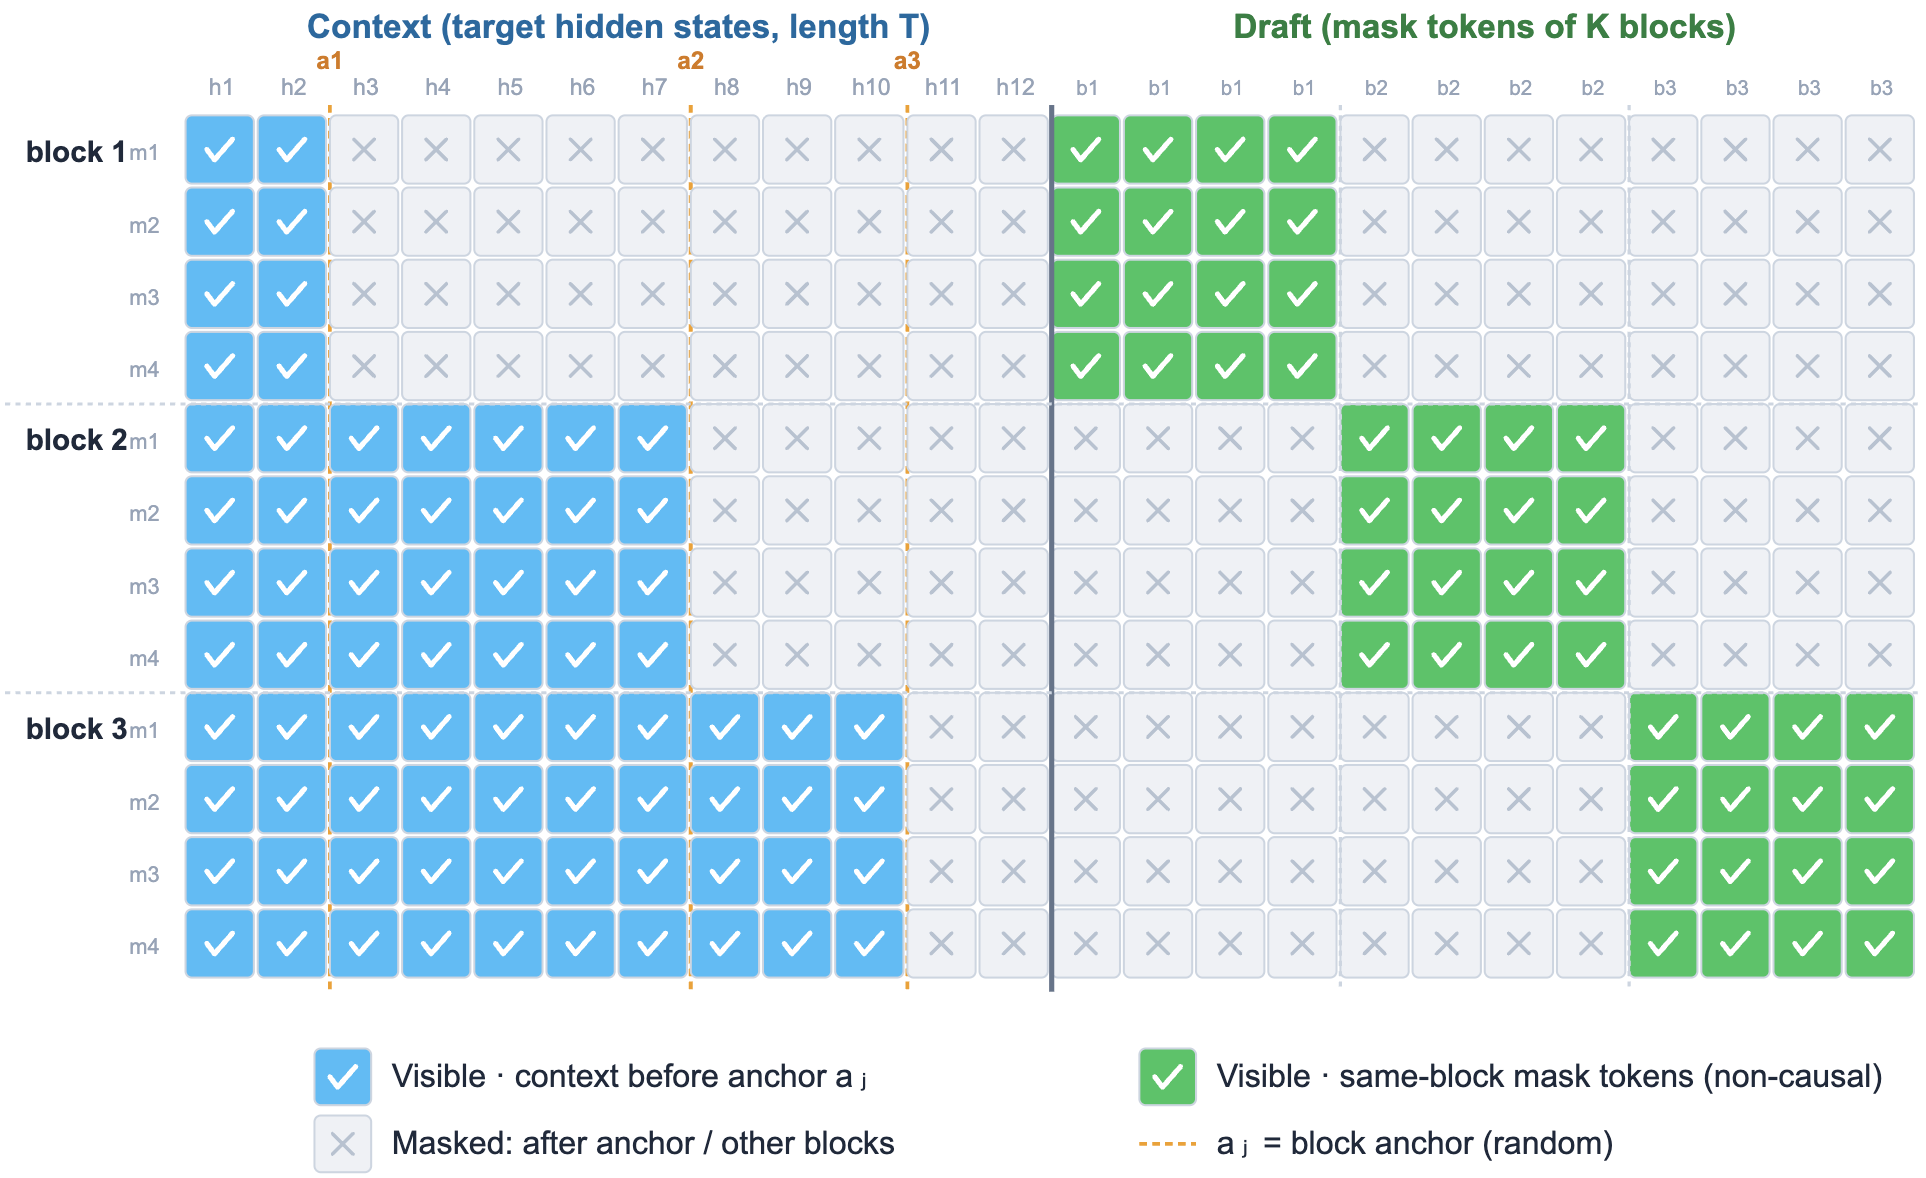
每个block只看见锚点 a j a_j aj之前的目标隐状态和自己块内的mask token,块与块之间切断,所以K个起草任务可以并行。草稿大约90.7M 参数,5层Transformer,从目标模型最后5层解码器初始化。损失是带位置权重的下一词交叉熵,锚点本身不计入, γ = 7.0 \gamma=7.0 γ=7.0,远处token权重更低。
单请求或低并发时,目标模型的自回归往往卡在显存带宽上,算力有一截闲着。DFlash拿这截闲算力一次写出16个草稿token,目标模型一次核对就能往前走好几个位置。HTML表格、公式、结构化Markdown局部规律强,接受前缀往往更长。
三、vLLM上整页1.408秒,表格页加速最大
速度测在OmniDocBench上,batch size为1。vLLM数字按930条样本的SOTA速度对照来报。双阶段系统报的是整页流水线延迟,含版面分析、区域识别和结果合并。各家分词器和输出格式不同,跨模型token/s不好比,主要看页延迟和页吞吐。
| 系统 | 路线 | 解码 | 平均延迟(秒/页) | 页/秒 | 相对Hunyuan AR |
|---|---|---|---|---|---|
| dots.ocr | 端到端 | 自回归 | 7.154 | 0.136 | 0.41× |
| DeepSeek-OCR 2 | 端到端 | 自回归 | 5.460 | 0.179 | 0.54× |
| Unlimited-OCR | 端到端 | 自回归 | 3.659 | 0.255 | 0.77× |
| HunyuanOCR-1.5 | 端到端 | 自回归 | 3.032 | 0.330 | 1.00× |
| PaddleOCR-VL-1.6 | 双阶段 | 级联 | 1.744 | 0.562 | 1.71× |
| GLM-OCR | 双阶段 | 级联 | 1.649 | 0.604 | 1.83× |
| HunyuanOCR-1.5 | 端到端 | DFlash | 1.408 | 0.706 | 2.14× |
没开DFlash时,1.5的vLLM自回归比PaddleOCR-VL-1.6的1.744秒和GLM-OCR的1.649秒都慢。打开之后才反超,大约比GLM-OCR快1.17倍,比PaddleOCR-VL-1.6快1.24倍,比dots.ocr快5.08倍。端到端要在延迟上追上流水线,靠的就是这一步。
Transformers从34.850秒降到5.474秒,加速比6.37×,有效接受长度8.89。vLLM有效接受长度8.36,一次写16个位置,实际接受大约八到九个。
输出越长加速比越高。vLLM上0到256 token只有1.31×,2048以上到2.30×。短输出的时间多半耗在预填充和固定开销上,投机解码摊不平。
按OmniDocBench版面标注分成文本、公式、表格三类,表格页加速最大。vLLM上表格页2.39×、有效接受长度10.45,公式页2.06×,文本页1.81×。Transformers上表格页到7.81×。HTML表标签规律太强,草稿更容易猜中下一截。
并发从1到32,加速比一直高于1.8×,并发4时到2.26×,并发32仍有1.80×。GPU打满后闲算力变少,草稿那次并行前向就不那么划算。
四、OmniDocBench端到端94.74,总榜已经不是第一
文档解析看OmniDocBench v1.6。HunyuanOCR-1.5总分94.74,在报告自己的端到端专家组里最高,1.0是92.03,Unlimited-OCR是93.92。
| 模型 | 参数 | Overall↑ | 文本Edit↓ | 公式CDM↑ | 表格TEDS↑ | 顺序Edit↓ |
|---|---|---|---|---|---|---|
| HunyuanOCR | 1B | 92.03 | 0.048 | 88.60 | 92.37 | 0.138 |
| Unlimited-OCR | 3B-A0.5B | 93.92 | 0.042 | 95.79 | 90.16 | 0.129 |
| HunyuanOCR-1.5 | 1B | 94.74 | 0.039 | 94.50 | 93.67 | 0.129 |
公式CDM 94.50,没过Unlimited-OCR的95.79。报告说自家倾向用begin/end一次写完多行公式,现行匹配会先拆成单行,端到端输出可能被低估。这个口径争议写在正文里,没有另开附录辩解。
后来的OvisOCR2报告里,PaddleOCR-VL-1.6是96.33,OvisOCR2是96.58。Hunyuan赢的是端到端组和速度,解析分不是全场第一。报告摘要写的是top-tier end-to-end,不宜写成OmniDocBench总冠军。
古文Chronicles-OCR古文字0.54、成熟书体0.79。MORE总分91.90,对照表里最高,表格子项80.77仍低于GLM-OCR的82.48。ChartArena英文平均48.9、中文64.1。TableVerse-5K的TEDS 79.37、TEDS-S 86.05,专家OCR里最高,结构分仍低于Gemini 2.5 Pro的87.13。
DUDE验证集54.64,没超过Qwen3.5-0.8B的56.41。Spotting内部榜71.40,无文字负样本从78.1%到99.8%,艺术字从56.76掉到53.21,屏幕和视频也略降。卡片92.40、票据92.55、字幕93.07,OCRBench 861,相对1.0只多1分。
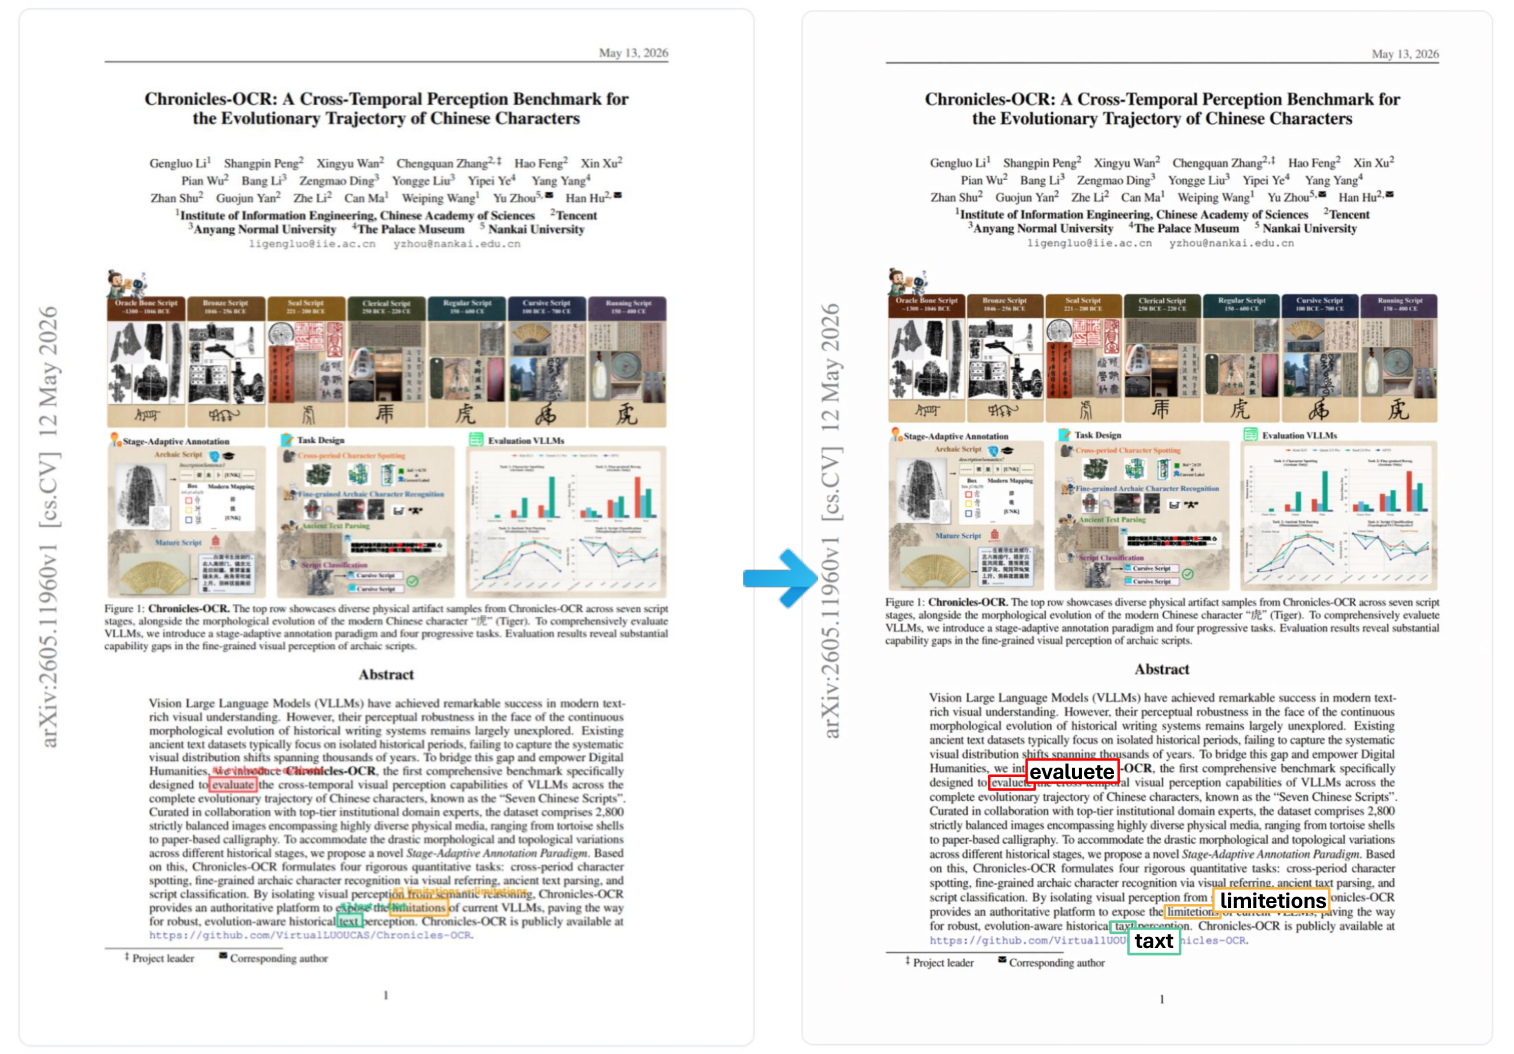
CHAOS-Bench把渲染页上两三个词改成无意义形近词,看模型会按看见的写,还是按语言习惯改回词典词。页均召回14.15,对照里最高,DeepSeek-OCR 2和MinerU2.5-Pro只有6.33。绝对值仍低。
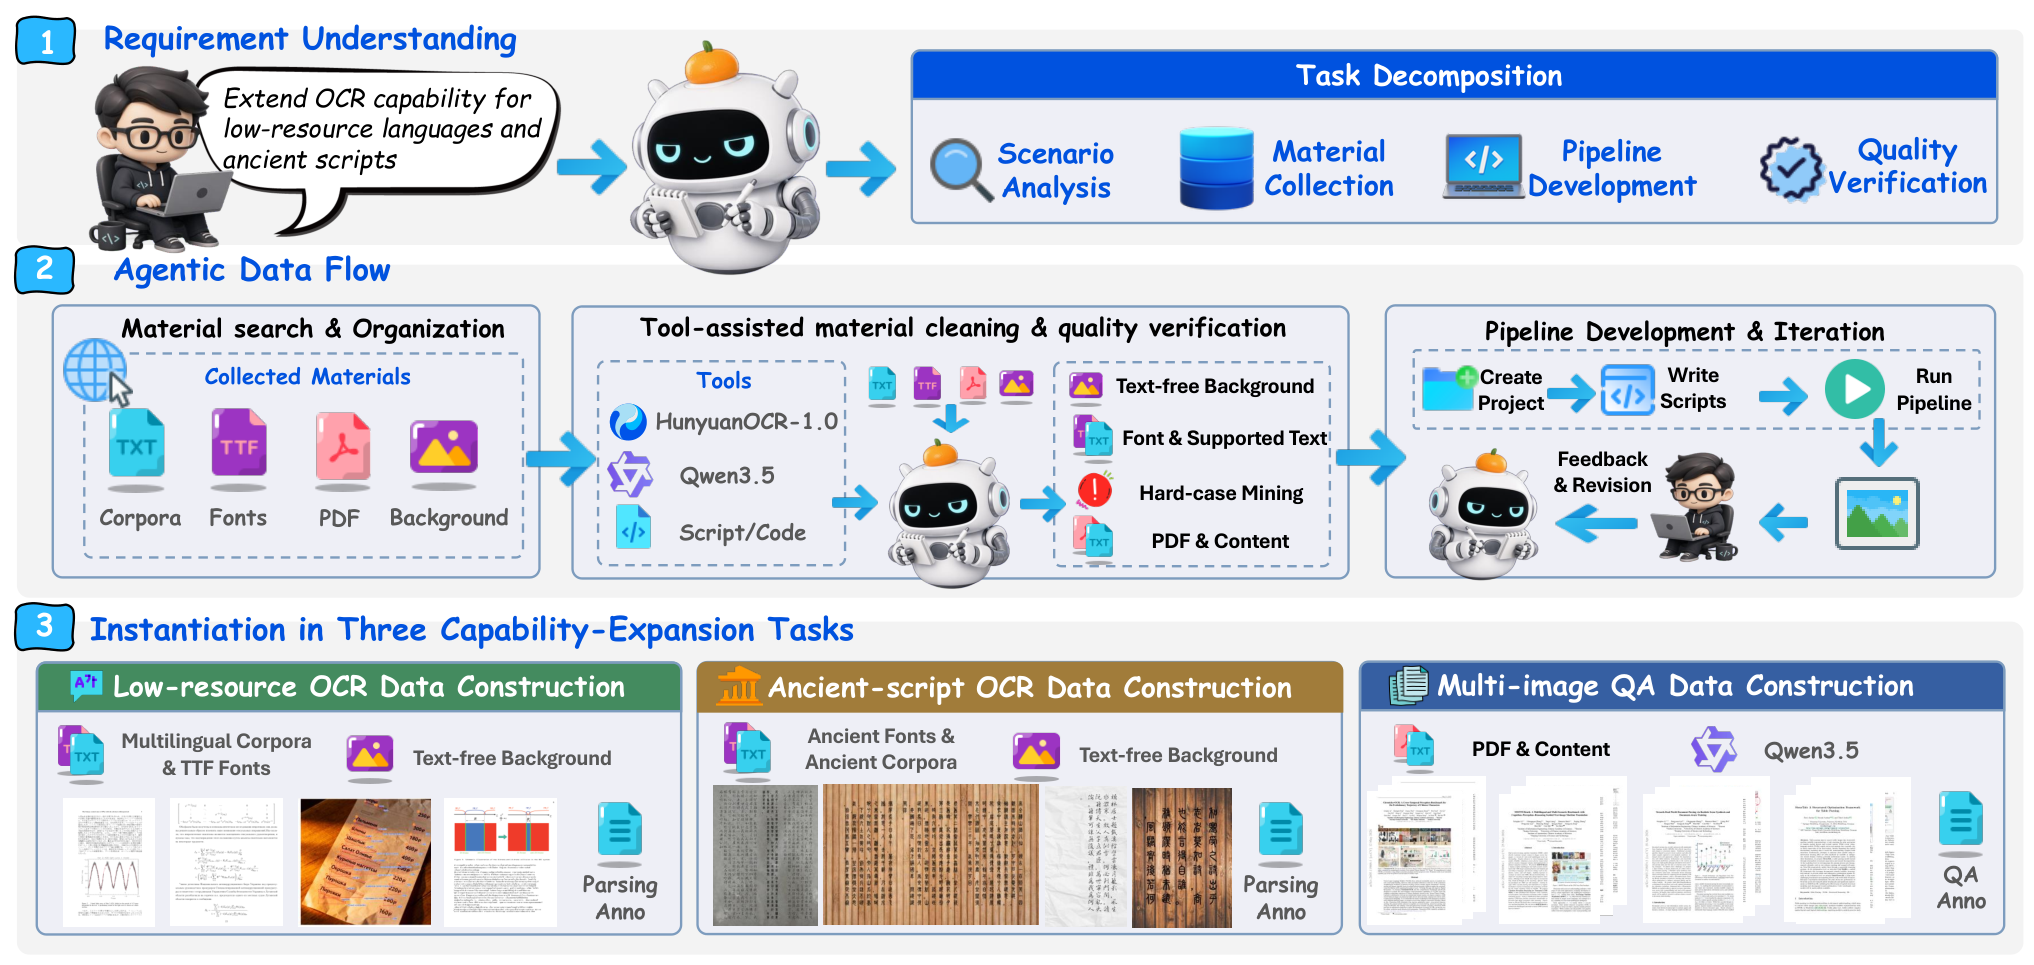
数据侧叫Agentic Data Flow。算法工程师用自然语言点出短板,智能体去搜语料和字体、调1.0和Qwen3.5做质检、写渲染脚本。低资源OCR覆盖331种语言,古文对汉字七种历史形态做合成。预训练只重做Stage3,把这些数据和1.0的历史OCR数据混在一起。合成细节放到MinerU和PaddleOCR那两篇。
后训练把难题留给RL,算法换成IcePop,按token校准训练引擎和推理引擎的概率比,落在0.2, 5.0之外的token不更新。SFT检查点OmniDocBench 92.92,RL之后94.74,这一段贡献了1.82分。
五、本地部署与推理实践
权重在Hugging Face的tencent/HunyuanOCR,根目录是1.5,DFlash草稿在dflash/,1.0归档在v1.0/。协议是腾讯混元社区许可,和1.0相同,不是Apache,商用前要自己读LICENSE。
官方统一环境要求CUDA 13,同一套安装覆盖vLLM自回归、DFlash和原生Transformers。缺CUDA 13时,仓库docs/inference/inference.md指向更轻的分配置安装。
bash
pip install uv
uv venv --python 3.12.11 && source .venv/bin/activate
uv pip install "vllm>=0.25.1"
uv pip install --no-build-isolation --no-cache-dir "flash-attn==2.8.3"

pip install -U "huggingface_hub[cli]"
huggingface-cli download tencent/HunyuanOCR --local-dir ./HunyuanOCR --exclude "v1.0/*"
git clone https://github.com/Tencent-Hunyuan/HunyuanOCR.git
cd HunyuanOCR三种配置共用同一套权重、任务提示和采样。模型卡锁定temperature=0.0、top_p=1.0、top_k=-1、repetition_penalty=1.08。文档解析要确定性输出,温度给0说得通,1.08用来压长输出里的循环重复。
Transformers要求transformers>=5.13.0,类名HunYuanVLForConditionalGeneration。模型卡最小示例如下。
python
import torch
from transformers import AutoProcessor, HunYuanVLForConditionalGeneration

MODEL_ID = "tencent/HunyuanOCR"
processor = AutoProcessor.from_pretrained(MODEL_ID, trust_remote_code=True, use_fast=False)
model = HunYuanVLForConditionalGeneration.from_pretrained(
    MODEL_ID, torch_dtype=torch.bfloat16, device_map="auto",
    trust_remote_code=True,
).eval()

prompt = (
    "提取文档图片中正文的所有信息用markdown格式表示,其中页眉、页脚部分忽略,"
    "表格用html格式表达,文档中公式用latex格式表示,按照阅读顺序组织进行解析。"
)
messages = [{
    "role": "user",
    "content": [
        {"type": "image", "image": "/path/to/document.png"},
        {"type": "text",  "text":  prompt},
    ],
}]
inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt",
).to(model.device)
with torch.inference_mode():
    out = model.generate(**inputs, max_new_tokens=8000, do_sample=False)
gen = out[:, inputs["input_ids"].shape[1]:]
print(processor.batch_decode(gen, skip_special_tokens=True)[0])最小示例max_new_tokens=8000。仓库脚本上限32768,服务端--max-model-len 131072。
vLLM自回归和DFlash共用客户端。
bash
MODEL_PATH=./HunyuanOCR GPU=0 PORT=8000 bash inference/vLLM/serve.sh
# DFlash草稿已在 ./HunyuanOCR/dflash ,默认不用再拷
MODEL_PATH=./HunyuanOCR GPU=0 PORT=8000 bash inference/DFlash/serve_DFlash.sh

python inference/vLLM/infer_vllm_client.py \
    --host 127.0.0.1 --port 8000 \
    --model tencent/HunyuanOCR \
    --image /path/to/document.png \
    --task-type doc_parse \
--max-tokens 32768--task-type锁官方任务,--list-tasks可看全表,常见的有doc_parse、spotting_json、chart_parse、doc_trans_en2zh。流式客户端带尾部重复提前停止和文档解析Markdown规范化。
PC端走llama.cpp。社区版能跑基座,DFlash要用wendadawen/llama.cpp的dflash-adapt-hunyuanocr-hunyuanstyle。
bash
git clone https://github.com/ggml-org/llama.cpp.git && cd llama.cpp
cmake -B build -DLLAMA_BUILD_EXAMPLES=ON
cmake --build ./build --config Release -j

hf download tencent/HunyuanOCR --local-dir ./HunyuanOCR --exclude "v1.0/*"
python3 convert_hf_to_gguf.py --outfile ./HunyuanOCR/hyocr-f16.gguf --outtype f16 ./HunyuanOCR
python3 convert_hf_to_gguf.py --outfile ./HunyuanOCR/mmproj-hyocr-f16.gguf --outtype f16 --mmproj ./HunyuanOCR

build/bin/llama-server \
  --model ./HunyuanOCR/hyocr-f16.gguf \
  --mmproj ./HunyuanOCR/mmproj-hyocr-f16.gguf \
  --host 0.0.0.0 --port 8080 --alias HYVL \
--ctx-size 10240 --n-predict 4096这里--ctx-size 10240、--n-predict 4096,和论文宣传的128K不是一档。端侧示例按这个窗口来,不要默认笔记本上也能喂满长文档。DFlash版和完整说明在仓库docs/llama_cpp.md。
六、总结与思考
HunyuanOCR-1.5把端到端OCR的部署问题拆成两半。一半是让已有小模型在长结构化输出上少走自回归步,DFlash吃的是表格、公式、HTML这种局部可预测的输出。另一半是把输入规格抬到4K和128K。
速度数字里,我更信vLLM的2.14×,不把Transformers的6.37×当成线上口径。没开DFlash时它比Paddle和GLM慢,打开之后才是对照里最快的端到端系统。投机解码靠闲算力,并发打满加速比会掉。
短板也清楚。OmniDocBench总榜已被流水线和后来的OvisOCR2拿走。CHAOS-Bench召回14.15,多数冲突仍听语言模型。多图问答没超过同尺寸通用VLM。协议也不是Apache。llama.cpp公开示例只有10240上下文,部署按脚本窗口来。
参考链接
- 技术报告原文 arXiv 2607.04884 v3,v1于2026年7月6日,v3于2026年9月17日,HTML版
- 代码仓库 Tencent-Hunyuan/HunyuanOCR
- 模型权重与推理示例 tencent/HunyuanOCR
- DFlash原稿 arXiv 2602.06036
- 前代 HunyuanOCR技术报告
- OmniDocBench榜单
- 对比方案 PaddleOCR-VL、GLM-OCR、OvisOCR2