团队在判断要不要继续投入某个 Copilot 功能时,缺一个能横向比较的采用指标。GitHub 在 9 月 17 日的官方更新里给出了新口径:每个功能有多少活跃用户在 28 天内至少两天用到了它。这篇文章说清这条口径的定义、它能证明什么、不能证明什么,以及怎么用本地活动表和任务结果表复算同一口径。
功能参与度口径怎么定
据 GitHub 9 月 17 日官方更新,Copilot 影响看板新增功能参与度视图,口径是:统计 28 天周期内,每个纳入统计的功能有多少活跃用户在至少两天里使用过该功能,原文表述为 "Shows how many active users engaged with each included feature on at least two days during the 28-day period."
要求「至少两天」而不是「用过一次」,是在过滤一次性的尝试行为。用户打开一次觉得不对味就关掉,和形成习惯性使用,在一次计数里完全一样,在两天计数里被区分开。28 天窗口比月度自然月更稳定,卡片排版变化不会让某个月多出几天。同日的更新还给使用量指标补充了五类计数:不同 Skill、不同自定义 Agent、不同 MCP、不同斜杠命令、不同插件各用了多少种,用来观察定制能力的覆盖面。
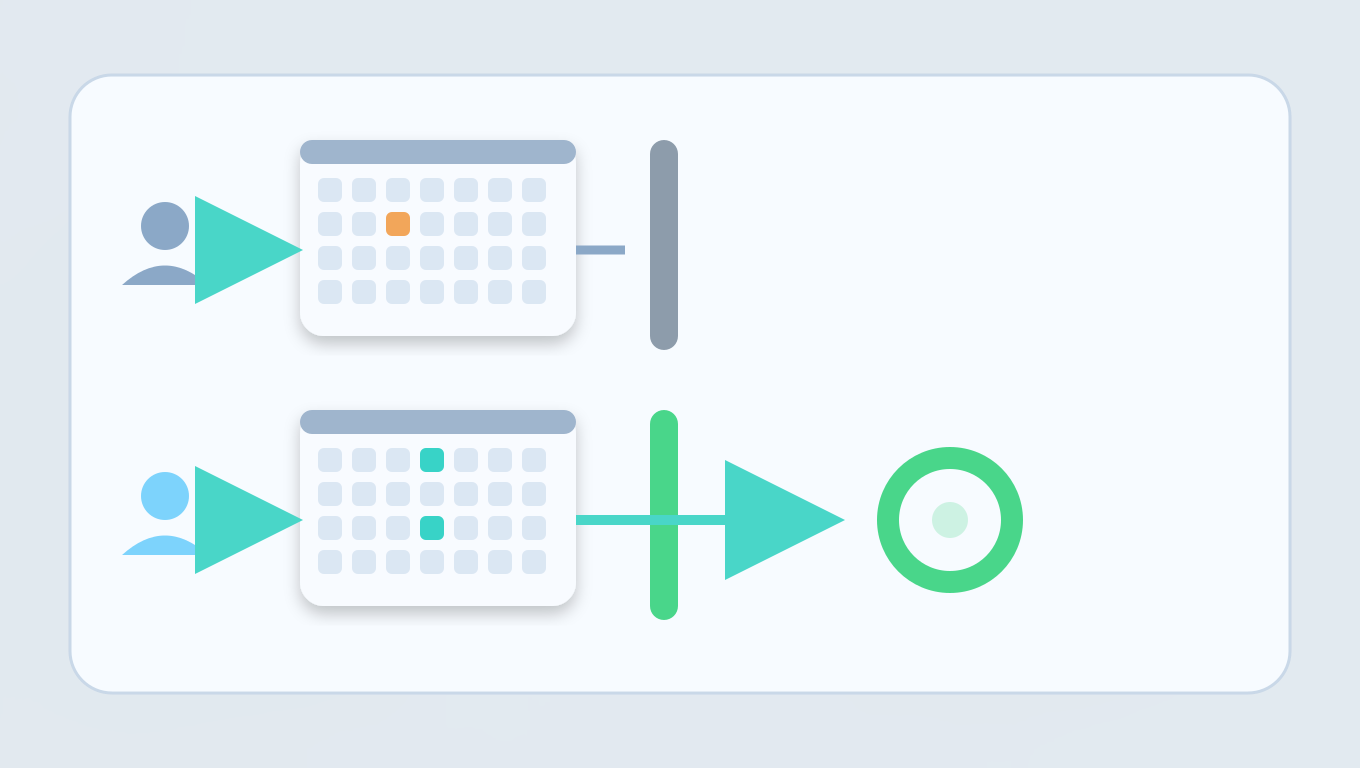
单日使用路径停止,跨两个日期的使用路径进入参与人数计数
这条口径证明了什么、没证明什么
对比两条常见的汇报方式就清楚它的位置。「上个月某功能被调用了 4000 次」是行为量,单次重试、批量脚本都会推高它;「28 天内 300 个活跃用户里,180 人至少两天用过」是人的覆盖面。前者回答系统忙不忙,后者回答有多少人在把它当日常工具,两者不能互相替代。
但也别把参与度当成 ROI。它只统计「是否达到两天使用」,不区分这两天的使用是高效交付还是反复绕弯;不统计完不成回到人工的比例;也不回答「投入两个工程师维护它值不值」。使用证据到收益证据之间还缺交付质量、耗时对比这些数据,本文建议把参与度当作采用侧的第一层指标,不要单独用作投入产出的结论。
工程上建议把指标拆成四层:授权席位回答覆盖范围,活跃用户回答近期是否进入工作流,功能参与度回答哪些能力被重复使用,任务结果回答工作是否按验收条件完成。四层必须使用同一个时间窗口和组织范围,并把自动任务与人工操作分别统计;分母变化、账号迁移、批量自动任务都要单独标记。只有参与度上升且失败率、人工返工与交付周期同步改善,才值得继续讨论业务收益。
把重复采用与任务结果放在一张表里
只看参与人数仍然不够。下面假设有 feature_activity(user_id, use_date, feature) 与 task_results(task_id, user_id, feature, completed_at, accepted, human_rework) 两张表。repeat_adoption 定义为 28 天内至少两天使用某功能的用户占该功能活跃用户的比例;failure_adjusted_completion 定义为无需人工返工且通过验收的任务占全部任务的比例。两项使用同一窗口和同一功能范围。
如果你在整理自己团队的 Agent 采用度量,可以先对照这份Agent场景自检列清要验证的问题,再决定把哪些字段纳入例行报表。
sql
WITH activity AS (
  SELECT DISTINCT user_id, use_date, feature
  FROM feature_activity
  WHERE use_date BETWEEN :window_start AND :window_end
), user_days AS (
  SELECT feature, user_id, COUNT(DISTINCT use_date) AS active_days
  FROM activity GROUP BY feature, user_id
), adoption AS (
  SELECT feature,
    COUNT(*) AS active_users,
    SUM(CASE WHEN active_days >= 2 THEN 1 ELSE 0 END) AS repeat_users
  FROM user_days GROUP BY feature
), task_scope AS (
  SELECT task_id, feature,
    CASE WHEN accepted = 1 AND human_rework = 0 THEN 1 ELSE 0 END AS clean_done
  FROM task_results
  WHERE DATE(completed_at) BETWEEN :window_start AND :window_end
), quality AS (
  SELECT feature, COUNT(DISTINCT task_id) AS tasks,
    SUM(clean_done) AS clean_tasks
  FROM task_scope GROUP BY feature
)
SELECT a.feature, a.repeat_users, a.active_users,
  ROUND(1.0 * a.repeat_users / NULLIF(a.active_users, 0), 4) AS repeat_adoption,
  ROUND(1.0 * q.clean_tasks / NULLIF(q.tasks, 0), 4) AS failure_adjusted_completion
FROM adoption a LEFT JOIN quality q USING (feature)
ORDER BY repeat_adoption DESC;
验证时准备四个用户:一个只用一天、一个跨两天、一个任务失败、一个通过但发生人工返工。查询结果中只有跨两天用户进入 repeat_users;失败和返工任务都不能进入 clean_tasks。再删除跨两天用户的一天活动记录,repeat_users 应减少但任务数不变;把失败任务改成通过且无需返工后,只有 clean_tasks 增加。这样能分别检查窗口、功能连接键和验收状态口径。
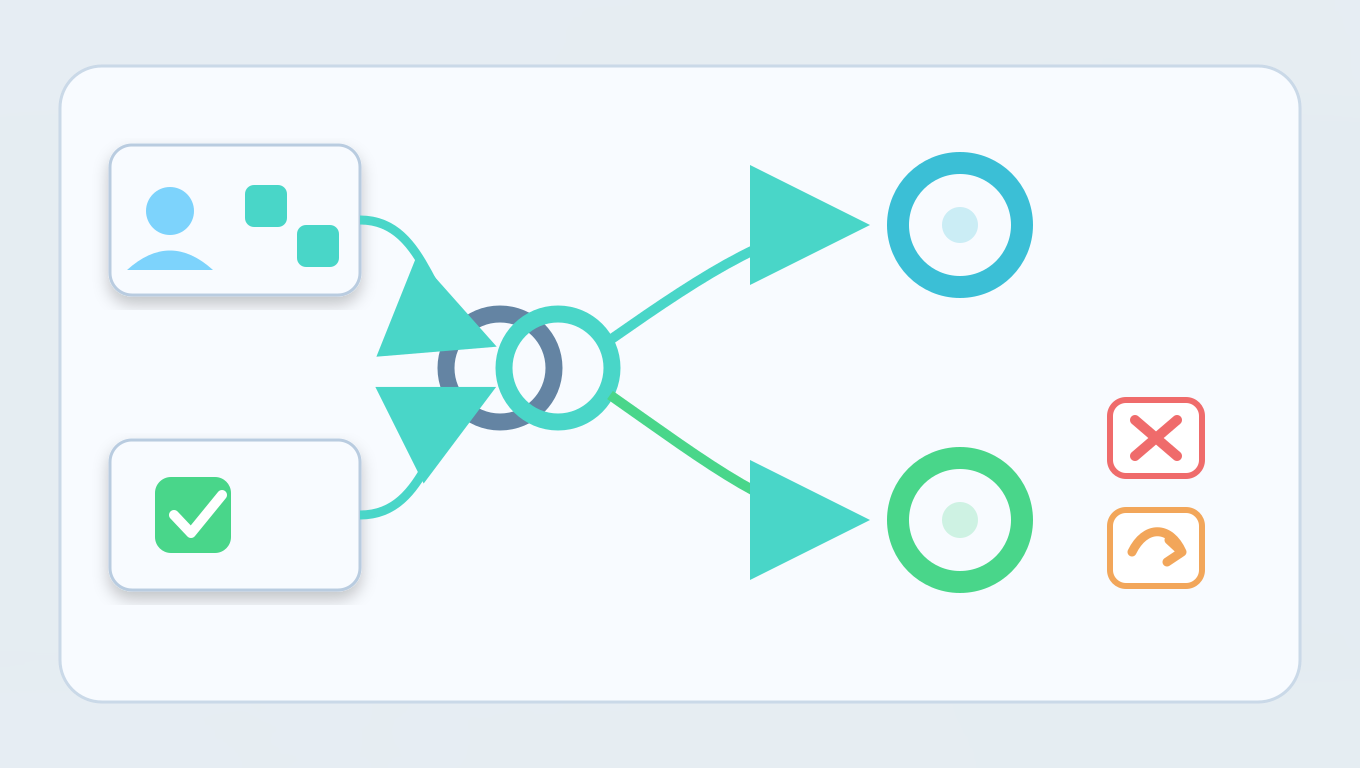
活动与任务结果在同一窗口按功能汇合,再分别统计重复用户与无失败、无返工的任务
使用数之外:边界与交接
两个实际坑要先说明。其一,导出里如果同一窗口内功能口径发生过变化(例如某工具后来才纳入统计),直接跨窗口对比会失真,本文建议按功能的纳入时长分段对比。其二,两天口径对低频功能偏严:一个每月只在关键故障时使用两次的工具,可能长期不达标,但贸然停用它的代价很高。本文建议对这类功能补一个「低频高价值」标签,单独评审,不与高频功能同列。
数据出问题时的处理路径也要提前定:参与人数突然掉到零,先确认是导出管道断了还是使用真的归零,而不是先把功能下线;口径变更要记录变更日期和旧口径的最后读数,否则半年后没人说得清曲线跳变的原因。读完后,先跑一遍上面的 SQL,核对本地数据里一个功能的 28 天参与数,再决定要不要把这套统计搬进团队的例行报表。