一、理论部分
1. 为什么需要子 Agent
第四章Agent的任务规划解决了"复杂任务如何拆分和记录进度"的问题,但如果所有子任务都由主 Agent 自己执行,搜索结果、文件读取、工具调用和中间分析仍然会不断进入主 Agent 的上下文。例如,一个研究任务可能需要多次网络搜索、文件写入和内容整理,这些中间过程本身可能产生大量 Token,而主 Agent 最终真正需要的往往只是研究结论。
因此,第五章引入 Subagent,其核心目的之一是 Context Quarantine,即上下文隔离。主 Agent 将某个完整子任务委派给子 Agent,子 Agent 在自己的 Context 中执行模型调用和工具调用,任务完成后只把最终结果返回给主 Agent。这样,大量中间过程不会进入主 Agent 的消息历史,主 Agent可以继续负责整体规划、任务分配和最终结果整合。官方文档也将 Subagent 的主要价值概括为隔离复杂子任务产生的大量中间上下文,同时允许不同子 Agent 使用专门的指令、工具和模型。
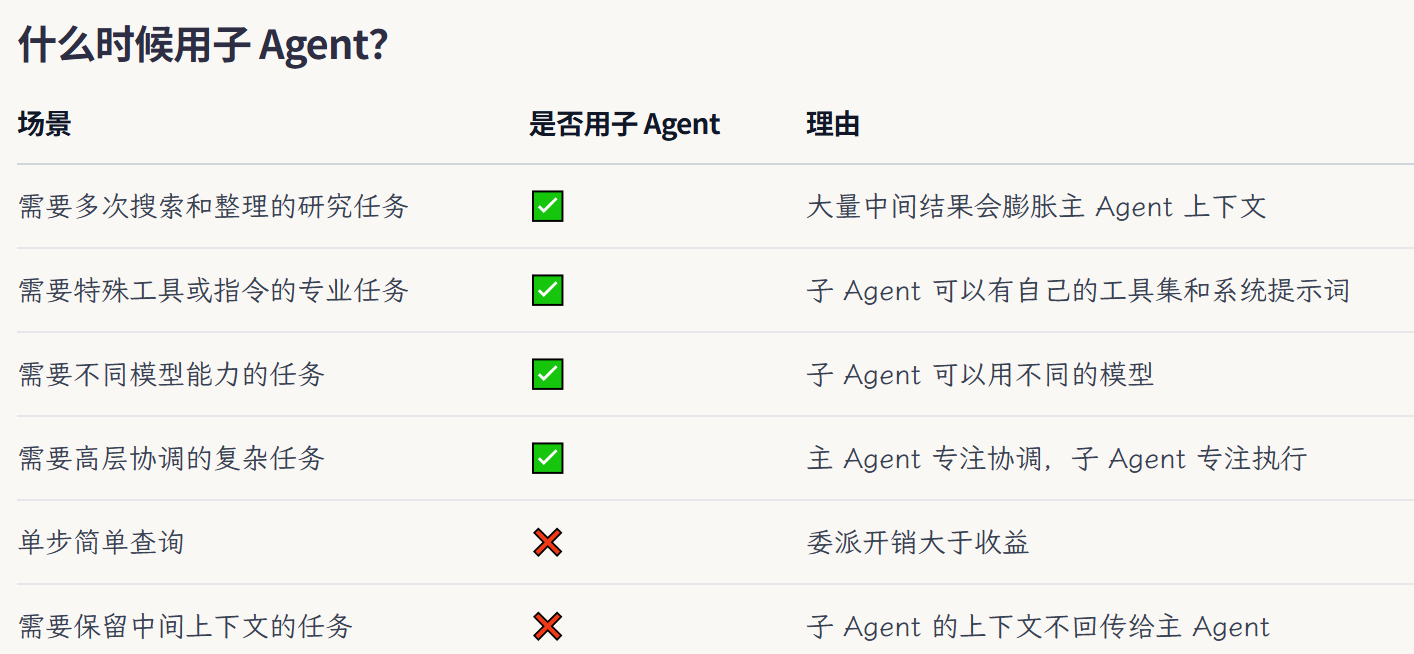
因此,子 Agent 并不是单纯为了"把系统拆成多个 Agent",而是在复杂任务中提供一种上下文边界和能力边界。如果某个任务只需要一次简单工具调用,创建子 Agent 通常没有必要;如果某个任务需要大量独立操作、特殊工具、专门指令或不同模型,则更适合交给独立子 Agent。
2. 主 Agent 与子 Agent 的执行关系
Deep Agents 中,主 Agent 通过 task 工具把任务委派给子 Agent。子 Agent 接收到的是明确的子任务,在自己的上下文中完成推理和工具调用,然后把最终结果返回给主 Agent。
例如:
python
task(
    name="researcher",
    task="搜索并总结 LangGraph 的最新技术文档"
)
其中 name 指定调用哪个子 Agent,task 表示需要完成的具体任务。
这种架构下,主 Agent 的主要职责通常是理解用户目标、制定计划、选择合适的子 Agent、组织多个任务之间的依赖关系,并整合最终结果。子 Agent则负责完成一个边界比较明确的专业任务。
需要特别理解的是:默认情况下,子 Agent 的完整推理和工具调用历史不会返回给主 Agent。 主 Agent接收到的主要是子 Agent 的最终输出。这也是 Subagent 能够降低主 Agent Context 压力的原因。
3. 定义子 Agent
最常见的方式是使用字典定义一个专业子 Agent。例如:
python
research_subagent = {
    "name": "researcher",
    "description": "负责需要多次搜索和信息整理的深度研究任务",
    "system_prompt": """
    你负责研究指定主题。
    使用搜索工具收集多个来源的信息,
    对信息进行整理和验证,
    最终只返回核心结论和信息来源。
    """,
    "tools": [internet_search],
}
然后将它注册到主 Agent:
python
agent = create_deep_agent(
    model=model,
    subagents=[research_subagent],
)
一个子 Agent 最重要的三个字段是 name、description 和 system_prompt。
| 字段 | 作用 |
|---|---|
name |
子 Agent 的唯一名称,主 Agent 调用 task() 时使用 |
description |
描述子 Agent 负责什么任务,主 Agent 根据它决定是否委派 |
system_prompt |
定义子 Agent 自己的角色、执行规则和输出格式 |
tools |
子 Agent 可以使用的工具 |
model |
可以为该子 Agent 单独指定模型 |
middleware |
子 Agent 自己使用的 Middleware |
skills |
子 Agent 专属 Skills |
response_format |
限制返回结果的数据结构 |
permissions |
限制子 Agent 对文件等资源的权限 |
其中,description 实际上承担了路由说明的作用 。主 Agent并没有一个固定的 if researcher then ... 程序,而是根据各个子 Agent 的 description 判断当前任务应该委派给谁。因此 description 应明确描述"什么情况下应该调用该 Agent",而不能只写"负责研究""负责分析"这种过于宽泛的描述。
4. 子 Agent 的能力隔离
专业子 Agent 并不是简单复制主 Agent。它可以拥有自己的 System Prompt、Tools、Skills、Middleware、Model 和权限,从而形成独立的执行环境。
这里需要特别注意几个继承关系。专业子 Agent 的 system_prompt 不会直接继承主 Agent,因此通常需要单独定义。tools 如果不指定,可以继承主 Agent;一旦显式指定,则使用新的工具集合,而不是和主 Agent 工具自动合并。skills 也需要专业子 Agent 自己配置。
这种机制使得不同子 Agent 可以只拥有完成自己任务所需的能力。例如研究 Agent 只获得搜索工具,数据分析 Agent只获得数据计算工具,写作 Agent只负责内容生成和文档处理。
这种设计符合最小权限原则:不要因为系统存在一个工具,就把这个工具暴露给所有 Agent。工具越多,模型的工具选择空间越大,同时也增加误调用和安全风险。
5. General-purpose 子 Agent
Deep Agents 默认提供一个 general-purpose 子 Agent。它没有固定的专业任务,主要作用是在主 Agent 需要隔离一个复杂子任务,但系统又没有专门配置对应专业 Agent 时,提供通用的任务执行能力。
General-purpose 子 Agent 和主 Agent 能力比较接近,因此它最主要的价值不是专业化,而是上下文隔离。例如主 Agent需要完成一个需要十次搜索的临时任务,可以直接交给 general-purpose 子 Agent,让这些搜索过程留在子 Agent Context 中。
如果系统存在明确、稳定的专业任务,则通常可以进一步定义专门的 researcher、data-analyzer 等子 Agent,从而提供更精确的 System Prompt、工具和模型。
6. CompiledSubAgent
普通字典方式适合大部分子 Agent,因为子 Agent本身仍然是标准的 Agent 循环。但有些子任务并不是简单的"LLM 自己决定下一步",而是存在明确的流程、分支或循环。
这种情况下,可以使用:
python
CompiledSubAgent把一个已经构建好的 LangGraph 工作流直接作为子 Agent。
例如:
python
custom_graph = create_agent(
    model=model,
    tools=[statistical_analysis, generate_chart],
    system_prompt="负责数据分析和可视化。"
)

data_agent = CompiledSubAgent(
    name="data-analyzer",
    description="负责复杂数据分析任务",
    runnable=custom_graph,
)
可以简单区分:
| 情况 | 推荐方式 |
|---|---|
| 普通专业 Agent | 字典定义 SubAgent |
| 子任务内部有明确多步骤流程 | CompiledSubAgent |
| 已经存在 LangGraph 工作流 | CompiledSubAgent |
因此,Subagent 不一定只是另外一个简单 LLM Agent,它也可以是一个完整的 LangGraph 工作流。
7. 多子 Agent 协作
复杂系统中,可以配置多个专业子 Agent,由主 Agent负责统一协调。例如一个研究报告系统可以配置数据收集、数据分析和报告生成三个专业 Agent。
python
subagents = [
    {
        "name": "data-collector",
        "description": "负责搜索和收集原始数据",
        ...
    },
    {
        "name": "data-analyzer",
        "description": "负责对数据进行分析并提取结论",
        ...
    },
    {
        "name": "report-writer",
        "description": "负责根据分析结果生成报告",
        ...
    },
]
主 Agent先进行任务规划,然后根据任务阶段分别调用对应子 Agent,最后整合各子 Agent 的输出。这种架构的关键并不是 Agent 数量,而是每个 Agent是否拥有明确且不同的职责边界。
多个 Agent 之间最好通过精炼结果进行通信,而不是相互传递完整执行历史。否则即使使用了多个 Agent,大量原始信息最终仍然进入主 Agent Context,就失去了上下文隔离的价值。
8. 结构化输出 response_format
默认情况下,子 Agent返回的是自由文本。但如果后续结果还需要被其他 Agent 或代码继续处理,自由文本并不是最稳定的数据接口。
可以通过 response_format 定义结构化结果:
python
from pydantic import BaseModel

class ResearchFindings(BaseModel):
    summary: str
    confidence: float
    sources: list[str]
然后配置:
python
research_subagent = {
    "name": "researcher",
    "description": "负责深度研究",
    "system_prompt": "研究指定问题。",
    "tools": [internet_search],
    "response_format": ResearchFindings,
}
此时主 Agent接收到的结果可以按照固定 JSON Schema 解析,而不是依赖自然语言格式。
结构化输出特别适合多 Agent 系统,因为不同 Agent 之间存在明确的数据接口。一个 Agent的结果如果还要成为下一个 Agent的输入,固定字段通常比自由文本更加稳定。
9. 子 Agent 的设计原则
子 Agent首先需要有明确的 description。Description 不只是文档说明,而是主 Agent进行任务路由的重要依据。多个子 Agent的 description 如果高度重叠,就容易出现调用错误,因此应该明确每个 Agent的适用任务和边界。
System Prompt 应包含该 Agent 的任务目标、允许使用的工具、执行要求以及输出格式。特别是对子 Agent的最终返回结果,应明确要求只返回主 Agent真正需要的信息。上下文隔离并不意味着子 Agent 可以把全部搜索结果和中间过程重新返回给主 Agent;如果这样做,主 Agent的 Context 仍然会膨胀。
工具配置同样应遵循最小化原则。研究 Agent只需要搜索工具,就不应该同时拥有发送邮件、删除文件和执行代码等无关工具。不同子 Agent也可以根据任务难度配置不同模型,例如简单检索使用成本较低的模型,复杂分析使用能力更强的模型。课程和官方文档都强调:专业子 Agent应具有具体描述、详细指令、最小工具集合,并向主 Agent返回精炼结果。
10. 常见问题
如果定义了子 Agent但主 Agent始终不调用,首先应该检查 description 是否足够明确,以及主 Agent System Prompt是否说明了何时应该委派任务。如果多个 Agent的 description 非常相似,主 Agent也可能选择错误的 Agent。
如果引入 Subagent 后主 Agent的 Context 仍然很大,应检查子 Agent最终返回的内容。子 Agent应该在自己的上下文中处理原始数据,只向主 Agent返回结论。大量原始材料可以写入文件系统,需要时再读取,而不应该全部作为 task() 的返回结果。
因此,判断 Subagent 机制是否真正有效,不能只看"是否调用了多个 Agent",还应该观察:中间过程是否真正被隔离,以及不同 Agent之间传递的信息是否足够精炼。
11、一些个人困惑:一个 Agent 系统到底应该设计几个 Agent?
没有固定数量,而且不要先决定"我要做 3 个 Agent / 5 个 Agent",再给它们找工作。
更合理的设计顺序是:
先用一个 Agent 完成系统;只有出现明确的职责或 Context 边界时,才拆出新的 Agent。
判断一个功能是否值得单独成为 Agent,建议看下面 5 个条件:
| 判断条件 | 是否适合拆 Agent |
|---|---|
| 子任务会产生大量独立中间 Context | 适合 |
| 需要完全不同的 System Prompt / 专业知识 | 适合 |
| 需要独立工具或权限 | 适合 |
| 需要使用不同模型 | 适合 |
| 需要独立并行执行 | 适合 |
| 只是业务流程中的一个简单步骤 | 通常不需要 |
| 只调用一次 API / Tool | 通常不需要 |
| 和主 Agent 使用相同 Context、模型和工具 | 优先不拆 |
固定的处理过程可能应该写成 Workflow / LangGraph Node;只有真正需要独立决策、独立 Context 和独立能力配置的模块,才值得成为 Agent。
| 需求 | 更可能应该设计成 |
|---|---|
| 一个确定操作 | Tool |
| 固定执行流程 | Workflow / LangGraph Node |
| 一组可复用专业知识 | Skill |
| 独立做决策的专业任务 | Subagent |
| 负责整体协调 | Main Agent |
能用 Tool 解决就不要增加 Agent;能用一个 Agent 解决就先不要 Multi-Agent。只有出现明确的 Context、能力、权限、模型或并行执行边界时,再拆出新的 Agent。
本章总结
第五章是在前几章 Context Engineering 基础上的进一步扩展。虚拟文件系统解决大量信息的外部存储问题,Summarization解决长对话压缩问题,Todo Planning解决长任务的进度管理,而 Subagent进一步通过独立 Context隔离复杂子任务。
主 Agent负责理解整体目标、规划任务、选择子 Agent和整合结果;子 Agent则在独立上下文中完成特定任务。一个专业子 Agent可以拥有独立的 System Prompt、Tools、Model、Skills、Middleware 和权限,因此 Subagent同时实现了上下文隔离与能力专业化。
本章最重要的几个概念可以总结为:
| 概念 | 核心作用 |
|---|---|
| Subagent | 独立完成一个子任务 |
| Context Quarantine | 隔离子任务产生的大量中间上下文 |
task() |
主 Agent委派任务 |
description |
主 Agent选择子 Agent的重要路由依据 |
system_prompt |
定义子 Agent自己的执行规则 |
CompiledSubAgent |
将完整 LangGraph 工作流作为子 Agent |
response_format |
规定 Agent之间的结构化数据接口 |
| General-purpose | 通用子 Agent,主要用于上下文隔离 |
Subagent 的主要价值不是增加 Agent 数量,而是将适合独立处理的复杂子任务隔离到独立 Context 中,并为这些任务配置专门的指令、工具、模型和权限。
二、实验
2.1 实验内容
实验模拟一个"项目经理 + 专业研究员"的工作方式:
c
用户提出复杂研究问题
        ↓
主 Agent 分析问题
        ↓
task 委派 research-agent
        ↓
research-agent 在独立上下文中运行
  ├─ tavily_search / 千问联网搜索
  ├─ think_tool 反思
  ├─ 再次搜索
  └─ 整理研究摘要
        ↓
只把最终摘要返回主 Agent
        ↓
主 Agent 汇总多个摘要
        ↓
生成最终研究报告
2.2 核心实现
1、核心代码是:
python
research_sub_agent = {
    "name": "research-agent",
    "description": (
        "Delegate research to the sub-agent researcher. "
        "Only give this researcher one topic at a time."
    ),
    "system_prompt": RESEARCHER_INSTRUCTIONS.format(date=current_date),
    "tools": [tavily_search, think_tool],
}
2、实验输入指令
c
完成一次"子 Agent 委派与上下文隔离"实验。

研究主题:比较 LangGraph 1.0 与 0.x 在以下三个方面的主要变化:

1. API 与状态定义
2. Checkpointer 与持久化
3. 部署和运行方式

执行要求:

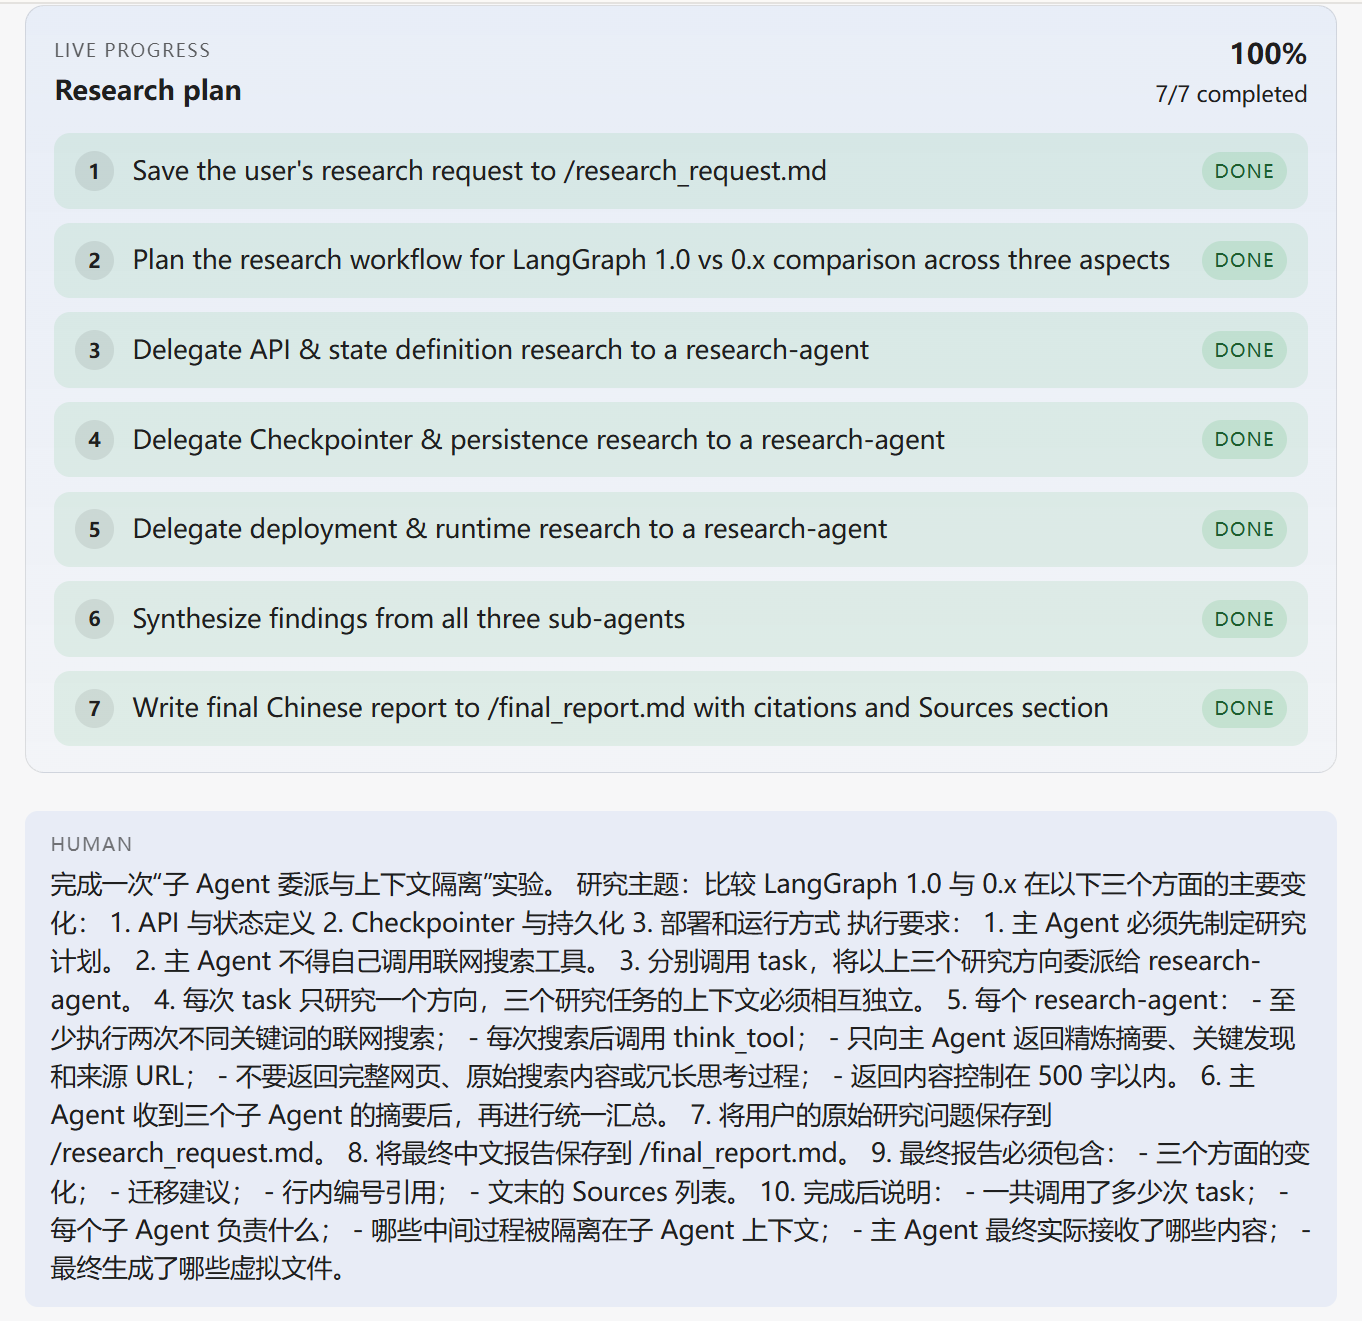
1. 主 Agent 必须先制定研究计划。
2. 主 Agent 不得自己调用联网搜索工具。
3. 分别调用 task,将以上三个研究方向委派给 research-agent。
4. 每次 task 只研究一个方向,三个研究任务的上下文必须相互独立。
5. 每个 research-agent:
   - 至少执行两次不同关键词的联网搜索;
   - 每次搜索后调用 think_tool;
   - 只向主 Agent 返回精炼摘要、关键发现和来源 URL;
   - 不要返回完整网页、原始搜索内容或冗长思考过程;
   - 返回内容控制在 500 字以内。
6. 主 Agent 收到三个子 Agent 的摘要后,再进行统一汇总。
7. 将用户的原始研究问题保存到 /research_request.md。
8. 将最终中文报告保存到 /final_report.md。
9. 最终报告必须包含:
   - 三个方面的变化;
   - 迁移建议;
   - 行内编号引用;
   - 文末的 Sources 列表。
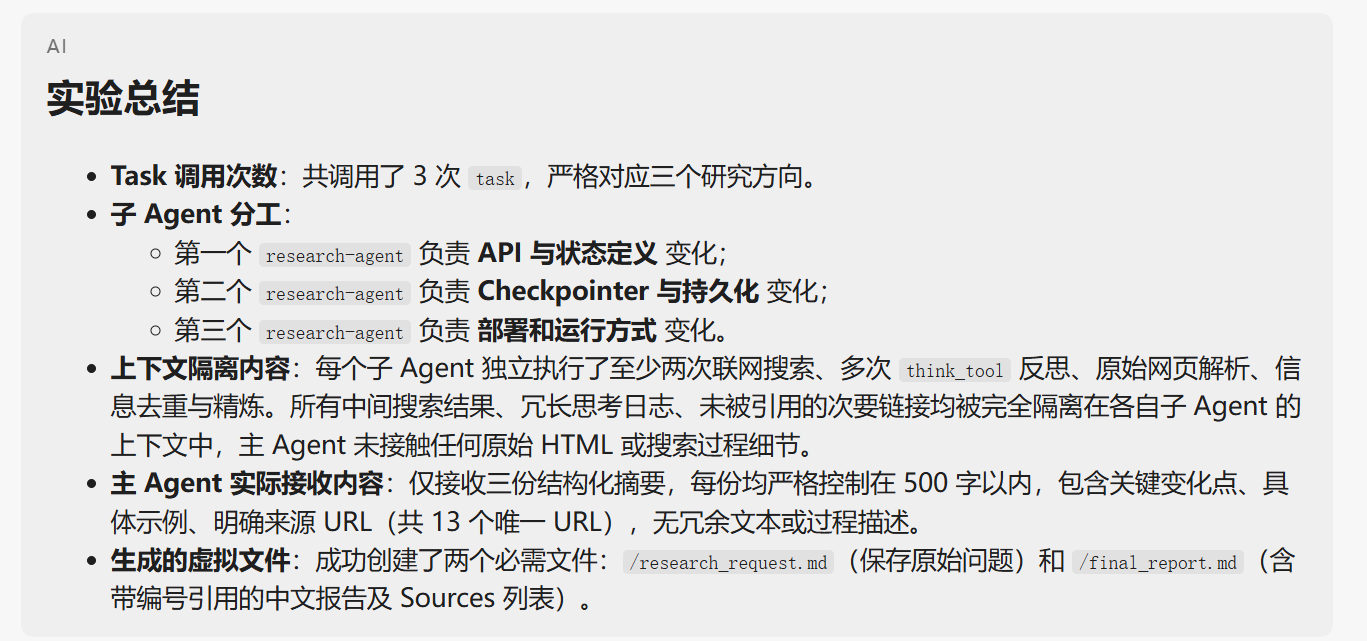
10. 完成后说明:
   - 一共调用了多少次 task;
   - 每个子 Agent 负责什么;
   - 哪些中间过程被隔离在子 Agent 上下文;
   - 主 Agent 最终实际接收了哪些内容;
   - 最终生成了哪些虚拟文件。
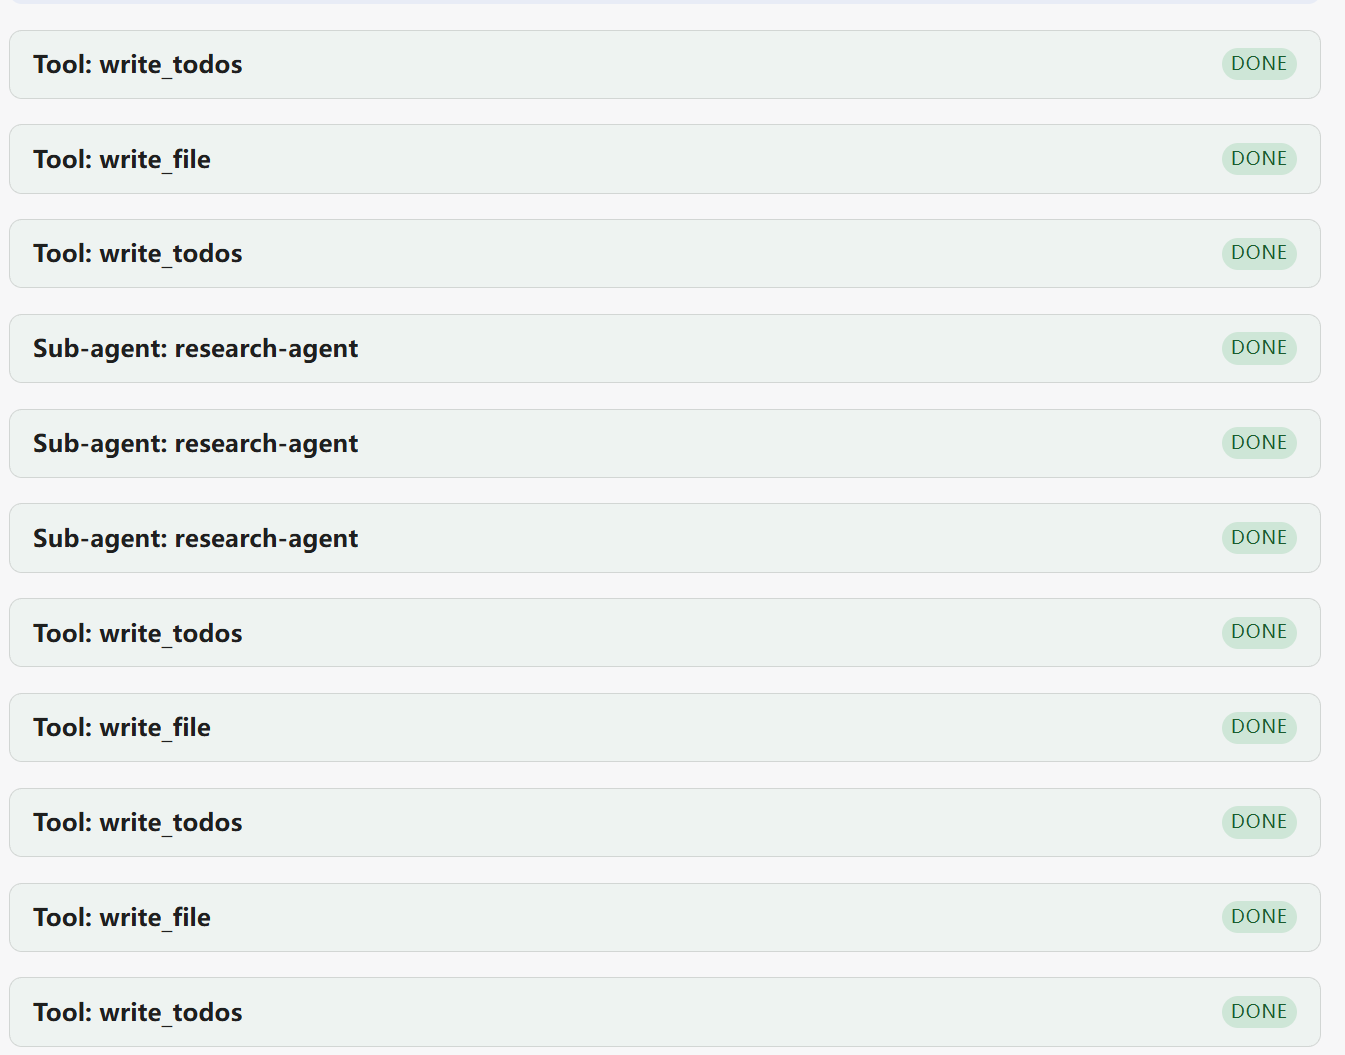
3、页面的流式输出
动态看deepagent调用过程确实很直观!