小肥柴的Hadoop之旅 快速实验篇(A11)数据集成与多维分析:从单实验产出到跨实验宽表
目录
前言
本文是"农业气象干旱分析"项目快速实验篇的第十一阶段,也是快速实验篇的收尾。前十个实验各自产出了一张表、一份结论,但彼此孤立。A5 知道每天每站的干旱等级,A6 知道每站每年的天数统计和事件清单,A8 有 Gamma 拟合参数和 severe_ratio,A9-1 有六组相关系数,A10 有 SPI 标准化结果。问题是,这些表从没被放在一起看过。
A11 的任务不是再跑一次计算,而是把 A1 到 A10 的产出集成成一张站点级宽表,然后用 Hive 窗口函数做一次单表查询就能完成的跨维度分析。核心要回答的是 A10 提出但没有回答的问题,即 SPI 标准化失效是否有空间聚集。
整个实验的最终产出是一张 108,325 行、38 列的宽表 station_profile,以及三个 Hive 窗口函数查询。查询 3 的结果把 A10 的 SPI 可用性边界落到了纬度带上,发现 SPI 失效在 30 到 40°N 最严重,45°N 以上最轻。这是 A1 到 A10 中任何一个单独实验都做不到的分析。
0. 背景知识:为什么数据集成比再算一遍更难
到 A10 为止,项目已经覆盖了干旱分析的四个维度:
- 时间维度,从 A5 逐日等级到 A6 年度统计加事件检测
- 统计维度,A8 Gamma 拟合参数加空间合并
- 相关维度,A9-1 气象因子相关系数
- 标准化维度,A10 SPI 可用性汇总
每张表都是站点级或站点年级,但它们的粒度、主键、覆盖范围都不完全一致:
| 实验 | 行数 | 粒度 | 主要字段 |
|---|---|---|---|
| A5 聚合 | 9,218,700 到 102,430 | 逐日逐站到每站每年 | 各等级天数 |
| A6 stats | 102,430 | 每站每年 | 各等级天数加 severe_ratio |
| A6 events | 4,074 | 每事件 | 时长、平均等级 |
| A8 | 108,325 | 每站一行 | 经纬度、Gamma 参数、q_zero |
| A9-1 | 102,395 | 每站一行 | 六组相关系数 |
| A10 | 102,395 | 每站一行 | spi_std、zero_ratio、n_zero |
直接 JOIN 会遇到三个问题。
第一是粒度不一致。A5 和 A6 stats 是每站每年,需要先聚合到每站才能和其他表对齐。
第二是主键不完全一致。A8 有 108,325 行,A5 和 A6 有 102,430 行,A9-1 和 A10 有 102,395 行,三个集合互有差异。
第三是语义相近但定义不同。A8 的 q_zero 是 Gamma 拟合中降水为零的比例,A10 的 zero_ratio 是 SPI 计算中零值占比,名字像,含义完全不同。
A11 的核心工作就在这里。数据集成不是建表 JOIN,先要做粒度对齐、字段映射、主键对齐,然后才是 JOIN。
1. 任务概述与目标
| 项目 | 说明 |
|---|---|
| 定位 | 承接 A1 到 A10 全部产出,构建站点级宽表,并用 Hive 窗口函数做跨维度查询演示。A11 是快速实验篇的收尾,不引入新的数据源,不重跑计算 |
| 目标 | 1. 把 7 个来源的站点级信息合并到一张宽表 2. 粒度对齐,A5 逐日聚合到站点级,A6 stats 聚合到站点级 3. 主键对齐,以 A8 为主表,LEFT JOIN 其余表 4. 在 Hive 中建外部表,用窗口函数做三个查询 5. 把 A10 的 SPI 可用性边界落到纬度带上 |
| 输出 | station_profile.csv,108,325 行、38 列,加三个 Hive 查询结果 |
| 验证 | A5 聚合天数与 A6 stats 天数完全一致;窗口函数 window_n 单调;SPI 纬度带分布非随机 |
A11 的定位需要说清楚。它不是新实验,是收尾。它不引入新的数据源,不重跑 MR,不建新的 Hive 集成管道。它做的是把已有的七份产出拼成一张宽表,然后问一个单表查询就能回答的跨维度问题。这个定位决定了后面所有工程决策。
2. 核心算法设计与工程决策
2.1 为什么 Python 主,Hive 辅,不走 MR
A9-2 曾测出 MapReduce 相对单机的盈亏平衡点在 7,812 站。A11 宽表有 108,325 站,按那个结论应该走 Hadoop。但实际选择是 Python 加 pandas,理由有三。
-
第一,A9-2 测的是计算,A11 做的是集成。集成的主要成本不在 CPU,而在数据搬运。A5 逐日输出 383 MB,A6 输出只有 1.2 MB。真正的重活已经在 A5、A6 的 MR 作业里干完了。A11 面对的输入全是已经聚合好的小表,pandas 一条 merge 就够。
-
第二,数据源全在本地。如果走 MR,需要先把 7 个来源全部上传 HDFS,再写 MapReduce 做 JOIN。多文件 JOIN 在 MR 中需要 Reduce-Side Join 或 Map-Side Join,代码量远超 pandas,而数据规模又完全用不上。
-
第三,Hive 降级为查询演示引擎。宽表建好之后,上传到 HDFS,建 Hive 外部表,用窗口函数演示分区排名、滑动窗口、分组统计。这一步是真的在做分布式查询演示,而不是在重跑 JOIN。
2.2 为什么用 Hive 窗口查询,而不是 pandas
宽表已经在本地有了一份 station_profile.csv,理论上可以直接用 pandas 做查询 1 到查询 3 的所有事。为什么还要多走一步 HDFS 加 Hive?
-
第一个原因是宽表在 HDFS 上有副本,Hive 是现成的查询引擎。A11-1 的宽表已经上传到 /drought/a11/python_side/,Hive 外部表 drought.station_profile 已经建好,列类型已确认为 double 和 int,skip.header.line.count 设为 1。此时直接用 Hive 查询,不需要再从 HDFS 拉回本地跑 pandas。
-
第二个原因是窗口函数是 Hive 的核心能力,正好匹配 A11 的三个查询。查询 1 是分区排名,用 ROW_NUMBER() OVER (PARTITION BY ...)。查询 2 是滑动窗口,用 AVG() OVER (ROWS BETWEEN ...)。查询 3 是分组聚合,用 CASE WHEN 加 GROUP BY。这三类查询如果用 pandas 写,需要 groupby().rank()、rolling()、groupby().agg() 三套不同 API。用 Hive 写,语法统一在 OVER 一个关键字上。
-
第三个原因是 Hive 的 COUNT(*) OVER 可以验证窗口边界。查询 2 的 window_n 从 201 单调涨到 250,这个窗口边界是否正确的验证在 Hive 里是一行 SQL,在 pandas 里要手动构造索引。
-
第四个原因是 A11 是快速实验篇的收尾,把 Hive 作为查询引擎演示一次,比在 pandas 里再写一遍更有意义。前面 A5、A6 已经展示了 MapReduce 的计算能力,A11 展示的是宽表加窗口函数的查询能力。两者加起来,覆盖了 Hadoop 生态的两大使用模式。
2.3 粒度对齐:A5 逐日到站点级
A5 输出 9,218,700 行逐日等级,需要先聚合到站点级:
python
a5_agg = a5.groupby('station_id')['drought_level'].value_counts().unstack(fill_value=0)
a5_agg.columns = ['a5_nodrought_days', 'a5_mild_days', 'a5_moderate_days',
                  'a5_severe_days', 'a5_extreme_days']
a5_agg['a5_total_days'] = a5_agg.sum(axis=1)
A6 stats 本身是每站每年,需要再按 station_id 求和:
python
a6_agg = a6_stats.groupby('station_id')[
    ['nodrought', 'mild', 'moderate', 'severe', 'extreme']
].sum().rename(columns={...})
关键验证是 A5 聚合与 A6 stats 聚合的六个天数字段完全一致,不一致行数为 0。这说明两套 MR 作业的等级映射逻辑没有偏差,A5 的逐日等级和 A6 的年度统计是同一份数据的两种切法。宽表保留两套天数列,用于交叉验证。
2.4 多表 JOIN:LEFT JOIN 策略
以 A8 的 108,325 行为主表,其余表 LEFT JOIN:
python
profile = a8
profile = profile.merge(a6_stats_agg, on='station_id', how='left')
profile = profile.merge(a6_events_agg, on='station_id', how='left')
profile = profile.merge(a9_corr, on='station_id', how='left')
profile = profile.merge(a10_spi, on='station_id', how='left')
选择 LEFT JOIN 而不是 INNER JOIN 的原因是主表不动,其余表缺就填 NaN。这样宽表行数恒等于 A8 的 108,325,任何下游分析看到的都是同一套站点集合,不会因为某个 JOIN 丢行而改变样本。
代价是缺失字段需要处理。A6 events 覆盖率只有 3.76%,也就是 4,074 除以 108,325。LEFT JOIN 后 96.24% 的行 n_events 是 NaN。这不是 bug,是 A6 事件过滤逻辑的结果,只统计持续至少 15 天且平均等级至少 2 的严重事件。
3. 踩坑与适应:三个数据警告
3.1 警告一:宽表存在完全重复行
宽表建好后,第一件事是查重复:
sql
SELECT COUNT(*), COUNT(DISTINCT station_id) FROM station_profile;
-- 108325, 101491
差 6,834 行。进一步查完全重复行:
sql
SELECT station_id, latitude, longitude, severe_ratio, spi_std, zero_ratio, COUNT(*) AS cnt
FROM station_profile
GROUP BY station_id, latitude, longitude, severe_ratio, spi_std, zero_ratio
HAVING COUNT(*) > 1
ORDER BY cnt DESC;
结果发现同一 station_id 的所有列完全相同,最多出现 28 次。这说明重复来自 A8 主表本身,A11 的 LEFT JOIN 只是把它们保留了下来,并没有引入新错误。
影响是查询 1 和查询 3 都会被重复行加权。例如原查询 1 的 5_>=45 带第 3、4、5 行完全相同,实际只有 3 个唯一站。
解决办法是在两个查询中都加一层去重:
sql
ROW_NUMBER() OVER (
  PARTITION BY station_id, latitude, longitude
  ORDER BY station_id
) AS rn
...
WHERE rn = 1
去重后查询 3 的 n_total 合计从 108,278 降到 101,456,正好等于 A10 的唯一站点数。这个数字对上了,说明去重逻辑正确。
3.2 警告二:A6 events 覆盖率仅 3.76%
A6 事件表只有 4,074 行,对应 108,325 个站点,覆盖率 3.76%。原因是 A6 只输出持续至少 15 天且平均等级至少 2 的严重事件,不是全部事件。任何用 n_events 的分析都必须带这个前提,否则会低估事件频率。
在宽表中,n_events、total_event_days、max_event_duration、mean_event_level 四个字段只对 3.76% 的站点有值,其余是 NaN。
3.3 警告三:多个 station_id 共用同一经纬度
A8 源数据中,同一个经纬度上可能有 36 个不同 station_id。这不是 A11 引入的,是源数据本身如此。空间分析如果直接按经纬度聚合,会把 36 个站当成一个位置,结论会失真。
宽表保留 station_id 作为唯一主键,空间分析时如果需要按位置聚合,要么用 station_id 去重,要么明确说明同一位置多站的前提。
4. Hive 窗口函数演示
三个 HQL 文件在 /home/hadoop/a11_output/sql/,对应的 Hive 表是 drought.station_profile,类型为 EXTERNAL,位置 /drought/a11/python_side,SerDe 是逗号分隔,列类型已确认为 double 和 int,不需要 CAST。
4.1 查询 1:按纬度带分区,各带 TOP 5
意图是在每个纬度带内,找出 severe_ratio 最高的 5 个站,看不同纬度带的极值站特征。
核心 SQL:
sql
SELECT lat_band, rn2, station_id, latitude, severe_ratio, spi_std, zero_ratio
FROM (
  SELECT
    station_id, latitude, longitude, severe_ratio, spi_std, zero_ratio,
    CASE
      WHEN latitude < 30 THEN '1_<30'
      WHEN latitude < 35 THEN '2_30-35'
      WHEN latitude < 40 THEN '3_35-40'
      WHEN latitude < 45 THEN '4_40-45'
      ELSE '5_>=45'
    END AS lat_band,
    ROW_NUMBER() OVER (
      PARTITION BY
        CASE
          WHEN latitude < 30 THEN '1_<30'
          WHEN latitude < 35 THEN '2_30-35'
          WHEN latitude < 40 THEN '3_35-40'
          WHEN latitude < 45 THEN '4_40-45'
          ELSE '5_>=45'
        END
      ORDER BY severe_ratio DESC, station_id
    ) AS rn2
  FROM (
    SELECT
      station_id, latitude, longitude, severe_ratio, spi_std, zero_ratio,
      ROW_NUMBER() OVER (
        PARTITION BY station_id, latitude, longitude
        ORDER BY station_id
      ) AS rn
    FROM drought.station_profile
    WHERE severe_ratio IS NOT NULL
  ) t
  WHERE rn = 1
) u
WHERE rn2 <= 5
ORDER BY lat_band, rn2;
结果是 25 行,5 带乘 5 站。各带 TOP 站的 severe_ratio 在 0.222 到 0.233 之间,与查询 3 的 mean_severe_ratio 约等于 0.20 一致。5_>=45 的高 severe_ratio 站 spi_std 普遍偏高,在 0.89 到 0.97 之间,与查询 3 该带 mean_spi_std 等于 0.8696 一致。
这里 ROW_NUMBER() OVER (PARTITION BY ...) 就是分组排名,一行 SQL 替代了循环每个带、排序、取前 5 的逻辑。不加内层去重时,重复行会占据 TOP 5 名额,这是实际踩到的坑。
4.2 查询 2:沿纬度滑动平均
意图是按纬度排序后,对 spi_std 做 401 行滑动平均,也就是前 200 加当前加后 200,看 SPI 离散度是否随纬度平滑变化。
核心 SQL:
sql
WITH ordered AS (
  SELECT
    station_id, latitude, longitude, spi_std,
    ROW_NUMBER() OVER (ORDER BY latitude, longitude, station_id) AS rn
  FROM drought.station_profile
  WHERE spi_std IS NOT NULL
)
SELECT
  rn, station_id, latitude, longitude, spi_std,
  ROUND(AVG(spi_std) OVER (
    ORDER BY rn
    ROWS BETWEEN 200 PRECEDING AND 200 FOLLOWING
  ), 4) AS spi_std_rolling,
  COUNT(*) OVER (
    ORDER BY rn
    ROWS BETWEEN 200 PRECEDING AND 200 FOLLOWING
  ) AS window_n
FROM ordered
ORDER BY rn
LIMIT 50;
结果是前 50 行,rn 从 1 连续递增,window_n 从 201 单调涨到 250,spi_std_rolling 从 0.8884 平滑降到 0.8488。
滑动窗口和分组排名的区别在于,分组排名按分区独立,滑动窗口是全局有序的。这里用 ROW_NUMBER() 先做确定性排序,再按 rn 做窗口,避免了只按 latitude、station_id 排序时因键重复导致的行序抖动。这是第一个版本踩到的坑,window_n 曾出现 210、211、209 这种非单调情况。
4.3 查询 3:SPI 失效的空间分布
意图是把 A10 的 SPI 可用性边界按纬度带统计,验证 SPI 失效是否空间聚集。A10 的边界是 zero_ratio 小于 17% 可用,大于 25% 不可用。这是 A10 没做过、A11 才能做的分析。
核心 SQL:
sql
WITH dedup AS (
  SELECT
    station_id, latitude, longitude, severe_ratio, spi_std, zero_ratio,
    ROW_NUMBER() OVER (
      PARTITION BY station_id, latitude, longitude
      ORDER BY station_id
    ) AS rn
  FROM drought.station_profile
  WHERE spi_std IS NOT NULL
)
SELECT
  CASE
    WHEN latitude < 30 THEN '1_<30'
    WHEN latitude < 35 THEN '2_30-35'
    WHEN latitude < 40 THEN '3_35-40'
    WHEN latitude < 45 THEN '4_40-45'
    ELSE '5_>=45'
  END AS lat_band,
  COUNT(*) AS n_total,
  SUM(CASE WHEN zero_ratio <  0.17 THEN 1 ELSE 0 END) AS n_spi_ok,
  SUM(CASE WHEN zero_ratio BETWEEN 0.17 AND 0.25 THEN 1 ELSE 0 END) AS n_spi_mid,
  SUM(CASE WHEN zero_ratio >  0.25 THEN 1 ELSE 0 END) AS n_spi_bad,
  ROUND(100.0 * SUM(CASE WHEN zero_ratio <  0.17 THEN 1 ELSE 0 END) / COUNT(*), 2) AS pct_ok,
  ROUND(100.0 * SUM(CASE WHEN zero_ratio >  0.25 THEN 1 ELSE 0 END) / COUNT(*), 2) AS pct_bad,
  ROUND(AVG(spi_std), 4)      AS mean_spi_std,
  ROUND(AVG(zero_ratio), 4)   AS mean_zero_ratio,
  ROUND(AVG(severe_ratio), 6) AS mean_severe_ratio
FROM dedup
WHERE rn = 1
GROUP BY
  CASE
    WHEN latitude < 30 THEN '1_<30'
    WHEN latitude < 35 THEN '2_30-35'
    WHEN latitude < 40 THEN '3_35-40'
    WHEN latitude < 45 THEN '4_40-45'
    ELSE '5_>=45'
  END
ORDER BY lat_band;
结果:
| 纬度带 | n_total | pct_ok | pct_bad | mean_spi_std | mean_zero_ratio | mean_severe_ratio |
|---|---|---|---|---|---|---|
| 1_<30 | 3,674 | 34.81 | 46.71 | 0.8097 | 0.2379 | 0.200469 |
| 2_30-35 | 23,538 | 16.65 | 69.38 | 0.7361 | 0.3274 | 0.200599 |
| 3_35-40 | 37,040 | 20.89 | 55.38 | 0.7711 | 0.2879 | 0.200736 |
| 4_40-45 | 27,968 | 31.49 | 40.66 | 0.8122 | 0.2396 | 0.200922 |
| 5_>=45 | 9,236 | 55.45 | 21.63 | 0.8696 | 0.1708 | 0.201090 |
核心结论是 SPI 失效确实有纬度聚集。
30 到 35°N 最严重,pct_bad 等于 69.38%,mean_zero_ratio 等于 0.3274,mean_spi_std 等于 0.7361。将近七成站点的 SPI 标准化不可用。
35 到 40°N 次差,pct_bad 等于 55.38%,pct_ok 只有 20.89%。
45°N 以上最好,pct_bad 等于 21.63%,pct_ok 等于 55.45%,超过一半站点的 SPI 可用。
mean_severe_ratio 各带几乎恒定,在 0.2005 到 0.2011 之间,最大差 0.0006。这说明严重干旱比例本身不随纬度变化,但 SPI 标准化失效随纬度明显变化。
这正好把 A10 的 SPI 可用性结论从有多少站可用推进到哪些纬度带可用。A10 只给出了全局统计,A11 的查询 3 给出了空间分布。
5. 数据可视化与解读
三张图从三个角度呈现查询 3 和查询 2 的结果。图 1 是核心图,直接展示 SPI 失效的纬度聚集。图 2 补充两个连续量的反相变化。图 3 从滑动平均角度看低纬段的趋势。
5.1 图 1:SPI 可用性随纬度带分布
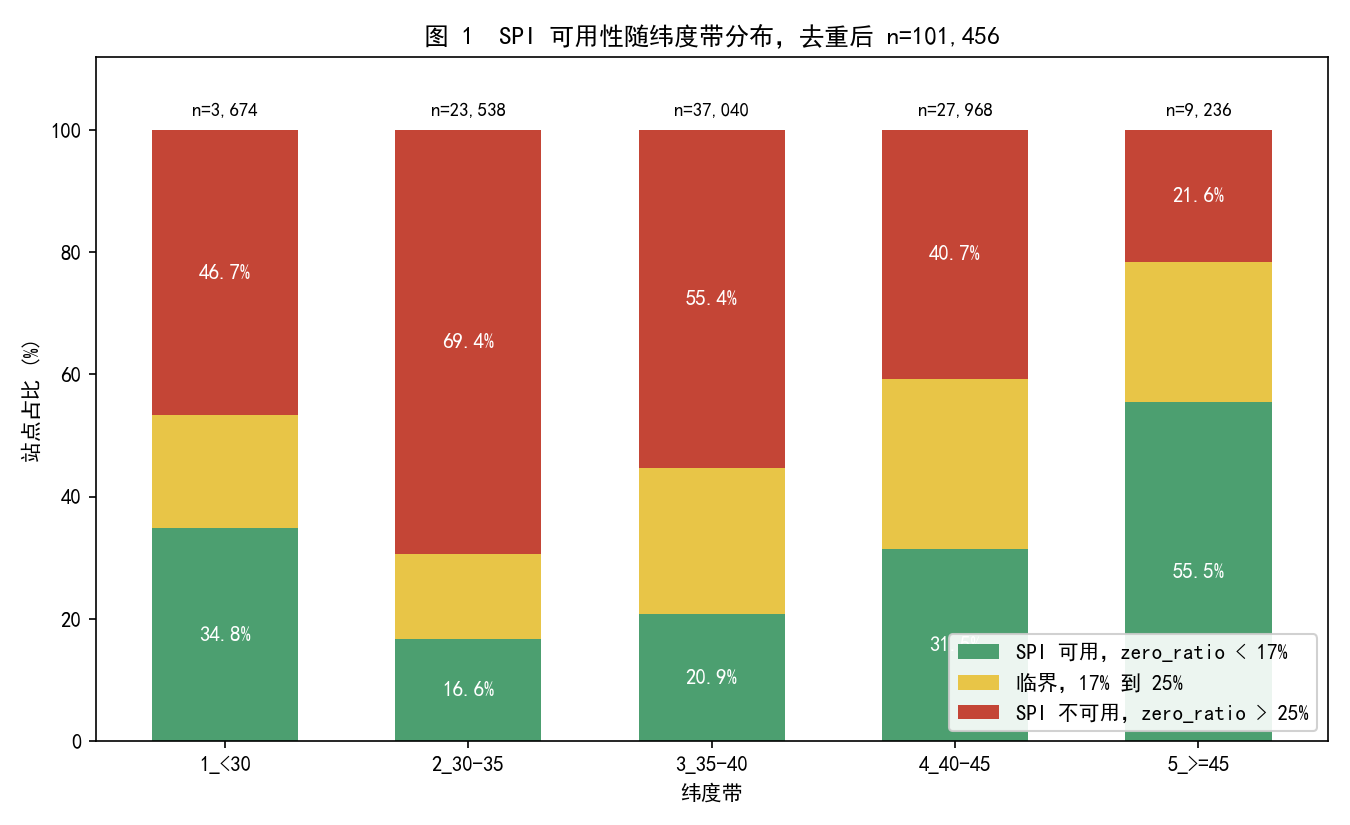
三段堆叠柱状图,从下到上依次是绿色(SPI 可用,zero_ratio < 17%)、黄色(临界,17% 到 25%)、红色(SPI 不可用,zero_ratio > 25%)。柱顶标了每带的站点数。
从图上能读出四件事。
-
第一,失效比例不是随纬度单调变化的,而是呈"两头轻、中间重"的形态。红色段在 2_30-35 带最高,达到 69.4%,然后往南北两侧递减。5_>=45 带的红色段只有 21.6%,1_<30 带是 46.7%。这说明 SPI 失效最严重的纬度带不是极端高纬也不是极端低纬,而是中低纬 30 到 35°N。
-
第二,绿色段和红色段几乎完全反相。绿色在 5_>=45 带最高,达到 55.5%,在 2_30-35 带最低,只有 16.6%。红色在 5_>=45 带最低,在 2_30-35 带最高。两段加起来的趋势是相反的,说明"可用"和"不可用"是同一个纬度因子的两面。
-
第三,黄色段(临界)在各带之间变化不大,大致在 14% 到 28% 之间,没有红色段那么剧烈的起伏。这说明纬度对 SPI 的影响主要是把站点从"可用"推向"不可用",而不是推向"临界"。临界带更像一个过渡区,不是终点。
-
第四,柱顶的 n 差异很大。3_35-40 带有 37,040 个站,占全量 101,456 的 36.5%,是样本最多的带;5_>=45 带只有 9,236 个站,是样本最少的带。在解读 5_>=45 带的 55.5% 可用率时,样本量小是一个需要注意的点,虽然比例差异已经足够大,但置信区间会比中间带更宽。
5.2 图 2:mean_zero_ratio 与 mean_spi_std 随纬度带变化
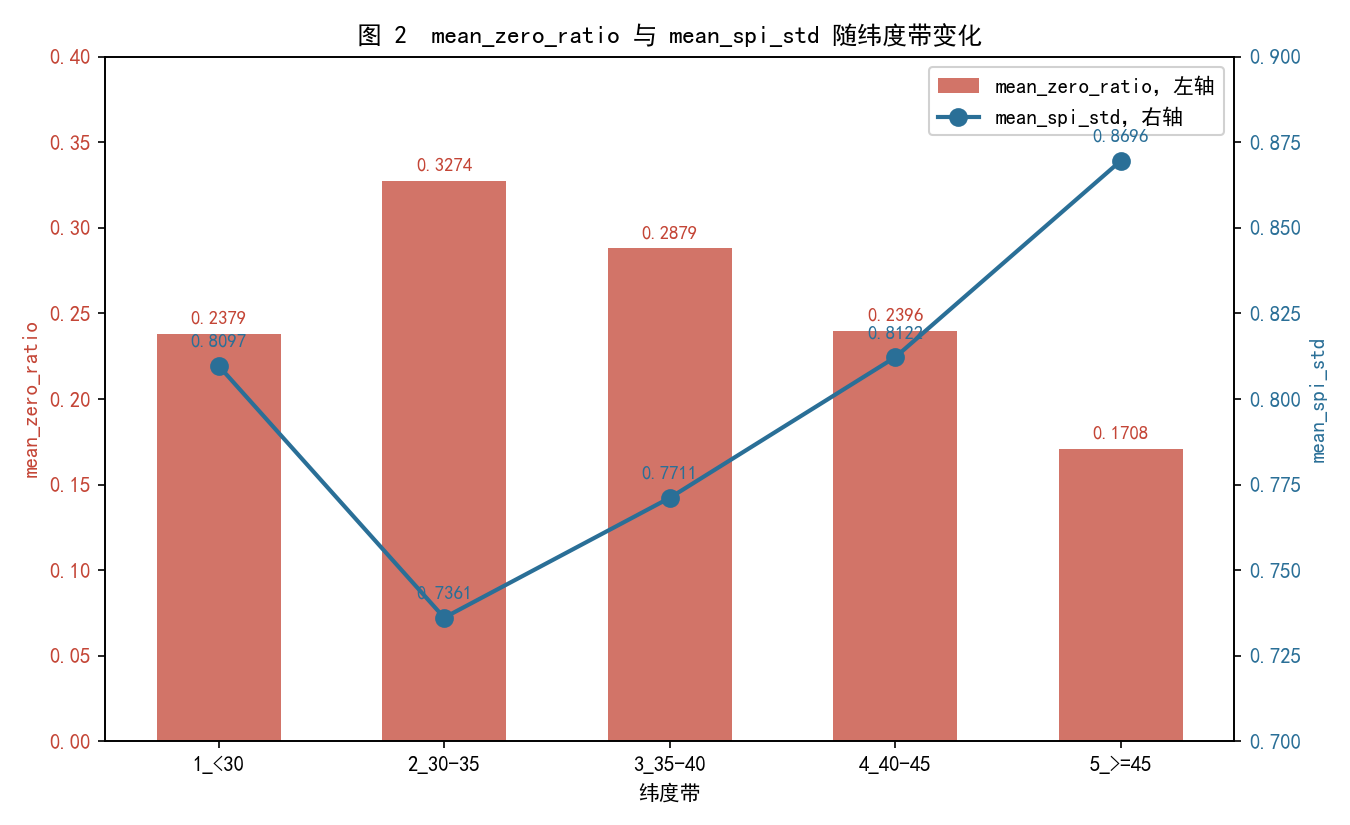
双轴图,左轴是 mean_zero_ratio(红柱),右轴是 mean_spi_std(蓝线加圆点)。
从图上能读出三件事。
-
第一,两个量完全反相。mean_zero_ratio 在 2_30-35 带达到峰值 0.3274,同时 mean_spi_std 在该带达到谷值 0.7361。到 5_>=45 带,mean_zero_ratio 降到 0.1708,mean_spi_std 升到 0.8696。两条曲线像镜像一样。这印证了图 1 的结论,zero_ratio 高的地方,SPI 标准化后的离散度也低,SPI 越不可用。
-
第二,转折点在 2_30-35 带。从 1_<30 到 2_30-35,mean_zero_ratio 从 0.2379 跳升到 0.3274,涨了 0.09;从 2_30-35 到 5_>=45,又一路降到 0.1708。这个转折和 A10 全局统计给出的 SPI 可用性边界在空间上的分布完全对上。
-
第三,右轴的刻度是 0.70 到 0.90,蓝线从 0.7361 升到 0.8696,跨度 0.1335,占右轴量程的 66.75%。如果只看绝对数值,0.7361 和 0.8696 差得不算大,但因为右轴放大了这个区间,视觉上看起来差异很明显。报告里引用数值时要注意这一点,不要把视觉差异当成绝对差异。
5.3 图 3:spi_std 滑动平均沿纬度变化
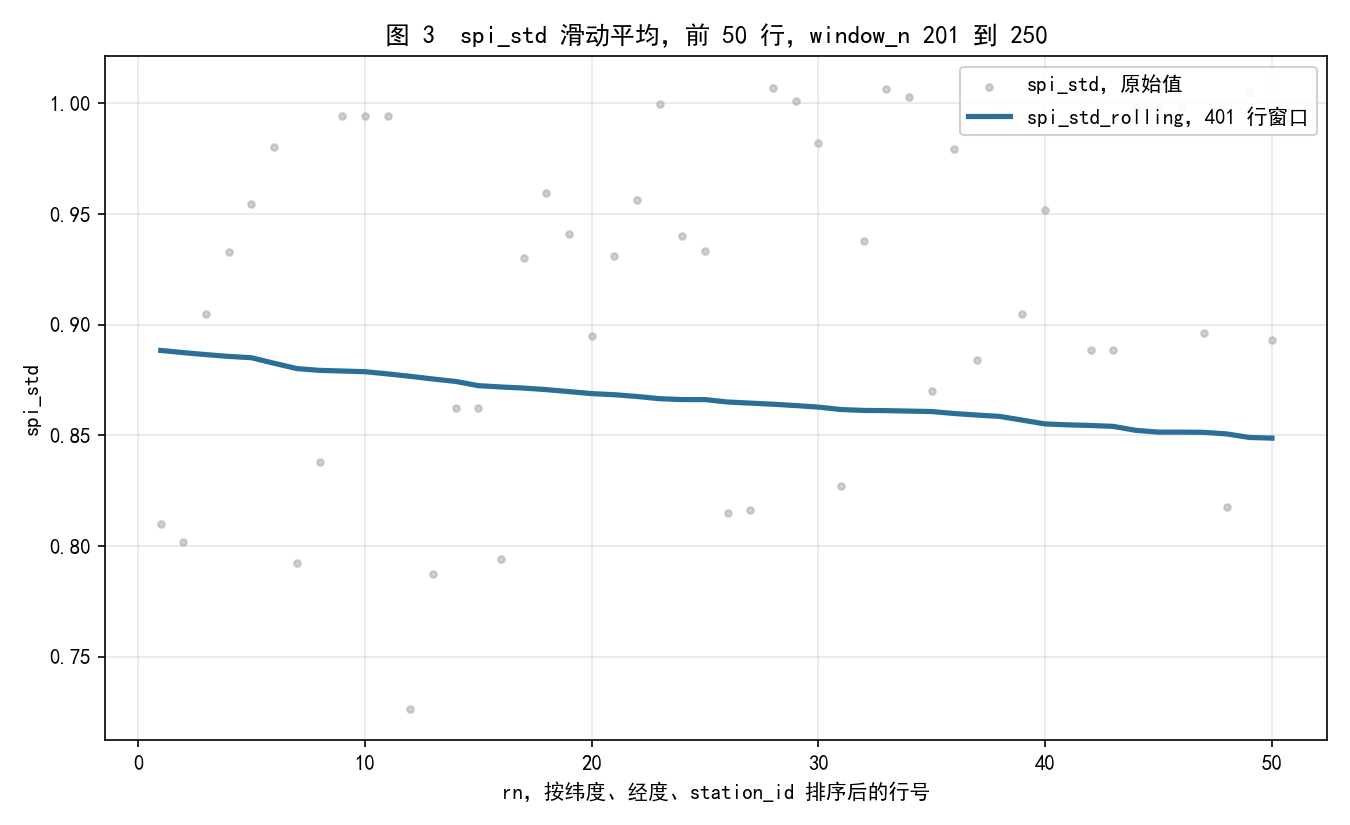
散点加折线图。灰色散点是原始 spi_std,蓝色实线是 401 行窗口的滑动平均。
从图上能读出三件事。
-
第一,滑动平均确实平滑。原始 spi_std 在 0.72 到 1.01 之间大幅波动,散点分散得很开。滑动平均线从 0.8884 平滑降到 0.8488,波动幅度只有 0.04,把单站之间的随机差异压掉了。
-
第二,前 50 行里滑动平均是下降的,但下降很缓慢。从 rn=1 到 rn=50,平均每行下降 0.0008。这个斜率不大,说明在低纬这一段,spi_std 的纬度趋势是渐变的,不是突变的。
-
第三,图上只显示了前 50 行,对应纬度大约在 24.8°N 到 25.8°N 之间,是全量数据里纬度最低的一段。这一段恰好落在 1_<30 带里。要看到 30 到 35°N 的 spi_std 谷值,需要看更靠后的行。所以图 3 的解读要限定在低纬段 spi_std 平缓下降这个范围内,不能外推到全纬度。
所有数据和脚本点这里(站内)
6. 阶段总结
A11 把 A1 到 A10 的产出合并成了一张 108,325 行、38 列的站点级宽表,但真正的难点不是 JOIN,是粒度对齐。A5 逐日要聚合成站点级,A6 stats 每站每年要再聚合一次,主键集合三套,分别是 108,325、102,430、102,395,要 LEFT JOIN 对齐。这些工作在 pandas 里是几行代码,但想清楚需要花时间。
踩的坑主要有三个。第一个是宽表重复行,A8 主表本身有 6,834 行完全重复,导致 TOP 5 和纬度带统计被加权,加了 ROW_NUMBER() PARTITION BY 去重后才对上 A10 的唯一站点数 101,456。第二个是 A6 events 覆盖率只有 3.76%,任何用 n_events 的分析都得带前提。第三个是多个 station_id 共用同一经纬度,空间分析要打折扣。
Hive 窗口函数演示做了三个查询。查询 1 是分区排名,查询 2 是滑动窗口,查询 3 是核心。查询 3 用 CASE WHEN 把 A10 的 SPI 可用性边界落到纬度带上,发现 SPI 失效在 30 到 40°N 最严重,45°N 以上最轻。这是 A10 没做过、A11 才能做的分析。
查询 2 的第一个版本踩了一个窗口函数的坑。只按 latitude、station_id 排序时,键有重复会导致行序抖动,window_n 出现 210、211、209 这种非单调情况。加 ROW_NUMBER() 做确定性排序后,window_n 单调从 201 涨到 250,滑动平均才平滑。
A11 的关键工程决策是 Python 为主,Hive 为辅,不走 MR。A9-2 测出 MR 盈亏平衡点在 7,812 站,A11 宽表 108,325 站按理该走 Hadoop。但 A9-2 测的是计算,A11 做的是集成,集成的主要成本在数据搬运,而 A5 的重活已经在 MR 里干完了。Hive 降级为查询演示引擎,不重跑 JOIN。
一句话概括 A11 的核心工作,数据集成不是建表 JOIN,先要做粒度对齐、字段映射、主键对齐,然后才是 JOIN。这三个步骤里,粒度对齐最容易出错,主键对齐最容易被忽略,字段映射最容易被名字骗,比如 q_zero 和 zero_ratio。
7. A1 到 A11 闭环与已知未验证方向
A11 是快速实验篇的最后一块拼图。回看整个 A1 到 A11,主线是清楚的。
A1 到 A3 是数据准备与基础统计,确定 102,430 个站点、每站 90 天。A4 到 A5 是干旱等级判定,从绝对阈值到站内百分位数,产出逐日等级。A6 到 A8 是时间聚合、事件识别、空间合并,产出站点级属性表。A9 到 A10 是相关分析与 SPI 标准化,引入气象因子和标准化维度。A11 是数据集成,把以上所有产出合并到一张宽表,并用 Hive 窗口函数做跨维度分析。
至此,A1 到 A11 构成完整闭环。从原始气象数据出发,经逐日干旱判定、年度聚合、事件检测、空间合并、相关分析、SPI 标准化,最终集成到一张宽表,并用窗口函数把 A10 的 SPI 可用性结论落到纬度带上。这条主线上每一步都有明确的输入、输出和验证方式,没有留下断点。
A11 留下一个已知未验证方向。SPI 失效严重的纬度带,也就是 30 到 40°N,是否也是气象因子相关性弱的纬度带?这个问题需要把查询 3 的纬度带统计和 A9-1 的六组相关系数做交叉验证。A11 宽表已经同时包含这两组字段,从数据上是可做的,但 A11 的定位是收尾,不再开新的分析实验。这个问题留作后续总结篇的一个待挖掘方向,而不是 A11 的实验任务。