Hive 从入门到实战(一):Hive 是什么?架构解析与 3.1.3 安装部署实录
本文介绍Hive作为基于Hadoop的数据仓库工具,通过类SQL(HQL)实现对HDFS结构化数据的分析。文章解析其架构:用户接口、元数据存储(Metastore)、驱动器(四步执行流程),并以"点菜-后厨"类比阐明其核心价值------降低大数据分析门槛。详细演示了在CentOS 7环境下部署Hive 3.1.3的六步流程,包括环境准备、配置文件设置、元数据库初始化及服务启动,并强调元数据存于MySQL、真实数据在HDFS的分离特性。最后通过建表查数验证功能,为后续实战打下基础。
目录
- 一、为什么要学 Hive:从 MapReduce 的痛点说起
- 二、Hive 是什么:一句话定义 + 一个类比
- 三、Hive 架构解析:一条 SQL 的完整旅程
- 四、安装部署:六步走
- 五、上手验证:建表、传数据、查询
- 六、Hive 整合 Yarn
- 七、常见踩坑
- 八、总结
一、为什么要学 Hive:从 MapReduce 的痛点说起
学大数据绕不开 Hadoop。但真正用 MapReduce 写过一个 WordCount 的人都知道那种痛苦:
- 统计一个单词出现次数,要写 Mapper、Reducer、Driver 三个 Java 类
- 每次改需求都要重新打包、上传、运行
- 一个稍微复杂的统计(比如分组求平均再过滤),代码量直线上升
而同样的事情,用 SQL 只需要一行:
sql
select word, count(1) from lines group by word;问题是:HDFS 上存的文件,SQL 能直接查吗?
答案是不能------除非有人帮我们把 SQL 翻译成 MapReduce 程序。这个"翻译官",就是 Hive。
二、Hive 是什么:一句话定义 + 一个类比
2.1 一句话定义
Hive 是基于 Hadoop 的一个数据仓库工具 ,可以将 HDFS 上的结构化数据文件映射成一张表 ,并提供类 SQL 查询功能。
拆开看三个关键词:
| 关键词 | 含义 |
|---|---|
| 数据仓库工具 | 它不是数据库,是"存数据 + 做分析"的工具 |
| 映射成表 | HDFS 文件本来只是文本,Hive 给它套上"表结构"的外壳 |
| 类 SQL 查询 | 写的是 HiveQL(HQL),底层自动翻译成 MapReduce |
2.2 一个类比:点菜与后厨
把 Hive 想象成一家餐厅:
- 你(分析人员):看菜单点菜,只管说"我要一个红烧肉"(写 SQL)
- Hive:服务员,把你的话翻译成后厨能执行的指令
- MapReduce / Yarn:后厨,真正干活的人
- HDFS:仓库,所有食材(数据)都放在这里
你全程不需要知道后厨怎么炒菜,只需要会说"菜名"(SQL)。这就是 Hive 的价值:降低大数据分析门槛,会 SQL 就能玩大数据。
2.3 数据库 vs 数据仓库:别搞混
新手最容易问:"Hive 和 MySQL 有什么区别?不就是存数据查数据吗?"
| 对比项 | MySQL(OLTP 事务型) | Hive(OLAP 分析型) |
|---|---|---|
| 定位 | 业务系统,处理订单、注册等事务 | 数据仓库,做统计分析 |
| 操作特点 | 增删改查单条记录,毫秒级响应 | 全表扫描做聚合统计,秒到分钟级 |
| 数据量 | GB 级 | TB / PB 级 |
| 更新删除 | 随时支持 | 默认不支持行级 update / delete |
| 底层 | 自己的存储引擎 | HDFS 存储 + MapReduce 计算 |
一句话记忆:MySQL 管"做生意",Hive 管"做分析"。所以别拿 Hive 的查询速度去和 MySQL 比,也没法在 Hive 里像 MySQL 那样频繁改一行数据。
三、Hive 架构解析:一条 SQL 的完整旅程
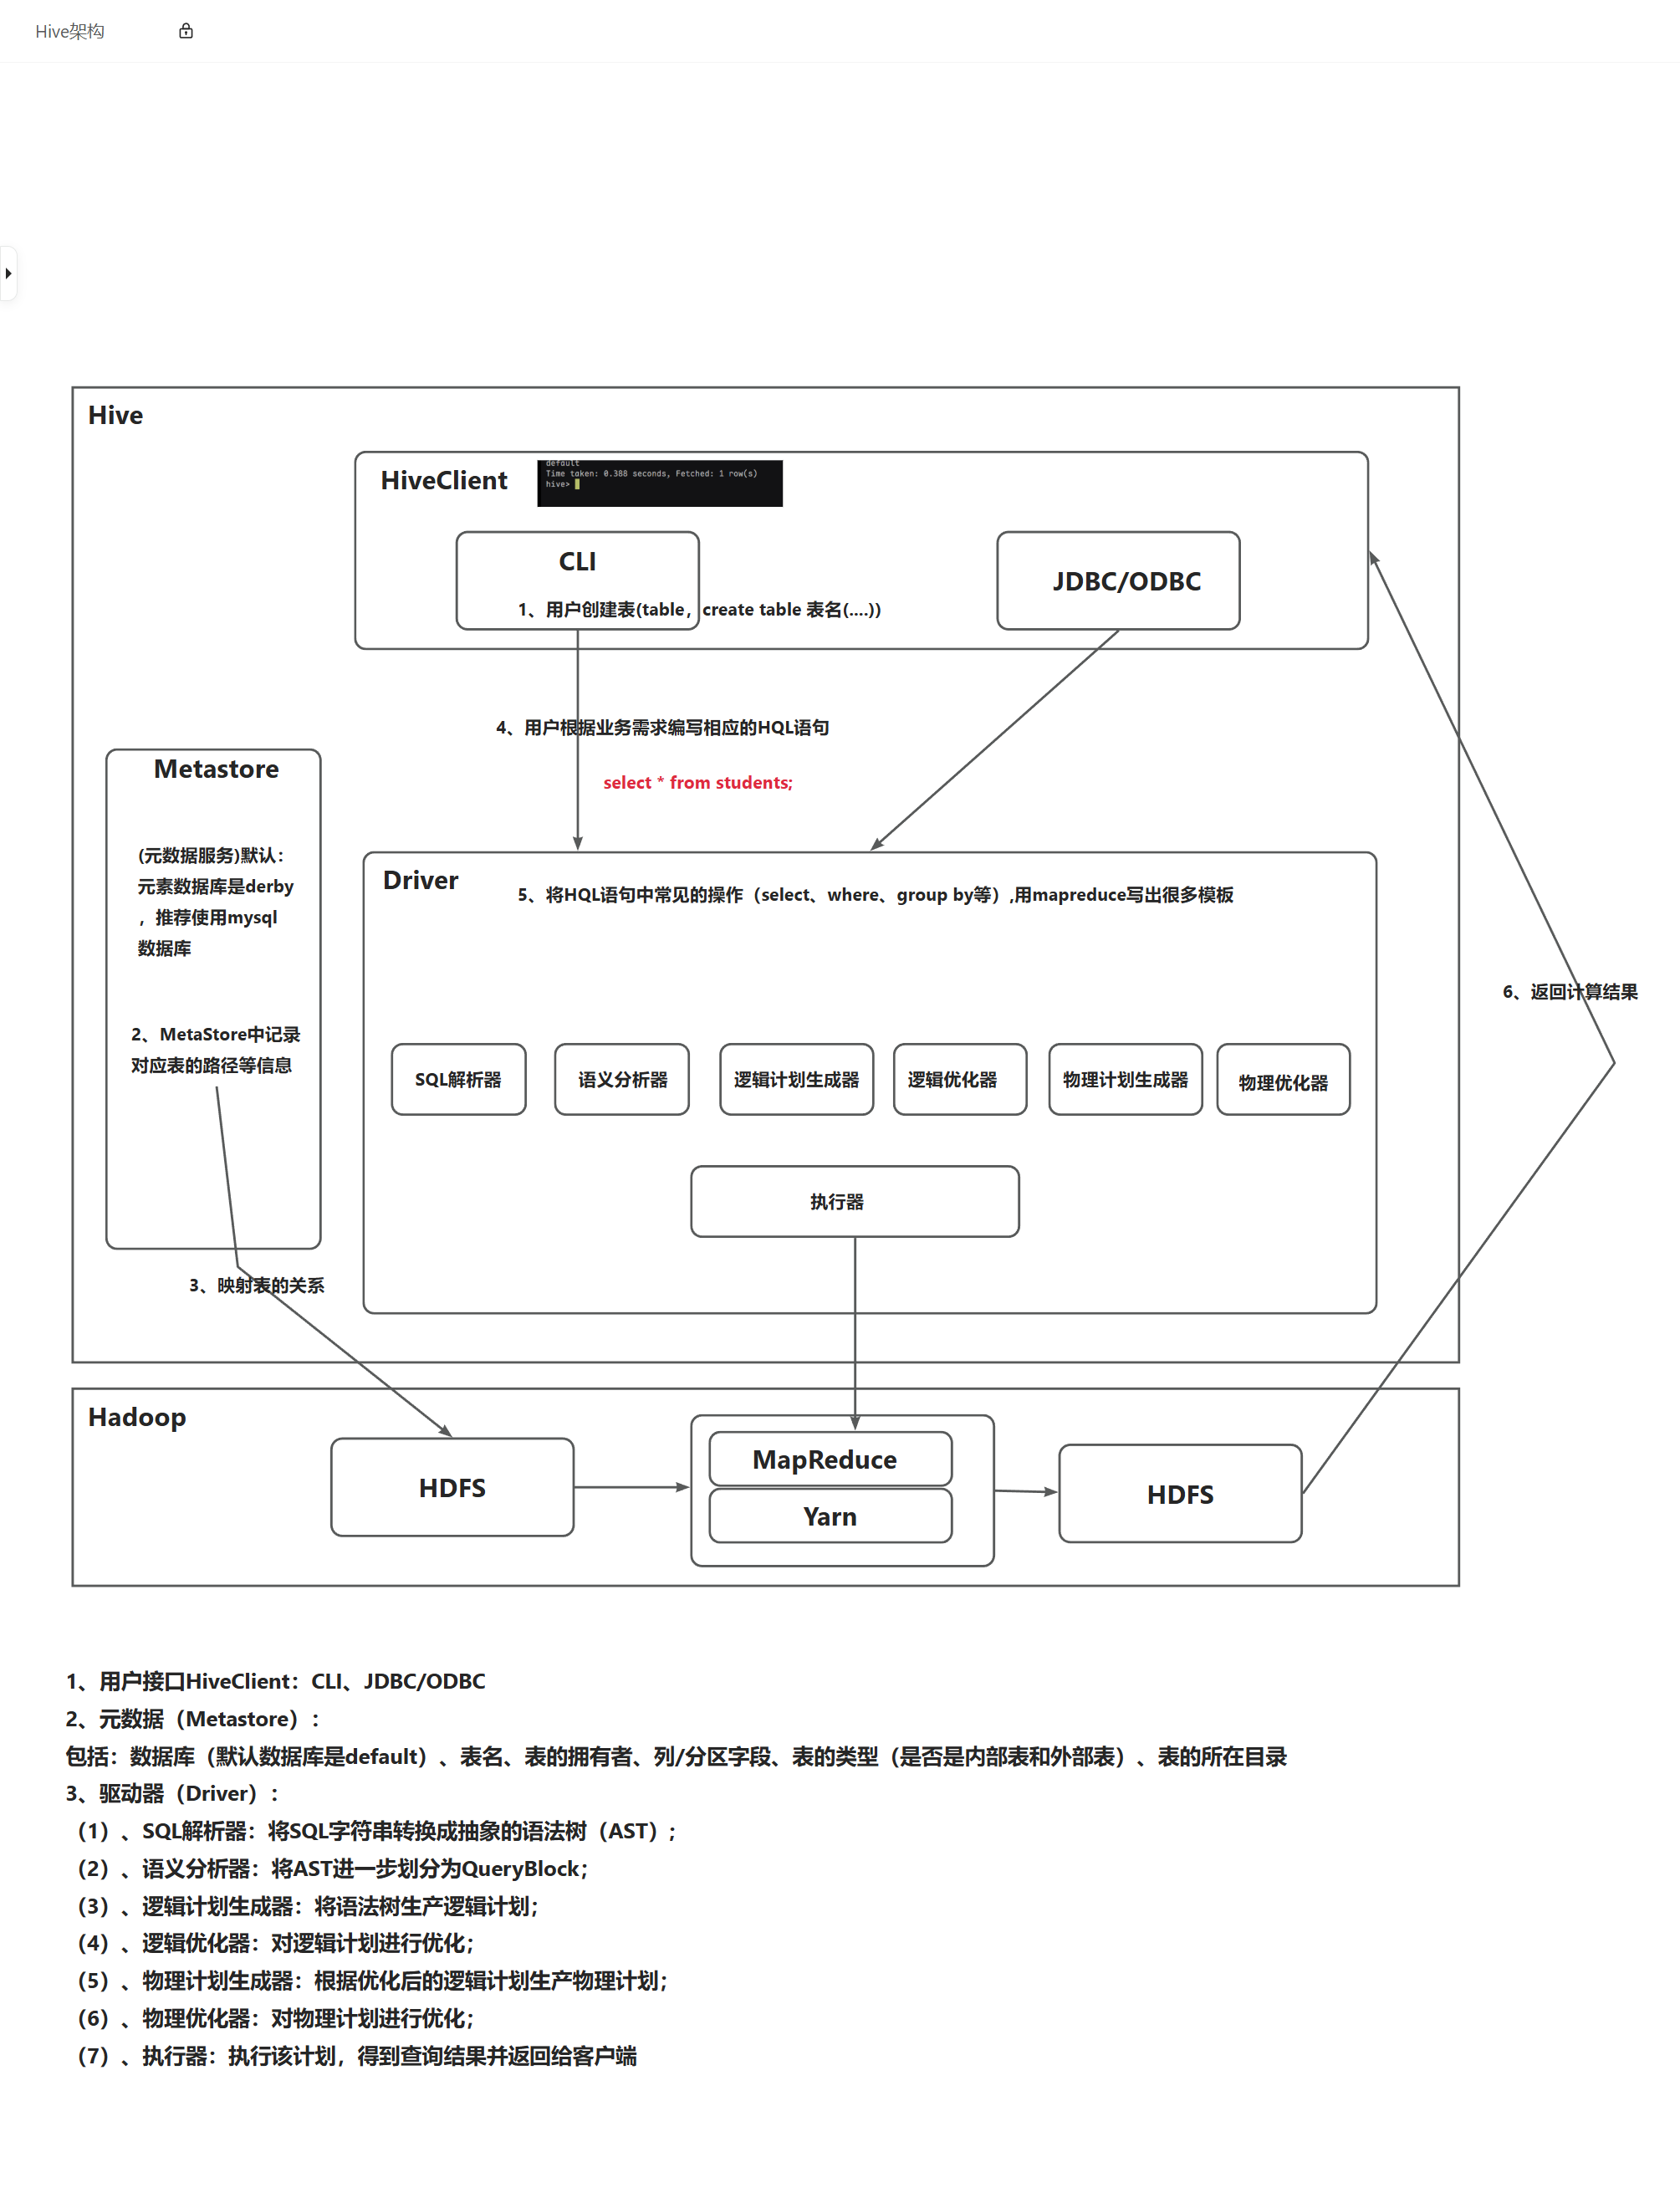
Hive 由三大部分组成:
3.1 用户接口层(Client)
和 Hive 打交道的入口有三种:
- CLI :命令行,就是敲
hive命令进入的那个黑窗口,本文主要用它 - JDBC / ODBC:通过 HiveServer2 服务远程连接(DBeaver、DataGrip 等图形工具走这条路)
- Web UI:浏览器界面,很少用
3.2 元数据存储(Metastore)
Metastore 是 Hive 的"户口本"。它记录了:
- 有哪些库、哪些表
- 每张表有哪些字段、什么类型
- 每张表的数据实际存在 HDFS 的哪个路径下
注意两个容易懵的点:
- 元数据存在 MySQL 里,不是 HDFS 里。所以装 Hive 前必须先装 MySQL。
- 真正的数据从来不在 Hive 里,一直在 HDFS 上。Hive 只是"登记了住址",本身不存数据。
类比:HDFS 是一栋楼里的住户(数据),Metastore 是物业的住户登记表(元数据)。你说"查查 3 单元的住户"(查表),物业先翻登记表(读元数据),再去楼里找人(读 HDFS 数据)。
3.3 驱动器(Driver):SQL 的四道工序
一条 HQL 从提交到出结果,要经过 Driver 的四步加工:
HQL → 解析器 → 编译器 → 优化器 → 执行器 → MapReduce → HDFS
(词法/语法检查) (生成逻辑计划) (优化执行计划) (变成物理MR任务)| 组件 | 干什么 | 类比 |
|---|---|---|
| 解析器 Parser | 检查 SQL 语法对不对,表存不存在 | 初审:格式合规吗 |
| 编译器 Compiler | 把 SQL 变成逻辑执行计划(先查什么后查什么) | 起草方案 |
| 优化器 Optimizer | 合并、裁剪、优化执行步骤 | 方案打回重写,挑最省力的 |
| 执行器 Executor | 把计划变成 MapReduce 任务丢给 Yarn 执行 | 派单后厨 |
理解这条链路非常重要:后面学分区裁剪(第 4 篇)、ORC 列式存储(第 5 篇),本质都是在"优化器"这一环帮你少干活,从而提速。
四、安装部署:六步走
0)前置条件
- Hadoop 3.1.3 已安装并能正常启动(Hive 跑在它上面)
- MySQL 已安装,且知道 root 密码(存元数据用)
- MySQL 的 JDBC 驱动包 (如
mysql-connector-java-5.1.x.jar)已拷贝到 Hive 的lib目录
1)上传解压,配置环境变量
shell
# 上传 hive-3.1.3.tar.gz 后解压
tar -xvf hive-3.1.3.tar.gz

# 配置环境变量
vim /etc/profile

# 追加以下两行
export HIVE_HOME=/usr/local/soft/hive-3.1.3
export PATH=$PATH:$HIVE_HOME/bin

# 让配置生效
source /etc/profile
注意:
HIVE_HOME要改成你自己的解压路径,后面所有配置都用同一个路径,保持一致。
2)修改配置文件 hive-site.xml
进入 conf 目录,创建 hive-site.xml,核心是告诉 Hive:元数据存到哪个 MySQL 里。
xml
<configuration>
    <!-- 元数据库连接:MySQL -->
    <property>
        <name>javax.jdo.option.ConnectionURL</name>
        <value>jdbc:mysql://master:3306/metastore</value>
        <description>metastore 库不存在时,可加 ?createDatabaseIfNotExist=true</description>
    </property>
    <property>
        <name>javax.jdo.option.ConnectionDriverName</name>
        <value>com.mysql.jdbc.Driver</value>
    </property>
    <property>
        <name>javax.jdo.option.ConnectionUserName</name>
        <value>root</value>
    </property>
    <property>
        <name>javax.jdo.option.ConnectionPassword</name>
        <value>123456</value>
    </property>
    <!-- Hive 数据在 HDFS 上的默认仓库目录 -->
    <property>
        <name>hive.metastore.warehouse.dir</name>
        <value>/user/hive/warehouse</value>
    </property>
</configuration>| 参数 | 作用 | 怎么改 |
|---|---|---|
| ConnectionURL | 元数据存到哪个 MySQL 的哪个库 | 主机名/库名按自己环境改 |
| ConnectionDriverName | MySQL 驱动类名 | 5.x 用 com.mysql.jdbc.Driver,8.x 用 com.mysql.cj.jdbc.Driver |
| UserName / Password | MySQL 账号密码 | 按自己环境改 |
| warehouse.dir | 建表后数据默认落在 HDFS 的哪里 | 一般不动 |
3)初始化元数据库
shell
schematool -dbType mysql -initSchema运行输出(节选):
Metastore connection URL:	 jdbc:mysql://master:3306/metastore
Metastore Connection Driver :	 com.mysql.jdbc.Driver
Metastore connection User:	 root
Starting metastore schema initialization to 3.1.0
Initialization script hive-schema-3.1.0.mysql.sql
...
schemaTool completed
看到 schemaTool completed 就成功了。这一步的本质是:在 MySQL 里建几十张系统表 (比如 TBLS 存表信息、COLUMNS_V2 存字段信息),作为 Hive 的元数据库。
4)启动服务:流程和顺序不能乱
启动 Hive 不是敲一条命令就完事,它有一串依赖关系,顺序错了必然报错。先看全景流程:
① 启动 Hadoop          start-all.sh          → HDFS 存数据、Yarn 调度计算
        ↓
② MySQL 保持运行        (通常开机自启)        → 元数据的"仓库",metastore 要连它
        ↓
③ 启动 metastore        hive --service metastore   → 元数据读写入口,端口 9083
        ↓
④ 启动 hiveserver2      hive --service hiveserver2 → JDBC 远程入口,端口 10000(可选)
        ↓
⑤ 客户端接入            hive CLI 或 DataGrip 等
为什么要按这个顺序? 理解依赖链就记住了:
- Hadoop 必须先起:Hive 建表要往 HDFS 写目录,查询要提交 MR 到 Yarn,底层不在线全是空谈
- MySQL 必须先通:metastore 启动第一件事就是连 MySQL 读写元数据表,连不上直接启动失败
- metastore 必须先于 hiveserver2:hiveserver2 接到任何一条查询,都要先经 metastore 查"这张表存在吗、字段是啥、数据在哪",入口没开它就是瞎子
确认依赖都在线后,按顺序启动两个 Hive 服务:
shell
# ③ 启动 hive 元数据服务(必须启动)
nohup hive --service metastore >> metastore.log 2>&1 &

# ④ 启动 hiveserver2 服务(需要远程连接 hive 时启动)
nohup hive --service hiveserver2 >> hiveserver2.log 2>&1 &
启动命令逐段拆解(新手最容易懵的一行):
| 片段 | 含义 |
|---|---|
hive --service metastore |
以"服务模式"启动 Hive 的 metastore 组件 |
nohup |
挂到系统后台,关闭终端后服务不会被杀 |
>> metastore.log |
运行日志追加写入 metastore.log(排错就看它) |
2>&1 |
错误输出也一并写进同一个日志文件 |
结尾 & |
命令放入后台执行,立刻释放当前终端 |
两个服务的分工:
| 服务 | 作用 | 什么时候要启动 |
|---|---|---|
| metastore | 对外提供元数据读写服务 | 必须启动,没它啥也干不了 |
| hiveserver2 | 提供 JDBC 接口 | 只在本机 CLI 敲命令可不启动;要用 DBeaver/DataGrip 远程连就必须启动 |
启动后验证三连(养成习惯,别急着用,先确认服务真起来了):
shell
# ① jps 看进程:两个 RunJar 分别对应 metastore 和 hiveserver2
jps1234 NameNode
5678 DataNode
9012 ResourceManager
3456 NodeManager
7890 RunJar ← metastore
2468 RunJar ← hiveserver2
shell
# ② 看端口:9083 = metastore,10000 = hiveserver2
netstat -nltp | grep -E "9083|10000"

# ③ 翻日志确认没有 ERROR
tail -200f metastore.log
关闭时与启动顺序相反 :先退出客户端,再关 hiveserver2,再关 metastore,最后 stop-all.sh 关 Hadoop。服务用 kill <RunJar的PID> 优雅退出即可。
顺序错了会怎样(报错对照表):
| 错误操作 | 典型报错 |
|---|---|
| Hadoop 没启动就建表/查询 | HDFS 连接失败、NameNode 相关异常 |
| metastore 没启动就进 hive | Could not connect to meta store using any of the URIs provided |
| hiveserver2 没启动就连 DataGrip | 连接被拒绝 / Connection refused |
5)进入 Hive
shell
hive看到熟悉的 hive> 提示符,安装完成。
敲下 hive 这条命令后发生了什么?CLI 会先连 metastore 拉取库和表的元数据(所以 3.2 节才说 metastore 必须先启动),之后你写的每条 SQL 都会走 3.3 节的"四道工序"变成 MapReduce 任务执行。
五、上手验证:建表、传数据、查询
5.1 建一张学生表
sql
CREATE TABLE students(
    id string ,
    name string ,
    age string  ,
    gender string  ,
    clazz string
)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
STORED AS INPUTFORMAT 'org.apache.hadoop.mapred.TextInputFormat'
    OUTPUTFORMAT 'org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat'
location '/data/students';
先不用纠结每个关键字(第 2 篇 DDL 会逐个拆解),只需要知道:
FIELDS TERMINATED BY ',':CSV 文件按逗号切列location '/data/students':这张表的数据指向 HDFS 的/data/students目录
5.2 建目录、传数据
shell
hdfs dfs -mkdir -p /data/students
hdfs dfs -put students.csv /data/students
5.3 查询:统计每个班的人数
sql
select clazz, count(1) from students
group by clazz;
输出示例(数据不同结果不同,重点看形式):
WARN: The method class org.apache.hadoop.hive... has been deprecated
Query ID = root_2026xxxxxxxxxxxx
Total jobs = 1
Launching Job 1 out of 1
...
MapReduce Jobs Launched:
Stage-Stage-1: Map: 2  Reduce: 1   Cumulative CPU: 5.32 sec   HDFS Read: 15234 HDFS Write: 210 SUCCESS
Total MapReduce CPU Time Spent: 5 seconds 320 msec
OK
clazz      _c1
理科一班    25
理科二班    22
文科一班    21
文科二班    18
Time taken: 18.05 seconds, Fetched: 4 row(s)注意细节:查询真的提交了 MapReduce 任务 (Launching Job、Map: 2 Reduce: 1),这就是 2.2 节说的"翻译官"在工作。这也解释了为什么 Hive 查询普遍要十几秒起步------MR 任务启动开销大。
5.4 测试大表:卡口车流数据
sql
create table gateway_records(
    plate_number string comment '车牌号',
    gateway_id  string comment '卡口编号',
    city string comment '卡口所在城市',
    car_brand string comment '车辆品牌',
    road_id string comment '道路编号',
    speed double comment '车辆速度',
    travel_direction string comment '车辆行驶方向'
)ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
STORED AS INPUTFORMAT 'org.apache.hadoop.mapred.TextInputFormat'
    OUTPUTFORMAT 'org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat'
location '/data/records';

-- 统计每个城市的车辆记录数
select city, count(1) as num from
gateway_records
group by
city;
这张大表是全系列的"性能测试基准":第 5 篇我们会用它实测 TEXTFILE / ORC / PARQUET 三种存储格式的查询耗时差异(26 秒 vs 17 秒)。
5.5 再测一个:统计每个学生的总分
sql
CREATE TABLE scores(
    id string ,
    cid string ,
    score double
)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
STORED AS INPUTFORMAT 'org.apache.hadoop.mapred.TextInputFormat'
    OUTPUTFORMAT 'org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat'
location '/data/scores';

select
    id,
    sum(score) as sum_score
from
    scores
group by
    id;
输出示例:
id        sum_score
1001      263.0
1002      247.0
1003      216.0
Time taken: 15.72 seconds, Fetched: 3 row(s)
六、Hive 整合 Yarn
Hive 执行 SQL 要提交 MapReduce 任务,而 MR 任务的资源调度由 Yarn 负责。如果还没整合,需要修改 Hadoop 的配置:
shell
cd /usr/local/soft/hadoop-3.1.3/etc/hadoop
vim mapred-site.xml
增加两个配置:
xml
<property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
</property>

<property>
    <name>mapreduce.application.classpath</name>
    <value>/usr/local/soft/hadoop-3.1.3/etc/hadoop:/usr/local/soft/hadoop-3.1.3/share/hadoop/common/lib/*:/usr/local/soft/hadoop-3.1.3/share/hadoop/common/*:/usr/local/soft/hadoop-3.1.3/share/hadoop/hdfs:/usr/local/soft/hadoop-3.1.3/share/hadoop/hdfs/lib/*:/usr/local/soft/hadoop-3.1.3/share/hadoop/hdfs/*:/usr/local/soft/hadoop-3.1.3/share/hadoop/mapreduce/lib/*:/usr/local/soft/hadoop-3.1.3/share/hadoop/mapreduce/*:/usr/local/soft/hadoop-3.1.3/share/hadoop/yarn:/usr/local/soft/hadoop-3.1.3/share/hadoop/yarn/lib/*:/usr/local/soft/hadoop-3.1.3/share/hadoop/yarn/*</value>
</property>| 配置 | 作用 |
|---|---|
mapreduce.framework.name=yarn |
让 MR 程序跑在 Yarn 上(本地模式改为集群模式) |
mapreduce.application.classpath |
告诉 Yarn 去哪里找 Hadoop 的类包,避免运行时 ClassNotFoundException |
然后重启 Hadoop 使配置生效:
shell
stop-all.sh
start-all.sh
七、常见踩坑
坑 1:schematool 报 Version information not found in metastore
原因:没初始化或初始化失败。回到第 3 步重新执行 schematool -dbType mysql -initSchema,注意先保证 MySQL 能连上。
坑 2:报 ClassNotFoundException: com.mysql.jdbc.Driver
原因:MySQL 的 JDBC 驱动 jar 没放进 hive-3.1.3/lib 目录。拷进去再初始化。
坑 3:Guava 版本冲突(Hive 3.1.3 + Hadoop 3.1.3 经典坑)
现象:启动或执行时报 NoSuchMethodError,涉及 com.google.common 包。
解决:用 Hadoop 的新版 Guava 替换 Hive 的旧版:
shell
# 删掉 hive 的旧版
rm /usr/local/soft/hive-3.1.3/lib/guava-19.0.jar
# 拷贝 hadoop 的新版
cp /usr/local/soft/hadoop-3.1.3/share/hadoop/common/lib/guava-27.0-jre.jar /usr/local/soft/hive-3.1.3/lib/
坑 4:连接报 Could not connect to meta store
原因:metastore 服务没启动。执行第 4 步的启动命令,看 metastore.log 排错。
坑 5:CREATE TABLE ... LOCATION '/data/students' 报权限错误
HDFS 的目标目录要给 Hive 当前用户读写权限,或提前手动 hdfs dfs -mkdir 并 chmod。
八、总结
- Hive = SQL 翻译官:把 HQL 翻译成 MapReduce,让会 SQL 的人也能做大数据分析
- 元数据在 MySQL,数据在 HDFS:Hive 本身不存数据,只存"户口"
- 一条 SQL 的旅程:解析 → 编译 → 优化 → 执行,最终跑的是 MR 任务
- 部署核心四步:配 hive-site.xml → 初始化元数据库 → 启动 metastore → 测试
装好了,下一篇正式玩 SQL:《Hive DDL:数据库与表操作,内部表 vs 外部表一文讲透》------我们建的第一张"表"到底是个什么东西?drop 掉表数据会丢吗?