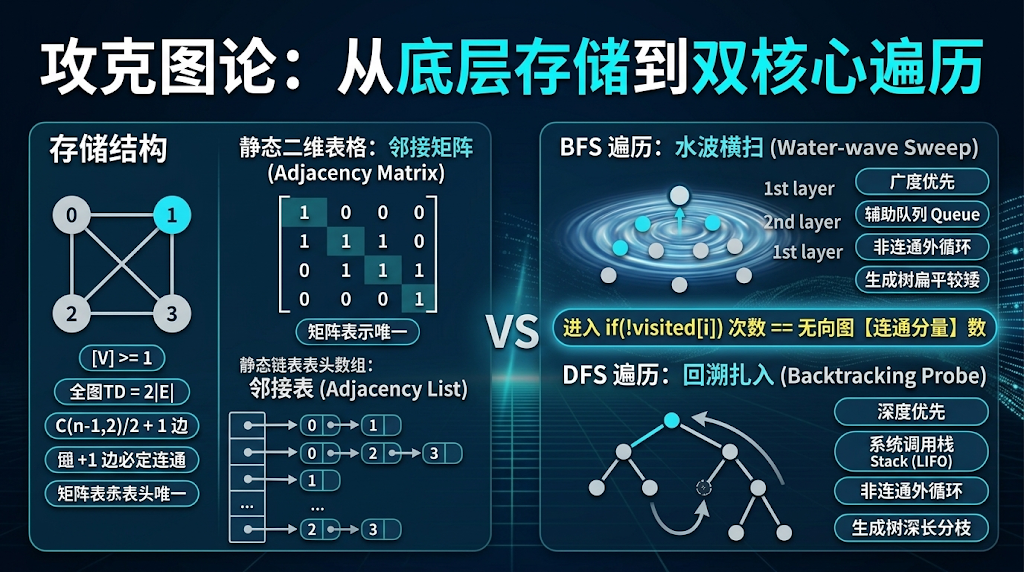
文章目录
- [阶段一:图的基本概念与 408 必考数学性质](#阶段一:图的基本概念与 408 必考数学性质)
-
-
- [第一步:408 核心概念对号入座](#第一步:408 核心概念对号入座)
- 第二步:连通性与连通分量(概念大坑)
-
- [一、 核心概念:什么是"连通图"与"连通分量"?(无向图视角)](#一、 核心概念:什么是“连通图”与“连通分量”?(无向图视角))
- [二、 极易混淆:"强连通图"与"强连通分量"(有向图视角)](#二、 极易混淆:“强连通图”与“强连通分量”(有向图视角))
- [三、 408 必考的"极端情况"推导配图(为什么是这个公式?)](#三、 408 必考的“极端情况”推导配图(为什么是这个公式?))
-
- 阶段二:图的两大存储结构图解与内存剖析
-
-
- [第一部分:邻接矩阵(Adjacency Matrix)------ 静态二维表格](#第一部分:邻接矩阵(Adjacency Matrix)—— 静态二维表格)
-
- [1. 结构本质:用一张棋盘记录"谁和谁之间通不通"](#1. 结构本质:用一张棋盘记录“谁和谁之间通不通”)
- (1)无向图的邻接矩阵
- (2)有向网图的邻接矩阵
- [2. 408 考场标准结构体定义(纯 C 语言)](#2. 408 考场标准结构体定义(纯 C 语言))
- [第二部分:邻接表(Adjacency List)------ 数组 + 单链表](#第二部分:邻接表(Adjacency List)—— 数组 + 单链表)
-
- [1. 结构拆解图](#1. 结构拆解图)
- [2. 408 核心考点与特性对比](#2. 408 核心考点与特性对比)
- [3. 408 考场标准结构体定义(纯 C 语言)](#3. 408 考场标准结构体定义(纯 C 语言))
- 第三部分:两种存储方式的考场优选法则
-
- [阶段三:图的双核心遍历------BFS 与 DFS](#阶段三:图的双核心遍历——BFS 与 DFS)
-
-
- [第一部分:广度优先搜索(BFS)------"水波涟漪 / 推土机式横扫"](#第一部分:广度优先搜索(BFS)——“水波涟漪 / 推土机式横扫”)
-
- [1. 核心思想与现实比喻](#1. 核心思想与现实比喻)
- [2. 底层驱动引擎:【辅助队列(Queue)】](#2. 底层驱动引擎:【辅助队列(Queue)】)
- [3. 字符画流程推演](#3. 字符画流程推演)
- 第二部分:深度优先搜索(DFS)------"一条道走到黑,撞南墙才回头"
-
- [1. 核心思想与现实比喻](#1. 核心思想与现实比喻)
- [2. 底层驱动引擎:【递归 / 系统调用栈】](#2. 底层驱动引擎:【递归 / 系统调用栈】)
- [3. 字符画流程推演(同一张图)](#3. 字符画流程推演(同一张图))
- [第三部分:408 考场满分防踩坑机制------"非连通图外层循环"](#第三部分:408 考场满分防踩坑机制——“非连通图外层循环”)
- [第四部分:BFS 与 DFS 的复杂度与生成树对比](#第四部分:BFS 与 DFS 的复杂度与生成树对比)
-
阶段一:图的基本概念与 408 必考数学性质
树是"一对多"的层次关系,而图是"多对多"的网状关系。任何结点之间都可以互通有无。
第一步:408 核心概念对号入座
图通常记为 G = ( V , E ) G = (V, E) G=(V,E),其中 V V V 是顶点集(Vertices) , E E E 是边集(Edges)。
- 图绝不能为空图!
- 408 陷阱点 :树可以是空树(结点数为 0),但图的顶点集 V V V 必须非空(至少有 1 个顶点) !边集 E E E 可以为空(只有顶点,互相不连线)。
- 无向图 vs 有向图:
- 无向图 :边是双向无序的,用圆括号表示 ( u , v ) (u, v) (u,v),说明 u u u 和 v v v 互通。
- 有向图 :边是有方向的(称为弧),用尖括号表示 ⟨ u , v ⟩ \langle u, v \rangle ⟨u,v⟩,表示从 u u u 指向 v v v( u u u 是弧尾, v v v 是弧头)。
- 顶点的度(Degree):
- 在无向图中:与该顶点相连的边数称为度( T D ( v ) TD(v) TD(v))。
- 在有向图中:分为入度(In-Degree, I D ID ID)和 出度(Out-Degree, O D OD OD) ,该结点的总度数 T D ( v ) = I D ( v ) + O D ( v ) TD(v) = ID(v) + OD(v) TD(v)=ID(v)+OD(v)。
- 408 握手定理(必背求和公式) :
无论是无向图还是有向图,全图所有顶点的度数之和,严格等于总边数(弧数)的 2 倍!
∑ i = 1 n T D ( v i ) = 2 ∣ E ∣ \sum_{i=1}^{n} TD(v_i) = 2\vert{}E\vert{} i=1∑nTD(vi)=2∣E∣
原理:每一条边都连接着两个端点,给两端各贡献了 1 点度数。
第二步:连通性与连通分量(概念大坑)
一、 核心概念:什么是"连通图"与"连通分量"?(无向图视角)
1. 连通图(全国高铁全部通网)
通俗解释 :图里的任意两个城市之间,不管转多少次车,总能有一条路走得通。
text
【这是一个普通的连通图】

        (A) ---------- (B)
         |          /   |
         |        /     |
         |      /       |
         |    /        	|
        (C) ---------- (D)

* 检查:
  - 从 A 能走到 D 吗?可以(A -> B -> D,或者 A -> C -> D)。
  - 任意挑两个点,全都能走通。
  - 结论:这就是【连通图】。
2. 非连通图与"连通分量"(孤岛与独立朋友圈)
通俗解释 :如果有几座孤岛之间完全没有桥梁相通,整张图就叫非连通图 。
而其中的每一个互通的小群体(最大连通子图) ,就叫一个连通分量。
text
【这是一个非连通图,包含 3 个"连通分量"】

  连通分量 1(大陆圈)      连通分量 2(孤岛圈)     连通分量 3(独行侠)

      (A) --- (B)                 (E)                  (G)
       |     /                     |
       |    /                      |
      (C) -(D)                    (F)

* 检查:
  - 问:"A 能走到 E 吗?" 根本没有路,互不通气!所以整张大图是【非连通图】。
  - 圈子 1:{A, B, C, D} 自己关起门来是连通的,并且把能拽的人全拽进来了,它是一个【连通分量】。
  - 圈子 2:{E, F} 内部连通,是第二个【连通分量】。
  - 圈子 3:{G} 一个人也是一个独立的【连通分量】。
  - 408 核心考点:如果图本身就是连通图,那它就只有【1 个】连通分量(它自己)。
二、 极易混淆:"强连通图"与"强连通分量"(有向图视角)
有向图的边是单行道。你过去容易,能不能原路返回就不一定了!
1. 强连通图(必须能去能回,形成闭环网络)
通俗解释 :对于任意两个人 A 和 B,既要有路从 A 到 B,也必须有路能从 B 回到 A。
text
【这是一个强连通图】

        (A) --------> (B)
         ^             |
         |             |
         |             v
        (D) <-------- (C)

* 检查:
  - 从 A 去 C:走 A -> B -> C(行得通)。
  - 从 C 回 A:走 C -> D -> A(行得通)。
  - 任何一个点都能通过单行道转一圈回到其他任何点。
  - 结论:这是【强连通图】。
2. 不是强连通图(单向死胡同)
看下面这个极具欺骗性的例子:
text
【这不是强连通图!】

        (A) --------> (B)
         |             |
         |             |
         v             v
        (C) --------> (D)

* 检查:
  - 从 A 可以走到 D 吗?可以(A -> B -> D 或 A -> C -> D)。
  - 那从 D 还能回到 A 吗?
    D 的身上只有两条指向自己的箭头(入度为 2,出度为 0),所有路在 D 这里全部进得去出不来!
  - 既然从 D 无法走到 A,那么它就【绝对不是强连通图】!
3. 强连通分量(有向图里的极大强连通小圈子)
在复杂的有向图里,挑出那些内部可以互相兜圈往返的最大群体:
text
【包含 2 个强连通分量的有向图】

      [ 小群体 1 ]                      [ 小群体 2 ]

        (A) ---> (B)                      (D) ---> (E)
         ^        |                        ^        |
         |        |                        |        |
         +-- (C)<-+                        +-- (F)<-+
              |
              | (单向桥梁,只能从 C 流向 D)
              v
             (D)

* 观察:
  - 在左边:A、B、C 形成了一个回环,彼此都能互相到达,构成【强连通分量 1】。
  - 在右边:D、E、F 也形成了一个回环,彼此都能互相到达,构成【强连通分量 2】。
  - 为什么不能把它们合并成一个大的?
    因为从 C 顺着桥梁可以去 D,但右边的人【无论如何也回不来左边】!
三、 408 必考的"极端情况"推导配图(为什么是这个公式?)
前面提到的公式:"8 个顶点的无向图,如果保证必定连通,最少需要多少条边?"
很多同学死记公式容易忘,看图一秒顿悟出命题人的"恶意陷阱":
命题人想怎么坑你?
要想用最多的边 把图搞得依然不连通 ,最极端的方法是:
孤立其中 1 个点,让剩下的 7 个点疯狂连线,把能连的边全连满(内部完全图)!
text
【最险恶的不连通状态(7 个人抱团,孤立第 8 个人)】

       (1) --- (2)
      / | \   / | \
    (3)-+--(4)--+-(5)      这 7 个点之间所有线全连满!
     \  |  / \  |  /       共 C(7, 2) = 7 * 6 / 2 = 21 条边。
       (6) --- (7)
(8) <--- 【被孤立的第 8 个点】- 此时整张图已经有了整整 21 条边!
- 但它连通吗?不连通!因为 8 号顶点还是座孤岛!
- 那怎样才能"保证它必定连通"?
只要在这个极端状态的基础上,随便再加 1 条边连向 8 号顶点,孤岛瞬间被打破,整张图无论如何都会连通! - 所以答案是:
21 + 1 = 22 条边 21 + 1 = \mathbf{22 \text{ 条边}} 21+1=22 条边
通用公式就是这么来的:
( n − 1 ) ( n − 2 ) 2 + 1 \frac{(n-1)(n-2)}{2} + 1 2(n−1)(n−2)+1
408 选择题极其喜欢在"强连通"和"连通分量"的字眼上挖坑:
| 术语 | 适用图类型 | 核心含义 |
|---|---|---|
| 连通图 | 无向图 | 图中任意两个顶点之间都有路径相通。 |
| 连通分量 | 无向图 | 无向图中的极大连通子图(连通块:子图必须连通,且把能拽进来的点和边全部包含,不能再扩大)。 |
| 强连通图 | 有向图 | 图中任意一对顶点 v i v_i vi 和 v j v_j vj,既有从 v i v_i vi 到 v j v_j vj 的路径,又有从 v j v_j vj 到 v i v_i vi 的路径。 |
| 强连通分量 | 有向图 | 有向图中的极大强连通子图。 |
408 考场秒杀数值极值:
- 一个无向图有 n n n 个顶点,若要保证它必定是连通图,至少需要多少条边?
- 最坏情况反向推导 :先让其中 n − 1 n-1 n−1 个顶点组成一个完全无向图(把边占满,共有 ( n − 1 ) ( n − 2 ) 2 \frac{(n-1)(n-2)}{2} 2(n−1)(n−2) 条边),此时还剩最后 1 个孤立顶点。只要再给这个孤立点连上 1 条边,整棵图瞬间全连通!
- 结论 :至少需要 ( n − 1 ) ( n − 2 ) 2 + 1 \mathbf{\frac{(n-1)(n-2)}{2} + 1} 2(n−1)(n−2)+1 条边。
- 一个有向图有 n n n 个顶点,若是强连通图,最少需要多少条边?
- 结论 :n n n 条边(首尾相连围成一个环)。
阶段二:图的两大存储结构图解与内存剖析
第一部分:邻接矩阵(Adjacency Matrix)------ 静态二维表格
1. 结构本质:用一张棋盘记录"谁和谁之间通不通"
假设有 4 个顶点:0, 1, 2, 3。
text
【无向图原形】                    【有向网图(带方向与权值)】

       (0)                              (0)
      /   \                            /   \
     /     \                       5  /     \  2
   (1) --- (2)                       v       v
    |                               (1) ----> (2)
   (3)                                    4
我们用一个二维数组 Edge[n][n] 来记录它们之间的连接情况:
(1)无向图的邻接矩阵
- 若顶点 i i i 和顶点 j j j 之间有边,则
Edge[i][j] = 1,否则为0:
text
    顶点:    0   1   2   3
  0 [ 0 ] [ 1 ] [ 1 ] [ 0 ]   <-- 0 号点连接了 1 和 2
  1 [ 1 ] [ 0 ] [ 1 ] [ 1 ]   <-- 1 号点连接了 0, 2, 3
  2 [ 1 ] [ 1 ] [ 0 ] [ 0 ]   <-- 2 号点连接了 0, 1
  3 [ 0 ] [ 1 ] [ 0 ] [ 0 ]   <-- 3 号点只连接了 1
408 必考规律(一眼看清):
- 对称性 :无向图的矩阵沿主对角线完全对称 (
Edge[i][j] == Edge[j][i])。在 408 中,常考"对称矩阵压缩存储",只存下三角能省一半空间。- 求度数 :想知道顶点 i i i 的度是多少?直接数第 i i i 行(或第 i i i 列)里有几个 1 即可。
(2)有向网图的邻接矩阵
- 有向图的行代表出度 (射出去的箭头),列代表入度(射进来的箭头)。
- 网图(带权值的图)中,若两点不通,通常用无穷大 ∞ \infty ∞ 表示;自身到自身通常记为 0。
text
    顶点:    0     1     2
  0 [ 0 ] [  5  ] [  2  ]     <-- 0 射出两条箭头:指向 1(权值5), 指向 2(权值2)
  1 [ ∞ ] [  0  ] [  4  ]     <-- 1 射出一条箭头:指向 2(权值4)
  2 [ ∞ ] [  ∞  ] [  0  ]     <-- 2 没射出任何箭头
408 核心考点:
- 求出度 :看第 i i i 行,有多少个有效权值,出度就是多少。
- 求入度 :看第 j j j 列,有多少个有效权值,入度就是多少。
2. 408 考场标准结构体定义(纯 C 语言)
c
#define MAX_VERTEX_NUM 100
#define INF 0x3f3f3f3f           // 设一个极大值代表两点不可达 (∞)

typedef struct {
    char Vex[MAX_VERTEX_NUM];                 // 顶点表(存顶点名字或数据)
    int Edge[MAX_VERTEX_NUM][MAX_VERTEX_NUM]; // 邻接矩阵(存边或边的权值)
    int vexnum, arcnum;                       // 当前图的顶点总数和边数
} MGraph;
第二部分:邻接表(Adjacency List)------ 数组 + 单链表
当图很稀疏(顶点多、连线少)时,邻接矩阵里会有铺天盖地的 0 或 ∞,严重浪费内存。
邻接表的思路是:每个顶点各自挂一条单链表,链表里只记录"跟自己直接相连的人"。
1. 结构拆解图
以同一个无向图为例:
- 顶点 0 连接了:1, 2
- 顶点 1 连接了:0, 2, 3
- 顶点 2 连接了:0, 1
- 顶点 3 连接了:1
在内存里的实际结构如下:
text
【顶点头结点数组】                  【各自挂载的边表单链表】
  下标  顶点数据  第一条边指针
  [0] |  'A'  |  firstarc  --->  [ 1 ] ---> [ 2 ] ^
  [1] |  'B'  |  firstarc  --->  [ 0 ] ---> [ 2 ] ---> [ 3 ] ^
  [2] |  'C'  |  firstarc  --->  [ 0 ] ---> [ 1 ] ^
[3] | 'D' | firstarc ---> [ 1 ] ^- 每一个链表结点
[ x ]记录的是:相连顶点的下标以及指向下一个邻居的指针。
2. 408 核心考点与特性对比
-
空间复杂度:
-
无向图:每条边 ( u , v ) (u, v) (u,v) 在 u u u 的链表里出现一次,在 v v v 的链表里也出现一次,所以全图链表结点一共有 2 ∣ E ∣ 2\vert{}E\vert{} 2∣E∣ 个。空间复杂度为 O ( ∣ V ∣ + 2 ∣ E ∣ ) O(\vert{}V\vert{} + 2\vert{}E\vert{}) O(∣V∣+2∣E∣)
-
有向图:每条箭头只在弧尾的链表里出现一次,空间复杂度为 O ( ∣ V ∣ + ∣ E ∣ ) O(\vert{}V\vert{} + \vert{}E\vert{}) O(∣V∣+∣E∣)。
-
找度数的优缺点(选择题大坑):
-
在有向图的邻接表里:找出度极快,顺着自己的单链表往下数就行。
-
找入度 极慢:你想知道谁把箭头射向了你,必须把全图所有顶点的单链表从头到尾扫一遍!
3. 408 考场标准结构体定义(纯 C 语言)
c
#define MAX_VERTEX_NUM 100

// 1. 边表结点(挂在链表上的小抽屉)
typedef struct ArcNode {
    int adjvex;                 // 该边指向的顶点下标(如连接了 1 号点,这里就存 1)
    struct ArcNode *nextarc;    // 指向该顶点的下一个邻居
    int weight;                 // 权值(若为带权网图则使用,无权图可不加)
} ArcNode;

// 2. 顶点头结点(数组里的每一个大抽屉)
typedef struct VNode {
    char data;                  // 顶点信息(如 'A', 'B')
    ArcNode *firstarc;          // 指向第一条邻居边的指针
} VNode, AdjList[MAX_VERTEX_NUM];

// 3. 完整的邻接表结构体
typedef struct {
    AdjList vertices;           // 顶点头结点数组
    int vexnum, arcnum;         // 图的顶点数和边数
} ALGraph;
第三部分:两种存储方式的考场优选法则
| 维度 | 邻接矩阵(二维数组) | 邻接表(数组 + 链表) |
|---|---|---|
| 空间占用 | 永远是 O ( ∣ V ∣ 2 ) O(\vert{}V\vert{}^2) O(∣V∣2),不管有多少条边 | 空间为 O ( ∣ V ∣ + ∣ E ∣ ) O(\vert{}V\vert{} + \vert{}E\vert{}) O(∣V∣+∣E∣),按需开辟 |
| 适合场景 | 稠密图(边非常多) | 稀疏图(边很少) |
| 查两点间是否有边 | O ( 1 ) O(1) O(1),直接查 Edge[i][j] |
O ( 度 ) O(\text{度}) O(度),要在单链表里挨个找 |
| 表示唯一性 | 唯一(给定顶点顺序后,矩阵完全固定) | 不唯一(链表结点的插入先后顺序可以不同) |
表示唯一性是选择题高频考点 :
因为邻接表插入新边时,头插法和尾插法会导致链表节点的顺序不同,所以同一个图的邻接表表示不唯一 ;而邻接矩阵表示是绝对唯一的!
在 408 考卷中,图的遍历是算法大题得分率最高、考查频次最密集的基础模块 。不管是求无向图连通分量、判断环路、求单源无权图最短路径,还是后续的拓扑排序,底层框架全都是基于 广度优先搜索(BFS) 或 深度优先搜索(DFS) 展开的。
阶段三:图的双核心遍历------BFS 与 DFS
我们先建立一个最直观的认知:
- 二叉树的层序遍历 → \to → 升级后就是图的 广度优先搜索(BFS);
- 二叉树的先序遍历 → \to → 升级后就是图的 深度优先搜索(DFS)。
但图与树有一个最致命的区别:图里可能有环!走着走着可能会绕回已经去过的地方,导致死循环。
因此,在图的遍历中,必须引入一个必考的辅助数组:
c
bool visited[MAX_VERTEX_NUM]; // 记录每个顶点是否已经被访问过第一部分:广度优先搜索(BFS)------"水波涟漪 / 推土机式横扫"
1. 核心思想与现实比喻
想象在平静的水面上扔下一颗石子:波纹是一圈一圈向外荡开的。
从起始点出发:
- 先访问它的直接邻居(距离为 1 的所有点);
- 再访问邻居的邻居(距离为 2 的所有点);
- 一层一层推过去,直到整张图所有点全部访问完毕。
2. 底层驱动引擎:【辅助队列(Queue)】
由于要遵守"先发现的邻居,先扩展它的子邻居"的规则,必须借助队列(FIFO)驱动。
3. 字符画流程推演
以下面这棵简单的无向图为例,从 顶点 1 开始做 BFS:
text
       (1) -------- (2)
      /   \          |
     /     \         |
   (3) --- (4)      (5)
            |
           (6)
推演过程表格化呈现:
text
第 0 步:访问起点 1,标记 visited[1] = true,起点入队。
        队列状态: [ 1 ]

第 1 步:1 出队,访问并把 1 的所有未访问邻居 (2, 3, 4) 入队。
        访问序列: 1
        队列状态: [ 2, 3, 4 ]

第 2 步:2 出队,把 2 的未访问邻居 (5) 入队。(注意:1 已经 visited,不重复入队)
        访问序列: 1, 2
        队列状态: [ 3, 4, 5 ]

第 3 步:3 出队,3 的邻居是 1 和 4,但 1 和 4 都已经在队列里被标记过了,无需重复入队。
        访问序列: 1, 2, 3
        队列状态: [ 4, 5 ]

第 4 步:4 出队,把 4 的未访问邻居 (6) 入队。
        访问序列: 1, 2, 3, 4
        队列状态: [ 5, 6 ]

第 5 步:5 出队,没有未访问邻居。
        访问序列: 1, 2, 3, 4, 5
        队列状态: [ 6 ]

第 6 步:6 出队,队列为空,遍历结束!
        最终 BFS 访问序列: 1 -> 2 -> 3 -> 4 -> 5 -> 6
第二部分:深度优先搜索(DFS)------"一条道走到黑,撞南墙才回头"
1. 核心思想与现实比喻
DFS 就像一个人在走迷宫:
- 遇到岔路口,永远挑其中一条路一直往前扎;
- 直到走到死胡同(或者所有邻居都去过了),再原路返回(回溯)到上一个岔路口,换另一条没走过的分支继续扎进去。
2. 底层驱动引擎:【递归 / 系统调用栈】
因为天然具备"后进先出(遇到死胡同退回上一步)"的回溯特征,所以采用递归函数实现最为精炼。
3. 字符画流程推演(同一张图)
text
       (1) -------- (2)
      /   \          |
     /     \         |
   (3) --- (4)      (5)
            |
           (6)
从 顶点 1 开始深度扎入(假定按编号升序选择邻居):
text
1. 从 1 出发,挑最小邻居 2:
   访问 1 -> 深入 2

2. 从 2 往下看,只有邻居 5 没去过:
   深入 5

3. 5 的所有路都断了(撞南墙!):
   回溯退回到 2,2 也没有其他路了,退回到 1。

4. 1 还有其他岔路:挑没去过的 3:
   深入 3

5. 从 3 往下看,只有邻居 4 没去过:
   深入 4

6. 从 4 往下看,只有邻居 6 没去过:
   深入 6

7. 6 撞南墙,一路回溯退栈结束。
   最终 DFS 访问序列: 1 -> 2 -> 5 -> 3 -> 4 -> 6
第三部分:408 考场满分防踩坑机制------"非连通图外层循环"
在 408 大题中,阅卷组常常会给一个非连通图(包含多个孤立岛屿) 。
如果你只写了一个 BFS(G, 0) 或 DFS(G, 0),你只能把起点所在的那个岛屿扫完,剩下的独立岛屿将全部被漏掉!
因此,408 标准主遍历函数必须套上一个遍历所有顶点的外层循环:
c
bool visited[MAX_VERTEX_NUM]; // 全局访问标记数组

// 408 标准全图遍历主框架
void BFSTraverse(Graph G) {
    // 1. 初始化访问数组为 false
    for (int i = 0; i < G.vexnum; i++) {
        visited[i] = false;
    }

    // 2. 核心防漏扫循环:每个点都查一遍,没访问过的作为新起点启动遍历
    for (int i = 0; i < G.vexnum; i++) {
        if (!visited[i]) {
            BFS(G, i); // 从未被涉足的岛屿启动一次搜索
        }
    }
}
408 必考定理秒杀规律 :
在
BFSTraverse或DFSTraverse中:进入
if (!visited[i])启动BFS或DFS的总次数,严格等于该无向图的【连通分量个数】!(如果图是连通的,这个
if语句只会进去整整 1 次)。
第四部分:BFS 与 DFS 的复杂度与生成树对比
| 考点对比 | 广度优先搜索(BFS) | 深度优先搜索(DFS) |
|---|---|---|
| 辅助空间复杂度 | 最坏需要辅助队列大小 O ( ∣ V ∣ ) O(\vert{}V\vert{}) O(∣V∣) | 递归调用栈最大深度 O ( ∣ V ∣ ) O(\vert{}V\vert{}) O(∣V∣) |
| 邻接表存储时间复杂度 | O ( ∣ V ∣ + ∣ E ∣ ) O(\vert{}V\vert{} + \vert{}E\vert{}) O(∣V∣+∣E∣)(每个点入队一次,每条边访问一次) | O ( ∣ V ∣ + ∣ E ∣ ) O(\vert{}V\vert{} + \vert{}E\vert{}) O(∣V∣+∣E∣) |
| 邻接矩阵存储时间复杂度 | O ( ∣ V ∣ 2 ) O(\vert{}V\vert{}^2) O(∣V∣2)(找一个点的邻居要扫整整一行) | O ( ∣ V ∣ 2 ) O(\vert{}V\vert{}^2) O(∣V∣2) |
| 衍生生成树 | 广度优先生成树(树高通常较矮、更扁平) | 深度优先生成树(树高通常较深、分支较长) |