一、引言
在大数据系统里,数据通常会经历三种形态:磁盘上的存储格式、网络中的传输格式、计算时的内存格式。Parquet、ORC 这类列式文件格式擅长长期存储和压缩;Protobuf、JSON、Avro 常被用于消息交换或服务通信;但当数据进入计算引擎后,系统仍然需要把它解码成某种内存结构才能执行过滤、聚合、排序和向量化计算。
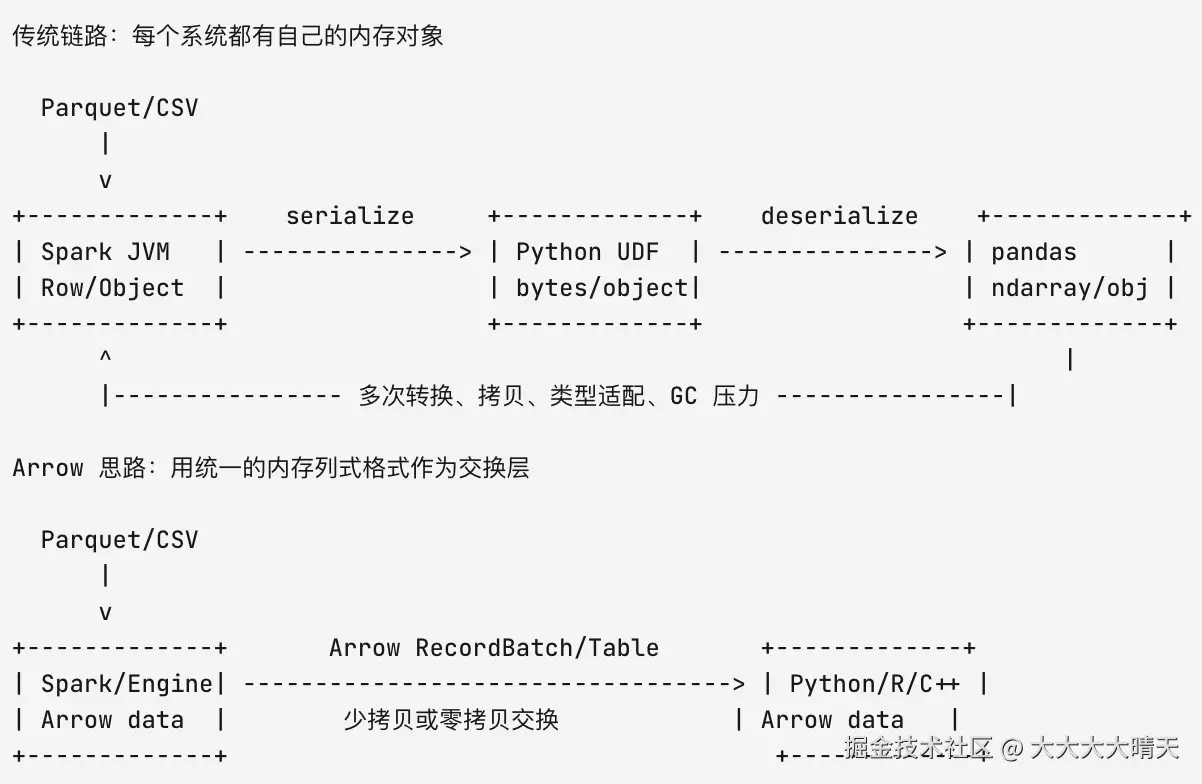
问题出在"每个系统都有自己的内存格式"。数据库、计算引擎、数据框库和机器学习库往往各自实现内部数据结构。当数据从 JVM 进入 Python,或者从 C++ 查询引擎进入 Java 服务时,常见路径是先序列化,再反序列化,再拷贝到目标运行时能理解的对象里。Apache Arrow 将这种问题概括为开发者时间和 CPU 周期的双重浪费,同时分析负载中的序列化开销有时可能占计算成本的 80% 到 90%。
可以用一个简化的数据链路理解 Arrow 出现前后的差异:
二、核心定位
Apache Arrow 是一个面向内存分析场景的多语言工具箱,它的核心是一套标准化、语言无关的内存列式数据格式,用于在不同系统、不同语言、不同进程之间高效表示、处理和传输表格型数据。它不是单一组件,而是一组围绕"内存列式数据"的规范与库,用于快速数据交换和内存分析,并强调其格式支持零拷贝读取,以减少传统序列化与反序列化带来的开销。
更准确地说,Arrow 至少包含以下几层能力:
| 层次 | 说明 | 意义 |
|---|---|---|
| 内存列式格式 | 标准化、语言无关的内存数据结构 | 让不同系统可以理解同一块列式内存 |
| IPC 与序列化协议 | 传输 RecordBatch、Schema 等数据 | 支持进程间、文件、流式交换 |
| 多语言实现 | C++、Java、Python、R、Rust、Go、JavaScript 等 | 降低跨语言集成成本 |
| Dataset / I/O 能力 | 读写 Parquet、IPC、CSV 等数据源 | 接入湖仓和本地文件系统 |
| Compute 能力 | 提供过滤、聚合、类型转换等计算函数 | 在 Arrow 数据上直接执行分析操作 |
| Flight / Flight SQL | 基于 Arrow 数据的高性能 RPC 框架 | 用于远程数据服务、查询服务和传输服务 |
三、架构原理
Arrow 的底层思想可以概括为三句话:列式布局、显式元数据、缓冲区组合。
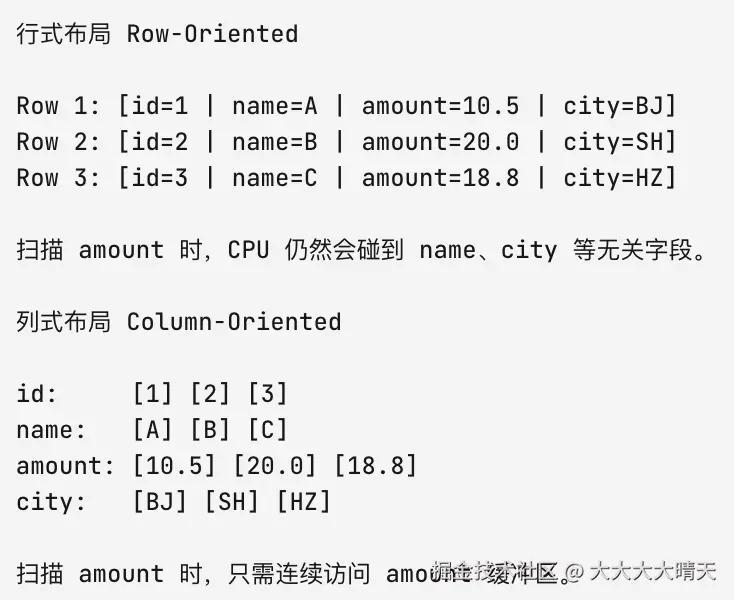
1.列式布局
列式布局把同一列的数据连续放在内存里,而不是把一行的多个字段混在一起。对于分析场景,查询通常只扫描部分列,例如user_id、event_time、amount,列式布局可以减少无关字段读取,并更容易利用 CPU 缓存和 SIMD 向量化。Arrow 的连续列式布局可以帮助计算例程和执行引擎在扫描大量数据时更高效,并支持现代处理器中的 SIMD 操作。
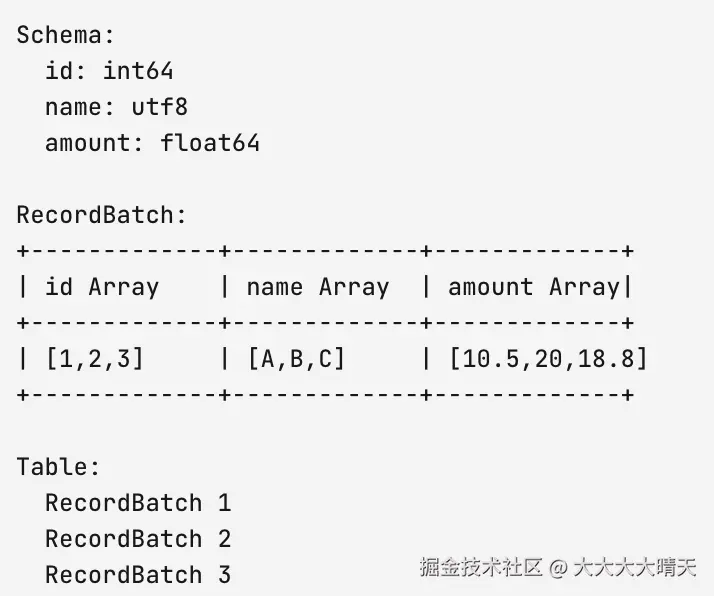
2.Array、RecordBatch 与 Table
Arrow 中最基础的逻辑单元是 Array,即一组同类型、已知长度的值。多个 Array 组成字段集合,并共享同一个 Schema,就可以形成 RecordBatch;多个 RecordBatch 可以进一步组成 Table 或流式数据。序列化数据的基本单位是 record batch,它是由多个长度相同、类型可以不同的数组组成的有序集合,字段名和类型共同形成 schema。
3.Buffer 与 Null Bitmap
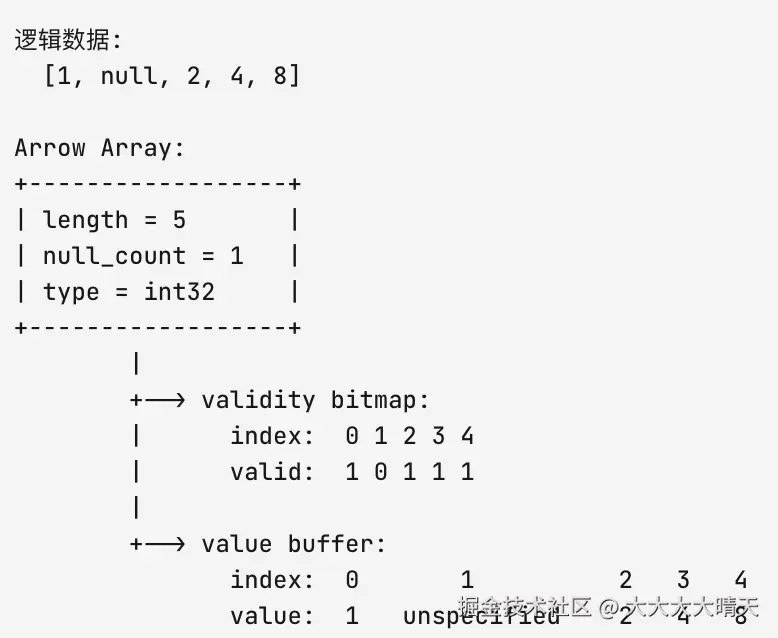
Arrow 的 Array 不是普通对象数组,而是由若干连续内存缓冲区和元数据描述出来的结构。一个数组由数据类型、缓冲区序列、长度、空值数量、可选字典,以及嵌套类型的子数组等组成。
以 int32 数组 [1, null, 2, 4, 8] 为例,它通常包含一个 value buffer 和一个 validity bitmap。bitmap 用 1 表示非空,用 0 表示空值;这比为每个值维护对象引用或额外标记更紧凑,也利于批量计算。
4.零拷贝的边界
"零拷贝"是 Arrow 最常被提到的优势,但它不是魔法。Arrow 的零拷贝主要来自两点:内存布局标准化,以及数据区与元数据区分离。当两个系统都能理解 Arrow 内存格式时,接收方不必把数据重新解析成自己的对象模型,而是可以直接读取现有缓冲区。Arrow memory format 支持 zero-copy reads,可避免序列化开销,支持 Arrow 的系统可以以很低甚至接近无成本的方式传输数据。
但在真实工程中,零拷贝是否成立取决于边界条件:是否跨进程、是否跨机器、是否需要压缩或加密、是否需要类型转换、目标系统是否支持同一套 Arrow 类型,以及数据是否已经以 Arrow 格式存在。如果从 JSON、CSV 或 Parquet 读取数据,解码阶段仍然不可避免;Arrow 优化的是进入内存后的表示、计算与交换。
四、功能特性
Arrow 的功能可以从"格式、库、传输、计算、生态"五个方向理解。
| 特性 | 说明 | 价值 |
|---|---|---|
| 语言无关的列式内存格式 | Arrow 定义为 language-independent columnar memory format | 跨语言数据交换成本低 |
| 扁平与嵌套数据支持 | 支持 Struct、List、Map、Union、Dictionary、Run-End Encoded 等类型 | 适配复杂分析数据模型 |
| O(1) 随机访问 | 关键特性包括 O(1) random access,Run-End Encoded 例外 | 支持扫描与点查混合场景 |
| SIMD 与向量化友好 | SIMD and vectorization-friendly | 适合批量分析计算 |
| IPC 文件与流 | Arrow 定义 IPC 机制,可传输 RecordBatch | 支持进程间、文件缓存和流式交换 |
| Flight RPC | 基于 Arrow 数据、gRPC 和 IPC 的高性能数据服务 RPC 框架 | 支持远程数据服务和分布式传输 |
| 多语言库 | 多语言实现 | 适合异构数据平台 |
| 与 Parquet 互补 | Parquet 是存储格式,Arrow 是内存计算格式 | 湖仓链路中可搭配使用 |
sql
Arrow 生态能力分层

+------------------------------------------------------+
| 应用层                                               |
| Spark / DataFusion / pandas / R / BI / ML / DB       |
+------------------------------------------------------+
| 服务与连接                                           |
| Arrow Flight / Flight SQL / ADBC / Dataset APIs      |
+------------------------------------------------------+
| 数据交换                                             |
| IPC Stream / IPC File / C Data Interface             |
+------------------------------------------------------+
| 核心格式                                             |
| Schema + Array + RecordBatch + Buffer + Bitmap       |
+------------------------------------------------------+
| 硬件基础                                             |
| CPU cache / SIMD / shared memory / mmap / network    |
+------------------------------------------------------+
五、适用场景
Arrow 最适合出现在"数据已经或即将进入内存计算"的位置,而不是替代所有存储和传输格式,比如读写列式存储格式、本地共享内存、网络传输、内存分析数据结构等场景。
- 跨语言数据交换:典型例子是 JVM 引擎与 Python/R 生态之间的数据交换,Spark 使用 Arrow 作为数据 interchange format,PySpark 和 sparklyr 都能利用 Arrow 改善传输性能。
- 查询引擎内部数据格式:对于 DataFusion、Velox、DuckDB 这类分析引擎或执行层而言,Arrow 的列式内存表示适合批量执行算子。
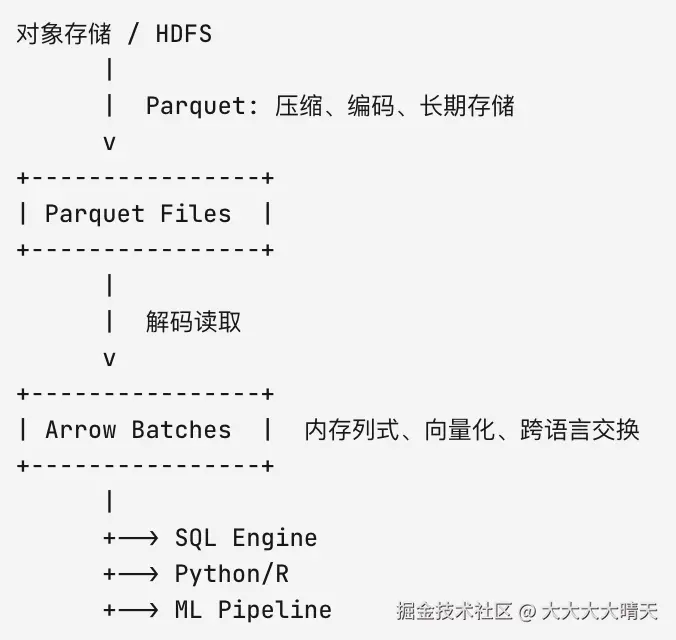
- 湖仓读写加速:Parquet 适合磁盘存储,Arrow 适合内存计算,两者是互补关系,常见方式是把数据用 Parquet 存在磁盘或对象存储里,读取后以 Arrow 格式在内存中计算。
- 高性能远程数据服务:当一个服务需要向客户端返回大量表格数据时,如果用 JSON 或行式对象传输,编码、解析和对象创建成本会很高。Arrow Flight 通过 Arrow RecordBatch 流传输数据,适合查询服务、特征服务、数据网关、跨集群数据服务等场景。
六、常见问题
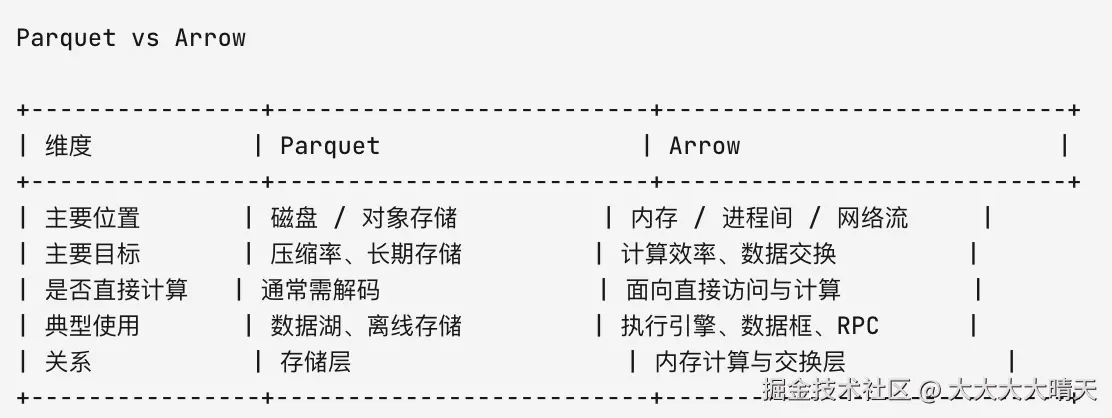
1.Arrow 和 Parquet 有什么区别
Parquet 是面向磁盘的列式存储格式,重点是压缩、编码和长期存储;Arrow 是面向内存的列式格式,重点是计算、随机访问、向量化和跨系统交换。Parquet 不是 runtime in-memory format,而 Arrow 旨在成为这类内存结构;同时也强调二者经常搭配使用。
2.Arrow IPC 文件能替代 Parquet 吗
一般不建议把 Arrow IPC 文件当作长期归档格式。Arrow IPC 文件的磁盘表示与内存表示一致,因此读取时可避免反序列化和额外拷贝;但 Parquet 更适合长期存储和归档,文件通常也更小。
更实用的判断是:如果数据用于短期缓存、跨进程共享、快速加载,可以考虑 Arrow IPC;如果用于数据湖、长期存储、跨多年兼容和节省存储空间,优先考虑 Parquet。
3.Arrow 是否总能零拷贝
不能。零拷贝依赖双方都理解 Arrow 内存格式,也依赖数据类型、内存边界和执行路径没有触发转换。如果从压缩文件、JSON、CSV、Parquet 中读取,解码成本仍然存在;如果跨网络传输,数据仍要经过网络栈;如果目标语言需要转成普通对象,也可能发生拷贝。Arrow 是支持 zero-copy reads 和 little-to-no cost transfer,而不是承诺所有场景完全无拷贝。
4.Arrow 格式是否稳定
Arrow 格式使用 Format Version 和 Library Version 两套版本描述,新版本库可以读取旧版本库产生的数据和元数据;只要主格式版本不变,新库对旧库保持向后兼容;格式主版本变化才意味着兼容性保证被破坏。
七、使用建议
在大数据平台中引入 Arrow 时,不建议把它理解成"替换 Parquet"或"替换 Kafka 消息格式"。更合理的方式是把它放在计算链路和交换链路中:文件仍然可以用 Parquet 存,服务协议仍然可以按业务选择,但当数据进入分析执行、跨语言 UDF、批量 RPC 或数据框处理时,优先评估 Arrow 能否减少中间对象、类型转换和序列化成本。
一个常见落点是从局部链路开始,例如 Spark 与 Python UDF、查询服务返回批量结果、特征工程平台与 Python 客户端之间的批量数据交换。确认收益后,再扩展到 Dataset、Flight 或更底层的 C Data Interface。Arrow 的优势来自生态协同,单点使用也有价值,但跨系统统一内存表示时价值更明显。