✨作者主页 :IT毕设梦工厂✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
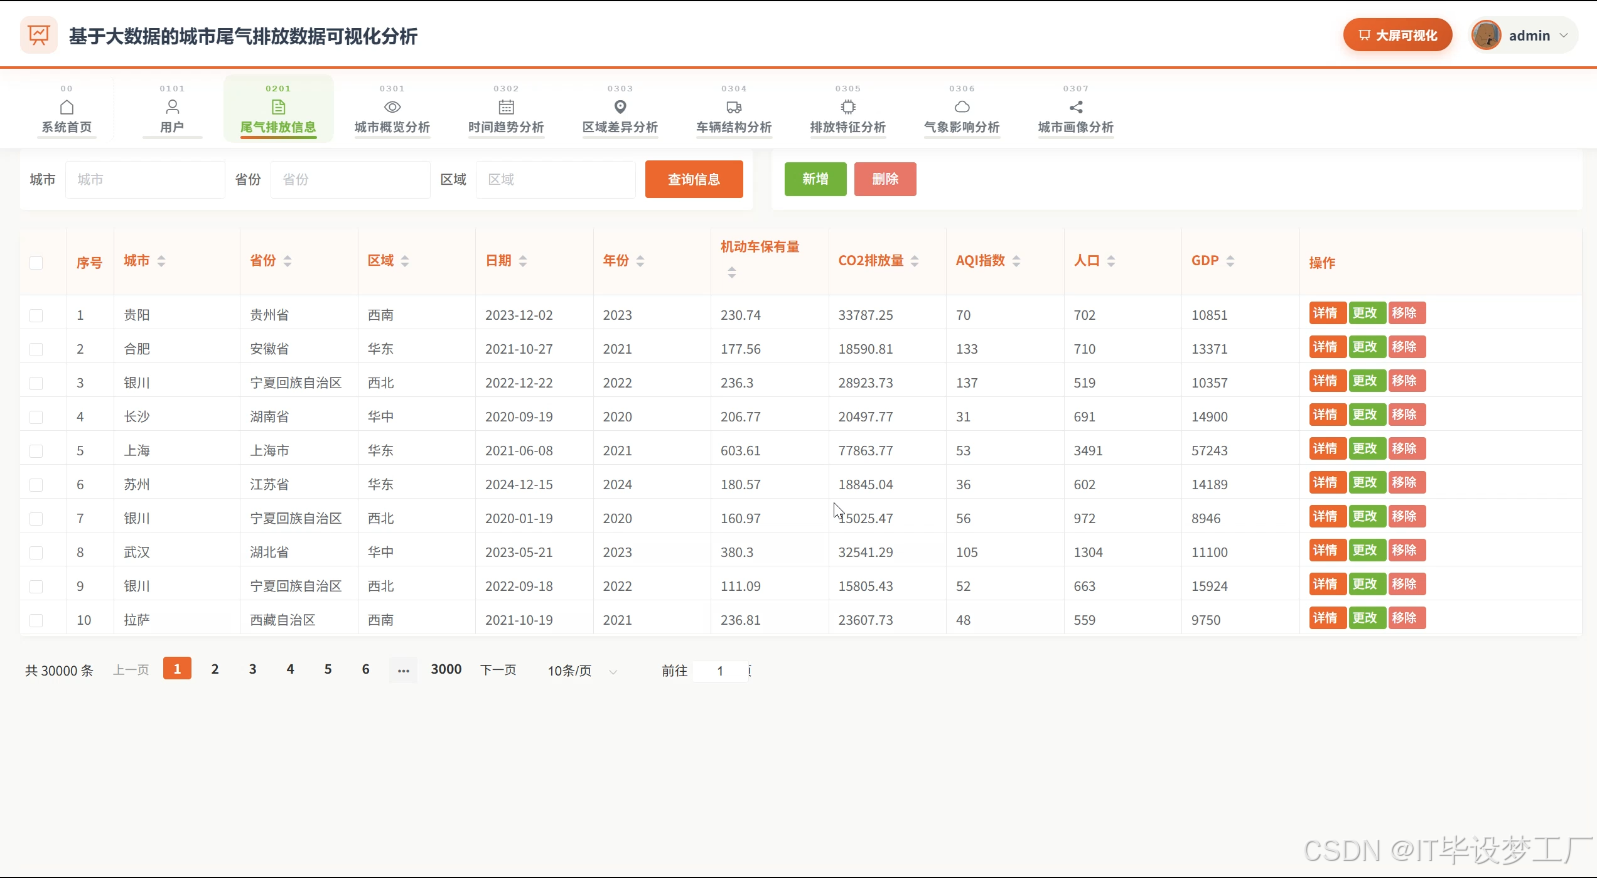
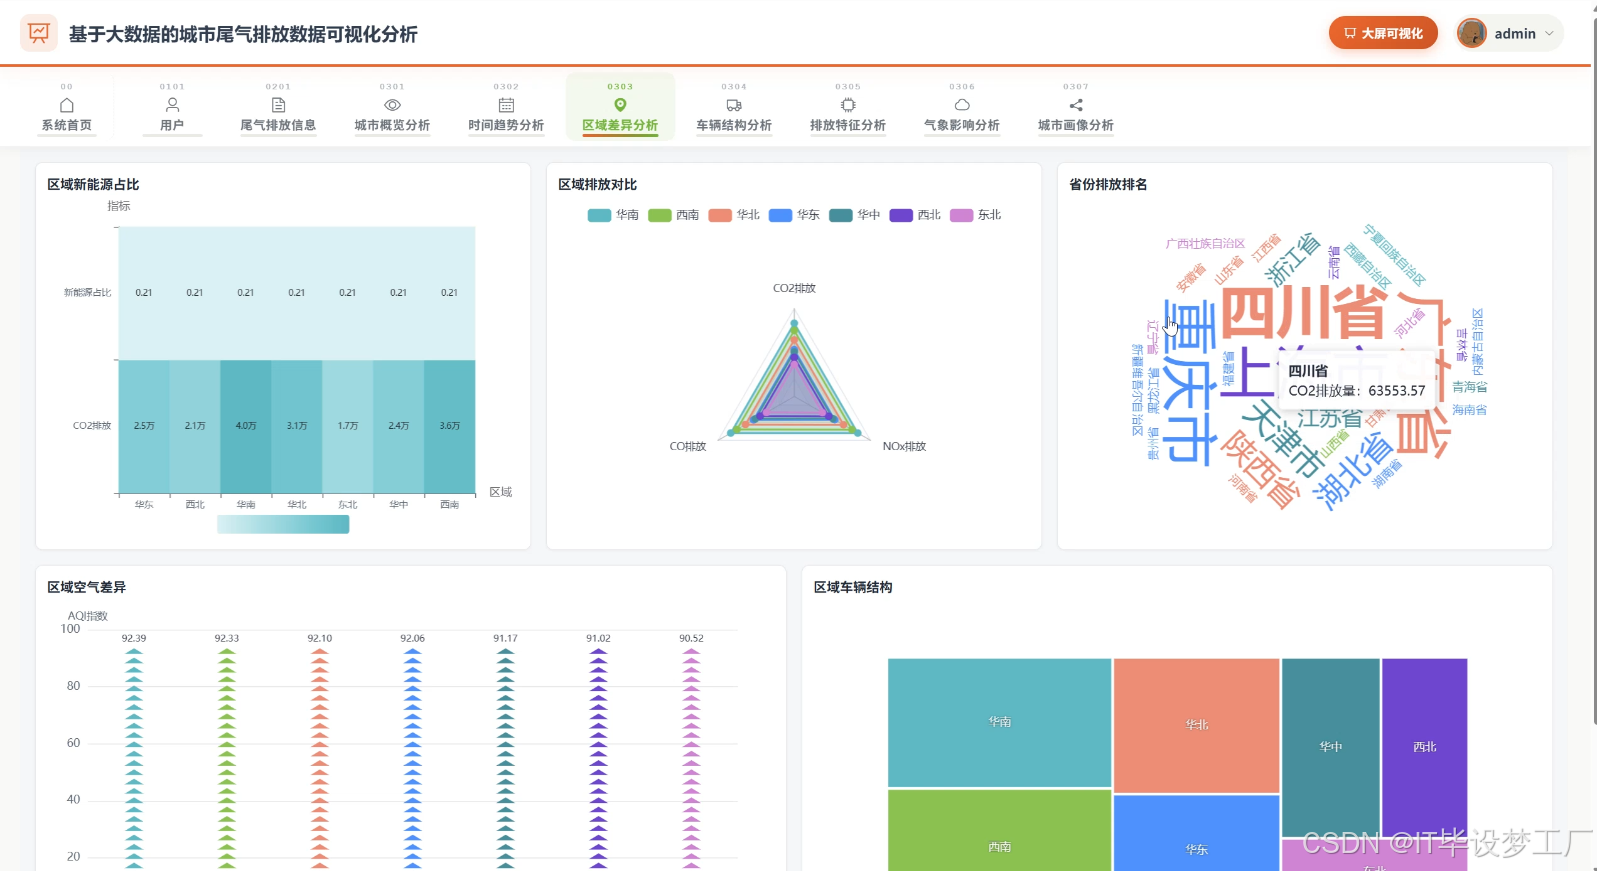
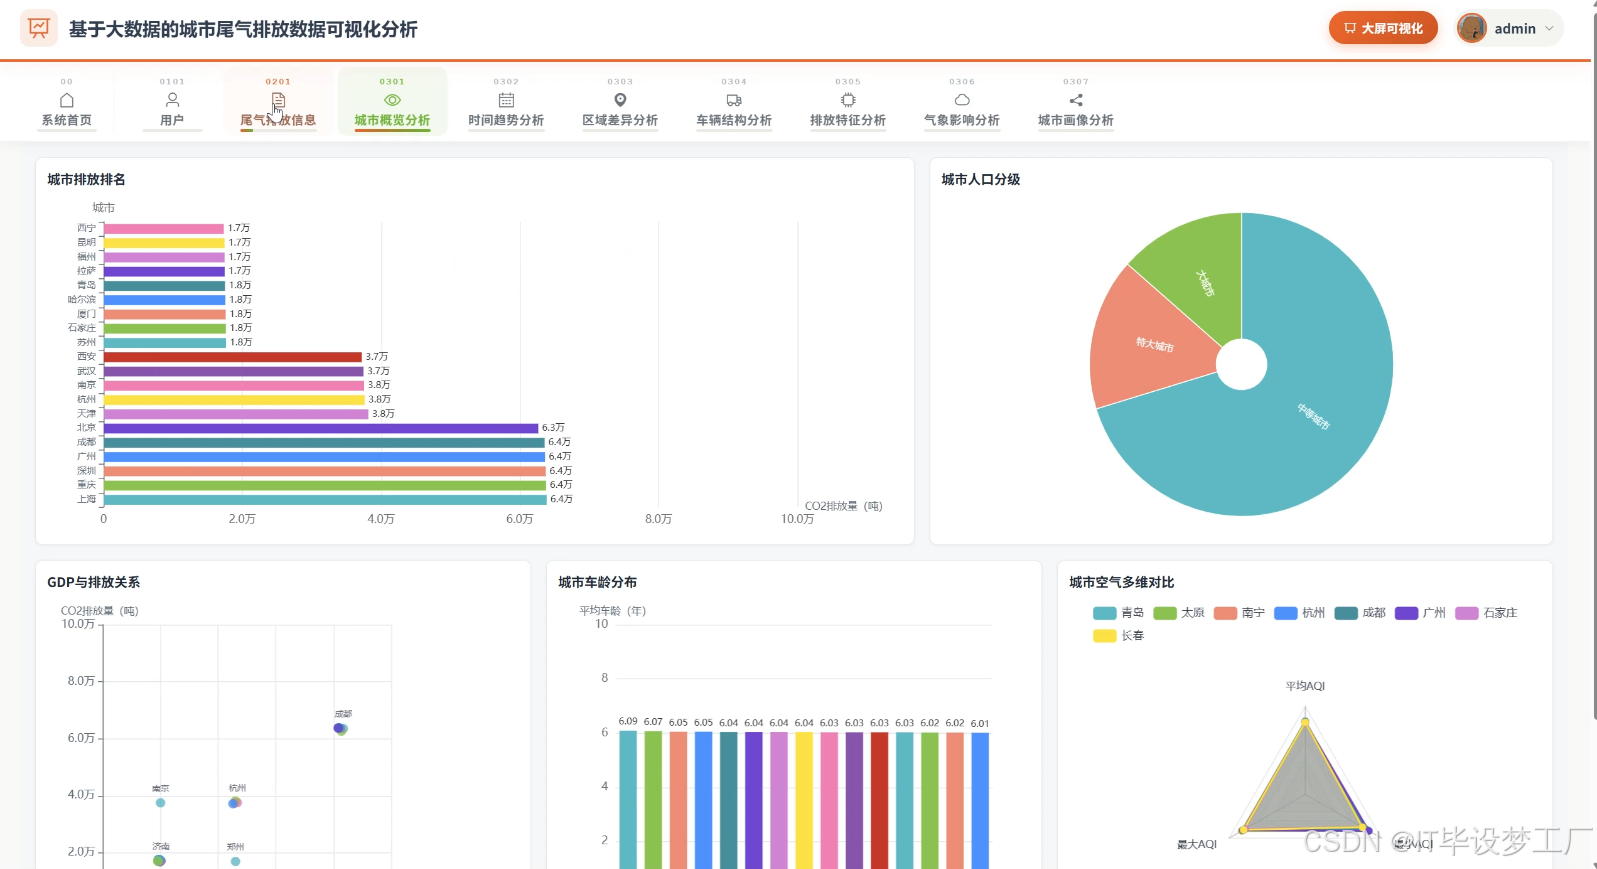
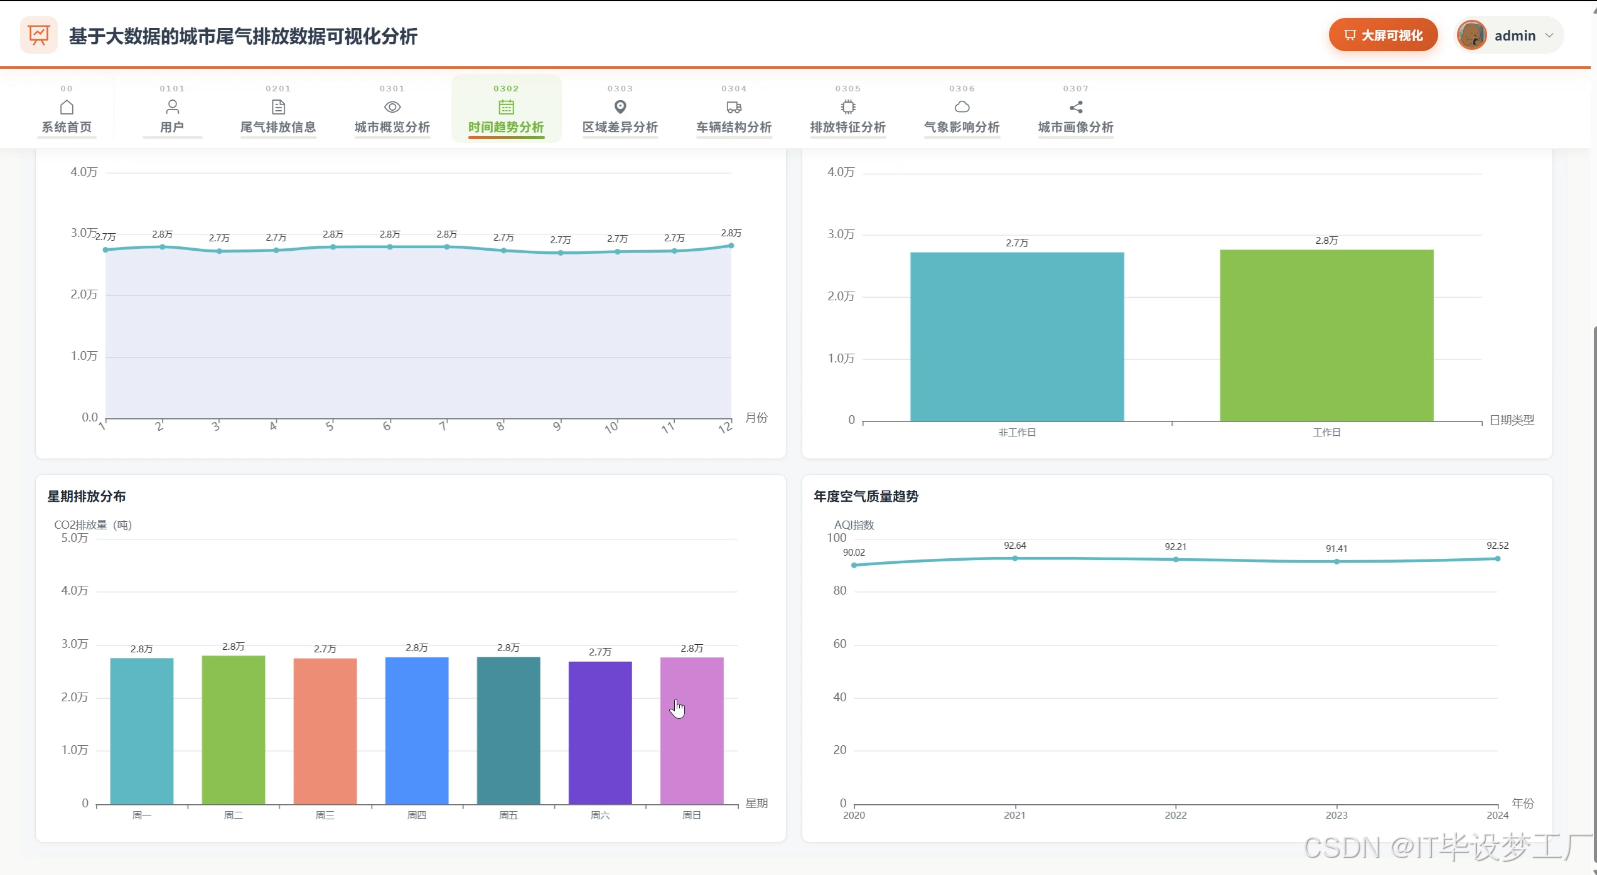
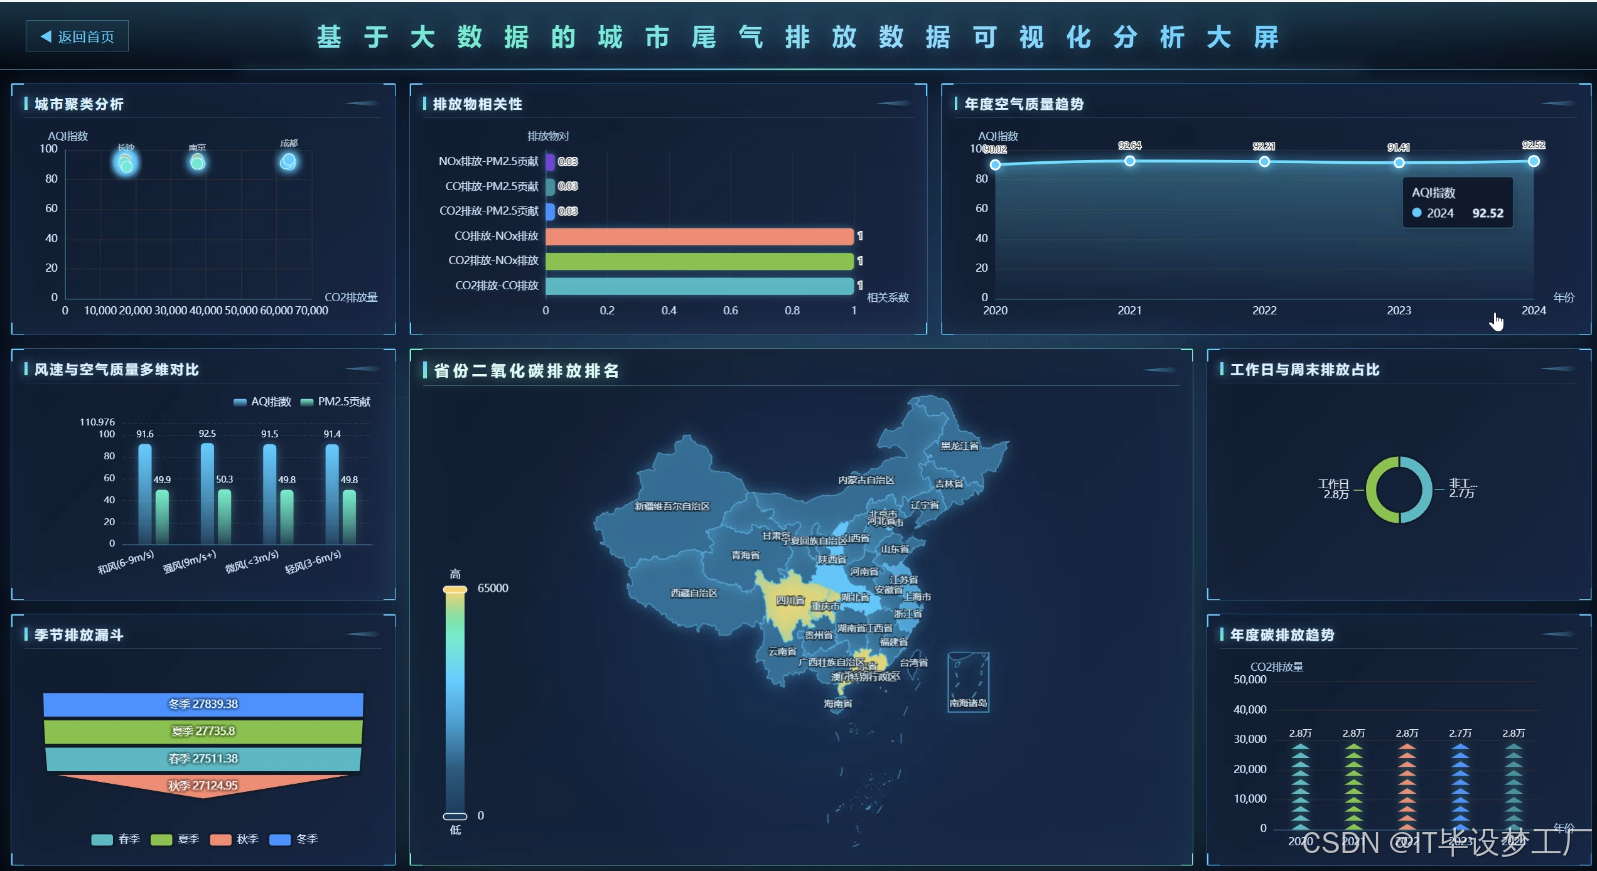
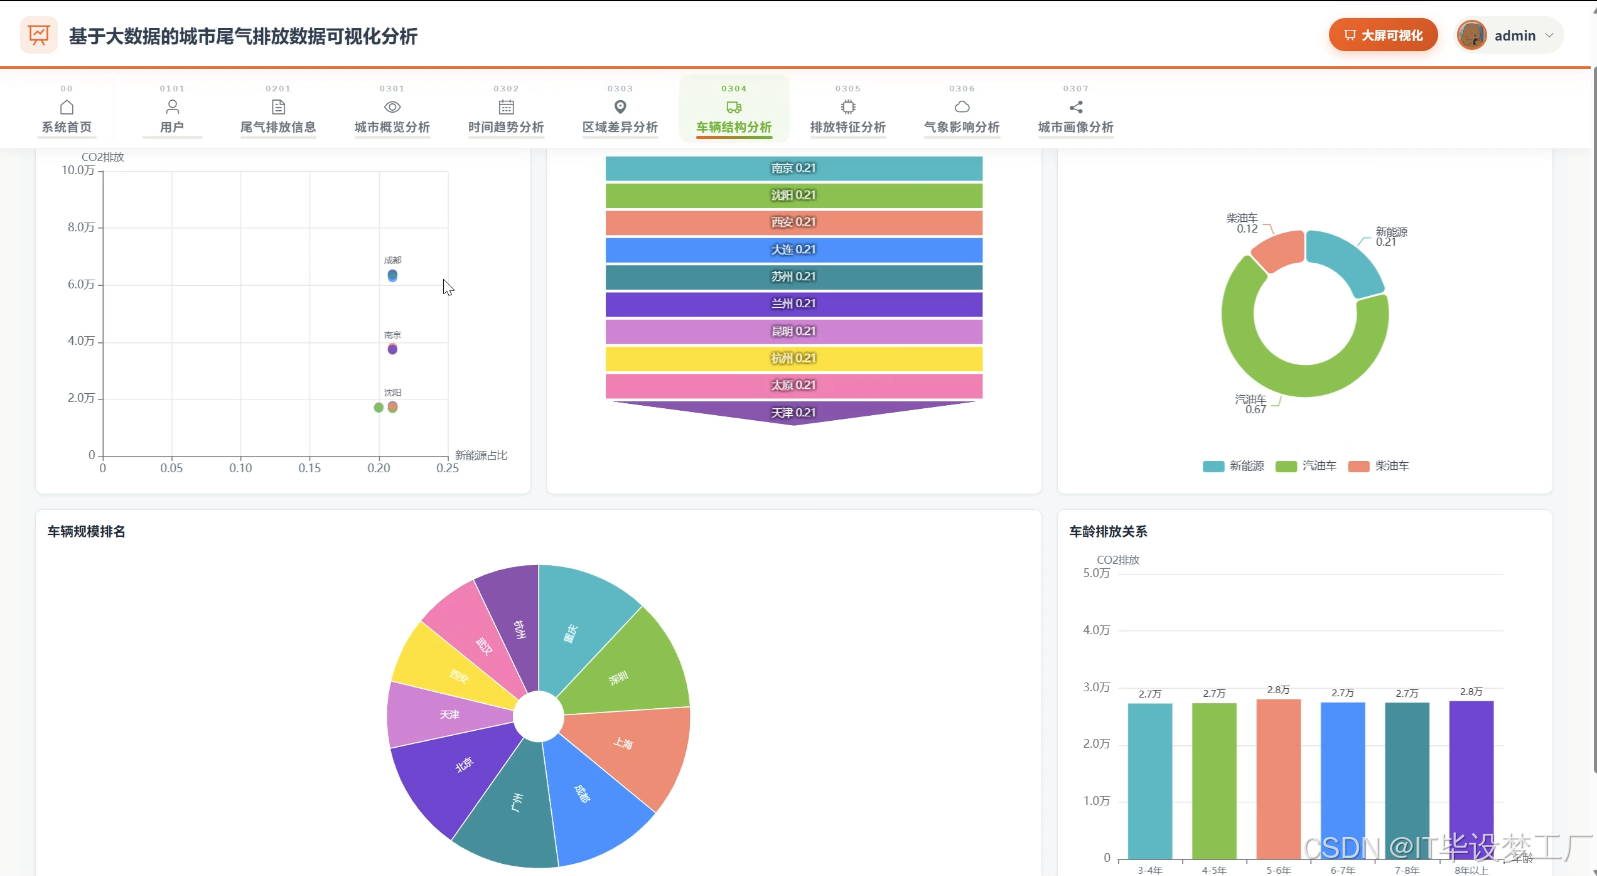
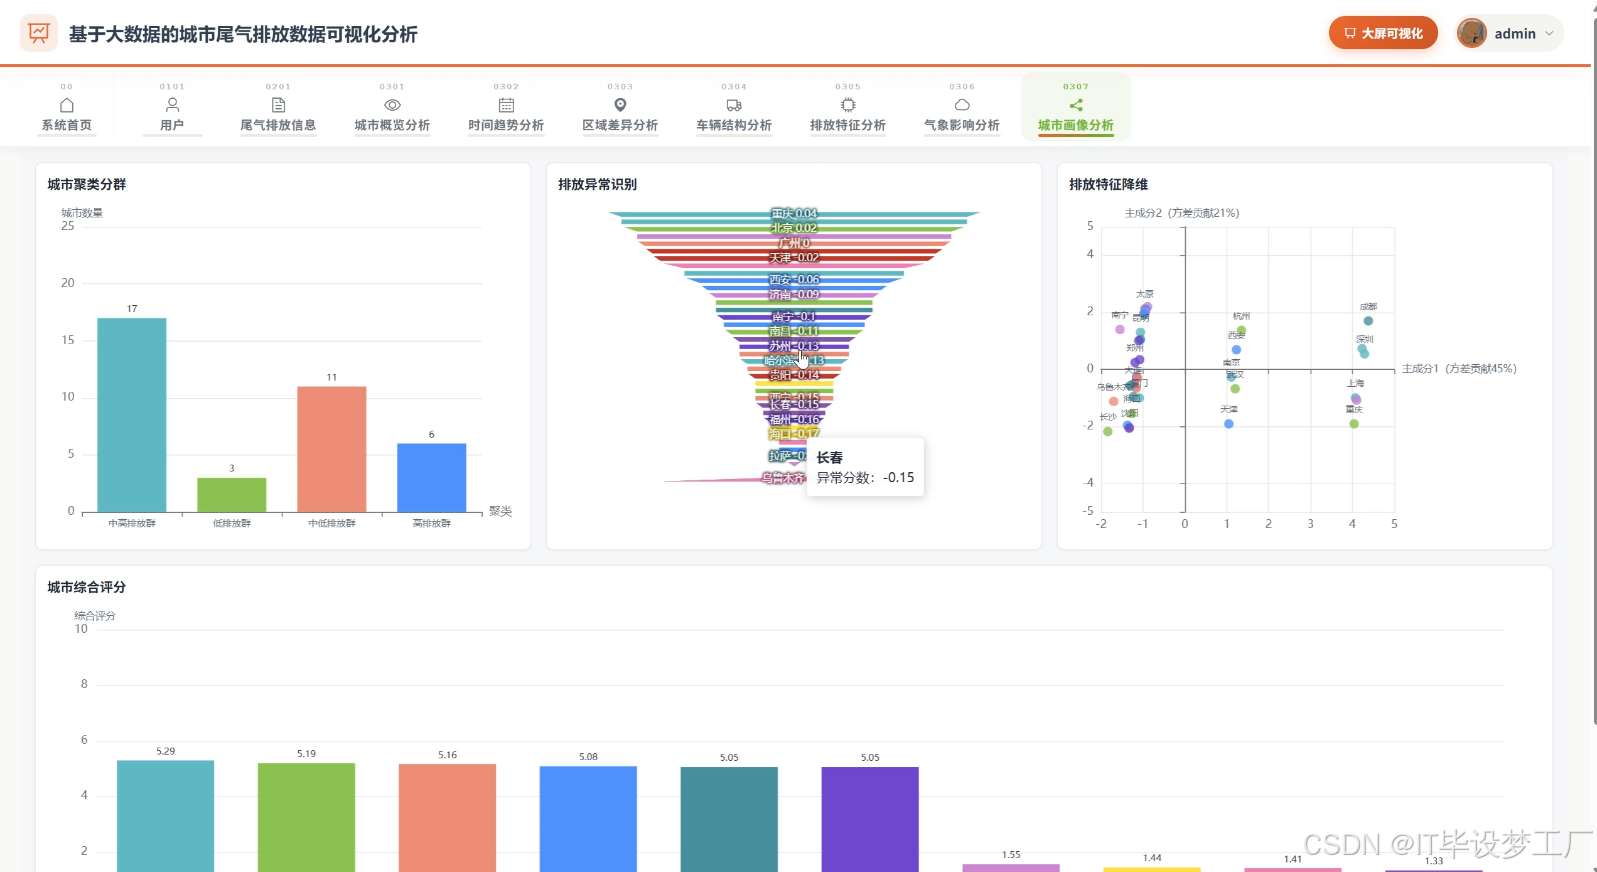
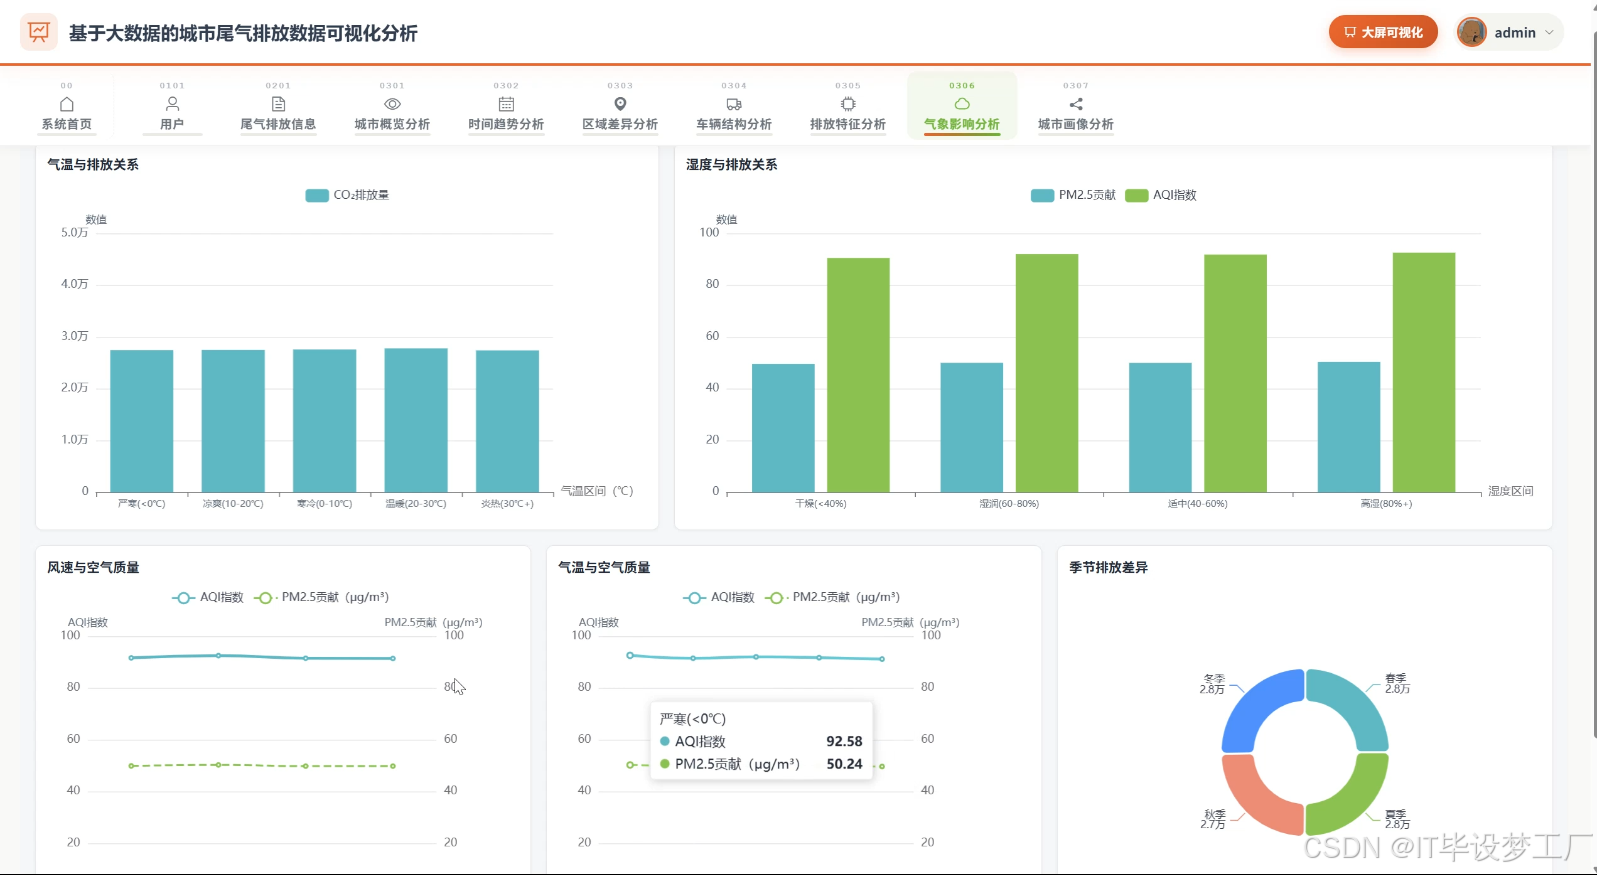
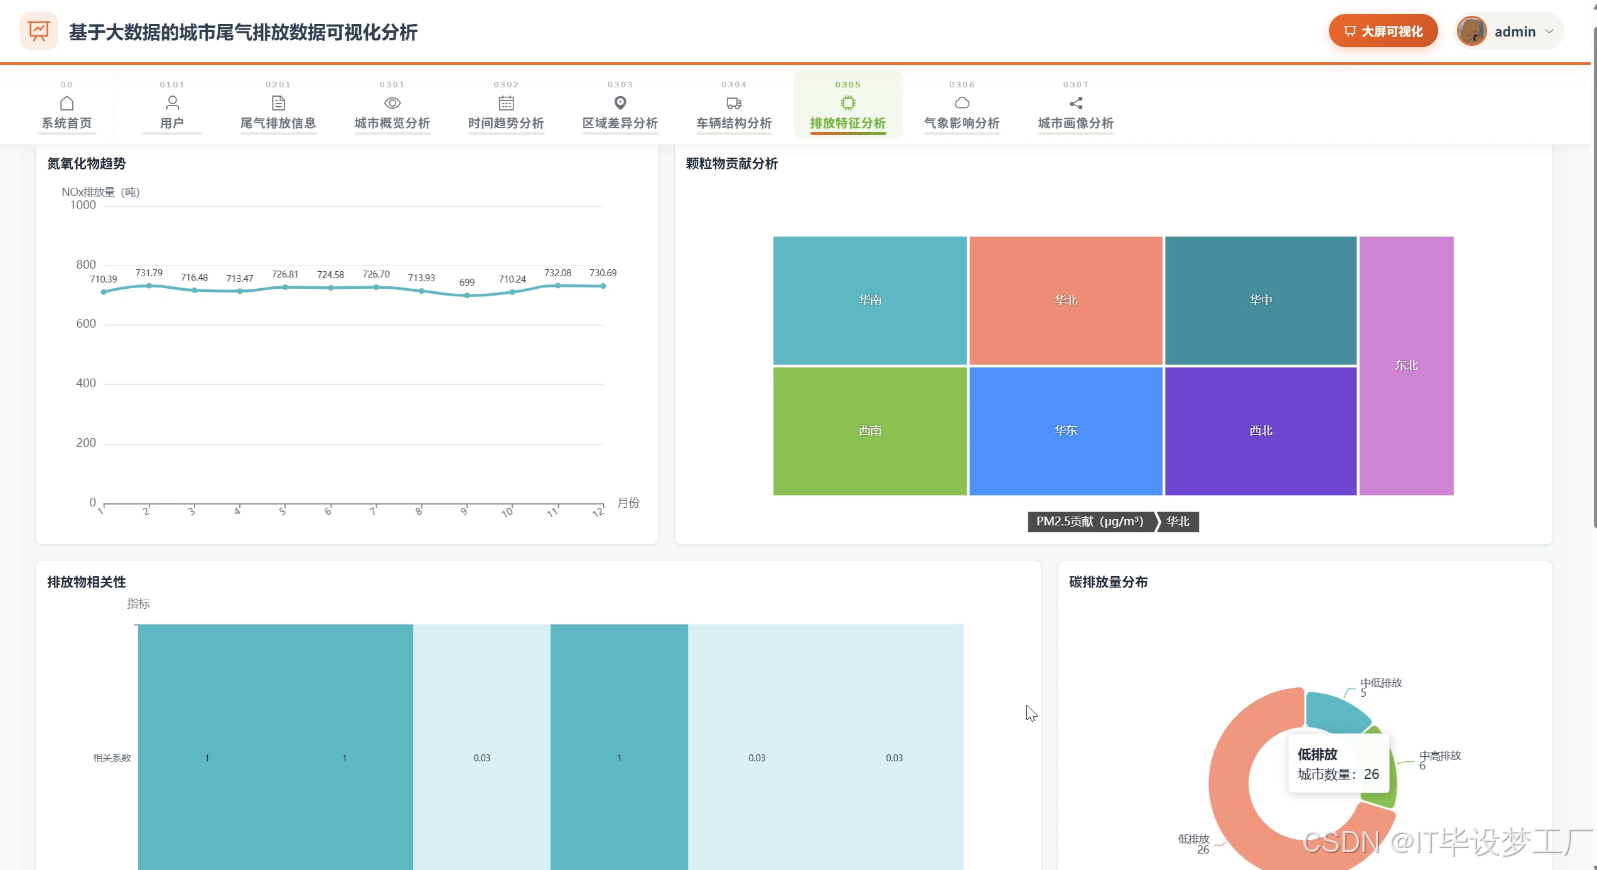
基于大数据的城市尾气排放数据可视化分析系统是一套面向计算机专业毕业设计的完整项目,主要用来对城市尾气排放相关数据进行采集、存储、计算和可视化展示。系统后端采用Hadoop与Spark作为大数据处理框架,利用HDFS完成数据的分布式存储,通过Spark SQL和Pandas、NumPy对尾气排放数据进行清洗、统计和分析,开发语言支持Python与Java两个版本,Python版本对应Django后端框架,Java版本对应Spring Boot框架,前端使用Vue、ElementUI、Echarts配合HTML、CSS、JavaScript和jQuery完成页面交互与图表渲染,数据库采用MySQL保存系统运行所需的业务数据。功能上,系统包含系统首页、大屏可视化、尾气排放信息、城市概览分析、时间趋势分析、区域差异分析、车辆结构分析、排放特征分析、气象影响分析、城市画像分析、个人信息和修改密码等模块,能够从城市、时间、区域、车辆类型、排放特征和气象条件等多个维度对尾气排放数据进行展示与分析,帮助使用者更直观地了解不同城市和不同条件下的尾气排放情况,也为后续相关研究提供一个可运行、可扩展的毕业设计参考。
二、开发环境
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
三、系统界面展示
- 基于大数据的城市尾气排放数据可视化分析系统界面展示:
四、部分代码设计
- 项目实战-代码参考:
python
# 核心功能一:时间趋势分析------按小时统计尾气排放均值与峰值
def analyze_time_trend(spark, mysql_conf):
    spark_session = SparkSession.builder.appName("CityExhaustTimeTrend").config("spark.sql.shuffle.partitions", "4").getOrCreate()
    jdbc_url = mysql_conf["url"]
    jdbc_props = {"user": mysql_conf["user"], "password": mysql_conf["password"], "driver": "com.mysql.cj.jdbc.Driver"}
    emission_df = spark_session.read.jdbc(url=jdbc_url, table="exhaust_emission", properties=jdbc_props)
    emission_df.createOrReplaceTempView("exhaust_emission")
    time_trend_df = spark_session.sql("""
        SELECT hour(collect_time) AS hour_point,
               city_name,
               AVG(co_amount) AS avg_co,
               AVG(hc_amount) AS avg_hc,
               AVG(nox_amount) AS avg_nox,
               MAX(co_amount) AS max_co,
               COUNT(1) AS record_count
        FROM exhaust_emission
        GROUP BY hour(collect_time), city_name
        ORDER BY hour_point, city_name
    """)
    time_trend_df.show(24, truncate=False)
    time_trend_pd = time_trend_df.toPandas()
    time_trend_pd["avg_total"] = time_trend_pd["avg_co"] + time_trend_pd["avg_hc"] + time_trend_pd["avg_nox"]
    peak_row = time_trend_pd.loc[time_trend_pd["avg_total"].idxmax()]
    result = {"hour": int(peak_row["hour_point"]), "city": peak_row["city_name"], "avg_total": float(peak_row["avg_total"]), "record_count": int(peak_row["record_count"])}
    spark_session.stop()
    return result

# 核心功能二:区域差异分析------按区域聚合排放总量并排序
def analyze_region_diff(spark, mysql_conf):
    spark_session = SparkSession.builder.appName("CityExhaustRegionDiff").config("spark.sql.shuffle.partitions", "4").getOrCreate()
    jdbc_url = mysql_conf["url"]
    jdbc_props = {"user": mysql_conf["user"], "password": mysql_conf["password"], "driver": "com.mysql.cj.jdbc.Driver"}
    region_df = spark_session.read.jdbc(url=jdbc_url, table="exhaust_region", properties=jdbc_props)
    region_df.createOrReplaceTempView("exhaust_region")
    region_rank_df = spark_session.sql("""
        SELECT region_name,
               city_name,
               SUM(co_amount) AS total_co,
               SUM(hc_amount) AS total_hc,
               SUM(nox_amount) AS total_nox,
               SUM(co_amount + hc_amount + nox_amount) AS total_emission,
               AVG(vehicle_count) AS avg_vehicle_count
        FROM exhaust_region
        GROUP BY region_name, city_name
        ORDER BY total_emission DESC
    """)
    region_rank_df.show(20, truncate=False)
    region_pd = region_rank_df.toPandas()
    region_pd["emission_ratio"] = region_pd["total_emission"] / region_pd["total_emission"].sum()
    top_region = region_pd.iloc[0]
    result = {"region": top_region["region_name"], "city": top_region["city_name"], "total_emission": float(top_region["total_emission"]), "ratio": float(top_region["emission_ratio"])}
    spark_session.stop()
    return result

# 核心功能三:车辆结构分析------按车型统计排放贡献占比
def analyze_vehicle_structure(spark, mysql_conf):
    spark_session = SparkSession.builder.appName("CityExhaustVehicleStructure").config("spark.sql.shuffle.partitions", "4").getOrCreate()
    jdbc_url = mysql_conf["url"]
    jdbc_props = {"user": mysql_conf["user"], "password": mysql_conf["password"], "driver": "com.mysql.cj.jdbc.Driver"}
    vehicle_df = spark_session.read.jdbc(url=jdbc_url, table="exhaust_vehicle", properties=jdbc_props)
    vehicle_df.createOrReplaceTempView("exhaust_vehicle")
    vehicle_struct_df = spark_session.sql("""
        SELECT vehicle_type,
               fuel_type,
               COUNT(1) AS vehicle_records,
               SUM(co_amount) AS total_co,
               SUM(hc_amount) AS total_hc,
               SUM(nox_amount) AS total_nox,
               SUM(co_amount + hc_amount + nox_amount) AS total_emission,
               AVG(emission_standard) AS avg_standard
        FROM exhaust_vehicle
        GROUP BY vehicle_type, fuel_type
        ORDER BY total_emission DESC
    """)
    vehicle_struct_df.show(30, truncate=False)
    vehicle_pd = vehicle_struct_df.toPandas()
    vehicle_pd["emission_share"] = vehicle_pd["total_emission"] / vehicle_pd["total_emission"].sum()
    top_vehicle = vehicle_pd.iloc[0]
    result = {"vehicle_type": top_vehicle["vehicle_type"], "fuel_type": top_vehicle["fuel_type"], "total_emission": float(top_vehicle["total_emission"]), "share": float(top_vehicle["emission_share"])}
    spark_session.stop()
    return result
五、论文参考
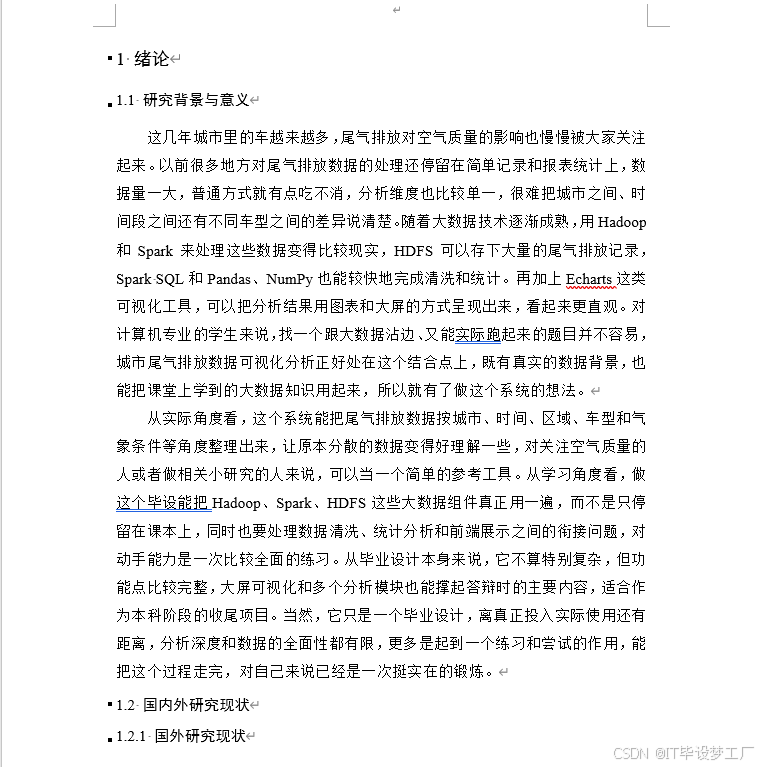
- 计算机毕业设计选题推荐-基于大数据的城市尾气排放数据可视化分析系统-论文参考:
六、系统视频
- 基于大数据的城市尾气排放数据可视化分析系统-项目视频:
项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的城市尾气排放数据可视化分析|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇