✨作者主页 :IT毕设梦工厂✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
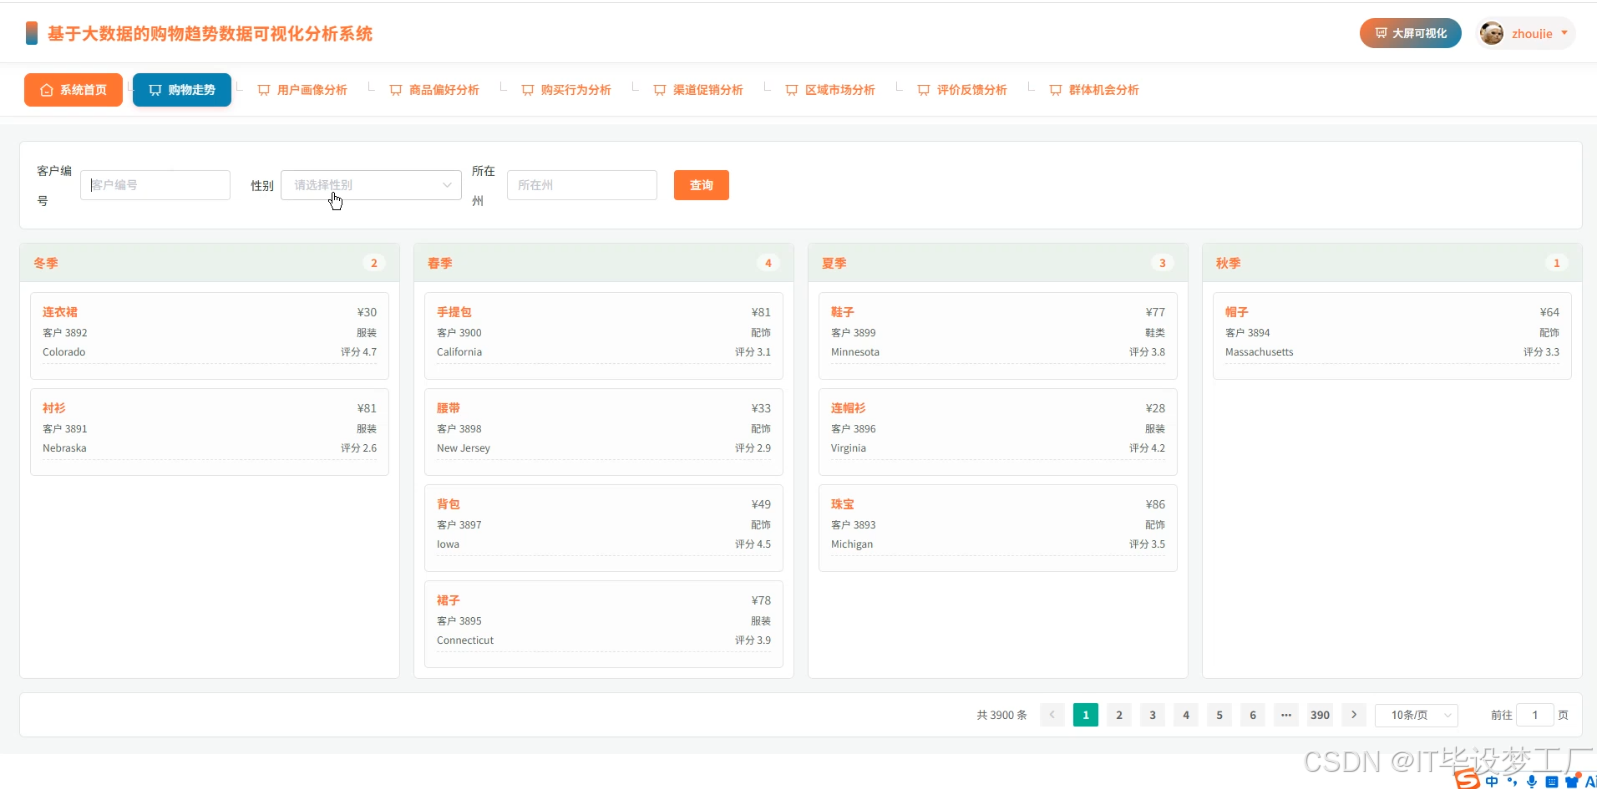
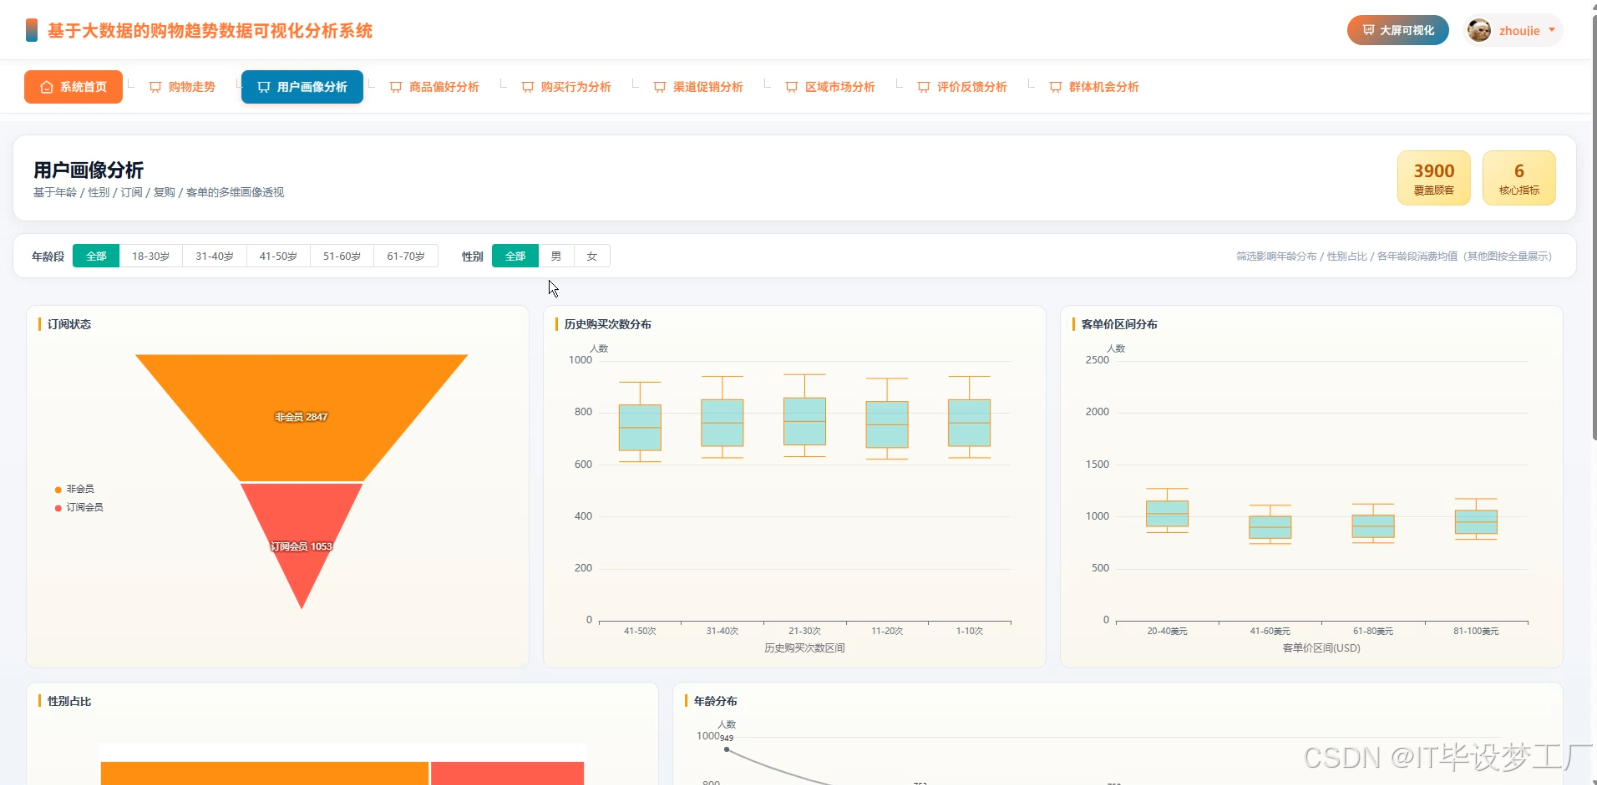
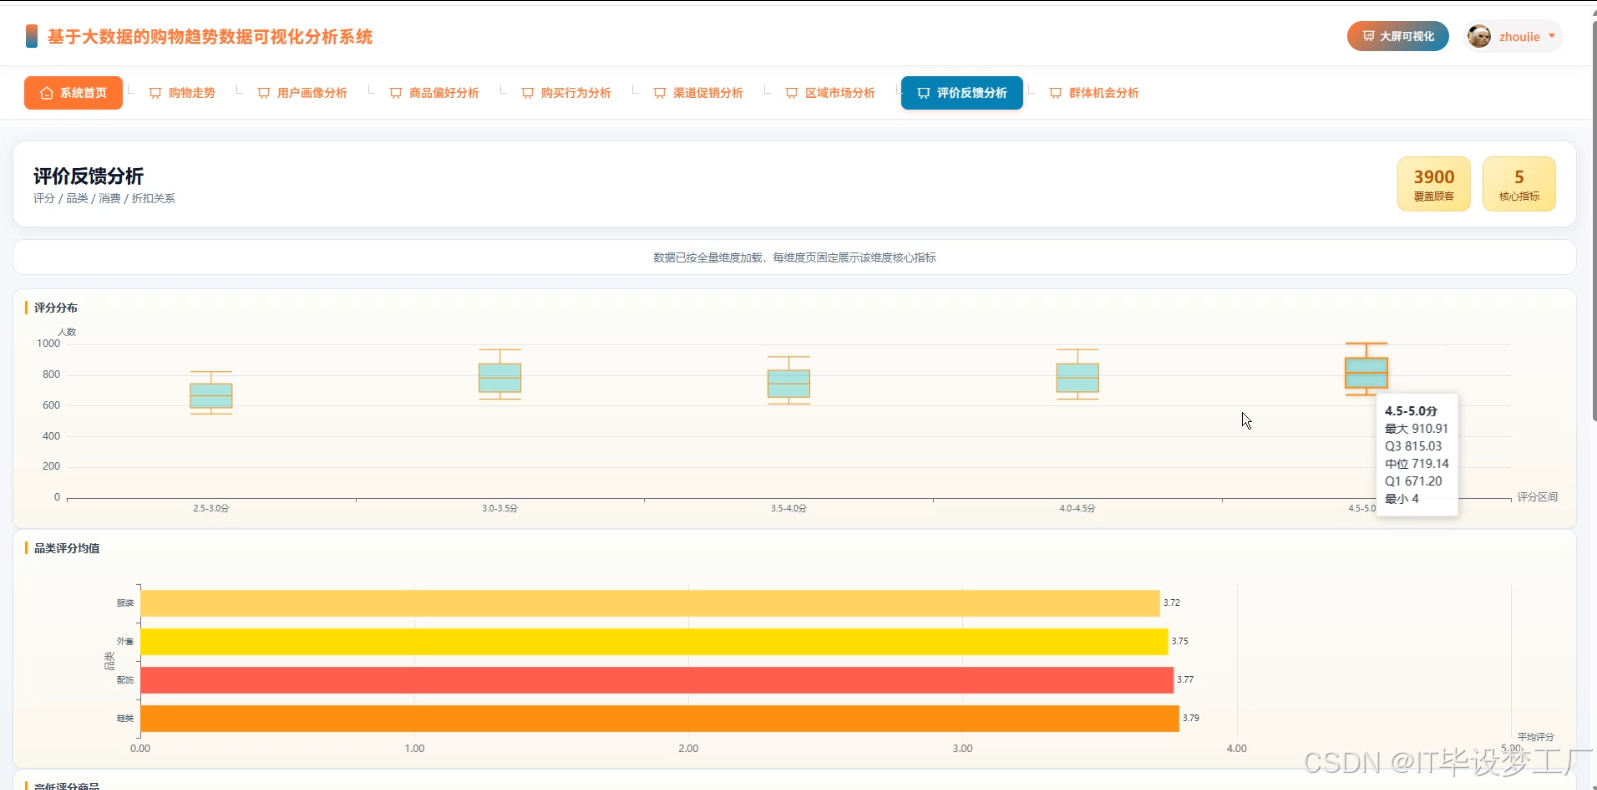
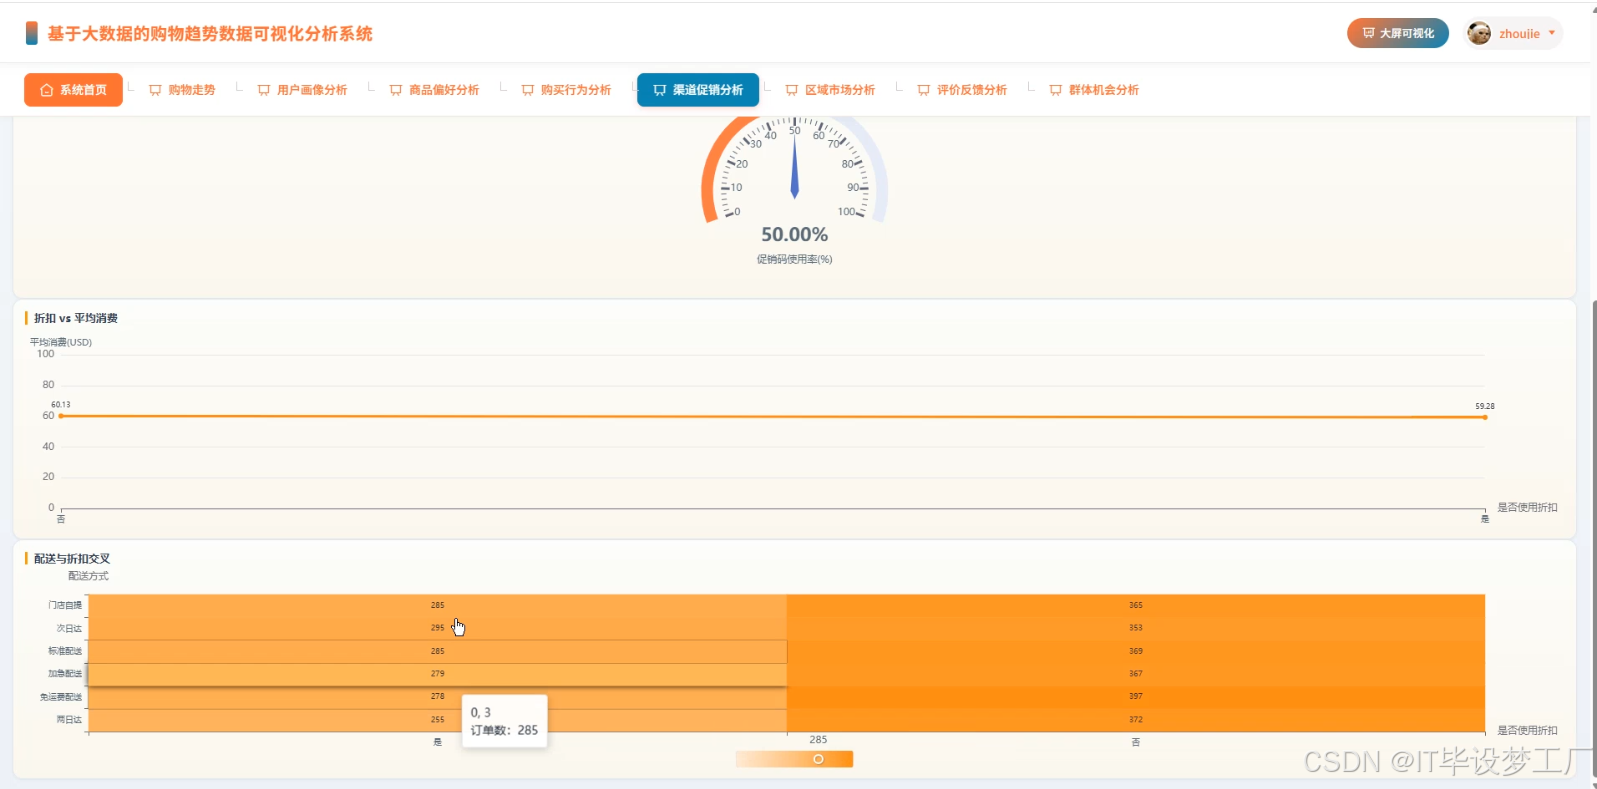
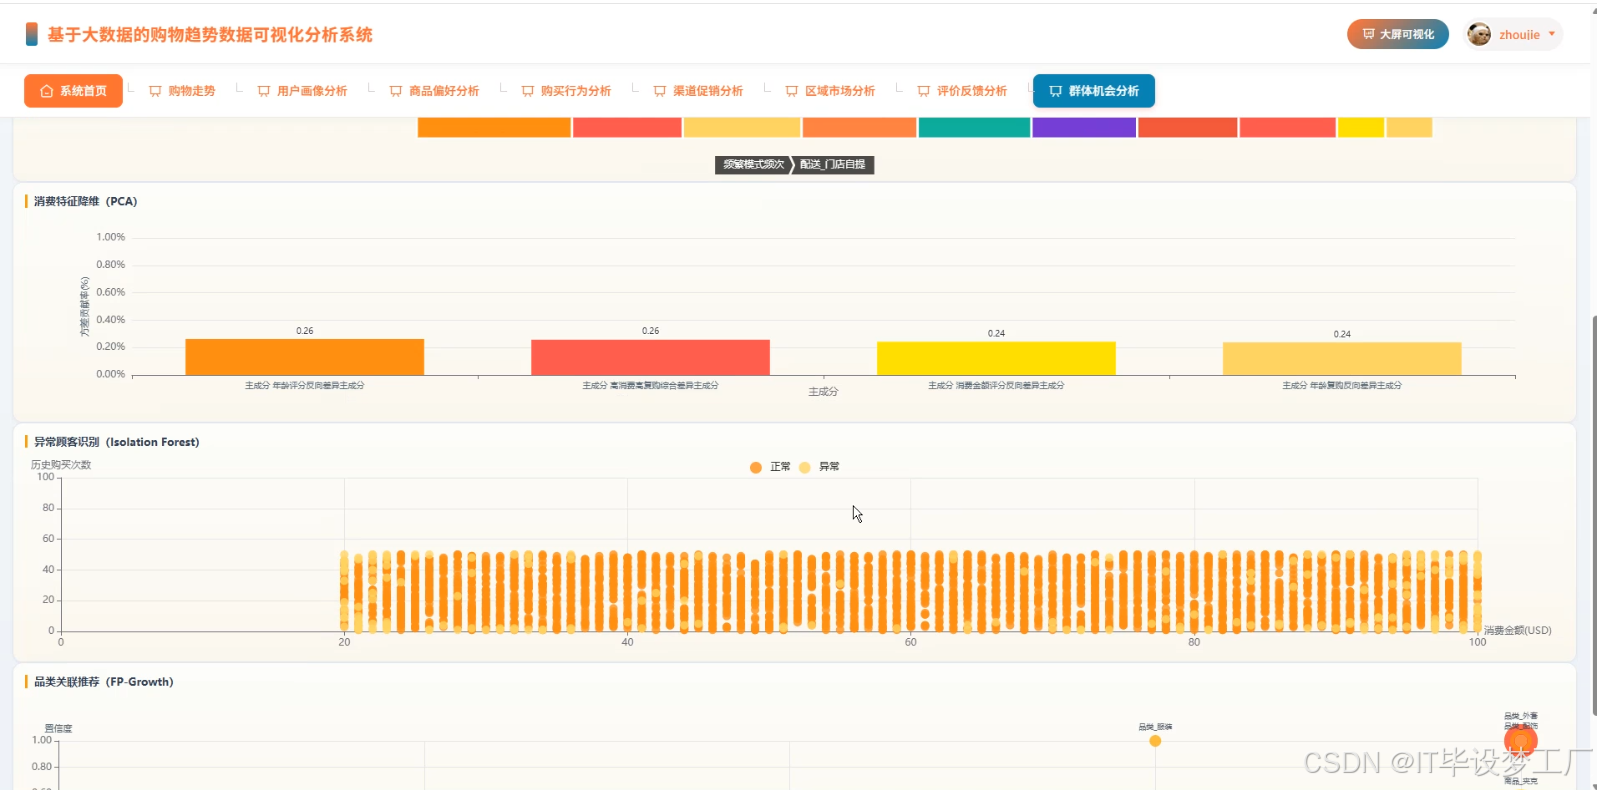
《基于大数据的购物趋势数据可视化分析系统》是一套面向计算机专业毕业设计的完整项目,主要用来把购物场景里产生的各类数据做一次系统化的整理、分析和展示。系统底层采用Hadoop加Spark这套大数据处理框架,用HDFS做数据存储,用Spark SQL配合Pandas、NumPy做数据清洗、统计和指标计算,后端提供Python的Django版本和Java的Spring Boot版本两套实现,前端用Vue加ElementUI,图表部分交给ECharts来渲染,数据库用的是MySQL。功能上,系统首页给出整体概览,大屏可视化把关键指标集中展示出来,用户模块负责登录和权限相关的基础操作,购物走势、用户画像分析、商品偏好分析、购买行为分析、渠道促销分析、区域市场分析、评价反馈分析、群体机会分析这些模块,分别从时间、人群、商品、行为、渠道、地域、口碑和机会几个角度去拆解购物数据,最后还有个人信息和修改密码两个基础页面。整套系统想做的事情并不复杂,就是让使用者能通过图表和指标,比较直观地看出购物趋势的变化和背后的规律,同时也让做毕设的同学能完整走一遍从大数据处理到可视化展示的流程。
二、开发环境
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
三、系统界面展示
- 基于大数据的购物趋势数据可视化分析系统系统界面展示:
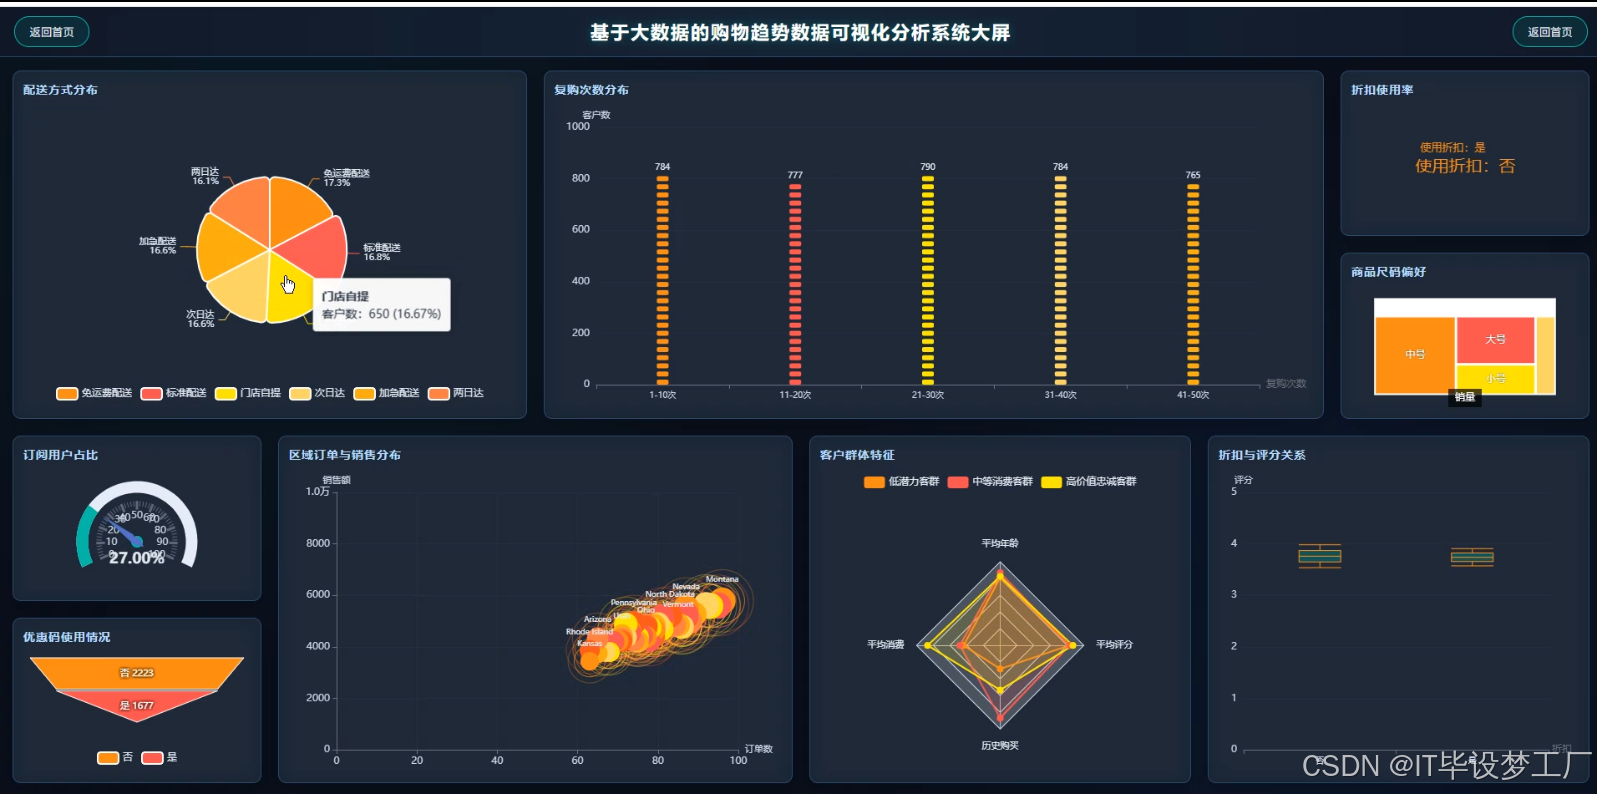
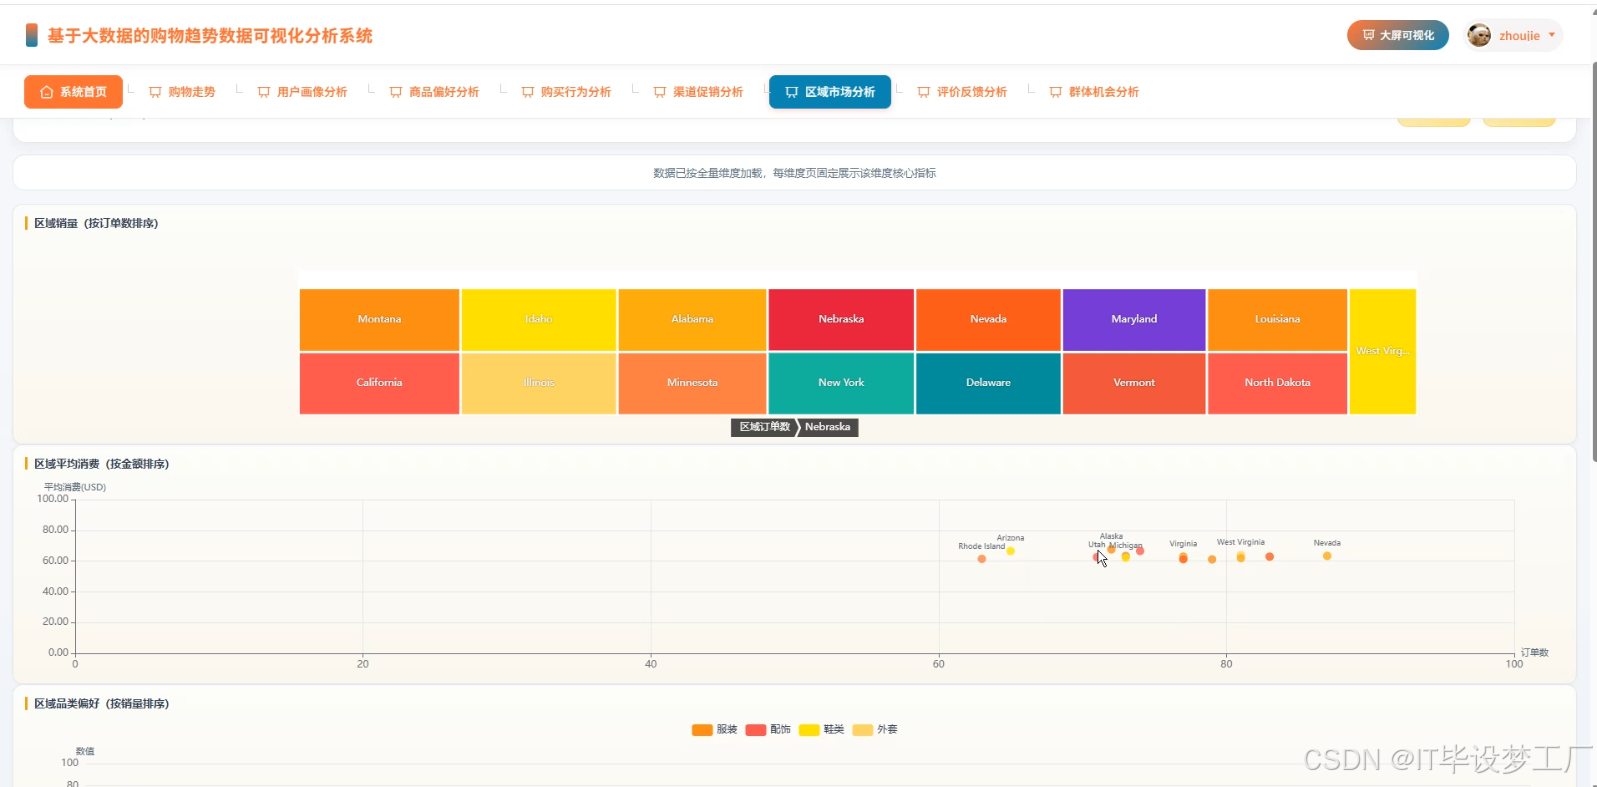
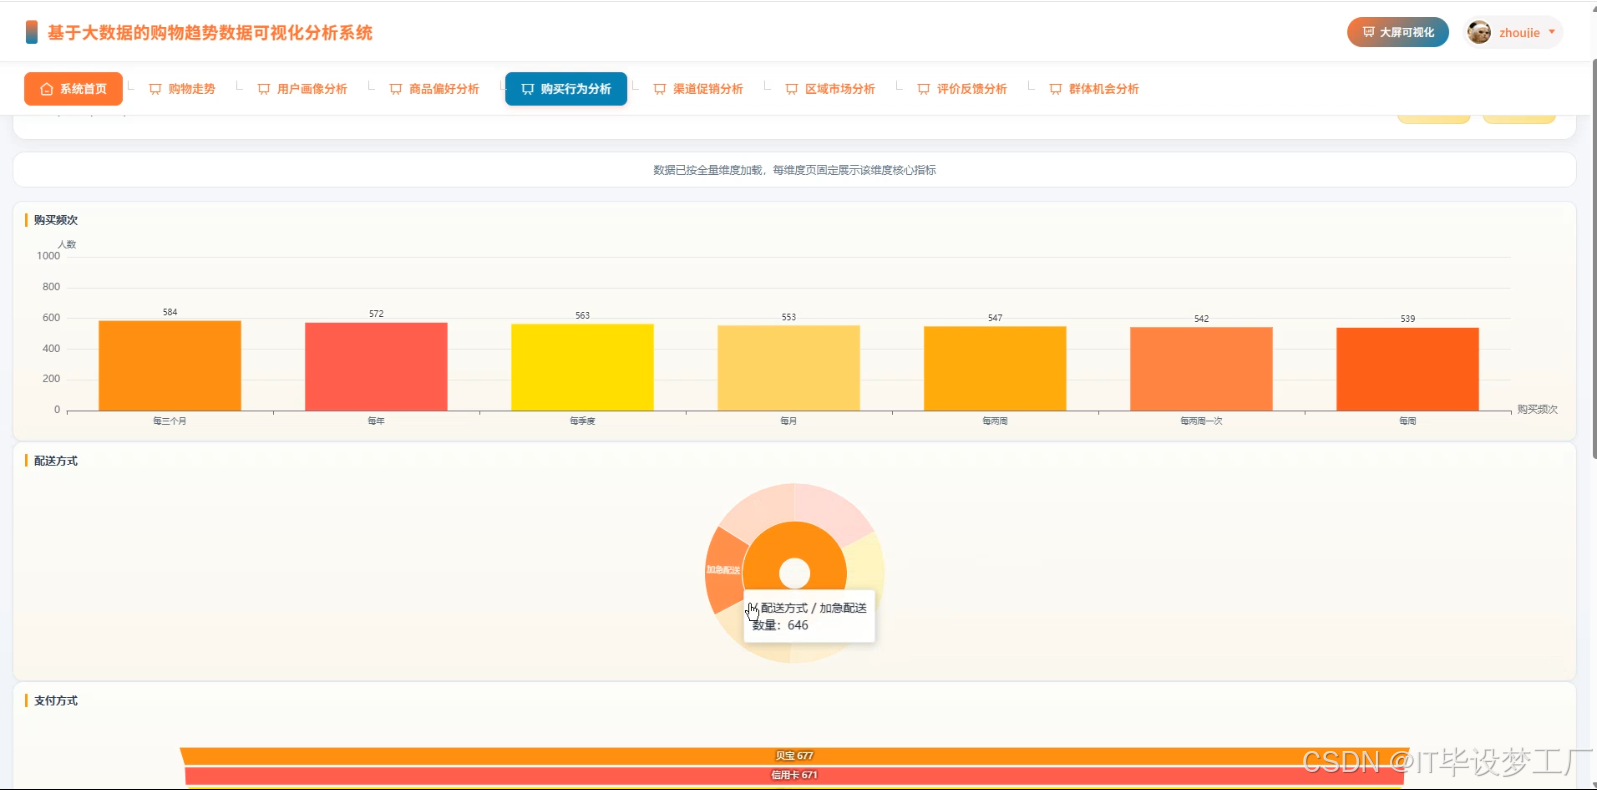
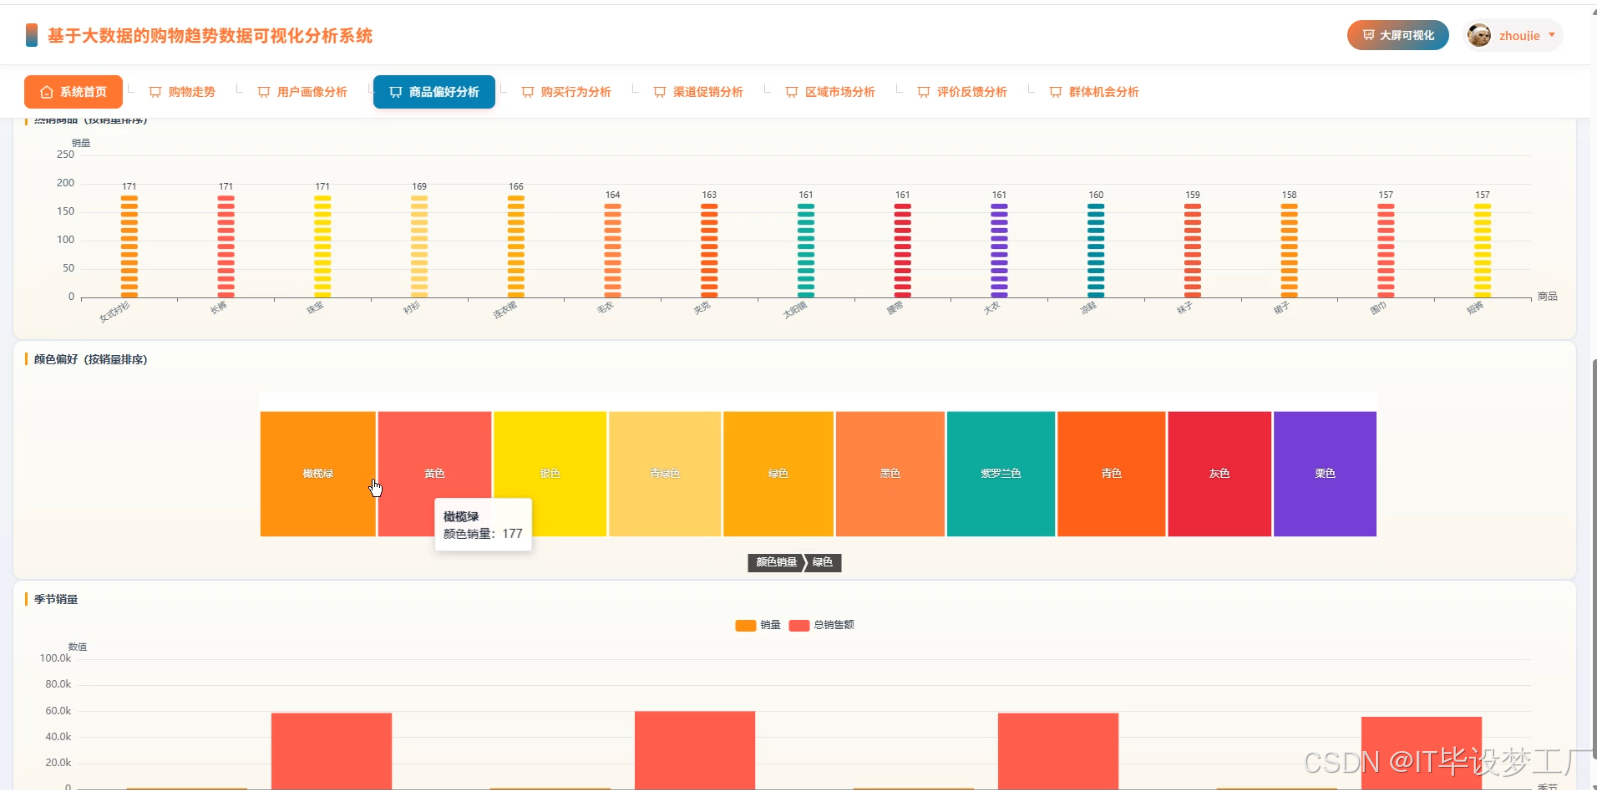
四、部分代码设计
- 项目实战-代码参考:
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum, count, avg, desc, to_date
from django.http import JsonResponse
from django.views.decorators.csrf import csrf_exempt
import json

spark = SparkSession.builder.appName("ShoppingTrendAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()

def shopping_trend_analysis(request):
    data_path = request.GET.get("data_path", "hdfs://localhost:9000/shopping/orders")
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(data_path)
    df = df.withColumn("order_date", to_date(col("order_time")))
    trend_df = df.groupBy("order_date").agg(sum("amount").alias("total_amount"), count("order_id").alias("order_count"), avg("amount").alias("avg_amount"))
    trend_df = trend_df.orderBy("order_date")
    result = trend_df.collect()
    trend_list = []
    for row in result:
        trend_list.append({"date": str(row["order_date"]), "total_amount": float(row["total_amount"]), "order_count": int(row["order_count"]), "avg_amount": float(row["avg_amount"])})
    return JsonResponse({"code": 200, "msg": "购物走势分析成功", "data": trend_list})

def user_portrait_analysis(request):
    data_path = request.GET.get("data_path", "hdfs://localhost:9000/shopping/users")
    order_path = request.GET.get("order_path", "hdfs://localhost:9000/shopping/orders")
    user_df = spark.read.option("header", "true").option("inferSchema", "true").csv(data_path)
    order_df = spark.read.option("header", "true").option("inferSchema", "true").csv(order_path)
    joined_df = order_df.join(user_df, on="user_id", how="inner")
    portrait_df = joined_df.groupBy("age_range", "gender", "city_level").agg(sum("amount").alias("total_amount"), count("order_id").alias("order_count"), avg("amount").alias("avg_amount"))
    portrait_df = portrait_df.orderBy(desc("total_amount"))
    result = portrait_df.collect()
    portrait_list = []
    for row in result:
        portrait_list.append({"age_range": row["age_range"], "gender": row["gender"], "city_level": row["city_level"], "total_amount": float(row["total_amount"]), "order_count": int(row["order_count"]), "avg_amount": float(row["avg_amount"])})
    return JsonResponse({"code": 200, "msg": "用户画像分析成功", "data": portrait_list})

def product_preference_analysis(request):
    data_path = request.GET.get("data_path", "hdfs://localhost:9000/shopping/orders")
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(data_path)
    product_df = df.groupBy("category", "product_name").agg(sum("amount").alias("total_amount"), sum("quantity").alias("total_quantity"), count("order_id").alias("order_count"))
    product_df = product_df.orderBy(desc("total_amount")).limit(50)
    result = product_df.collect()
    product_list = []
    for row in result:
        product_list.append({"category": row["category"], "product_name": row["product_name"], "total_amount": float(row["total_amount"]), "total_quantity": int(row["total_quantity"]), "order_count": int(row["order_count"])})
    return JsonResponse({"code": 200, "msg": "商品偏好分析成功", "data": product_list})
五、论文参考
- 计算机毕业设计选题推荐-基于大数据的购物趋势数据可视化分析系统系统-论文参考:
六、系统视频
- 基于大数据的购物趋势数据可视化分析系统系统-项目视频:
项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的购物趋势数据可视化分析系统|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇