做转录组研究时,经常会遇到两类棘手问题:RNA 测序结果和实验预期不一致;或者转录水平变化显著,但蛋白检测结果没有对应趋势。
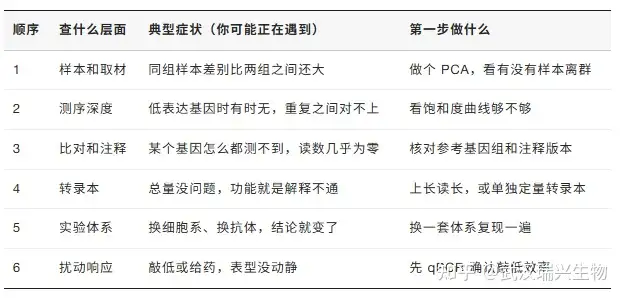
很多科研人员遇到该问题会盲目重复实验,浪费样本与时间。本文从样本取材、测序深度、比对注释、转录本、实验体系、扰动响应六个层面,系统性梳理排查思路,遇到 RNA 与蛋白表达不匹配的同学可以对照自查。
1 样本和取材------最容易被跳过的一层
先说最重要的:先看样本,再看测序。 很多"不符预期",最后追回来是取材本身的问题。
- ●组织不均一:一整块组织磨出来的 RNA,是里面所有细胞的平均值。比如肿瘤组织,肿瘤细胞占 30% 还是 50%,测出来的"差异"可能只是细胞比例变了,不是细胞真的变了。做组织样本的,最好配一张组织切片评估;
- ●细胞弄错了:细胞系身份要对一遍。买错、污染、传代太多次导致性状漂移,都会让结论整个跑偏------这是花五分钟能排除、却能省掉一个月的事;
- ●样本降解了:RNA 放久了会断。断得厉害的样本,测出来会偏 3' 端,本来表达正常的基因,看着就像"表达下降"。
怎么判断 :先做 PCA。如果同一组的样本之间差别,比两组之间的差别还大,别往下做差异分析了,回去查样本。
2 测序深度------测得不深,差异是"抽"出来的
低表达基因,本来就时灵时不灵。 测序量不够的时候,同一个基因可能这批样本测到了、那批没测到,到了差异分析里,就成了假阳性或者假阴性。
怎么判断 :挑几个你在意的基因,看看它们的检出情况在重复样本里是不是一致。不一致,就补测序量或者换更深的方案------别急着解读数据。
3 比对和注释版本------"这个基因测不到"的技术原因
有些基因测不到,跟生物学一点关系都没有,纯粹是技术问题。
最常见的是参考版本不统一:比如两批数据用了不同版本的注释文件,新发现的转录本在老版本里根本不存在,测到的读数就被丢到一个"空坐标"上,看起来就是没表达。比对率异常低,还要考虑污染或者参考序列选错了。
怎么判断:看一眼比对率是否正常,再确认所有数据的参考版本和注释版本是不是同一套。特别是不同时间点、不同人做的数据,最容易混版本。
4 转录本------总量没问题,功能解释不通
前三层都干净了,数据还是不对劲,就轮到这一层。这一层最容易被漏掉。
同一个基因,可以做出好几种转录本。 常规测序只算这个基因的总账,不区分是哪几种。
一个真实案例(Communications Biology,IF 5.8):同一批阿尔茨海默病脑组织,研究者分了两路------一路用常规短读长测序,算"基因总量";一路用长读长测序,数"每种转录本各占多少"。
结果很有意思:SEPTIN4 这个基因,在常规测序的差异基因列表里完全找不到。 换成能分转录本的方法一看才明白------它的一种转录本在病人里明显减少,另一种转录本却明显增多,一个减一个加,加起来正好抵消。所以从"总量"上看,它毫无变化。研究者又用 RT-PCR 一个个样本验证过,两种转录本确实都真实存在。
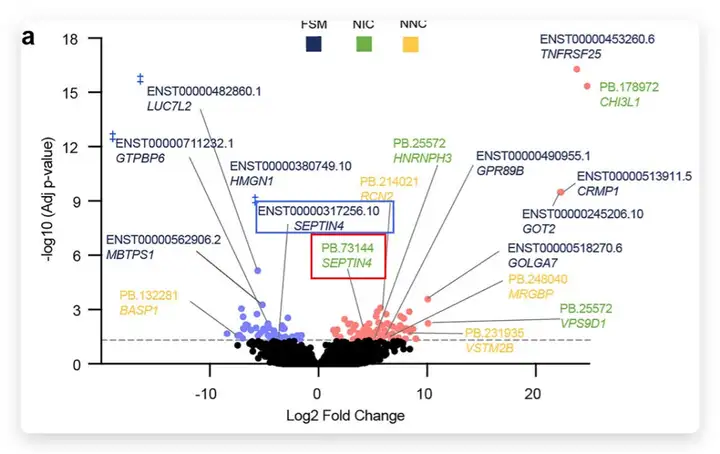
SEPTIN4 一减一加互相抵消
什么时候该往这一层查:① 差异分析结果和你的表型方向相反,或者该出现的基因没出现;② 配对样本里,总量变化解释不了功能变化;③ 你研究的正好是 HER2、EGFR、MET、ALK 这类容易做出多种转录本的基因。
要查这一层,可以按需要选 :想看一个基因到底有几种转录本 ,用全长转录组测序(ONT-lrRNA-seq);想同时看poly(A) 尾长和 APA 位点 (APA 指同一个基因在不同位置截断,做出长短不一的结尾),用含 poly(A) 尾全长转录组测序(ONT-PAIrRNA-seq)------这条路测的是尾巴,看不到 RNA 修饰 ;想看 RNA 修饰 (m6A/m5C 这类),用直接 RNA 测序(ONT-DRS);想看每个细胞分别用了哪种转录本,用单细胞三代全长转录组测序。
5 实验体系------体系不对,照样出反结论
RNA 测对了,体系不对,结论还是错的。
- ●细胞系差异:同一条通路,在两个细胞系里方向相反,是很常见的事(遗传背景不同)。只做一个细胞系就下结论,要小心;
- ●抗体对不上 :抗体不专一,或者它识别的那一段正好在不同转录本之间有差别,WB 和 IHC 的条带就会和预期不符。所以"这个抗体认的是哪种转录本",本身就值得先确认一下------有些转录本缺了抗体识别的位点,条带自然出不来,这不是实验做坏了;
- ●批次效应:不同批试剂、不同人操作,会把技术差别混进生物学差别里。
怎么判断:换一套独立体系、或者换一个识别位点不同的抗体,再复现一遍。两套都做不出来,这个结论先存疑。
6 扰动响应------敲低没反应,不一定是没敲掉
这层最容易误判。 敲低或给药之后表型没变化,第一反应往往是"没敲掉"或者"药没用",但也可能是下面几种:
- ●代偿:这个基因被压下去了,通路里别的成员顶上来,表型被兜住了;
- ●功能相似可替代:同一家族里有几个基因干相似的活,敲掉一个看不出变化;
- ●靶点根本没表达:你以为它在,其实它不在------这是最该先确认的一件事。
怎么判断 :先用 qPCR 确认敲低效率,再补一层蛋白证据(WB,或者单细胞蛋白组 AbSeq)。RNA、蛋白、表型三层都对上了,结论才站得住。
总结:就按这个顺序查
样本 → 深度 → 注释 → 转录本 → 体系 → 扰动。
顺序别乱:前面的层出问题,后面的层怎么查都查不出来。 大多数"不符预期",在第 1、2 层就能找到原因。前三层干净、总量也对,才轮到转录本。
你手头有没有"RNA 和蛋白对不上"的经历?留言说说现象。