引言:一场没有终点的博弈
2014年,Ian Goodfellow和他在蒙特利尔大学的同事们发表了一篇仅八页的论文,提出了一个在当时看来近乎异想天开的想法:如果用两个神经网络互相对抗来训练生成模型会怎样?这篇论文开创了生成对抗网络(Generative Adversarial Network, GAN)这一领域,也开启了一场持续至今的"猫鼠游戏"。
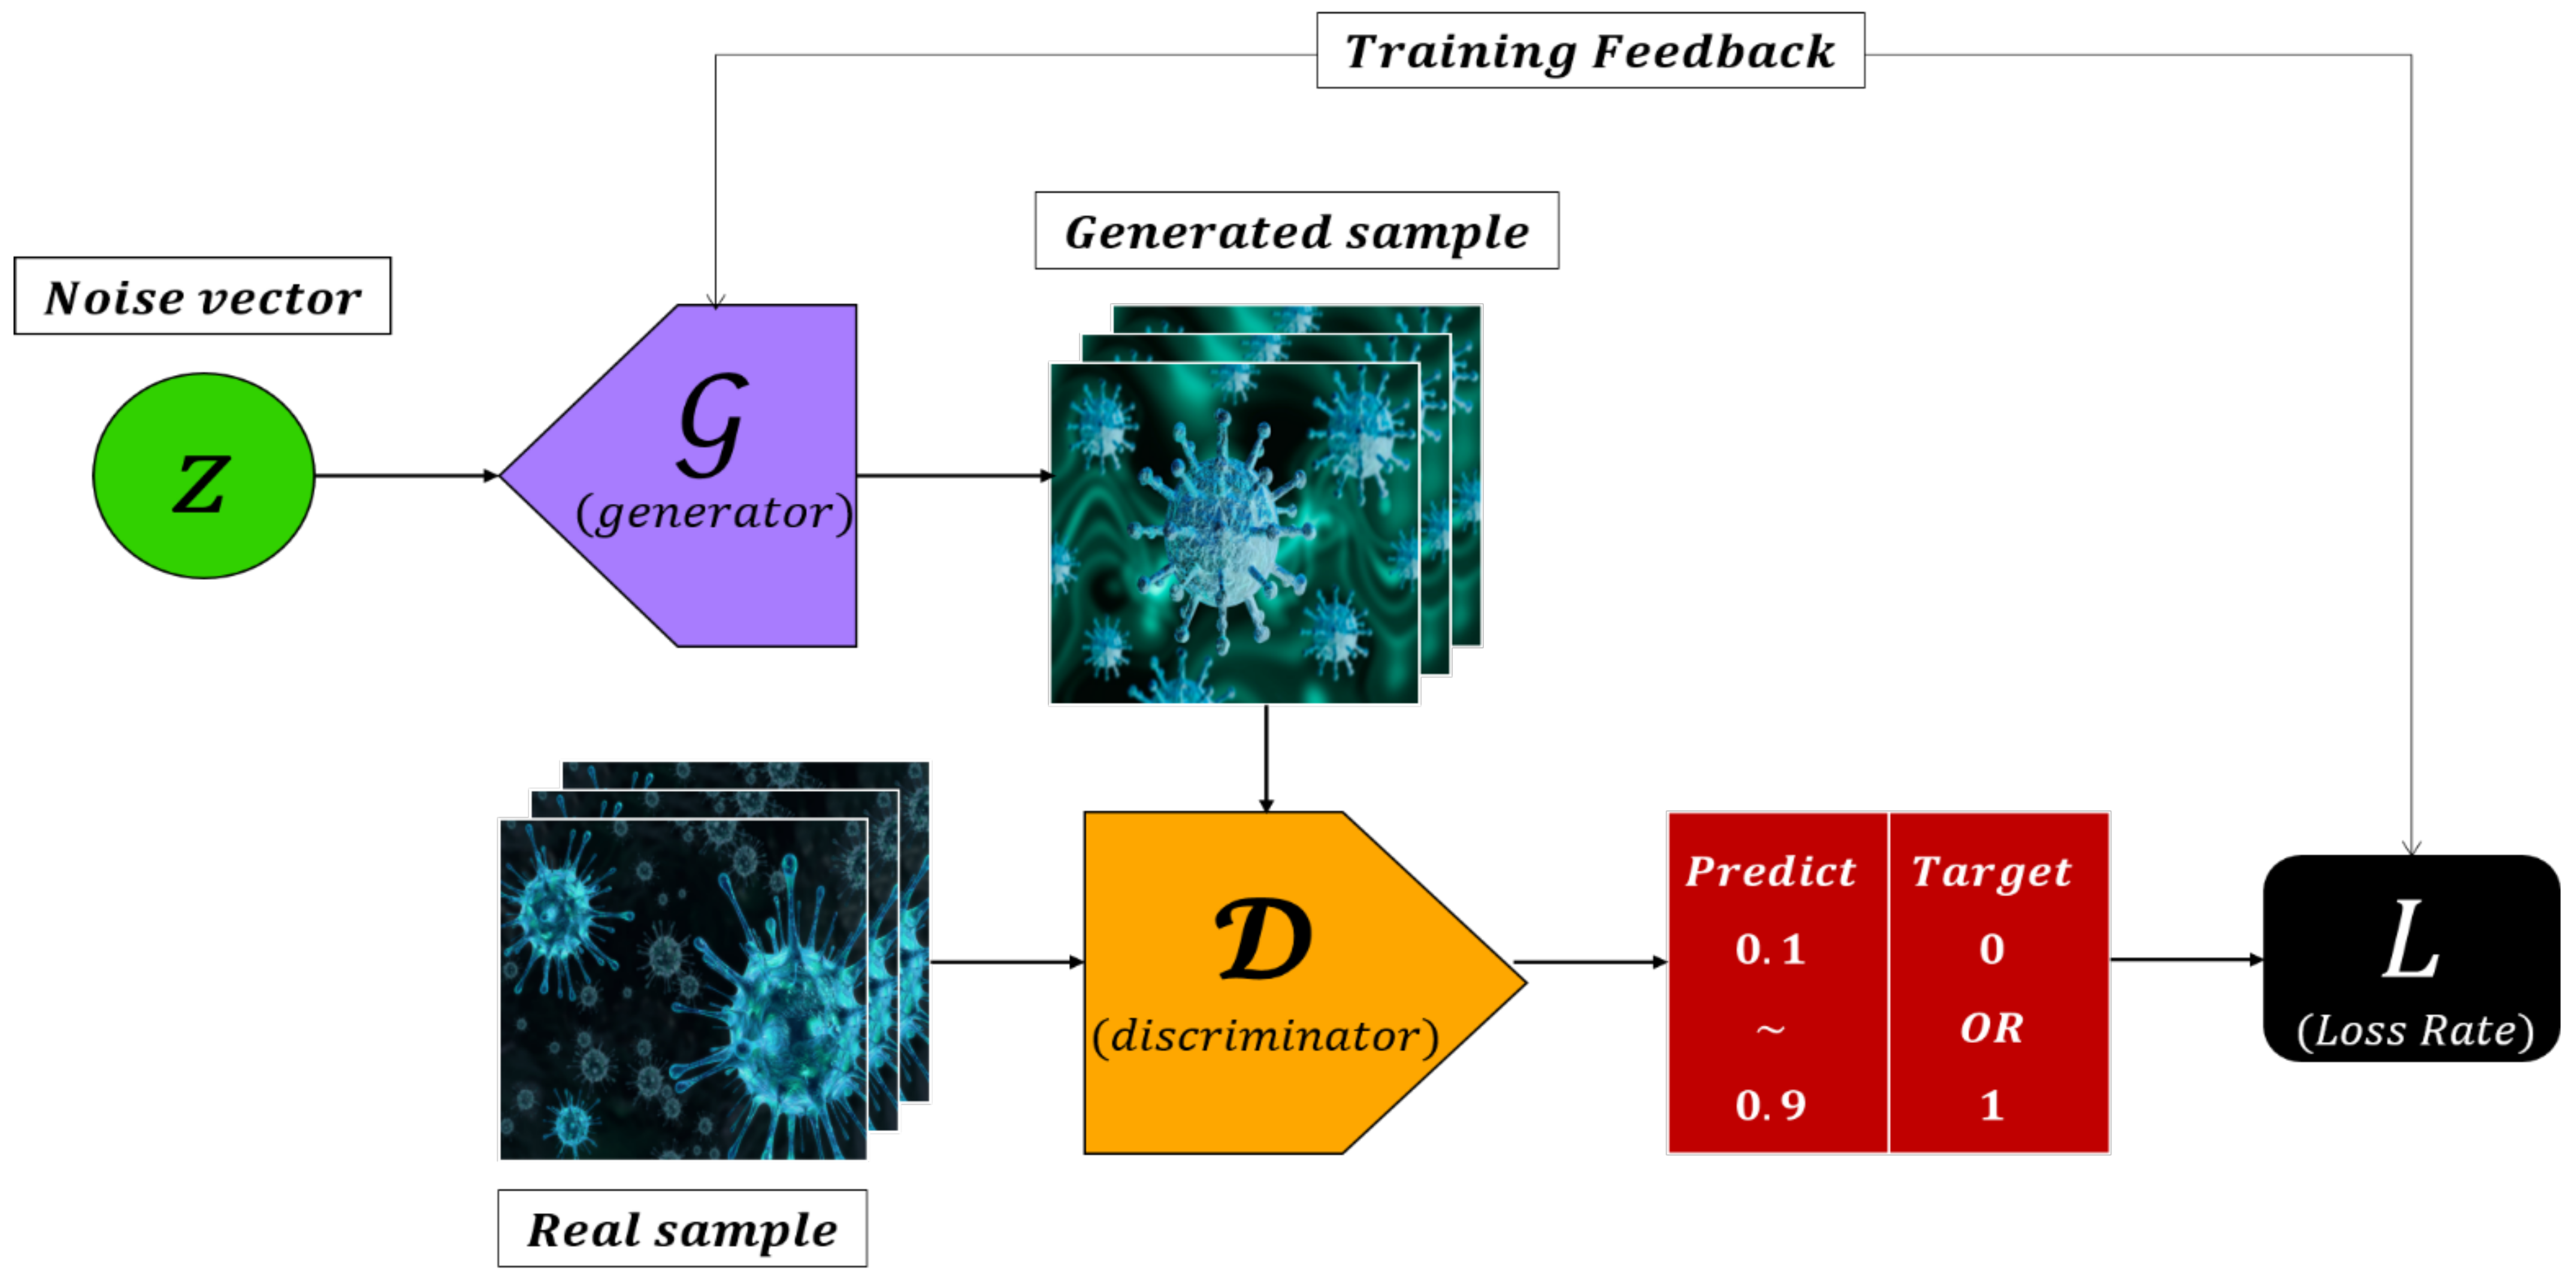
GAN的核心思想极其简洁:让一个网络负责生成假数据(生成器),另一个网络负责辨别真假(判别器),两者在训练中互相竞争、共同进化。生成器的目标是骗过判别器,判别器的目标是识破生成器的伪装。这种对抗关系迫使生成器不断提升造假水平,直到它生成的样本与真实数据几乎无法区分。
这个想法之所以深刻,是因为它把生成问题转化为一个博弈问题。传统生成模型直接优化"生成样本与真实样本的相似度",而GAN让模型自己学会什么是"像"------通过判别器这个动态的、不断升级的评判标准。这种对抗性训练的思想,后来不仅深刻影响了生成建模,还渗透到强化学习、表示学习、甚至AI安全等多个领域。
理解GAN,需要理解这场博弈的规则、双方的策略、以及博弈中出现的种种微妙平衡。本文将从生成模型的问题出发,逐步解剖GAN的数学原理、架构设计、训练动态,以及它面临的挑战和演进。
第一部分:生成模型的核心难题
什么是生成模型
生成模型的目标是学习数据分布 pdata(x)pdata(x),然后从中采样生成新的样本。给定一堆猫的图片,生成模型应该能生成出新的、从未存在过的猫的图片,而不是简单地复制训练数据。
这个问题比分类或回归困难得多。在分类任务中,模型只需要学习一个从输入到标签的映射;在生成任务中,模型需要刻画整个数据分布的复杂结构------所有像素之间的相关性、语义的一致性、风格的连贯性。一张 256×256256×256 的RGB图像有近20万个维度,数据分布在这个超高维空间中占据了极其复杂的流形结构。
传统方法的困境
在GAN之前,生成模型主要有两类方法。
变分自编码器(VAE) 通过编码器将输入映射到一个潜在空间,再通过解码器重建输入。它的目标函数包含重建误差和KL散度正则项。VAE的训练稳定,但生成样本往往模糊------因为它的损失函数(通常是均方误差)倾向于产生"平均"的结果,缺乏高频细节。
自回归模型(如PixelRNN、PixelCNN)逐像素生成图像,每个像素的条件概率依赖于之前生成的所有像素。这种方法能生成清晰的图像,但生成速度极慢------生成一张 256×256256×256 的图像需要逐像素进行65536次前向传播。
这两类方法的核心困境在于:如何定义一个既计算可行、又能促使模型生成高质量样本的损失函数 。均方误差导致模糊,逐像素似然导致缓慢。GAN的洞察是:不要手动设计损失函数,而是让一个神经网络来学习这个损失函数。
第二部分:对抗博弈的数学框架
生成器与判别器的角色
GAN由两个网络组成:
生成器 G:接收一个随机噪声向量 z(通常从标准正态分布采样),输出一个生成样本 G(z)。它的目标是让 G(z) 尽可能像真实数据,从而骗过判别器。生成器可以看作一个从低维潜在空间到高维数据空间的映射函数。
判别器 D:接收一个样本 x,输出一个标量 D(x)∈0,1,表示 x 是真实样本的概率。它的目标是尽可能准确地区分真实样本和生成样本。
两者构成了一个零和博弈:生成器的收益等于判别器的损失,反之亦然。生成器想要最大化判别器犯错的可能性,判别器想要最小化自己的分类错误。
极小极大目标函数
GAN的目标函数可以写成一个极小极大(minimax)问题:
GminDmaxV(D,G)=Ex∼pdata(x)logD(x)+Ez∼pz(z)log(1−D(G(z)))
这个公式需要仔细解读。
对于判别器来说,它要最大化 V(D,G):
-
第一项 Ex∼pdatalogD(x):对真实样本,判别器希望 D(x) 接近1,即 logD(x) 接近0(最大值)。
-
第二项 Ezlog(1−D(G(z))):对生成样本,判别器希望 D(G(z)) 接近0,即 log(1−D(G(z))) 接近0。
所以判别器的目标是:给真实样本打高分,给生成样本打低分。
对于生成器来说,它要最小化 V(D,G)。但第一项与 G 无关,所以生成器只优化第二项:
GminEzlog(1−D(G(z)))
生成器希望 D(G(z)) 接近1,即判别器把生成样本误判为真实样本。此时 log(1−D(G(z))) 趋向负无穷,最小化这个值就是让判别器犯错。
从博弈到分布匹配
这个博弈的均衡点在哪里?Goodfellow等人证明了一个重要结论:在生成器能力不受限的情况下,最优判别器为:
D∗(x)=pdata(x)+pg(x)pdata(x)
其中 pg 是生成器学到的分布。这个公式的直觉是:判别器在某个样本上的输出,取决于该样本来自真实分布和生成分布的概率之比。如果 pdata(x)=pg(x),则 D∗(x)=1/2------判别器完全无法区分,只能随机猜测。
将这个最优判别器代入目标函数,可以证明生成器的最小化目标等价于最小化真实分布与生成分布之间的 Jensen-Shannon散度(JSD):
GminV(D∗,G)=−log4+2⋅JSD(pdata∥pg)
JSD是非负的,当且仅当两个分布完全相同时为零。因此,博弈的全局最优解是 pg=pdata,此时生成器完美复制了真实分布,判别器输出恒为 1/2。
这个理论结果极其优雅:它把"生成逼真样本"这个模糊的目标,转化为了"最小化两个分布的JSD"这个明确的数学问题。但理论上的优雅,掩盖了实践中的重重困难。
第三部分:训练动态------猫鼠游戏的现实
交替训练的算法
GAN的训练采用交替优化的方式。每一轮迭代分两步:
第一步:训练判别器。 固定生成器 G,从真实数据中采样一批 x,从噪声中采样一批 z 并生成 G(z)。计算判别器损失:
LD=−ExlogD(x)−Ezlog(1−D(G(z)))
通过梯度上升更新判别器参数,使其更好地分辨真假。
第二步:训练生成器。 固定判别器 D,采样一批噪声 z,计算生成器损失:
LG=−EzlogD(G(z))
通过梯度下降更新生成器参数,使其生成的样本更容易被判别器误判为真实。
注意这里生成器损失的实际实现形式:原始论文中使用 log(1−D(G(z))),但实践中更常用 −logD(G(z))。原因在于梯度行为:当判别器很强时(D(G(z))≈0),log(1−D(G(z))) 的梯度会饱和,导致生成器学不到东西;而 −logD(G(z)) 在 D(G(z))≈0 时梯度很大,能提供更强的学习信号。
理想与现实的分裂
理论分析假设生成器和判别器都有无限容量,且训练可以达到各自的全局最优。现实中,两个网络都是有限容量的神经网络,训练是迭代的、不完美的。这导致了一系列问题。
模式崩溃(Mode Collapse) 是最常见的问题。生成器可能发现某些样本特别容易骗过判别器,于是反复生成这些样本,而忽略数据分布的其他模式。例如,在训练生成手写数字时,生成器可能只生成"1",因为"1"最简单、最容易骗过判别器。此时生成器损失很低,但生成样本的多样性严重不足。
模式崩溃的根源在于生成器的优化目标是"骗过当前判别器",而不是"覆盖整个数据分布"。如果判别器对某个模式的识别能力较弱,生成器就会利用这个漏洞,把所有概率质量集中到这个模式上。
训练不稳定 是另一个核心问题。GAN的训练是一个动态博弈,没有固定的损失函数景观。判别器和生成器的能力必须保持某种平衡:判别器太弱,生成器得不到有效的梯度信号;判别器太强,生成器梯度消失,学不动。
这种平衡极其脆弱。实践中,训练GAN需要精心调整学习率、网络架构、优化器参数,甚至需要多次尝试不同的随机种子。Goodfellow本人曾调侃说,训练GAN需要"运气"。
梯度消失 是判别器过强时的典型症状。当判别器能完美区分真假样本时,D(G(z))≈0,生成器损失 log(1−D(G(z))) 的梯度趋于零。生成器收不到有效的学习信号,训练停滞。
博弈的均衡未必是收敛
从动力系统的角度看,GAN的训练是在寻找一个纳什均衡。但梯度下降-上升算法在博弈中并不保证收敛。即使存在均衡点,交替梯度更新也可能导致振荡、发散、或陷入极限环。
一个简单的例子:如果生成器和判别器的学习率不匹配,判别器更新太快,生成器就会被"甩在后面",永远追不上判别器的判别标准。反之,生成器更新太快,判别器来不及适应,也会导致训练失控。
这种动态复杂性使GAN的理论分析极其困难。直到今天,我们仍然没有一套完整的理论能解释GAN训练中的所有现象。
第四部分:架构的演进------从DCGAN到StyleGAN
DCGAN:卷积的引入
原始GAN使用全连接网络,生成图像质量很差。2015年,Radford等人提出了DCGAN(Deep Convolutional GAN),将卷积神经网络引入GAN,并总结了一套架构设计准则:
-
生成器使用转置卷积(反卷积)进行上采样,从低分辨率逐步生成高分辨率图像。
-
判别器使用步长卷积进行下采样,逐步提取特征并输出分类结果。
-
使用批归一化(Batch Normalization)稳定训练。
-
生成器输出层使用tanh激活,判别器使用LeakyReLU。
-
去除全连接层,使用全局池化。
DCGAN首次让GAN能够生成具有一定分辨率和多样性的图像,奠定了后续GAN架构的基础。
条件GAN:可控生成
原始GAN生成的是随机样本,无法控制生成内容。条件GAN(cGAN)通过将条件信息(如类别标签、文本描述)同时输入生成器和判别器,实现了可控生成。
生成器接收噪声 z 和条件 y,输出 G(z,y);判别器接收样本 x 和条件 y,输出 D(x,y)。条件信息可以通过拼接、嵌入、或注意力机制注入网络。
条件GAN打开了应用的大门:根据标签生成特定类别的图像、根据文本描述生成图像、根据草图生成照片等。
WGAN:重新定义距离
原始GAN的JSD在分布不重叠时会饱和,导致梯度消失。2017年,Arjovsky等人提出了Wasserstein GAN(WGAN),用Earth Mover's Distance(EMD,又称Wasserstein距离)替代JSD。
Wasserstein距离衡量的是"将一个分布移动到另一个分布所需的最小代价"。即使两个分布完全不重叠,它也能提供有意义的梯度。WGAN的判别器(此时称为"评论家",Critic)不再输出概率,而是输出一个实数分数,且需要满足Lipschitz连续性约束。
WGAN通过权重裁剪或梯度惩罚(WGAN-GP)来强制Lipschitz约束。它的训练稳定性显著优于原始GAN,模式崩溃也大大减少。WGAN是GAN发展史上的一个里程碑,它让GAN的训练从"玄学"向"工程"迈进了一步。
StyleGAN:解耦风格与内容
2018-2019年,NVIDIA的StyleGAN系列将GAN的图像生成质量推向了前所未有的高度。StyleGAN的核心创新是风格调制:生成器的每一层都接收一个风格向量,通过自适应实例归一化(AdaIN)调制特征图的统计量。
这种设计实现了风格与内容的解耦:低层风格控制姿态、脸型等粗粒度特征,中层风格控制发型、眼睛等中粒度特征,高层风格控制肤色、纹理等细粒度特征。StyleGAN生成的1024×1024人脸图像,在多数评判标准下已经与真实照片无法区分。
StyleGAN还引入了噪声注入机制,在每一层添加随机噪声,增加生成图像的细节多样性(如毛孔、发丝)。这种精细的架构设计,代表了GAN在图像生成领域的巅峰。
第五部分:评估的困境
生成质量如何衡量
GAN的训练目标是一个博弈,没有像交叉熵那样明确的损失值来反映生成质量。如何评估一个GAN的好坏,本身就是一个难题。
Inception Score(IS) 使用预训练的Inception网络评估生成图像。它衡量两个指标:生成图像的类别置信度(是否清晰)和类别多样性(是否覆盖多个类别)。IS的局限是它只关心类别层面的多样性,不关心同一类别内的多样性。
Fréchet Inception Distance(FID) 是目前最常用的指标。它提取真实图像和生成图像在Inception网络某一层的特征,假设这些特征服从多维高斯分布,然后计算两个分布之间的Fréchet距离。FID越低,表示生成分布与真实分布越接近。FID对模式崩溃敏感,且与人类感知质量有较好的相关性。
Precision and Recall 将生成质量分解为两个维度:Precision衡量生成样本中有多少是"高质量"的(接近真实分布),Recall衡量真实分布中有多少模式被生成器覆盖了。这两个指标分别对应生成样本的保真度和多样性。
评估的哲学问题
所有这些指标都依赖于预训练网络提取的特征,而这些特征本身可能带有偏见。此外,指标之间的相关性并不完美:一个GAN可能在FID上表现优异,但在人类评判中生成样本缺乏多样性。
更深层的问题是:生成模型的终极目标是什么?是复制训练分布,还是理解数据的生成过程,还是创造新的、有意义的内容?不同的目标需要不同的评估标准。GAN的评估困境,反映了生成建模领域对自身目标的尚未完全明确。
第六部分:GAN的遗产与影响
对生成建模的推动
GAN最大的贡献是对抗训练这一范式。它证明了不需要显式的似然函数,也可以通过博弈来训练生成模型。这一思想启发了后续大量工作:
-
对抗样本:在分类器中添加微小扰动使分类错误,成为AI安全的重要研究方向。
-
域适应:通过对抗训练让源域和目标域的特征分布对齐。
-
图像翻译:CycleGAN、pix2pix等实现了无需配对数据的图像到图像转换。
与扩散模型的竞争
2020年后,扩散模型(Diffusion Model)迅速崛起,在图像生成质量上超越了GAN。扩散模型通过逐步去噪生成样本,训练稳定、模式覆盖好、生成质量高。DALL-E 2、Stable Diffusion、Midjourney等产品都基于扩散模型。
GAN是否被淘汰了?并非如此。GAN在推理速度上有天然优势:生成一张图像只需要一次前向传播,而扩散模型需要数十到数百步去噪。在实时生成、视频生成、交互式应用等场景中,GAN仍然具有不可替代的价值。
此外,GAN的对抗思想与扩散模型正在融合。一些工作使用对抗损失来加速扩散模型的采样,或用扩散模型作为GAN的判别器。这两种范式的边界正在变得模糊。
更广泛的启示
GAN的意义超越了生成建模本身。它展示了一种学习如何学习的元思想:不手动设计损失函数,而是让另一个网络来学习损失函数。这种思想在元学习、强化学习(如GAIL)、表示学习(如对抗自编码器)中都有体现。
GAN也提醒我们,优化目标的定义与优化算法本身同样重要。一个好的目标函数不仅要数学上合理,还要在优化上可行。GAN的理论优雅与训练困难之间的张力,是机器学习中"理论-实践差距"的经典案例。
结语:一场仍在继续的博弈
回到那个猫鼠游戏的比喻。生成器是那只不断进化伪装能力的"老鼠",判别器是那只不断升级识别能力的"猫"。在理想的博弈中,两者共同进化,最终达到一个平衡点------老鼠的伪装完美无缺,猫只能随机猜测。
现实中的博弈远比这复杂。猫和老鼠的能力必须匹配,任何一方过强都会导致博弈崩溃。训练过程中的振荡、模式崩溃、梯度消失,都是这场博弈中的"意外"。但正是这些挑战,推动了GAN架构和训练算法的持续创新。
从2014年的八页论文,到StyleGAN的逼真人脸,到与扩散模型的融合,GAN走过了十余年的历程。它没有解决所有问题,但它改变了我们思考生成建模的方式。对抗训练的思想已经成为机器学习工具箱中的基本工具,而"生成器与判别器的猫鼠游戏"这个隐喻,将继续启发新一代的研究者。
在生成式AI爆发的今天,回看GAN的故事,我们看到的不仅是一个模型的兴衰,更是一种思维方式的胜利:让模型在竞争中学习,在对抗中进化。这或许才是GAN留给我们最持久的遗产。