机器学习二分类预测算法组合工具:12种算法、113种组合的批量建模方案8031期
在生物标记物筛选、临床预后模型构建等高维变量场景中,研究者常面临一个核心难题:面对大量分类预测意义不明的变量,如何同时完成变量筛选、模型筛选与分类模型构建?本文介绍的这套机器学习二分类预测算法组合工具,以12种算法、113种组合的批量比较框架,为上述场景提供系统化解决方案。
工具三要素速览
类别(12种算法,113种组合)
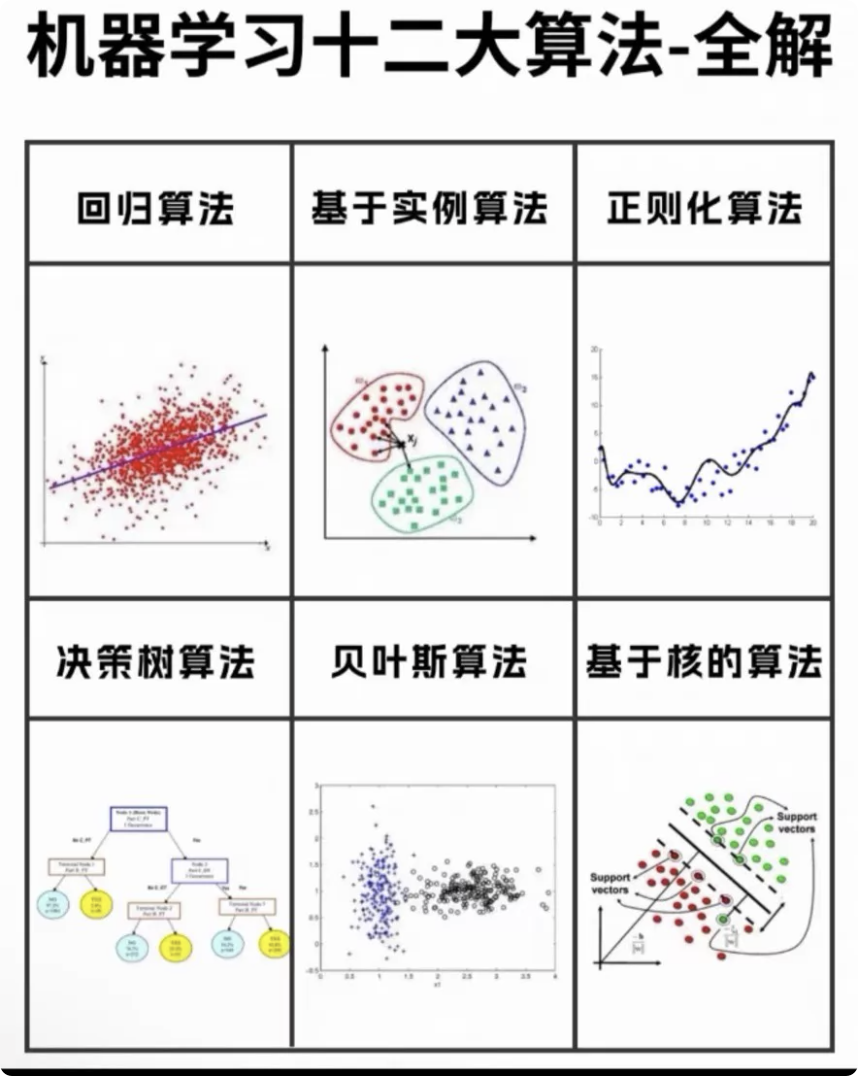
当前更新至2.0版本,在原有基础上新增两种常用建模算法,共集成12种二元分类预测算法:
- 正则化回归类:Lasso、Ridge、Enet(弹性网络)、Stepglm(逐步回归)
- 支持向量与判别类:SVM、LDA(线性判别分析)
- 集成学习类:glmBoost、RandomForest、GBM、XGBoost
- 其他经典方法:plsRglm(偏最小二乘广义线性回归)、NaiveBayes(朴素贝叶斯)
上述算法通过不同组合方式形成 113种算法组合 ,覆盖从线性到非线性、从单模型到集成学习的多种建模路径,便于在统一框架下批量比较。
数量(版本迭代与输出成果)
- 当前版本:2.0版本(新增两种算法)
- 算法数量:12种
- 组合数量:113种
- 输出结果 :
- 训练集上获得的模型文件(model.rds)
- 测试集(或含训练集)上的评估结果(AUC_mat.txt)
- 评估结果的热图展示(AUC.pdf)
- 附赠内容 :另有一套10种机器学习、101种组合的预后模型4.0版本,以及此前两套预后模型脚本,形成完整的模型比较工具体系
应用价值(变量筛选与最优模型获取)
该工具直接服务于高维变量场景下的分类预测研究:
- 变量筛选与模型构建同步完成:在大量意义不明的变量中自动筛选并建模,减少人工试错
- 批量比较替代逐一尝试:113种组合一次性运行,快速定位最优模型
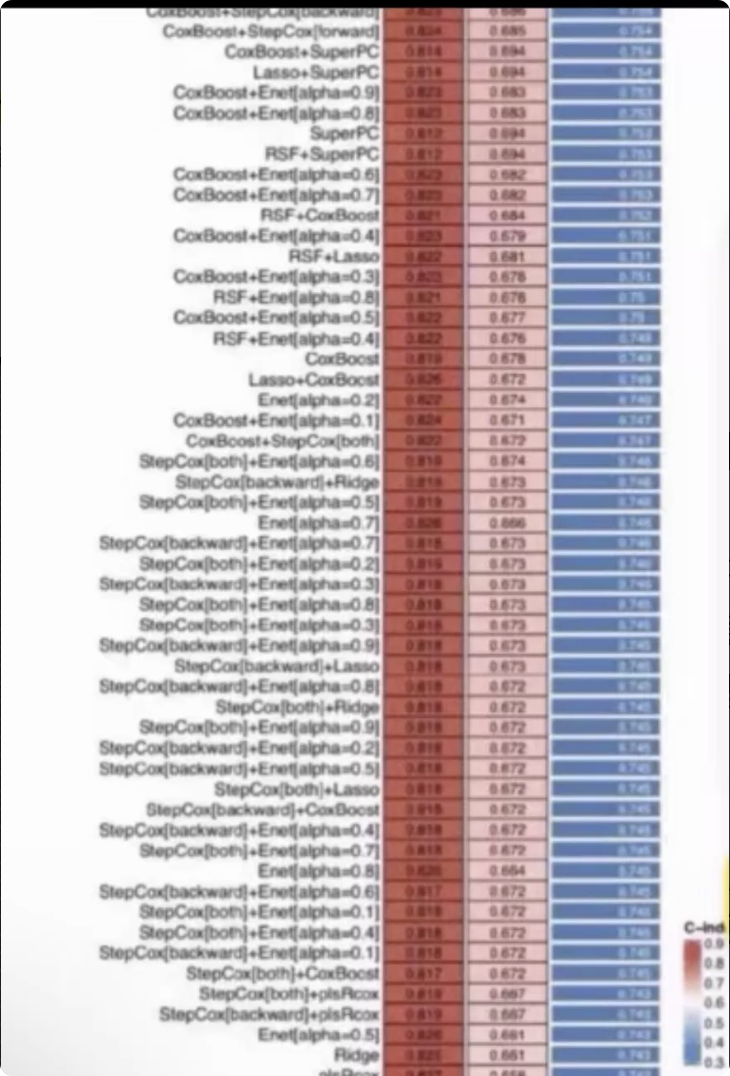
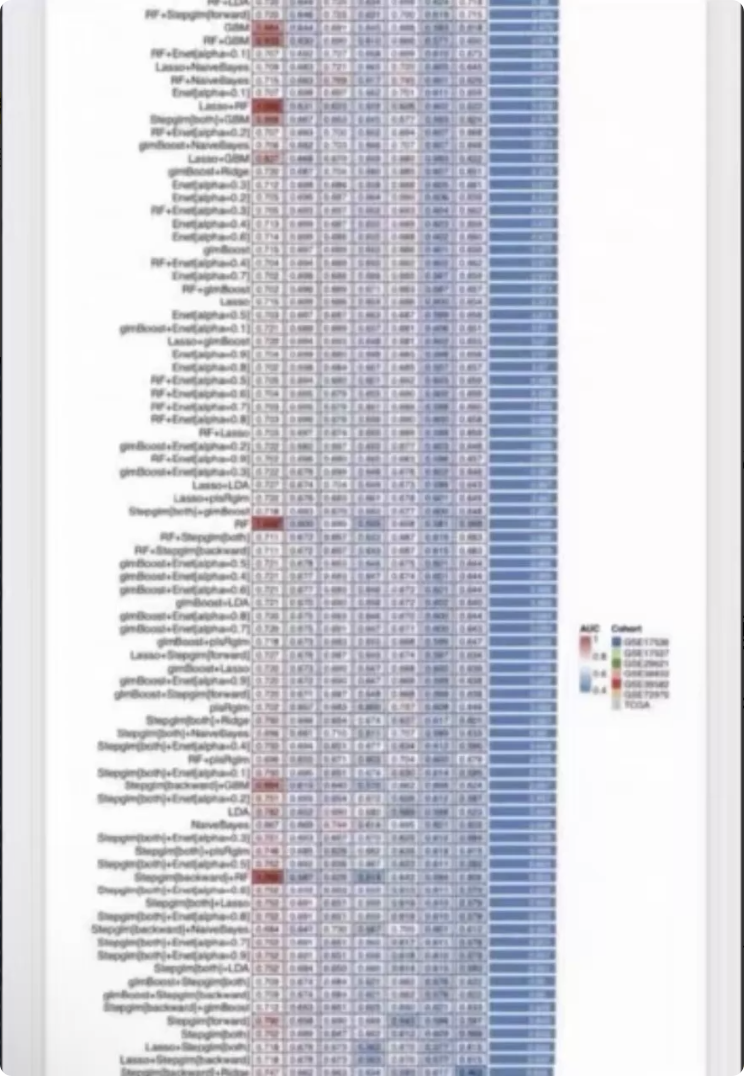
- 结果可视化:热图直观展示各组合的AUC表现,便于横向对比
- 研究效率提升:特别适合生物标记物相关研究,大幅压缩建模周期
工具核心指标一览
| 指标项 | 详细说明 |
|---|---|
| 工具名称 | 机器学习二分类预测算法组合工具 |
| 当前版本 | 2.0版本 |
| 算法数量 | 12种(Lasso、Ridge、Enet、Stepglm、SVM、glmBoost、LDA、plsRglm、RandomForest、GBM、XGBoost、NaiveBayes) |
| 组合数量 | 113种 |
| 适用场景 | 存在大量分类预测意义不明变量,需同步进行变量筛选、模型筛选与分类模型构建 |
| 输出结果 | model.rds(模型)、AUC_mat.txt(评估结果)、AUC.pdf(热图) |
| 附赠资源 | 预后模型4.0版本(10种算法、101种组合)及此前两套预后模型脚本 |
| 最大应用价值 | 批量比较算法组合,快速获取最优分类预测模型,提升生物标记物研究效率 |
应用分层解读
1. 高维变量场景的现实痛点
在生物医学研究中,研究者常面对数百甚至上千个候选变量(如基因表达、代谢物、临床指标),其中真正具有分类预测价值的可能仅占少数。若逐一尝试变量筛选方法与建模算法,工作量巨大且难以保证比较的公平性。该工具通过统一的批量框架,将变量筛选嵌入各算法组合中,使不同方法在同一数据划分与评估标准下比较,提升结果可信度。
2. 12种算法的覆盖广度
12种算法涵盖线性模型(Lasso、Ridge、Enet、Stepglm、LDA)、核方法(SVM)、集成方法(RandomForest、GBM、XGBoost、glmBoost)、概率模型(NaiveBayes)及偏最小二乘方法(plsRglm)。这种多样性使研究者能够比较不同假设空间下的模型表现,避免因算法单一而错失更优解。
3. 113种组合的比较价值
组合数量的意义在于:不同算法对变量筛选的敏感度不同,同一算法在不同预处理或参数设定下表现也可能差异显著。113种组合提供了充分的比较空间,配合AUC热图,研究者可快速识别表现稳定且优异的组合,而非依赖单一模型的偶然结果。
4. 输出结果的实用性
model.rds保存训练完成的模型对象,便于后续复现与部署;AUC_mat.txt以表格形式记录各组合在测试集上的评估指标,便于统计分析;AUC.pdf热图则提供直观的可视化对比。三份输出覆盖"模型-数值-图形"三个层面,满足研究记录与论文呈现的双重需求。
5. 附赠资源的体系化价值
除二分类预测工具外,另附10种算法、101种组合的预后模型4.0版本,以及此前两套预后模型脚本。二分类与预后模型在方法上有共通之处,两套工具并行,可满足不同类型研究的建模需求,形成从分类预测到生存分析的完整方法链。
使用建议
建议在运行前明确训练集与测试集的划分方式,确保各组合在同一数据划分下比较,避免因数据泄露导致评估虚高。对于变量维度极高的数据,可先进行基础预处理(如缺失值填补、标准化),再投入批量建模。结果解读时,除关注AUC最高值外,还应考察组合间的稳定性,优先选择在训练集与测试集上表现一致的模型。若用于论文发表,建议报告完整的热图与评估表格,并说明组合筛选的具体标准。
#机器学习 #二分类预测 #算法组合 #生物标记物 #模型比较