如果有一天,大语言模型(LLM)的 KV Cache 彻底消失,你会如何重新设计一个 Coding Agent?
在现有的开发范式中,绝大多数 AI 编码工具(如 Claude Code、Cursor 等)都采用"追加式对话历史"(Append-only transcript)的架构。这种设计源于 KV Cache 的经济学约束:复用已缓存的前缀成本极低,而一旦修改上下文前面的内容,就会导致缓存失效,被迫重新计算整个序列。
然而,这种对 KV Cache 的盲目依赖,也为当前 Agent 的架构设计带来了深刻的局限性。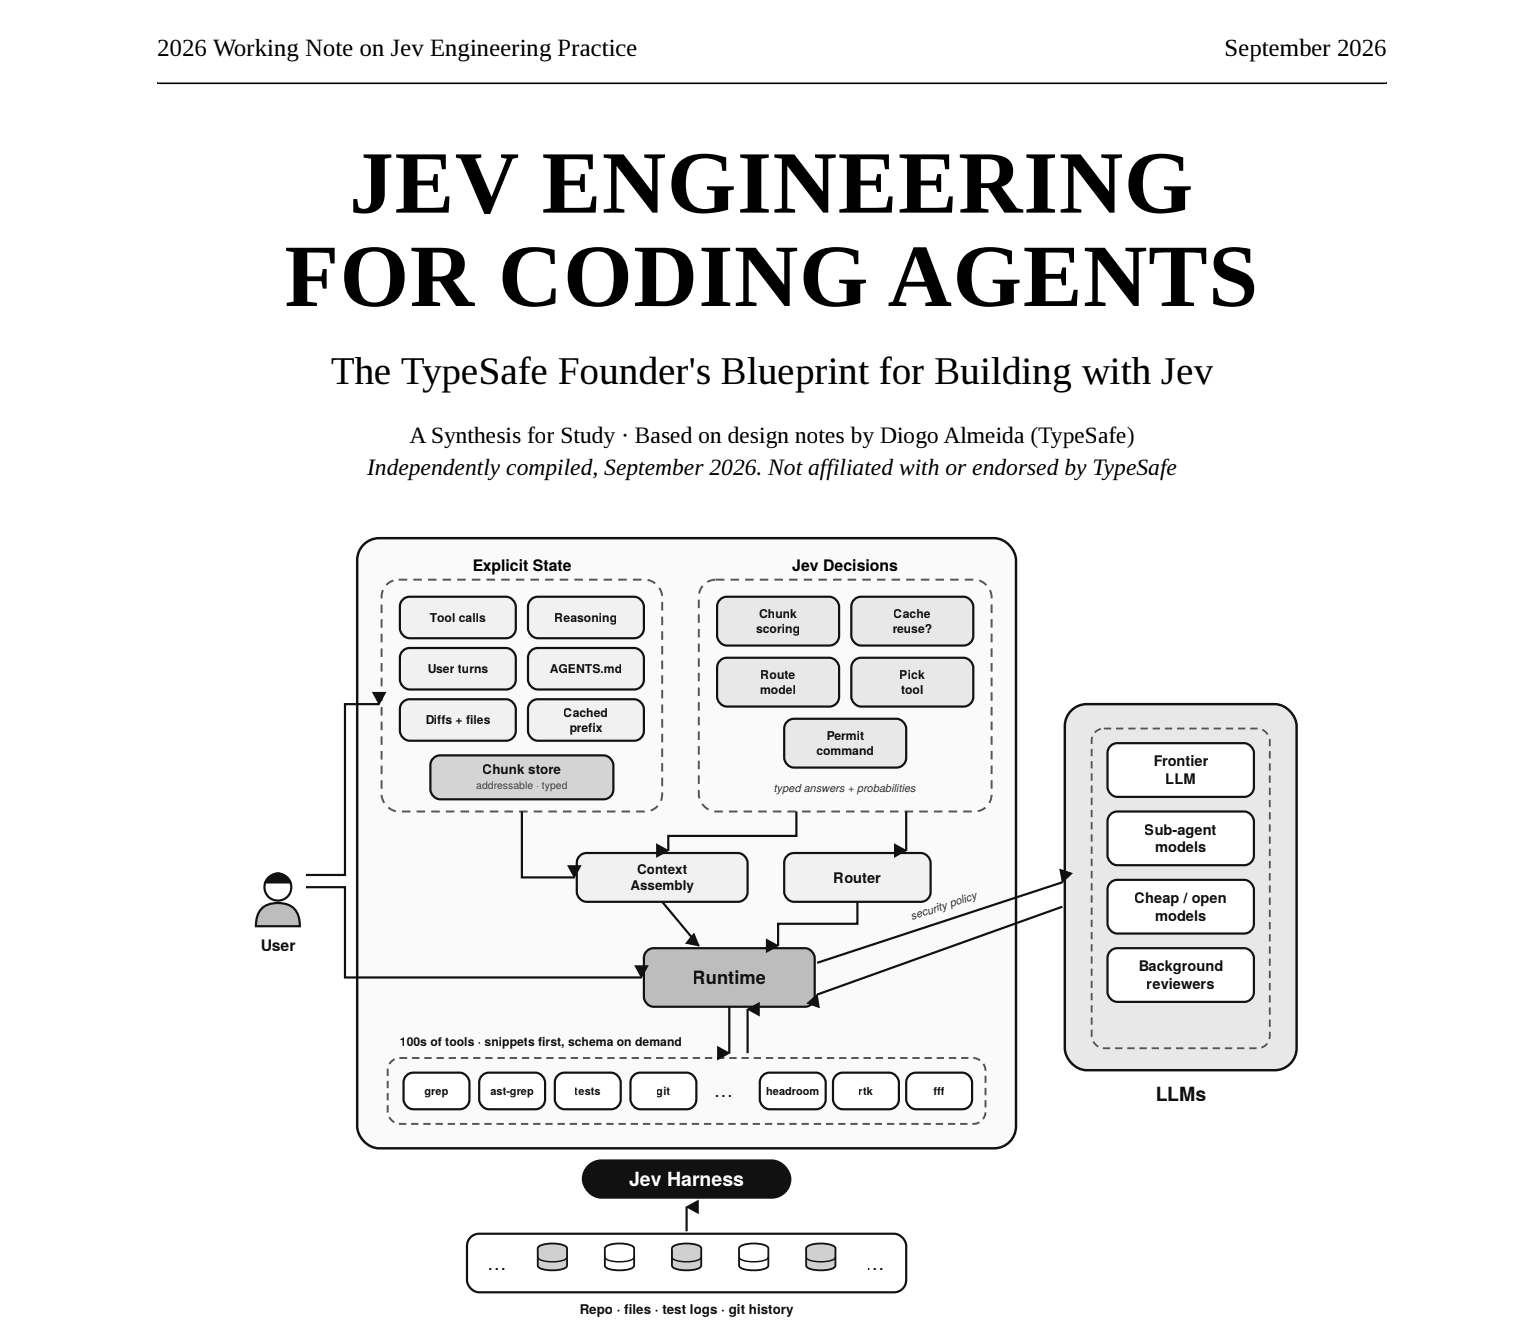
近期由 TypeSafe 创始人 Diogo Almeida 撰写的技术报告 《Jev Engineering for Coding Agents: The TypeSafe Founder's Blueprint for Building with Jev》,抛出了这一极具颠覆性的假设,并深入剖析了现有 Coding Agent 的结构性瓶颈与优化路径。
现行 Agent 架构的"六大病灶"
报告指出,由于过度妥协于 KV Cache 的缓存机制,当前的 Coding Agent 普遍存在以下六个设计缺陷:
- 路由陷阱(Routing Fails) :直觉上,由高级模型规划、低成本模型执行、再由高级模型审阅能够降低成本。然而在长上下文场景中,模型间频繁切换会导致上下文重复加载。计算表明,混合路由的总成本可能比全程使用旗舰模型高出 30% 至 50%。
- 工具拥堵(Tools Crowd Context):为了保证 Agent 随时能调用工具,系统不得不将大量工具的 Schema 完整放入 System Message 中。这不仅浪费 Token,还会降低模型精准选取工具的能力。
- 盲目压缩(Compaction Compresses Blind):传统的上下文压缩通常在不确知后续具体任务的情况下进行全局摘要,极易误删后续推理所需的关键信息。
- 子 Agent 效率低下(Sub-Agents are Rare):由于跨模型调度和状态同步的上下文选择与合并成本高昂,多 Agent 协作难以高效落地。
- 重启抹杀状态(Restarts Discard State):一旦对话上下文出现漂移或污染,目前普遍的解决方式是清空重启,导致此前生成的有效状态被一并丢弃。
- 功能内置与上下文开销的矛盾(Batteries Debate):内置功能越丰富,永久占用的上下文开销就越大;开发者被迫在易用性与长文本性能之间做权衡。
算力分布:Token 究竟消耗在何处?
根据报告对典型 CLI Coding Agent 算力消耗的统计分析,结果显示:
- 读取文件内容:30% -- 40%
- 代码库搜索(grep / glob):10% -- 18%
- 终端命令输出(日志/报错):10% -- 20%
- 系统提示词 & 工具定义:5% -- 12%
- 思考与规划:5% -- 15%
- 实际编写与修改代码 :仅占 4% -- 10%
核心结论 :Coding Agent 的核心价值在于编写代码,但代码生成本身所消耗的 Token 占比不足 10%。信息检索与文件读取占据了近 60% 的 Token 开销 。因此,Agent 性能与成本优化的突破口不在于修改代码的格式,而在于更高效的上下文管理与检索机制。
基于 Jev 的解法:显式状态与动态控制
针对上述问题,TypeSafe 提出了 Jev 控制层架构 。Jev 并不直接负责代码编写,而是作为 决策模型(Decision Layer),在每一轮对话中生成结构化的控制指令:
-
上下文显式化与结构化 :将目标、代码、日志、历史等所有信息拆分为可寻址的块(Chunk Store),进行独立存储与管理,而非统一追加至对话历史中。
-
动态可见度阶梯(Visibility Ladder) :针对具体 Query,Jev 会实时评估每个 Chunk 的可见度层级(隐藏 / 短摘要 / 长摘要 / 完整展开),实现基于查询的按需压缩(Query-aware Compression)。
-
渐进式工具披露(Tiered Disclosure):
-
第一级:仅保留工具名称与单句功能描述;
-
第二级:当 Agent 明确需要使用某工具时,按需加载完整的 Schema;
-
第三级:遇到特殊需求时再调用完整的使用文档。
-
条件式指令(Conditional Instructions) :优化
AGENTS.md的加载方式。例如在修改前端代码时动态加载样式规范,在进入特定目录时加载该目录的配置说明,且此类核心指令具备压缩免疫权。 -
基于数据敏感度的安全路由:将数据隐私纳入路由判定条件。开源依赖项可交由低成本模型处理,业务代码使用标准云端模型,而涉及敏感配置与密钥的文件,则强制限定由高安全级别的旗舰模型处理。
结语
Agent 的架构重心正从单纯依赖模型本身的推理能力 ,转向上下文工程与决策控制层的深度设计。
将上下文从"无限追加的文本流"改造为"可动态组装与寻址的结构化变量",是提升 Coding Agent 运行效率、安全性与经济可行性的重要方向。