从联想记忆到能量函数,理解神经动力学的数学本质
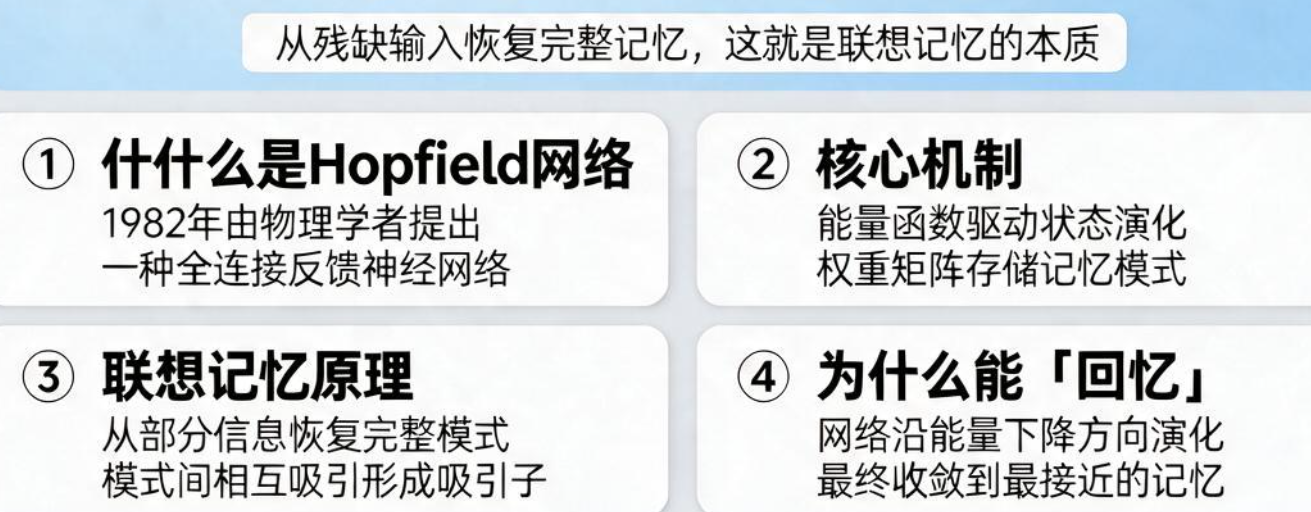
开头:为什么照片模糊了你还能认出来?
上一篇我们学习了动态规划,解决的是「决策」问题。
今天我们学习 Hopfield 网络,解决的是「记忆」问题。
联想记忆:
    给你一张模糊的照片 → 你能认出是谁
    给你一句歌词的开头 → 你能想起整首歌
    给你一个残缺的图案 → 你能补全它

Hopfield 网络就是模仿这个过程:
    输入残缺/有噪声的模式 → 输出完整的原始模式
一、Hopfield 网络结构
1.1 网络特点
Hopfield 网络结构
═══════════════════════════════════════════════════════════════════

特点:
    1. 全连接:每个神经元与其他所有神经元连接
    2. 对称权重:w_ij = w_ji
    3. 无自连接:w_ii = 0
    4. 二值激活:x_i ∈ {-1, +1}(或 {0, 1})

    ┌─────────────────┐
    │  x₁ ──── x₂    │
    │  │ ╲    ╱ │    │
    │  │  ╲  ╱  │    │
    │  │   ╲╱   │    │
    │  │   ╱╲   │    │
    │  │  ╱  ╲  │    │
    │  │ ╱    ╲ │    │
    │  x₃ ──── x₄    │
    └─────────────────┘
1.2 与感知器的区别
| 特性 | 感知器 | Hopfield |
|---|---|---|
| 连接方式 | 单层前馈 | 全连接递归 |
| 权重 | 有向 | 对称 |
| 目标 | 分类 | 联想记忆 |
| 更新 | 一次性 | 迭代直到稳定 |
二、联想记忆
2.1 存储模式
存储模式
═══════════════════════════════════════════════════════════════════

假设要存储 K 个模式:x¹, x², ..., x^K
每个模式是 N 维向量:x^k = (x₁^k, x₂^k, ..., x_N^k)
x_i^k ∈ {-1, +1}

权重矩阵:
    W = Σ_k (x^k)(x^k)ᵀ - K I

    W_ij = Σ_k x_i^k x_j^k  (i ≠ j)
    W_ii = 0

直觉:
    如果两个神经元在所有模式中经常同时为 +1 或 -1
    → 它们的连接权重为正(正相关)
2.2 回忆过程
回忆过程(异步更新)
═══════════════════════════════════════════════════════════════════

输入:残缺/有噪声的模式 x(0)

迭代:
    for t = 0, 1, 2, ...
        随机选择一个神经元 i
        h_i = Σ_j w_ij x_j(t)
        x_i(t+1) = sign(h_i)

        if x(t+1) == x(t):
            break  # 收敛

输出:稳定的完整模式

类比:
    人看到模糊的照片 → 大脑自动补全 → 识别出是谁
三、能量函数
3.1 能量定义
Hopfield 网络的能量函数
═══════════════════════════════════════════════════════════════════

E = -Σ_{i<j} w_ij x_i x_j

性质:
    1. 能量有下界
    2. 每次更新,能量单调递减:ΔE ≤ 0
    3. 稳定点是能量的局部最小值

    能量 ↑
         │╲
         │ ╲
         │  ╲
         │   ○ 稳定点(能量最小)
         │
         └──────────→ 状态
3.2 稳定性证明
稳定性证明(单个神经元更新)
═══════════════════════════════════════════════════════════════════

假设更新神经元 i:
    x_i(t+1) = sign(Σ_j w_ij x_j(t))

能量变化:
    ΔE = -x_i(t+1) Σ_j w_ij x_j(t) + x_i(t) Σ_j w_ij x_j(t)
       = -(x_i(t+1) - x_i(t)) Σ_j w_ij x_j(t)

如果 x_i(t+1) ≠ x_i(t):
    x_i(t+1) = sign(Σ_j w_ij x_j(t))
    → x_i(t+1) 和 Σ_j w_ij x_j(t) 同号
    → ΔE < 0

结论:能量单调递减,网络一定会收敛到稳定点
四、Python 实现 Hopfield 网络
4.1 完整代码
python
import numpy as np
import matplotlib.pyplot as plt

class HopfieldNetwork:
    """Hopfield 网络"""

    def __init__(self, n_neurons):
        """
        参数:
            n_neurons: 神经元数量
        """
        self.n = n_neurons
        self.W = np.zeros((n_neurons, n_neurons))

    def store(self, pattern):
        """
        存储一个模式

        参数:
            pattern: 形状 (n_neurons,),值为 -1 或 +1
        """
        # 外积规则
        self.W += np.outer(pattern, pattern) / self.n
        # 去除自连接
        np.fill_diagonal(self.W, 0)

    def store_patterns(self, patterns):
        """存储多个模式"""
        for pattern in patterns:
            self.store(pattern)

    def recall(self, pattern, n_iterations=100, async_update=True):
        """
        回忆(从噪声输入恢复原始模式)

        参数:
            pattern: 初始输入(可能是噪声)
            n_iterations: 最大迭代次数
            async_update: 是否异步更新
        """
        state = pattern.copy()
        prev_state = np.zeros_like(state)

        for _ in range(n_iterations):
            if async_update:
                # 异步更新:随机选择神经元
                for i in np.random.permutation(self.n):
                    h = self.W[i] @ state
                    state[i] = 1 if h >= 0 else -1
            else:
                # 同步更新:所有神经元同时更新
                h = state @ self.W
                state = np.where(h >= 0, 1, -1)

            # 检查收敛
            if np.array_equal(state, prev_state):
                break
            prev_state = state.copy()

        return state

    def energy(self, state):
        """计算能量"""
        return -0.5 * state @ self.W @ state

    def capacity(self):
        """估计最大存储容量"""
        # 经验法则:约 0.138N 个模式
        return int(0.138 * self.n)
4.2 测试:存储和回忆
python
# 创建 Hopfield 网络
n = 100  # 10x10 图案
hopfield = HopfieldNetwork(n)

# 定义要存储的模式(5x5 简化版)
patterns = []
labels = ['T', 'L', 'X', 'O', '+']

# 模式 T
T = np.array([
    [1, 1, 1, 1, 1],
    [-1, -1, 1, -1, -1],
    [-1, -1, 1, -1, -1],
    [-1, -1, 1, -1, -1],
    [-1, -1, 1, -1, -1]
]).flatten()

# 模式 L
L = np.array([
    [1, -1, -1, -1, -1],
    [1, -1, -1, -1, -1],
    [1, -1, -1, -1, -1],
    [1, -1, -1, -1, -1],
    [1, 1, 1, 1, 1]
]).flatten()

# 模式 X
X = np.array([
    [1, -1, -1, -1, 1],
    [-1, 1, -1, 1, -1],
    [-1, -1, 1, -1, -1],
    [-1, 1, -1, 1, -1],
    [1, -1, -1, -1, 1]
]).flatten()

patterns = [T, L, X]
pattern_labels = ['T', 'L', 'X']

# 存储模式
hopfield.store_patterns(patterns)

# 测试回忆(添加噪声)
noise_levels = [0.1, 0.2, 0.3, 0.4]
fig, axes = plt.subplots(len(patterns), len(noise_levels) + 1,
                         figsize=(15, 10))

for i, (pattern, label) in enumerate(zip(patterns, pattern_labels)):
    # 原始模式
    axes[i, 0].imshow(pattern.reshape(5, 5), cmap='gray')
    axes[i, 0].set_title(f'Original: {label}')
    axes[i, 0].axis('off')

    for j, noise in enumerate(noise_levels):
        # 添加噪声
        noisy = pattern.copy()
        n_flip = int(noise * len(pattern))
        flip_idx = np.random.choice(len(pattern), n_flip, replace=False)
        noisy[flip_idx] *= -1

        # 回忆
        recalled = hopfield.recall(noisy)

        # 可视化
        axes[i, j + 1].imshow(recalled.reshape(5, 5), cmap='gray')
        axes[i, j + 1].set_title(f'Noise: {noise:.0%}')
        axes[i, j + 1].axis('off')

plt.tight_layout()
plt.show()
4.3 能量收敛可视化
python
# 能量收敛过程
def recall_with_energy(hopfield, pattern, n_iterations=50):
    """回忆并记录能量变化"""
    state = pattern.copy()
    energies = [hopfield.energy(state)]

    for _ in range(n_iterations):
        for i in np.random.permutation(hopfield.n):
            h = hopfield.W[i] @ state
            state[i] = 1 if h >= 0 else -1
        energies.append(hopfield.energy(state))

    return state, energies

# 测试
noisy = patterns[0].copy()
flip_idx = np.random.choice(100, 30, replace=False)
noisy[flip_idx] *= -1

recalled, energies = recall_with_energy(hopfield, noisy)

# 绘制能量曲线
plt.figure(figsize=(10, 4))
plt.plot(energies, 'b-', linewidth=2)
plt.xlabel('Iteration')
plt.ylabel('Energy')
plt.title('Energy Convergence During Recall')
plt.grid(True)
plt.show()

print(f"初始能量: {energies[0]:.4f}")
print(f"最终能量: {energies[-1]:.4f}")
print(f"能量下降: {energies[0] - energies[-1]:.4f}")
五、工业应用
5.1 图像识别
图像识别
═══════════════════════════════════════════════════════════════════

应用场景:
    - 手写数字识别(MNIST)
    - 人脸识别(简单版本)
    - 字符识别

优势:
    - 对噪声和残缺不敏感
    - 实现简单

局限:
    - 存储容量有限(约 0.138N)
    - 只能存储二值图像
5.2 优化问题
优化问题
═══════════════════════════════════════════════════════════════════

旅行商问题(TSP):
    - 用 Hopfield 网络求解
    - 能量函数对应路径长度
    - 稳定点对应近似最优解

其他组合优化:
    - 图着色
    - 调度问题
5.3 联想记忆
联想记忆
═══════════════════════════════════════════════════════════════════

异联想:
    输入:模式 A
    输出:模式 B

应用:
    - 关键词 → 完整句子
    - 图片 → 描述
    - 问题 → 答案
六、避坑指南:使用 Hopfield 的 3 个陷阱
坑 1:存储模式太多 → 伪稳定点
错误做法:存储太多模式
python
# ❌ 存储超过容量
n = 100
hopfield = HopfieldNetwork(n)
for i in range(20):  # 超过 0.138*100 ≈ 14
    hopfield.store(np.random.choice([-1, 1], n))
# 会出现伪稳定点(不是原始模式的稳定点)正确做法:控制存储模式数量
python
# ✅ 在容量范围内
n = 100
max_patterns = int(0.138 * n)  # ≈ 14
hopfield = HopfieldNetwork(n)
for i in range(10):  # 小于 14
    hopfield.store(np.random.choice([-1, 1], n))
坑 2:权重矩阵不对称 → 能量不单调递减
错误做法:权重不对称
python
# ❌ 权重不对称
hopfield.W[i, j] = 1
hopfield.W[j, i] = 0.5  # 不对称
# 能量可能增加,网络不稳定正确做法:确保对称
python
# ✅ 对称权重
hopfield.W[i, j] = 1
hopfield.W[j, i] = 1  # 对称
坑 3:自连接不设为 0 → 稳定点不稳定
错误做法:保留自连接
python
# ❌ 自连接不为 0
hopfield.W[i, i] = 1
# 神经元会影响自己,可能导致不稳定正确做法:设为 0
python
# ✅ 无自连接
np.fill_diagonal(hopfield.W, 0)
七、Hopfield 网络 vs 现代神经网络
| 特性 | Hopfield | 现代 RNN/LSTM |
|---|---|---|
| 记忆方式 | 联想记忆 | 序列记忆 |
| 训练算法 | 外积规则 | 反向传播 |
| 容量 | 约 0.138N | 理论上无限 |
| 应用 | 图像识别 | 自然语言处理 |
八、本篇总结
核心要点回顾
- Hopfield 网络:全连接、对称权重、无自连接
- 联想记忆:从残缺/噪声输入恢复完整模式
- 存储规则 :W = Σ (xk)(xk)ᵀ - K I
- 回忆过程:异步更新直到收敛
- 能量函数:单调递减,稳定点是局部最小
- 容量限制:约 0.138N 个模式
下篇预告
下一篇我们学习卡尔曼滤波。
Hopfield 网络处理静态模式,卡尔曼滤波处理动态系统的状态估计。
下一篇你将学到:
- 贝叶斯推断基础
- 卡尔曼滤波的预测和更新
- 粒子滤波处理非线性系统
- 用 Python 手写卡尔曼滤波
本期互动
你对 Hopfield 网络有什么看法?
- 你用过 Hopfield 网络吗?在什么场景下?
- 你觉得 Hopfield 网络和 Transformer 的注意力机制有什么关系?
- 你知道 Hopfield 网络的哪些应用?
欢迎在评论区留言。
系列目录
| 篇 | 标题 | 状态 |
|---|---|---|
| 01 | Haykin 精讲开篇:从「只会调参」到「理解神经网络的灵魂」 | ✅ 完成 |
| 02 | 感知器:神经网络的「鼻祖」,为什么它能「学会」分类? | ✅ 完成 |
| 03 | LMS 算法:从最小二乘到随机梯度下降,工业自适应滤波的核心 | ✅ 完成 |
| 04 | 反向传播:神经网络为什么能「学习」?用 NumPy 手写 BP | ✅ 完成 |
| 05 | 核方法:为什么 SVM 能处理非线性问题?理解「升维」的本质 | ✅ 完成 |
| 06 | 支持向量机:最大间隔的「艺术」,为什么它是「小数据之王」? | ✅ 完成 |
| 07 | 正则化:为什么模型越复杂越容易过拟合?L1/L2/Dropout | ✅ 完成 |
| 08 | PCA:为什么降维能「去噪」?从特征值分解到核 PCA | ✅ 完成 |
| 09 | SOM:无监督学习的「聚类之王」,为什么它能「自组织」? | ✅ 完成 |
| 10 | 信息论:为什么「信息最大化」能学特征?从熵到 ICA | ✅ 完成 |
| 11 | 玻尔兹曼机:深度学习的「前世」,从统计力学到 RBM | ✅ 完成 |
| 12 | 动态规划:强化学习的「数学基础」,从 MDP 到值迭代 | ✅ 完成 |
| 13 | Hopfield 网络:联想记忆的「鼻祖」,为什么它能「回忆」? | ✅ 当前 |
| 14 | 卡尔曼滤波:为什么它能「预测」?从贝叶斯推断到粒子滤波 | ⏳ 下一篇 |
| 15 | Haykin 精讲终篇:从感知器到深度学习------一部神经网络的「进化史」 | ⏳ 待写 |
点赞收藏转发,是我持续更新的动力!