时间序列非平衡样本分类研究综述:发展脉络、核心方法与前沿方向
摘要
时间序列非平衡分类(Imbalanced Time Series Classification, ITSC)广泛存在于工业故障诊断、设备健康监测、医疗异常识别、金融欺诈、网络入侵和稀有事件检测等场景。与普通表格数据的类别不平衡相比,时间序列同时包含时间依赖、相位偏移、局部模式、多尺度变化以及多变量耦合,因此简单复制少数类样本或直接使用传统 SMOTE 往往不能从根本上解决问题。
从研究发展来看,ITSC 大致经历了三个阶段:早期研究主要解决"样本数量不平衡 ";随后转向"生成样本时保持时间结构 ";近年的研究重点进一步转向"在不平衡条件下学习更好的少数类表示与决策边界 "。尤其是 2025---2026 年,监督/自监督对比学习、图结构建模、双分支学习以及面向长尾分布的表示学习开始成为重要方向。
因此,理解这一方向最重要的不是记住几十种采样算法,而是掌握如下核心逻辑:
样本数量失衡 → 决策边界失衡 → 特征表示失衡 → 真实场景分布失衡
现代 ITSC 的研究已经明显从第一层向第三、第四层发展。
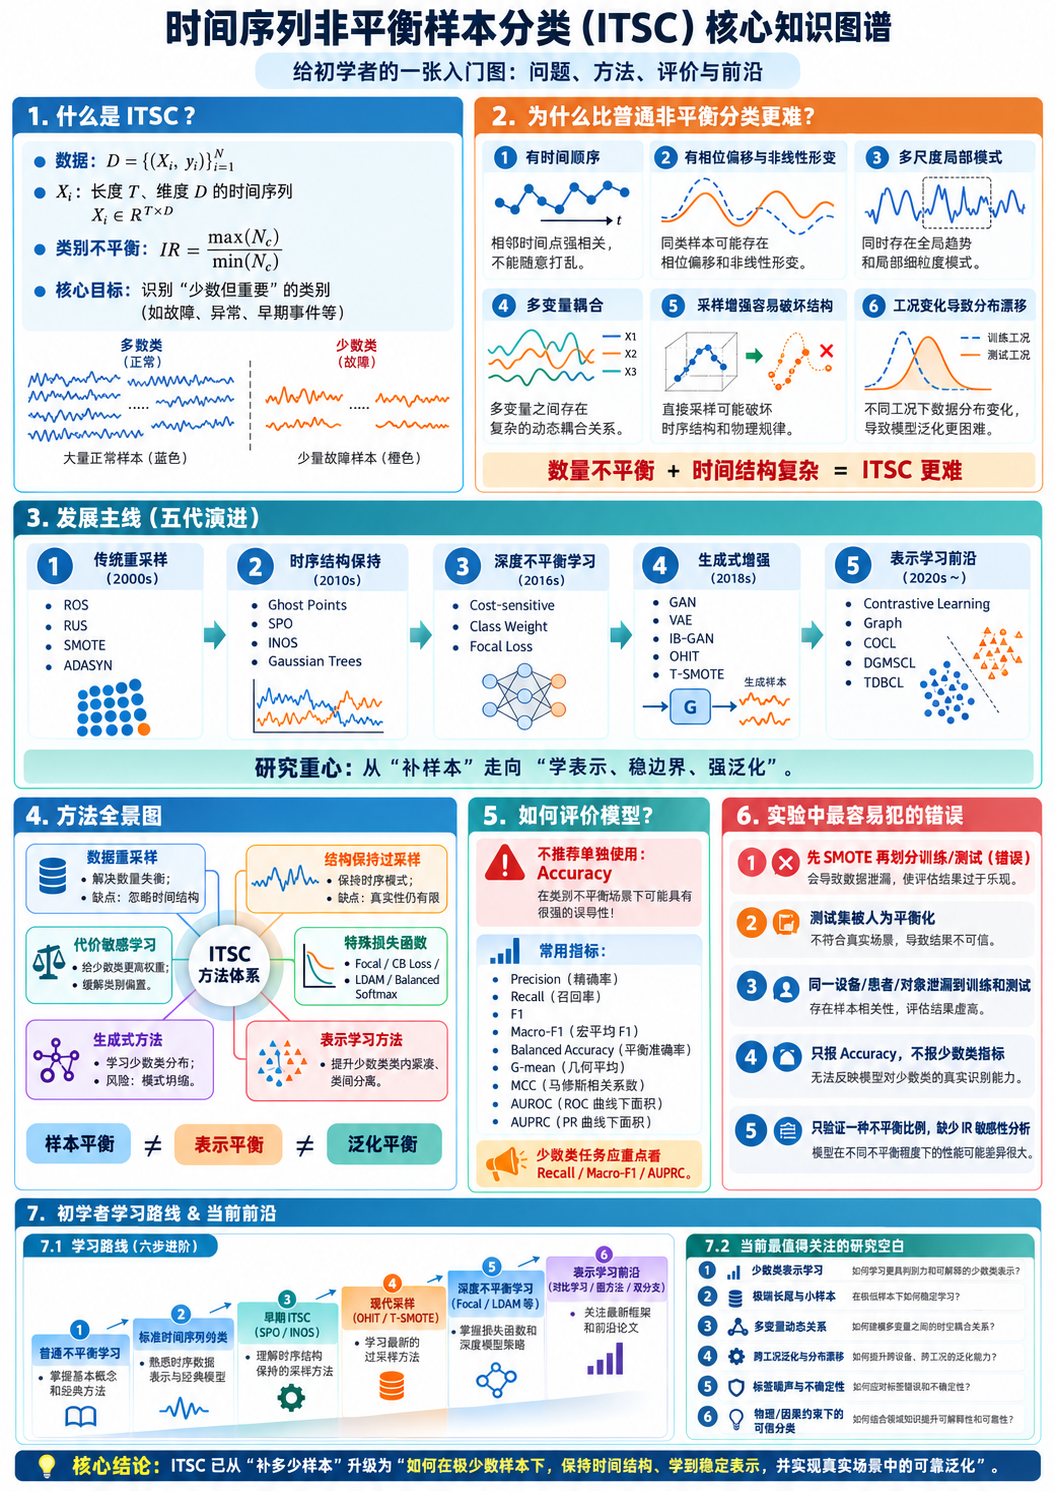
1. 什么是时间序列非平衡分类
设训练集为
D={(Xi,yi)}i=1N, \mathcal{D}=\{(X_i,y_i)\}_{i=1}^{N}, D={(Xi,yi)}i=1N,
其中
Xi∈RT×D X_i\in\mathbb{R}^{T\times D} Xi∈RT×D
表示长度为 TTT、变量数为 DDD 的时间序列,标签为
yi∈{1,2,⋯ ,C}. y_i\in\{1,2,\cdots,C\}. yi∈{1,2,⋯,C}.
第 ccc 类样本数量为 NcN_cNc。
最常见的不平衡程度可以用
IR=maxcNcmincNc IR=\frac{\max_c N_c}{\min_c N_c} IR=mincNcmaxcNc
描述。
例如某设备监测数据中:
| 状态 | 样本量 |
|---|---|
| 正常 | 10,000 |
| 轻微异常 | 800 |
| 严重故障 | 100 |
| 极端故障 | 20 |
| 此时模型即使把大量样本都预测成正常,也可能获得很高 Accuracy,但真正重要的少数故障类别却几乎无法识别。 | |
| 因此非平衡问题真正关心的是: |
能不能识别少数但重要的模式
而不是简单追求总体预测准确率。
2. 为什么时间序列非平衡问题比普通非平衡分类更困难
传统非平衡分类通常考虑
x∈Rd. x\in\mathbb{R}^d. x∈Rd.
但时间序列存在
X=x1,x2,...,xT X=x_1,x_2,\\ldots,x_T X=x1,x2,...,xT
这样的有序结构。
这带来了六个额外困难。
| 困难 | 普通数据 | 时间序列 |
|---|---|---|
| 样本顺序 | 通常无意义 | 时间顺序具有语义 |
| 特征关系 | 主要是变量相关性 | 时间依赖 + 变量相关性 |
| 样本距离 | 欧氏距离常可使用 | 常存在时间错位和非线性形变 |
| 数据增强 | 插值较容易 | 插值可能产生不存在的动态过程 |
| 少数类 | 样本少 | 样本少且内部模式可能高度多样 |
| 分布变化 | 较静态 | 工况、时间、设备会持续变化 |
| 例如正常设备振动有 10,000 条,而轴承故障只有 50 条。 | ||
| 如果直接对两个故障序列逐点做 SMOTE: | ||
| $$ | ||
| X_{new}=X_i+\lambda(X_j-X_i), | ||
| $$ | ||
| 生成的波形在数学上成立,却可能破坏冲击周期、频谱结构或者相位关系。 | ||
| 这也是为什么时间序列领域很早就开始研究 Structure-Preserving Oversampling。2011 年的 SPO 已经明确提出在生成少数类时间序列时维护协方差结构,而 2013 年的 INOS、2014 年的 Gaussian-tree 模型继续沿着这一思路发展。 |
3. 整个领域的发展主线
时间序列非平衡分类的发展可以理解为五代方法。
| 阶段 | 核心问题 | 典型思想 |
|---|---|---|
| 第一代 | 数量不平衡 | Under-sampling、Over-sampling、SMOTE |
| 第二代 | 时间结构被破坏 | SPO、INOS、Gaussian Tree、DTW |
| 第三代 | 深度模型偏向多数类 | Class Weight、Cost-sensitive、Focal Loss |
| 第四代 | 生成更真实的少数类 | GAN、结构保持生成、T-SMOTE、OHIT |
| 第五代 | 少数类表征学习不足 | Contrastive Learning、Graph、Dual Branch、Long-tail learning |
| 这一演化非常重要。 | ||
| 早期问题是: |
少数类只有几十个,怎么办?
于是答案是:
多生成一些少数类
现在研究的问题变成:
即使给模型补了少数类,为什么少数类特征仍然和多数类混在一起?
因此现代答案逐渐变成:
重新设计表示空间和分类边界
4. 第一类方法:传统重采样
最经典的方法来自普通非平衡学习。
SMOTE 于 2002 年提出,通过少数类邻居之间的线性插值产生新样本;ADASYN 则进一步根据不同少数类样本的学习难度决定生成多少新样本。
基本形式为:
xnew=xi+λ(xj−xi), x_{new}=x_i+\lambda(x_j-x_i), xnew=xi+λ(xj−xi),
其中
λ∼U(0,1). \lambda\sim U(0,1). λ∼U(0,1).
传统方法包括随机过采样、随机欠采样、SMOTE、Borderline-SMOTE、ADASYN、SMOTEBoost 等。
其优势是简单、与分类器无关,而且常能快速提高 Recall。
问题也十分明显:
SMOTE 不理解"时间"
两个形态相似但存在相位错位的时间序列,如果直接逐点插值,可能生成不符合真实物理过程的数据。
因此,传统 SMOTE 更适合作为一个 baseline,而不是现代 ITSC 研究的终点。
5. 第二类方法:时间结构保持的过采样
这一阶段是真正的"时间序列非平衡学习"开始形成自己的研究特色。
5.1 Ghost Points
Köknar-Tezel 和 Latecki 的工作指出,时间序列之间常需要考虑时间变形,因此普通欧氏特征空间中的合成少数类点并不总是合理。他们通过 ghost points 改善不平衡时间序列上的 SVM 分类。
核心变化是:
Euclidean space → temporal similarity space. \text{Euclidean space} \;\rightarrow\; \text{temporal similarity space}. Euclidean space→temporal similarity space.
5.2 SPO:Structure Preserving Oversampling
2011 年 Cao 等提出 SPO。
其思想不是简单连接两个时间序列,而是估计少数类的协方差结构,再从相应统计分布产生样本。
即:
Xminority→(μ,Σ)→Xnew∼N(μ,Σ). X_{minority}\rightarrow(\mu,\Sigma)\rightarrow X_{new}\sim\mathcal{N}(\mu,\Sigma). Xminority→(μ,Σ)→Xnew∼N(μ,Σ).
这里第一次明确体现出一个非常重要的思想:
生成数量不是关键,生成结构正确才是关键
5.3 INOS
2013 年的 Integrated Oversampling(INOS)将改进的结构保持过采样与插值式方法结合,以增强少数类覆盖能力。
说明研究者已经发现只靠一种生成机制很难同时解决:
真实性+多样性. \text{真实性} + \text{多样性}. 真实性+多样性.
5.4 Mixture of Gaussian Trees
2014 年 Cao、Tan 和 Pang 进一步利用 Gaussian Trees 建模少数类时间相关结构,并允许少数类具有多个模式。该方法特别关注高维时间序列下"少样本却需要估计大量协方差参数"的问题。
这是一个很有代表性的转变:
少数类≠单一分布. \text{少数类} \neq \text{单一分布}. 少数类=单一分布.
实际故障往往是:
Fault A=多个子模式的混合. \text{Fault A} = \text{多个子模式的混合}. Fault A=多个子模式的混合.
这就是今天所谓的 small disjunct problem 的早期体现。
6. 第三类方法:时间序列数据增强
数据增强和过采样并不完全相同。
过采样的目标主要是:
Nminority↑ N_{minority}\uparrow Nminority↑
而数据增强更强调:
保持标签的情况下增加样本变化
时间序列常见增强包括 jittering、scaling、cropping、permutation、magnitude warping、time warping、window warping、DTW barycentric averaging、guided warping 等。
Iwana 和 Uchida 在 2021 年系统测试了 12 种时间序列增强方法、6 种神经网络以及全部 128 个 UCR 2018 数据集,并将方法概括为变换、模式混合、生成模型和分解等主要家族。
其中值得特别掌握的是基于 DTW 的方法,例如:
DTW(Xi,Xj) DTW(X_i,X_j) DTW(Xi,Xj)
首先找到两个时间序列的时间对齐关系,然后再混合。
这比
Xnew=λXi+(1−λ)Xj X_{new}=\lambda X_i+(1-\lambda)X_j Xnew=λXi+(1−λ)Xj
更符合时序数据自身的几何结构。
SPAWNER、wDBA、RGW、DGW 就属于这类思路。
但是它们也存在一个现实问题:
DTW 类增强往往计算成本较高
特别是在长序列和大量样本情况下。
7. 第四类方法:代价敏感学习
另一条路线干脆不修改数据。
普通交叉熵为:
LCE=−∑ilogp(yi∣Xi). L_{CE}=-\sum_i \log p(y_i|X_i). LCE=−i∑logp(yi∣Xi).
如果正常样本有 10,000 个,故障只有 100 个,那么正常样本产生的梯度很容易主导优化。
于是可以定义:
L=−∑iwyilogp(yi∣Xi), L=-\sum_i w_{y_i}\log p(y_i|X_i), L=−i∑wyilogp(yi∣Xi),
令
wminority>wmajority. w_{minority}>w_{majority}. wminority>wmajority.
2018 年 Geng 和 Luo 专门针对 imbalanced time-series classification 提出了 cost-sensitive convolutional neural networks,通过自适应误分类代价改造多类时间序列深度网络。
该思想的优势在于:
不产生虚假时间序列
因此在医疗和工业故障领域非常实用。
缺点则是:权重 wcw_cwc 往往需要调参,而且简单的
wc=1Nc w_c=\frac{1}{N_c} wc=Nc1
可能给极少数类过大的梯度权重。
8. 第五类方法:重新设计损失函数
2017 年以后,长尾学习领域出现了大量可迁移到时间序列的损失函数。
Focal Loss
Focal Loss 定义为:
LFL=−αt(1−pt)γlogpt. L_{FL}=-\alpha_t(1-p_t)^\gamma\log p_t. LFL=−αt(1−pt)γlogpt.
它不是单纯强调"少数类",而是降低大量容易分类样本对训练的支配,让模型更多关注难样本。
这对于"大量正常简单样本 + 少量困难故障样本"的情形尤其有价值。
Class-Balanced Loss
Cui 等提出 effective number:
En=1−βn1−β, E_n=\frac{1-\beta^n}{1-\beta}, En=1−β1−βn,
据此构造类别权重,而不是简单使用 1/Nc1/N_c1/Nc。
其思想是:
同一类别增加第 10,001 个样本产生的信息,不应该和增加第 2 个样本完全一样。
LDAM
LDAM 从分类 margin 入手,为少数类设置更大的分类间隔要求:
Δc∝1Nc1/4. \Delta_c\propto\frac{1}{N_c^{1/4}}. Δc∝Nc1/41.
因此:
Nc↓ ⇒ Δc↑. N_c\downarrow \;\Rightarrow\; \Delta_c\uparrow. Nc↓⇒Δc↑.
它代表另一种思路:
不平衡问题本质上也是决策边界问题
Logit Adjustment 与 Balanced Softmax
2020 年前后的长尾学习进一步指出,类别先验本身会影响 softmax 输出,因此可以依据训练类别频率对 logits 进行校正。Balanced Softmax 和 Logit Adjustment 都属于这一思想。
这些方法原本并非专门为时间序列提出,但正在成为 ITSC 很值得系统比较的一组 baseline。
9. 第六类方法:生成式模型
传统 SMOTE 假设局部线性关系。
但真实少数类可能满足复杂分布:
P(X∣y=minority). P(X\mid y=\text{minority}). P(X∣y=minority).
因此可以学习:
z∼P(z)→G(z)→X~. z\sim P(z)\rightarrow G(z)\rightarrow\tilde{X}. z∼P(z)→G(z)→X~.
GAN、VAE 等生成模型由此进入时间序列非平衡学习。
2022 年 SDM 的 IB-GAN 就是比较典型的专门方法。它不是简单从随机噪声产生少数类,而是将 imputation 与 balancing 相结合,以生成更高质量的多变量时间序列,并将生成和分类统一起来。
它代表了:
sampling→distribution learning. \text{sampling}\rightarrow\text{distribution learning}. sampling→distribution learning.
不过生成式方法也有明显问题:少数类本身数据极少时,生成模型反而最难学到真正的少数类分布。
于是容易出现 Mode Collapse ,或者产生"看起来很像,但并不真正属于该故障机制"的序列。
因此 GAN 并没有让传统过采样自动过时。
10. 2022 年的重要转折:OHIT 与 T-SMOTE
2022 年是 ITSC 一个很重要的时间节点。
OHIT
Zhu 等在 Knowledge-Based Systems 提出的 OHIT 专门针对高维不平衡时间序列。
方法首先对少数类进行模式聚类,然后估计不同少数类模式的协方差结构,最后分别生成样本;作者同时把 OHIT 嵌入 Boosting 得到 OHITBoost。
其关键认识是:
少数类内部不是均匀的
因此不能简单围绕所有少数类样本平均生成数据。
T-SMOTE
同年 IJCAI 发表了 T-SMOTE。
T-SMOTE 不再直接把传统 SMOTE 套到时间序列上,而是利用时间信息构造靠近类别边界的少数类样本,再进行合成和加权采样。作者还在 early prediction 场景进行了验证。
因此其逻辑可以理解为:
Temporal information+Border information+Oversampling. \text{Temporal information} + \text{Border information} + \text{Oversampling}. Temporal information+Border information+Oversampling.
T-SMOTE 已经成为现代 ITSC 实验中非常值得纳入的专用 baseline。
11. 真正的前沿:从"数据平衡"走向"表示平衡"
这是理解当前研究现状最关键的一部分。
假设经过 SMOTE 后:
Nmajority=Nminority. N_{majority}=N_{minority}. Nmajority=Nminority.
是否意味着问题解决?
不一定。
因为深度网络最终学习的是:
z=fθ(X). z=f_\theta(X). z=fθ(X).
真正的问题可能发生在特征空间:
P(z∣minority) P(z\mid \text{minority}) P(z∣minority)
仍然聚集不好,或者与
P(z∣majority) P(z\mid \text{majority}) P(z∣majority)
严重重叠。
因此:
数量平衡 ≠ 特征平衡 ≠ 决策平衡
这正是 2024---2026 年研究逐渐关注的问题。
12. 对比学习成为重要方向
普通监督学习:
X→z→y. X\rightarrow z\rightarrow y. X→z→y.
对比学习则进一步要求:
zi≈zjwhenyi=yj, z_i\approx z_j \quad \text{when} \quad y_i=y_j, zi≈zjwhenyi=yj,
以及
zi≉zkwhenyi≠yk. z_i\not\approx z_k \quad \text{when} \quad y_i\neq y_k. zi≈zkwhenyi=yk.
这对于少数类特别有价值,因为模型可以直接学习:
什么是少数类的共同结构
而不仅仅依赖分类交叉熵。
2023 年 AAAI 的 supervised contrastive few-shot time-series 工作已经表明,在标签稀缺情况下,监督对比表示可以提高时间序列的鲁棒表征能力。
到了 2025 年,Jin 等发表在 IEEE TNNLS 的研究直接指出,InfoNCE 式时间序列对比学习本身也存在 false negatives 和 class imbalance 问题,并通过多实例判别、图交互投影头以及少量标签语义一致性来增强少数类表示。
这说明一个非常重要的趋势:
不平衡问题已经进入 representation learning 内部
而不是仅仅作为训练前的数据预处理步骤。
13. 多变量时间序列:DGMSCL
多变量时间序列进一步存在:
X∈RT×D. X\in\mathbb{R}^{T\times D}. X∈RT×D.
此时不仅要建模
t1,t2,⋯ ,tT t_1,t_2,\cdots,t_T t1,t2,⋯,tT
之间的时间依赖,还要考虑:
x(1),x(2),⋯ ,x(D) x^{(1)},x^{(2)},\cdots,x^{(D)} x(1),x(2),⋯,x(D)
之间动态变化的变量关系。
2025 年 Neural Networks 发表的 DGMSCL 将动态图、层次注意力与混合监督对比学习结合,用于 class-imbalanced multivariate time series classification,并特别强调少数类与过渡样本在动态时空结构上的干扰问题。
这代表当前 ITSC 一个明显趋势:
Class imbalance + Temporal dynamics + Inter-variable relationships
开始被统一建模。
14. 2025 年:针对表示空间本身设计平衡机制
2025 年 Expert Systems with Applications 的 COCL 工作进一步从 contrastive clustering loss 入手,希望改善不平衡情况下类内聚集和类间分离,并在多个时间序列数据集上进行了比较。
因此研究逻辑又前进了一步。
传统方法:
让两个类别数量接近
现代方法:
让表示空间中的类别几何结构合理
这两种目标并不是一回事。
15. 2026 年:TDBCL 代表一种新的混合范式
2026 年 Pattern Recognition 的 TDBCL 是当前值得重点阅读的专门 ITSC 工作之一。
TDBCL 使用双分支结构:
- Contrastive Representation Branch(对比表示分支)
- Balanced Classification Branch (平衡分类分支)
同时进行学习。
分类分支又使用面向时间序列设计的 DDTW-Tomek Link 和 Self-SMOTE,而两个分支之间使用 cosine-annealing transfer mechanism 动态调整学习重点。论文在不平衡 UCR 和 UEA 数据集上进行系统实验。
这其实代表了当前非常重要的一种范式:
Representation Learning + Data Rebalancing + Classifier Learning
不再试图用一个单独的 SMOTE、一个 loss 或一个 CNN 解决整个问题。
16. 目前整个领域可以重新整理成六条技术路线
| 路线 | 代表方法 | 解决什么 | 核心缺陷 |
|---|---|---|---|
| 数据重采样 | ROS、RUS、SMOTE、ADASYN | 样本数量 | 忽略时间结构 |
| 时序结构过采样 | SPO、INOS、OHIT、T-SMOTE | 时间结构 | 生成真实性仍难保证 |
| 代价敏感 | Class Weight、Cost-sensitive CNN | 梯度偏置 | 权重难设定 |
| 特殊损失 | Focal、CB Loss、LDAM、Logit Adjustment | 决策边界 | 很多不是时序专用 |
| 生成式增强 | GAN、VAE、IB-GAN | 少数类分布 | 少样本下生成模型不稳定 |
| 表示学习 | SupCon、DGMSCL、COCL、TDBCL | 特征空间失衡 | 当前仍是快速发展期 |
| 对初学者来说,这张表比记几十篇论文更重要。 |
17. 传统方法、现代方法到底差在哪里
可以把研究目标概括成四层。
Level 1:Sample Balance
Nmajority≈Nminority N_{majority}\approx N_{minority} Nmajority≈Nminority
解决:
数量是不是差太多?
Level 2:Loss Balance
∇Lmajority≫̸∇Lminority \nabla L_{majority}\not\gg\nabla L_{minority} ∇Lmajority≫∇Lminority
解决:
优化过程是不是被多数类支配?
Level 3:Representation Balance
Dintraminority↓,Dinter↑. D_{intra}^{minority}\downarrow,\qquad D_{inter}\uparrow. Dintraminority↓,Dinter↑.
解决:
少数类能不能形成好的特征簇?
Level 4:Generalization Balance
最终目标并不是训练数据平衡,而是:
Ptrain(X,Y)≠Ptest(X,Y) P_{train}(X,Y)\neq P_{test}(X,Y) Ptrain(X,Y)=Ptest(X,Y)
时少数类仍能识别。
也就是:
跨工况、跨设备、跨人群、跨时间仍然有效
这是未来更难也更有价值的问题。
18. 与 Few-shot、Long-tail、Anomaly Detection 的区别
这几个概念很容易混淆。
| 问题 | 核心 |
|---|---|
| Imbalanced Classification | 类别数量比例差异 |
| Long-tail Learning | 大量类别形成头部---尾部分布 |
| Few-shot Learning | 每类监督样本极少 |
| Anomaly Detection | 通常不知道所有异常类别 |
| One-class Classification | 主要只学习正常类 |
| Open-set Recognition | 测试阶段出现未知类别 |
| 它们相互关联,但不等价。 | |
| 例如: | |
| $$ | |
| 10000:100 | |
| $$ | |
| 属于严重不平衡。 | |
| 而 | |
| $$ | |
| 5:5 | |
| $$ | |
| 虽然平衡,却仍然是 few-shot。 | |
| 2024 年针对 low-shot 与 class imbalance 的综述也明确把二者视为高度相关但不同的研究问题。 |
19. 时间序列非平衡分类的评价方法
这里是很多论文最容易犯错误的地方。
假设:
9900 normal+100 fault. 9900\ \text{normal} + 100\ \text{fault}. 9900 normal+100 fault.
模型全部预测为正常:
Accuracy=99%. Accuracy=99\%. Accuracy=99%.
但:
Recallfault=0. Recall_{fault}=0. Recallfault=0.
因此 Accuracy 几乎没有意义。
更合理的实验应该至少同时考察:
Precision、Recall、F1、Macro-F1、Balanced Accuracy、G-mean、MCC、AUROC 以及 AUPRC 。
其中多类别情况下尤其应报告:
Macro-F1=1C∑c=1CF1c, \text{Macro-F1}=\frac{1}{C}\sum_{c=1}^C F1_c, Macro-F1=C1c=1∑CF1c,
而不能只报告 Micro-F1。
需要注意,ROC-AUC 与 PR-AUC 在类别比例发生变化时的性质并不相同,近年的研究也提醒不要机械地声称"PR-AUC 永远比 ROC-AUC 更正确"。更稳妥的做法是同时报告阈值指标、排序指标以及少数类实际 Precision/Recall,并说明测试集真实类别先验。
20. ITSC 实验最容易出现的五类错误
首先,不能先 SMOTE 再划分训练和测试集 。正确流程一定是:
D→Dtrain,Dtest \mathcal{D}\rightarrow D_{train},D_{test} D→Dtrain,Dtest
然后:
Dtrain→SMOTE. D_{train}\rightarrow\text{SMOTE}. Dtrain→SMOTE.
否则生成样本可能包含测试数据的信息。
其次,在工业、医疗等时间序列中,应特别警惕同一个设备、患者或井的数据同时出现在训练集和测试集中。
形式上训练测试独立了:
Xtrain∩Xtest=∅, X_{train}\cap X_{test}=\varnothing, Xtrain∩Xtest=∅,
但实际上:
Subjecttrain∩Subjecttest≠∅. \text{Subject}{train}\cap\text{Subject}{test}\neq\varnothing. Subjecttrain∩Subjecttest=∅.
这仍然可能造成严重的信息泄漏。
第三,不应该人为把测试集也平衡化,然后宣称模型适用于真实场景。测试分布应尽量对应部署时类别先验。
第四,单纯制造一个人为的 IR=10IR=10IR=10 数据集还不够。最好研究:
IR∈{1,5,10,20,50,100} IR\in\{1,5,10,20,50,100\} IR∈{1,5,10,20,50,100}
下性能如何变化。
第五,仅比较 Accuracy 很难证明一种不平衡算法真正有效。
21. 公共数据集如何做这个方向
目前很多 ITSC 方法使用 UCR Time Series Classification Archive 和 UEA Multivariate Time Series Archive 。
2026 年 TDBCL 就在不平衡 UCR 和 UEA 数据集上进行评价。
UCR/UEA 原本主要是通用 TSC benchmark,因此研究者通常有两种做法:
- 利用天然类别不平衡的数据集;
或者人为构造:
IR=5, 10, 20, 50,⋯ IR=5,\ 10,\ 20,\ 50,\cdots IR=5, 10, 20, 50,⋯
这样就可以系统研究算法对 imbalance severity 的敏感性。
除此之外,真实应用数据更有价值,例如 Backblaze 硬盘故障、ECG、EEG、工业设备故障、网络流量和电力系统故障。
例如 2025 年的 COCL 工作还基于公开 Backblaze 数据构造硬盘数据进行实验。
22. 当前真正没有解决好的问题
从现有研究看,ITSC 已经不是"缺一个新的 SMOTE"的问题。
| 科学问题 | 当前不足 | 值得研究程度 |
|---|---|---|
| 少数类时间结构保持 | 合成样本可能破坏真实动态规律 | 高 |
| 少数类内部多模态 | 一个类别可能有多个故障机制 | 高 |
| 类间重叠 | 数量平衡后边界仍然模糊 | 很高 |
| 多变量动态关系 | 变量相关性随时间和工况改变 | 很高 |
| 极端不平衡 | 1:1000 甚至 1:10000 | 很高 |
| 标签噪声 | 极少数错标签可能影响整个少数类 | 很高 |
| 跨工况泛化 | 训练工况与测试工况不同 | 很高 |
| 时间分布漂移 | 类别比例本身随时间变化 | 很高 |
| 不确定性 | 少数类预测置信度常不可靠 | 很高 |
| 自监督学习的不平衡 | 预训练阶段也存在 representation bias | 前沿 |
| Foundation Model + Long-tail | 尚缺系统成熟方案 | 前沿 |
| 尤其值得注意的是: |
Class Imbalance ≠ Sample Imbalance
现代真正困难的是:
Representation Imbalance + Distribution Shift
23. 2026 年值得关注的新趋势
2026 年最新 TSC 综述已经把传统方法、深度学习、few-shot learning、自监督以及 foundation-style representation learning 放在统一框架中讨论;现实 TSC 教程也开始明确把 class imbalance 与 unequal length、missingness、高维度等共同视为"imperfect time-series data"问题。
另一个变化是多个困难开始被联合研究。
例如 2026 年 AAAI 已出现同时考虑:
irregular sampling+missingness+class imbalance \text{irregular sampling} + \text{missingness} + \text{class imbalance} irregular sampling+missingness+class imbalance
的时间序列分类工作。
这意味着未来论文更可能研究:
真实复杂时间序列中的联合分布问题
而不是单独假设一个干净、等长、无缺失的数据集,然后只制造一个 1:10 类别比例。
24. 代表性文献脉络
| 年份 | 工作 | 主要意义 |
|---|---|---|
| 2002 | SMOTE | 奠定合成少数类过采样范式 |
| 2008 | ADASYN | 根据学习难度自适应生成 |
| 2010/2011 | Ghost Points | 开始考虑时间序列特殊距离结构 |
| 2011 | SPO | 明确提出结构保持时序过采样 |
| 2013 | INOS | 组合统计生成与插值 |
| 2014 | Mixture of Gaussian Trees | 建模少数类多模态时间结构 |
| 2017 | Focal Loss | 从难样本角度解决梯度失衡 |
| 2018 | Cost-sensitive CNN for ITSC | 深度时间序列代价敏感分类 |
| 2019 | Class-Balanced Loss / LDAM | 有效样本数与决策 margin |
| 2020 | Logit Adjustment / Balanced Softmax | 类别先验与输出校正 |
| 2021 | Iwana & Uchida survey | 系统梳理时间序列增强 |
| 2022 | OHIT | 高维结构保持、多模态过采样 |
| 2022 | T-SMOTE | 面向时间结构与类别边界 |
| 2022 | IB-GAN | 生成式非平衡 MTS 分类 |
| 2023 | SupCon few-shot TSC | 监督对比学习进入小样本时序 |
| 2025 | DGMSCL | 动态图 + 不平衡 MTS + 对比学习 |
| 2025 | TS contrastive learning against imbalance | 从自监督表示内部研究不平衡 |
| 2025 | COCL | 表示空间平衡损失 |
| 2026 | TDBCL | 对比表示 + 时序采样 + 双分支统一 |
| 从这条时间线可以明显看到: |
SMOTE → Temporal SMOTE → Deep Imbalance → Generative Balance → Representation Balance
这就是这一领域二十余年的核心演进。
25. 初学者最合适的学习顺序
建议按下面顺序进入该方向,而不要一上来就研究 Transformer。
- 先理解普通不平衡学习:掌握 SMOTE、ADASYN、class weight、Precision、Recall、F1、AUC、AUPRC。
- 再理解标准时间序列分类:掌握 DTW-KNN、FCN、ResNet、LSTM-FCN、InceptionTime,以及 UCR/UEA benchmark。
- 阅读早期 ITSC:Ghost Points → SPO → INOS → Gaussian Trees,理解为什么普通 SMOTE 不适合直接处理时间序列。
- 阅读现代采样方法:OHIT → T-SMOTE → IB-GAN,理解"结构保持、边界、多模态、生成分布"。
- 进入深度不平衡学习:Focal Loss → CB Loss → LDAM → Logit Adjustment → Balanced Softmax。
- 最后进入当前前沿 :监督/自监督对比学习 → DGMSCL → Time-Series Contrastive Learning against Class Imbalance → COCL → TDBCL。
完成这条路线以后,基本就能读懂当前绝大多数时间序列非平衡分类论文。
26. 对当前研究现状的总体判断
截至 2026 年,可以把领域状态概括为:
- 传统采样方法已经相当成熟
- 时间结构保持采样仍有改进空间
- 单纯"深度网络 + SMOTE + Focal Loss"创新性已经有限
而真正仍具有较高研究价值的是: - 少数类表示学习
- 跨工况与分布漂移
- 多变量动态关系
- 极端长尾 + 小样本
- 不确定性与可信分类
以及: - 物理/因果约束下的少数类泛化
27. 最终研究地图
如果把整个领域压缩为一张逻辑图,可以表示为:
Imbalanced Time-Series Classification
        ↓
Sample Imbalance
        ↓
Temporal-Structure Imbalance
        ↓
Optimization Imbalance
        ↓
Representation Imbalance
        ↓
Generalization Imbalance
对应方法则是:
SMOTE → SPO / T-SMOTE → Cost / Focal
              ↓
          GAN / OHIT
              ↓
   Contrastive / Graph / Dual Branch
              ↓
   Cross-Domain / Uncertainty / Causal
因此,对这个研究方向最准确的理解不是:
"如何把少数类补到和多数类一样多?"
而应该升级为:
如何在极少数监督样本条件下,保持时间动力学结构,学习稳定且具有判别性的少数类表示,并使其在工况变化、类别先验变化和真实噪声环境下仍具有可靠泛化能力?
这已经是当前时间序列非平衡分类研究真正的核心科学问题。