目录
- [一、为什么 Transformer 需要 Decoder?](#一、为什么 Transformer 需要 Decoder?)
- [1.1 Encoder 和 Decoder 最初分别负责什么?](#1.1 Encoder 和 Decoder 最初分别负责什么?)
- [1.2 Decoder 为什么不能像 Encoder 一样直接看完整序列?](#1.2 Decoder 为什么不能像 Encoder 一样直接看完整序列?)
- [二、什么是 Masked Self-Attention?](#二、什么是 Masked Self-Attention?)
- [2.1 先回顾普通 Self-Attention](#2.1 先回顾普通 Self-Attention)
- [三、Causal Mask:把未来的信息遮住](#三、Causal Mask:把未来的信息遮住)
- [3.1 用一个简单例子理解 Mask](#3.1 用一个简单例子理解 Mask)
- [四、Mask 到底是怎么加进 Attention 里的?](#四、Mask 到底是怎么加进 Attention 里的?)
- [五、为什么一定要使用 -∞?](#五、为什么一定要使用 -∞?)
- [六、为什么这种 Mask 是一个三角矩阵?](#六、为什么这种 Mask 是一个三角矩阵?)
- [七、Decoder 的 Self-Attention 到底解决了什么问题?](#七、Decoder 的 Self-Attention 到底解决了什么问题?)
- [八、什么是 Autoregressive Generation?](#八、什么是 Autoregressive Generation?)
- 九、训练时和生成时有什么区别?
- [9.1 训练阶段:一次计算很多位置](#9.1 训练阶段:一次计算很多位置)
- [9.2 为什么生成阶段不能像训练一样一次预测全部?](#9.2 为什么生成阶段不能像训练一样一次预测全部?)
- [十、Decoder 中为什么还有 Cross-Attention?](#十、Decoder 中为什么还有 Cross-Attention?)
- [十一、Cross-Attention 和 Self-Attention 有什么区别?](#十一、Cross-Attention 和 Self-Attention 有什么区别?)
- [十二、GPT 为什么没有 Encoder 和 Cross-Attention?](#十二、GPT 为什么没有 Encoder 和 Cross-Attention?)
- [十三、从输入到下一个 token:完整过程](#十三、从输入到下一个 token:完整过程)
- 十四、为什么模型输出的不是"一个答案",而是一组概率?
- [十五、Greedy、Sampling:下一个 token 到底怎么选?](#十五、Greedy、Sampling:下一个 token 到底怎么选?)
- 十六、一个完整的自回归生成例子
- 十七、训练语言模型时,模型到底在学习什么?
- [十八、为什么 Causal Mask 对训练也非常重要?](#十八、为什么 Causal Mask 对训练也非常重要?)
- [十九、现在重新理解 Decoder](#十九、现在重新理解 Decoder)
- [二十、Encoder-Decoder Transformer 与 GPT 的区别](#二十、Encoder-Decoder Transformer 与 GPT 的区别)
- [二十一、从"Transformer Block"到"语言模型"](#二十一、从“Transformer Block”到“语言模型”)
- 二十二、这一篇真正需要记住什么?
- [二十三、下一篇:从 Transformer 到 GPT,大语言模型是怎么来的?](#二十三、下一篇:从 Transformer 到 GPT,大语言模型是怎么来的?)
前言
前六篇文章,我们已经沿着 Transformer 的核心结构一步一步地走了下来。
第一篇,我们从 RNN、LSTM 的局限出发,理解了为什么需要 Transformer。
第二篇,我们从整体结构上认识了 Encoder、Decoder,以及 Transformer 的模块化设计。
第三篇,我们深入 Self-Attention,理解了 Query、Key、Value,以及注意力分数是如何计算出来的。
第四篇,我们进一步理解 Multi-Head Attention,知道了为什么 Transformer 不只使用一个注意力头。
第五篇,我们解决了 Self-Attention 无法天然感知顺序的问题,认识了 Positional Encoding,以及现代模型中常见的其他位置表示方法。
第六篇,我们又把 Transformer Block 内部剩下的重要组件补齐了:FFN、Residual Connection 和 LayerNorm。
到这里,我们已经知道一个 Transformer Block 是如何工作的:
text
输入
 ↓
Multi-Head Attention
 ↓
Residual + LayerNorm
 ↓
FFN
 ↓
Residual + LayerNorm
 ↓
输出
但是,这还没有回答一个最关键的问题:
Transformer 是如何真正生成一段文本的?
我们平时使用大语言模型时,输入:
text
今天天气模型并不是一次性把完整答案全部计算出来。
它更像是在不断重复这样的过程:
text
今天天气
   ↓
预测下一个 token
   ↓
今天天气很好
   ↓
再次预测下一个 token
   ↓
今天天气很好。
   ↓
再次预测下一个 token
   ↓
...
也就是说,大语言模型生成文本时,本质上是在不断预测:
下一个 token 是什么?
但是这里立刻出现了一个非常严重的问题。
假设训练数据中有一句:
text
我喜欢吃苹果当模型正在预测"苹果"时,它应该只能看到:
text
我喜欢吃而不能提前看到:
text
苹果否则模型就相当于已经知道了答案。
所以 Decoder 需要一种特殊机制:
让当前位置只能关注自己以及自己之前的 token,而不能看到未来的信息。
这就是本篇文章的核心:
text
Decoder
Masked Self-Attention
Causal Mask
Autoregressive Generation
理解了这些内容,我们才能真正理解 GPT 这一类大语言模型为什么能够一个 token 一个 token 地生成文本。
下面是本篇文章的整体脉络图:
#mermaid-svg-fyfbWKS4nrBS5Ha2{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .error-icon{fill:#552222;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .marker.cross{stroke:#333333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-fyfbWKS4nrBS5Ha2 p{margin:0;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .cluster-label text{fill:#333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .cluster-label span{color:#333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .cluster-label span p{background-color:transparent;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .label text,#mermaid-svg-fyfbWKS4nrBS5Ha2 span{fill:#333;color:#333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .node rect,#mermaid-svg-fyfbWKS4nrBS5Ha2 .node circle,#mermaid-svg-fyfbWKS4nrBS5Ha2 .node ellipse,#mermaid-svg-fyfbWKS4nrBS5Ha2 .node polygon,#mermaid-svg-fyfbWKS4nrBS5Ha2 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .rough-node .label text,#mermaid-svg-fyfbWKS4nrBS5Ha2 .node .label text,#mermaid-svg-fyfbWKS4nrBS5Ha2 .image-shape .label,#mermaid-svg-fyfbWKS4nrBS5Ha2 .icon-shape .label{text-anchor:middle;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .rough-node .label,#mermaid-svg-fyfbWKS4nrBS5Ha2 .node .label,#mermaid-svg-fyfbWKS4nrBS5Ha2 .image-shape .label,#mermaid-svg-fyfbWKS4nrBS5Ha2 .icon-shape .label{text-align:center;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .node.clickable{cursor:pointer;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .arrowheadPath{fill:#333333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-fyfbWKS4nrBS5Ha2 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-fyfbWKS4nrBS5Ha2 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-fyfbWKS4nrBS5Ha2 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .cluster text{fill:#333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .cluster span{color:#333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-fyfbWKS4nrBS5Ha2 rect.text{fill:none;stroke-width:0;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .icon-shape,#mermaid-svg-fyfbWKS4nrBS5Ha2 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .icon-shape p,#mermaid-svg-fyfbWKS4nrBS5Ha2 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .icon-shape .label rect,#mermaid-svg-fyfbWKS4nrBS5Ha2 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-fyfbWKS4nrBS5Ha2 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-fyfbWKS4nrBS5Ha2 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-fyfbWKS4nrBS5Ha2 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 前六篇:理解 Transformer Block
核心问题:如何生成文本?
Decoder 需要遮挡未来信息
Masked Self-Attention
Causal Mask(三角矩阵)
Autoregressive Generation
训练 vs 生成
Cross-Attention(Encoder-Decoder)
GPT:Decoder-only
从输入到下一个 token 的完整过程
一、为什么 Transformer 需要 Decoder?
1.1 Encoder 和 Decoder 最初分别负责什么?
在最初的 Transformer 结构中,Transformer 并不是专门为了聊天或者文本续写设计的。
原始 Transformer 主要用于:
text
输入序列
   ↓
Encoder
   ↓
理解输入
   ↓
Decoder
   ↓
生成输出序列
例如机器翻译:
text
英语:
I love apples.

      ↓ Encoder

内部表示

      ↓ Decoder

中文:
我喜欢苹果。
Encoder 更像是在负责:
理解输入序列。
Decoder 更像是在负责:
根据已有的信息,一步一步生成输出序列。
这两个部分虽然都使用 Transformer Block,但它们的任务并不完全一样。
1.2 Decoder 为什么不能像 Encoder 一样直接看完整序列?
假设我们现在要生成:
text
我 喜欢 吃 苹果如果是 Encoder,那么看到完整句子没有问题。
因为 Encoder 的任务主要是理解:
text
我
喜欢
吃
苹果这些 token 之间的关系。
但是 Decoder 不一样。
Decoder 的任务是:
根据已经生成的内容,预测下一个 token。
例如:
text
输入:我
预测:喜欢
然后:
text
输入:我 喜欢
预测:吃
然后:
text
输入:我 喜欢 吃
预测:苹果
所以 Decoder 在预测当前位置时,不能看到未来的 token。
否则:
text
我 喜欢 吃 苹果
            ↑
         已经知道答案
模型就不需要真正学习预测了。
因此 Decoder 必须具备一种"遮挡未来信息"的能力。
这就是 Masked Self-Attention。
二、什么是 Masked Self-Attention?
2.1 先回顾普通 Self-Attention
在第三篇文章中,我们已经知道 Self-Attention 的核心公式:
Attention ( Q , K , V ) = softmax ( Q K T d k ) V \operatorname{Attention}(Q,K,V)= \operatorname{softmax} \left( \frac{QK^T}{\sqrt{d_k}} \right)V Attention(Q,K,V)=softmax(dk QKT)V
其中:
- Q Q Q 表示 Query
- K K K 表示 Key
- V V V 表示 Value
首先计算:
Q K T QK^T QKT
得到不同 token 之间的相关性分数。
然后除以:
d k \sqrt{d_k} dk
再通过 Softmax 转换成注意力权重。
最后对 V V V 进行加权求和。
问题在于:
普通 Self-Attention 默认允许每一个 token 关注所有 token。
例如:
text
我 喜欢 吃 苹果对于"吃"这个 token,普通 Self-Attention 理论上可以同时看到:
text
我
喜欢
吃
苹果也就是说,它甚至可以看到未来的"苹果"。
这对于理解整个句子没有问题。
但对于"预测下一个 token"的任务,这是不允许的。
三、Causal Mask:把未来的信息遮住
3.1 用一个简单例子理解 Mask
假设我们有四个 token:
text
我 喜欢 吃 苹果我们希望:
text
我只能看到自己。
text
我 喜欢中的"喜欢"可以看到:
text
我
喜欢而不能看到:
text
吃
苹果于是就可以画成一个注意力矩阵:
text
          我   喜欢   吃   苹果

我         ✓    ×    ×    ×

喜欢       ✓    ✓    ×    ×

吃         ✓    ✓    ✓    ×

苹果       ✓    ✓    ✓    ✓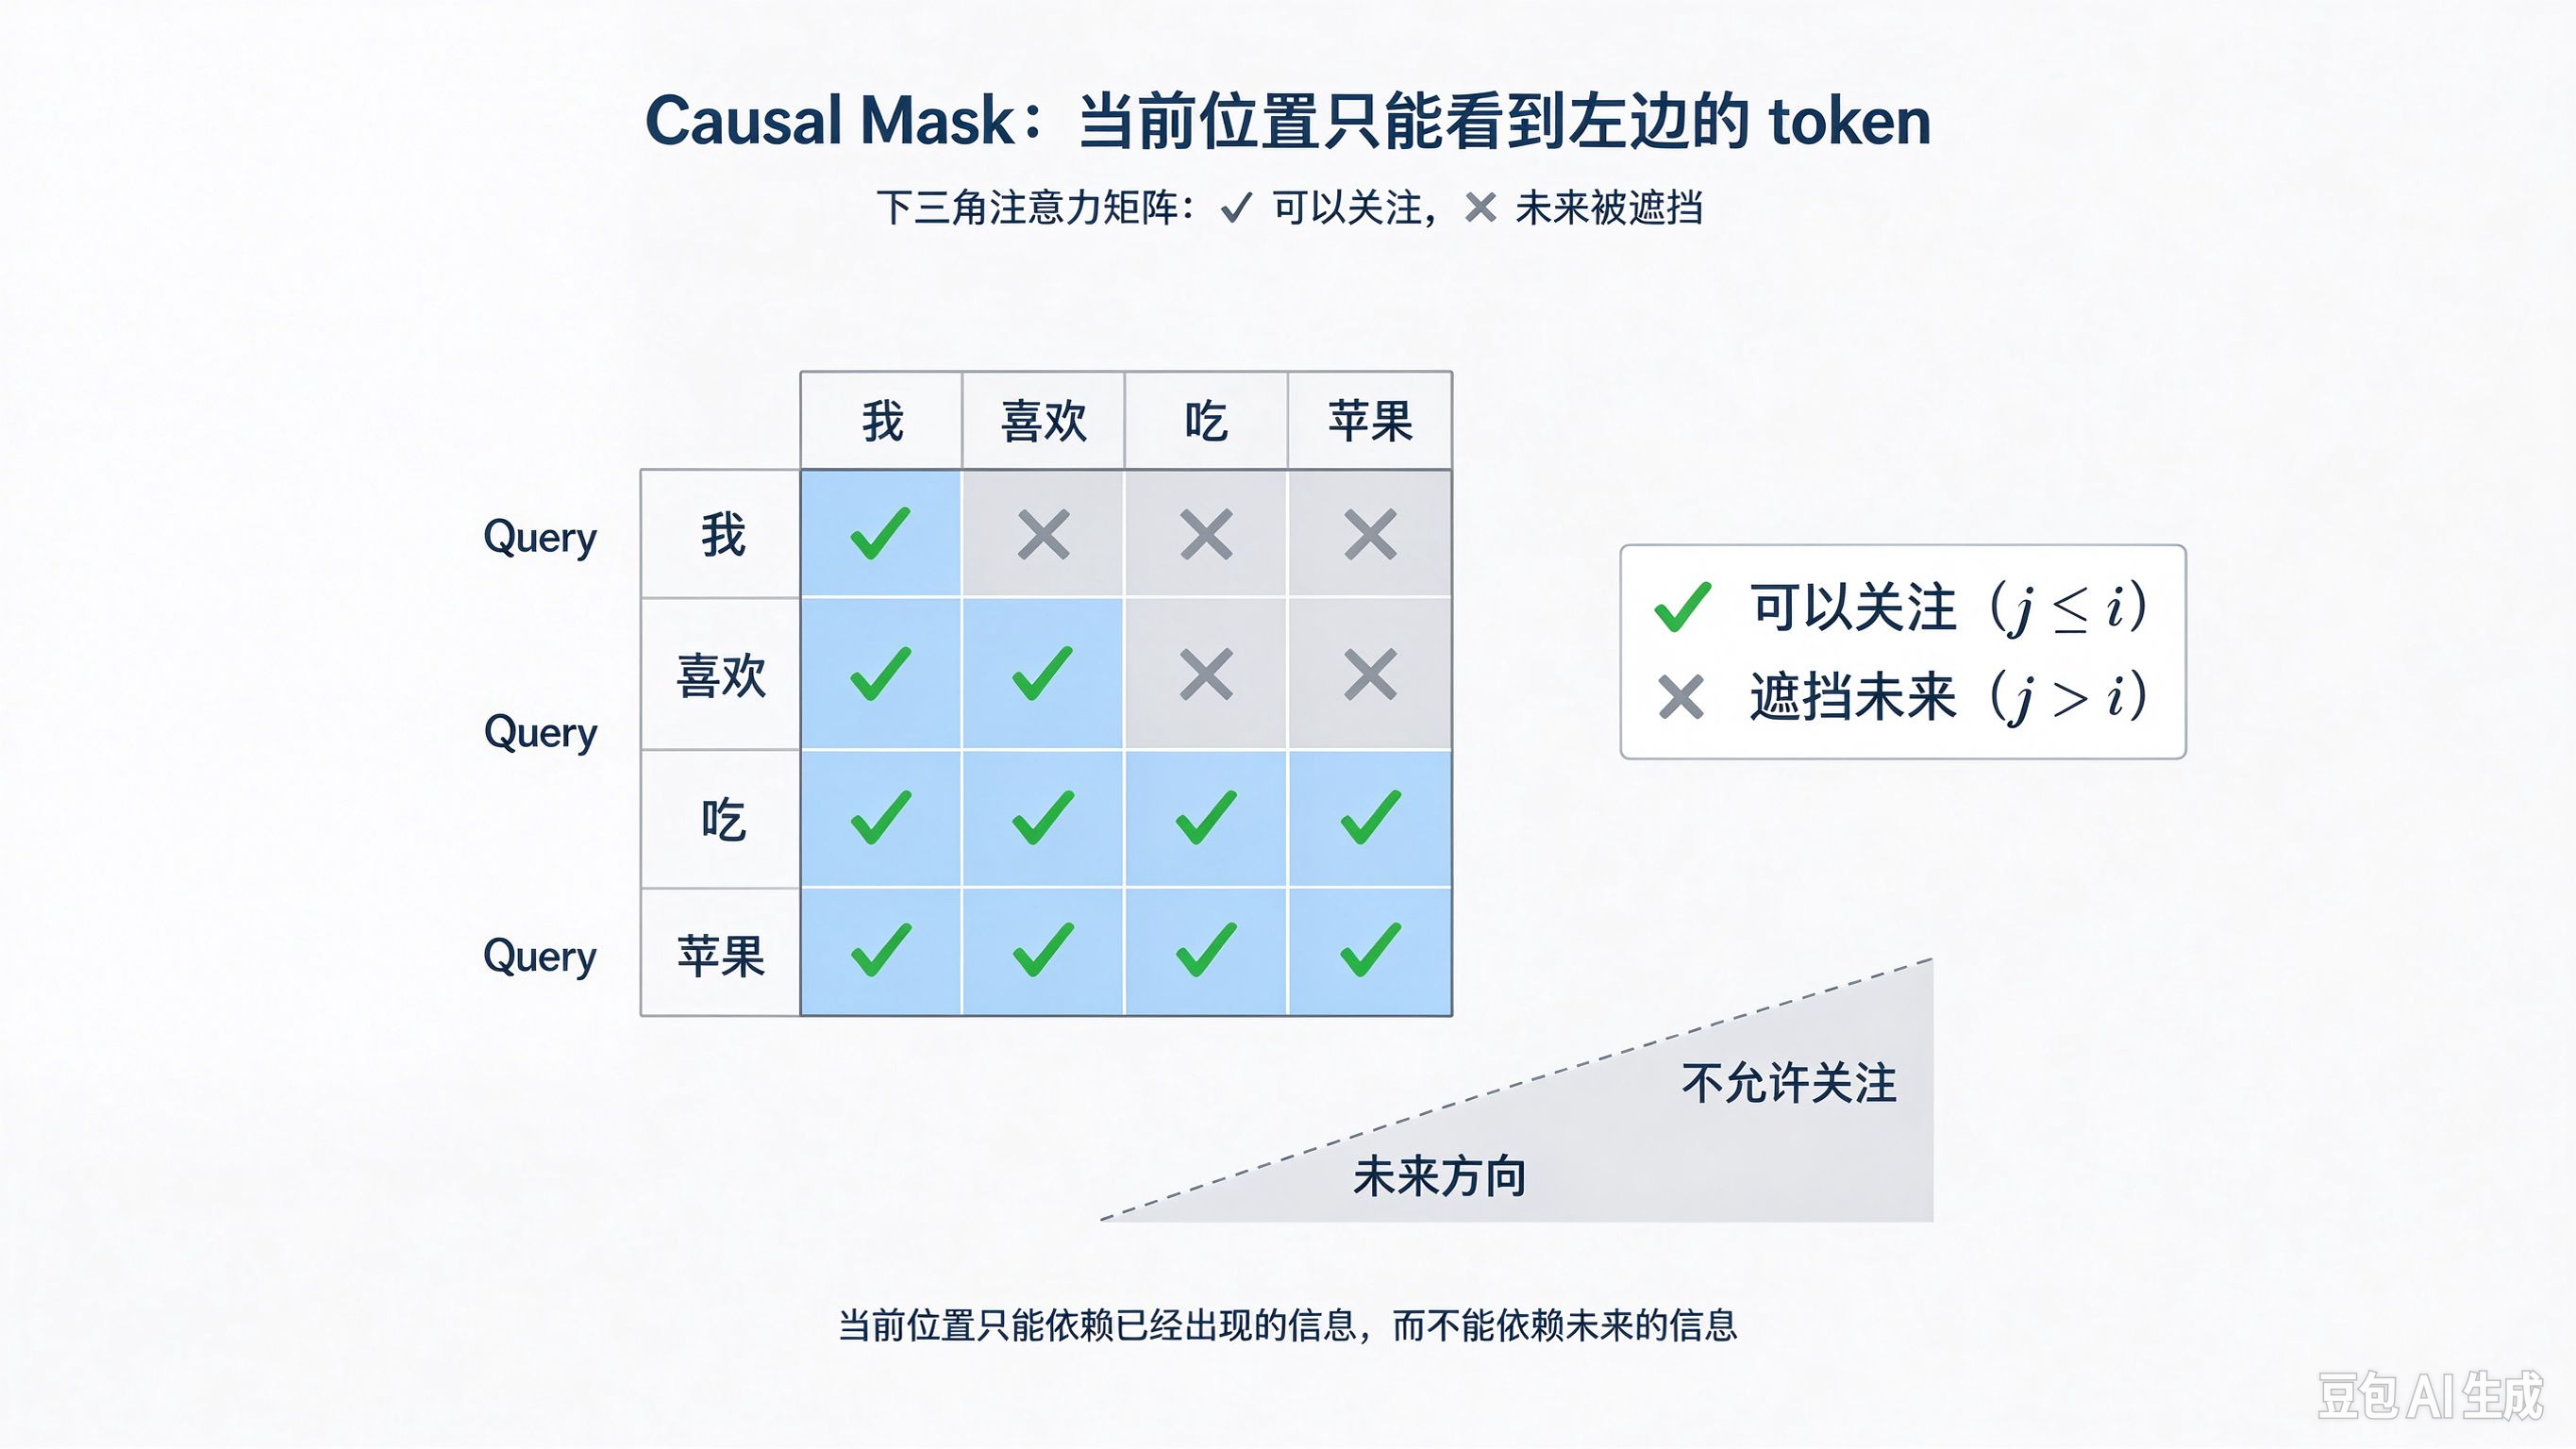
这里:
text
✓ = 可以关注
× = 不允许关注
可以发现,这个矩阵具有一个非常明显的特点:
只能看到当前位置左边以及当前位置本身。
所以它也经常被称为:
text
Causal Attention或者:
text
Causal Self-Attention其中 Causal 可以理解成"因果"。
因为在生成过程中:
当前位置只能依赖已经出现的信息,而不能依赖未来的信息。
四、Mask 到底是怎么加进 Attention 里的?
现在我们已经知道需要遮住未来 token。
但模型究竟是怎么做到的?
关键就在 Attention 分数计算完成以后。
普通 Attention 会先计算:
S = Q K T d k S=\frac{QK^T}{\sqrt{d_k}} S=dk QKT
这里的 S S S 就是 Attention Score,也就是注意力分数矩阵。
例如可能得到:
S = 2.1 1.2 0.7 1.5 0.8 2.4 1.1 1.7 1.2 0.9 2.8 1.6 1.4 1.8 0.7 2.5 S= \begin{bmatrix} 2.1 & 1.2 & 0.7 & 1.5\\ 0.8 & 2.4 & 1.1 & 1.7\\ 1.2 & 0.9 & 2.8 & 1.6\\ 1.4 & 1.8 & 0.7 & 2.5 \end{bmatrix} S= 2.10.81.21.41.22.40.91.80.71.12.80.71.51.71.62.5
但是我们不希望第一行看到第二、第三、第四个 token。
所以可以构造一个 Mask:
M = 0 − ∞ − ∞ − ∞ 0 0 − ∞ − ∞ 0 0 0 − ∞ 0 0 0 0 M= \begin{bmatrix} 0 & -\infty & -\infty & -\infty\\ 0 & 0 & -\infty & -\infty\\ 0 & 0 & 0 & -\infty\\ 0 & 0 & 0 & 0 \end{bmatrix} M= 0000−∞000−∞−∞00−∞−∞−∞0
然后把它加到原来的分数矩阵:
S ′ = S + M S'=S+M S′=S+M
于是:
S ′ = 2.1 − ∞ − ∞ − ∞ 0.8 2.4 − ∞ − ∞ 1.2 0.9 2.8 − ∞ 1.4 1.8 0.7 2.5 S'= \begin{bmatrix} 2.1 & -\infty & -\infty & -\infty\\ 0.8 & 2.4 & -\infty & -\infty\\ 1.2 & 0.9 & 2.8 & -\infty\\ 1.4 & 1.8 & 0.7 & 2.5 \end{bmatrix} S′= 2.10.81.21.4−∞2.40.91.8−∞−∞2.80.7−∞−∞−∞2.5
接下来再进行 Softmax:
A = softmax ( S ′ ) A=\operatorname{softmax}(S') A=softmax(S′)
这里最关键的地方就是:
e − ∞ = 0 e^{-\infty}=0 e−∞=0
因此那些被 Mask 的位置经过 Softmax 后,注意力权重就会变成 0。
也就是说:
text
未来 token
   ↓
Mask
   ↓
分数变成 -∞
   ↓
Softmax
   ↓
权重变成 0
   ↓
无法获得未来 token 的信息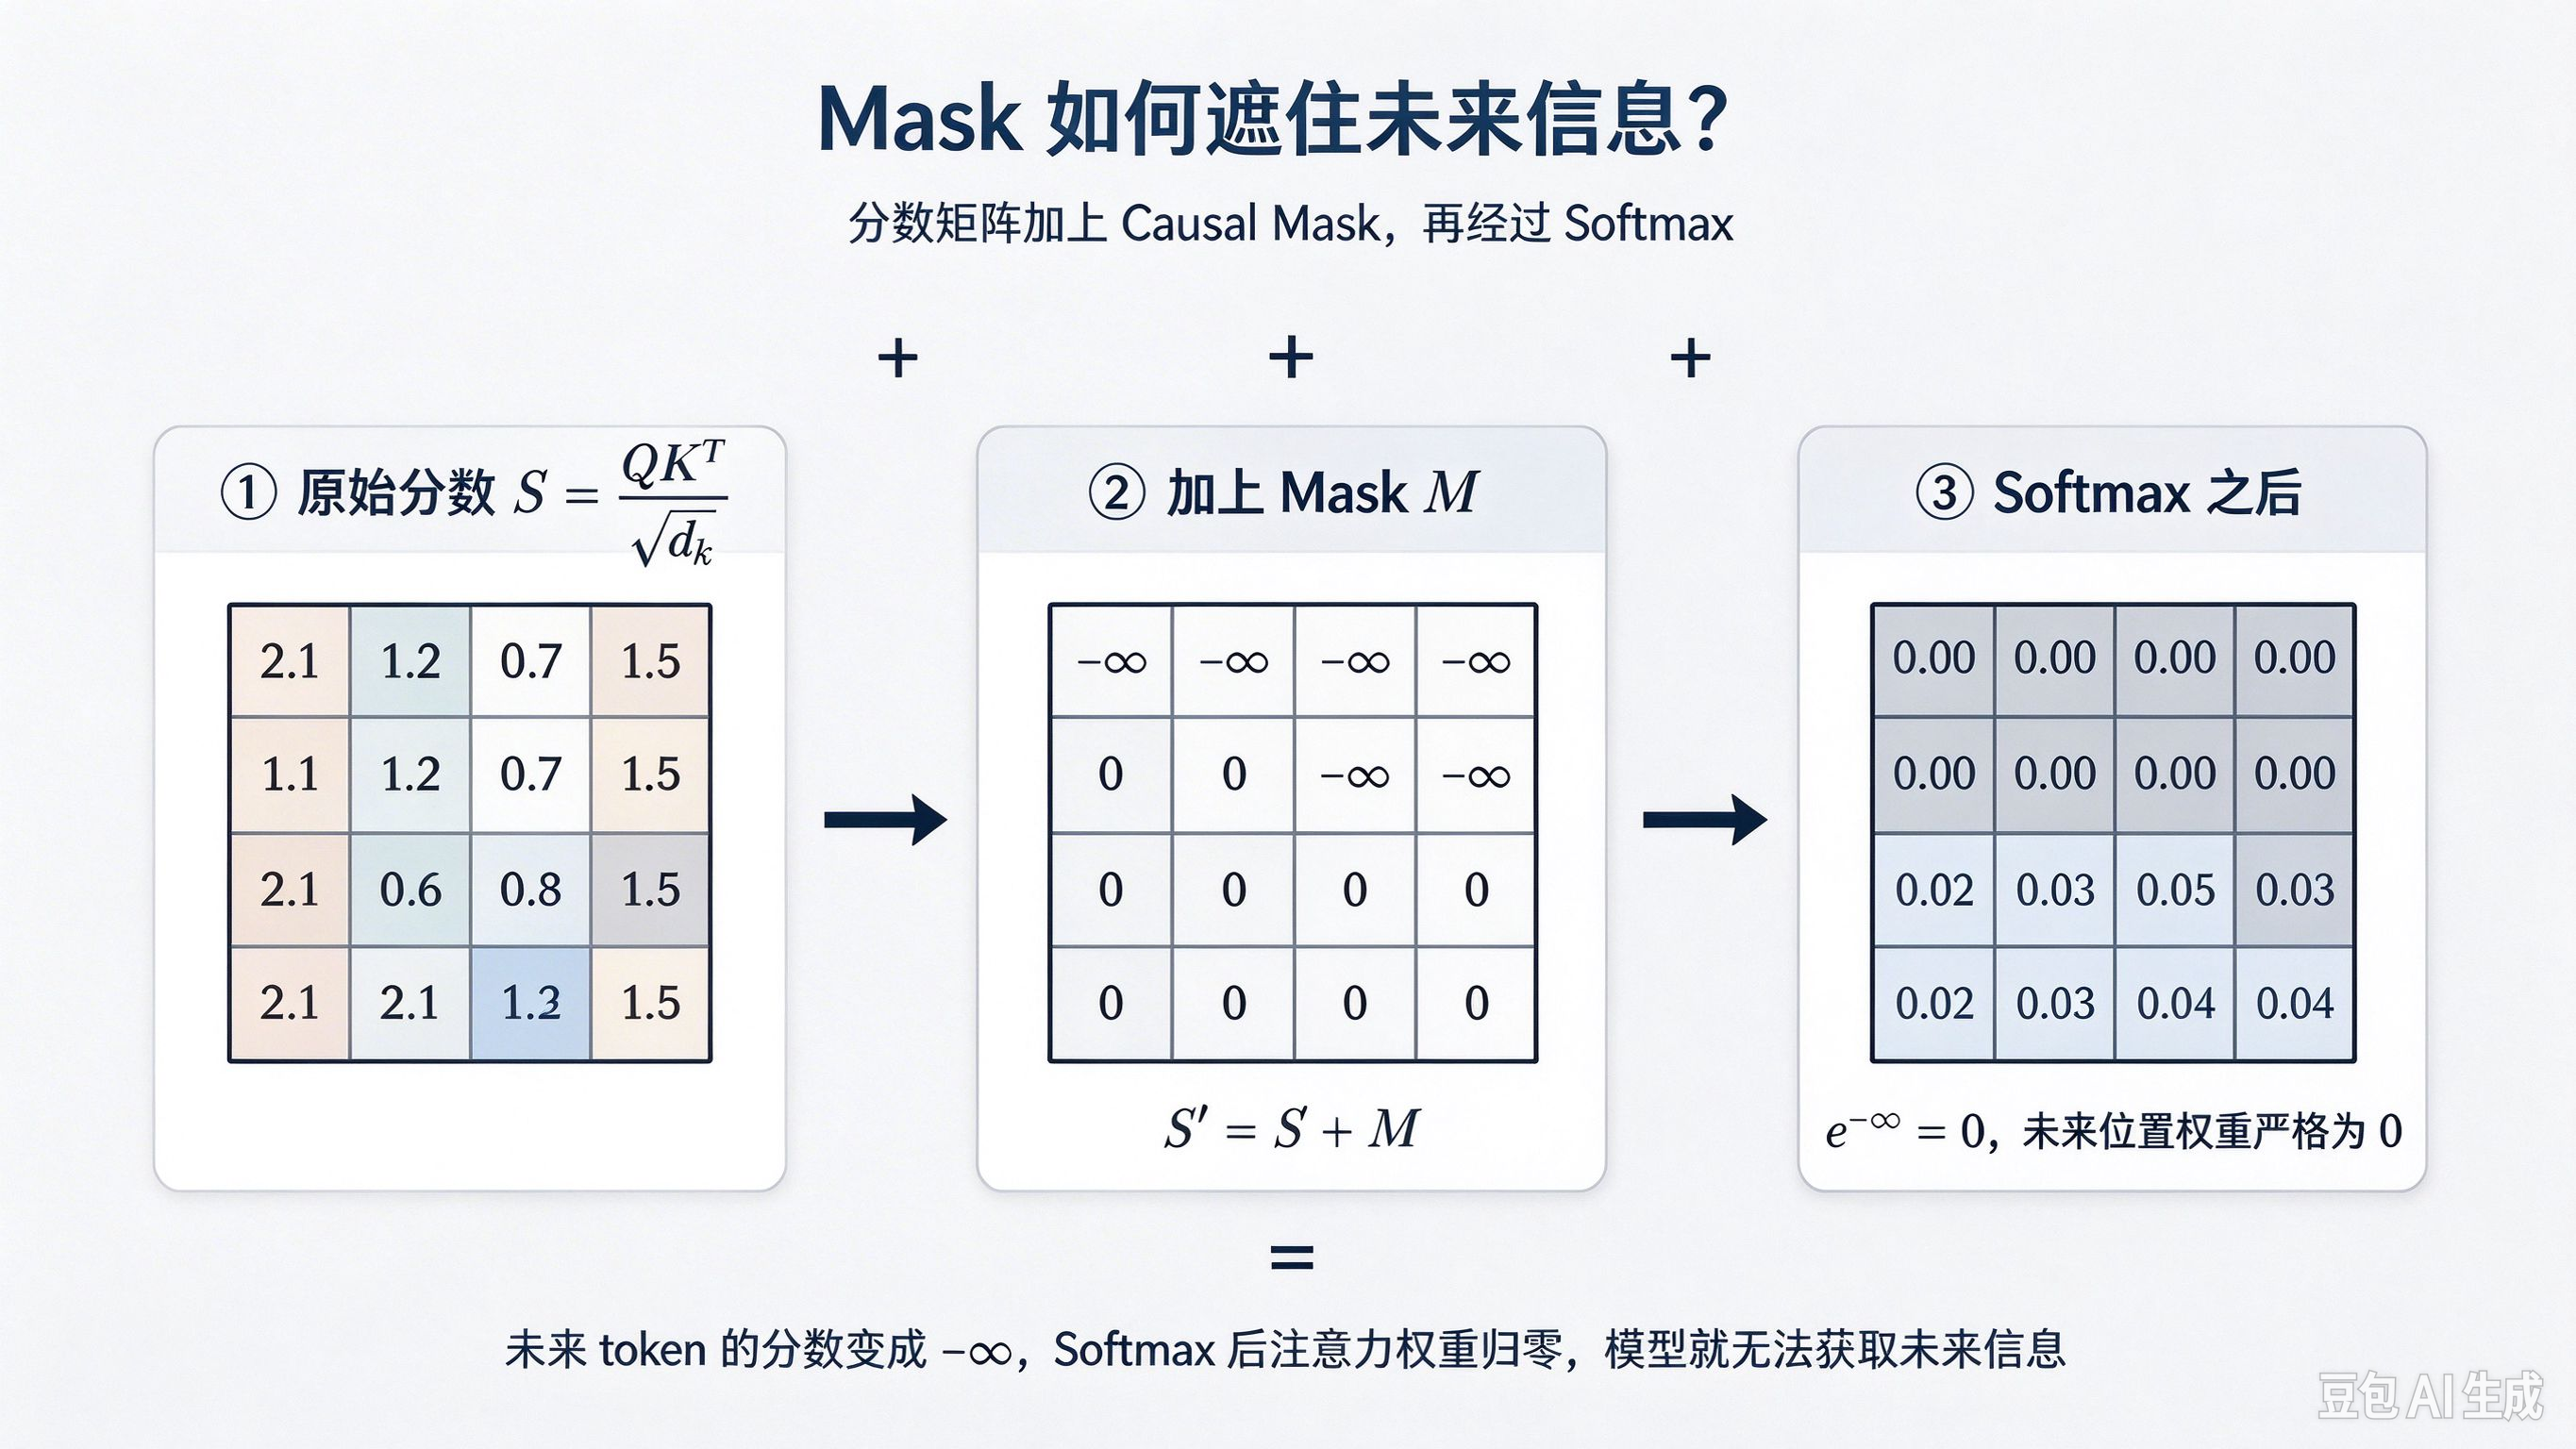
这就是 Causal Mask 最核心的实现思想。
下面是 Mask 加入 Attention 的完整流程:
#mermaid-svg-osUKDxrnQTUBWWUX{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-osUKDxrnQTUBWWUX .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-osUKDxrnQTUBWWUX .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-osUKDxrnQTUBWWUX .error-icon{fill:#552222;}#mermaid-svg-osUKDxrnQTUBWWUX .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-osUKDxrnQTUBWWUX .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-osUKDxrnQTUBWWUX .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-osUKDxrnQTUBWWUX .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-osUKDxrnQTUBWWUX .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-osUKDxrnQTUBWWUX .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-osUKDxrnQTUBWWUX .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-osUKDxrnQTUBWWUX .marker{fill:#333333;stroke:#333333;}#mermaid-svg-osUKDxrnQTUBWWUX .marker.cross{stroke:#333333;}#mermaid-svg-osUKDxrnQTUBWWUX svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-osUKDxrnQTUBWWUX p{margin:0;}#mermaid-svg-osUKDxrnQTUBWWUX .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-osUKDxrnQTUBWWUX .cluster-label text{fill:#333;}#mermaid-svg-osUKDxrnQTUBWWUX .cluster-label span{color:#333;}#mermaid-svg-osUKDxrnQTUBWWUX .cluster-label span p{background-color:transparent;}#mermaid-svg-osUKDxrnQTUBWWUX .label text,#mermaid-svg-osUKDxrnQTUBWWUX span{fill:#333;color:#333;}#mermaid-svg-osUKDxrnQTUBWWUX .node rect,#mermaid-svg-osUKDxrnQTUBWWUX .node circle,#mermaid-svg-osUKDxrnQTUBWWUX .node ellipse,#mermaid-svg-osUKDxrnQTUBWWUX .node polygon,#mermaid-svg-osUKDxrnQTUBWWUX .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-osUKDxrnQTUBWWUX .rough-node .label text,#mermaid-svg-osUKDxrnQTUBWWUX .node .label text,#mermaid-svg-osUKDxrnQTUBWWUX .image-shape .label,#mermaid-svg-osUKDxrnQTUBWWUX .icon-shape .label{text-anchor:middle;}#mermaid-svg-osUKDxrnQTUBWWUX .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-osUKDxrnQTUBWWUX .rough-node .label,#mermaid-svg-osUKDxrnQTUBWWUX .node .label,#mermaid-svg-osUKDxrnQTUBWWUX .image-shape .label,#mermaid-svg-osUKDxrnQTUBWWUX .icon-shape .label{text-align:center;}#mermaid-svg-osUKDxrnQTUBWWUX .node.clickable{cursor:pointer;}#mermaid-svg-osUKDxrnQTUBWWUX .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-osUKDxrnQTUBWWUX .arrowheadPath{fill:#333333;}#mermaid-svg-osUKDxrnQTUBWWUX .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-osUKDxrnQTUBWWUX .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-osUKDxrnQTUBWWUX .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-osUKDxrnQTUBWWUX .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-osUKDxrnQTUBWWUX .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-osUKDxrnQTUBWWUX .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-osUKDxrnQTUBWWUX .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-osUKDxrnQTUBWWUX .cluster text{fill:#333;}#mermaid-svg-osUKDxrnQTUBWWUX .cluster span{color:#333;}#mermaid-svg-osUKDxrnQTUBWWUX div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-osUKDxrnQTUBWWUX .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-osUKDxrnQTUBWWUX rect.text{fill:none;stroke-width:0;}#mermaid-svg-osUKDxrnQTUBWWUX .icon-shape,#mermaid-svg-osUKDxrnQTUBWWUX .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-osUKDxrnQTUBWWUX .icon-shape p,#mermaid-svg-osUKDxrnQTUBWWUX .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-osUKDxrnQTUBWWUX .icon-shape .label rect,#mermaid-svg-osUKDxrnQTUBWWUX .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-osUKDxrnQTUBWWUX .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-osUKDxrnQTUBWWUX .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-osUKDxrnQTUBWWUX :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 计算注意力分数 S = QK^T / √d_k
构造 Causal Mask M
S' = S + M
Softmax(S')
未来位置权重变为 0
无法获得未来 token 的信息
五、为什么一定要使用 -∞?
这里有一个很容易产生疑问的问题:
为什么 Mask 使用的是:
− ∞ -\infty −∞
而不是简单地写成:
text
0或者:
text
-1原因就在 Softmax。
Softmax 的公式是:
$$
\operatorname{softmax}(x_i)
\frac{e^{x_i}}
{\sum_j e^{x_j}}
$$
如果我们希望某个位置的最终权重严格变成 0,那么最直接的方法就是让:
e x i = 0 e^{x_i}=0 exi=0
而:
e − ∞ = 0 e^{-\infty}=0 e−∞=0
所以把对应位置的分数设置成:
− ∞ -\infty −∞
Softmax 之后,这个位置就不会获得注意力权重。
因此 Mask 并不是把未来的信息"删除"。
更准确地说:
Mask 让模型在计算注意力权重时忽略未来位置。
六、为什么这种 Mask 是一个三角矩阵?
把刚才的 Mask 单独拿出来:
M = 0 − ∞ − ∞ − ∞ 0 0 − ∞ − ∞ 0 0 0 − ∞ 0 0 0 0 M= \begin{bmatrix} 0 & -\infty & -\infty & -\infty\\ 0 & 0 & -\infty & -\infty\\ 0 & 0 & 0 & -\infty\\ 0 & 0 & 0 & 0 \end{bmatrix} M= 0000−∞000−∞−∞00−∞−∞−∞0
可以发现:
text
0  -∞ -∞ -∞
0   0 -∞ -∞
0   0  0 -∞
0   0  0  0
它实际上是一个下三角矩阵。
所以这种 Mask 经常被称为:
Causal Mask / Lower Triangular Mask
如果序列长度是 n n n,那么可以把它抽象成:
M i j = { 0 , j ≤ i − ∞ , j > i M_{ij}= \begin{cases} 0, & j\leq i\\ -\infty, & j>i \end{cases} Mij={0,−∞,j≤ij>i
这里:
- i i i 表示当前 token 的位置
- j j j 表示它正在关注的位置
当:
j ≤ i j\leq i j≤i
说明目标位置没有超过当前位置,可以访问。
当:
j > i j>i j>i
说明目标位置属于未来,因此必须屏蔽。
七、Decoder 的 Self-Attention 到底解决了什么问题?
到这里,我们就可以重新理解 Decoder 中的 Self-Attention。
普通 Self-Attention:
text
每个 token
    ↓
可以关注所有 token
Masked Self-Attention:
text
每个 token
    ↓
只能关注自己和过去的 token
所以:
text
Encoder Self-Attention和:
text
Decoder Masked Self-Attention最大的区别之一,就是是否需要阻止未来信息泄露。
可以简单总结成:
| 模块 | 能看到哪些 token |
|---|---|
| Encoder Self-Attention | 整个输入序列 |
| Decoder Masked Self-Attention | 当前 token 以及之前的 token |
这也是 Decoder 能够用于自回归生成的重要基础。
八、什么是 Autoregressive Generation?
现在我们终于可以进入大语言模型生成文本的核心机制:
Autoregressive Generation,自回归生成。
"自回归"这个词看起来比较复杂,但核心思想其实很简单:
根据已经生成的内容,预测下一个 token,然后把这个 token 加入输入,再继续预测下一个 token。
例如我们想生成:
text
我喜欢吃苹果模型可能经历:
text
输入:
我

预测:
喜欢
然后:
text
输入:
我 喜欢

预测:
吃
然后:
text
输入:
我 喜欢 吃

预测:
苹果
最后:
text
输入:
我 喜欢 吃 苹果

预测:
<EOS>
这里:
text
<EOS>可以理解成:
End Of Sequence
也就是告诉模型:
这段文本生成结束了。
因此整个过程可以抽象成:
text
已有 token
    ↓
Transformer
    ↓
预测下一个 token
    ↓
把新 token 加入序列
    ↓
再次输入 Transformer
    ↓
继续预测
    ↓
...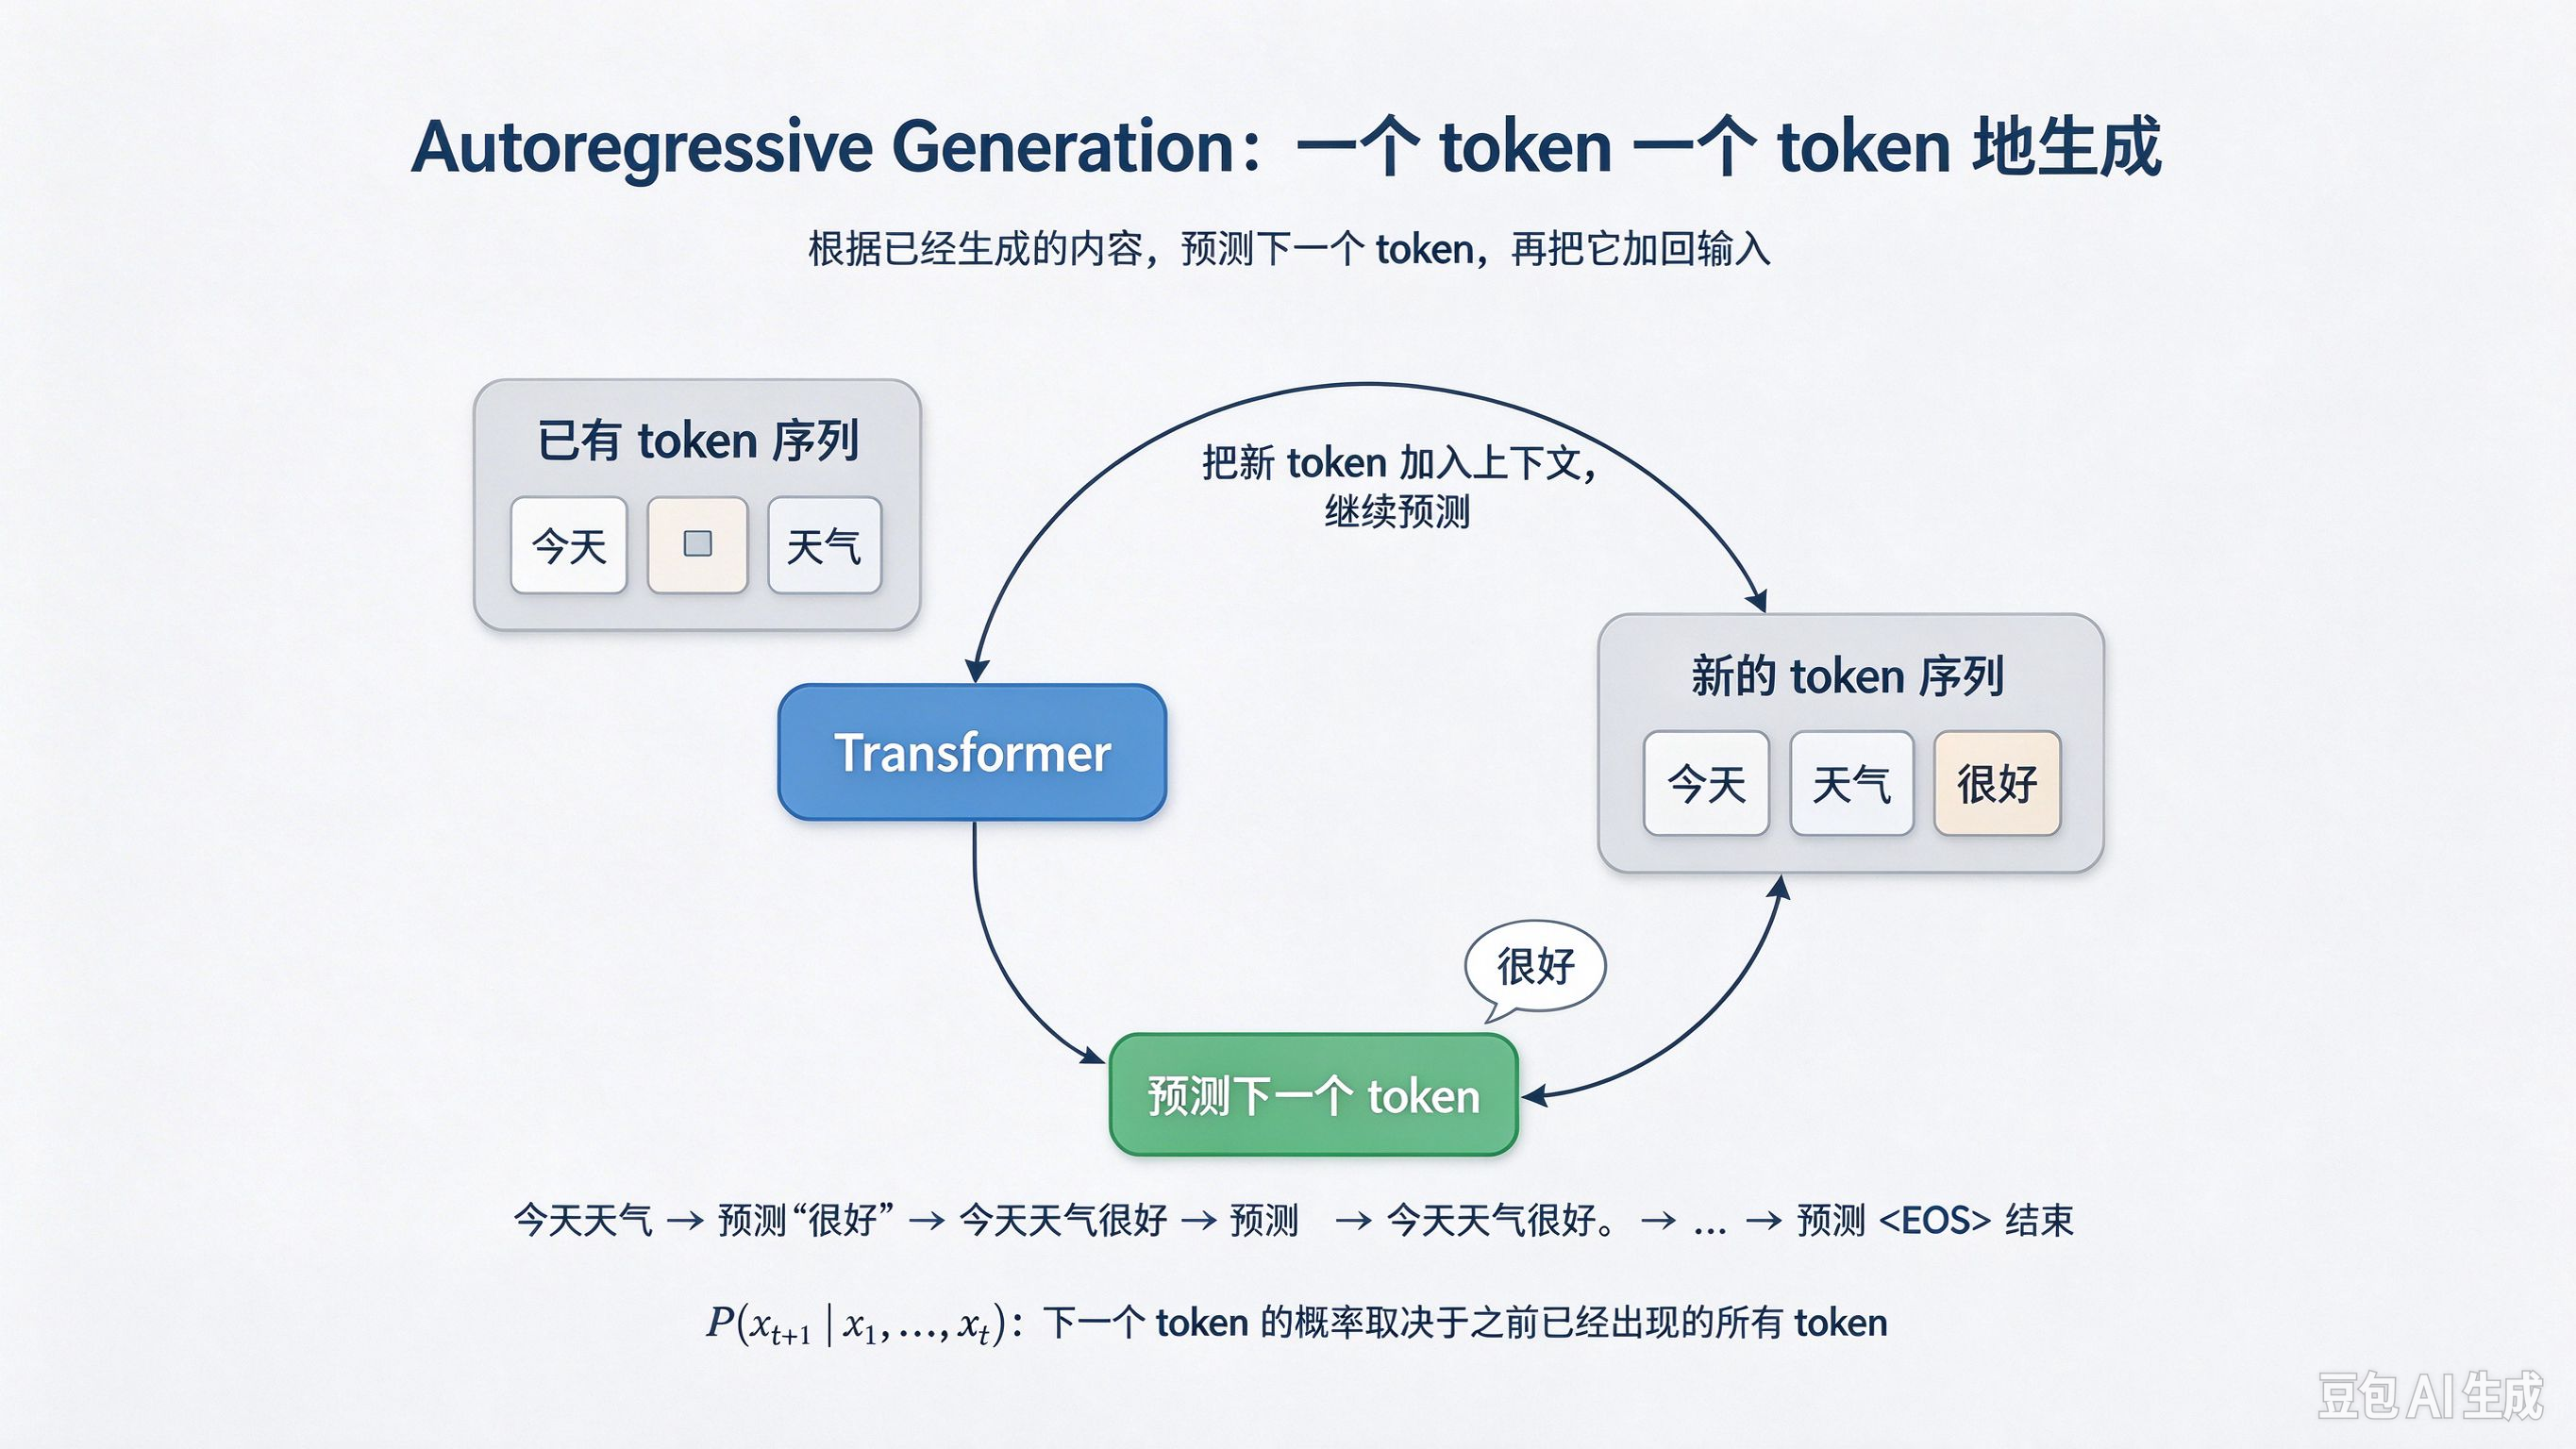
这就是大语言模型最基本的文本生成过程。
下面是自回归生成的完整流程:
#mermaid-svg-sqLNwn37VrSFfkyW{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-sqLNwn37VrSFfkyW .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-sqLNwn37VrSFfkyW .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-sqLNwn37VrSFfkyW .error-icon{fill:#552222;}#mermaid-svg-sqLNwn37VrSFfkyW .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-sqLNwn37VrSFfkyW .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-sqLNwn37VrSFfkyW .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-sqLNwn37VrSFfkyW .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-sqLNwn37VrSFfkyW .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-sqLNwn37VrSFfkyW .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-sqLNwn37VrSFfkyW .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-sqLNwn37VrSFfkyW .marker{fill:#333333;stroke:#333333;}#mermaid-svg-sqLNwn37VrSFfkyW .marker.cross{stroke:#333333;}#mermaid-svg-sqLNwn37VrSFfkyW svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-sqLNwn37VrSFfkyW p{margin:0;}#mermaid-svg-sqLNwn37VrSFfkyW .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-sqLNwn37VrSFfkyW .cluster-label text{fill:#333;}#mermaid-svg-sqLNwn37VrSFfkyW .cluster-label span{color:#333;}#mermaid-svg-sqLNwn37VrSFfkyW .cluster-label span p{background-color:transparent;}#mermaid-svg-sqLNwn37VrSFfkyW .label text,#mermaid-svg-sqLNwn37VrSFfkyW span{fill:#333;color:#333;}#mermaid-svg-sqLNwn37VrSFfkyW .node rect,#mermaid-svg-sqLNwn37VrSFfkyW .node circle,#mermaid-svg-sqLNwn37VrSFfkyW .node ellipse,#mermaid-svg-sqLNwn37VrSFfkyW .node polygon,#mermaid-svg-sqLNwn37VrSFfkyW .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-sqLNwn37VrSFfkyW .rough-node .label text,#mermaid-svg-sqLNwn37VrSFfkyW .node .label text,#mermaid-svg-sqLNwn37VrSFfkyW .image-shape .label,#mermaid-svg-sqLNwn37VrSFfkyW .icon-shape .label{text-anchor:middle;}#mermaid-svg-sqLNwn37VrSFfkyW .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-sqLNwn37VrSFfkyW .rough-node .label,#mermaid-svg-sqLNwn37VrSFfkyW .node .label,#mermaid-svg-sqLNwn37VrSFfkyW .image-shape .label,#mermaid-svg-sqLNwn37VrSFfkyW .icon-shape .label{text-align:center;}#mermaid-svg-sqLNwn37VrSFfkyW .node.clickable{cursor:pointer;}#mermaid-svg-sqLNwn37VrSFfkyW .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-sqLNwn37VrSFfkyW .arrowheadPath{fill:#333333;}#mermaid-svg-sqLNwn37VrSFfkyW .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-sqLNwn37VrSFfkyW .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-sqLNwn37VrSFfkyW .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-sqLNwn37VrSFfkyW .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-sqLNwn37VrSFfkyW .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-sqLNwn37VrSFfkyW .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-sqLNwn37VrSFfkyW .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-sqLNwn37VrSFfkyW .cluster text{fill:#333;}#mermaid-svg-sqLNwn37VrSFfkyW .cluster span{color:#333;}#mermaid-svg-sqLNwn37VrSFfkyW div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-sqLNwn37VrSFfkyW .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-sqLNwn37VrSFfkyW rect.text{fill:none;stroke-width:0;}#mermaid-svg-sqLNwn37VrSFfkyW .icon-shape,#mermaid-svg-sqLNwn37VrSFfkyW .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-sqLNwn37VrSFfkyW .icon-shape p,#mermaid-svg-sqLNwn37VrSFfkyW .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-sqLNwn37VrSFfkyW .icon-shape .label rect,#mermaid-svg-sqLNwn37VrSFfkyW .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-sqLNwn37VrSFfkyW .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-sqLNwn37VrSFfkyW .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-sqLNwn37VrSFfkyW :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 已有 token
Transformer
预测下一个 token
把新 token 加入序列
再次输入 Transformer
遇到 EOS 结束
九、训练时和生成时有什么区别?
这里是理解 GPT 类模型时非常重要的一点。
虽然训练和真正生成文本时都在做:
预测下一个 token
但是两者的执行方式其实并不完全一样。
9.1 训练阶段:一次计算很多位置
假设训练数据是:
text
我 喜欢 吃 苹果训练时可以把整个序列一次送进模型。
但是通过 Causal Mask:
text
我       → 只能看我
喜欢     → 只能看我、喜欢
吃       → 只能看我、喜欢、吃
苹果     → 只能看我、喜欢、吃、苹果
于是模型可以同时计算多个位置的预测任务。
例如:
text
输入位置:

我
喜欢
吃

目标:

喜欢
吃
苹果
可以理解成:
text
我      → 预测 喜欢
喜欢    → 预测 吃
吃      → 预测 苹果
虽然这些预测在逻辑上具有先后关系,但由于 Causal Mask 已经保证了每个位置看不到未来信息,因此训练时可以把多个位置放到一次矩阵计算中并行处理。
这也是 Transformer 相对于传统 RNN 的一个重要优势:
训练阶段可以高度并行化。
9.2 为什么生成阶段不能像训练一样一次预测全部?
因为生成阶段的未来 token 根本还不存在。
例如现在只有:
text
我 喜欢模型要预测:
text
吃只有模型生成"吃"以后,下一次输入才变成:
text
我 喜欢 吃然后才能预测:
text
苹果所以生成过程天然具有:
text
一步
↓
下一步
↓
再下一步
↓
再下一步
这样的顺序依赖。
因此可以形成一个非常重要的对比:
text
训练:

大量 token
    ↓
Causal Mask
    ↓
并行计算多个位置


生成:

已有 token
    ↓
预测一个 token
    ↓
加入新 token
    ↓
继续预测
所以:
Transformer 在训练阶段可以高度并行,而在自回归生成阶段,token 的产生仍然具有天然的顺序性。
这也是为什么大语言模型生成文本时,我们可以明显看到:
text
一个 token
一个 token
一个 token
不断出现。
下面是训练与生成阶段的对比图:
#mermaid-svg-MUTe5AfRAl3qk0mR{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-MUTe5AfRAl3qk0mR .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-MUTe5AfRAl3qk0mR .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-MUTe5AfRAl3qk0mR .error-icon{fill:#552222;}#mermaid-svg-MUTe5AfRAl3qk0mR .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-MUTe5AfRAl3qk0mR .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-MUTe5AfRAl3qk0mR .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-MUTe5AfRAl3qk0mR .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-MUTe5AfRAl3qk0mR .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-MUTe5AfRAl3qk0mR .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-MUTe5AfRAl3qk0mR .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-MUTe5AfRAl3qk0mR .marker{fill:#333333;stroke:#333333;}#mermaid-svg-MUTe5AfRAl3qk0mR .marker.cross{stroke:#333333;}#mermaid-svg-MUTe5AfRAl3qk0mR svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-MUTe5AfRAl3qk0mR p{margin:0;}#mermaid-svg-MUTe5AfRAl3qk0mR .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-MUTe5AfRAl3qk0mR .cluster-label text{fill:#333;}#mermaid-svg-MUTe5AfRAl3qk0mR .cluster-label span{color:#333;}#mermaid-svg-MUTe5AfRAl3qk0mR .cluster-label span p{background-color:transparent;}#mermaid-svg-MUTe5AfRAl3qk0mR .label text,#mermaid-svg-MUTe5AfRAl3qk0mR span{fill:#333;color:#333;}#mermaid-svg-MUTe5AfRAl3qk0mR .node rect,#mermaid-svg-MUTe5AfRAl3qk0mR .node circle,#mermaid-svg-MUTe5AfRAl3qk0mR .node ellipse,#mermaid-svg-MUTe5AfRAl3qk0mR .node polygon,#mermaid-svg-MUTe5AfRAl3qk0mR .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-MUTe5AfRAl3qk0mR .rough-node .label text,#mermaid-svg-MUTe5AfRAl3qk0mR .node .label text,#mermaid-svg-MUTe5AfRAl3qk0mR .image-shape .label,#mermaid-svg-MUTe5AfRAl3qk0mR .icon-shape .label{text-anchor:middle;}#mermaid-svg-MUTe5AfRAl3qk0mR .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-MUTe5AfRAl3qk0mR .rough-node .label,#mermaid-svg-MUTe5AfRAl3qk0mR .node .label,#mermaid-svg-MUTe5AfRAl3qk0mR .image-shape .label,#mermaid-svg-MUTe5AfRAl3qk0mR .icon-shape .label{text-align:center;}#mermaid-svg-MUTe5AfRAl3qk0mR .node.clickable{cursor:pointer;}#mermaid-svg-MUTe5AfRAl3qk0mR .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-MUTe5AfRAl3qk0mR .arrowheadPath{fill:#333333;}#mermaid-svg-MUTe5AfRAl3qk0mR .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-MUTe5AfRAl3qk0mR .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-MUTe5AfRAl3qk0mR .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-MUTe5AfRAl3qk0mR .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-MUTe5AfRAl3qk0mR .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-MUTe5AfRAl3qk0mR .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-MUTe5AfRAl3qk0mR .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-MUTe5AfRAl3qk0mR .cluster text{fill:#333;}#mermaid-svg-MUTe5AfRAl3qk0mR .cluster span{color:#333;}#mermaid-svg-MUTe5AfRAl3qk0mR div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-MUTe5AfRAl3qk0mR .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-MUTe5AfRAl3qk0mR rect.text{fill:none;stroke-width:0;}#mermaid-svg-MUTe5AfRAl3qk0mR .icon-shape,#mermaid-svg-MUTe5AfRAl3qk0mR .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-MUTe5AfRAl3qk0mR .icon-shape p,#mermaid-svg-MUTe5AfRAl3qk0mR .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-MUTe5AfRAl3qk0mR .icon-shape .label rect,#mermaid-svg-MUTe5AfRAl3qk0mR .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-MUTe5AfRAl3qk0mR .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-MUTe5AfRAl3qk0mR .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-MUTe5AfRAl3qk0mR :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 生成阶段
已有 token
预测一个 token
加入新 token
继续预测
训练阶段
大量 token
Causal Mask
并行计算多个位置
十、Decoder 中为什么还有 Cross-Attention?
到这里我们主要讲的是 Decoder 的 Masked Self-Attention。
但是原始 Transformer Decoder 还有一个非常重要的组件:
Cross-Attention。
这也是 Encoder-Decoder Transformer 和 GPT 这类 Decoder-only 模型之间非常重要的区别之一。
先看原始 Transformer。
整体结构:
text
输入
 ↓
Encoder
 ↓
Encoder Output
 ↓
Decoder
 ↓
输出
Decoder 需要同时获取两类信息。
第一类:
已经生成的内容。
这通过:
text
Masked Self-Attention完成。
第二类:
Encoder 对输入序列提取出来的信息。
这通过:
text
Cross-Attention完成。
十一、Cross-Attention 和 Self-Attention 有什么区别?
我们之前讲过 Self-Attention。
Self-Attention 的特点是:
text
Q、K、V
来自同一个序列
而 Cross-Attention 则不同。
它通常是:
text
Q
来自 Decoder

K、V
来自 Encoder
可以简单画成:
text
Decoder 当前表示
       │
       ↓
       Q
       │
       ↓
Cross-Attention
       ↑
       │
     K、V
       │
       ↑
Encoder 输出
所以 Cross-Attention 的作用可以理解成:
Decoder 在生成内容时,主动去查询 Encoder 对输入内容的理解。
例如机器翻译:
text
英文输入:
I love apples.

       ↓

Encoder

       ↓

内部表示

       ↓

Decoder
Decoder 在生成:
text
我之后,又需要生成:
text
喜欢它就可以通过 Cross-Attention 去关注 Encoder 中与当前生成内容相关的部分。
因此:
text
Masked Self-Attention解决的是:
我已经生成了什么?
而:
text
Cross-Attention解决的是:
输入内容中哪些信息对我现在生成最有帮助?
十二、GPT 为什么没有 Encoder 和 Cross-Attention?
这里就可以自然过渡到现代大语言模型。
像 GPT 这一类模型,并不是完整使用原始 Transformer 的 Encoder-Decoder 结构。
它采用的是:
Decoder-only Transformer
也就是说:
text
只有 Decoder
没有 Encoder
那么既然没有 Encoder:
text
Cross-Attention自然也就没有必要存在。
GPT 类模型的核心结构更加接近:
text
Token
 ↓
Embedding
 ↓
Transformer Block
 ↓
Transformer Block
 ↓
Transformer Block
 ↓
...
 ↓
Logits
 ↓
Next Token
其中 Transformer Block 主要使用:
text
Causal / Masked Self-Attention
+
FFN
+
Residual
+
LayerNorm
所以我们现在终于可以把前面几篇文章和 GPT 联系起来。
十三、从输入到下一个 token:完整过程
假设用户输入:
text
今天天气首先需要把文本转换成 token。
实际模型中的 token 划分会根据具体 Tokenizer 而不同,这里只是为了理解流程。
然后:
text
Token
 ↓
Token Embedding
 ↓
Position Information
 ↓
Transformer Block 1
 ↓
Transformer Block 2
 ↓
...
 ↓
Transformer Block N
经过很多层 Transformer Block 后,模型会得到最后一个位置的隐藏表示。
假设最后一个 token 是:
text
气模型需要根据它以及前面的上下文预测下一个 token。
最终通过一个输出层,把隐藏表示转换成整个词表上的分数。
假设词表中有:
text
很好
不错
晴朗
阴天
...
模型可能得到:
z = 2.1 1.5 0.8 0.2 ⋮ z= \begin{bmatrix} 2.1\\ 1.5\\ 0.8\\ 0.2\\ \vdots \end{bmatrix} z= 2.11.50.80.2⋮
这里的每一个数都可以理解为对应 token 的预测分数,也就是 Logit。
然后通过 Softmax 转换成概率:
P ( y i ) = e z i ∑ j e z j P(y_i)= \frac{e^{z_i}} {\sum_j e^{z_j}} P(yi)=∑jezjezi
于是就得到:
text
很好   0.42
不错   0.27
晴朗   0.18
阴天   0.05
...
然后模型根据某种生成策略选择一个 token。
例如选择:
text
很好于是文本变成:
text
今天天气很好然后继续进行下一轮预测。
下面是整个语言模型推理流程的完整图:
#mermaid-svg-AgrjhR5UF4dpjZ0S{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-AgrjhR5UF4dpjZ0S .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-AgrjhR5UF4dpjZ0S .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-AgrjhR5UF4dpjZ0S .error-icon{fill:#552222;}#mermaid-svg-AgrjhR5UF4dpjZ0S .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-AgrjhR5UF4dpjZ0S .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-AgrjhR5UF4dpjZ0S .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-AgrjhR5UF4dpjZ0S .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-AgrjhR5UF4dpjZ0S .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-AgrjhR5UF4dpjZ0S .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-AgrjhR5UF4dpjZ0S .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-AgrjhR5UF4dpjZ0S .marker{fill:#333333;stroke:#333333;}#mermaid-svg-AgrjhR5UF4dpjZ0S .marker.cross{stroke:#333333;}#mermaid-svg-AgrjhR5UF4dpjZ0S svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-AgrjhR5UF4dpjZ0S p{margin:0;}#mermaid-svg-AgrjhR5UF4dpjZ0S .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-AgrjhR5UF4dpjZ0S .cluster-label text{fill:#333;}#mermaid-svg-AgrjhR5UF4dpjZ0S .cluster-label span{color:#333;}#mermaid-svg-AgrjhR5UF4dpjZ0S .cluster-label span p{background-color:transparent;}#mermaid-svg-AgrjhR5UF4dpjZ0S .label text,#mermaid-svg-AgrjhR5UF4dpjZ0S span{fill:#333;color:#333;}#mermaid-svg-AgrjhR5UF4dpjZ0S .node rect,#mermaid-svg-AgrjhR5UF4dpjZ0S .node circle,#mermaid-svg-AgrjhR5UF4dpjZ0S .node ellipse,#mermaid-svg-AgrjhR5UF4dpjZ0S .node polygon,#mermaid-svg-AgrjhR5UF4dpjZ0S .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-AgrjhR5UF4dpjZ0S .rough-node .label text,#mermaid-svg-AgrjhR5UF4dpjZ0S .node .label text,#mermaid-svg-AgrjhR5UF4dpjZ0S .image-shape .label,#mermaid-svg-AgrjhR5UF4dpjZ0S .icon-shape .label{text-anchor:middle;}#mermaid-svg-AgrjhR5UF4dpjZ0S .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-AgrjhR5UF4dpjZ0S .rough-node .label,#mermaid-svg-AgrjhR5UF4dpjZ0S .node .label,#mermaid-svg-AgrjhR5UF4dpjZ0S .image-shape .label,#mermaid-svg-AgrjhR5UF4dpjZ0S .icon-shape .label{text-align:center;}#mermaid-svg-AgrjhR5UF4dpjZ0S .node.clickable{cursor:pointer;}#mermaid-svg-AgrjhR5UF4dpjZ0S .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-AgrjhR5UF4dpjZ0S .arrowheadPath{fill:#333333;}#mermaid-svg-AgrjhR5UF4dpjZ0S .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-AgrjhR5UF4dpjZ0S .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-AgrjhR5UF4dpjZ0S .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-AgrjhR5UF4dpjZ0S .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-AgrjhR5UF4dpjZ0S .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-AgrjhR5UF4dpjZ0S .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-AgrjhR5UF4dpjZ0S .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-AgrjhR5UF4dpjZ0S .cluster text{fill:#333;}#mermaid-svg-AgrjhR5UF4dpjZ0S .cluster span{color:#333;}#mermaid-svg-AgrjhR5UF4dpjZ0S div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-AgrjhR5UF4dpjZ0S .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-AgrjhR5UF4dpjZ0S rect.text{fill:none;stroke-width:0;}#mermaid-svg-AgrjhR5UF4dpjZ0S .icon-shape,#mermaid-svg-AgrjhR5UF4dpjZ0S .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-AgrjhR5UF4dpjZ0S .icon-shape p,#mermaid-svg-AgrjhR5UF4dpjZ0S .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-AgrjhR5UF4dpjZ0S .icon-shape .label rect,#mermaid-svg-AgrjhR5UF4dpjZ0S .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-AgrjhR5UF4dpjZ0S .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-AgrjhR5UF4dpjZ0S .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-AgrjhR5UF4dpjZ0S :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 文本
Tokenization
Token Embedding
Position Information
Transformer Blocks
Hidden Representation
Linear
Logits
Softmax
下一个 Token
加入上下文
十四、为什么模型输出的不是"一个答案",而是一组概率?
这是理解语言模型非常关键的一步。
模型本质上并不是直接输出:
text
答案 = 很好而是输出:
词表中每一个 token 的分数。
例如:
text
很好    2.8
不错    2.1
晴朗    1.7
阴天    0.9
下雨    0.4
...
这些分数经过 Softmax 后,就变成概率分布。
所以模型实际上是在回答:
根据当前上下文,下一个 token 分别有多大概率出现?
因此:
text
Transformer
   ↓
Hidden State
   ↓
Linear
   ↓
Logits
   ↓
Softmax
   ↓
Probability Distribution
   ↓
选择下一个 Token
这一步就把前面学习的 Attention、FFN 等内部计算,连接到了真正的"文本生成"。
十五、Greedy、Sampling:下一个 token 到底怎么选?
得到概率以后,还有一个问题:
到底选择哪个 token?
最简单的方法叫做:
Greedy Decoding
也就是每次都选择概率最大的 token。
例如:
text
很好   0.45
不错   0.30
晴朗   0.15
阴天   0.10
那么直接选择:
text
很好但是,如果每次都选择概率最高的 token,生成结果可能比较固定。
因此实际大语言模型中还可以使用各种 Sampling 方法。
例如:
text
Temperature
Top-K
Top-P
它们的作用,本质上都是对最终的概率分布进行调整,影响模型如何选择下一个 token。
这里先不展开,因为这些内容涉及生成策略本身,后面的文章还会再次用到。
目前只需要记住:
Transformer 最终给出的不是一句完整答案,而是对"下一个 token"的概率分布。
十六、一个完整的自回归生成例子
现在把整个过程完整走一遍。
假设用户输入:
text
今天第一轮:
text
输入:
今天

模型预测:
天气
于是:
text
今天 天气第二轮:
text
输入:
今天 天气

模型预测:
很好
于是:
text
今天 天气 很好第三轮:
text
输入:
今天 天气 很好

模型预测:
。
于是:
text
今天 天气 很好 。第四轮:
text
输入:
今天 天气 很好 。

模型预测:
<EOS>
生成结束。
整个过程可以表示成:
text
x1
 ↓
预测 x2
 ↓
x1 x2
 ↓
预测 x3
 ↓
x1 x2 x3
 ↓
预测 x4
 ↓
...
如果用数学形式表示,假设已经生成了:
x 1 , x 2 , ⋯ , x t x_1,x_2,\cdots,x_t x1,x2,⋯,xt
那么模型要预测的就是:
P ( x t + 1 ∣ x 1 , x 2 , ⋯ , x t ) P(x_{t+1}\mid x_1,x_2,\cdots,x_t) P(xt+1∣x1,x2,⋯,xt)
也就是说:
下一个 token 的概率,取决于之前已经出现的所有 token。
生成过程不断重复:
x t + 1 ∼ P ( x t + 1 ∣ x 1 , ⋯ , x t ) x_{t+1} \sim P(x_{t+1}\mid x_1,\cdots,x_t) xt+1∼P(xt+1∣x1,⋯,xt)
然后把新生成的 x t + 1 x_{t+1} xt+1 加入上下文,继续预测:
x t + 2 ∼ P ( x t + 2 ∣ x 1 , ⋯ , x t , x t + 1 ) x_{t+2} \sim P(x_{t+2}\mid x_1,\cdots,x_t,x_{t+1}) xt+2∼P(xt+2∣x1,⋯,xt,xt+1)
这就是自回归生成。
十七、训练语言模型时,模型到底在学习什么?
现在我们已经知道模型如何生成文本。
那么训练阶段到底在学什么?
最核心的目标其实非常简单:
根据前面的 token,预测下一个 token。
假设训练文本是:
text
我 喜欢 吃 苹果那么可以构造:
text
输入:
我

目标:
喜欢
然后:
text
输入:
我 喜欢

目标:
吃
再然后:
text
输入:
我 喜欢 吃

目标:
苹果
因此训练目标可以写成:
P ( x t ∣ x 1 , x 2 , ⋯ , x t − 1 ) P(x_t\mid x_1,x_2,\cdots,x_{t-1}) P(xt∣x1,x2,⋯,xt−1)
模型希望让正确答案的概率尽可能大。
通常会使用交叉熵损失。
对于一个位置:
L = − log P ( x t ∣ x 1 , ⋯ , x t − 1 ) L=-\log P(x_t\mid x_1,\cdots,x_{t-1}) L=−logP(xt∣x1,⋯,xt−1)
如果模型正确 token 的概率很高,那么损失就会比较小。
如果模型给正确 token 的概率非常低,那么损失就会变大。
所以训练过程中,模型不断调整自己的参数,使得:
在给定前文的情况下,正确的下一个 token 更容易获得较高概率。
当这种学习在大量文本上进行之后,模型就逐渐获得了语言建模能力。
十八、为什么 Causal Mask 对训练也非常重要?
现在可以重新理解 Causal Mask 的意义。
假设训练文本:
text
我 喜欢 吃 苹果我们希望模型学习:
text
我
 ↓
喜欢

我 喜欢
 ↓
吃

我 喜欢 吃
 ↓
苹果
如果没有 Mask,那么在预测"吃"的时候,模型可能直接看到"苹果"。
那么它学习到的就不是:
text
根据过去预测未来而变成:
text
根据完整答案预测答案这显然没有意义。
所以 Causal Mask 保证了训练过程遵守一个非常重要的规则:
预测当前位置时,只允许使用过去的信息。
因此:
text
Causal Mask
      ↓
阻止未来信息泄露
      ↓
保证训练目标正确
      ↓
模型学习"根据过去预测未来"
这也是为什么 GPT 类模型的核心通常会被称为:
Causal Language Modeling
也就是因果语言建模。
十九、现在重新理解 Decoder
到了这里,我们已经可以完整理解 Decoder 的作用。
原始 Transformer Decoder 中,可以把核心结构概括成:
text
输入已经生成的 token
        ↓
Masked Self-Attention
        ↓
Residual + LayerNorm
        ↓
Cross-Attention
        ↓
Residual + LayerNorm
        ↓
FFN
        ↓
Residual + LayerNorm
        ↓
输出
其中:
Masked Self-Attention
负责:
让当前 token 关注已经出现的 token,同时阻止未来信息进入。
Cross-Attention
负责:
让 Decoder 关注 Encoder 对输入序列提取出的信息。
FFN
负责:
对隐藏表示进行进一步的非线性变换。
Residual + LayerNorm
负责:
帮助信息传播并保持隐藏表示稳定。
这几个组件组合起来,就构成了完整的 Decoder Block。
二十、Encoder-Decoder Transformer 与 GPT 的区别
现在可以把两种结构放在一起看。
原始 Transformer:
text
输入
 ↓
Encoder
 ↓
Encoder Output
 ↓
Decoder
 ↓
输出
Decoder 中包含:
text
Masked Self-Attention
+
Cross-Attention
+
FFN
而 GPT 类模型:
text
输入
 ↓
Decoder-only Transformer
 ↓
输出下一个 token 的概率
其中主要使用:
text
Causal Self-Attention
+
FFN
+
Residual
+
LayerNorm
因为没有 Encoder,所以也不需要 Cross-Attention。
这就是为什么当我们后面讨论 GPT 时,经常会说:
GPT 是 Decoder-only Transformer。
理解这一点以后,前面几篇文章中的很多知识就真正串起来了。
二十一、从"Transformer Block"到"语言模型"
到这里,我们终于完成了一个非常重要的连接。
前面第六篇,我们学习的是:
text
Transformer Block它解决的是:
如何处理隐藏表示?
这一篇,我们进一步加入:
text
Causal Mask
Decoder
Autoregressive Generation
于是 Transformer 开始具备:
根据前文预测后文的能力。
整个过程可以概括成:
text
文本
 ↓
Tokenization
 ↓
Token Embedding
 ↓
Position Information
 ↓
Transformer Blocks
 ↓
Hidden Representation
 ↓
Linear
 ↓
Logits
 ↓
Softmax
 ↓
下一个 Token
 ↓
加入上下文
 ↓
再次计算
 ↓
继续生成
这已经非常接近我们今天所说的"大语言模型"的基本推理流程了。
当然,现代大语言模型还加入了很多更加复杂的技术,例如:
text
KV Cache
RoPE
RMSNorm
SwiGLU
FlashAttention
MoE
各种并行训练技术
这些内容会在后面的文章中逐渐展开。
二十二、这一篇真正需要记住什么?
如果只保留这一篇最重要的内容,可以记住下面几个核心概念。
第一,Decoder 的任务是根据已经出现的内容生成后续内容。
因此它不能像普通 Encoder 一样无条件看到完整序列。
第二,Masked Self-Attention 会阻止当前位置看到未来 token。
核心 Mask 可以表示为:
M i j = { 0 , j ≤ i − ∞ , j > i M_{ij}= \begin{cases} 0, & j\leq i\\ -\infty, & j>i \end{cases} Mij={0,−∞,j≤ij>i
然后:
Attention ( Q , K , V ) = softmax ( Q K T d k + M ) V \operatorname{Attention}(Q,K,V)= \operatorname{softmax} \left( \frac{QK^T}{\sqrt{d_k}}+M \right)V Attention(Q,K,V)=softmax(dk QKT+M)V
这样就可以保证未来位置的注意力权重为 0。
第三,自回归生成就是不断预测下一个 token。
数学上可以表示为:
P ( x t + 1 ∣ x 1 , ⋯ , x t ) P(x_{t+1}\mid x_1,\cdots,x_t) P(xt+1∣x1,⋯,xt)
模型根据已经出现的 token,预测下一个 token,然后把预测结果加入上下文。
第四,训练阶段和生成阶段的执行方式不同。
训练阶段可以利用 Causal Mask 一次并行计算多个位置。
生成阶段则因为未来 token 尚不存在,需要一个 token 一个 token 地向前生成。
第五,GPT 属于 Decoder-only Transformer。
它主要依靠:
text
Causal Self-Attention
+
FFN
+
Residual
+
LayerNorm
完成对上下文的建模和下一个 token 的预测。
二十三、下一篇:从 Transformer 到 GPT,大语言模型是怎么来的?
到这里,我们已经真正走到了 Transformer 和大语言模型之间的连接处。
前面的文章主要是在回答:
text
Transformer 是怎么工作的?而这一篇开始,我们已经回答了:
text
Transformer 是怎么生成文本的?但是还有一个更大的问题:
为什么一个原本用于序列建模的 Transformer,最后能够发展成今天的 GPT 和各种大语言模型?
我们已经知道 GPT 使用:
text
Decoder-only Transformer也知道它通过:
text
Next Token Prediction不断学习语言。
但仅仅知道这些还不够。
我们还需要继续回答:
text
为什么 GPT 只需要 Decoder?
为什么预测下一个 token 就能学到如此丰富的语言能力?
预训练到底在做什么?
为什么模型越大通常需要越多的数据和计算?
Transformer 是如何从一个架构,逐渐发展成今天的大语言模型的?
这些问题会把我们从:
text
Transformer真正带到:
text
GPT以及:
text
Large Language Model下一篇,我们就正式从 Transformer 走向 GPT。
第八篇:从 Transformer 到 GPT------大语言模型是怎么来的?