💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询
💕💕Java项目
💕💕微信小程序项目
💕💕Android项目
💕💕Python项目
💕💕PHP项目
💕💕ASP.NET项目
💕💕Node.js项目
💕💕大数据项目
💕💕选题推荐
基于大数据的北京市招标公告数据分析与可视化
文章目录
1、研究背景
随着北京市公共资源交易规模的持续扩大,招标公告数据呈现出爆发式增长态势。海量数据涵盖品目大类、采购方式、预算金额、开标区划等多元维度,传统的数据处理方式难以应对如此庞大且复杂的结构与非结构化信息。大数据技术(如Hadoop和Spark)的成熟,为解决这一问题提供了基础支撑。利用Python进行数据清洗与预处理,结合MySQL进行数据存储与管理,引入数据挖掘与机器学习算法(如K-Means聚类),能够深入挖掘隐藏在公告背后的规律。通过Vue和Echarts构建可视化前端,可将复杂的数据转化为直观的图表。在此背景下,开发一套基于大数据的北京市招标公告数据分析与可视化系统,成为提升招投标行业数据透明度与监管效率的迫切需求,旨在打破信息孤岛,实现数据驱动的科学决策。
2、研究目的和意义
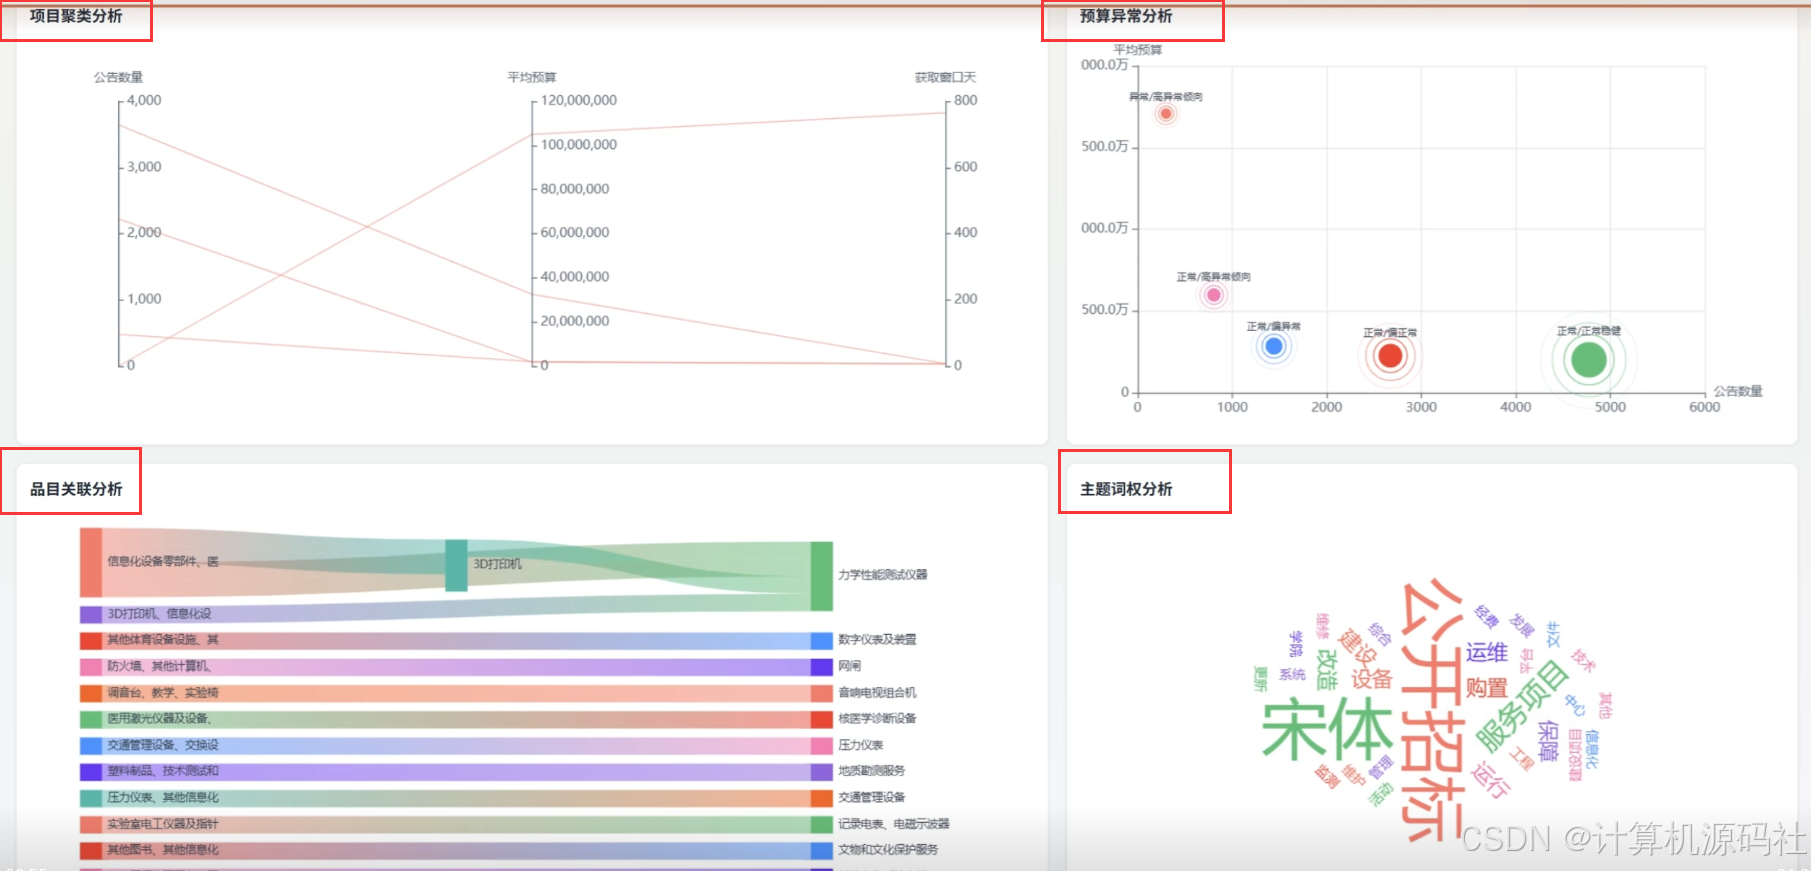
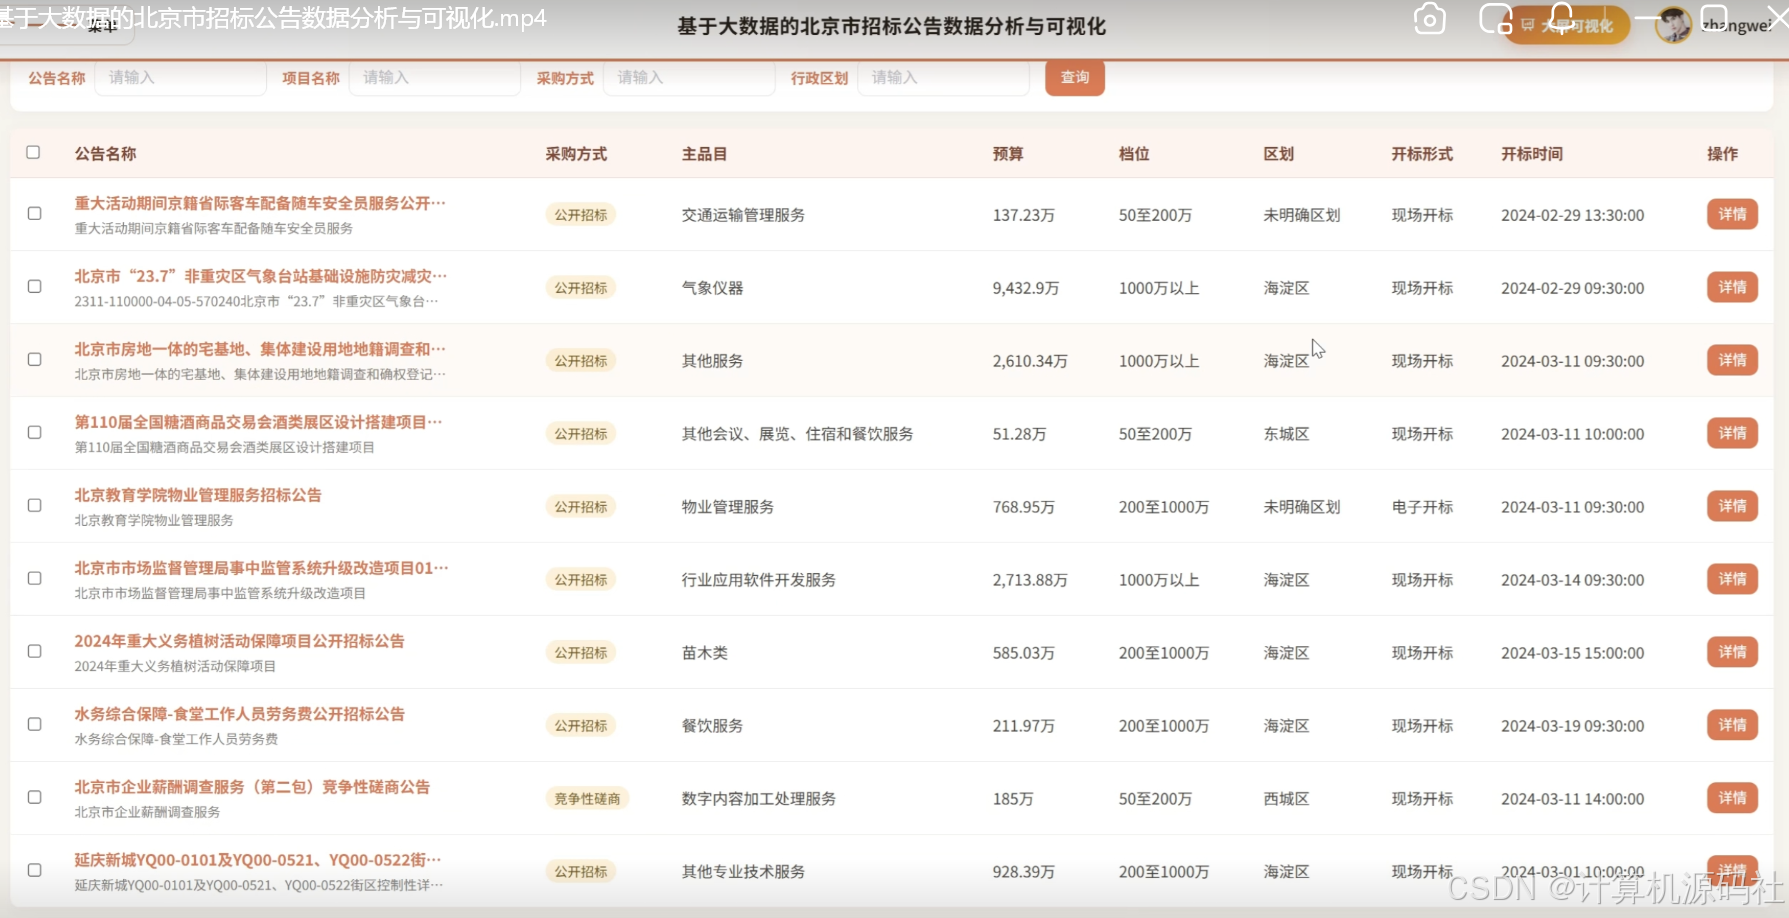
本系统旨在对北京市海量招标公告进行全面、多维度的深度解析与可视化呈现。系统致力于将繁杂的数据转化为直观的图表,如品目分布分析、品目方式分析、获取窗口分析以及开标间隔分析等,帮助管理人员快速掌握市场动态。通过集成大数据与机器学习技术,系统能运用K-Means算法进行项目聚类分析和预算异常分析,精准识别正常稳健、偏高及偏低的异常项目,提升资金监管的精准度。系统还针对开标区位、热门场所、方式预算、品目关联网络以及主题词权进行深度挖掘,并通过表格界面展示公告名称、预算、档位、开标时间等明细数据。其核心目的是辅助监管部门与采购单位透视招投标全貌,发现流程中的痛点与风险点,为优化采购流程、合理配置预算资金以及制定宏观政策提供有力的数据支撑与决策依据。
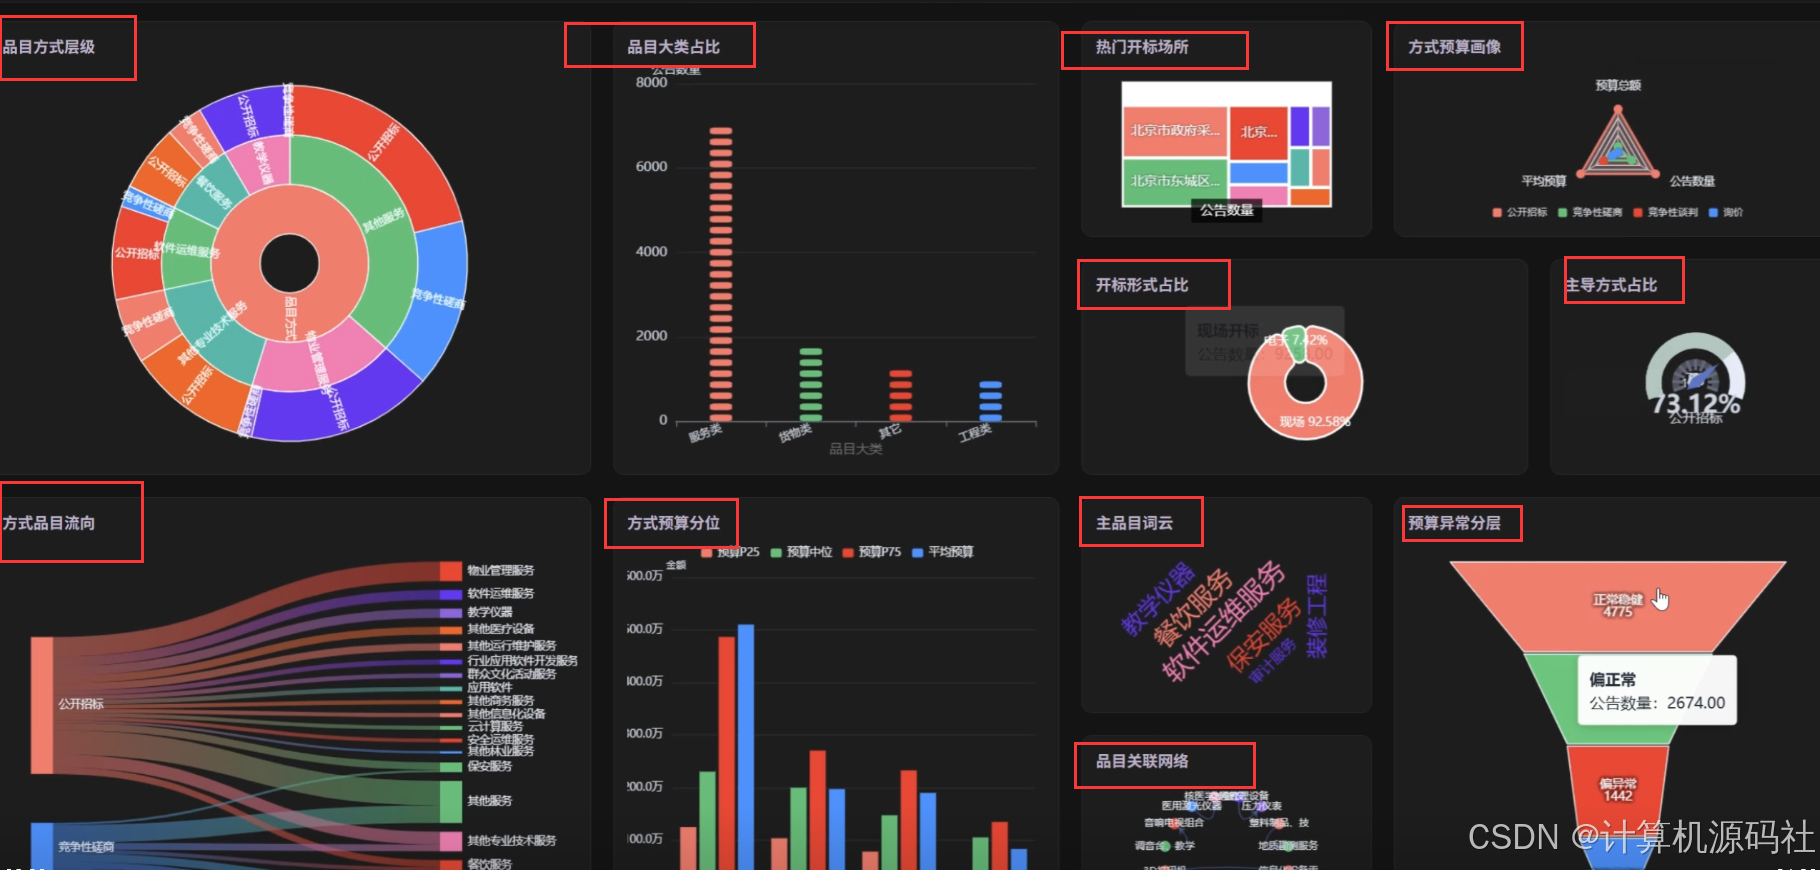
开发本系统对于推动北京市招标采购领域的数字化转型具有深远意义。通过Hadoop与Spark强大的计算能力结合Echarts生动的视觉效果,系统打破了传统数据统计的局限性,将招标方式品目流向、季度演变分析以及周内开标分析等复杂业务逻辑清晰地展现出来。运用K-Means等机器学习算法对预算异常进行分层预警,能够有效防范招投标过程中的暗箱操作与资金浪费,提升监管的透明度与公平性。多维度的品目大类占比、方式数量与方式售价分析,有助于洞察市场供需关系与价格走势。系统整合了公告明细查询与多维分析功能,降低了数据获取与理解门槛。这对于提高政府行政效能、激发市场活力、促进公共资源交易阳光化运行具有重要的现实意义,也为大数据技术在政务招投标领域的落地提供了示范价值。
3、系统研究内容
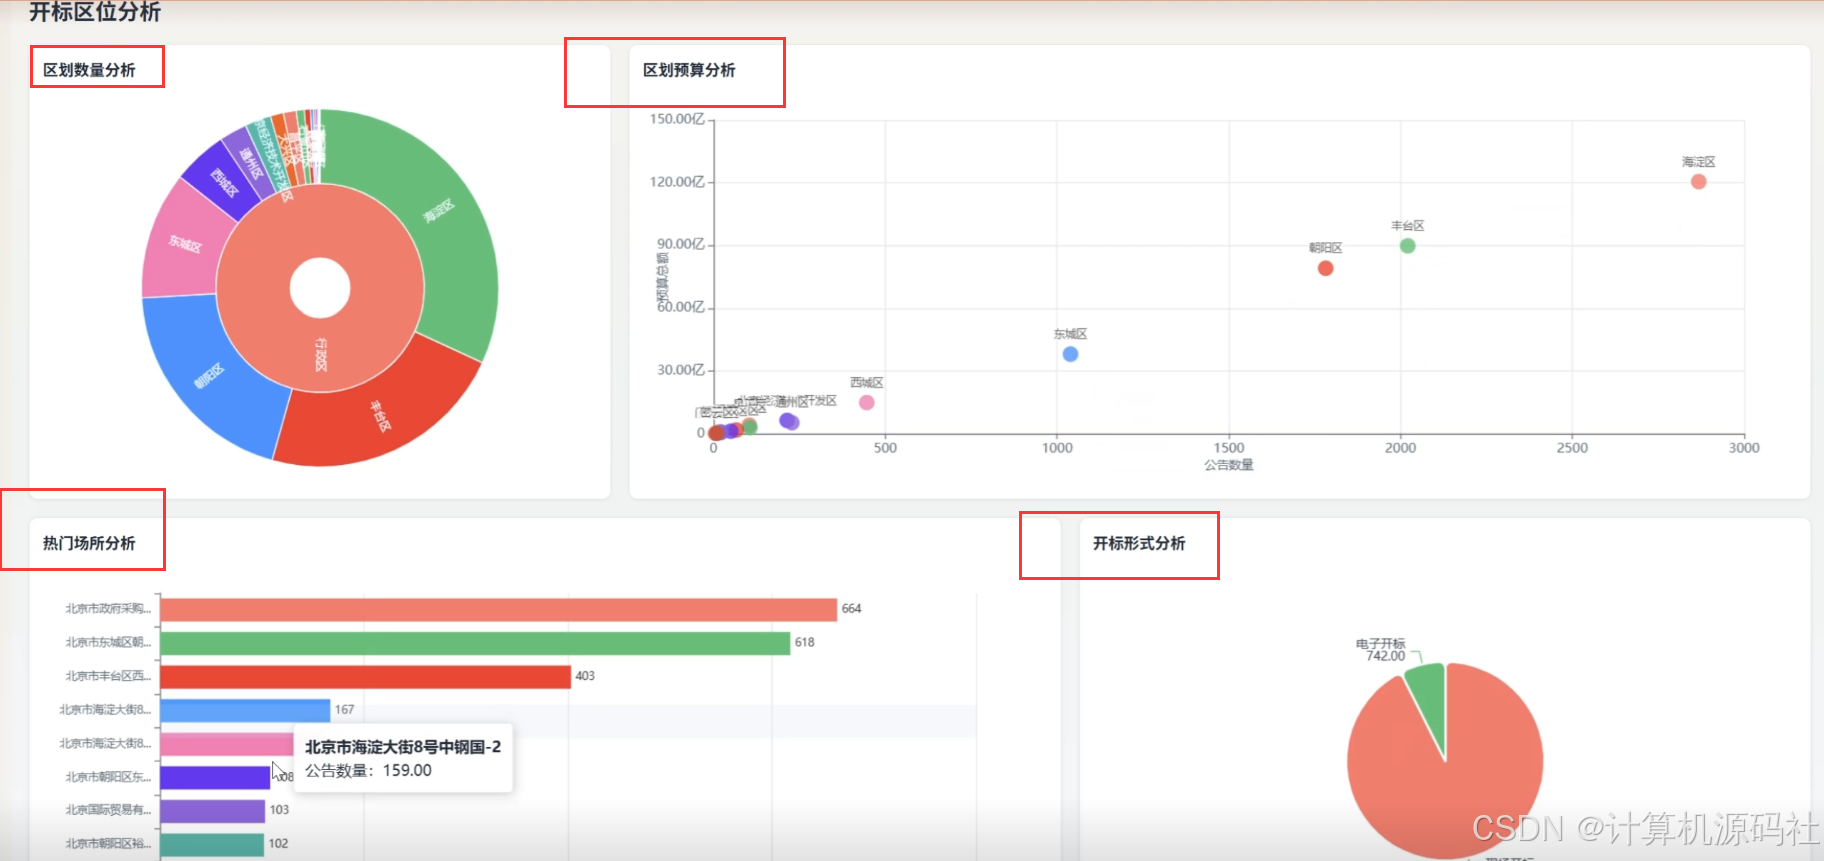
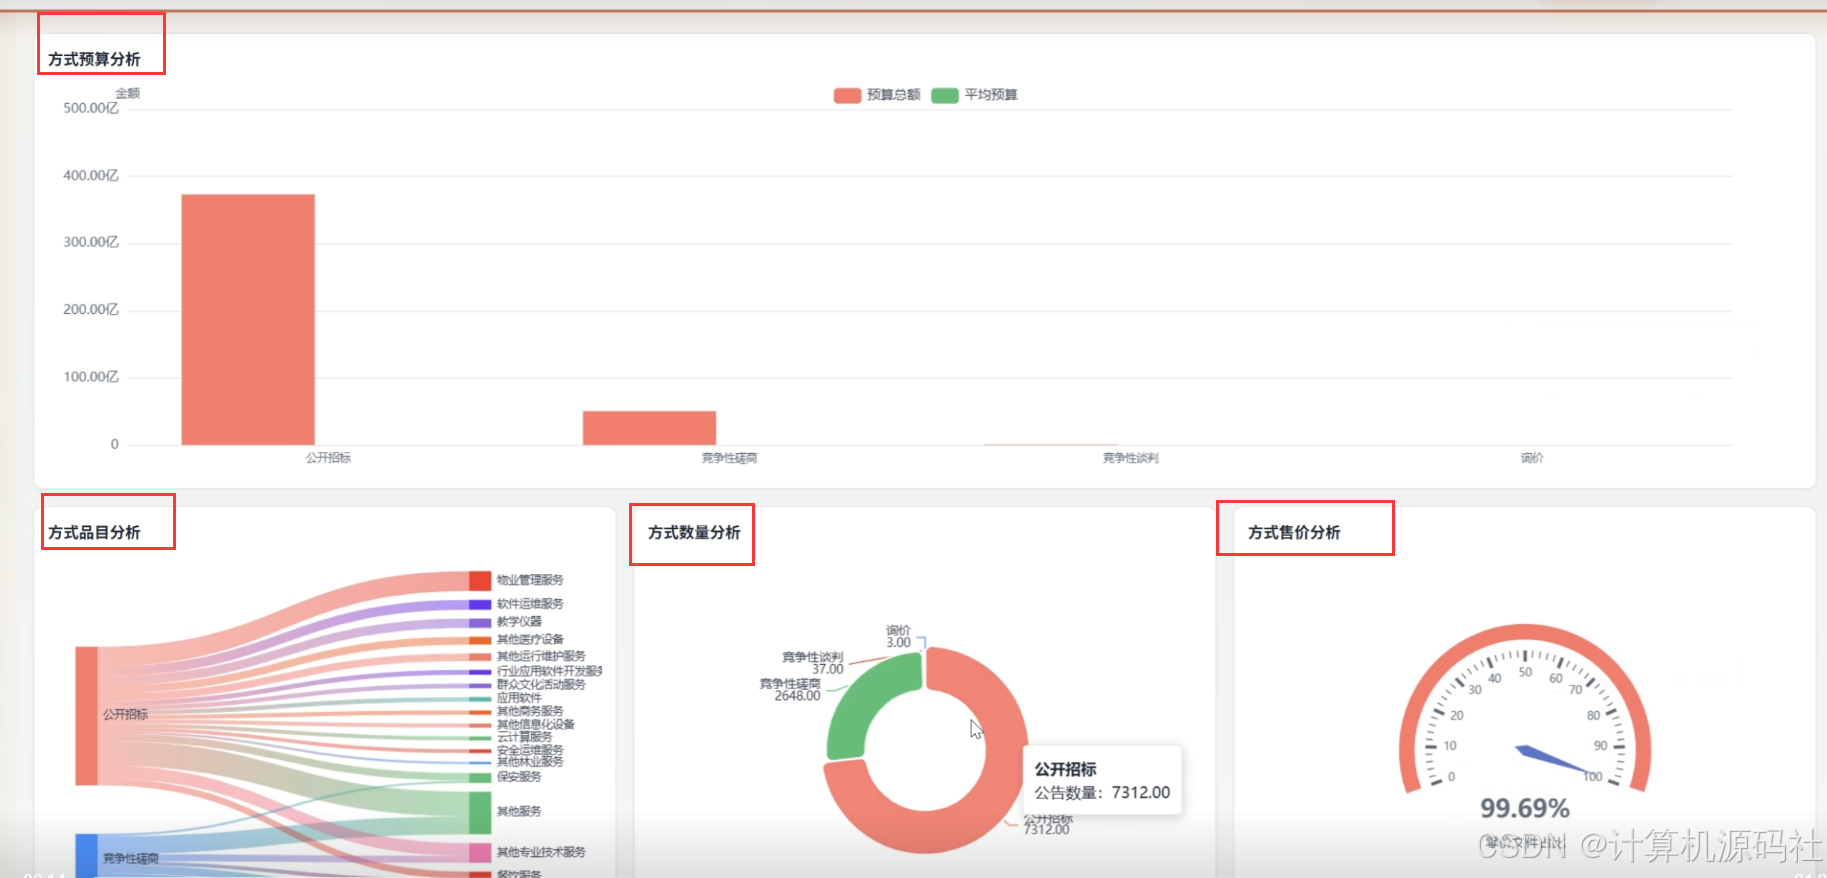
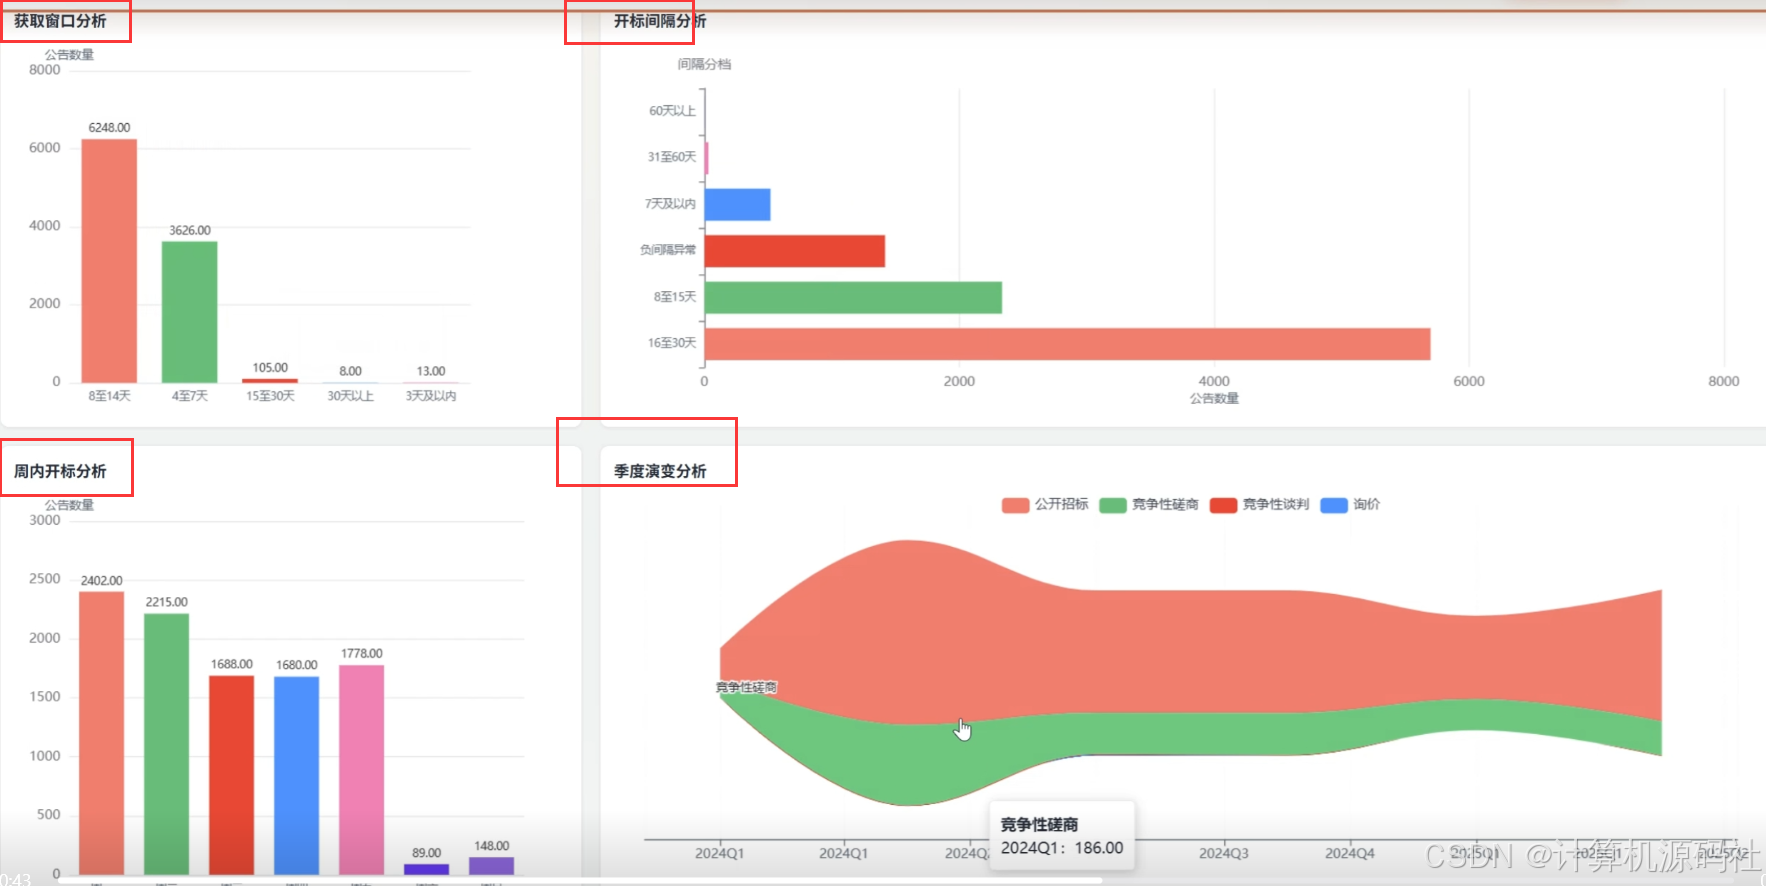
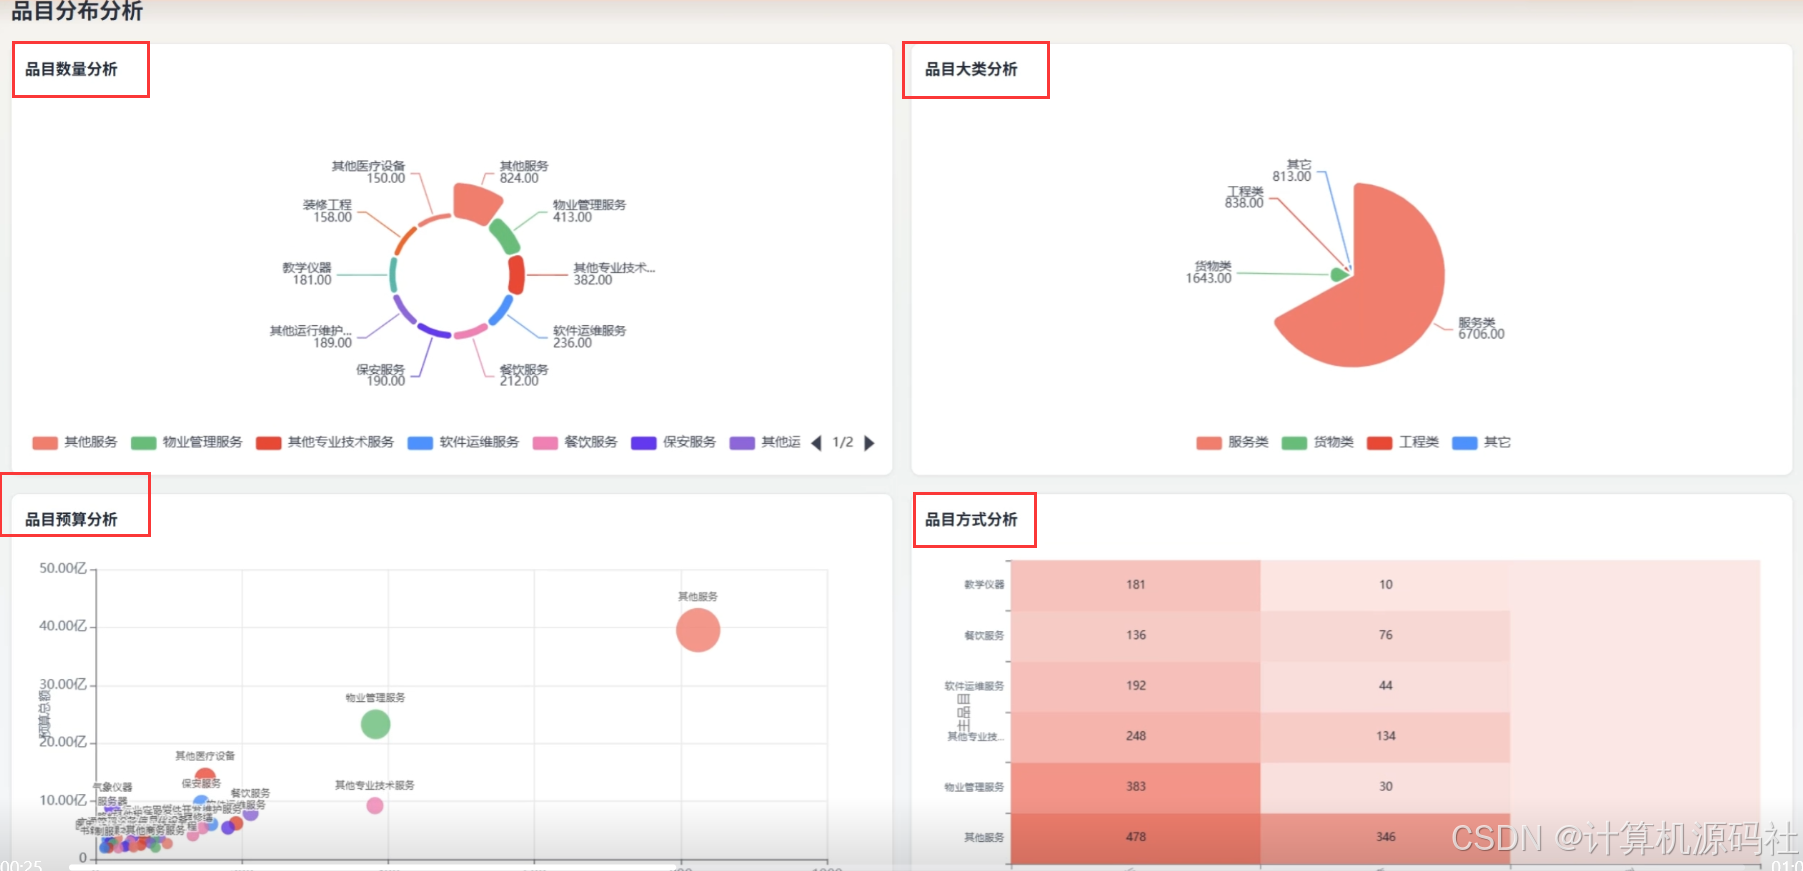
系统开发内容围绕数据采集、清洗、挖掘到可视化的全流程展开,采用Python、大数据(Hadoop、Spark)、MySQL、Vue、Echarts及机器学习等技术栈构建。后端利用Spark对北京市招标公告原始数据进行高效清洗与分布式计算,MySQL负责存储结构化业务数据。核心功能模块涵盖品目分布分析、品目预算分析、品目方式分析及品目关联网络,通过桑基图、气泡图、热力图等形式展现数据间深层联系。时间维度上设有获取窗口分析、开标间隔分析、周内开标分析及季度演变分析,探究招投标周期规律。预算与异常层面,利用K-Means算法实现项目聚类分析、预算异常分层及方式预算分位,揭示资金分布与异常状况。区划层面提供区划数量分析、区划预算分析及热门场所分析。系统前端基于Vue构建交互界面,利用Echarts生成品目词云、方式数量环形图、方式售价仪表盘等丰富图表,并提供详细的公告数据表格与搜索查询功能,实现多维数据的全方位可视化呈现。
4、系统页面设计
如需要源码,可以扫取文章下方二维码联系咨询
5、参考文献
1李真. 信息化视角下项目部用车社会化租赁招标研究J.铁路采购与物流,2026,21(6):108-110.DOI:10.20123/j.cnki.1673-7121.2026.06.030.
2付颖. 基于大数据分析的招标代理风险预警系统构建J.大陆桥视野,2026,(6):37-39.
3麻海杰.企业级招标采购平台的数据治理与智能化决策支持系统构建C//广西网络安全和信息化联合会.2026年第十三届工程领域数字化转型与新质生产力发展研究学术交流会论文集.2026:486-488.DOI:10.26914/c.cnkihy.2026.030671.
4王宇婷.基于BIM技术的工程项目电子招投标平台应用研究C//河北省绿色低碳循环发展协会.2026年第一届工程技术与绿色低碳发展论坛论文集.2026:211-213.DOI:10.26914/c.cnkihy.2026.018141.
5杨明.大数据在交通工程造价分析中的应用探讨C//江西省汽车工程学会.工程技术创新发展学术研讨会论文集(第一册).2026:1493-1496.DOI:10.26914/c.cnkihy.2026.011614.
6李冉. 信息化驱动下招标行业财务共享平台的应用J.商业2.0,2026,(4):103-105.
7谢津.大数据技术辅助交通设备采购招标风险评估研究C//河北省绿色低碳循环发展协会.2025年工程技术与建设管理创新发展交流会论文集(二).2025:296-300.DOI:10.26914/c.cnkihy.2025.111825.
8邓俊轩.多源异构招标数据整合与可视化决策支持系统开发C//广西网络安全和信息化联合会.2025年第八届工程领域数字化转型与新质生产力发展研究学术交流会论文集.2025:5-7.DOI:10.26914/c.cnkihy.2025.087454.
9张力立. 浅析数智化赋能全过程工程咨询招标采购管理模式转型J.中国房地产业,2025,(29):102-105.
10毛国育,缪昊轩,梁壹. 基于数据驱动的智能需求管理探索与实践------以四川轻化工大学"1257"数字赋能为例J.中国政府采购,2025,(7):25-28.
11张瑞. 运用数字化技术大幅提高发电企业招投标的效率和透明度J.中国商界,2025,(13):120-121.
12赵堃. 基于大数据的招标市场行为分析与招标竞争策略J.中国招标,2025,(7):95-97.
13侯蓉,陆洋,李庚徽. 招标大数据图谱应用分析研究J.招标采购管理,2025,(5):27-30.
14崔晓琴.大数据技术在炼化企业采购内部审计的应用研究------以S企业为例D.中央财经大学,2025.
15汪维东. 基于大数据的建筑招投标文件管理系统设计研究J.中国新技术新产品,2025,(9):128-131.DOI:10.13612/j.cnki.cntp.2025.09.032.
16张红梅. 招投标数字化趋势下的数据隐忧与破解之策J.招标采购管理,2025,(4):46-47.
17王大庆,贾鹏,陈子凡,等.大数据背景下的企业招标采购数字化管理分析与实践C//中国石油学会石油物探专业委员会.第三届中国石油物探学术年会论文集(四).2025:1633-1635.DOI:10.26914/c.cnkihy.2025.002618.
18韩夫霞. 基于大数据的工程造价招标精准定价研究J.中国招标,2025,(4):107-109.
19韩雪琦. 大数据在电力企业招标采购管理中的应用研究J.中国招标,2025,(3):132-134.
20严锋. 基于"BIM+大数据"的企业招标采购管理研究J.中国招标,2025,(3):195-198.
6、核心代码
java
 def process_anomaly_detection(self, k=3):
        """
        利用K-Means对预算金额进行聚类,识别预算异常项
        """
        # 1. 数据预处理:选择预算金额和品目数量作为特征(模拟多维特征)
        # 假设数据集中存在 budget(预算金额)和 quantity(数量)字段
        feature_cols = ["budget", "quantity"]
        assembler = VectorAssembler(inputCols=feature_cols, outputCol="features")
        vector_df = assembler.transform(self.df)

        # 2. 初始化K-Means模型,k=3对应正常、偏高异常、偏低异常
        kmeans = KMeans(k=k, seed=1, featuresCol="features", predictionCol="cluster")
        model = kmeans.fit(vector_df)

        # 3. 预测聚类结果
        predictions = model.transform(vector_df)

        # 4. 获取聚类中心,计算每个簇的平均预算,用于打上业务标签
        centers = model.clusterCenters()
        cluster_budget_map = {}
        for idx, center in enumerate(centers):
            # 假设特征向量的第一个元素是预算金额
            cluster_budget_map[idx] = center[0]

        # 根据预算中心值排序,区分高、中、低预算
        sorted_clusters = sorted(cluster_budget_map.items(), key=lambda item: item[1])
        low_cluster_id = sorted_clusters[0][0]      # 偏低异常
        normal_cluster_id = sorted_clusters[1][0]   # 正常稳健
        high_cluster_id = sorted_clusters[2][0]     # 偏高异常

        # 5. 将聚类ID映射为业务标签(为前端Echarts散点图提供分类依据)
        from pyspark.sql.functions import udf
        from pyspark.sql.types import StringType

        def map_anomaly_label(cluster_id):
            if cluster_id == low_cluster_id:
                return "偏低异常"
            elif cluster_id == normal_cluster_id:
                return "正常稳健"
            else:
                return "偏高异常"

        label_udf = udf(map_anomaly_label, StringType())
        result_df = predictions.withColumn("anomaly_label", label_udf(col("cluster")))

        # 6. 输出结果供前端调用(包含公告名称、预算、异常标签等)
        return result_df.select("announcement_name", "budget", "quantity", "anomaly_label")

# ==============================================================================
# 核心模块二:品目关联分析(基于FP-Growth关联规则挖掘)
# 对应可视化模块:品目关联网络、品目关联分析(桑基图或力导向图展示)
# ==============================================================================
class CategoryAssociationAnalyzer:
    def __init__(self, data_path):
        # 读取历史招标公告数据
        self.df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/bidding_db") \
            .option("dbtable", "bidding_items").option("user", "root").option("password", "password").load()

    def process_association_rules(self, min_support=0.01, min_confidence=0.1):
        """
        利用FP-Growth算法挖掘不同品目之间的关联关系
        """
        # 1. 数据转换:将同一项目下的多个品目聚合为列表(购物篮格式)
        # 假设数据包含 project_id 和 category_name(品目名称)
        basket_df = self.df.groupBy("project_id") \
            .agg(collect_list("category_name").alias("items")) \
            .filter(count("items") > 1)  # 过滤掉只包含单一品目的项目

        # 2. 初始化FP-Growth模型
        fp_growth = FPGrowth(itemsCol="items", minSupport=min_support, minConfidence=min_confidence)

        # 3. 训练模型
        model = fp_growth.fit(basket_df)

        # 4. 获取频繁项集(用于绘制品目关联网络中的节点权重)
        freq_itemsets = model.freqItemsets
        # 按频次降序排列,提取前20个用于可视化
        top_freq_items = freq_itemsets.orderBy(col("freq").desc()).limit(20)

        # 5. 获取关联规则(用于绘制品目关联网络中的边及流向)
        association_rules = model.associationRules
        # 按置信度降序排列
        top_rules = association_rules.orderBy(col("confidence").desc()).limit(50)

        # 6. 返回关联规则数据供前端Echarts绘制桑基图或关系图
        # 包含前件、后件、置信度等字段
return top_rules.select("antecedent", "consequent", "confidence", "lift")💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询