NumPy.random.Algebra 随机代数实战指南
一份实用指南,把 numpy.random 模拟与向量代数、随机矩阵、线性系统、投影、二次型和 Monte Carlo 结合起来。
- 明确区分 numpy.random 的数据生成与 NumPy 数组代数的变换分析。
- 构建可复现的随机向量、矩阵、方程组、投影和二次型。
- 用残差、秩、特征值和条件性验证随机代数实验。
- 把代数期望与模拟估计和收敛诊断联系起来。
示例均为独立代码片段,可复制到 Python 3 环境中运行。
1. 范围、随机状态与代数数据
NumPy 并不存在单独名为 numpy.random.Algebra 的模块。本指南使用 numpy.random 生成随机数值数据,并使用 NumPy 数组操作,尤其是 numpy.linalg,对这些数据进行代数运算。这个区分很重要:随机性定义实验,代数定义变换、约束或被研究的统计量。
|--------|-----------------|---------------------------------|
| 层次 | 职责 | 典型表达式 |
| 随机生成 | 创建向量、矩阵、噪声或样本 | rng.normal(...)、rng.choice(...) |
| 数组形状 | 定义标量、向量、矩阵或批次含义 | x.shape、A.shape |
| 代数 | 变换或组合数据 | A @ x、x + v |
| 线性代数 | 求解、分解、投影和分析 | np.linalg.solve、svd |
| 统计 | 汇总随机结果 | mean、variance、residua |
import numpy as np
rng = np.random.default_rng(2026)
vector = rng.normal(size=4)
matrix = rng.normal(size=(3, 4))
noise = rng.normal(scale=0.1, size=3)
result = matrix @ vector + noise
print(vector.shape, matrix.shape, result.shape)
可复现的随机代数
- 使用 default_rng 创建局部 Generator,并记录种子。
- 记录维度、分布参数和随机调用顺序。
- 把随机数据生成与确定性代数分开,使每个阶段都可以测试。
- 对形状、有限值、预期秩和代数不变量使用断言。
2. 随机向量、线性组合与几何
随机向量可以表示带噪测量、系数向量、方向或模拟状态。线性组合用标量权重组合多个向量。点积是加权和,也是衡量方向一致性的几何量;范数衡量大小;投影提取沿指定方向的分量。
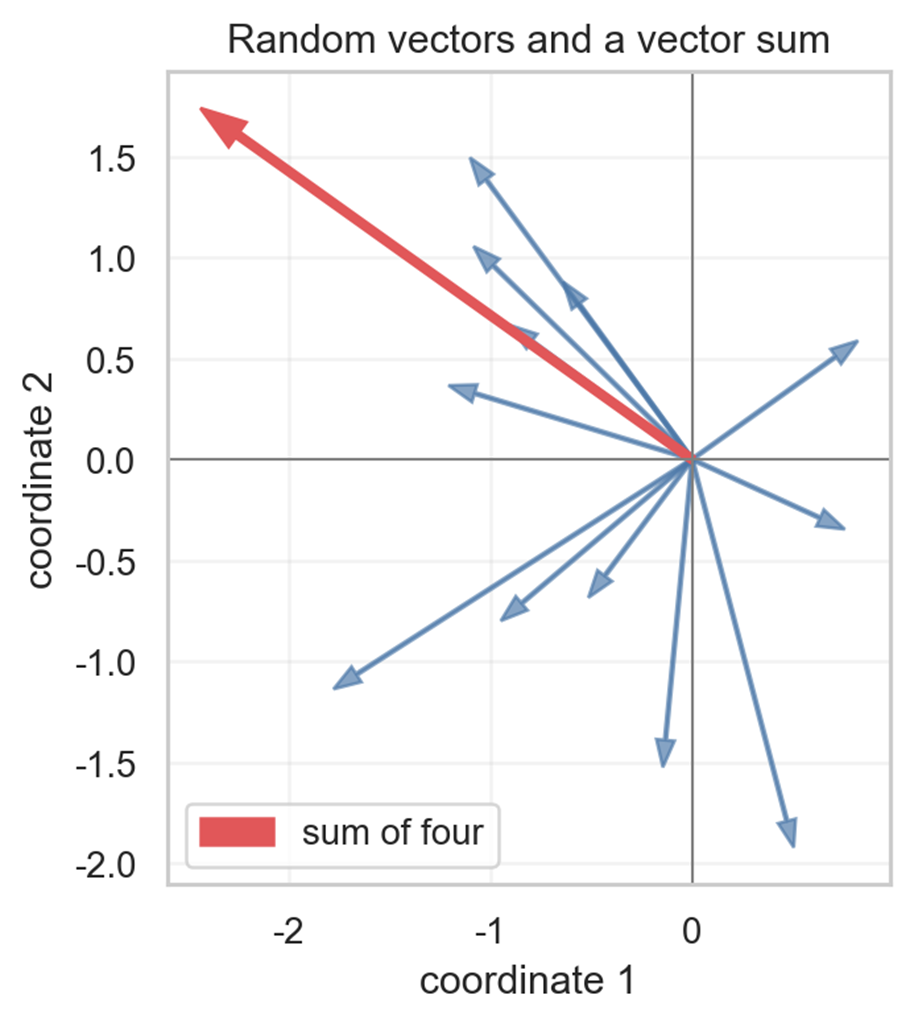
图 1:随机向量可以组合,投影也可以通过代数计算。
rng = np.random.default_rng(2026)
u = rng.normal(size=3)
v = rng.normal(size=3)
weights = rng.normal(size=3)
linear_combination = weights0 * u + weights1 * v
projection = (v @ u) / (u @ u) * u
orthogonal_residual = v - projection
print(u @ v, np.linalg.norm(v))
print(np.allclose(orthogonal_residual @ u, 0.0))
|--------|----------------------------|-----------|
| 操作 | 表达式 | 解释 |
| 线性组合 | Σ cᵢvᵢ | 张成空间中的点 |
| 点积 | u @ v | 方向一致性和加权和 |
| 范数 | np.linalg.norm(v) | 向量大小 |
| 投影 | (v·u)/(u·u) u | 沿 u 的分量 |
| 正交残差 | v − projection | 垂直于 u 的分量 |
| 余弦相似度 | (u·v)/(||u||||v||) | 无尺度方向一致性 |
形状选择
shape 为 (n,) 的向量参与一维向量运算,shape 为 (n, 1) 的列向量参与二维矩阵乘法。批量采样多个向量时,应一致使用 (batch, dimension),并沿维度轴进行归约。
3. 随机矩阵与线性变换
随机矩阵定义了一个随机线性变换。它可能拉伸、旋转、剪切、反射或压缩某些方向。把同一个矩阵应用于点集,可以观察几何如何变化;二维中行列式的绝对值与面积缩放有关,奇异值则描述不同方向上的拉伸。
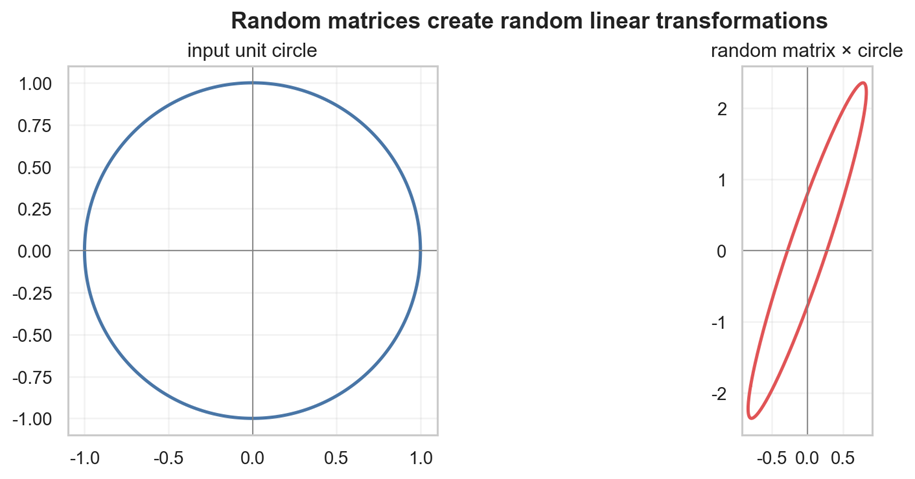
图 2:随机 2×2 矩阵把单位圆映射为新的曲线。
rng = np.random.default_rng(2026)
A = rng.normal(size=(2, 2))
points = rng.normal(size=(1000, 2))
transformed = points @ A.T
area_scale = np.linalg.det(A)
condition = np.linalg.cond(A)
print(A)
print("determinant:", area_scale)
print("condition:", condition)
|----------|--------------------------|------------|
| 矩阵性质 | 表达式 | 随机代数含义 |
| 行列式 | np.linalg.det(A) | 有符号面积/体积缩放 |
| 转置 | A.T | 交换矩阵轴 |
| 秩 | np.linalg.matrix_rank(A) | 独立输出方向数 |
| 范数 | np.linalg.norm(A) | 大小或最大放大程度 |
| 条件数 | np.linalg.cond(A) | 对扰动的敏感性 |
| 对称部分 | (A + A.T)/2 | 适合二次型 |
随机矩阵设计
- 只有在模型确实如此时才独立生成每个元素;很多问题需要协方差结构。
- 缩放元素以控制典型范数、奇异值或谱半径。
- 需要对称随机矩阵时使用 (A + A.T)/2。
- 把随机矩阵用于求解器或类似求逆操作前,检查秩和条件性。
4. 随机线性系统与最小二乘
随机线性系统可用于测试求解器、估计敏感性以及模拟带噪测量。对于方阵系统 Ax=b,矩阵非奇异时 solve 可以得到精确解。对于超定系统,lstsq 寻找使平方残差最小的系数向量。
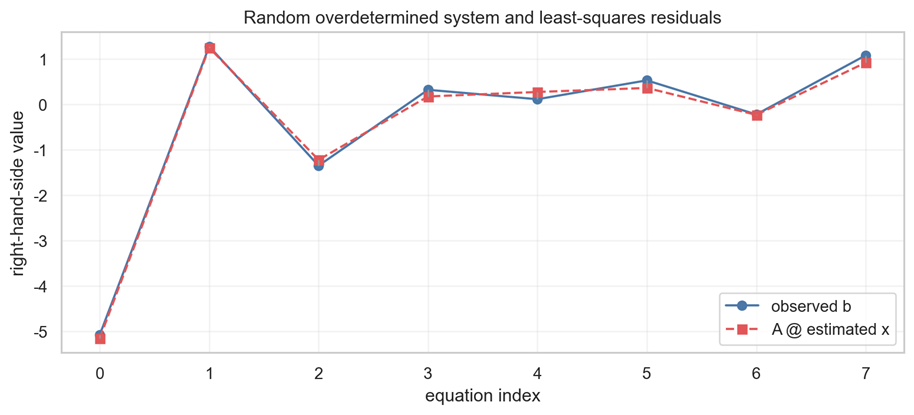
图 3:随机超定系统产生观测和拟合的右端项值。
rng = np.random.default_rng(2026)
A = rng.normal(size=(20, 5))
true_x = rng.normal(size=5)
b = A @ true_x + rng.normal(scale=0.05, size=20)
estimate, residuals, rank, singular_values = np.linalg.lstsq(A, b, rcond=None)
residual = A @ estimate - b
relative_error = np.linalg.norm(residual) / np.linalg.norm(b)
print(np.linalg.norm(estimate - true_x))
print(relative_error, rank, singular_values)
|--------|-----------------|-----------|
| 场景 | 方法 | 验证 |
| 精确方阵系统 | np.linalg.solve | 相对残差 |
| 带噪超定数据 | np.linalg.lstsq | 残差范数和系数误差 |
| 秩亏数据 | lstsq 或 pinv | 秩和奇异值截断 |
| 多个右端项 | solve(A, B) | 对每一列检查残差 |
| 重复随机测试 | 生成矩阵族 | 汇总成功率和误差率 |
测试设计
测试数值行为时,应生成具有可控条件数的系统。把真实系数向量与测量噪声分开,这样才能分别解释系数误差、预测误差和残差误差。
方阵系统和残差检查
A = rng.normal(size=(5, 5))
while np.linalg.matrix_rank(A) < 5:
A = rng.normal(size=(5, 5))
x_true = rng.normal(size=5)
b = A @ x_true
x_estimated = np.linalg.solve(A, b)
assert np.allclose(x_estimated, x_true)
5. 随机投影与降维
随机投影使用随机矩阵把高维向量映射到低维空间。在合适的缩放和维度下,对于有限数据集,点对之间的距离通常可以近似保持。这种方法适合数据草图、近似搜索、可视化和降低计算成本,但不能保证所有方向都精确保持。
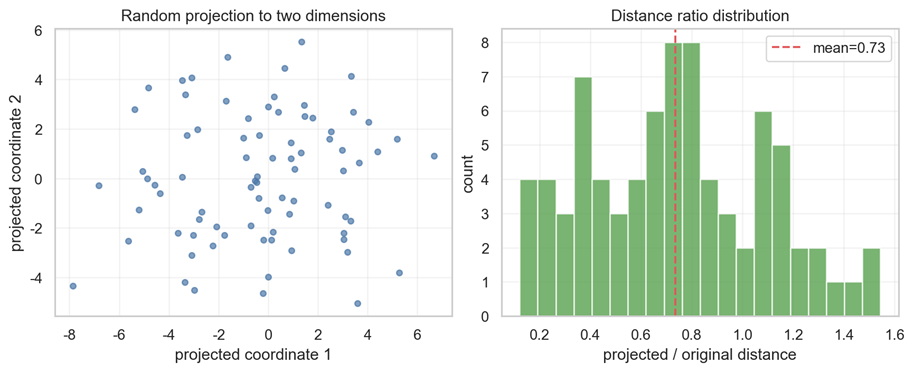
图 4:随机投影创建二维视图,并展示距离比值的分布。
rng = np.random.default_rng(2026)
X = rng.normal(size=(500, 100))
projection = rng.normal(size=(100, 12)) / np.sqrt(12)
X_reduced = X @ projection
original_distances = np.linalg.norm(X1: - X0, axis=1)
reduced_distances = np.linalg.norm(X_reduced1: - X_reduced0, axis=1)
ratios = reduced_distances / original_distances
print(X.shape, X_reduced.shape)
print(ratios.mean(), ratios.std())
|--------|----------|--------------|
| 选择 | 影响 | 问题 |
| 投影维度 | 控制压缩程度 | 近似误差是否可接受? |
| 元素分布 | 控制几何和集中性 | 缩放是否合适? |
| 归一化 | 控制期望距离尺度 | 是否希望平均保持范数? |
| 随机种子 | 控制一个具体嵌入 | 能否复现该嵌入? |
| 距离指标 | 定义保持目标 | 欧氏、余弦还是其他指标? |
投影验证
- 在代表性数据上测量距离比值,不要默认保持性一定成立。
- 下游行为依赖嵌入时,应使用多个随机种子重复。
- 可能时与确定性基线比较投影表示。
- 即使距离看起来可接受,低维化仍可能删除重要信号。
6. 二次型、随机特征值与 Monte Carlo 代数
二次型 xᵀAx 出现在能量、距离、不确定性、优化和概率中。如果 A 对称半正定,二次型非负。随机抽样可以估计它的期望,并通过特征值探索几何结构。对于标准正态向量 x,在合适维度下 ExᵀAx = trace(A)。
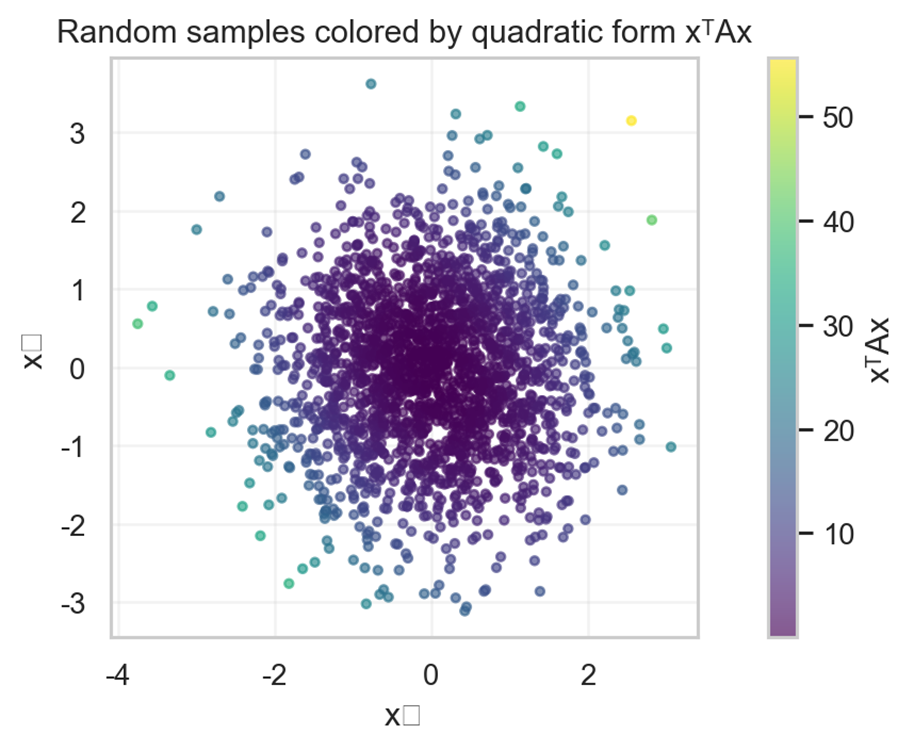
图 5:随机点根据二次型 xᵀAx 着色。
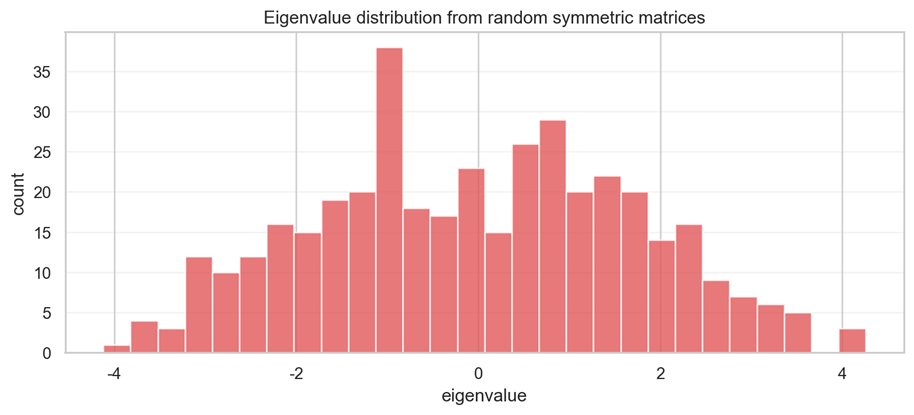
图 6:通过重复生成研究随机对称矩阵的特征值分布。
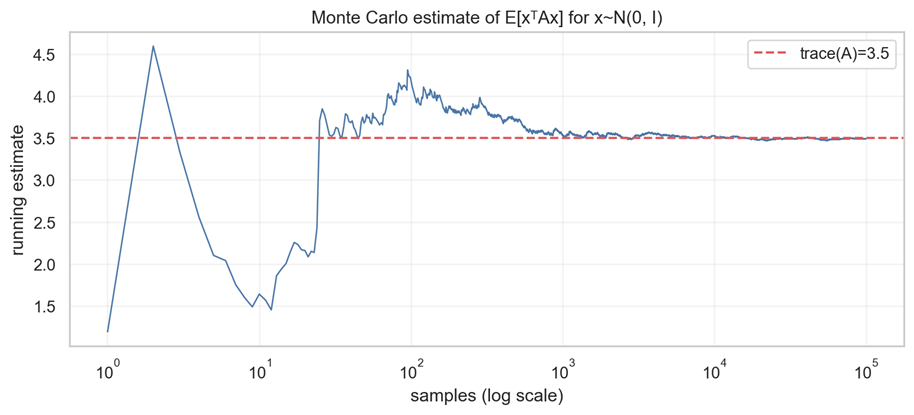
图 7:x~N(0,I) 时,Monte Carlo 估计 ExᵀAx 趋近 trace(A)。
rng = np.random.default_rng(2026)
A = np.array(\[2.0, 0.4, 0.4, 1.5])
X = rng.normal(size=(100_000, 2))
quadratic_values = np.einsum("bi,ij,bj->b", X, A, X)
estimate = quadratic_values.mean()
theory = np.trace(A)
print(estimate, theory)
随机对称矩阵和特征值
M = rng.normal(size=(6, 6))
S = (M + M.T) / 2
values = np.linalg.eigvalsh(S)
print(values)
|----------------|------------------------------------|------------|
| 代数量 | NumPy 模式 | 解释 |
| 二次型 | np.einsum('bi,ij,bj->b', X, A, X) | 每个随机向量一个标量 |
| 迹 | np.trace(A) | 对角线/特征值之和 |
| 特征值 | np.linalg.eigvalsh(S) | 主缩放方向 |
| 半正定检查 | eigvals >= -tol | 二次能量非负 |
| Monte Carlo 估计 | values.mean() | 模拟近似 |
7. 可复现随机代数检查表
随机代数实验应被设计为数值测试。定义输入分布、代数操作、预期不变量或理论值、误差指标和容差。然后在多个种子或受控矩阵族上重复,以区分偶然成功和稳定行为。
|---------|----------------|----------------------|
| 检查项 | 问题 | 行动 |
| 随机状态 | 输入能否重新生成? | 使用 default_rng 并记录种子 |
| 形状 | 批次、向量和矩阵含义清楚吗? | 断言准确形状 |
| 有限值 | 输入输出是否有限? | 使用 np.isfinite |
| 秩 | 约束是否可识别? | 检查 matrix_rank 和奇异值 |
| 残差 | 代数结果是否满足方程? | 计算绝对和相对残差 |
| 条件性 | 噪声是否可能被放大? | 检查 cond 并缩放变量 |
| 理论 | 是否有已知期望或不变量? | 将模拟与理论比较 |
| 重复 | 多个种子下是否稳定? | 运行受控种子集合 |
可复现随机代数测试摘要
rng = np.random.default_rng(2026)
A = rng.normal(size=(12, 4))
x_true = rng.normal(size=4)
b = A @ x_true
x_est, residuals, rank, singular_values = np.linalg.lstsq(A, b, rcond=None)
report = {
"seed": 2026,
"A_shape": A.shape,
"rank": int(rank),
"condition": float(np.linalg.cond(A)),
"relative_residual": float(np.linalg.norm(A @ x_est - b) / np.linalg.norm(b)),
"coefficient_error": float(np.linalg.norm(x_est - x_true)),
}
print(report)
随机代数最终检查表
- numpy.random 只负责明确的随机生成,确定性变换使用 NumPy 数组代数。
- 明确维度、单位、分布和种子策略。
- 使用 solve 或 lstsq,避免不必要的显式求逆。
- 检查秩、奇异值、条件数、残差和已知理论期望。
- 重要实验应跨种子重复,并报告平均行为和变异程度。