Agent 智能体开发(二)Agent 经典架构范式构建
- Hello-Agents GitHub: https://github.com/datawhalechina/Hello-Agents
- Hello-Agents Online: https://hello-agents.datawhale.cc
为了更好地约束和组织智能体的"思考"与"行动"过程,实现智能体循环的核心运行机制,业界涌现出了多种经典的智能体架构范式,其中最具代表性的三种范式分别为:
- ReAct (Reasoning and Acting): 将"思考"和"行动"紧密结合的范式,目标是在事中边推理边行动。该范式形成了思考指导行动、行动结果引导思考方向的循环,使得智能体能够具有与外部交互、知行合一的能力;
- Plan-and-Solve: "三思而后行"的范式,目标是在事前先规划后解决。该范式将工作流程解耦为了规划和执行两个核心阶段、执行内容严格遵循规划步骤,使得智能体能够解决长任务、多步骤等复杂问题中容易"偏离轨道"的问题;
- Reflection: 迭代与优化的范式,目标是在事后进行反思与修正。该范式通过自我批判和修正来不断优化结果,使得智能体具有自我内部纠错、持续演进的能力(提升复杂任务成功率和答案质量);
事实上,市面上已有的LangChain、LlamaIndex等众多智能体开发框架都是基于多种智能体架构范式,通过工程化的能力和技术进行了高度抽象和封装,这类成熟的智能体框架在工程效率上效果显著,但是这类标准组件同样也带来了无法满足定制化、复杂需求的问题,因此在本文我们将手动实现三种智能体构建范式、掌握其设计原理、理解其运行机制。
一、ReAct 范式
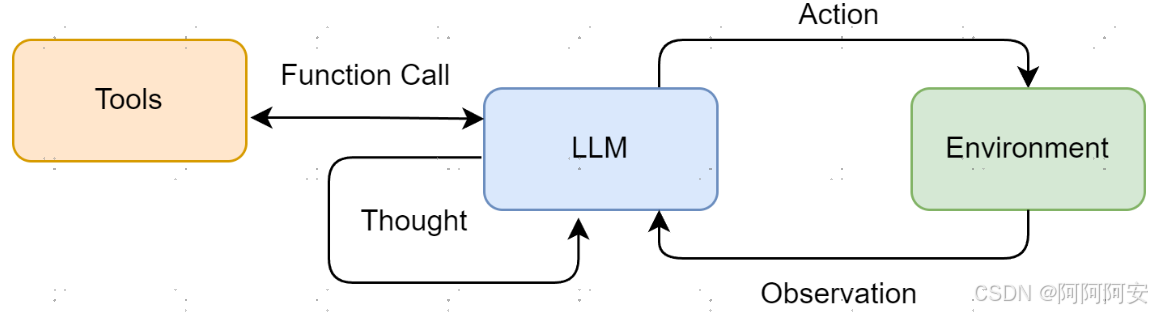
ReAct 的工作流程是"思考-行动-观察"的循环链,智能体将重复这个 Thought -> Action -> Observation 的循环(思考结果指导行动、行动结果引导思考),不断将新的观察结果追加到历史记录中、形成一个不断增长的上下文,直到大模型在Thought中认为已经找到了最终答案、然后输出结果。在这个过程中,通过行动对外部环境施加影响是驱动循环持续进行的关键,那么工具调用能力(Function Call)或外部调用能力则是行动执行的核心实现方式,因此 ReAct 范式的关键实现点在于构建工具调用能力与封装链式循环的处理过程。
1. 工具定义与实现
在智能体中良好定义的工具应当包含以下三个核心要素:
- 名称 (Name) : 简明、唯一的标识符,用于智能体在
Action中调用,例如搜索工具Search; - 描述 (Description) : 清晰的自然语言描述,说明工具的用途。这是整个机制中最关键的部分,因为大语言模型会依赖这段描述来判断何时使用哪个工具;
- 执行逻辑 (Execution Logic): 真正执行任务的具体函数或方法(可调用对象);
这里的工具可以是框架中预置的也可以是通过自动扫描技术获取的函数或方法(大部分框架会选择这么做),我们将在本节中实现一个网页搜索工具,并构建一个通用的工具管理器。
1.1 工具实现
我们选用第一篇文章中准备的 SerpApi 实现网页搜索工具的能力,它通过 API 提供结构化的搜索结果(对 Google 兼容性最好,当然也可以选择其它搜索引擎比如 Bing、Baidu),能直接返回"答案摘要框"或精确的知识图谱信息,我们这里使用谷歌搜索引擎(其他搜索引擎的支持效果太差了)。
python
import os
from serpapi import SerpApiClient

def search(query: str) -> str:
    """
    基于SerpApi的网页搜索引擎工具:解析搜索结果并返回直接答案或知识图谱信息。
    """
    print(f"🔍 正在执行 [SerpApi] 网页搜索: {query}")
    try:
        api_key = os.getenv("SERPAPI_API_KEY")
        if not api_key:
            return "错误: SERPAPI_API_KEY 未定义"
        # 初始化客户端
        params = {
            "engine": "google", # 我们这里使用谷歌搜索引擎
            "q": query,
            "api_key": api_key
        }
        client = SerpApiClient(params)
        # 获取查询结果
        results = client.get_dict()
        # 解析查询结果: 按优先级匹配答案
        if "answer_box_list" in results:
            return "\n".join(results["answer_box_list"])
        if "answer_box" in results and "answer" in results["answer_box"]:
            return results["answer_box"]["answer"]
        if "knowledge_graph" in results and "description" in results["knowledge_graph"]:
            return results["knowledge_graph"]["description"]
        if "organic_results" in results and results["organic_results"]:
            # 如果没有直接答案,则返回前三个有机结果的摘要
            snippets = [
                f"[{i + 1}] {res.get('title', '')}\n{res.get('snippet', '')}" for i, res in enumerate(results["organic_results"][:3])
            ]
            return "\n\n".join(snippets)
        return f"没有找到关于 '{query}' 的信息"
    except Exception as e:
        return f"搜索异常: {e}"
在上述代码中,解析的查询结果(包括解析策略)将直接影响 LLM 的思考与执行、影响最终结果的质量。
1.2 工具管理器实现
只有工具还不够,当智能体需要使用多种工具协同工作时(例如,除了搜索,还可能需要计算、查询数据库等),我们需要一个统一的管理器来注册和调度这些工具。
按照核心要素的定义,每个工具的注册信息应当包含工具的名称、描述和执行逻辑(在Python中可以使用callable类型来表示任何可调用对象,比如函数或方法)。
json
{
    "Search": {
        "description": "网页搜索引擎工具,用于解析搜索结果并返回直接答案或知识图谱信息",
        "func": search
    }
}
代码实现如下:
python
from typing import Dict, Any


class ToolExecutor:
    """
    工具调度执行器:负责管理、调度和执行工具
    """
    def __init__(self):
        self.tools: Dict[str, Dict[str, Any]] = {} #初始化工具集合

    def register(self, name: str, description: str, func: callable):
        """
        向管理器中注册工具
        """
        if name in self.tools:
            print(f"警告: 工具 '{name}' 已存在")
        self.tools[name] = {"description": description, "func": func}
        print(f"工具 '{name}' 注册成功")

    def getTool(self, name: str) -> callable:
        """
        根据名称获取工具的执行函数(用于执行工具)
        """
        return self.tools.get(name, {}).get("func")

    def getTools(self) -> str:
        """
        获取所有工具的格式化描述字符串(用于给模型选择工具)
        """
        return "\n".join([
            f"- {name}: {info['description']}" for name, info in self.tools.items()
        ])
1.3 测试验证
我们将网页搜索工具注册到工具管理器中,并模拟Agent智能体的Action调用场景来获取搜索结果。
python
from dotenv import load_dotenv
from tools.ToolExecutor import ToolExecutor
from tools.search import search

# 加载 .env 文件中的环境变量配置
load_dotenv()

def search_run():
    # 1. 初始化工具执行器
    toolExecutor = ToolExecutor()

    # 2. 注册网页搜索工具
    toolExecutor.register("Search", "网页搜索引擎工具,用于解析搜索结果并返回直接答案或知识图谱信息", search)

    # 3. 获取工具信息
    print("\n--- 工具集合信息 ---")
    print(toolExecutor.getTools())

    # 4. 模拟智能体的 Action 调用
    tool_name = "Search"
    tool_input = "国际最新金价趋势"
    print(f"\n--- 执行 Action: Search['{tool_input}'] ---\n")

    tool_func = toolExecutor.getTool(tool_name)
    if tool_func:
        observation = tool_func(tool_input)
        print("--- 观察 (Observation) 结果 ---")
        print(observation)
    else:
        print(f"未找到 '{tool_name}' 工具")

if __name__ == '__main__':
search_run()工具 'Search' 注册成功
--- 工具集合信息 ---
- Search: 网页搜索引擎工具,用于解析搜索结果并返回直接答案或知识图谱信息
--- 执行 Action: Search['国际最新金价趋势'] ---
🔍 正在执行 [SerpApi] 网页搜索: 国际最新金价趋势
--- 观察 (Observation) 结果 ---
[1] 黄金价格走势图
BullionVault 的金价走势图将显示专业黄金市场的实时现货价格。您也可以在BullionVault 以这些价格买入黄金。 我们提供最快的网上更新,每十秒都会刷新最新的即时数据 ...
[2] 国际现货黄金价格走势图-黄金实时行情分析-黄金k线图
现货黄金更新时间:04-16 00:37. 4828.04/4828.3937.53(0.78%). 今开:4795.96; 最高:4838.15; 昨收:4790.51; 最低:4790.96. 分时图基本面分析> 黄金、外汇、原油、期货 ...
[3] XAUUSD图表--- 黄金现货美元价格
金价压缩-- 破位来临黄金-- 在趋势线下的压缩,流动性在下一次扩张前建立黄金不再呈现冲动走势------它正在向下行趋势线下方的压缩阶段过渡。在完成五浪结构并且从高位强烈 ...2. ReAct 智能体实现
2.1 LLM 客户端流式优化
相比非流式输出来说,流式输出逐块返回结果、首字延迟低、能够避免 HTTP 连接超时,更加适合长文本生成场景,且对于用户来说等待时间更短、体验更好,因此在本节我们将 LLM 封装客户端的输出优化为默认流式输出。
python
import os
from typing import List, Dict, Optional
from openai import OpenAI

class BaseLLMClient:
    """
    LLM 客户端
    它用于调用任何兼容OpenAI接口规范的服务
    """
    def __init__(self, model: str=None, apiKey: str=None, baseUrl: str=None, timeout: int=None):
        """
        初始化客户端:优先使用传入参数,如果未提供则从环境变量加载
        """
        self.model = model or os.getenv("LLM_MODEL_ID")
        apiKey = apiKey or os.getenv("LLM_API_KEY") # 不保存敏感配置信息仅用于创建客户端
        baseUrl = baseUrl or os.getenv("LLM_BASE_URL")
        timeout = timeout or int(os.getenv("LLM_TIMEOUT", 60))

        # 任意配置为空则抛出异常
        if not all([self.model, apiKey, baseUrl]):
            raise ValueError("参数异常:模型ID、API密钥或服务地址未定义")

        # 创建 OpenAI 接口规范客户端
        self.client = OpenAI(api_key=apiKey, base_url=baseUrl, timeout=timeout)


    def think(self, messages: List[Dict[str, str]], temperature: float = 0, stream: bool = True) -> Optional[str]:
        """
        调用大语言模型思考并返回标准化响应
        """
        print(f"🧠 正在调用 {self.model} 模型...")
        try:
            # 获取模型响应(默认流式输出)
            response = self.client.chat.completions.create(
                model=self.model,
                messages=messages,
                temperature=temperature,
                stream=stream
            )
            # 处理模型响应
            print(f"✅ 大语言模型响应成功:")
            if not stream:
                # 非流式处理
                result = response.choices[0].message.content
                print(result)
            else:
                # 流式处理
                collected_content = []
                for chunk in response:
				    if not chunk.choices:
                        continue
                    content = chunk.choices[0].delta.content or ""
                    print(content, end="", flush=True) # 打字机输出
                    collected_content.append(content)
                print()  # 在流式输出结束后换行
                result = "".join(collected_content)
            return result
        except Exception as e:
            print(f"❌ 大语言模型响应失败: {e}")
            return None
这里需要注意的是,LLM 客户端只提供大模型的调用和交互能力,范式的约束由智能体实现。
2.2 系统提示词设计
不管如何抽象和封装智能体框架,智能体的"大脑🧠"始终是最底层的大语言模型,而与大语言模型交互最根本、最直接的方式还是需要通过提示词,因此我们需要设计一套提示词模板,用于定义角色、输出格式、交互规则 ,并能动态的插入可用工具、用户问题以及中间过程的交互历史/上下文。
python
# ReAct 提示词模板
REACT_PROMPT_TEMPLATE = """
请注意,你是一个能够调用外部工具来解决问题的智能助手。

可用工具清单如下:
{tools}

请严格按照以下格式进行回应:

Thought: 你的思考过程,用于分析问题、拆解任务和规划下一步行动。
Action: 你决定采取的行动,必须是以下格式之一:
- {{tool_name}}[{{tool_input}}]: 这表示调用一个可用工具。
- Finish[最终答案内容]: 这表示你认为已经获得最终答案。
- 当你收集到足够的信息,能够回答用户的最终问题时,你必须在Action:字段后使用 Finish[最终答案内容] 来输出最终答案。

现在,请开始解决以下问题:
Question: {question}
History: {history}
"""
2.3 核心循环实现
智能体 ReAct 范式的核心循环:思考 -> 行动 -> 观察 实现流程如下:
- 格式化提示词:在提示词模板中追加上下文、问题描述和可用工具信息(给模型提供充足的信息和输出格式要求);
- 调用LLM客户端:输入提示词进行思考;
- 解析LLM的输出内容:按照提示词模板中既定的输出格式解析思考Thought和行动Action的内容(正则表达式);
- 解析行动 Action:解析行动Action中的调用工具及其输入内容(正则表达式);
- 执行 Action 工具调用:通过工具管理器执行工具调用, 调用结果就是观测结果;
- 更新与迭代:将本次行动Action与观测结果追加到上下文中,继续执行智能体循环向答案演进(结果引导思考);
- 循环结束:直到模型认为获得最终答案结束(Finish最终答案内容)、或达到循环上限时结束(避免智能体陷入无限循环);
python
import re
from client.BaseLLMClient import BaseLLMClient
from template.react import REACT_PROMPT_TEMPLATE
from tools.ToolExecutor import ToolExecutor


class ReActAgent:
    """
    ReAct 智能体实现:核心逻辑封装
    """
    def __init__(self, llm_client: BaseLLMClient, tool_executor: ToolExecutor, max_steps: int = 5):
        self.llm_client = llm_client # LLM 客户端
        self.tool_executor = tool_executor # 工具管理器
        self.max_steps = max_steps # 循环上限
        self.history = [] # 历史上下文

    def run(self, question: str):
        """
        执行智能体ReAct核心循环:思考 -> 行动 -> 观察
        """
        self.history = []  # 每次运行时重置历史记录
        current_step = 0

        while current_step < self.max_steps:
            current_step += 1
            print(f"--- 第 {current_step} 次迭代 ---")

            # 1. 格式化提示词
            tools_desc = self.tool_executor.getTools() # 获取可用工具描述
            history_content = "\n".join(self.history) # 拼接历史上下文信息
            prompt = REACT_PROMPT_TEMPLATE.format(
                tools=tools_desc,
                question=question,
                history=history_content
            )
            # print(f"prompt: {prompt}")

            # 2. 调用LLM客户端进行思考
            message = [{"role": "user", "content": prompt}]
            response_text = self.llm_client.think(messages=message)
            if not response_text:
                print("❌错误:LLM返回响应失败,流程终止")
                break
            # print(response_text)

            # 3. 解析LLM的输出内容
            thought, action = self._parse_output(response_text)
            if thought:
                print(f"📕思考: {thought}")
            if not action:
                print("❌错误:Action无效,流程终止")
                break

            # 4. 解析行动 Action
            if action.startswith("Finish"):
                # Finish 指令用于输出最终答案并结束
                final_answer = re.match(r"Finish\[(.*)\]", action, re.DOTALL).group(1)
                print(f"✅最终答案: {final_answer}")
                return final_answer
            tool_name, tool_input = self._parse_action(action)
            if not tool_name or not tool_input:
                print("❌错误:工具解析无效,流程终止")
                break
            print(f"🚀行动: {tool_name} [{tool_input}]")

            # 5. 执行 Action 工具调用 -> 更新观测结果
            tool_func = self.tool_executor.getTool(tool_name)
            if not tool_func:
                observation = f"错误: 未找到名为 '{tool_name}' 的工具"
            else:
                observation = tool_func(tool_input) # 调用真实工具
            print(f"👀观测结果: {observation}")

            # 6. 更新历史上下文继续迭代
            self.history.append(f"Action: {action}")
            self.history.append(f"Observation: {observation}")
        # 7.循环结束
        print("🀄已达到最大步数,流程终止")
        return None


    def _parse_output(self, text: str):
        """
        解析LLM返回的响应,提取模板中的Thought和Action
        """
        # Thought: 正则表达式匹配到 'Action:' 或文本末尾
        thought_match = re.search(r"Thought:\s*(.*?)(?=\nAction:|$)", text, re.DOTALL)
        # Action: 正则表达式匹配到文本末尾
        action_match = re.search(r"Action:\s*(.*?)$", text, re.DOTALL)
        # 获取最终结果
        thought = thought_match.group(1).strip() if thought_match else None
        action = action_match.group(1).strip() if action_match else None
        return thought, action

    def _parse_action(self, action_text: str):
        """
        解析Action字符串:提取工具名称和工具输入(仅提取一对)
        """
        # tool[tool_input] -> tool + tool_input
        match = re.match(r"(\w+)\[(.*)\]", action_text, re.DOTALL)
        if match:
            return match.group(1), match.group(2)
        return None, None
2.4 测试验证
python
from agent.ReActAgent import ReActAgent
from client.BaseLLMClient import BaseLLMClient
from dotenv import load_dotenv
from tools.ToolExecutor import ToolExecutor
from tools.search import search

# 加载 .env 文件中的环境变量配置
load_dotenv()

def react_run():
    # 1. LLM 客户端
    llm_client = BaseLLMClient()
    # 2. 工具管理器
    tool_executor = ToolExecutor()
    # 3. 注册网页搜索工具
    tool_executor.register("Search", "网页搜索引擎工具,用于解析搜索结果并返回直接答案或知识图谱信息", search)
    # 4. ReAct 智能体
    react_agent = ReActAgent(llm_client, tool_executor)
    # 5. 运行智能体
    question = "国际最新金价"
    print(f"--- 问题: {question} ---")
    answer = react_agent.run(question)
    print(f"--- 答案: {answer} ---")


if __name__ == '__main__':
    react_run()
注意,实际测试过程中可能会出现多次失败情况,可能的原因包括:
- 大模型没有按照模板输出:调整提示词内容或在提示词中加入具体示例,保证按照我们的正则表达式解析格式进行输出;
- 迭代次数超过阈值:这表示在有限循环中没有找到答案,可以观察思考过程在提示词增加更多规则限制、更换模型或提高上限阈值;
- 工具使用失败:验证工具的输入输出格式是否正确,同时也要确保工具返回的
observation格式是智能体可以理解和处理;
下面是一次真实的运行记录:
工具 'Search' 注册成功
--- 问题: 国际最新金价 ---
--- 第 1 次迭代 ---
🧠 正在调用 coding-glm-5.1-free 模型...
✅ 大语言模型响应成功:
Action: Search[国际最新金价]
🚀行动: Search [国际最新金价]
🔍 正在执行 [SerpApi] 网页搜索: 国际最新金价
👀观测结果: [1] COMEX黄金(GC00Y)_行情中心
最新价, 涨跌幅. COMEX黄金2702, 5054.7, 2.05%. COMEX黄金2701, 5010.8, 1.53 ... 国际金价在5200美元关口盘整避险属性会否回归?03-11; 原油巨震!霍尔木兹海峡突发 ...

[2] 黄金价格走势图
BullionVault 的金价走势图将显示专业黄金市场的实时现货价格。您也可以在BullionVault 以这些价格买入黄金。 我们提供最快的网上更新,每十秒都会刷新最新的即时数据 ...

[3] 国际现货黄金价格走势图-黄金实时行情分析-黄金k线图
COMEX黄金期货上涨1.01%,报价为4856.60美元每盎司,本周累计涨幅为1.44%。 2026-04-18 04:41:56现货黄金刚刚突破4840.00美元/盎司关口,最新报4839.95美元/盎司, ...
--- 第 2 次迭代 ---
🧠 正在调用 coding-glm-5.1-free 模型...
✅ 大语言模型响应成功:
Thought: 观察之前的搜索结果,发现其中包含了最新的国际金价信息。具体来看,现货黄金最新报价为4839.95美元/盎司,同时COMEX黄金期货价格也有相关数据。我可以直接将这些信息整理并作为最终答案提供给用户。
Action: Finish[根据最新搜索结果,国际现货黄金价格最新报约4839.95美元/盎司(此数据参考时间为2026-04-18 04:41:56);此外,COMEX黄金期货部分合约报价在4856.60美元至5054.7美元每盎司之间。请注意,黄金价格实时波动,具体交易请以实时行情为准。]
📕思考: 观察之前的搜索结果,发现其中包含了最新的国际金价信息。具体来看,现货黄金最新报价为4839.95美元/盎司,同时COMEX黄金期货价格也有相关数据。我可以直接将这些信息整理并作为最终答案提供给用户。
✅最终答案: 根据最新搜索结果,国际现货黄金价格最新报约4839.95美元/盎司(此数据参考时间为2026-04-18 04:41:56);此外,COMEX黄金期货部分合约报价在4856.60美元至5054.7美元每盎司之间。请注意,黄金价格实时波动,具体交易请以实时行情为准。
--- 答案: 根据最新搜索结果,国际现货黄金价格最新报约4839.95美元/盎司(此数据参考时间为2026-04-18 04:41:56);此外,COMEX黄金期货部分合约报价在4856.60美元至5054.7美元每盎司之间。请注意,黄金价格实时波动,具体交易请以实时行情为准。 ---
二、Plan-and-Solve 范式
Plan-and-Solve 的工作流程是规划和执行两个阶段的解耦,其核心动机是为了解决思维链在处理长任务、多步骤等复杂问题时容易"偏离轨道"的问题,比如数学应用、代码生成、信息整合等。
- 规划阶段:智能体接收用户问题并将问题分解,制定出一个清晰明确、步骤详细的执行计划,这个计划本身就是一次大语言模型的调用产物。
- 执行阶段:基于规划阶段生成的完整计划,智能体严格按照计划中的步骤、逐一执行,直到所有步骤都完成,得出最终答案。
因此,为了实现 Plan-and-Solve 范式,我们的实现目标包括针对问题生成计划、基于计划逐步执行(每步执行都可能独立的 LLM 调用或是对上步结果的加工),本章暂不结合使用工具的方式。
1. 规划阶段
规划阶段的目标是让 LLM 接收原始问题,并输出一个清晰明确、步骤详细的执行计划,这个计划必须是结构化的,以便我们的代码可以轻松解析与识别。
1.1 系统提示词设计
规划阶段的提示词应当包含角色与任务描述、动态的问题占位(分解目标)以及格式化输出约束(便于代码解析)。
python
# Plan-and-Solve  Plan 提示词模板

PLANNER_PROMPT_TEMPLATE = """
你是一个顶级的AI规划专家。你的任务是将用户提出的复杂问题分解成一个由多个简单步骤组成的行动计划。
请确保计划中的每个步骤都是一个独立的、可执行的子任务,并且严格按照逻辑顺序排列。
你的输出必须是一个Python列表,其中每个元素都是一个描述子任务的字符串。

问题: {question}

请严格按照以下格式输出你的计划,```python与```作为前后缀是必要的(不可省略):
```python
["步骤1", "步骤2", "步骤3", ...]
```
"""
1.2 规划器实现
规划器用于封装规划阶段流程,构造提示词、调用LLM并解析返回结果,生成最终计划清单。
python
import ast
from template.plan import PLANNER_PROMPT_TEMPLATE

class Planner:
    def __init__(self, llm_client):
        self.llm_client = llm_client

    def plan(self, question: str) -> list[str]:
        """
        根据用户问题生成执行计划
        """
        prompt = PLANNER_PROMPT_TEMPLATE.format(question=question)

        # 1. 调用LLM客户端进行思考
        messages = [{"role": "user", "content": prompt}]

        print("--- 正在生成计划 ---")

        response_text = self.llm_client.think(messages=messages) or "" # 使用流式输出

        print(f"✅ 计划已生成:\n{response_text}")

        # 2. 解析LLM输出计划列表
        try:
            # 定位```python和```之间的内容
            plan_str = response_text.split("```python")[1].split("```")[0].strip()
            # 安全解析字符串并将其转换为Python列表
            plan = ast.literal_eval(plan_str)
            return plan if isinstance(plan, list) else []
        except (ValueError, SyntaxError, IndexError) as e:
            print(f"❌ 解析计划内容不满足格式: {e}")
            return []
        except Exception as e:
            print(f"❌ 解析计划时发生未知错误: {e}")
            return []
2. 执行阶段
执行阶段的目标是逐步完成计划中的任务,执行阶段除了需要多次调用大语言模型来获取逐步骤结果,还需要记录每步执行的状态并将其作为上下文提供给后续步骤,这样才能确保信息在整个任务链条中顺畅流动。
2.1 系统提示词设计
执行阶段的提示词应当专注于每个步骤的解决,需要包含已有上下文和当前目标两个部分:
- 已有上下文:原始问题、完整计划、历史步骤和结果;
- 当前目标:当前步骤、当前目标;
python
# Plan-and-Solve  Solve 提示词模板

SOLVE_PROMPT_TEMPLATE = """
你是一位顶级的AI执行专家。你的任务是严格按照给定的计划,一步步地解决问题。
你将收到原始问题、完整的计划、以及到目前为止已经完成的步骤和结果。
请你专注于解决"当前步骤",并仅输出该步骤的最终答案,不要输出任何额外的解释或对话。

# 原始问题:
{question}

# 完整计划:
{plan}

# 历史步骤与结果:
{history}

# 当前步骤:
{current_step}

请仅输出针对"当前步骤"的回答:
"""
2.2 执行器实现
规划器用于封装计划执行流程,串联多个步骤、维护上下文状态。
python
from template.plan_executor import SOLVE_PROMPT_TEMPLATE


class Solver:
    def __init__(self, llm_client):
        self.llm_client = llm_client

    def execute(self, question: str, plan: list[str]) -> str:
        """
        根据执行计划逐步执行步骤
        """
        history = ""  # 用于存储历史步骤和结果的字符串

        print("\n--- 正在执行计划 ---")

        for i, step in enumerate(plan):
            print(f"\n-> 正在执行步骤 {i + 1}/{len(plan)}: {step}")

            # 1. 拼接当前步骤提示词
            prompt = SOLVE_PROMPT_TEMPLATE.format(
                question=question,
                plan=plan,
                history=history if history else "无",  # 如果是第一步则历史为空
                current_step=step
            )

            # 2. 调用LLM客户端进行思考
            messages = [{"role": "user", "content": prompt}]

            response_text = self.llm_client.think(messages=messages) or "" # 无需解析

            # 3. 更新并记录执行状态(历史记录)
            history += f"步骤 {i + 1}: {step}\n结果: {response_text}\n\n"

            print(f"✅ 步骤 {i + 1} 已完成,结果: {response_text}")

        # 4. 返回最终答案(循环结束后最后一步的响应)
        final_answer = response_text
        return final_answer
3. 智能体实现
实现规划阶段 Planner 和执行阶段 Solver 后,我们需要基于"组合优于继承"的设计原则 将各个组件整合为智能体 PlanAndSolveAgent,用于启动和协调整个流程。
python
from agent.planAndSolve.Planner import Planner
from agent.planAndSolve.Solver import Solver

class PlanAndSolveAgent:
    def __init__(self, llm_client):
        """
        初始化智能体、创建规划器和执行器实例
        """
        self.llm_client = llm_client
        self.planner = Planner(self.llm_client)
        self.executor = Solver(self.llm_client)

    def run(self, question: str):
        """
        运行 PlanAndSolve 范式的完整流程:先规划后执行
        """
        print(f"\n--- 开始处理问题 ---\n问题: {question}")

        # 1. 调用规划器生成计划
        plan = self.planner.plan(question)
        if not plan:
            print("\n--- 任务终止 --- \n无法生成有效的行动计划。")
            return

        # 2. 调用执行器执行计划
        final_answer = self.executor.execute(question, plan)

        print(f"\n--- 任务完成 ---\n最终答案: {final_answer}")
4. 测试验证
python
def plan_and_solve_run():
    # 1. LLM 客户端
    llm_client = BaseLLMClient()
    # 2. PlanAndSolve 智能体
    agent = PlanAndSolveAgent(llm_client)
    # 3. 运行智能体
    question = "一个水果店周一卖出了15个苹果。周二卖出的苹果数量是周一的两倍。周三卖出的数量比周二少了5个。请问这三天总共卖出了多少个苹果?"
    agent.run(question)

if __name__ == '__main__':
    plan_and_solve_run()
输出结果:
--- 开始处理问题 ---
问题: 一个水果店周一卖出了15个苹果。周二卖出的苹果数量是周一的两倍。周三卖出的数量比周二少了5个。请问这三天总共卖出了多少个苹果?
--- 正在生成计划 ---
🧠 正在调用 ZhipuAI/GLM-5.3-Flash 模型...
✅ 大语言模型响应成功:
```python
["根据周一卖出的15个苹果,计算周二卖出的苹果数量(周一数量的两倍)", "根据周二卖出的苹果数量,计算周三卖出的苹果数量(周二数量减去5个)", "将周一、周二、周三三天卖出的苹果数量相加,得出总销售量"]
```
✅ 计划已生成:
```python
["根据周一卖出的15个苹果,计算周二卖出的苹果数量(周一数量的两倍)", "根据周二卖出的苹果数量,计算周三卖出的苹果数量(周二数量减去5个)", "将周一、周二、周三三天卖出的苹果数量相加,得出总销售量"]
```

--- 正在执行计划 ---

-> 正在执行步骤 1/3: 根据周一卖出的15个苹果,计算周二卖出的苹果数量(周一数量的两倍)
🧠 正在调用 ZhipuAI/GLM-5.3-Flash 模型...
✅ 大语言模型响应成功:
周二卖出的苹果数量:15 × 2 = 30个
✅ 步骤 1 已完成,结果: 周二卖出的苹果数量:15 × 2 = 30个

-> 正在执行步骤 2/3: 根据周二卖出的苹果数量,计算周三卖出的苹果数量(周二数量减去5个)
🧠 正在调用 ZhipuAI/GLM-5.3-Flash 模型...
✅ 大语言模型响应成功:
周三卖出的苹果数量:30 - 5 = 25个
✅ 步骤 2 已完成,结果: 周三卖出的苹果数量:30 - 5 = 25个

-> 正在执行步骤 3/3: 将周一、周二、周三三天卖出的苹果数量相加,得出总销售量
🧠 正在调用 ZhipuAI/GLM-5.3-Flash 模型...
✅ 大语言模型响应成功:
总销售量:15 + 30 + 25 = 70个
✅ 步骤 3 已完成,结果: 总销售量:15 + 30 + 25 = 70个

--- 任务完成 ---
最终答案: 总销售量:15 + 30 + 25 = 70个
三、Reflection 范式
Reflection 的工作流程是在任务执行完成之后进行持续自我矫正,本质上该范式是"初稿 → 终稿"的两阶段划分,其核心实现流程可以抽象为执行 → 反思 → 优化的三步循环:
- 执行:该步骤的目标纯粹是完成当前任务,因此在具体实现过程中可以使用直接实现、ReAct、Plan-and-Solve 等多种我们熟悉的方式;
- 反思:该步骤的目标是基于执行结果,由独立的"审查员"角色进行执行结果评估,给出优化建议或改进方案,其评估维度包括是否满足要求、是否存在风险、或者是否达到最优;
- 优化:该步骤的目标是进行反馈建议的落地,将"初稿"和"反馈"作为新的上下文对初稿进行修正,不断迭代逼近最优结果;
这个循环可以重复进行多次,直到反思阶段不再发现新的问题,或者达到预设的迭代次数上限,其价值不仅在于修复错误,更在于驱动解决方案在质量和效率上实现阶梯式的提升,这使其成为构建复杂、高质量智能体的关键技术之一。
在该章节实践中我们主要完成 Python 代码生成场景的迭代与优化,该场景具有优化路径明确、反思点清晰、优化结果可度量等特点,是检验 Reflection 范式的绝佳场景。
1. 记忆模块
Reflection 的核心在于迭代,而迭代的前提是能够记住之前的尝试和对应获得的反馈。因此,"短期记忆"模块是实现该范式的必需品,不同于前述章节记忆实现中简单的模板内容追加,当前记忆模块需要负责存储每次"执行-反思"循环的完整轨迹、并在每个步骤中独立应用。
python
from typing import List, Dict, Any, Optional


class Memory:
    """
    短期记忆模块:用于存储智能体的行动与反思轨迹。
    """

    def __init__(self):
        """
        初始化空列表来存储所有记录。
        """
        self.records: List[Dict[str, Any]] = []

    def add_record(self, record_type: str, content: str):
        """
        向记忆中添加一条新记录。

        参数:
        - record_type (str): 记录的类型 ('execution' 或 'reflection')。
        - content (str): 记录的具体内容 (例如,生成的代码或反思的反馈)。
        """
        record = {"type": record_type, "content": content}
        self.records.append(record)
        print(f"📝 记忆已更新,新增一条 '{record_type}' 记录。")

    def get_trajectory(self) -> str:
        """
        将所有记忆记录格式化为一个连贯的字符串文本,用于构建提示词。
        """
        trajectory_parts = []
        for record in self.records:
            if record['type'] == 'execution':
                trajectory_parts.append(f"--- 上一轮尝试 (代码) ---\n{record['content']}")
            elif record['type'] == 'reflection':
                trajectory_parts.append(f"--- 评审员反馈 ---\n{record['content']}")

        return "\n\n".join(trajectory_parts)

    def get_last_execution(self) -> Optional[str]:
        """
        获取最近的执行结果 (例如,最新生成的代码)。
        如果不存在,则返回 None。
        """
        for record in reversed(self.records):
            if record['type'] == 'execution':
                return record['content']
        return None
2. 系统提示词设计
与之前的范式不同的是 Reflection 机制需要多个不同角色的提示词来协同工作(执行、反思、优化)。
2.1 初始提示词
智能体首次尝试解决问题的提示词,只需要求模型完成指定任务(内容相对直接)。
python
# Reflection 初始提示词模板

INITIAL_PROMPT_TEMPLATE = """
你是一位资深的Python程序员。请根据以下要求,编写一个Python函数。
你的代码必须包含完整的函数签名、文档字符串,并遵循PEP 8编码规范。

要求: {task}

请直接输出代码,不要包含任何额外的解释。
"""
2.2 反思提示词
指示模型扮演"代码评审员"的角色,对上轮生成的代码进行独立的批判性分析,并提供具体的、可操作的反馈。
python
# Reflection 反思提示词模板

REFLECT_PROMPT_TEMPLATE = """
你是一位极其严格的代码评审专家和资深算法工程师,对代码的性能有极致的要求。
你的任务是审查以下Python代码,并专注于找出其在<strong>算法效率</strong>上的主要瓶颈。

# 原始任务:
{task}

# 待审查的代码:
```python
{code}
```

请分析该代码的时间复杂度,并思考是否存在一种<strong>算法上更优</strong>的解决方案来显著提升性能。
如果存在,请清晰地指出当前算法的不足,并提出具体的、可行的改进算法建议(例如,使用筛法替代试除法)。
如果代码在算法层面已经达到最优,才能回答"无需改进"。

请直接输出你的反馈,不要包含任何额外的解释。
"""
2.3 优化提示词
收到反馈后,引导模型根据反馈内容对原有代码进行修正和优化。
python
# Reflection 优化提示词模板

REFINE_PROMPT_TEMPLATE = """
你是一位资深的Python程序员。你正在根据一位代码评审专家的反馈来优化你的代码。

# 原始任务:
{task}

# 你上一轮尝试的代码:
{last_code_attempt}
评审员的反馈:
{feedback}

请根据评审员的反馈,生成一个优化后的新版本代码。
你的代码必须包含完整的函数签名、文档字符串,并遵循PEP 8编码规范。
请直接输出优化后的代码,不要包含任何额外的解释。
"""
3. 智能体实现
将前述记忆模块与"执行-反思-优化"的循环进行整合与封装,实现 ReflectionAgent 智能体。
python
from agent.reflection.Memory import Memory
from template.reflection.initial import INITIAL_PROMPT_TEMPLATE
from template.reflection.refine import REFINE_PROMPT_TEMPLATE
from template.reflection.reflection import REFLECT_PROMPT_TEMPLATE


class ReflectionAgent:
    def __init__(self, llm_client, max_iterations=3):
        self.llm_client = llm_client
        self.memory = Memory()
        self.max_iterations = max_iterations

    def run(self, task: str):
        print(f"\n--- 开始处理任务 ---\n任务: {task}")

        # --- 1. 初始执行 ---
        print("\n--- 正在进行初始尝试 ---")
        initial_prompt = INITIAL_PROMPT_TEMPLATE.format(task=task)
        initial_code = self._get_llm_response(initial_prompt)
        self.memory.add_record("execution", initial_code)

        # --- 2. 迭代循环:反思与优化 ---
        for i in range(self.max_iterations):
            print(f"\n--- 第 {i + 1}/{self.max_iterations} 轮迭代 ---")

            # a. 反思
            print("\n-> 正在进行反思...")
            last_code = self.memory.get_last_execution()
            reflect_prompt = REFLECT_PROMPT_TEMPLATE.format(task=task, code=last_code)
            feedback = self._get_llm_response(reflect_prompt)
            self.memory.add_record("reflection", feedback)

            # b. 检查是否需要停止
            if "无需改进" in feedback:
                print("\n✅ 反思认为代码已无需改进,任务完成。")
                break

            # c. 优化
            print("\n-> 正在进行优化...")
            refine_prompt = REFINE_PROMPT_TEMPLATE.format(
                task=task,
                last_code_attempt=last_code,
                feedback=feedback
            )
            refined_code = self._get_llm_response(refine_prompt)
            self.memory.add_record("execution", refined_code)

        final_code = self.memory.get_last_execution()
        print(f"\n--- 任务完成 ---\n最终生成的代码:\n```python\n{final_code}\n```")
        return final_code

    def _get_llm_response(self, prompt: str) -> str:
        """辅助方法:用于调用LLM并获取完整的流式响应。"""
        messages = [{"role": "user", "content": prompt}]
        response_text = self.llm_client.think(messages=messages) or ""
        return response_text
4. 测试验证
python
def reflection_run():
    # 1. LLM 客户端
    llm_client = BaseLLMClient()
    # 2. Reflection 智能体
    agent = ReflectionAgent(llm_client)
    # 3. 运行智能体
    task = "编写一个Python函数,找出1到n之间所有的素数 (prime numbers)。"
    agent.run(task)

if __name__ == '__main__':
    reflection_run()
输出结果示例如下:
--- 开始处理任务 ---
任务: 编写一个Python函数,找出1到n之间所有的素数 (prime numbers)。

--- 正在进行初始尝试 ---
🧠 正在调用 ZhipuAI/GLM-5.3-Flash 模型...
✅ 大语言模型响应成功:
```python
def find_primes(n):
    """找出 1 到 n 之间所有的素数。

    使用埃拉托斯特尼筛法(Sieve of Eratosthenes)实现,
    时间复杂度为 O(n log log n),空间复杂度为 O(n)。

    Args:
        n (int): 搜索范围的上界(包含 n 本身)。

    Returns:
        list[int]: 由 1 到 n 之间所有素数组成的升序列表。
            若 n 小于 2,则返回空列表。

    Raises:
        TypeError: 当 n 不是整数时抛出。

    Examples:
        >>> find_primes(10)
        [2, 3, 5, 7]
        >>> find_primes(1)
        []
    """
    if not isinstance(n, int):
        raise TypeError("n 必须是整数")

    if n < 2:
        return []

    is_prime = [True] * (n + 1)
    is_prime[0] = is_prime[1] = False

    for i in range(2, int(n ** 0.5) + 1):
        if is_prime[i]:
            for multiple in range(i * i, n + 1, i):
                is_prime[multiple] = False

    return [num for num, prime in enumerate(is_prime) if prime]
```
📝 记忆已更新,新增一条 'execution' 记录。

--- 第 1/3 轮迭代 ---

-> 正在进行反思...
🧠 正在调用 ZhipuAI/GLM-5.3-Flash 模型...
✅ 大语言模型响应成功:


## 时间复杂度分析

- 当前实现为标准埃拉托斯特尼筛法:时间 **O(n log log n)**,空间 **O(n)**。
- 实现细节正确(外层只到 √n、内层从 i² 起筛),正确性无问题。

## 算法层面的不足

1. **并非渐近最优**。存在复杂度更低的筛法:
   - **线性筛(欧拉筛)**:O(n),每个合数仅被其最小质因子标记一次;
   - **Atkin 筛**:理论 O(n / log log n)(但常数大,纯 Python 下通常反而更慢)。
2. **真正的热点在实现层**:内层 `for multiple in range(...)` 为纯 Python 解释执行,且每个合数被重复访问约 log log n 次,这是 CPython 下的最大瓶颈。
3. **空间浪费**:`[True] * (n+1)` 为 8 字节/元素的指针数组;`bytearray` 仅 1 字节/元素,缓存局部性更好。
4. **未做奇偶剪枝**:偶数占一半存储与一半标记工作量,可用 wheel-2 全部跳过。
5. **潜在精度隐患**:`int(n ** 0.5)` 在 n 极大时可能因浮点误差偏移,应改用 `math.isqrt(n)`。

## 改进建议(按实际收益排序)

**1. 切片赋值向量化标记(收益最大,约 5--10 倍)**------将内层循环下沉到 C 层:

```python
import math

def find_primes(n):
    if not isinstance(n, int):
        raise TypeError("n 必须是整数")
    if n < 2:
        return []
    sieve = bytearray([1]) * (n + 1)
    sieve[0] = sieve[1] = 0
    for i in range(2, math.isqrt(n) + 1):
        if sieve[i]:
            sieve[i*i::i] = bytearray((n - i*i) // i + 1)
    return [i for i, p in enumerate(sieve) if p]
```

渐近复杂度不变,但标记在 C 层完成,实际速度提升一个数量级。

**2. 奇数筛(wheel-2)**:只存储/筛奇数,时间与空间再减半。

**3. 线性筛(渐近最优 O(n))**:

```python
primes, is_comp = [], bytearray(n + 1)
for i in range(2, n + 1):
    if not is_comp[i]:
        primes.append(i)
    for p in primes:
        if i * p > n:
            break
        is_comp[i * p] = 1
        if i % p == 0:
            break
```

注意:纯 Python 下其解释开销常使其慢于方案 1,优势主要体现在 C/NumPy 等环境或理论层面。

**4. 分段筛**:n 极大且内存受限时按块筛选,空间降至 O(√n),缓存命中率更高(渐近复杂度不变)。

## 结论

当前代码在教科书意义上正确,但**并非算法与工程上的最优解**:渐近上存在 O(n) 的线性筛;工程上,纯 Python 逐元素标记是首要瓶颈,应改为切片赋值 + bytearray,并叠加奇数筛;超大 n 场景应采用分段筛。**需要改进。**
📝 记忆已更新,新增一条 'reflection' 记录。

-> 正在进行优化...
🧠 正在调用 ZhipuAI/GLM-5.3-Flash 模型...
✅ 大语言模型响应成功:


```python
import math


def find_primes(n):
    """找出 1 到 n 之间所有的素数。

    采用针对 CPython 深度优化的埃拉托斯特尼筛法:

    - **奇数筛(wheel-2)**:偶数中仅 2 为素数,故只存储并筛选
      奇数,空间与标记工作量均减半;
    - **bytearray 存储**:每元素仅占 1 字节(布尔列表为 8 字节
      指针),缓存局部性更好;
    - **切片赋值向量化**:内层标记通过 ``sieve[start::i] =
      bytearray(count)`` 下沉到 C 层执行,消除纯 Python 逐元素
      循环的解释开销,实际速度提升约一个数量级;
    - **math.isqrt**:以整数平方根替代 ``int(n ** 0.5)``,
      避免大整数场景下的浮点精度偏差。

    时间复杂度 O(n log log n),空间复杂度 O(n / 2)。
    (渐近更优的线性筛在纯 Python 下因解释开销常慢于本实现,
    其优势主要体现在 C/NumPy 等环境,故此处未采用。)

    Args:
        n (int): 搜索范围的上界(包含 n 本身)。

    Returns:
        list[int]: 由 1 到 n 之间所有素数组成的升序列表。
            若 n 小于 2,则返回空列表。

    Raises:
        TypeError: 当 n 不是整数时抛出。

    Examples:
        >>> find_primes(10)
        [2, 3, 5, 7]
        >>> find_primes(1)
        []
        >>> find_primes(2)
        [2]
        >>> find_primes(30)
        [2, 3, 5, 7, 11, 13, 17, 19, 23, 29]
    """
    if not isinstance(n, int):
        raise TypeError("n 必须是整数")

    if n < 2:
        return []

    # sieve[k] 表示奇数 2*k + 1 是否为素数:
    # 索引 0 对应 1,索引 k 对应奇数 2*k + 1。
    size = (n + 1) // 2
    sieve = bytearray([1]) * size
    sieve[0] = 0  # 1 不是素数

    for i in range(3, math.isqrt(n) + 1, 2):
        if sieve[i // 2]:
            start = i * i // 2  # i*i 为奇数,其索引为 i*i // 2
            count = (size - start + i - 1) // i
            sieve[start::i] = bytearray(count)

    # sieve[0] 已置 0,enumerate 不会误收 1。
    return [2] + [2 * k + 1 for k, is_prime in enumerate(sieve) if is_prime]
```
📝 记忆已更新,新增一条 'execution' 记录。

--- 第 2/3 轮迭代 ---

-> 正在进行反思...
🧠 正在调用 ZhipuAI/GLM-5.3-Flash 模型...
✅ 大语言模型响应成功:


不能判为"无需改进"。

- 时间复杂度:`O(n log log n)`;空间复杂度:`O(n)` 字节,奇数筛下约为 `n / 2` 字节。
- 阻断性错误:最后列表推导里的 `is_prime` 未定义,会直接 `NameError`;应改为判断 `sieve[k]`。
- 算法层面:当前已经是奇数版埃拉托斯特尼筛,不是试除法;对纯 Python 全量生成素数,通常没有更实用的渐进算法。线性筛 `O(n)`、Atkin/Pritchard 理论上更优,但 CPython 常数大,通常不划算。
- 实际瓶颈:大 `n` 时主要是 `O(n)` 连续内存、缓存压力和最终 Python 级过滤;更大规模应使用分段筛,空间降到约 `O(√n + segment)`,并用 `itertools.compress` / NumPy / bitarray 做 C 级提取。

最小修正与局部优化:

```python
import math
from itertools import compress


def find_primes(n):
    if not isinstance(n, int):
        raise TypeError("n 必须是整数")

    if n < 2:
        return []

    size = (n + 1) // 2
    sieve = bytearray([1]) * size
    sieve[0] = 0

    for i in range(3, math.isqrt(n) + 1, 2):
        if sieve[i // 2]:
            start = i * i // 2
            count = (size - start + i - 1) // i
            sieve[start::i] = bytearray(count)

    return [2, *compress(range(3, n + 1, 2), memoryview(sieve)[1:])]
```
📝 记忆已更新,新增一条 'reflection' 记录。

✅ 反思认为代码已无需改进,任务完成。

--- 任务完成 ---
最终生成的代码:
```python
```python
import math


def find_primes(n):
    """找出 1 到 n 之间所有的素数。

    采用针对 CPython 深度优化的埃拉托斯特尼筛法:

    - **奇数筛(wheel-2)**:偶数中仅 2 为素数,故只存储并筛选
      奇数,空间与标记工作量均减半;
    - **bytearray 存储**:每元素仅占 1 字节(布尔列表为 8 字节
      指针),缓存局部性更好;
    - **切片赋值向量化**:内层标记通过 ``sieve[start::i] =
      bytearray(count)`` 下沉到 C 层执行,消除纯 Python 逐元素
      循环的解释开销,实际速度提升约一个数量级;
    - **math.isqrt**:以整数平方根替代 ``int(n ** 0.5)``,
      避免大整数场景下的浮点精度偏差。

    时间复杂度 O(n log log n),空间复杂度 O(n / 2)。
    (渐近更优的线性筛在纯 Python 下因解释开销常慢于本实现,
    其优势主要体现在 C/NumPy 等环境,故此处未采用。)

    Args:
        n (int): 搜索范围的上界(包含 n 本身)。

    Returns:
        list[int]: 由 1 到 n 之间所有素数组成的升序列表。
            若 n 小于 2,则返回空列表。

    Raises:
        TypeError: 当 n 不是整数时抛出。

    Examples:
        >>> find_primes(10)
        [2, 3, 5, 7]
        >>> find_primes(1)
        []
        >>> find_primes(2)
        [2]
        >>> find_primes(30)
        [2, 3, 5, 7, 11, 13, 17, 19, 23, 29]
    """
    if not isinstance(n, int):
        raise TypeError("n 必须是整数")

    if n < 2:
        return []

    # sieve[k] 表示奇数 2*k + 1 是否为素数:
    # 索引 0 对应 1,索引 k 对应奇数 2*k + 1。
    size = (n + 1) // 2
    sieve = bytearray([1]) * size
    sieve[0] = 0  # 1 不是素数

    for i in range(3, math.isqrt(n) + 1, 2):
        if sieve[i // 2]:
            start = i * i // 2  # i*i 为奇数,其索引为 i*i // 2
            count = (size - start + i - 1) // i
            sieve[start::i] = bytearray(count)

    # sieve[0] 已置 0,enumerate 不会误收 1。
    return [2] + [2 * k + 1 for k, is_prime in enumerate(sieve) if is_prime]
```
```
可以看到,在第 2 轮迭代中,模型反思输出的是不能判为"无需改进" ,但是由于循环中仅将无需改进 关键词的出现判定为最优结果标识,导致循环提前结束,因此我们 Reflection 范式的工程实现还有很多不足之处,完善的 Agent 框架应当能够兼容和规避各种异常情况,这也是我们后续要做的事情。
除此之外,Reflection 机制是一种典型的"以成本换质量"的策略,它在提升解决质量的同时、在模型调用开销、任务执行延迟等方面都存在不同程度的增高。它非常适合那些对最终结果的质量、准确性和可靠性有极高要求,且对任务完成的实时性要求相对宽松的场景。