✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
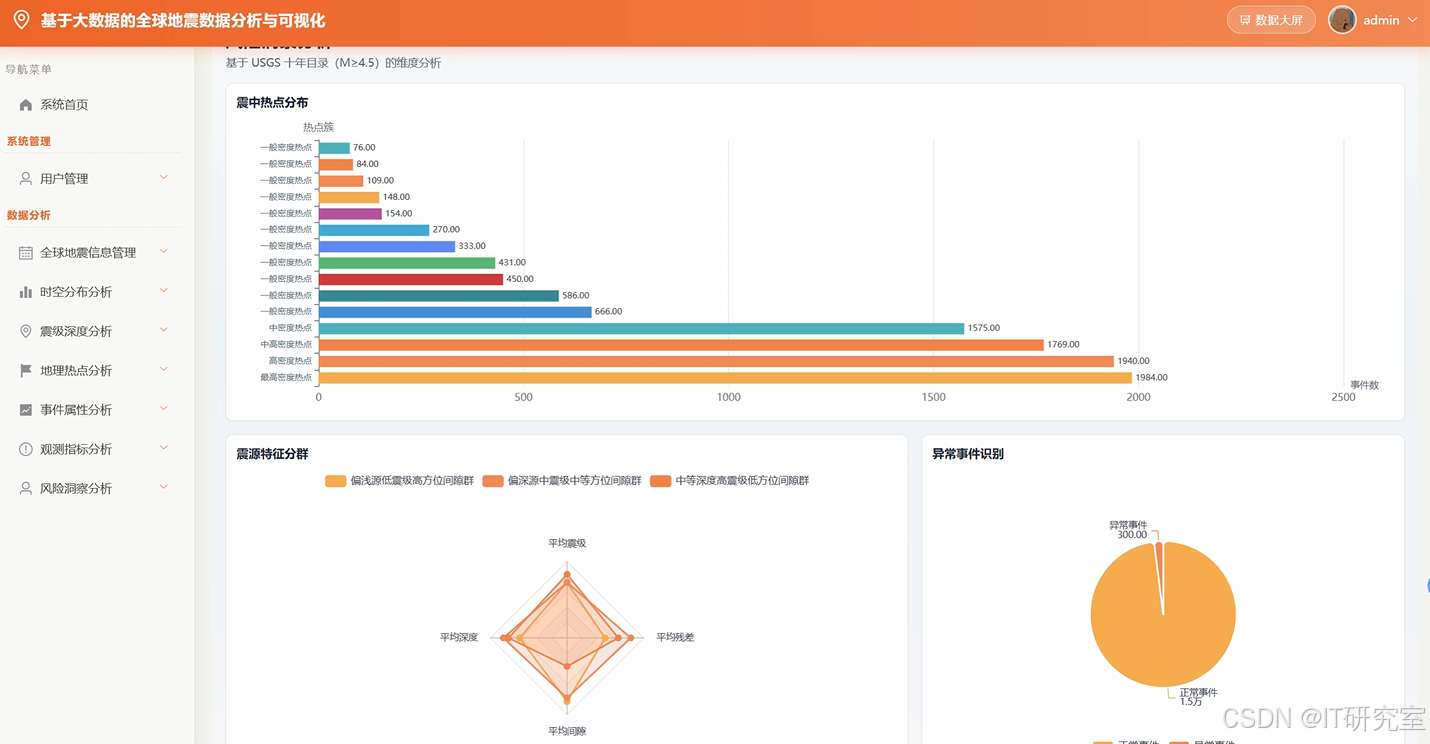
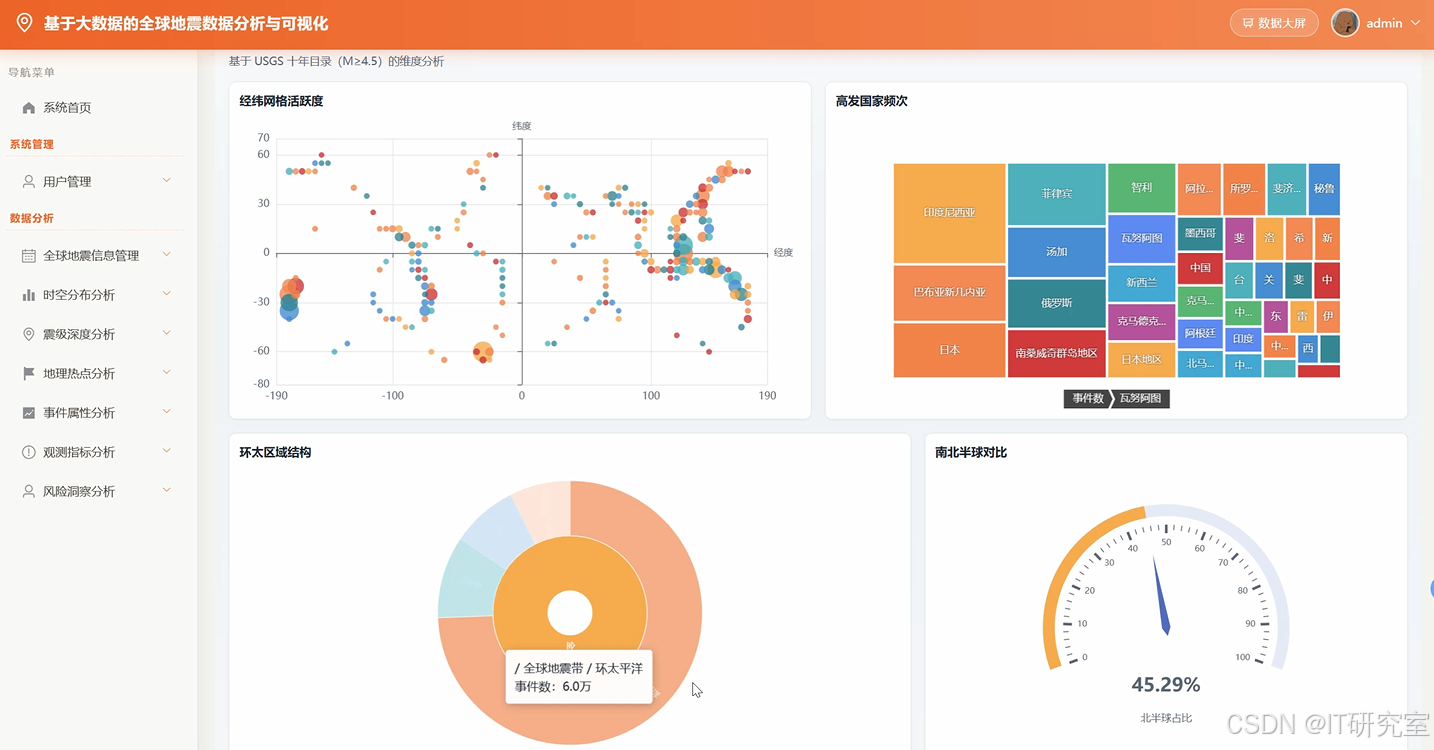
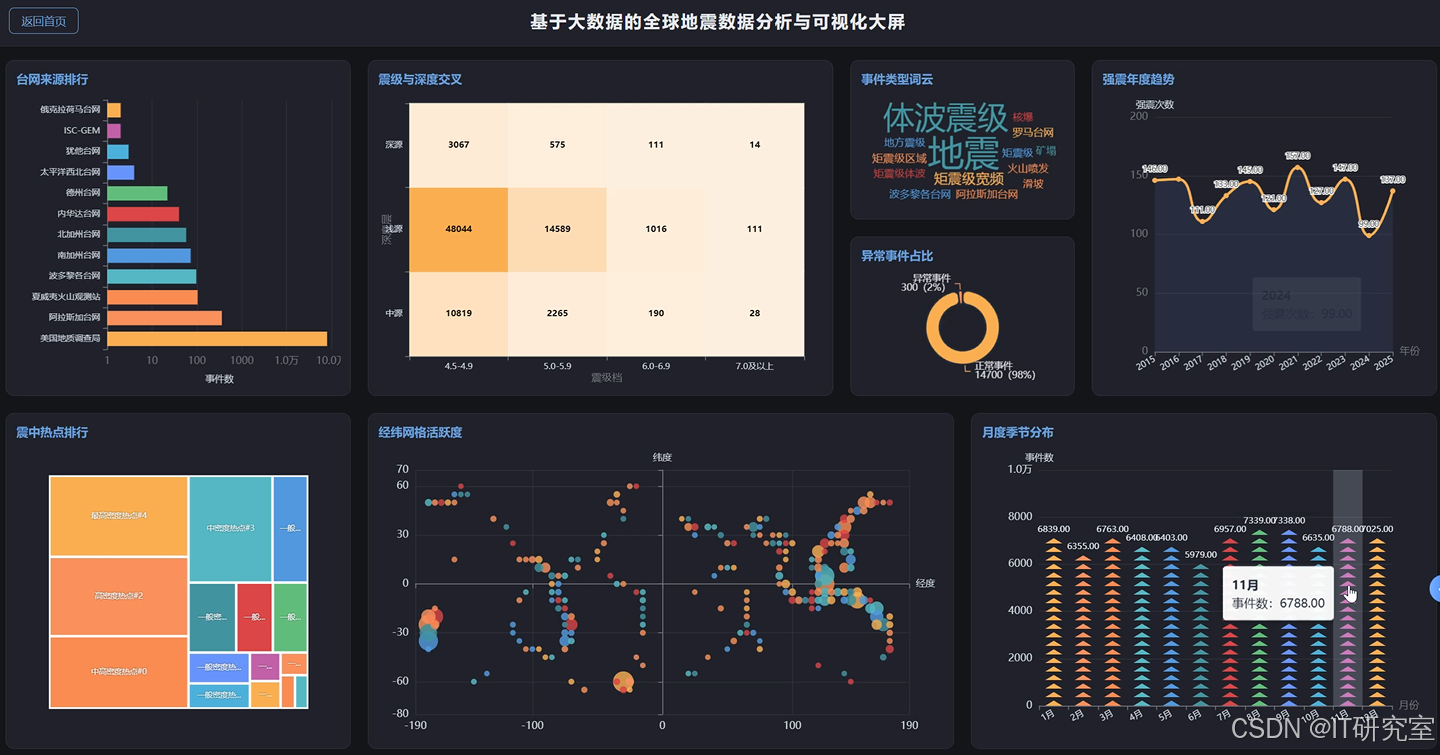
本系统名为《基于大数据的全球地震数据分析与可视化》,是一套面向全球地震观测数据的采集、存储、计算与可视化展示平台。系统以Hadoop与HDFS作为底层数据存储支撑,借助Spark与Spark SQL完成对海量地震记录数据的分布式计算与统计分析,并通过Pandas、NumPy对数据进行清洗与预处理。后端提供Python与Java两个版本,分别采用Django与Spring Boot框架实现业务接口与数据交互,前端采用Vue、ElementUI、Echarts、HTML、CSS、JavaScript与jQuery完成页面渲染与图表展示,数据库采用MySQL存储用户信息及分析结果。系统功能涵盖系统首页、用户管理、全球地震信息管理、时空分布分析、震级深度分析、地理热点分析、事件属性分析、观测指标分析与风险洞察分析等模块,能够从时间、空间、震级、深度、地理热点等多个维度对全球地震数据进行综合分析与可视化呈现,帮助使用者较为直观地了解全球地震活动的分布规律与特征。
选题背景
全球地震活动一直是人们比较关注的自然现象,每年世界各地都会发生大量不同震级的地震,这些地震数据被各国地震监测机构记录下来,形成了规模庞大的观测数据集。随着监测手段不断进步,地震数据的积累速度越来越快,单条记录虽然简单,但整体数据量已经达到了传统单机处理方式难以轻松应对的程度。以往很多地震分析系统只是把数据存进关系型数据库,做一些简单的查询和列表展示,面对上百万甚至更多的记录时,查询和统计的效率就会明显下降,也很难从时间、空间等多个角度去做深入的统计分析。Hadoop与Spark这类大数据技术的出现,为处理这种规模的数据提供了新的思路,把数据放到HDFS上存储,再用Spark做分布式计算,可以在可接受的时间内完成原本比较吃力的统计任务。在这样的情况下,把大数据技术应用到全球地震数据的分析与可视化中,就成为一个比较有实际价值的方向,本课题也正是围绕这一思路展开。
选题意义
从实际意义来看,本课题把Hadoop、Spark这些大数据技术用到了全球地震数据分析上,算是一次比较完整的工程实践。对使用者来说,系统可以把原本分散、数量庞大的地震记录整理成时空分布、震级深度、地理热点等多个角度的分析结果,并通过Echarts以图表形式展示出来,看数据的时候会更直观一些,不用再去翻大量原始表格。对计算机专业的学生来说,这个课题涉及数据存储、分布式计算、后端接口、前端可视化等多个环节,做完之后对大数据项目的基本流程会有更清楚的认识,也能把课堂上学到的知识真正串起来。从学习角度讲,本课题提供了一个相对完整的案例,可以作为后续类似数据分析项目的参考。当然,受限于个人能力和时间,系统在分析深度和功能完善程度上还有不少提升空间,目前只是对全球地震数据分析做了一次初步的尝试,离真正专业的分析平台还有距离,但作为毕业设计,它已经能够体现大数据技术在具体场景中的基本应用思路。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
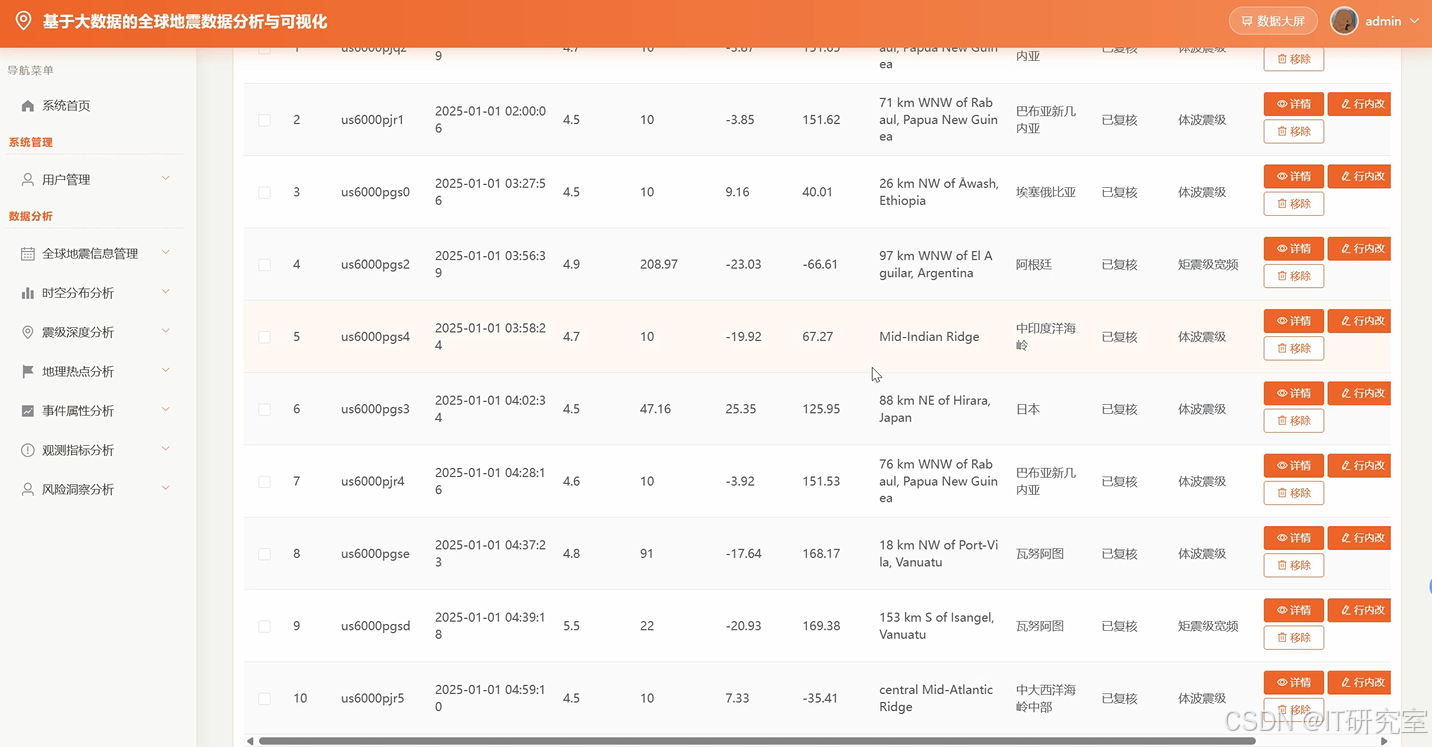
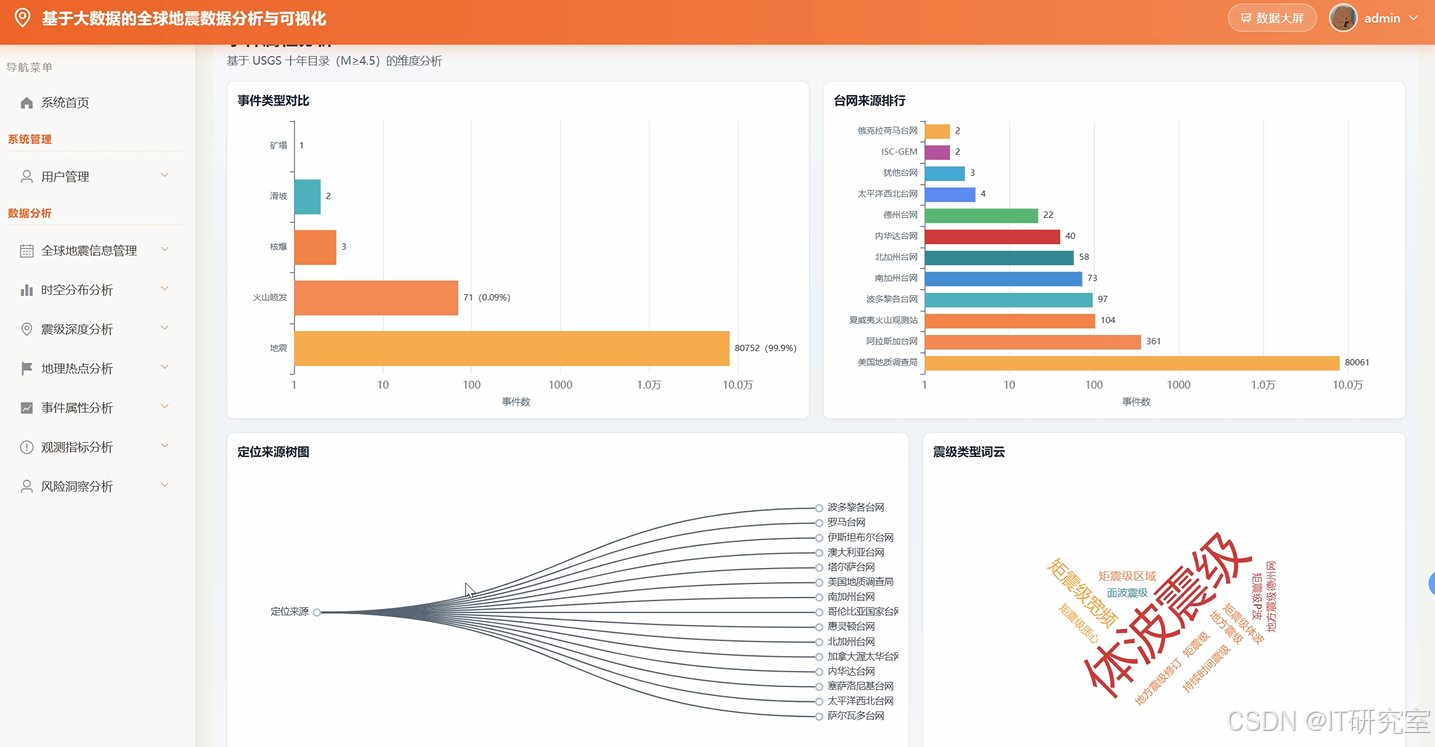
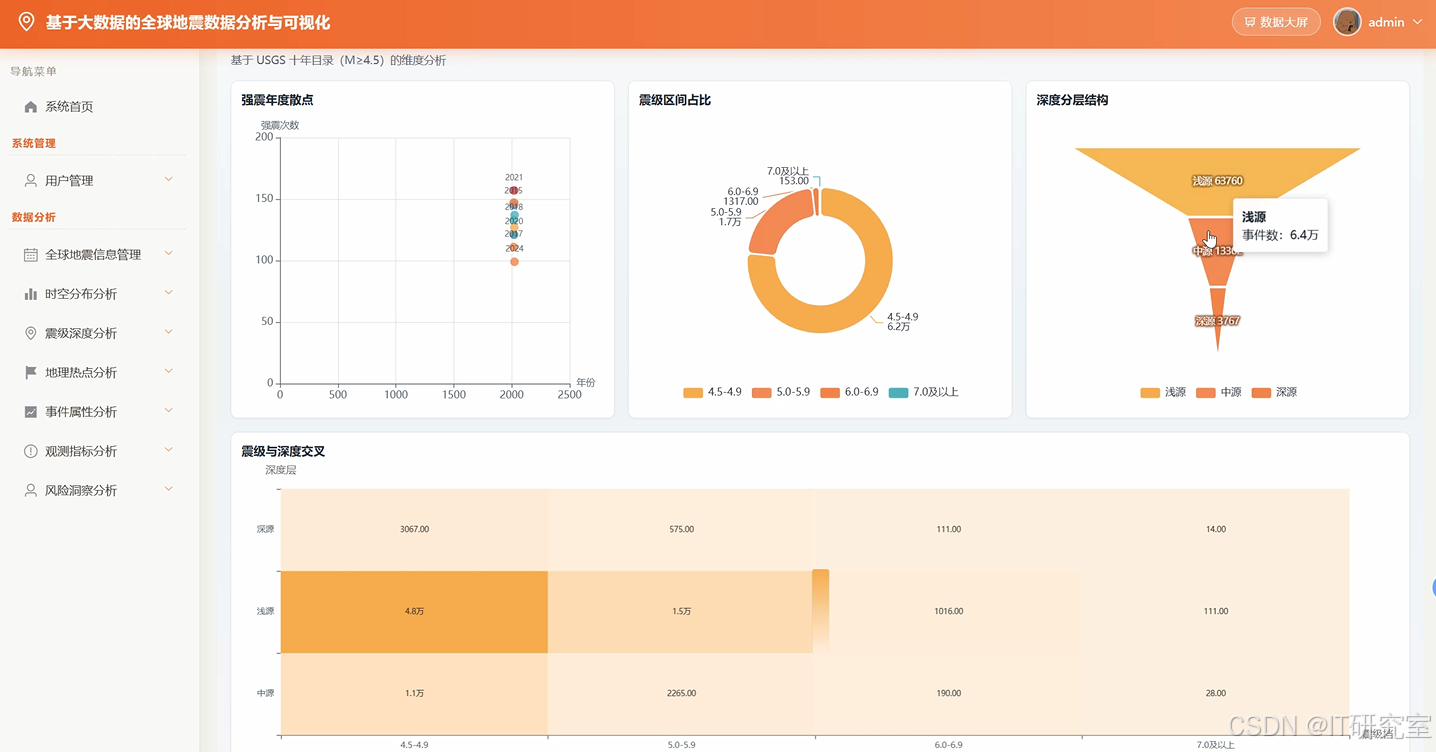
- 基于大数据的全球地震数据分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, avg, max, min, when, to_date, year, month
import pandas as pd
import numpy as np
import json
import requests

spark = SparkSession.builder.appName("GlobalEarthquakeAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()

def load_earthquake_data(file_path):
    df = spark.read.option("header", "true").option("inferSchema", "true").csv(file_path)
    df = df.withColumn("time", to_date(col("time")))
    df = df.withColumn("year", year(col("time")))
    df = df.withColumn("month", month(col("time")))
    df = df.filter(col("latitude").isNotNull() & col("longitude").isNotNull())
    df = df.filter(col("magnitude").isNotNull() & col("depth").isNotNull())
    df = df.withColumn("mag_level", when(col("magnitude") < 3, "微震").when(col("magnitude") < 5, "小震").when(col("magnitude") < 7, "中强震").otherwise("强震"))
    df.cache()
    df.createOrReplaceTempView("earthquake_table")
    return df

def spatiotemporal_analysis(df):
    time_dist = df.groupBy("year", "month").agg(count("*").alias("quake_count"), avg("magnitude").alias("avg_mag"), max("magnitude").alias("max_mag")).orderBy("year", "month")
    space_dist = df.groupBy("latitude", "longitude").agg(count("*").alias("point_count"), avg("magnitude").alias("avg_mag")).filter(col("point_count") > 1)
    heat_data = space_dist.select("latitude", "longitude", "point_count").toPandas()
    heat_list = heat_data.to_dict(orient="records")
    time_result = time_dist.toPandas().to_dict(orient="records")
    return {"time_distribution": time_result, "heat_points": heat_list}

def magnitude_depth_analysis(df):
    mag_stats = df.groupBy("mag_level").agg(count("*").alias("total"), avg("depth").alias("avg_depth"), avg("magnitude").alias("avg_mag"), min("magnitude").alias("min_mag"), max("magnitude").alias("max_mag"))
    depth_range = df.withColumn("depth_level", when(col("depth") < 70, "浅源").when(col("depth") < 300, "中源").otherwise("深源"))
    depth_stats = depth_range.groupBy("depth_level", "mag_level").agg(count("*").alias("cnt"), avg("magnitude").alias("avg_mag")).orderBy("depth_level", "mag_level")
    corr_data = df.select("magnitude", "depth").toPandas()
    corr_value = corr_data["magnitude"].corr(corr_data["depth"])
    mag_result = mag_stats.toPandas().to_dict(orient="records")
    depth_result = depth_stats.toPandas().to_dict(orient="records")
    return {"magnitude_stats": mag_result, "depth_stats": depth_result, "correlation": round(float(corr_value), 4)}

def geographic_hotspot_analysis(df):
    grid_df = df.withColumn("lat_grid", (col("latitude") * 10).cast("int") / 10).withColumn("lon_grid", (col("longitude") * 10).cast("int") / 10)
    hotspot = grid_df.groupBy("lat_grid", "lon_grid").agg(count("*").alias("quake_count"), avg("magnitude").alias("avg_mag"), max("magnitude").alias("max_mag")).filter(col("quake_count") >= 3).orderBy(col("quake_count").desc())
    top_hotspot = hotspot.limit(50).toPandas().to_dict(orient="records")
    region_stats = df.withColumn("region", when((col("latitude") > -60) & (col("latitude") < 60), "低纬区域").otherwise("高纬区域")).groupBy("region").agg(count("*").alias("cnt"), avg("magnitude").alias("avg_mag"))
    region_result = region_stats.toPandas().to_dict(orient="records")
    return {"hotspot_grids": top_hotspot, "region_stats": region_result}
五、系统视频
基于大数据的全球地震数据分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的全球地震数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇