文章目录
卷积核的理解
我直接画一个像素级小例子,你一看就明白它不是"放大感受野"。
1×1 卷积
假设输入特征图是 2×2×3,也就是 2×2 的空间位置,每个位置有 3 个通道:
r
位置(0,0): [a1, a2, a3]
位置(0,1): [b1, b2, b3]
位置(1,0): [c1, c2, c3]
位置(1,1): [d1, d2, d3]
现在用一个 1×1 卷积 ,把 3 通道变成 2 通道。
并列列出两个独立的卷积核,每个核单独生成一个输出通道。
- 卷积核 #1 :
[w1, w2, w3]→ 生成输出的第 1 个通道 - 卷积核 #2 :
[u1, u2, u3]→ 生成输出的第 2 个通道
注意:它没有空间尺寸,只有通道权重。
计算过程
对位置 (0,0):
r
输出(0,0) 第1通道 = a1*w1 + a2*w2 + a3*w3
输出(0,0) 第2通道 = a1*u1 + a2*u2 + a3*u3
对位置 (0,1):
r
输出(0,1) 第1通道 = b1*w1 + b2*w2 + b3*w3
输出(0,1) 第2通道 = b1*u1 + b2*u2 + b3*u3看到了吗?每个位置只用自己的通道值,不看邻居像素。
所以:
- 位置 (0,0) 的输出只来自 (0,0) 的输入;
- 位置 (0,1) 的输出只来自 (0,1) 的输入;
- 没有任何"扩大感受野"的事情发生。
它真正在做什么
在每个像素位置上,把 3 个通道的值做一次加权求和,变成 2 个新通道。
就像:
r
旧通道1 = 边缘特征
旧通道2 = 颜色特征
旧通道3 = 纹理特征

新通道1 = 0.3×边缘 + 0.5×颜色 + 0.2×纹理
新通道2 = 0.7×边缘 - 0.1×颜色 + 0.4×纹理它在混合通道信息 ,不是在扩大空间视野。
3x3卷积
3×3 卷积干的事和 1×1 完全不一样:1×1 管"通道怎么混合",3×3 管"空间上怎么聚合"。它会在每个像素周围看 3×3 的邻居,把局部空间信息合成一个新特征。
直观例子:检测"竖直边缘"
假设输入是一张灰度图,像素值 0 表示黑,255 表示白:
r
输入局部区域(5×5):

  0   0   0   255  255
  0   0   0   255  255
  0   0   0   255  255
  0   0   0   255  255
  0   0   0   255  255
中间有一条竖直边缘,左边黑,右边白。
现在用一个 3×3 卷积核来检测竖直边缘:
r
卷积核(竖边检测器):

 -1   0   1
 -1   0   1
 -1   0   1
滑动计算
把卷积核对准输入上每个 3×3 区域,做加权求和。
比如对准左上角那个 3×3 区域:
r
输入区域:           卷积核:
 0   0   0           -1   0   1
 0   0   0           -1   0   1
 0   0   0           -1   0   1

加权和 = 0×(-1) + 0×0 + 0×1
       + 0×(-1) + 0×0 + 0×1
       + 0×(-1) + 0×0 + 0×1
       = 0
输出是 0,说明这里没有竖边。
再对准中间跨边缘的那个 3×3 区域:
r
输入区域:           卷积核:
 0   0   255         -1   0   1
 0   0   255         -1   0   1
 0   0   255         -1   0   1

加权和 = 0×(-1) + 0×0 + 255×1
       + 0×(-1) + 0×0 + 255×1
       + 0×(-1) + 0×0 + 255×1
       = 765
输出很大,说明这里检测到了竖边。
把所有位置的输出拼起来,就得到一张边缘响应图:边缘位置值大,平坦区域值小。
3×3 卷积在 CNN 里的实际作用
| 作用 | 说明 |
|---|---|
| 提取局部空间特征 | 边缘、角点、纹理、局部形状 |
| 扩大感受野 | 每加一层 3×3,感受野就向外扩一圈 |
| 层级组合 | 浅层看边缘,中层看纹理/部件,深层看整体物体 |
| 保持空间分辨率 | 配合 padding 可以保持 H×W 不变 |
3 x 3 和 1×1 对比
| 1×1 卷积 | 3×3 卷积 | |
|---|---|---|
| 看的范围 | 只看当前像素的所有通道 | 看当前像素 + 周围 8 个邻居 |
| 感受野 | 1×1,不扩大 | 3×3,扩大空间视野 |
| 主要作用 | 通道混合、升维/降维 | 空间特征提取 |
| 典型用法 | Bottleneck 里压缩/恢复通道 | 残差块主路径里提取特征 |
一句话总结
3×3 卷积是在每个像素位置上,把它自己和周围 8 个邻居的像素值做一次加权求和,从而提取局部空间模式(比如边缘、纹理)。1×1 卷积不看邻居,只混合通道;3×3 卷积看邻居,提取空间特征。两者配合起来,一个管"通道怎么组合",一个管"空间长什么样"。
反卷积/转置卷积
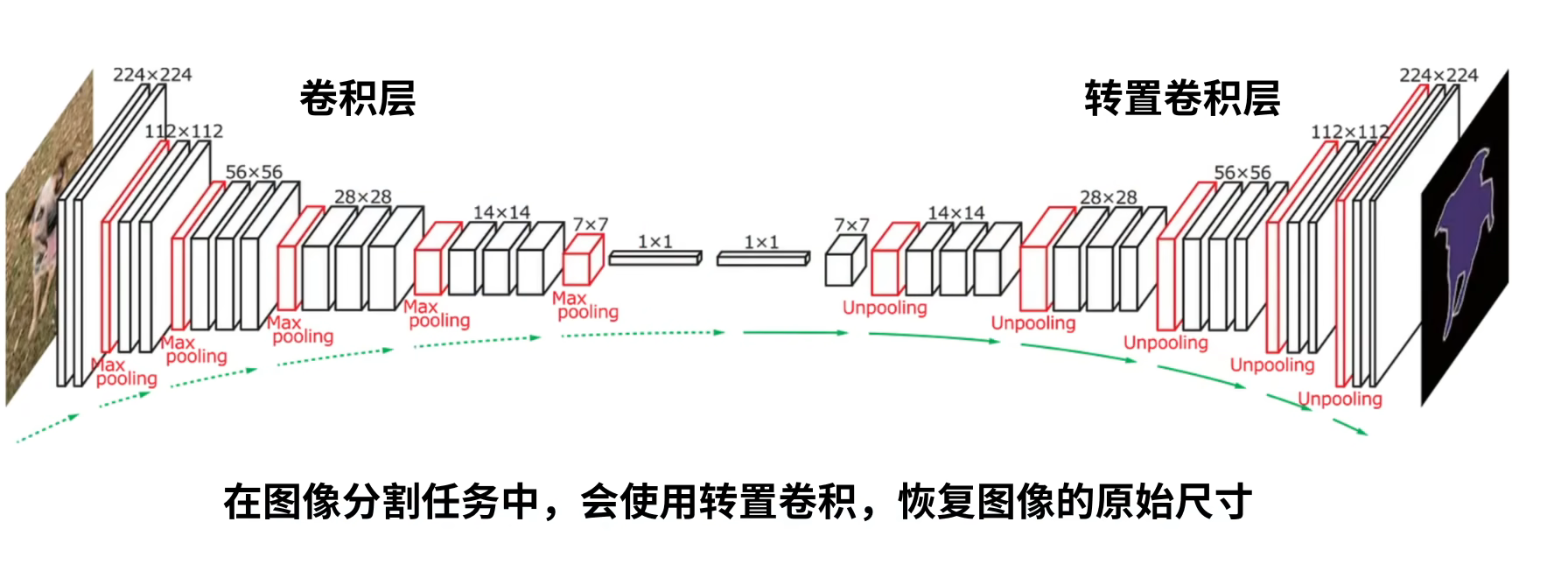
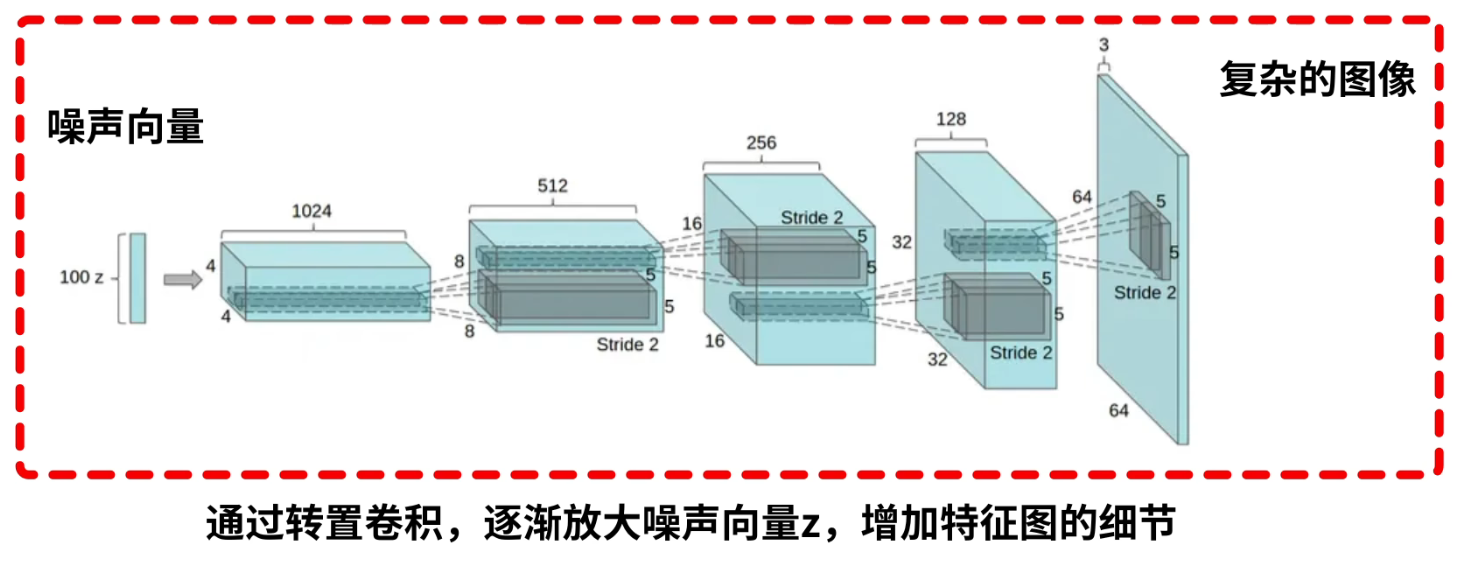
反卷积在深度学习里主要做一件事:把小尺寸特征图放大成大尺寸特征图 ,也就是"可学习上采样"。
它不是把卷积真正"倒回去",不能把被卷积破坏的像素原样恢复,只是让输出尺寸变大。
我的理解就算,在一个图中发现了某一个人,并不是很明显,经过反卷积明显之后,放大,像是电影那种感觉。
它主要用在这些地方
| 场景 | 作用 | 例子 |
|---|---|---|
| 语义分割 | 把网络压缩后的特征图放大回原图尺寸,做像素级分类 | FCN、U-Net 的解码器部分常用它 |
| 图像生成 | 把噪声向量或低分辨率特征逐步放大成完整图像 | GAN 生成器里常用 |
| 超分辨率 | 把低分辨率图像放大成高分辨率图像 | 图像放大、细节增强 |
| 医学影像 | 提升 CT、MRI 等影像的分辨率 | 辅助分割、重建、诊断 |
| 特征可视化 | 把高层特征图还原到像素空间,看网络关注哪里 | 早期反卷积网络用于可视化 |
为什么不用普通上采样?
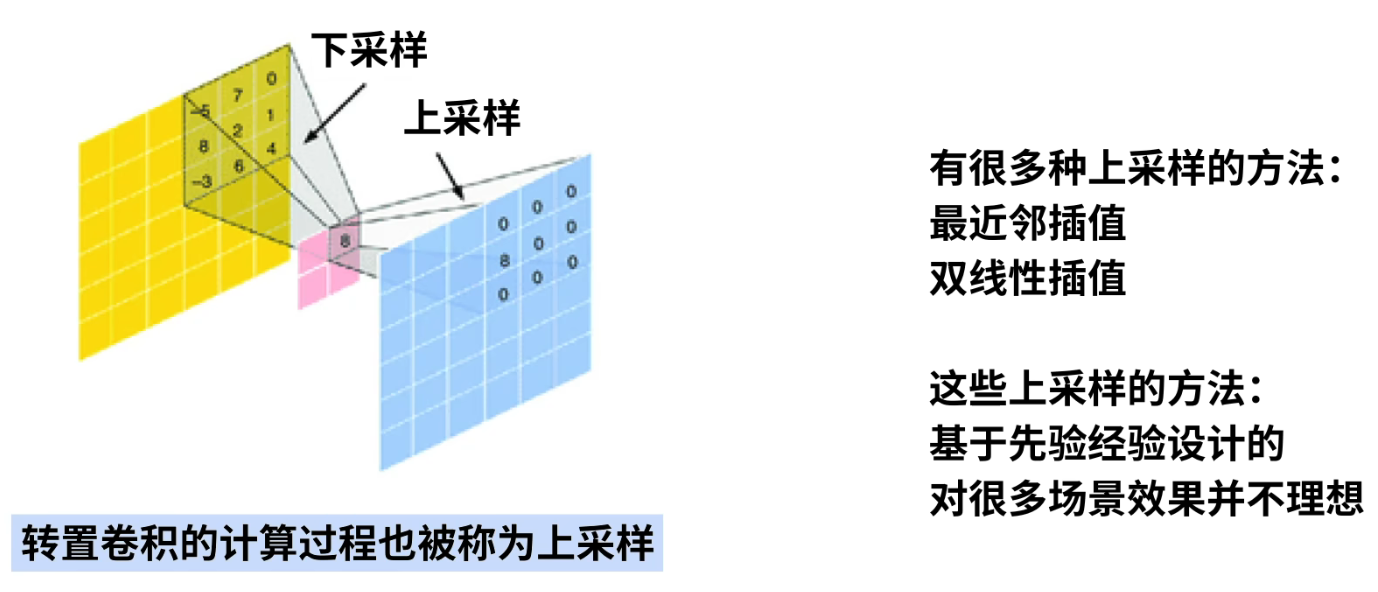
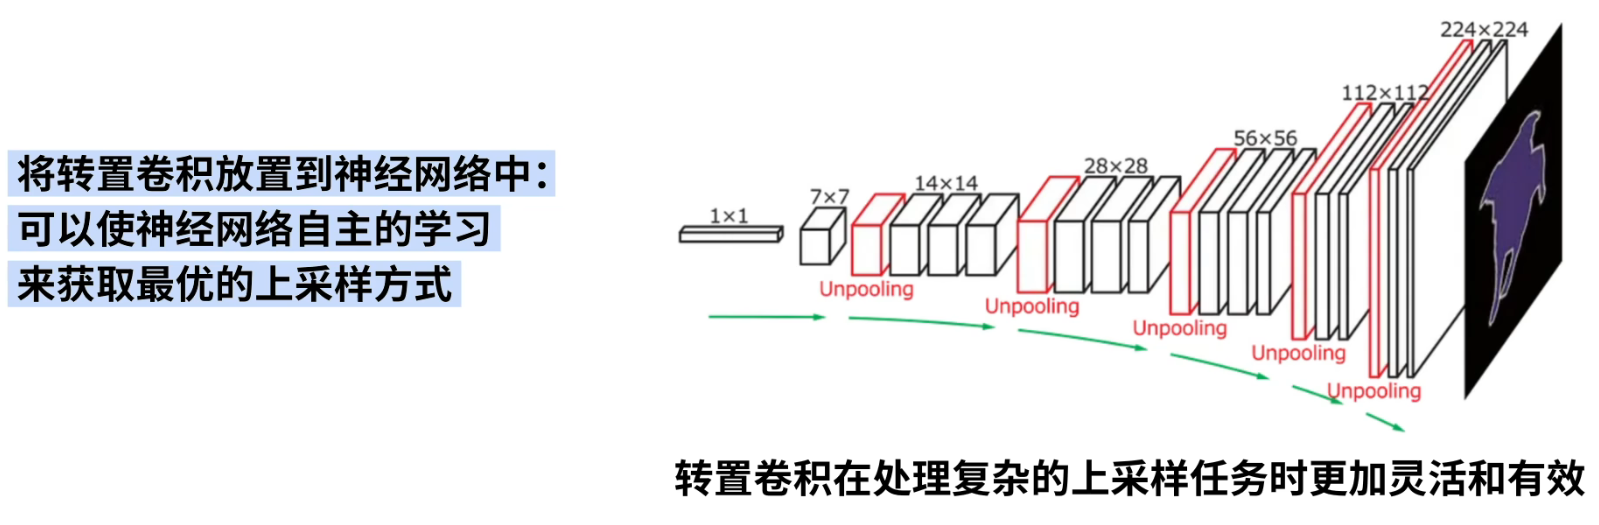
普通上采样比如最近邻、双线性插值,参数是固定的,只能按规则放大。
反卷积/转置卷积的卷积核是可学习的,网络可以自己学"怎么放大更合适"。
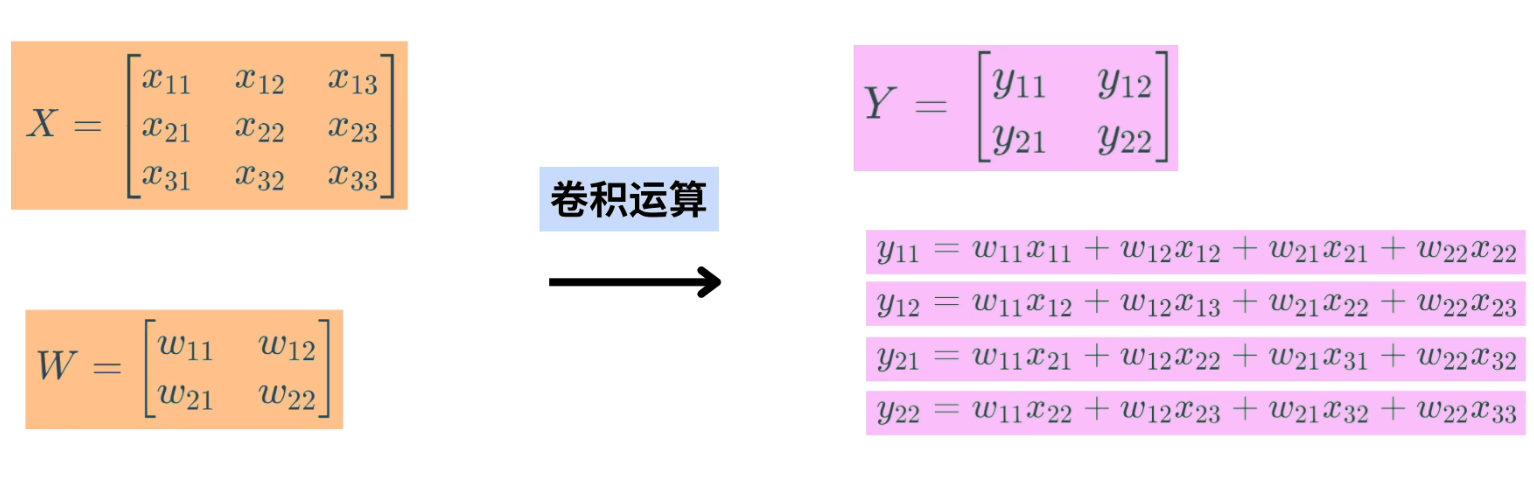
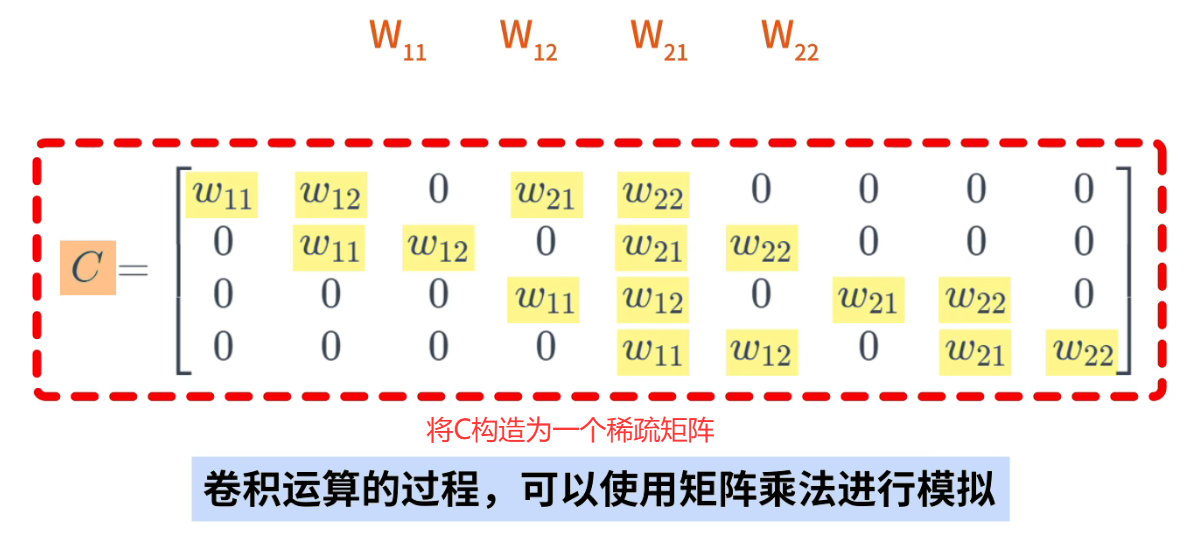
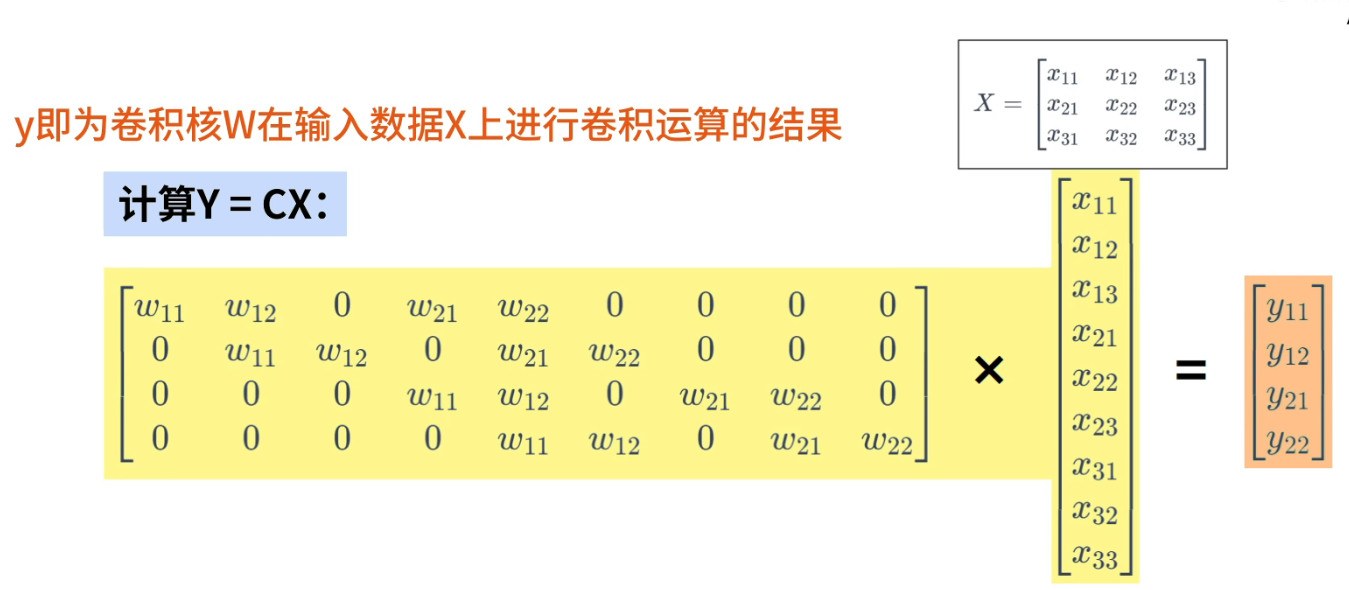
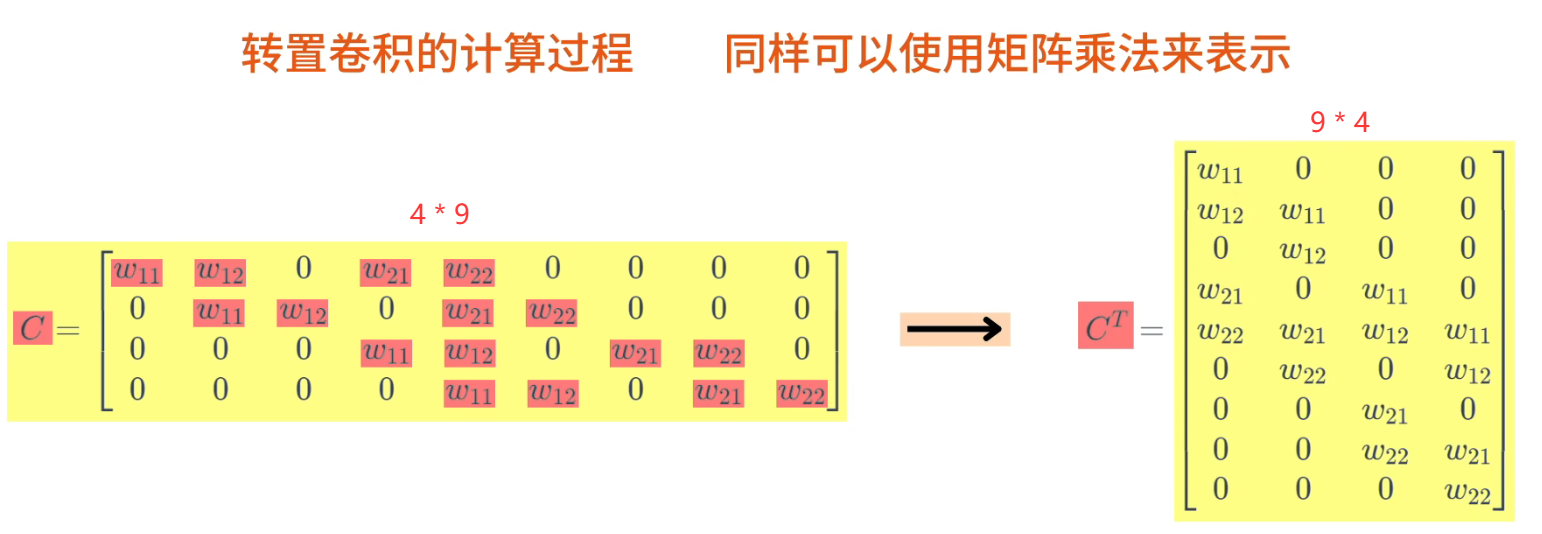
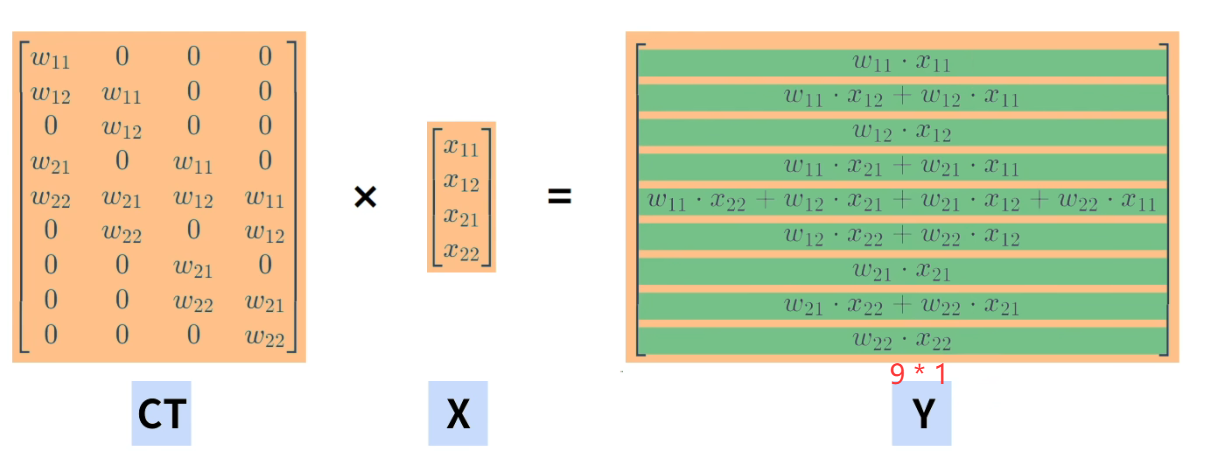
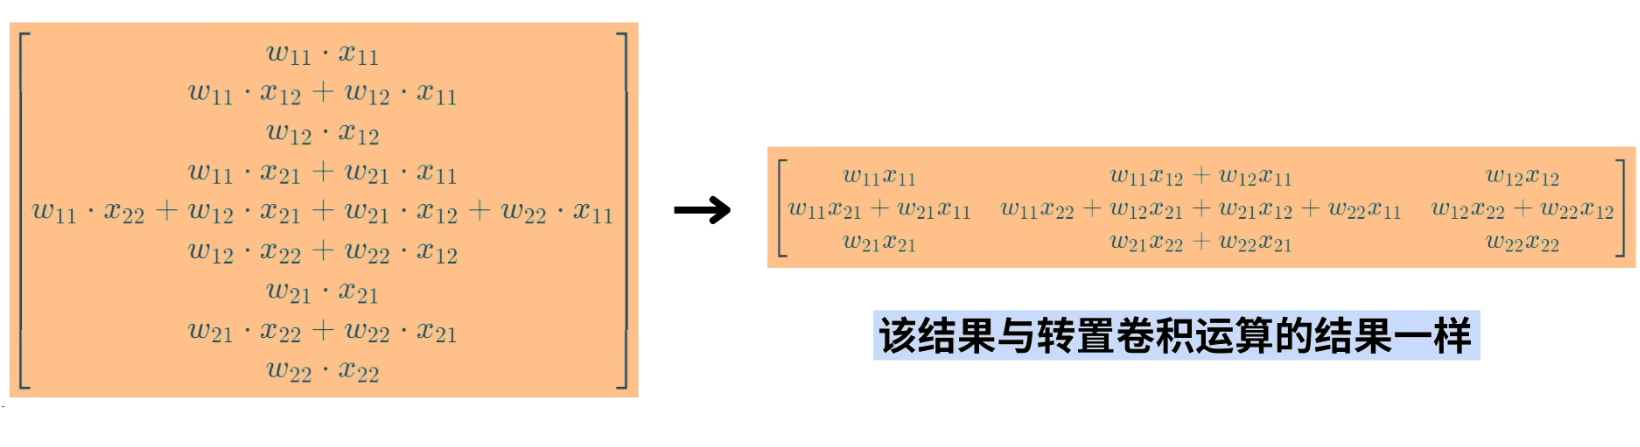
转置卷积的计算方法
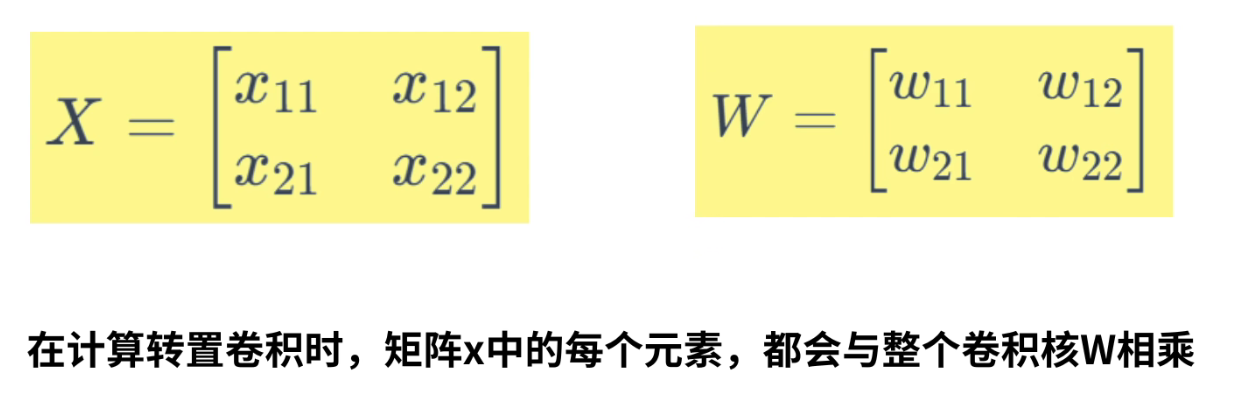
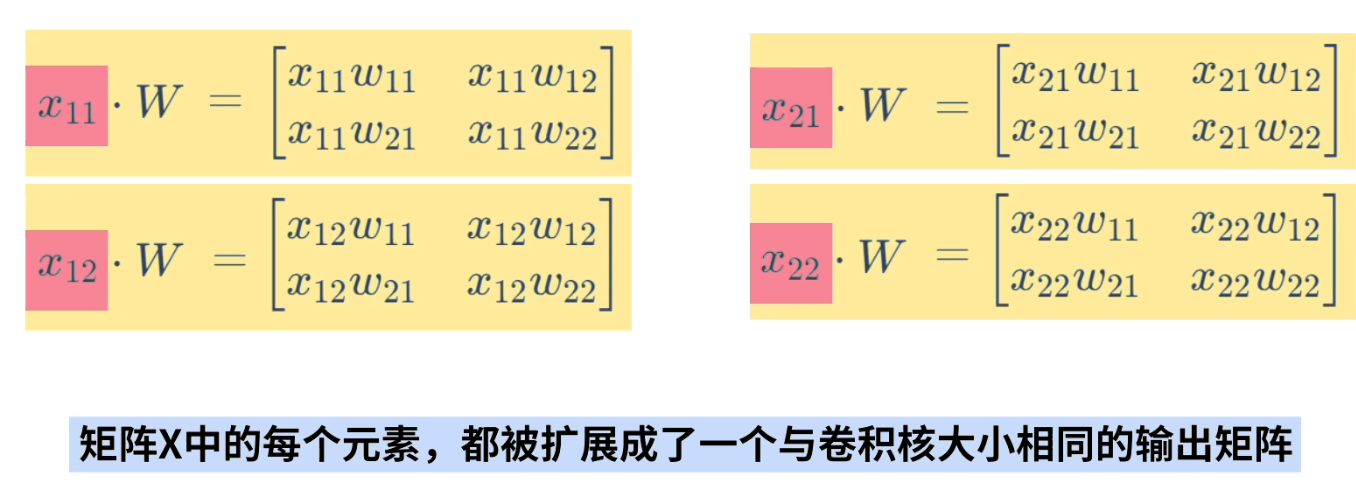
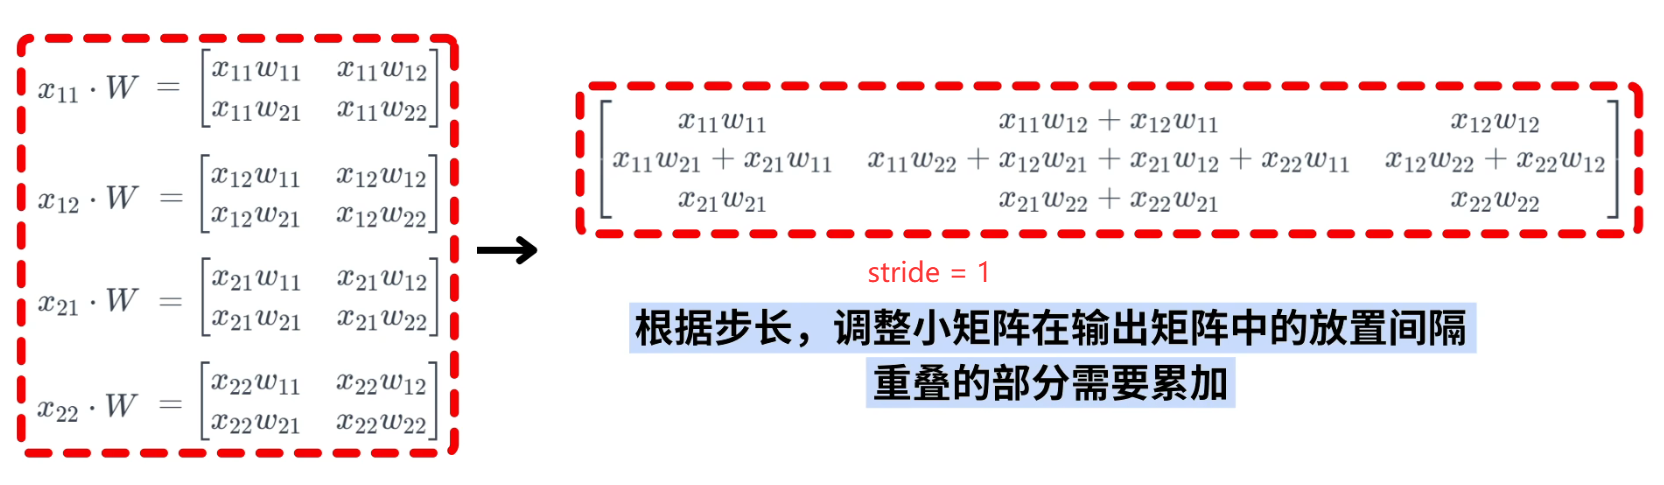
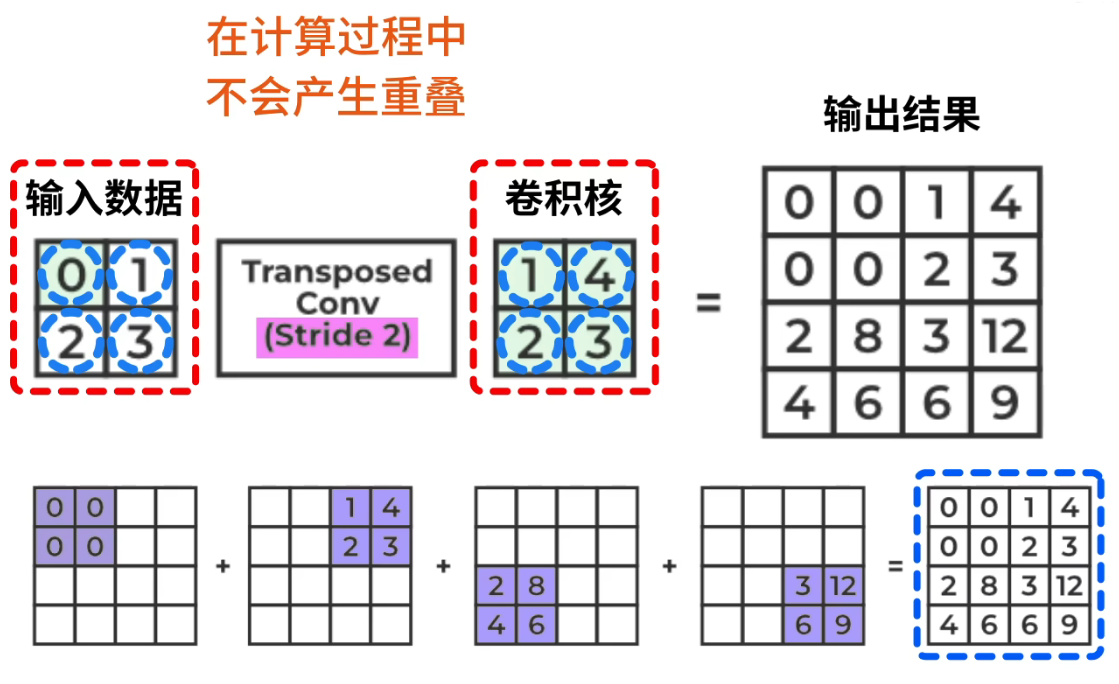
基于矩阵乘法理解
一句话总结
反卷积/转置卷积就是带参数的放大层:普通卷积把图像越做越小,反卷积把它越做越大;它最常用于分割、生成、超分和医学影像恢复,但它只能恢复尺寸,不能真正还原卷积丢失的信息。