开篇介绍:
hello 大家,那么在大家学习完了Redis的单线程模型之后,我们接下来就要再进一步的学习Redis的相关知识点,首当其冲的就是string类型,所以,接下来我们就来学习一下Redis中的string类型。
作为 Redis最基础、最核心、使用频率最高的数据类型,String 类型是所有 Redis 使用者的入门必修课,更是后续学习 list、hash、set、zset 的基础 ------Redis 中所有键的类型都是 String,其他四种数据结构的元素也均为 String 类型。
在这最上面,给大家讲一下,如何在Redis命令行客户端中实现get汉字是不出现16进制,而是纯正的汉字,那这就需要大家在redis-cli的时候,后面加上--raw,即:
bash
redis-cli --raw一、Redis String 类型的核心基础认知:你必须先懂的底层特性
在学习命令和场景之前,我们首先要搞清楚Redis 的 String 到底是什么 、有哪些关键特性,这是理解后续所有内容的前提,也是避开使用误区的关键。
1.1 不是普通字符串:Redis String 的本质定义
Redis 中的 String 类型并非传统编程语言中的字符串(如 Java 的 String、C++ 的 std::string) ,而是一种动态的二进制字节数组。
简单来说,Redis 不关心你存的是什么数据,它只把数据当作二进制流来存储和读取 ------ 这也是 Redis String 最核心的特性来源。
官方对 String 类型的定义有两个关键要点:
- 存储的值可以是字符串 (普通文本、JSON/XML 格式、任意字符集)、数字 (整型、浮点型)、二进制流(图片、音频、视频、序列化对象等);
- 单个 String 类型值的最大容量为 512MB,满足绝大多数业务的存储需求。
1.2 核心特性 1:二进制安全,不处理字符集编码
这是 Redis String 最易被忽略但极其重要的特性,也是它能存储任意二进制数据的原因。
- 二进制安全:指 Redis 在存储和读取数据时,不会对数据的二进制内容做任何修改、解析,输入什么二进制流,输出就是什么二进制流,不会因为遇到
\0(空字符)就截断数据(而 C 语言的字符串会以\0作为结束标识); - 不处理字符集编码:Redis 服务端不会对客户端传入的字符串做任何编码 / 解码操作,客户端用什么字符集(如 UTF-8、GBK、GB2312)编码,Redis 就原封不动存储,后续读取时也由客户端自行解码。
通俗举例:你用 Java 客户端以 UTF-8 编码将中文 "Redis 字符串" 存入 Redis,Redis 只会存储该字符串对应的 UTF-8 二进制流;如果后续用 Python 客户端以 GBK 解码读取,就会出现乱码 ------ 这是客户端编码不一致的问题,与 Redis 无关。
1.3 核心特性 2:Redis 中所有键都是 String 类型
Redis 是键值对数据库,其中键(Key)的类型固定为 String,而值(Value)可以是 String、list、hash 等五种数据类型。
这意味着:
- 无论你的值是哪种类型,键都必须是符合 String 规范的字符串(如
user:1001、video:play:5253); - 键的命名没有强制语法限制(仅不能包含少数特殊字符如
\0),但合理的键名设计是 Redis 使用的基础(后续实战部分会详细讲键名设计规范)。
1.4 核心特性 3:值的灵活存储,支持数字原生操作
Redis String 可以存储数字(整型 / 浮点型),并且提供了incr/decr/incrbyfloat等原生数字操作命令,无需客户端先读取、再计算、最后写入,直接在服务端完成原子性操作 ------ 这也是 Redis 能高效实现计数功能的核心原因。
需要注意的是:Redis 存储数字时,并非直接存为数值类型,而是先以字符串形式存储,再通过内部编码优化为整型(后续内部编码部分详细讲),但对开发者来说,这个过程是完全透明的,我们可以直接对存储的数字执行自增 / 自减操作。
1.5 一张表总结 Redis String 的基础特性
| 特性 | 具体说明 | 核心价值 |
|---|---|---|
| 二进制安全 | 按二进制流存储,不修改、不解析数据,不处理编码 | 支持存储任意数据(文本、数字、二进制流) |
| 键固定为 String | 所有 Redis 键都是 String 类型,值支持多类型 | 统一键的规范,为其他数据结构奠定基础 |
| 最大 512MB | 单个 String 值的最大容量为 512MB | 满足绝大多数业务的存储需求 |
| 支持数字原生操作 | 提供原子性的自增 / 自减 / 浮点运算命令 | 高效实现计数、累加等业务场景 |
| 动态存储 | 可根据存储内容自动调整内部编码 | 平衡内存占用和操作性能 |
二、Redis String 类型的核心命令:分模块深度解析,附使用场景与示例
Redis 为 String 类型提供了丰富且灵活的命令体系,覆盖基础增删查改、批量操作、数字计数、字符串操作四大类,所有命令的时间复杂度均为 O (1)(批量操作为 O (N),N 为键的数量),性能极致。
2.1 基础增删查改命令:SET/GET/DEL,String 类型的入门三板斧
这是 String 类型最基础的命令,也是使用频率最高的命令,其中SET命令支持多个核心选项,功能远超 "简单设置值",是 Redis String 的核心命令。
2.1.1 SET:设置键值对,支持过期、条件设置
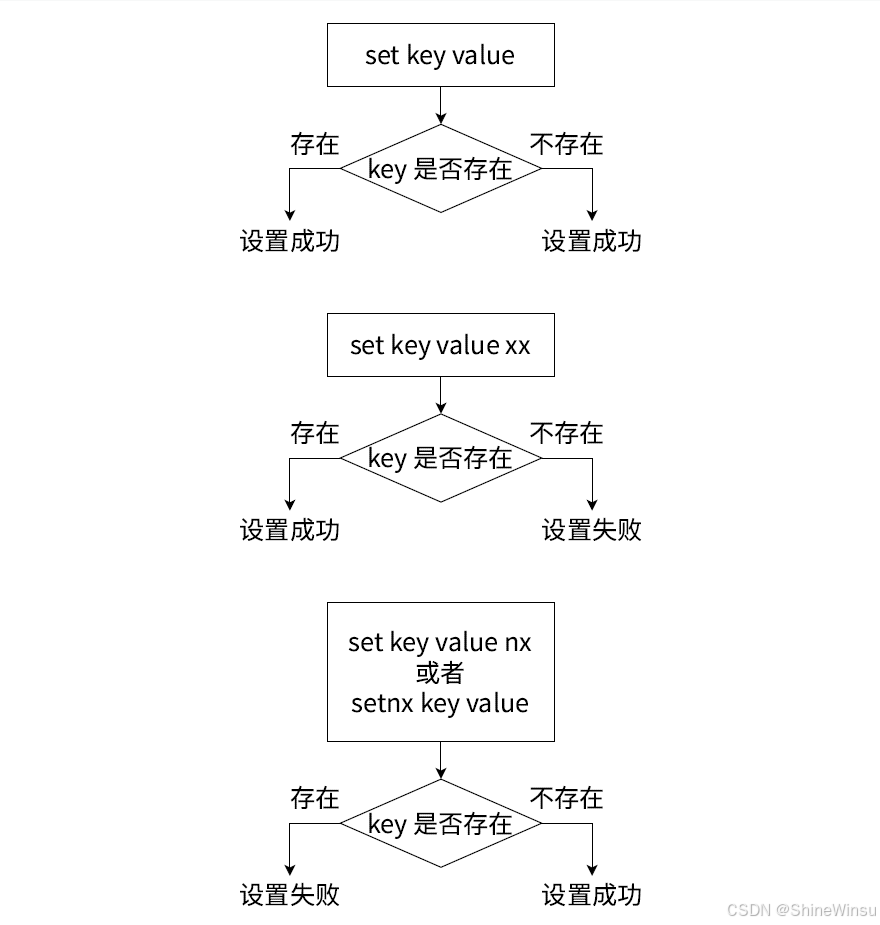
核心作用 :将 String 类型的 value 关联到 key,如果 key 已存在,直接覆盖原有值(无论原有值是什么数据类型),且该 key 的过期时间(TTL)会被清空。
语法 :SET key value [EX seconds] [PX milliseconds] [NX|XX]
有效版本:1.0.0+
时间复杂度:O(1)
核心选项(重点):Redis 的 SET 命令通过选项实现了 SETNX、SETEX、PSETEX 等命令的功能,官方后续可能合并这些单独命令,推荐优先使用带选项的 SET:
EX seconds:为 key 设置秒级过期时间,等价于SETEX命令;PX milliseconds:为 key 设置毫秒级过期时间,等价于PSETEX命令;NX:仅当 key 不存在时才设置值,要是原先该key值存在,那么就不会设置新的值(value)去覆盖原来的值(value),等价于SETNX命令,核心用于实现分布式锁;XX:仅当 key 存在时才设置值,要是原先该key值不存在,那么就不会设置值,核心用于实现安全更新,避免创建不存在的 key。
返回值:
- 设置成功:返回
OK; - 条件不满足(NX/XX):返回
(nil),不执行任何操作。
实操示例:覆盖原有值、条件设置、过期设置全场景
bash
# 1. 基础设置:key不存在,设置成功
127.0.0.1:6379> EXISTS mykey  # 检查key是否存在
(integer) 0
127.0.0.1:6379> SET mykey "Hello Redis"
OK
127.0.0.1:6379> GET mykey
"Hello Redis"

# 2. NX选项:key已存在,设置失败
127.0.0.1:6379> SET mykey "Hello World" NX
(nil)

# 3. XX选项:删除key后,key不存在,设置失败
127.0.0.1:6379> DEL mykey
(integer) 1
127.0.0.1:6379> SET mykey "Hello World" XX
(nil)

# 4. NX选项:key不存在,设置成功
127.0.0.1:6379> SET mykey "Hello World" NX
OK

# 5. EX选项:设置值并指定10秒过期
127.0.0.1:6379> SET mykey "Expire in 10s" EX 10
OK
127.0.0.1:6379> GET mykey  # 10秒内读取
"Expire in 10s"
127.0.0.1:6379> GET mykey  # 10秒后读取,key已过期
(nil)

# 6. 组合选项:NX+EX,key不存在时设置值并过期,分布式锁核心用法
127.0.0.1:6379> SET lock:order 1 NX EX 30
OK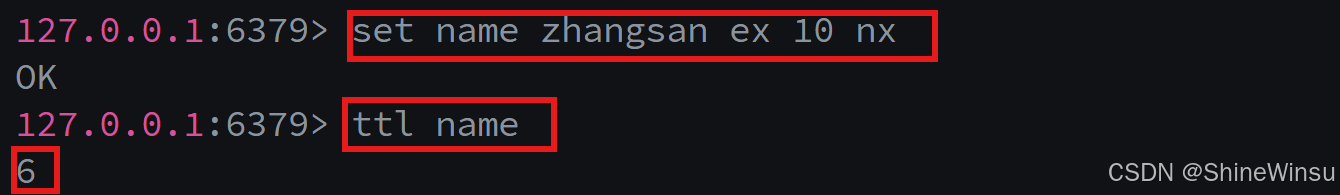
核心使用场景:
- 基础的键值对存储:如缓存用户昵称、商品名称;
- 分布式锁:
SET key value NX EX seconds(最经典的 Redis 分布式锁实现,后续实战部分详细讲); - 安全更新:
SET key value XX,仅更新已存在的 key,避免误创建; - 带过期时间的缓存:
SET key value EX/PX,无需单独执行EXPIRE命令,减少网络请求。
2.1.2 GET:获取键对应的值,类型校验
核心作用 :获取指定 key 对应的 String 值,若 key 不存在返回nil,若 key 的值不是 String 类型(如 list、hash),直接报错。
语法 :GET key
有效版本:1.0.0+
时间复杂度:O(1)
返回值:
- key 存在且为 String 类型:返回对应 value;
- key 不存在:返回
(nil); - key 的值非 String 类型:返回
WRONGTYPE错误。
实操示例:基础读取、不存在、类型错误场景
bash
# 1. key不存在,返回nil
127.0.0.1:6379> GET nonexist_key
(nil)

# 2. key存在且为String类型,返回值
127.0.0.1:6379> SET mykey "Hello Redis"
OK
127.0.0.1:6379> GET mykey
"Hello Redis"

# 3. key的值为hash类型,读取报错
127.0.0.1:6379> DEL mykey
(integer) 1
127.0.0.1:6379> HSET mykey name "Bob" age 20
(integer) 2
127.0.0.1:6379> GET mykey
(error) WRONGTYPE Operation against a key holding the wrong kind of value核心使用场景:所有 String 类型值的读取操作,如从缓存中读取用户信息、验证码等。
2.1.3 DEL:删除指定键,通用命令
核心作用:删除指定的一个或多个 key,无论 key 的值是什么数据类型,删除成功返回删除的 key 数量。
语法 :DEL key [key ...]
有效版本:1.0.0+
时间复杂度:O (N),N 为删除的 key 数量
返回值:成功删除的 key 的数量(注意:删除不存在的 key,不计入返回值)。
实操示例:
bash
127.0.0.1:6379> SET key1 "a" key2 "b" key3 "c"
OK
127.0.0.1:6379> DEL key1 key2 nonexist_key  # 删除2个存在的key,1个不存在的
(integer) 2核心使用场景:清理无用的键值对,如缓存失效、用户退出后清理 Session。
2.2 批量操作命令:MSET/MGET,提升 Redis 访问性能
在实际业务中,我们经常需要同时设置 / 读取多个键值对,如果使用多次SET/GET,会产生多次网络请求,而网络 IO 是 Redis 性能的主要瓶颈之一 ------批量操作命令 MSET/MGET 通过一次网络请求完成多个键的设置 / 读取,大幅减少网络开销,提升性能。
这是 Redis 开发的核心优化技巧,必须掌握!
2.2.1 MSET:批量设置多个键值对
核心作用:一次性设置多个 key-value 键值对,若部分 key 已存在,直接覆盖,原子性操作(要么全部设置成功,要么全部失败)。
语法 :MSET key value [key value ...],其实也就是mset后面跟着多个key value,然后每个组合都用空格隔开,也就形成了批量设置
有效版本:1.0.1+
时间复杂度:O (N),N 为键的数量
返回值 :永远返回OK(原子性,无部分成功)。
实操示例:
bash
127.0.0.1:6379> MSET user:1001:name "张三" user:1001:age "25" user:1001:gender "男"
OK
127.0.0.1:6379> GET user:1001:name
"张三"
127.0.0.1:6379> GET user:1001:age
"25"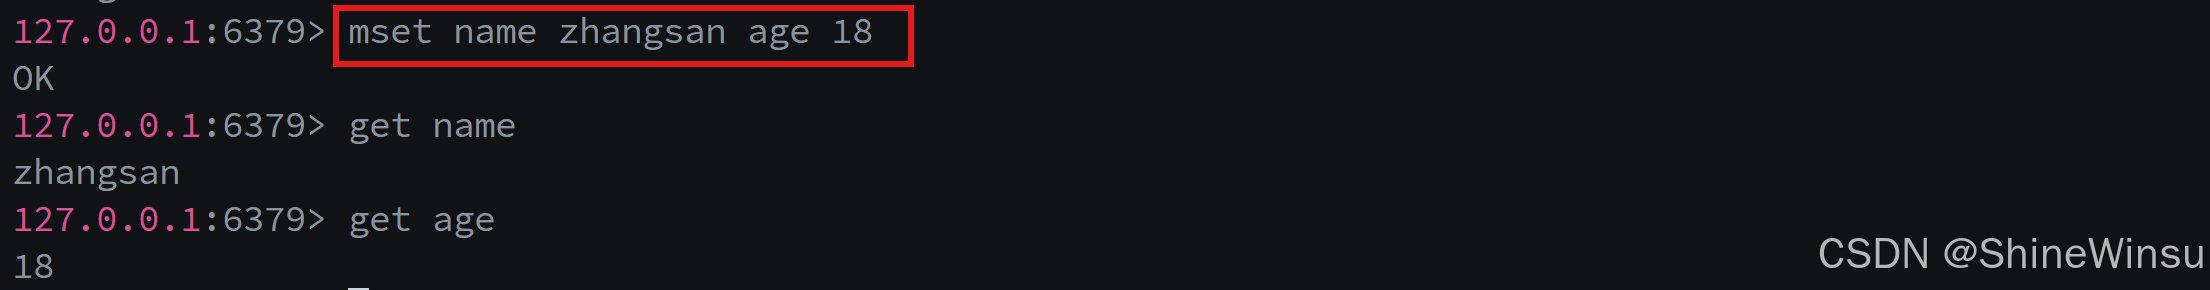
2.2.2 MGET:批量获取多个键的值
核心作用 :一次性获取多个 key 的值,返回值的顺序与传入 key 的顺序一致;若 key 不存在 / 值非 String 类型,对应位置返回nil。
语法 :MGET key [key ...],其实也就是mget后面跟着多个key value,然后每个组合都用空格隔开,也就形成了批量查询,和mset的使用方法可以说是一模一样
有效版本 :1.0.0+时间复杂度:O (N),N 为键的数量
返回值 :对应 key 的值组成的列表,不存在 / 类型错误的 key 对应位置为nil。
实操示例:
127.0.0.1:6379> MGET user:1001:name user:1001:age user:1001:gender nonexist_key
1) "张三"
2) "25"
3) "男"
4) (nil)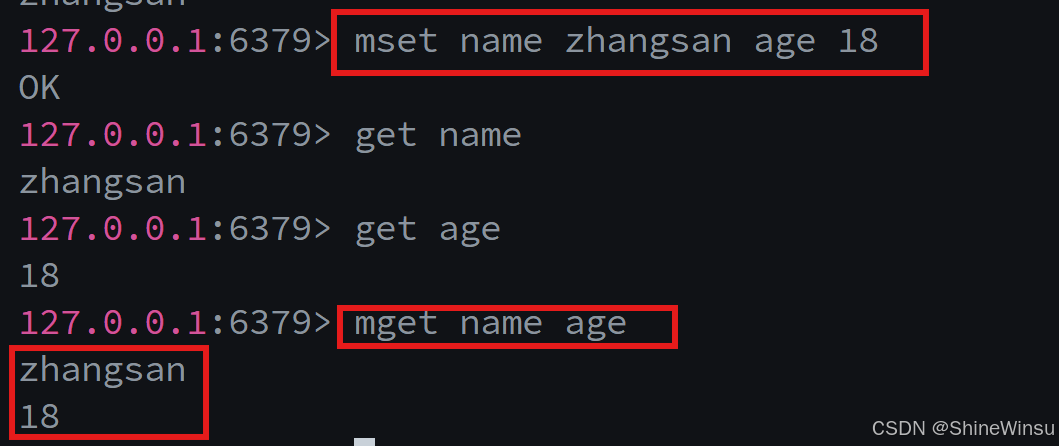
2.2.3 批量操作 vs 单次操作:性能对比(重点)
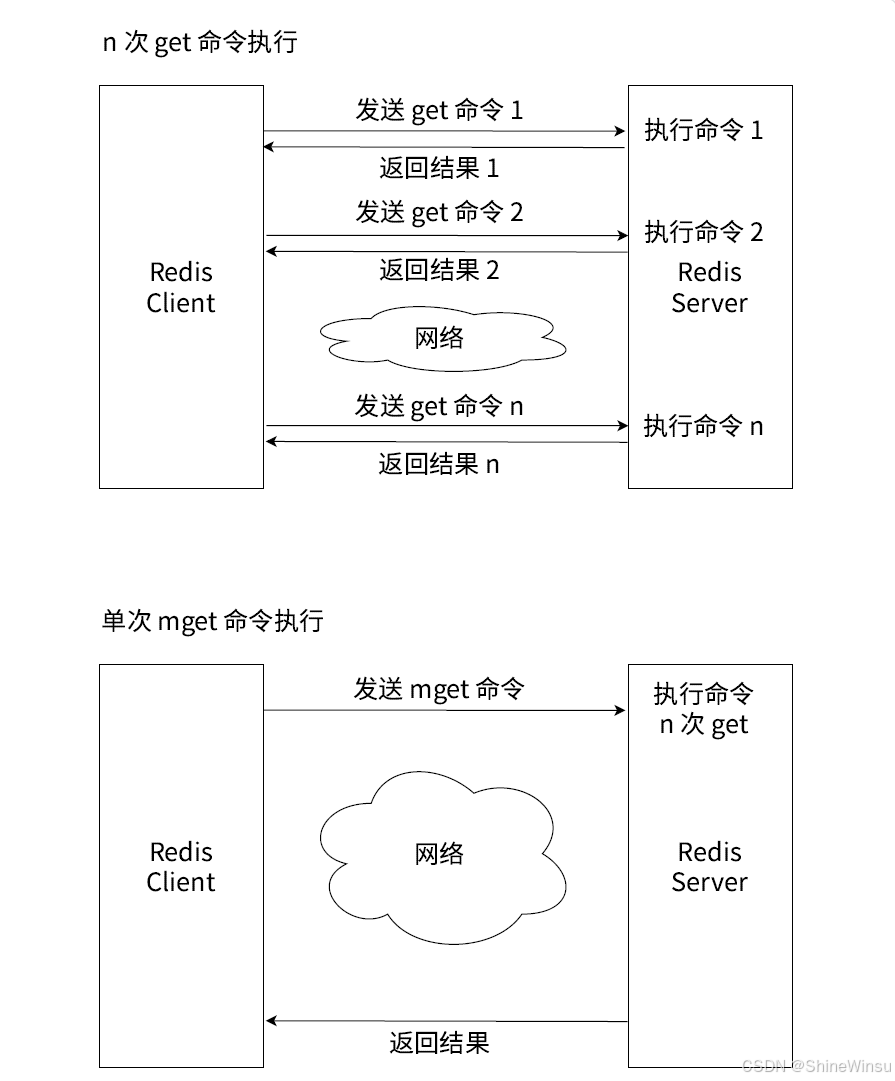
我们用实际时间计算来看看批量操作的性能优势,假设:
- 单次网络请求耗时:1 毫秒(网络 IO 的固定开销);
- 单次命令执行耗时:0.1 毫秒(Redis 纯内存操作,耗时极低);
- 需操作的键数量:1000 个。
1000 次单次 GET 操作总耗时 :1000×1ms(网络) + 1000×0.1ms(执行) = 1100ms = 1.1秒
1 次 MGET 操作总耗时 :1×1ms(网络) + 1000×0.1ms(执行) = 101ms = 0.101秒
性能提升约 10 倍 !这就是批量操作的核心价值 ------将多次网络请求合并为一次,大幅减少网络 IO 开销(Redis 的纯内存操作耗时可以忽略,性能瓶颈主要在网络)。
2.2.4 批量操作的使用注意事项
- 原子性:MSET 是原子操作,要么全部设置成功,要么全部失败,适合需要同时设置多个关联键的场景(如用户的多个属性);
- 键数限制 :批量操作的键数不宜过多(建议不超过 1000 个),否则会导致单个命令执行时间过长,阻塞 Redis 单线程(Redis 单线程模型,长命令会阻塞后续请求);
- 类型统一 :MGET 仅能正确读取 String 类型的 key,若批量传入的 key 中有非 String 类型,对应位置返回
nil,不影响其他 key 的读取。
核心使用场景:
- 批量缓存 / 读取结构化数据:如用户的姓名、年龄、性别等多个属性,用 MSET 批量设置,MGET 批量读取;
- 批量操作热点数据:如电商首页的多个商品名称、价格,一次性读取,提升接口响应速度。
2.3 数字计数命令:INCR/INCRBY/DECR/DECRBY/INCRBYFLOAT,原子性数值运算
Redis String 支持存储数字(整型 / 浮点型),并提供了原子性的数值运算命令,无需客户端参与计算,直接在服务端完成 ------ 这是 Redis 实现计数功能的核心,也是相比其他缓存(如 Memcached)的优势之一。
核心特性 :所有计数命令都是原子操作(Redis 单线程模型,命令串行执行,无并发竞争),无需加锁,可直接用于高并发场景(如视频播放量、文章阅读量、接口访问量)。
通用规则:
- 若 key 不存在,执行命令时会先将 key 的值初始化为
0,再进行运算; - 若 key 的值不是数字(如普通字符串),或整型超出64 位有符号整型范围,直接报错;
- 浮点运算命令
INCRBYFLOAT支持科学计数法,且可以传入负数实现减法。
2.3.1 整型自增:INCR/INCRBY
incr,其实就是英语increase的前4个字母啦
- INCR :将 key 对应的整型值自增 1 ,语法
INCR key; - INCRBY :将 key 对应的整型值自增指定的整数 n ,语法
INCRBY key n,这里要注意,n也可以为负数,为负数的话就是减去指定的整数哦 - 时间复杂度:O(1);
- 返回值:运算后的整型值。
实操示例:
bash
# INCR:key不存在,初始化为0,自增1
127.0.0.1:6379> EXISTS counter
(integer) 0
127.0.0.1:6379> INCR counter
(integer) 1

# INCR:继续自增1
127.0.0.1:6379> INCR counter
(integer) 2

# INCRBY:自增10
127.0.0.1:6379> INCRBY counter 10
(integer) 12

# 非数字值,报错
127.0.0.1:6379> SET counter "abc"
OK
127.0.0.1:6379> INCR counter
(error) ERR value is not an integer or out of range

# 超出64位有符号整型范围,报错
127.0.0.1:6379> SET counter "9223372036854775807"  # 64位有符号整型最大值
OK
127.0.0.1:6379> INCR counter
(error) ERR value is not an integer or out of range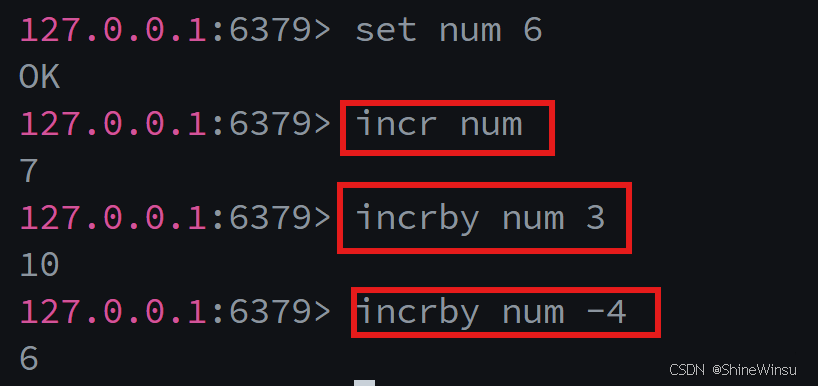
2.3.2 整型自减:DECR/DECRBY
- DECR :将 key 对应的整型值自减 1 ,语法
DECR key; - DECRBY :将 key 对应的整型值自减指定的整数 n ,语法
DECRBY key n,一样的,这里的n也可以是负数,就相当于是key 对应的整型值-(-n)而已,这个大家还是很好理解的 - 时间复杂度:O(1);
- 返回值:运算后的整型值。
实操示例:
bash
# DECR:key不存在,初始化为0,自减1
127.0.0.1:6379> EXISTS counter
(integer) 0
127.0.0.1:6379> DECR counter
(integer) -1

# DECR:继续自减1
127.0.0.1:6379> DECR counter
(integer) -2

# DECRBY:自减5
127.0.0.1:6379> DECRBY counter 5
(integer) -7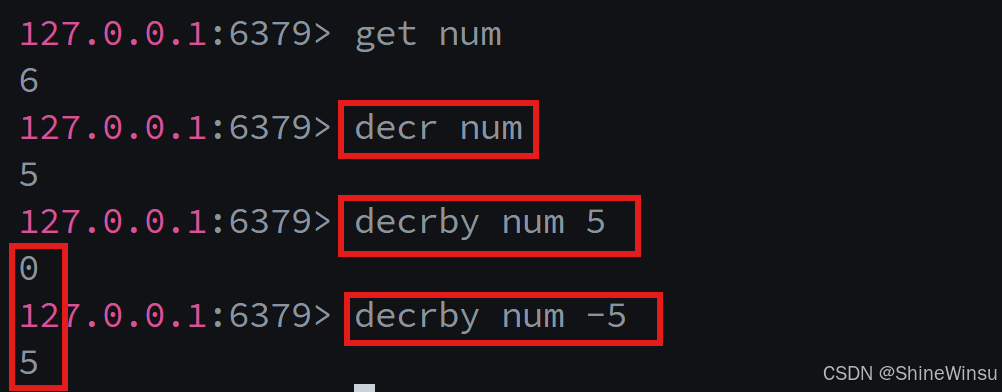
2.3.3 浮点型运算:INCRBYFLOAT
核心作用 :将 key 对应的浮点型值增加指定的浮点数 n ,传入负数则实现减法,支持科学计数法(如5.0e3表示 5000),实际这里的key对应的浮点数是以字符串形成存储的,但是当我们使用incrbyfloat的时候,redis就会把字符串转换为浮点型之后,再去进行计算哦,所以相对整型计算而言,浮点型的计算效率还是较低的
语法 :INCRBYFLOAT key increment,这里我们要注意,redis并没有提供decrbyfloat,所以我们要是想使用减法的话,就是得incrbyfloat后面跟着负数哦,此时就是进行减法运算
有效版本:2.6.0+
时间复杂度:O(1)
返回值:运算后的浮点型值(字符串形式)。
实操示例:
bash
# 基础浮点自增
127.0.0.1:6379> SET num 10.50
OK
127.0.0.1:6379> INCRBYFLOAT num 0.1
"10.6"

# 浮点自减(传入负数)
127.0.0.1:6379> INCRBYFLOAT num -5
"5.6"

# 支持科学计数法
127.0.0.1:6379> SET num 5.0e3
OK
127.0.0.1:6379> INCRBYFLOAT num 2.0e2
"5200"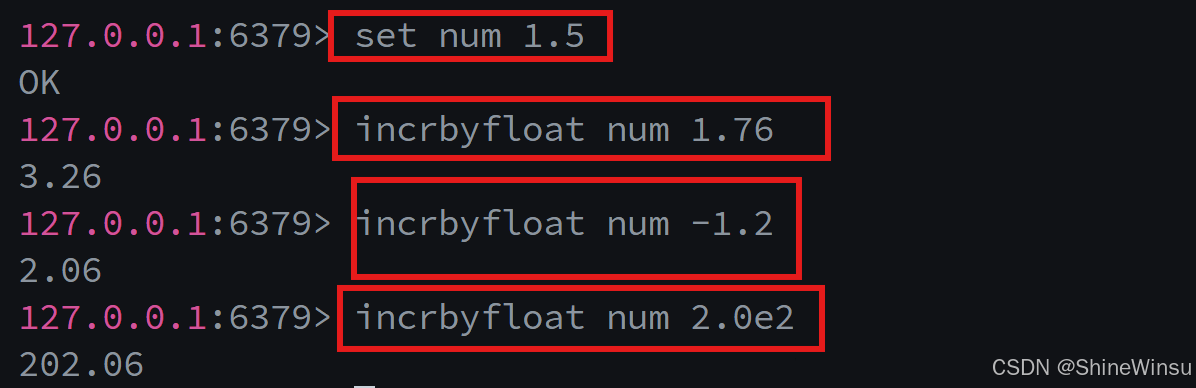
2.3.4 计数命令的核心使用场景
- 视频 / 文章播放量 :用户每播放一次视频,执行
INCR video:play:5253; - 接口访问量统计 :接口每被访问一次,执行
INCR api:visit:user:list; - 点赞 / 收藏数 :用户点赞,执行
INCR article:like:1001;取消点赞(业务层控制),执行DECR article:like:1001; - 浮点型统计:如商品价格调整、数据指标累加(如销售额、用户增长率)。
2.4 字符串操作命令:APPEND/STRLEN/GETRANGE/SETRANGE,对字符串的原生操作
Redis 还提供了对 String 类型值的原生字符串操作命令,无需客户端读取后再处理,直接在服务端完成,减少网络请求和客户端计算开销。
2.4.1 APPEND:追加字符串到原有值末尾
核心作用 :若 key 存在且为 String 类型,将 value 追加到原有值的末尾;若 key 不存在,等价于SET key value。
语法 :APPEND key value ,这里要注意,后面value内容不能有空格,一旦有的话,就会报错,也就是说,value必须是一个连续的字符串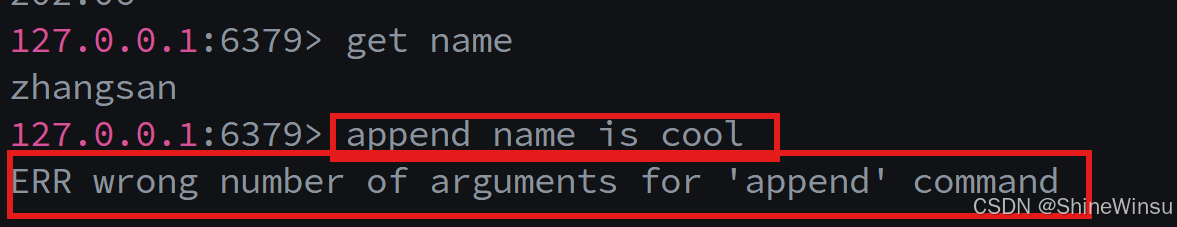
有效版本:2.0.0+
时间复杂度:O (1)(追加的字符串长度较短时,可视为 O (1))
返回值:追加后的字符串总长度。
实操示例:
bash
# key不存在,等价于SET
127.0.0.1:6379> EXISTS mykey
(integer) 0
127.0.0.1:6379> APPEND mykey "Hello"
(integer) 5
127.0.0.1:6379> GET mykey
"Hello"

# key存在,追加字符串
127.0.0.1:6379> APPEND mykey " Redis"
(integer) 11
127.0.0.1:6379> GET mykey
"Hello Redis"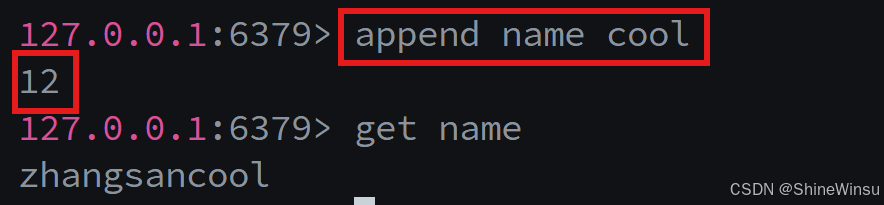
使用场景:动态拼接字符串,如日志记录、拼接用户行为轨迹。
2.4.2 STRLEN:获取字符串长度
核心作用:获取 key 对应的 String 值的长度;若 key 不存在,返回 0;若 key 的值非 String 类型,报错。
语法 :STRLEN key
有效版本:2.2.0+
时间复杂度:O(1)
返回值:字符串长度(key 不存在为 0)。
实操示例:
bash
127.0.0.1:6379> SET mykey "Hello Redis"
OK
127.0.0.1:6379> STRLEN mykey
(integer) 11

# key不存在,返回0
127.0.0.1:6379> STRLEN nonexist_key
(integer) 0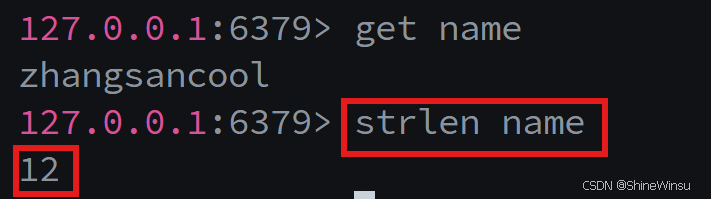
使用场景:校验字符串长度,如验证码长度、用户昵称长度。
2.4.3 GETRANGE:获取字符串的子串(左闭右闭)
核心作用 :获取字符串中从start到end的子串,左闭右闭区间;支持负数索引(-1 表示最后一个字符,-2 表示倒数第二个,以此类推);超出范围的索引会自动调整为字符串的起始 / 结束位置,这里大家要和C++区分开来,C++采取的是左闭右开区间,大家要注意哦,还有就是,redis中,默认字符串的第一个字符下标是0哦,和C++数组一样的规则
语法 :GETRANGE key start end
有效版本:2.4.0+
时间复杂度:O (N)(N 为子串长度,字符串较短时视为 O (1))
返回值:截取的子串。
实操示例:
bash
127.0.0.1:6379> SET mykey "This is a Redis string"
OK

# 正索引:0-3,截取前4个字符
127.0.0.1:6379> GETRANGE mykey 0 3
"This"

# 负索引:-6到-1,截取最后6个字符
127.0.0.1:6379> GETRANGE mykey -6 -1
"string"

# 0到-1,截取整个字符串
127.0.0.1:6379> GETRANGE mykey 0 -1
"This is a Redis string"

# 索引超出范围,自动调整
127.0.0.1:6379> GETRANGE mykey 20 100
"string"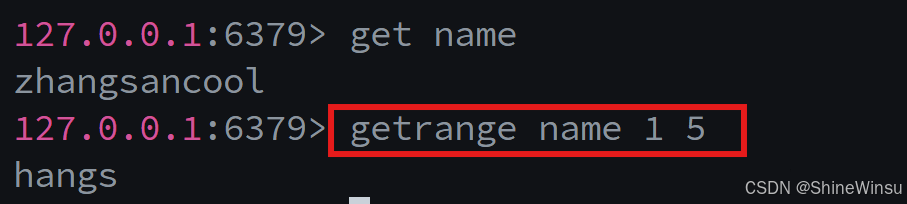
使用场景:截取字符串的指定部分,如获取手机号的后 4 位、截取商品名称的前 10 个字符。
2.4.4 SETRANGE:从指定偏移量覆盖字符串
核心作用 :从指定的offset(偏移量,从 0 开始)位置开始,用新的 value 覆盖原有字符串的部分内容;若偏移量超过原有字符串长度,中间用\0(空字符)填充
语法 :SETRANGE key offset value
有效版本:2.2.0+
时间复杂度:O (N)(N 为新 value 的长度,较短时视为 O (1))
返回值:覆盖后的字符串总长度。
实操示例:
bash
127.0.0.1:6379> SET mykey "Hello World"
OK

# 从偏移量6开始,用"Redis"覆盖原有内容
127.0.0.1:6379> SETRANGE mykey 6 "Redis"
(integer) 11
127.0.0.1:6379> GET mykey
"Hello Redis"

# 偏移量超过原有长度,中间补空字符
127.0.0.1:6379> SETRANGE mykey 20 "test"
(integer) 24
127.0.0.1:6379> GET mykey
"Hello Redis\x00\x00\x00\x00\x00\x00\x00\x00\x00test"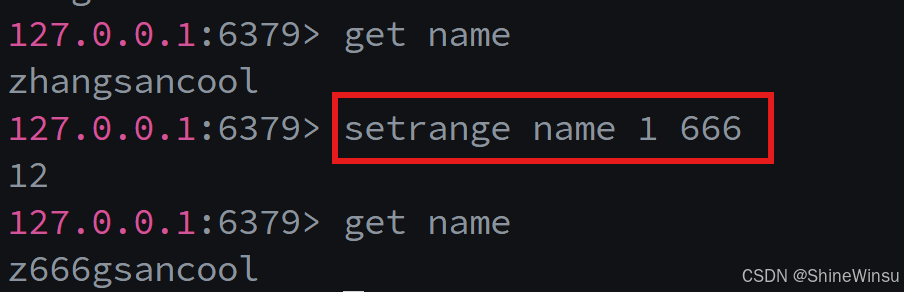
使用场景:修改字符串的指定部分,如更新缓存中的部分数据、替换固定位置的字符。
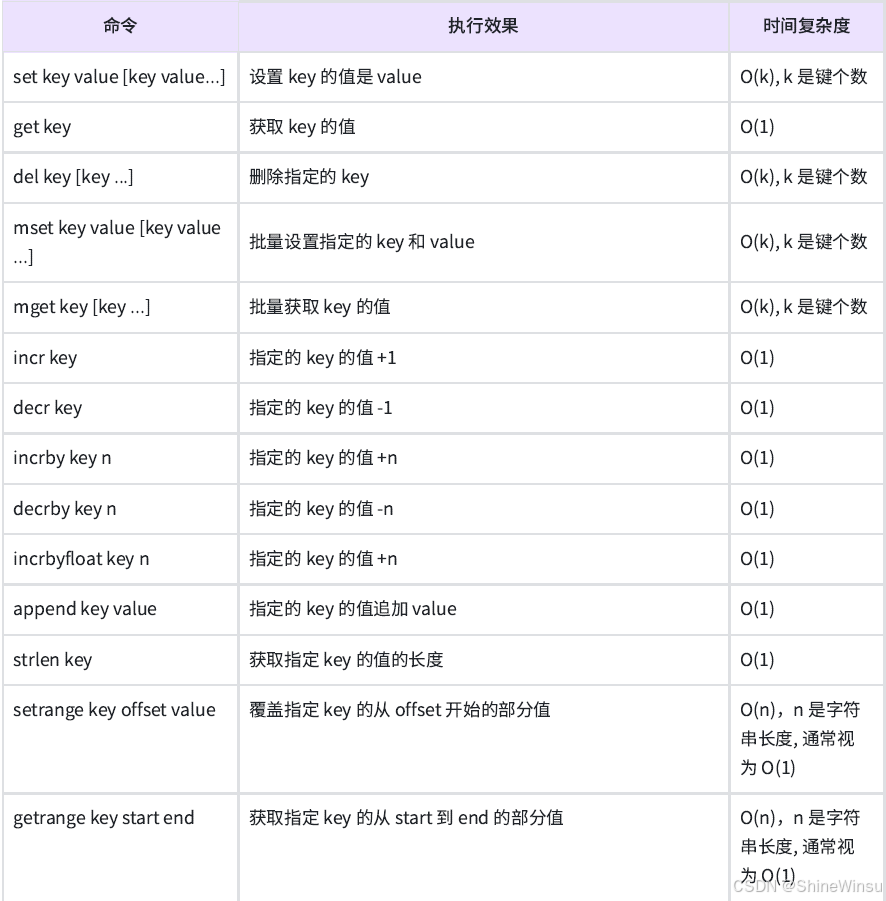
2.5 所有 String 命令汇总表:快速查询,按需使用
为了方便大家日常开发快速查询,我们将所有 Redis String 核心命令按功能、语法、时间复杂度、核心作用整理成表,涵盖开发中 99% 的使用场景:
| 功能模块 | 命令 | 语法 | 时间复杂度 | 核心作用 |
|---|---|---|---|---|
| 基础操作 | SET | SET key value EX/PX NX/XX | O(1) | 设置键值对,支持过期、条件设置 |
| 基础操作 | GET | GET key | O(1) | 获取 String 类型值,类型校验 |
| 基础操作 | DEL | DEL key key ... | O(N) | 删除一个 / 多个键,通用命令 |
| 批量操作 | MSET | MSET key value key value ... | O(N) | 批量设置多个键值对,原子性 |
| 批量操作 | MGET | MGET key key ... | O(N) | 批量获取多个键值对,顺序一致 |
| 整型计数 | INCR | INCR key | O(1) | 整型值自增 1,key 不存在初始化为 0 |
| 整型计数 | INCRBY | INCRBY key n | O(1) | 整型值自增指定整数 n |
| 整型计数 | DECR | DECR key | O(1) | 整型值自减 1,key 不存在初始化为 0 |
| 整型计数 | DECRBY | DECRBY key n | O(1) | 整型值自减指定整数 n |
| 浮点计数 | INCRBYFLOAT | INCRBYFLOAT key increment | O(1) | 浮点型值增减指定浮点数,支持科学计数法 |
| 字符串操作 | APPEND | APPEND key value | O(1) | 追加字符串到末尾,key 不存在等价于 SET |
| 字符串操作 | STRLEN | STRLEN key | O(1) | 获取字符串长度,key 不存在返回 0 |
| 字符串操作 | GETRANGE | GETRANGE key start end | O(N) | 截取子串,左闭右闭,支持负索引 |
| 字符串操作 | SETRANGE | SETRANGE key offset value | O(N) | 从偏移量开始覆盖字符串,超长度补空字符 |
三、Redis String 类型的内部编码:智能优化,平衡内存与性能
Redis 的对外数据类型(如 String、list)和底层内部编码是分离的 ------ 对外暴露统一的 String 接口,底层会根据存储的数据类型、字符串长度 自动选择最优的内部编码,实现内存占用 和操作性能的平衡。
这是 Redis 的设计精髓之一,对开发者完全透明,无需手动干预,但理解内部编码能帮助我们更好地优化 Redis 的内存使用和性能。
3.1 String 类型的三种内部编码
Redis String 类型提供了三种内部编码 ,分别适配不同的存储场景,可通过object encoding key命令查看指定 key 的内部编码:
- int:8 字节的 64 位有符号整型;
- embstr :用于存储小于等于 39 字节的短字符串(Redis 3.2 + 版本,旧版本为 44 字节);
- raw :用于存储大于 39 字节的长字符串,或需要修改的短字符串。
3.2 每种内部编码的深度解析:适用场景 + 核心优势
3.2.1 int:整型值的极致内存优化
适用场景 :key 的值为64 位有符号整型(范围:-9223372036854775808 ~ 9223372036854775807)。
核心实现 :直接将值存储为 8 字节的 64 位整型,而非字符串形式,极致节省内存 (存储整型1000仅需 8 字节,存储字符串"1000"需要 4 字节)。
核心优势:
- 内存占用极低,适合大量计数场景(如播放量、访问量);
- 整型运算命令(
incr/decr)无需字符串转整型,性能极致。
实操示例:
bash
127.0.0.1:6379> SET counter 6379
OK
127.0.0.1:6379> object encoding counter
"int"

# 超出64位有符号整型范围,自动转为raw
127.0.0.1:6379> SET big_num 9223372036854775808
OK
127.0.0.1:6379> object encoding big_num
"raw"
3.2.2 embstr:短字符串的连续内存存储
适用场景 :key 的值为小于等于 39 字节 的短字符串,且无需修改(修改会触发编码转换)。
核心实现 :将Redis 对象的元数据 (如对象类型、引用计数、长度)和字符串内容 存储在同一块连续的内存中,一次性完成内存分配和释放,减少内存碎片。
核心优势:
- 连续内存存储,缓存命中率高(CPU 缓存能一次性读取元数据和内容);
- 内存分配 / 释放仅需一次,操作效率高;
- 相比 raw 编码,减少了内存指针的开销。
实操示例:
bash
# 短字符串(5字节),embstr编码
127.0.0.1:6379> SET str "hello"
OK
127.0.0.1:6379> object encoding str
"embstr"

# 39字节字符串,embstr编码
127.0.0.1:6379> SET str39 "123456789012345678901234567890123456789"
OK
127.0.0.1:6379> STRLEN str39
(integer) 39
127.0.0.1:6379> object encoding str39
"embstr"

# 40字节字符串,自动转为raw编码
127.0.0.1:6379> SET str40 "1234567890123456789012345678901234567890"
OK
127.0.0.1:6379> STRLEN str40
(integer) 40
127.0.0.1:6379> object encoding str40
"raw"
3.2.3 raw:长字符串 / 可修改字符串的灵活存储
适用场景 :key 的值为大于 39 字节 的长字符串,或需要修改的短字符串 (如APPEND、SETRANGE操作)。
核心实现 :将Redis 对象的元数据 和字符串内容 存储在两块不同的内存中,通过指针关联,支持动态扩容和修改。
核心优势:
- 支持任意长度的字符串(最大 512MB),灵活度高;
- 支持频繁的修改操作,扩容逻辑成熟;
- 避免大尺寸的连续内存块,减少内存碎片。
关键特性 :embstr 编码的字符串修改后会直接转为 raw 编码 ,且不可逆(即使后续将字符串缩短至 39 字节以内,也不会再转回 embstr)。
实操示例:
bash
# 短字符串,embstr编码
127.0.0.1:6379> SET str "hello"
OK
127.0.0.1:6379> object encoding str
"embstr"

# 追加字符串后,自动转为raw编码
127.0.0.1:6379> APPEND str " redis"
(integer) 11
127.0.0.1:6379> object encoding str
"raw"

# 即使缩短字符串,也不会转回embstr
127.0.0.1:6379> SET str "hello"
OK
127.0.0.1:6379> object encoding str
"embstr"
3.3 String 类型内部编码的自动转换规则(重点)
Redis 会根据数据类型、字符串长度、操作行为 自动完成内部编码的转换,转换规则为单向不可逆(仅从更优的编码向通用的编码转换,不会反向转换),具体规则如下:
- int → embstr/raw:当将整型值修改为非整型字符串时,若字符串长度≤39 字节转为 embstr,否则转为 raw;
- embstr → raw :
- 字符串长度超过 39 字节;
- 对字符串执行修改操作(
APPEND、SETRANGE); - 转换后不可逆;
- 无 raw → embstr/int:raw 编码不会再转回 embstr 或 int,即使数据满足条件。
一张表总结转换规则:
| 原编码 | 触发条件 | 目标编码 | 可逆性 |
|---|---|---|---|
| int | 修改为非整型短字符串(≤39 字节) | embstr | 不可逆 |
| int | 修改为非整型长字符串(>39 字节) | raw | 不可逆 |
| embstr | 字符串长度 > 39 字节 / 执行修改操作 | raw | 不可逆 |
| raw | 任何条件 | 无转换 | - |
3.4 内部编码的设计价值:为什么 Redis 要做这样的优化?
Redis 作为内存数据库,内存利用率 和操作性能是核心指标,而内部编码的智能优化正是为了平衡这两个指标:
- 针对场景做极致优化:整型用 int 编码省内存,短字符串用 embstr 编码提升缓存命中率,长字符串用 raw 编码保证灵活性;
- 对开发者透明:无需手动指定编码,Redis 自动适配,降低使用成本;
- 简化底层实现:不同的编码对应不同的底层数据结构,按需选择,避免单一结构的短板;
- 提升整体性能:通过内存优化减少内存占用,通过连续内存提升缓存命中率,最终提升 Redis 的整体处理能力。
四、Redis String 类型的典型实战场景
Redis String 类型的使用场景覆盖了缓存、计数、分布式锁、共享 Session、手机验证码等绝大多数互联网业务场景,也是后续其他数据结构的基础。
4.1 核心场景 1:缓存层(最经典使用场景)
4.1.1 业务痛点
传统的数据库(如 MySQL)是磁盘存储,访问速度慢(毫秒级),无法支撑高并发请求(如电商秒杀、首页访问),导致接口响应慢、数据库崩溃。
4.1.2 解决方案
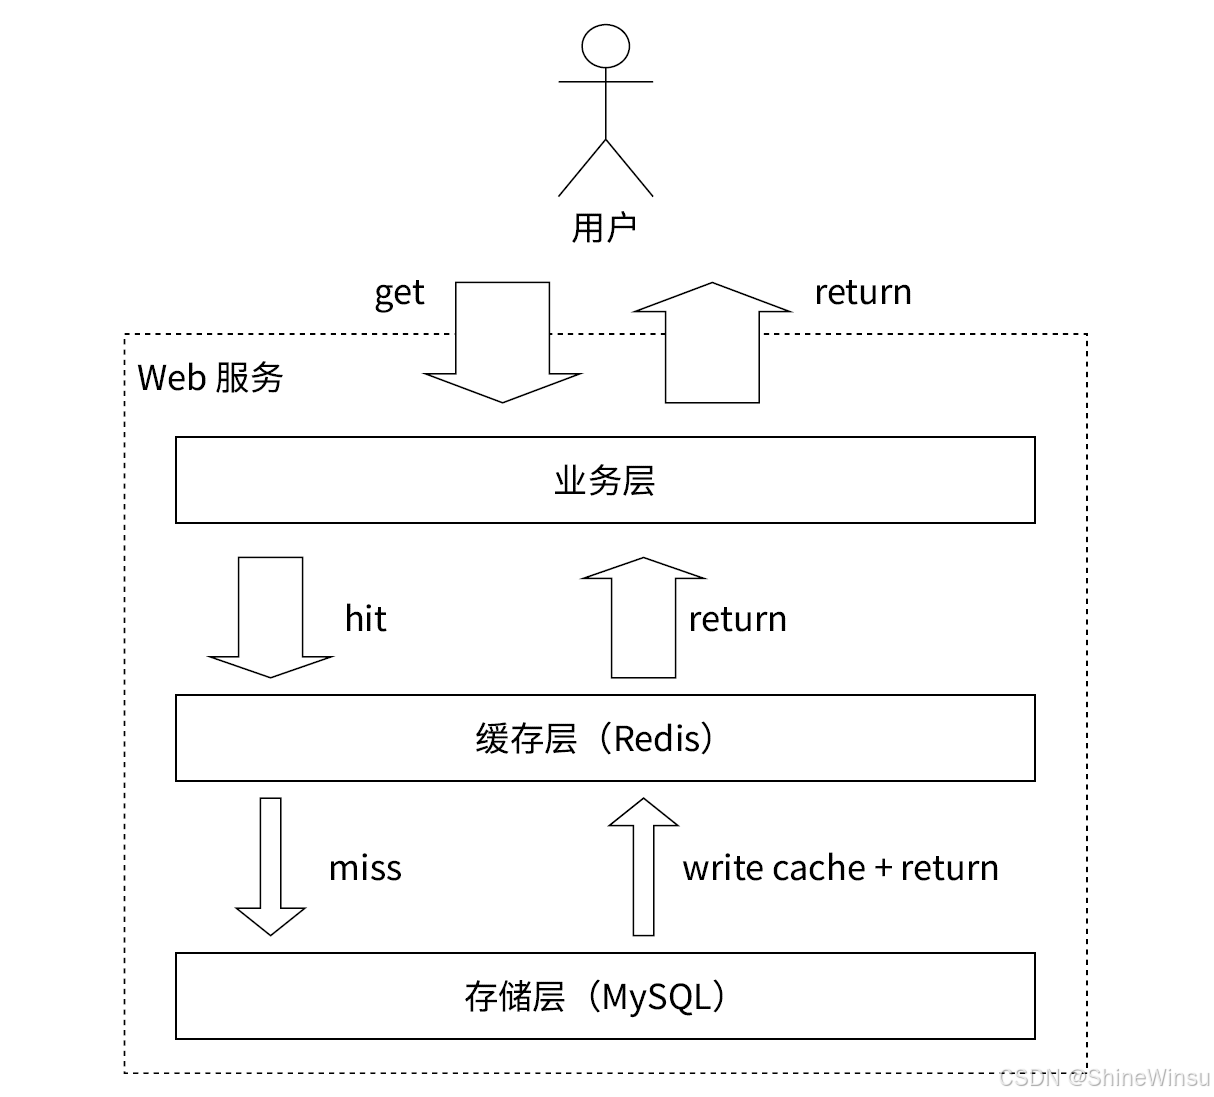
用 Redis String 作为缓存层,将高频访问的热点数据(如用户信息、商品详情、首页数据)缓存到 Redis 中,绝大多数请求直接从 Redis 读取,避免直接访问数据库,加速读写、降低数据库压力。
4.1.3 核心设计思路
- 缓存命中:请求先访问 Redis,若 Redis 中有数据(缓存命中),直接返回,无需访问数据库;
- 缓存未命中 :若 Redis 中无数据(缓存未命中),访问数据库获取数据,将数据写入 Redis 并设置过期时间(防止缓存数据与数据库不一致),再返回给客户端;
- 键名设计 :遵循
业务名:对象名:唯一标识[:属性]的规范,避免键冲突,提升可维护性; - 数据序列化:将结构化数据(如用户对象、商品对象)序列化为 JSON 字符串存储(Redis String 支持存储任意字符串)。
4.1.4 伪代码实现(Java 风格,通用思路)
以根据用户 ID 获取用户信息为例:
java
/**
 * 根据用户ID获取用户信息,Redis缓存+MySQL兜底
 * @param uid 用户ID
 * @return 用户信息
 */
UserInfo getUserInfo(Long uid) {
    // 1. 设计Redis键名:业务名:对象名:唯一标识
    String redisKey = "user:info:" + uid;
    // 2. 先从Redis读取缓存
    String userJson = redis.execute("GET", redisKey);
    // 3. 缓存命中:反序列化为对象并返回
    if (userJson != null && !userJson.isEmpty()) {
        return JSON.parseObject(userJson, UserInfo.class);
    }
    // 4. 缓存未命中:从MySQL读取数据
    UserInfo userInfo = mysql.query("select * from user_info where uid = ?", uid);
    // 5. 数据库中无数据:返回404
    if (userInfo == null) {
        return null;
    }
    // 6. 将数据序列化后写入Redis,设置1小时过期时间(防止缓存雪崩)
    String userJsonStr = JSON.toJSONString(userInfo);
    redis.execute("SET", redisKey, userJsonStr, "EX", 3600);
    // 7. 返回用户信息
    return userInfo;
}
4.1.5 关键注意事项
- 设置过期时间 :必须为缓存设置过期时间(
EX/PX),避免缓存永久有效,导致数据与数据库不一致(缓存脏数据); - 键名设计规范 :拒绝使用无意义的键名(如
user1001),遵循业务名:对象名:唯一标识,如order:detail:10001、goods:name:5253; - 避免大字符串缓存:单个缓存值不宜过大(建议不超过 10KB),否则会增加 Redis 的内存占用和网络传输时间;
- 缓存更新策略 :数据库数据更新时,需及时删除 Redis 缓存 (而非更新),避免缓存与数据库不一致(如执行
DEL user:info:1001); - 缓存穿透 / 雪崩 / 击穿:这是缓存的三大经典问题,后续可通过布隆过滤器、过期时间随机化、分布式锁解决(基础场景先保证核心功能)。
4.2 核心场景 2:计数功能(高并发原子计数)
4.2.1 业务痛点
高并发场景下的计数功能(如视频播放量、文章阅读量、接口访问量),若用数据库实现(如update video set play_count = play_count +1 where id=5253),会产生大量的行锁竞争,导致数据库性能下降,甚至无法支撑高并发。
4.2.2 解决方案
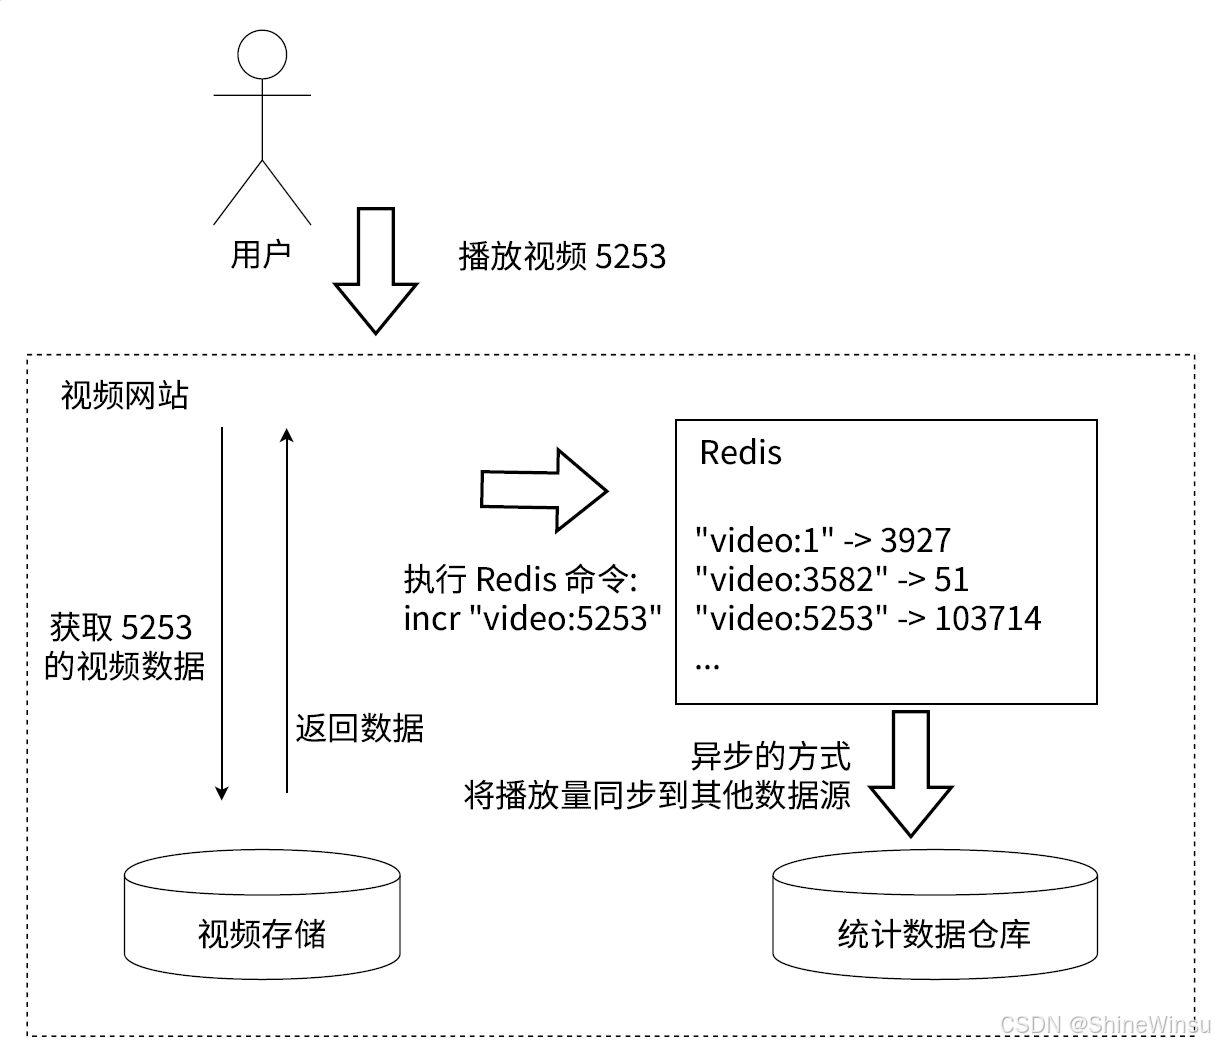
用 Redis String 的原子计数命令(incr/incrby)实现计数,Redis 单线程模型保证计数操作的原子性,无并发竞争,且纯内存操作,性能极致(每秒可支撑数十万次计数),后续可通过异步任务将计数数据同步到数据库中。
4.2.3 核心设计思路
- 实时计数 :用户触发计数行为(如播放视频),直接执行 Redis 的
INCR命令,完成实时计数; - 键名设计 :
业务名:计数类型:唯一标识,如video:play:5253、article:read:1001; - 异步落地:将高频的计数操作放在 Redis 中,通过定时任务 / 消息队列将 Redis 中的计数数据异步同步到数据库,减少数据库压力;
- 防作弊:业务层增加防作弊逻辑(如同一用户短时间内多次播放不计入),避免恶意刷量。
4.2.4 伪代码实现(Java 风格)
以视频播放量计数为例:
java
/**
 * 视频播放量计数,Redis实时计数,异步同步到MySQL
 * @param vid 视频ID
 * @return 最新播放量
 */
Long incrVideoPlayCount(Long vid) {
    // 1. 设计Redis键名:业务名:计数类型:唯一标识
    String redisKey = "video:play:" + vid;
    // 2. 执行原子自增,获取最新播放量
    Long newPlayCount = redis.execute("INCR", redisKey);
    // 3. 异步将播放量同步到MySQL(如通过消息队列发送任务,不阻塞主线程)
    messageQueue.send("video_play_count_sync", vid, newPlayCount);
    // 4. 返回最新播放量
    return newPlayCount;
}

/**
 * 异步同步播放量到MySQL的消费方法
 * @param vid 视频ID
 * @param playCount 最新播放量
 */
void syncVideoPlayCountToMysql(Long vid, Long playCount) {
    mysql.execute("update video set play_count = ? where id = ?", playCount, vid);
}
4.1.5 关键注意事项
- 原子性保证 :直接使用 Redis 的原生计数命令,避免客户端先
GET再SET(非原子操作,会导致计数错误); - 异步落地:实时计数只在 Redis 中完成,异步同步到数据库,避免数据库成为性能瓶颈;
- 数据持久化:Redis 开启 RDB/AOF 持久化,防止 Redis 重启后计数数据丢失;
- 计数清零 :若需要清零计数,执行
SET key 0而非DEL key(避免INCR时重新初始化,导致计数错误)。
4.3 核心场景 3:分布式锁(SET NX EX 经典实现)
4.3.1 业务痛点
分布式系统中,多个服务实例同时操作同一资源(如秒杀下单、库存扣减),会产生并发竞争,导致数据不一致(如超卖、重复下单),需要一种跨服务的锁机制来保证操作的原子性。
4.3.2 解决方案
用 Redis String 的SET key value NX EX seconds命令实现分布式锁,这是 Redis 最经典、最常用的分布式锁实现方式,简单高效,能满足绝大多数分布式场景的锁需求。
4.3.3 核心设计思路
- 加锁 :执行
SET lock:xxx value NX EX seconds,其中:lock:xxx:锁的键名,如lock:order:10001(针对具体资源的锁);NX:仅当锁不存在时才设置,保证只有一个服务实例能获取锁;EX seconds:设置锁的过期时间,防止服务实例挂掉后锁永久有效(死锁);value:建议设置为唯一标识(如服务实例 ID + 线程 ID),用于解锁时的身份校验;
- 解锁 :通过 Lua 脚本实现原子解锁(先判断锁的 value 是否为当前实例的唯一标识,再删除锁),避免误删其他实例的锁;
- 执行业务:获取锁的服务实例执行具体业务(如扣减库存、创建订单);
- 释放锁:业务执行完成后,执行 Lua 脚本解锁。
4.3.4 伪代码实现(Java 风格,含 Lua 解锁脚本)
以电商秒杀下单为例:
java
// 分布式锁键名模板:lock:业务名:资源标识
private static final String LOCK_KEY_TPL = "lock:order:%s";
// 锁的过期时间:30秒(根据业务实际耗时调整,避免业务未执行完锁过期)
private static final int LOCK_EXPIRE_SECONDS = 30;
// 锁的唯一标识:服务实例ID+线程ID(防止不同实例/线程误删对方的锁)
private static final String LOCK_VALUE = UUID.randomUUID().toString() + "-" + Thread.currentThread().getId();
// 原子解锁Lua脚本:先判断锁的value是否为当前实例的标识,再删除,保证原子性
private static final String UNLOCK_LUA_SCRIPT =
    "if redis.call('GET', KEYS[1]) == ARGV[1] then " +
    "return redis.call('DEL', KEYS[1]) " +
    "else " +
    "return 0 " +
    "end";

/**
 * 秒杀下单,Redis分布式锁保证单资源原子操作
 * @param goodsId 商品ID
 * @param userId 用户ID
 * @return 是否下单成功
 */
public boolean seckillOrder(Long goodsId, Long userId) {
    // 1. 生成当前商品的分布式锁键名
    String lockKey = String.format(LOCK_KEY_TPL, goodsId);
    Jedis jedis = null;
    try {
        jedis = getJedis();
        // 2. 加锁:SET key value NX EX seconds,原子性加锁+设置过期时间
        String lockResult = jedis.set(lockKey, LOCK_VALUE, SetParams.setParams().nx().ex(LOCK_EXPIRE_SECONDS));
        // 3. 加锁失败:其他实例已获取锁,直接返回下单失败
        if (!"OK".equals(lockResult)) {
            return false;
        }
        // 4. 加锁成功:执行核心秒杀业务(扣减库存、创建订单)
        // 4.1 检查商品库存是否充足(模拟数据库/Redis库存校验)
        Long stock = jedis.incrBy("goods:stock:" + goodsId, 0);
        if (stock <= 0) {
            return false;
        }
        // 4.2 扣减库存
        jedis.decr("goods:stock:" + goodsId);
        // 4.3 创建订单(模拟数据库操作)
        createOrder(goodsId, userId);
        return true;
    } catch (Exception e) {
        log.error("秒杀下单失败", e);
        return false;
    } finally {
        // 5. 最终解锁:执行Lua脚本原子解锁,避免误删锁
        if (jedis != null) {
            jedis.eval(UNLOCK_LUA_SCRIPT, Collections.singletonList(lockKey), Collections.singletonList(LOCK_VALUE));
            jedis.close();
        }
    }
}

// 模拟创建订单的数据库操作
private void createOrder(Long goodsId, Long userId) {
    // 执行insert into order(goods_id, user_id) values(?, ?)
}

// 获取Redis连接
private Jedis getJedis() {
    return new Jedis("127.0.0.1", 6379);
}
4.3.5 分布式锁的关键注意事项
- 原子性加锁 :必须使用
SET key value NX EX seconds单命令 加锁,禁止先SETNX再EXPIRE(两个命令非原子,若加锁后服务挂掉,会导致死锁); - 设置锁过期时间:必须为锁设置合理的过期时间,避免服务实例获取锁后挂掉,导致锁永久有效(死锁),过期时间需大于业务最大执行耗时;
- 唯一标识防误删:锁的 value 必须是当前实例 / 线程的唯一标识,解锁时先判断再删除,避免其他实例删除当前实例的锁;
- 原子性解锁 :必须用Lua 脚本 实现解锁,禁止先
GET再DEL(两个命令非原子,若GET后锁过期,会删除其他实例的锁); - 避免锁重入 :基础的
SET NX EX分布式锁不支持重入(同一线程多次获取同一把锁会失败),若需要重入锁,需基于 Redis Hash 实现或使用 Redisson 框架; - 锁竞争优化 :若锁竞争激烈,可引入自旋锁(加锁失败后短暂休眠再重试),避免直接返回失败,提升下单成功率。
4.4 核心场景 4:共享 Session(分布式 Web 服务统一会话)
4.4.1 业务痛点
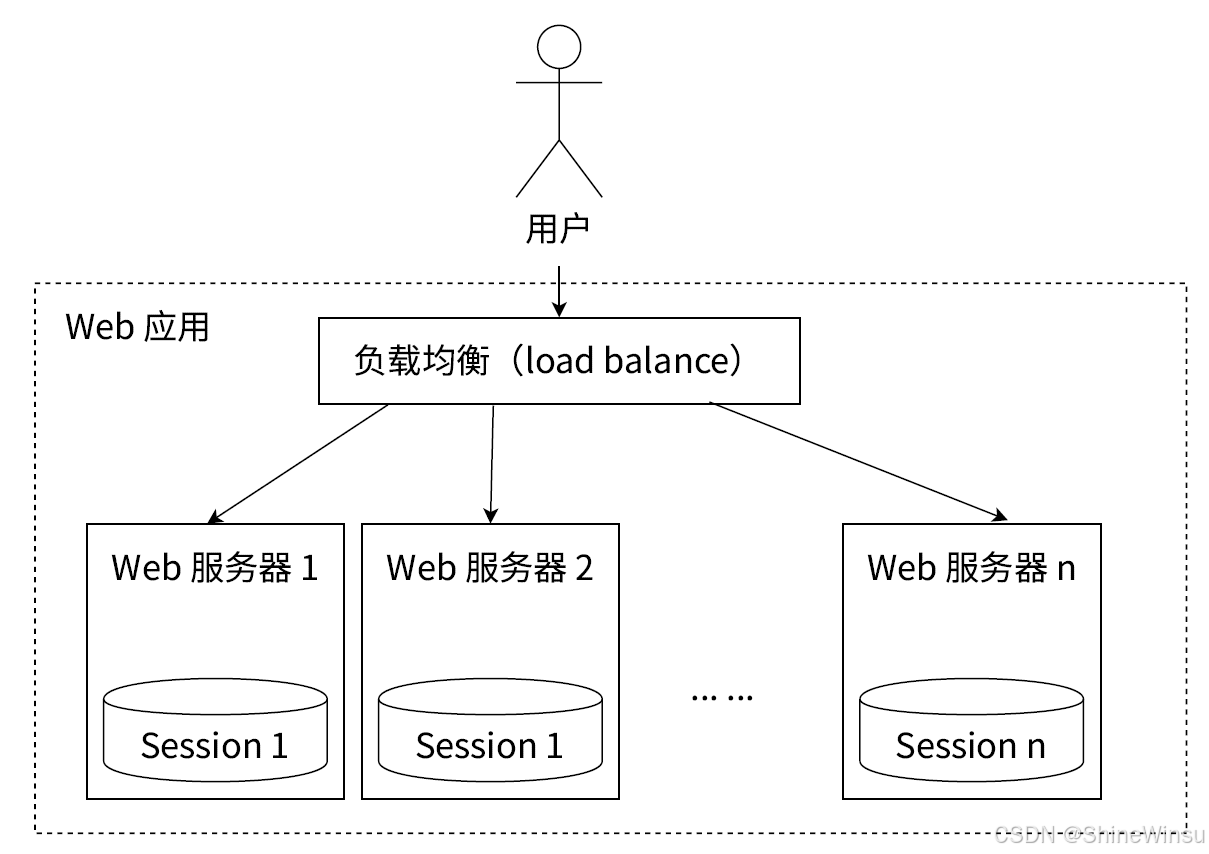
分布式 Web 服务中,用户的 Session 默认存储在单个 Web 服务器的内存中,而负载均衡会将用户的请求随机分发到不同的 Web 服务器上。用户第一次请求到服务器 A 并创建 Session,第二次请求可能被分发到服务器 B,服务器 B 无该用户的 Session,导致用户需要重新登录,严重影响体验。
4.4.2 解决方案
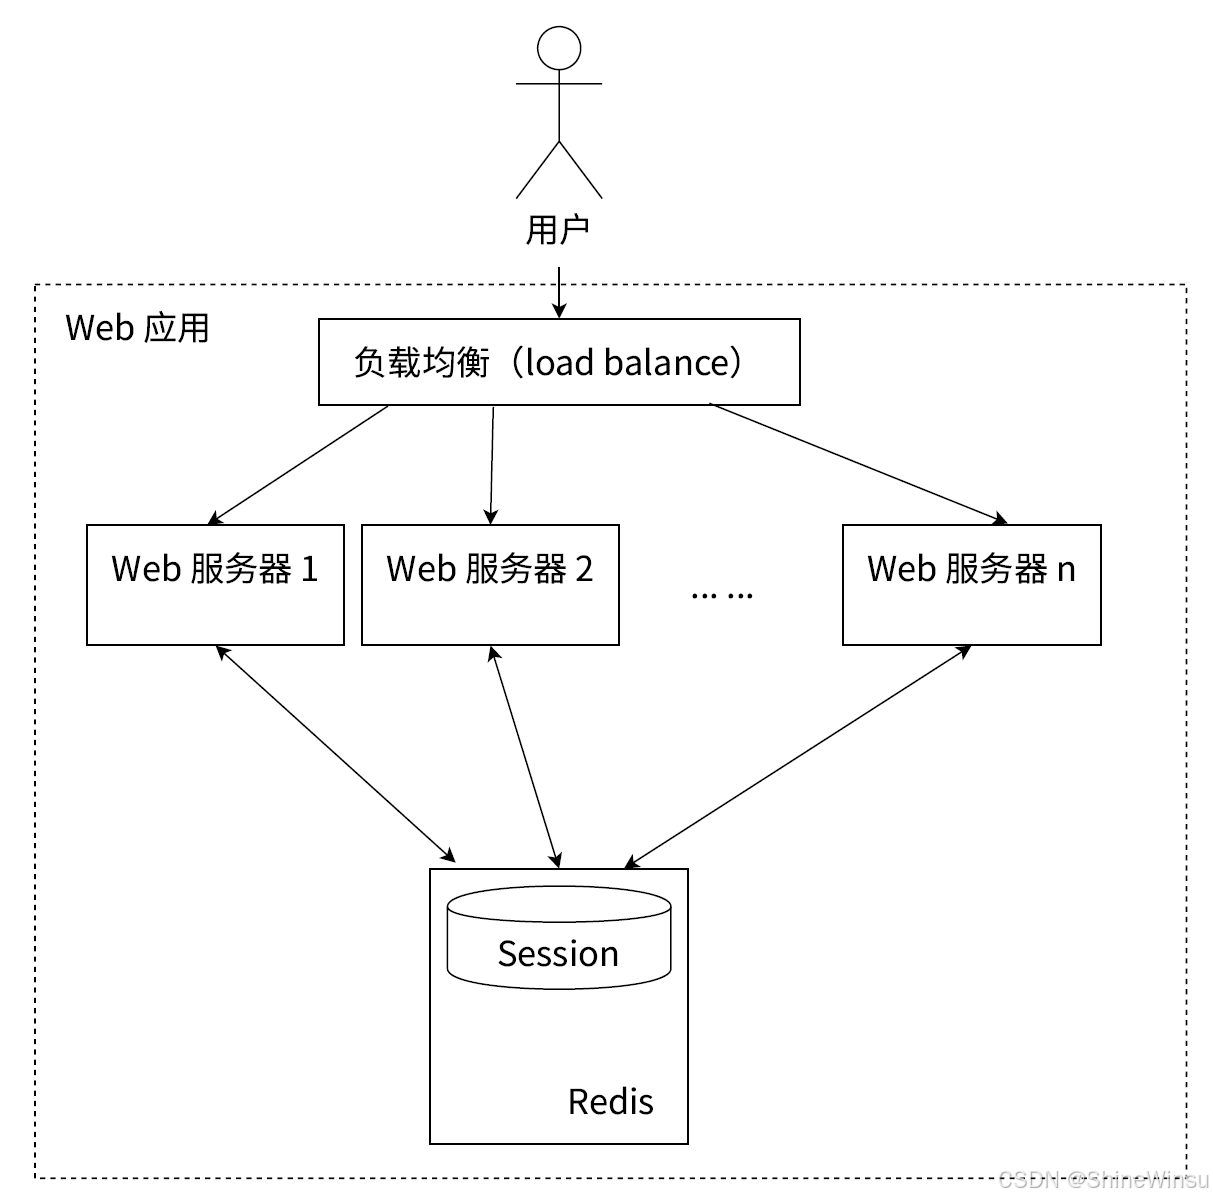
用 Redis String 作为分布式 Session 的统一存储介质,将所有 Web 服务器的 Session 集中存储在 Redis 中,无论用户的请求分发到哪台 Web 服务器,都从 Redis 中读取、更新 Session,实现 Session 的全局共享。
4.4.3 核心设计思路
- Session 集中存储:将用户的 Session 对象序列化为 JSON 字符串,存储到 Redis 中,替代服务器本地内存;
- 键名设计 :
session:id:${sessionId},其中sessionId为用户的会话标识(如浏览器 Cookie 中的 JSESSIONID); - 设置过期时间:为 Session 设置与原生 Session 一致的过期时间(如 30 分钟),Redis 自动过期清理,无需手动维护;
- Session 操作 :Web 服务器的 Session 创建、读取、更新、删除操作,全部转为对 Redis 的
SET/GET/DEL操作; - Cookie 传递 :将
sessionId通过 Cookie 返回给用户浏览器,用户后续请求携带该 Cookie,Web 服务器通过sessionId从 Redis 中获取 Session。
4.4.4 伪代码实现(Java Web 风格,模拟 Session 操作)
java
/**
 * 分布式Session工具类,基于Redis String实现
 */
public class RedisSessionUtil {
    // Redis连接
    private static final Jedis JEDIS = new Jedis("127.0.0.1", 6379);
    // Session过期时间:30分钟(1800秒),与原生Web Session一致
    private static final int SESSION_EXPIRE_SECONDS = 1800;
    // Session键名模板:session:id:${sessionId}
    private static final String SESSION_KEY_TPL = "session:id:%s";

    /**
     * 创建Session:生成sessionId,将Session对象存入Redis
     * @param sessionData Session数据(如用户ID、登录状态)
     * @return sessionId 会话标识
     */
    public static String createSession(Map<String, Object> sessionData) {
        // 1. 生成唯一的sessionId
        String sessionId = UUID.randomUUID().toString().replace("-", "");
        // 2. 将Session数据序列化为JSON字符串
        String sessionJson = JSON.toJSONString(sessionData);
        // 3. 存入Redis并设置过期时间
        String sessionKey = String.format(SESSION_KEY_TPL, sessionId);
        JEDIS.set(sessionKey, sessionJson, SetParams.setParams().ex(SESSION_EXPIRE_SECONDS));
        return sessionId;
    }

    /**
     * 获取Session:通过sessionId从Redis中读取Session数据
     * @param sessionId 会话标识
     * @return Session数据,不存在返回null
     */
    public static Map<String, Object> getSession(String sessionId) {
        if (sessionId == null || sessionId.isEmpty()) {
            return null;
        }
        String sessionKey = String.format(SESSION_KEY_TPL, sessionId);
        String sessionJson = JEDIS.get(sessionKey);
        if (sessionJson == null) {
            return null;
        }
        // 重置Session过期时间(用户活跃时刷新过期时间)
        JEDIS.expire(sessionKey, SESSION_EXPIRE_SECONDS);
        // 反序列化为Map返回
        return JSON.parseObject(sessionJson, new TypeReference<Map<String, Object>>() {});
    }

    /**
     * 更新Session:修改Redis中的Session数据
     * @param sessionId 会话标识
     * @param sessionData 新的Session数据
     * @return 是否更新成功
     */
    public static boolean updateSession(String sessionId, Map<String, Object> sessionData) {
        if (sessionId == null || sessionData == null) {
            return false;
        }
        String sessionKey = String.format(SESSION_KEY_TPL, sessionId);
        if (JEDIS.exists(sessionKey) == 0) {
            return false;
        }
        String sessionJson = JSON.toJSONString(sessionData);
        JEDIS.set(sessionKey, sessionJson, SetParams.setParams().ex(SESSION_EXPIRE_SECONDS));
        return true;
    }

    /**
     * 删除Session:用户退出登录时,从Redis中删除Session
     * @param sessionId 会话标识
     * @return 是否删除成功
     */
    public static boolean deleteSession(String sessionId) {
        if (sessionId == null || sessionId.isEmpty()) {
            return false;
        }
        String sessionKey = String.format(SESSION_KEY_TPL, sessionId);
        return JEDIS.del(sessionKey) > 0;
    }
}

// 业务层使用示例:用户登录创建Session
public String userLogin(String username, String password) {
    // 1. 校验用户名密码(模拟数据库校验)
    if (!"admin".equals(username) || !"123456".equals(password)) {
        return null;
    }
    // 2. 构造Session数据
    Map<String, Object> sessionData = new HashMap<>();
    sessionData.put("userId", 1001L);
    sessionData.put("username", username);
    sessionData.put("loginTime", System.currentTimeMillis());
    sessionData.put("isLogin", true);
    // 3. 创建分布式Session,获取sessionId
    String sessionId = RedisSessionUtil.createSession(sessionData);
    // 4. 将sessionId写入Cookie,返回给浏览器
    // response.addCookie(new Cookie("JSESSIONID", sessionId));
    return sessionId;
}
4.4.5 共享 Session 的关键注意事项
- Session 序列化:建议使用 JSON 序列化 Session 对象,避免使用 Java 原生序列化(序列化后字节数大、兼容性差);
- 刷新过期时间 :用户每次发起有效请求时,需重置 Session 的过期时间(
expire),保证用户活跃时 Session 不会过期; - Cookie 安全 :将存储
sessionId的 Cookie 设置为HttpOnly(防止 XSS 攻击)、Secure(仅 HTTPS 传输)、SameSite=Strict(防止 CSRF 攻击); - Session 过期时间:设置合理的过期时间,过短会导致用户频繁重新登录,过长会占用 Redis 内存,建议 30 分钟~2 小时;
- 避免大 Session:Session 中仅存储用户 ID、登录状态、权限等核心信息,不存储大体积数据(如用户详细信息),减少 Redis 内存占用和网络传输;
- Redis 高可用:Session 存储在 Redis 中,Redis 必须保证高可用(主从复制、哨兵模式、集群),避免 Redis 单点故障导致所有用户 Session 丢失。
4.5 核心场景 5:手机验证码(限流 + 有效期控制)
4.5.1 业务痛点
用户登录 / 注册时的手机验证码功能,存在两个核心问题:
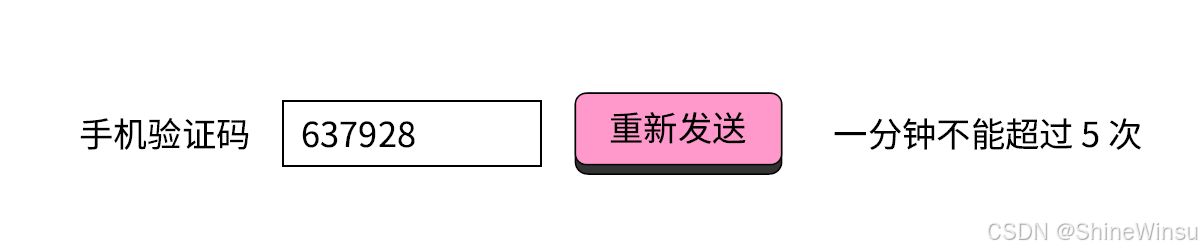
- 短信接口限流:若不限制用户获取验证码的频率,恶意用户会频繁请求获取验证码,导致短信接口被刷、短信费用激增;
- 验证码有效期:验证码需要设置有效期(如 5 分钟),过期后自动失效,避免验证码被他人盗用。
4.5.2 解决方案
用 Redis String 实现验证码的限流 + 有效期控制:
- 频率限流:用
SET key 1 NX EX 60限制用户每分钟只能获取 1 次验证码,后续用INCR计数,超过阈值则拒绝请求; - 验证码存储:用
SET key 验证码 EX 300将验证码存储到 Redis 中,并设置 5 分钟过期时间,过期后自动失效; - 验证逻辑:用户输入验证码后,从 Redis 中读取验证码进行比对,验证成功后立即删除 Redis 中的验证码(防止重复使用)。
4.5.3 核心设计思路
- 限流键名 :
sms:limit:${phoneNumber},记录手机号每分钟的获取次数,60 秒过期; - 验证码键名 :
sms:code:${phoneNumber},存储手机号对应的验证码,300 秒过期; - 限流规则:每分钟最多获取 5 次验证码,超过则拒绝,防止短信轰炸;
- 原子性限流 :用
SET NX初始化限流计数,用INCR累加计数,单命令保证原子性; - 验证码一次性:用户验证成功后,立即删除 Redis 中的验证码,避免同一验证码被重复使用。
4.5.4 伪代码实现(Java 风格)
java
/**
 * 手机验证码工具类,基于Redis String实现限流+有效期控制
 */
public class SmsCodeUtil {
    private static final Jedis JEDIS = new Jedis("127.0.0.1", 6379);
    // 验证码限流键名模板:sms:limit:${phoneNumber},60秒过期(1分钟)
    private static final String SMS_LIMIT_KEY_TPL = "sms:limit:%s";
    // 验证码存储键名模板:sms:code:${phoneNumber},300秒过期(5分钟)
    private static final String SMS_CODE_KEY_TPL = "sms:code:%s";
    // 每分钟最大获取次数:5次
    private static final int MAX_GET_TIMES_PER_MIN = 5;
    // 限流过期时间:60秒
    private static final int LIMIT_EXPIRE_SECONDS = 60;
    // 验证码过期时间:300秒
    private static final int CODE_EXPIRE_SECONDS = 300;

    /**
     * 发送手机验证码:先限流,再生成验证码,最后存储并发送
     * @param phoneNumber 手机号
     * @return 验证码,限流失败返回null
     */
    public static String sendSmsCode(String phoneNumber) {
        // 1. 校验手机号格式(省略)
        if (phoneNumber == null || phoneNumber.length() != 11) {
            return null;
        }
        String limitKey = String.format(SMS_LIMIT_KEY_TPL, phoneNumber);
        // 2. 初始化限流计数:SET key 1 NX EX 60,仅当key不存在时设置(1分钟内第一次获取)
        String limitInit = JEDIS.set(limitKey, "1", SetParams.setParams().nx().ex(LIMIT_EXPIRE_SECONDS));
        Long currentTimes;
        if ("OK".equals(limitInit)) {
            // 第一次获取,计数为1
            currentTimes = 1L;
        } else {
            // 非第一次获取,计数累加
            currentTimes = JEDIS.incr(limitKey);
            // 3. 超过限流阈值,返回null
            if (currentTimes > MAX_GET_TIMES_PER_MIN) {
                return null;
            }
        }
        // 4. 生成6位随机验证码
        String smsCode = String.format("%06d", new Random().nextInt(999999));
        // 5. 将验证码存入Redis,设置5分钟过期时间
        String codeKey = String.format(SMS_CODE_KEY_TPL, phoneNumber);
        JEDIS.set(codeKey, smsCode, SetParams.setParams().ex(CODE_EXPIRE_SECONDS));
        // 6. 调用短信接口发送验证码(模拟)
        sendSms(phoneNumber, smsCode);
        return smsCode;
    }

    /**
     * 验证手机验证码:比对验证码,验证成功后删除
     * @param phoneNumber 手机号
     * @param inputCode 用户输入的验证码
     * @return 是否验证成功
     */
    public static boolean verifySmsCode(String phoneNumber, String inputCode) {
        // 1. 校验参数
        if (phoneNumber == null || inputCode == null || inputCode.length() != 6) {
            return false;
        }
        String codeKey = String.format(SMS_CODE_KEY_TPL, phoneNumber);
        // 2. 从Redis中获取验证码
        String redisCode = JEDIS.get(codeKey);
        // 3. 验证码不存在/不一致,验证失败
        if (redisCode == null || !redisCode.equals(inputCode)) {
            return false;
        }
        // 4. 验证成功,立即删除验证码(防止重复使用)
        JEDIS.del(codeKey);
        return true;
    }

    // 模拟调用短信接口发送验证码
    private static void sendSms(String phoneNumber, String smsCode) {
        log.info("向手机号{}发送验证码:{}", phoneNumber, smsCode);
        // 调用第三方短信接口:如阿里云短信、腾讯云短信
    }
}

// 业务层使用示例
public static void main(String[] args) {
    // 1. 发送验证码
    String smsCode = SmsCodeUtil.sendSmsCode("13800138000");
    System.out.println("发送的验证码:" + smsCode);
    // 2. 验证验证码(用户输入正确)
    boolean verifySuccess = SmsCodeUtil.verifySmsCode("13800138000", smsCode);
    System.out.println("验证码验证结果:" + verifySuccess);
    // 3. 重复验证(验证码已被删除,验证失败)
    boolean verifyFail = SmsCodeUtil.verifySmsCode("13800138000", smsCode);
    System.out.println("重复验证结果:" + verifyFail);
}
4.5.5 手机验证码的关键注意事项
- 验证码格式:建议使用 6 位数字验证码,简单易记,避免字母 + 数字的复杂格式;
- 限流规则:根据短信接口的限流能力设置合理的获取频率,建议每分钟≤5 次,每小时≤20 次,防止恶意刷量;
- 验证码一次性:验证成功后必须立即删除 Redis 中的验证码,避免同一验证码被他人重复使用;
- 短信接口容错:调用第三方短信接口时,需增加重试、熔断机制,避免短信接口故障导致业务阻塞;
- 防止验证码泄露:Redis 中存储的验证码无需加密(短期有效,且为随机数),但需保证 Redis 的访问安全,禁止外部网络直接访问;
- 空值处理:用户输入的验证码为空、格式错误时,直接返回验证失败,无需访问 Redis。
五、Redis String 类型的避坑指南与性能优化
Redis String 类型虽然简单易用,但在生产环境中,若使用不当,会导致内存占用过高、性能下降、服务阻塞等问题。本节总结了开发中最常见的坑,以及对应的优化方案,帮助你规范使用 String 类型,发挥 Redis 的极致性能。
5.1 坑 1:键名设计不规范,导致键冲突、可维护性差
问题表现
使用无意义的键名(如user1001、code13800138000)、不同业务的键名无区分,导致不同业务的键冲突,后期难以维护和排查问题。
优化方案
遵循统一的键名设计规范,让键名 "见名知意",核心规范:
【可选】业务名:对象名:唯一标识[:属性]- 业务名:若 Redis 为多业务共享,添加业务名(如
order、user、goods),隔离不同业务的键; - 对象名:表示键对应的业务对象(如
info、stock、play、code); - 唯一标识:区分同一对象的不同实例(如用户 ID、商品 ID、手机号);
- 属性:可选,标识对象的具体属性(如
name、age、price)。
规范示例:
- 正确:
user:info:1001、goods:stock:5253、sms:code:13800138000、video:play:10086; - 错误:
user1001、stock5253、code13800138000、play10086。
额外优化 :若键名过长,可使用团队内部约定的缩写 (如u:info:1001代替user:info:1001),减少键名的内存占用。
5.2 坑 2:存储大字符串,导致内存占用高、网络传输慢
问题表现
将大体积数据(如超过 100KB 的图片、大文本、完整的业务对象)存储为 String 类型,导致:
- Redis 内存占用快速飙升,频繁触发内存淘汰,影响性能;
- 网络传输大字符串耗时久,接口响应慢;
- 单命令执行时间过长,阻塞 Redis 单线程。
优化方案
- 拆分大字符串 :将大的结构化对象拆分为多个小的 String 键值对,按需读取,避免一次性传输大数据;
- 示例:将
user:info:1001(存储完整的用户对象 JSON)拆分为user:1001:name、user:1001:age、user:1001:gender;
- 示例:将
- 避免存储二进制大文件:不要将图片、音频、视频等二进制大文件存储到 Redis 中,建议使用 OSS、MinIO 等对象存储,Redis 仅存储文件的 URL;
- 控制字符串大小 :单个 String 值的大小建议不超过 10KB ,高频访问的热点数据建议不超过 1KB;
- 使用压缩算法:若必须存储较长的字符串(如大文本),先通过 Gzip、Snappy 等压缩算法压缩后再存储,减少内存占用和网络传输量。
5.3 坑 3:滥用单次操作,忽视批量操作,导致网络 IO 过高
问题表现
需要操作多个 String 键时,使用多次SET/GET命令,而非MSET/MGET,导致多次网络请求,网络 IO 成为性能瓶颈(Redis 的纯内存操作耗时可忽略,性能瓶颈主要在网络)。
优化方案
- 优先使用批量操作 :同时操作多个键时,一律使用
MSET/MGET,将多次网络请求合并为一次,大幅减少网络 IO 开销; - 控制批量操作的键数 :批量操作的键数不宜过多(建议≤1000 个),否则会导致单个命令执行时间过长,阻塞 Redis 单线程;
- 分批批量操作 :若需要操作的键数超过 1000 个,将其拆分为多个批次的
MSET/MGET,每批次 1000 个键以内,避免单命令阻塞; - 客户端优化:使用支持 ** 管道(Pipeline)** 的 Redis 客户端(如 Jedis、Redisson),将多个命令通过管道批量发送到 Redis,减少 TCP 握手和挥手的开销。
5.4 坑 4:使用 GET+SET 实现计数,而非原生计数命令,导致计数错误
问题表现
实现计数功能时,先通过GET读取当前值,在客户端进行加减计算,再通过SET写回 Redis,即:
// 错误示例:非原子操作,高并发下会导致计数错误
Long count = Long.parseLong(jedis.get("counter"));
count += 1;
jedis.set("counter", count.toString());高并发下,多个客户端同时GET到相同的计数值,最终写回的结果会覆盖,导致计数少加 / 少减。
优化方案
- 使用原生原子计数命令 :实现整型计数用
INCR/INCRBY/DECR/DECRBY,实现浮点型计数用INCRBYFLOAT,所有计算在 Redis 服务端完成,单命令保证原子性,无计数错误; - 禁止客户端参与计数计算:计数的核心逻辑必须在 Redis 服务端完成,客户端仅负责发起计数命令和获取结果;
- 计数清零用 SET 而非 DEL :需要将计数值清零时,使用
SET counter 0,而非DEL counter,避免后续INCR时重新初始化计数值为 0,导致计数逻辑异常。
5.5 坑 5:未设置过期时间,导致缓存脏数据、内存泄漏
问题表现
使用 String 类型做缓存时,未设置过期时间(EX/PX),导致:
- 缓存脏数据:数据库中的数据更新后,Redis 中的缓存数据未及时更新,长期有效,导致用户读取到旧数据;
- 内存泄漏:Redis 中的缓存数据永久有效,内存占用持续飙升,最终触发内存淘汰,甚至导致 Redis 服务崩溃。
优化方案
- 为所有缓存键设置过期时间 :使用
SET key value EX/PX或EXPIRE为缓存键设置合理的过期时间,避免缓存永久有效; - 设置随机过期时间 :多个同类缓存键的过期时间建议增加随机偏移量 (如 3600±60 秒),避免大量缓存键在同一时间过期,导致缓存雪崩 (大量缓存同时失效,请求全部涌入数据库);
- 示例:
jedis.set(key, value, SetParams.setParams().ex(3600 + new Random().nextInt(120)));
- 示例:
- 主动删除脏缓存 :数据库中的数据更新 / 删除时,立即通过
DEL命令删除 Redis 中对应的缓存键,而非更新缓存,避免缓存与数据库不一致; - 使用过期策略:根据业务特性设置合理的过期策略,热点数据设置较长的过期时间(如 1 小时),冷数据设置较短的过期时间(如 10 分钟)。
5.6 坑 6:忽视内部编码,导致内存利用率低
问题表现
不了解 Redis String 的内部编码规则,导致 Redis 无法使用最优的编码(int/embstr),而是使用通用的 raw 编码,内存利用率低。
优化方案
- 计数场景用整型:计数功能的键值直接存储为整型,让 Redis 使用 int 编码,极致节省内存;
- 控制短字符串长度 :高频访问的短字符串尽量控制在39 字节以内,让 Redis 使用 embstr 编码,提升缓存命中率和操作性能;
- 避免频繁修改短字符串:embstr 编码的字符串修改后会转为 raw 编码,且不可逆,若需要频繁修改字符串,提前考虑使用 raw 编码,避免编码转换的开销;
- 批量初始化短字符串 :对多个短字符串进行初始化时,使用
MSET,减少 Redis 的内存分配开销。
5.7 坑 7:使用非原子命令实现分布式锁,导致死锁、误删锁
问题表现
实现分布式锁时,使用SETNX+EXPIRE(非原子)加锁,使用GET+DEL(非原子)解锁,导致:
- 死锁 :
SETNX加锁后,服务挂掉,未执行EXPIRE,锁永久有效; - 误删锁 :
GET读取锁后,锁过期,其他实例获取了锁,当前实例执行DEL,删除了其他实例的锁。
优化方案
- 原子性加锁 :一律使用
SET key value NX EX seconds单命令加锁,原子性完成加锁 + 设置过期时间,避免死锁; - 原子性解锁 :使用Lua 脚本实现解锁,先判断锁的 value 是否为当前实例的唯一标识,再删除,避免误删锁;
- 设置合理的锁过期时间:过期时间需大于业务的最大执行耗时,避免业务未执行完锁已过期;
- 使用成熟的锁框架:若需要更复杂的分布式锁(如重入锁、公平锁、红锁),直接使用 Redisson 框架,无需手动实现,避免造轮子。
5.8 坑 8:滥用 APPEND/SETRANGE,导致 embstr 转为 raw
问题表现
对 embstr 编码的短字符串频繁执行APPEND/SETRANGE等修改操作,导致 embstr 编码转为 raw 编码,失去 embstr 的性能优势(连续内存、高缓存命中率)。
优化方案
- 避免频繁修改短字符串:若字符串需要频繁修改,提前规划为 raw 编码,无需追求 embstr;
- 一次性设置字符串 :尽量在
SET时直接设置完整的字符串,避免后续通过APPEND拼接; - 拆分修改操作 :若需要修改字符串的部分内容,可将字符串拆分为多个小字符串,修改单个小字符串,而非通过
SETRANGE修改原字符串。
六、Redis String 类型的核心总结
Redis String 类型作为最基础、最核心、使用频率最高的数据类型,是 Redis 的入门必修课,也是后续学习 list、hash、set、zset 的基础。
6.1 基础特性:掌握本质,避开认知误区
- Redis String 是二进制安全的动态字节数组,非普通编程语言的字符串,支持存储字符串、数字、二进制流,最大容量 512MB;
- Redis 中所有键的类型都是 String,其他数据结构的元素也均为 String;
- Redis 不处理字符集编码,客户端用什么编码存入,就用什么编码读取,乱码问题由客户端解决;
- String 支持数字原生原子操作,是实现计数功能的核心优势。
6.2 核心命令:按模块记忆,按需使用
将 String 命令分为4 大模块,重点掌握高频命令和核心选项:
- 基础操作 :
SET(NX/XX/EX/PX 选项)、GET、DEL,SET的选项是实现分布式锁、缓存的核心; - 批量操作 :
MSET、MGET,减少网络 IO,提升性能,核心优化技巧; - 计数操作 :
INCR/INCRBY/DECR/DECRBY/INCRBYFLOAT,原子计数,高并发下无计数错误; - 字符串操作 :
APPEND、STRLEN、GETRANGE、SETRANGE,服务端原生操作,减少客户端开销。
6.3 内部编码:智能优化,透明适配
Redis 根据存储内容自动选择3 种内部编码,单向不可逆,平衡内存和性能:
- int:8 字节 64 位有符号整型,极致节省内存,适合计数场景;
- embstr:≤39 字节的短字符串,连续内存存储,高缓存命中率,不可修改;
- raw:>39 字节的长字符串或可修改的短字符串,灵活存储,支持动态扩容。
可通过object encoding key命令查看键的内部编码,开发中无需手动干预,只需根据编码规则优化数据存储。
6.4 实战场景:覆盖 90% 的互联网业务
String 类型的实战场景覆盖了绝大多数互联网业务,核心 5 大场景必须掌握:
- 缓存层:最经典场景,加速读写,降低数据库压力,核心是缓存命中 / 未命中逻辑 + 过期时间;
- 计数功能:视频播放量、接口访问量、点赞数,原生原子计数命令,高性能;
- 分布式锁 :
SET key value NX EX seconds+Lua 脚本解锁,简单高效,解决分布式并发竞争; - 共享 Session:分布式 Web 服务的统一会话,解决 Session 分散问题,提升用户体验;
- 手机验证码:限流 + 有效期控制,防止短信轰炸,保证验证码安全。
6.5 避坑优化:规范使用,发挥极致性能
生产环境中,String 类型的坑主要集中在键名设计、数据大小、网络 IO、原子操作、过期时间五个方面,核心优化原则:
- 键名设计遵循规范,见名知意,隔离业务;
- 控制 String 值的大小,避免存储大字符串和二进制大文件;
- 优先使用批量操作和管道,减少网络 IO;
- 计数、锁等场景使用 Redis 原生原子命令,避免客户端非原子操作;
- 所有缓存键必须设置过期时间,增加随机偏移量,避免缓存雪崩;
- 了解内部编码规则,按需优化数据存储,提升内存利用率。
结语
到这里,Redis String 类型的全方位解析就圆满结束了。作为 Redis 最基础、最核心、使用频率最高的数据类型,String 看似简单,却藏着 Redis 设计的精髓 ------以二进制安全的动态字节数组为底层,用智能内部编码平衡内存与性能,靠原子命令支撑高并发场景。
回顾整篇内容,我们从 "二进制安全""键固定为 String" 等基础特性入手,拆解了四大类核心命令(基础增删查改、批量操作、原子计数、字符串操作),深入剖析了 int/embstr/raw 三种内部编码的适配逻辑,最后落地到缓存、计数、分布式锁、共享 Session、手机验证码五大实战场景,还总结了 8 个高频避坑点。这些内容层层递进,本质上是在传递一个核心思想:Redis String 的强大,在于它的 "灵活与极致"------ 既能存储文本、数字、二进制等任意数据,又能通过内部优化和原子命令,在高并发场景下保持高性能。
对开发者而言,String 类型的学习价值不仅在于 "会用命令",更在于 "理解设计逻辑":比如内部编码的自动切换,是 Redis "场景化优化" 的体现;批量操作和原子命令,是 Redis 应对高并发的核心手段;而避坑指南中的规范(如键名设计、过期时间设置),则是生产环境稳定运行的保障。这些逻辑和规范,同样适用于后续其他数据结构的学习。
String 类型是 Redis 学习之路的 "基石",学好它,你已经掌握了 Redis 80% 的常用场景。接下来,我们将陆续学习 list、hash、set、zset 等其他数据结构,它们本质上都是基于 String 构建的,很多命令逻辑和设计思想可以直接复用。建议你在学习后续内容时,多回头对比 String 类型的特性,比如 hash 与 String 存储结构化数据的差异、zset 与 String 计数功能的互补,这样能更快形成完整的 Redis 知识体系。
最后再叮嘱一句:Redis 的学习离不开实操。建议你把文中的命令、场景案例在自己的 Redis 环境中反复演练,尤其是原子计数、分布式锁、批量操作这些核心功能,亲手验证内部编码的转换、感受批量操作的性能优势、踩一踩未设置过期时间的坑,才能真正把知识内化为能力。
String 类型的学习是 Redis 探索之旅的重要一站,它让我们看到 "基础组件" 如何通过优秀设计支撑起复杂业务。接下来,让我们带着对 String 类型的理解,继续深入 Redis 其他数据结构的世界,解锁更多高性能场景的解决方案,我们下次博客再见~