本文摘要:深分页 offset 达九十万时单页常耗数秒,页码越深越慢。延迟关联先在索引挑出 id,再回表 20 行,回表次数从 offset+N 降到 N。
一、问题与结论
orders 表约 100 万行,SELECT * FROM orders ORDER BY created_at DESC LIMIT 900000, 20 走的是 idx_created (created_at),offset 90 万与 offset 1 万的响应差着量级(量级判断,需按第四节命令实测)。慢的不是缺索引:MySQL 为了取最后 20 行,必须先把前 90 万行逐条回表取完整列,再把它们全部丢弃。
结论先行:改写后回表从 offset+20 次降到 20 次,代价是 SQL 多一层派生表,且被跳过的索引条目仍要顺序读;offset 到千万级时收益明显缩水。业务只要允许顺序翻页,游标分页才是与页码无关的解法。
二、排查与选择依据
判断一条深分页值不值得改写,看 EXPLAIN 的 type、rows、Extra 三处:
Extra出现Using index:只读二级索引 B+ 树,零回表;SELECT *不出现它,说明每行都要回表取非索引列。Extra出现Using filesort:ORDER BY列没走上索引排序,延迟关联的收益基本消失。- 外层
type=eq_ref且rows=20:回表只发生在最终 20 行,说明改写生效。 - 派生表
rows估算仍接近全表:符合预期,offset扫描没有消失。
索引选择上,InnoDB 二级索引记录是 (索引列, 主键),idx_created 已能覆盖 SELECT id,不需要为延迟关联额外建索引。若列表只查 created_at, user_id, status, amount 这类少量列,直接建 INDEX(created_at, user_id, status, amount) 走覆盖索引更简单,但索引变宽会放大写入与页分裂成本,remark 这类大字段不能进索引。
另有两个常见前置判断:COUNT(*) 需要扫描整棵索引树,深分页接口若每页都带总数,统计成本往往高于翻页本身,可缓存总数、只在第一页统计,或用"是否还有下一页"替代;业务若只需上一页/下一页,优先游标分页。
替代方案与取舍
| 方案 | 选择条件 | 代价 | 边界 |
|---|---|---|---|
| 延迟关联 | 必须跳页,offset 在十万到百万级 |
仍要顺序扫 offset 条索引;SQL 多一层派生表 |
offset 超千万收益有限;ORDER BY 无索引时无效 |
| 游标分页 | 只需顺序翻页,排序键唯一或有复合游标 | 不能跳页;要保存上一页末尾游标值 | created_at 有重复时须用 (created_at, id) 复合游标,否则漏行 |
| 覆盖索引 | SELECT 列少且固定 | 索引宽、写放大 | 列多或含大字段时不可行 |
ORDER BY 列无可用索引、offset 长期在千万级、SQL 带 GROUP BY 或聚合时,改写只增加复杂度,不该用延迟关联。
三、关键原理
InnoDB 聚簇索引叶子节点是完整行,二级索引叶子是 (索引列, 主键)。SELECT * 在二级索引上拿到主键后,必须回到聚簇索引取其余列,这一次随机查找就是回表;深分页里前 offset 条各回表一次后被丢弃,成本是 O(offset+N) 次回表。
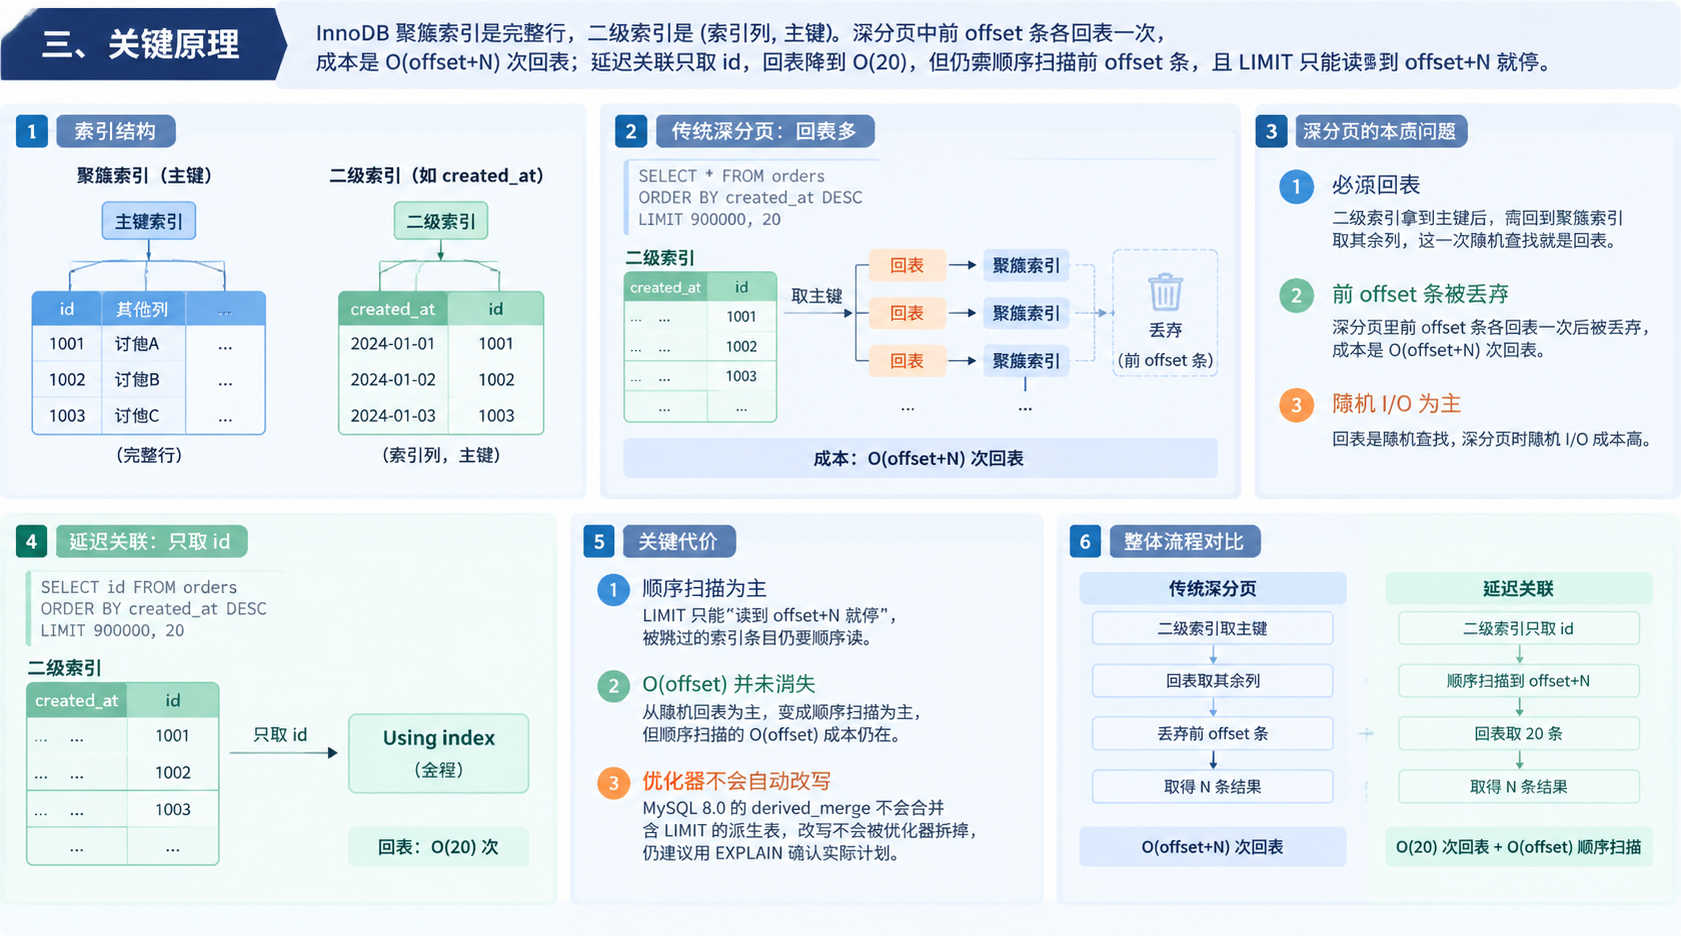
延迟关联的子查询 SELECT id FROM orders ORDER BY created_at DESC LIMIT 900000, 20 只取 id,id 已在 idx_created 中,扫描全程 Using index,回表降到 O(20) 次。但 LIMIT 只能"读到 offset+N 就停",被跳过的索引条目仍要顺序读,成本从随机回表为主变成顺序扫描为主,O(offset) 并未消失。MySQL 8.0 的 derived_merge 不会合并含 LIMIT 的派生表,改写不会被优化器拆掉,仍建议用 EXPLAIN 确认实际计划。
四、可运行示例
环境:MySQL 8.0.x、InnoDB、默认配置。用 digits 表交叉连接生成 100 万行,created_at 每 3 行共用同一秒,便于验证游标去重。
sql
DROP TABLE IF EXISTS digits;
CREATE TABLE digits (d TINYINT PRIMARY KEY) ENGINE=InnoDB;
INSERT INTO digits VALUES (0),(1),(2),(3),(4),(5),(6),(7),(8),(9);

DROP TABLE IF EXISTS orders;
CREATE TABLE orders (
    id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    user_id INT UNSIGNED NOT NULL,
    status TINYINT NOT NULL,
    amount DECIMAL(10,2) NOT NULL,
    created_at DATETIME NOT NULL,
    remark VARCHAR(200),
    INDEX idx_created (created_at)
) ENGINE=InnoDB;

INSERT INTO orders (user_id, status, amount, created_at, remark)
SELECT seq % 100000, seq % 5, (seq % 10000) / 100,
       DATE_ADD('2024-01-01 00:00:00', INTERVAL (seq DIV 3) SECOND),
       CONCAT('r-', seq)
FROM (
    SELECT a.d + b.d*10 + c.d*100 + e.d*1000 + f.d*10000 + g.d*100000 AS seq
    FROM digits a, digits b, digits c, digits e, digits f, digits g
) t;

ANALYZE TABLE orders;
方式 A:直接深分页。
sql
EXPLAIN
SELECT * FROM orders ORDER BY created_at DESC LIMIT 900000, 20;
预期输出(关键列):
text
type=index key=idx_created rows≈1000000 Extra: 不出现 Using index实际输出:执行后比对 type、key、rows、Extra 四项,Extra 没有 Using index 就意味着每行都回表。
方式 B:延迟关联。
sql
EXPLAIN
SELECT t.*
FROM orders t
JOIN (
    SELECT id FROM orders ORDER BY created_at DESC LIMIT 900000, 20
) tmp ON t.id = tmp.id;
预期输出:
text
<derived2>  type=index   key=idx_created  rows≈1000000  Extra: Using index
orders t    type=eq_ref  key=PRIMARY      rows=20       Extra: 无 Using filesort
实际输出:派生表一侧出现 Using index、外层 rows=20 即改写生效;8.0.18 起可用 EXPLAIN ANALYZE 看到实际循环次数与耗时。
计时对比:
bash
time mysql -u root -p -D test -e "SELECT * FROM orders ORDER BY created_at DESC LIMIT 900000, 20"
time mysql -u root -p -D test -e "SELECT t.* FROM orders t JOIN (SELECT id FROM orders ORDER BY created_at DESC LIMIT 900000, 20) tmp ON t.id = tmp.id"
预期输出:两条命令 real 时间的差值即收益,常见量级是延迟关联进入两位数毫秒、原写法为秒级(量级预期,未在本文环境中实测)。实际输出:同一机器、同一数据各跑 5 次取中位数,避免缓冲池冷热差异。
游标分页(顺序翻页,已知上一页末行 ('2024-01-10 08:00:00', 500000)):
sql
SELECT id, user_id, status, amount, created_at
FROM orders
WHERE (created_at, id) < ('2024-01-10 08:00:00', 500000)
ORDER BY created_at DESC, id DESC
LIMIT 20;失败处理:ORDER BY 列无索引时,延迟关联反而更慢。
sql
DROP INDEX idx_created ON orders;
EXPLAIN
SELECT t.* FROM orders t
JOIN (SELECT id FROM orders ORDER BY created_at DESC LIMIT 900000, 20) tmp ON t.id = tmp.id;
预期输出:派生表 type=ALL,Extra: Using filesort; Using temporary。原因:子查询无法用索引完成排序,全表扫描加 filesort 的成本远大于省下的回表,多一层 JOIN 只是额外开销。修复:补回 idx_created,或按上文改用游标分页;若游标查询出现 Using filesort,显式补 (created_at, id) 复合索引。
五、验证结果与边界
读数方式:EXPLAIN 只给估算,收益要用同一数据下两条计时命令的差值衡量;EXPLAIN ANALYZE 输出实际循环次数,可直接看到派生表扫过多少索引条目、外层回表多少次。上文耗时为量级预期,未在本文环境中实测。
代价与边界:
- 子查询仍要顺序读
offset条索引条目,offset千万级时通常只能从"秒级"降到"亚秒级"。 - 每页统计
COUNT(*)时,统计成本常高于分页本身;用缓存总数、只统计第一页或改"是否还有下一页"。 ORDER BY无索引、SQL 带聚合或GROUP BY、列表要查大字段时,延迟关联不适用。offset长期超千万且必须跳页时,预计算页码映射或搜索系统的search_after更合适。
思考
- 列表页返回的总条数,是牺牲统计实时性换取体验,还是收敛成"是否还有下一页"?
- 产品是否真需要任意跳页,还是能把交互收敛为顺序翻页,换得与页码无关的响应?