工业现场的数据链路,很多时候比互联网后端要"拧巴"。一个中型产线,可能有几百个 PLC、传感器、仪表在持续上报数据,采样频率从几百毫秒到几秒不等。这些数据先落到采集网关,再进消息队列,然后一部分要存下来做历史查询,另一部分要立刻算------比如判断某个温度是不是连续超限、某个振动值是不是在恶化。
传统做法是时序库存一份,实时计算框架读一份,两边各管各的。数据在中间搬来搬去,延迟和运维成本都上去了。这两年"时序库+实时计算一体化"的说法越来越多,但到底哪种组合适合自己,很多团队其实没想清楚。
这篇文章不打算给一个"标准答案",因为工业场景差异太大。我想做的是把几种主流方案拉出来,从接入方式、延迟、运维复杂度几个角度对比,并给出可以实际跑起来的代码片段,让你能自己判断。
先明确"一体化"到底指什么
在讨论方案之前,得先把概念说清楚。所谓一体化,通常指下面几种情况之一:
- 时序数据库自己带流式计算能力,写入的同时就能触发规则运算;
- 时序库和计算引擎深度集成,比如共享存储层或统一 SQL 接口;
- 以消息队列为核心,时序库和计算引擎都作为下游消费者,数据只写一次。
这三种思路的取舍点完全不同。第一种省事但计算能力受限,第二种灵活但对版本和生态有要求,第三种解耦最好但链路最长。下面逐个说。
方案一:时序库自带流计算
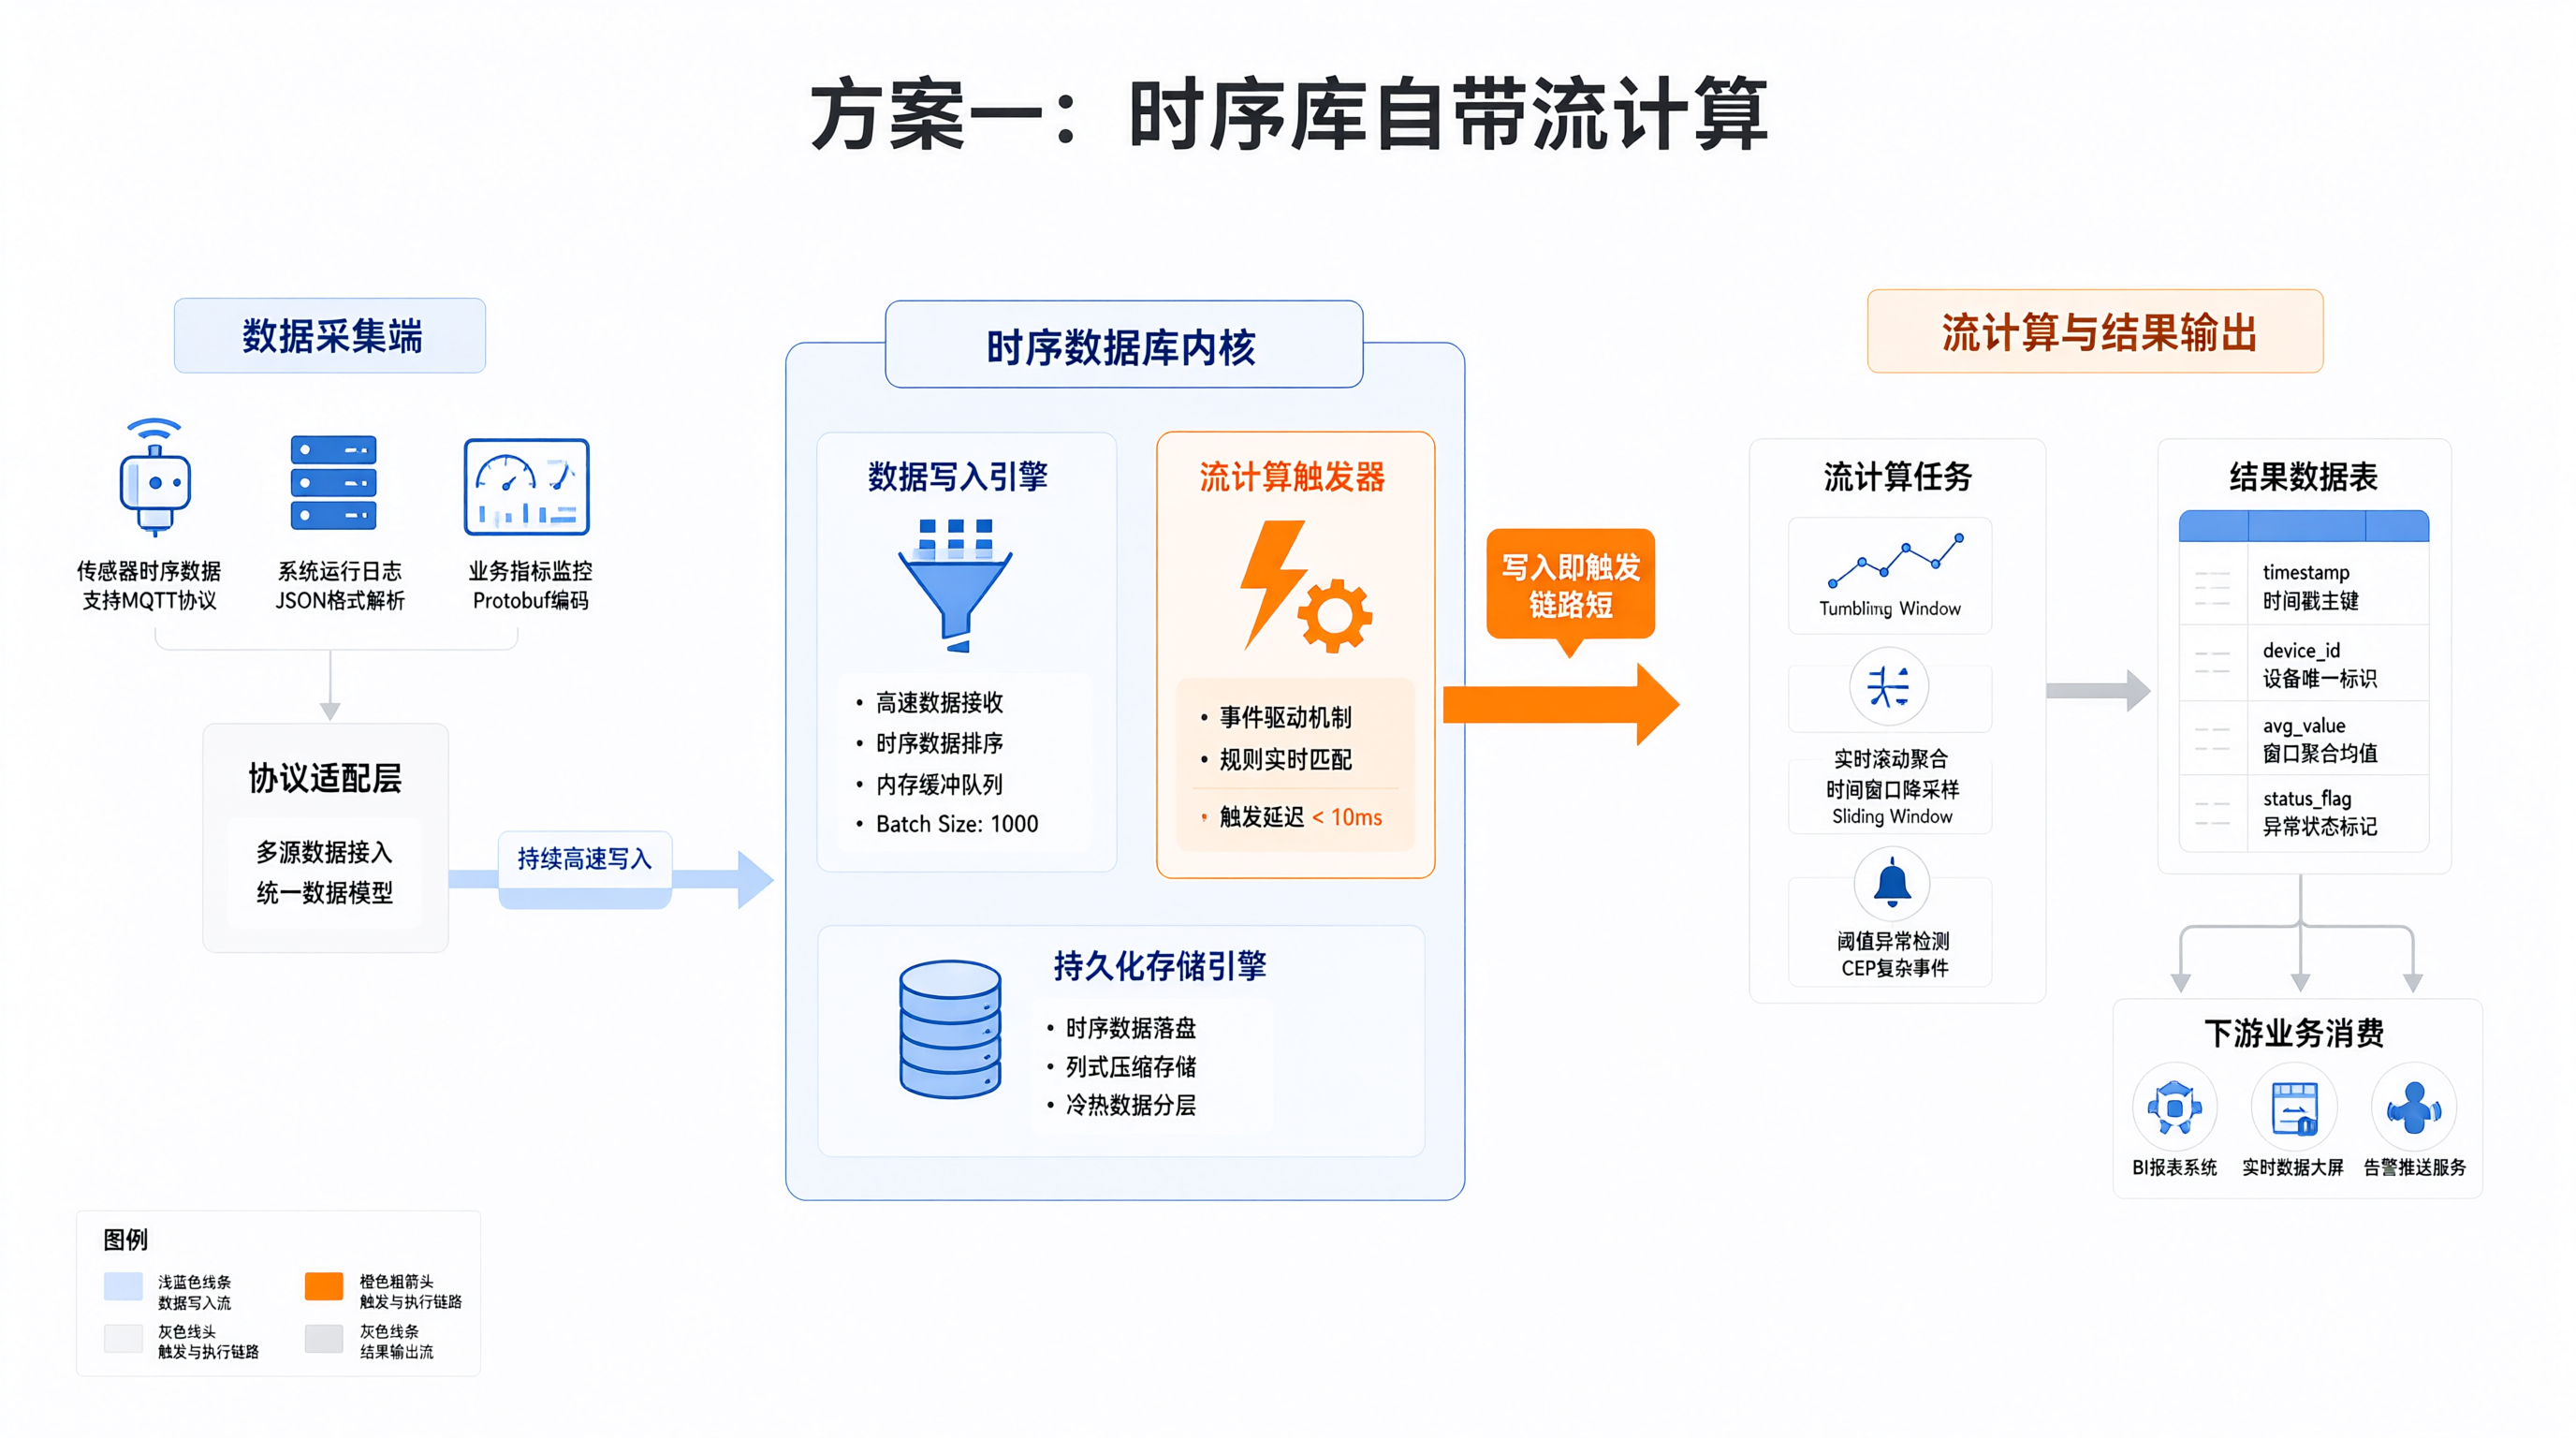
很多时序数据库近些年都在往"库+计算"方向走。以 TDengine 为例,它提供了流式计算(Stream)能力,可以在建流的时候指定触发条件,数据写入时自动计算并写入结果表。类似的思路在 InfluxDB 的任务系统、TimescaleDB 的连续聚合里也能看到影子。
这种方案最大的好处是链路短。数据写入即触发计算,不需要额外的计算框架,也不需要把数据再读出来。对于"阈值判断""滑动窗口聚合"这类相对固定的计算,非常合适。
我用 Python 写一个简化示例,模拟通过 REST 接口写入数据并建立流计算任务。这里不写具体版本的 API 参数,因为各版本接口有差异,建议以你实际部署版本的官方文档为准。
python
import requests
import time
import random

# 假设 TDengine 的 REST 接口地址,实际以你的部署为准
BASE_URL = "http://localhost:6041/rest/sql"
AUTH = ("root", "taosdata")

def exec_sql(sql: str):
    resp = requests.post(
        BASE_URL,
        data=sql.encode("utf-8"),
        auth=AUTH,
        timeout=5,
    )
    resp.raise_for_status()
    return resp.json()

# 建库建表(简化,未加保留策略等参数)
exec_sql("CREATE DATABASE IF NOT EXISTS factory")
exec_sql("USE factory")
exec_sql(
    "CREATE TABLE IF NOT EXISTS sensor_temp "
    "(ts TIMESTAMP, device_id NCHAR(32), temp FLOAT)"
)

# 写入模拟数据
now = int(time.time() * 1000)
for i in range(20):
    ts = now + i * 1000
    temp = 60 + random.uniform(-5, 15)
    exec_sql(
        f"INSERT INTO sensor_temp VALUES "
        f"({ts}, 'dev_001', {temp:.2f})"
    )

# 建一个流:温度超过 70 时写入告警表
# 具体语法请以你使用的版本为准,这里只表达思路
exec_sql(
    "CREATE STREAM IF NOT EXISTS temp_alarm "
    "INTO temp_alarm_table AS "
    "SELECT ts, device_id, temp FROM sensor_temp WHERE temp > 70"
)这段代码的重点不在语法本身,而在于计算逻辑被下推到了数据库内部。你不需要维护一个 Flink 集群,也不需要写消费逻辑。对于规则相对固定的场景,这是最省心的路径。
但它也有明显短板。流计算能力通常只覆盖 SQL 能表达的运算,一旦你需要调用外部模型、做复杂状态管理、或者跨多个数据源关联,就会很吃力。所以我的判断是:规则简单、变化少、团队没有专职流计算开发,优先考虑这条路。
方案二:时序库 + Flink 组合
如果计算逻辑复杂,或者需要和别的数据源做关联,Flink 这类流计算框架仍然是主流选择。它的优势是状态管理成熟、Exactly-Once 语义有保障、生态丰富。
问题在于,Flink 和时序库之间怎么衔接。常见做法有两种:一是 Flink 直接读时序库的变更,二是 Flink 从消息队列消费,算完再写回时序库。
第一种做法依赖时序库的 CDC 能力,不是所有库都支持得好。第二种更通用,但意味着数据要先进消息队列。
我用 PyFlink 写一个最小示例,展示从 Kafka 消费、做窗口聚合、再写回外部存储的骨架。注意 PyFlink 的版本差异较大,下面代码基于较新的 1.17+ 风格,老版本 API 不同。
python
from pyflink.datastream import StreamExecutionEnvironment
from pyflink.datastream.connectors.kafka import (
    KafkaSource,
    KafkaOffsetsInitializer,
)
from pyflink.common.serialization import SimpleStringSchema
from pyflink.common import WatermarkStrategy, Duration, Types
from pyflink.datastream.functions import MapFunction


class ParseSensor(MapFunction):
    """把 Kafka 里的 JSON 字符串解析成元组"""

    def map(self, value):
        import json
        obj = json.loads(value)
        return (obj["device_id"], obj["ts"], float(obj["temp"]))


def build_job():
    env = StreamExecutionEnvironment.get_execution_environment()
    env.set_parallelism(2)

    source = (
        KafkaSource.builder()
        .set_bootstrap_servers("localhost:9092")
        .set_topics("sensor_raw")
        .set_group_id("flink_sensor_group")
        .set_starting_offsets(KafkaOffsetsInitializer.latest())
        .set_value_only_deserializer(SimpleStringSchema())
        .build()
    )

    stream = env.from_source(
        source,
        WatermarkStrategy.for_bounded_out_of_orderness(
            Duration.of_seconds(5)
        ),
        "kafka_sensor_source",
    )

    parsed = stream.map(
        ParseSensor(),
        output_type=Types.TUPLE(
            [Types.STRING(), Types.LONG(), Types.FLOAT()]
        ),
    )

    # 这里做窗口聚合,比如 10 秒内每个设备的平均温度
    # 实际写回时序库需要自定义 Sink,此处省略具体实现
    agg = parsed.key_by(lambda x: x[0]).count_window(10)

    agg.print()

    env.execute("sensor_aggregation_job")


if __name__ == "__main__":
    build_job()
这段代码只是骨架,真正落地时,Sink 部分需要你自己实现,或者用现成的连接器。这也是这个方案的一个现实问题:集成工作量大,且很多连接器质量参差不齐。
【踩坑提醒】PyFlink 和 Flink 的版本必须严格对齐,尤其是连接器依赖。用 pip 装 pyflink 时,Kafka 连接器往往需要单独下载 jar 并放到指定目录,否则运行时会报类找不到。这一点我建议在测试环境先跑通最小链路,再上生产。
方案三:消息队列为中心
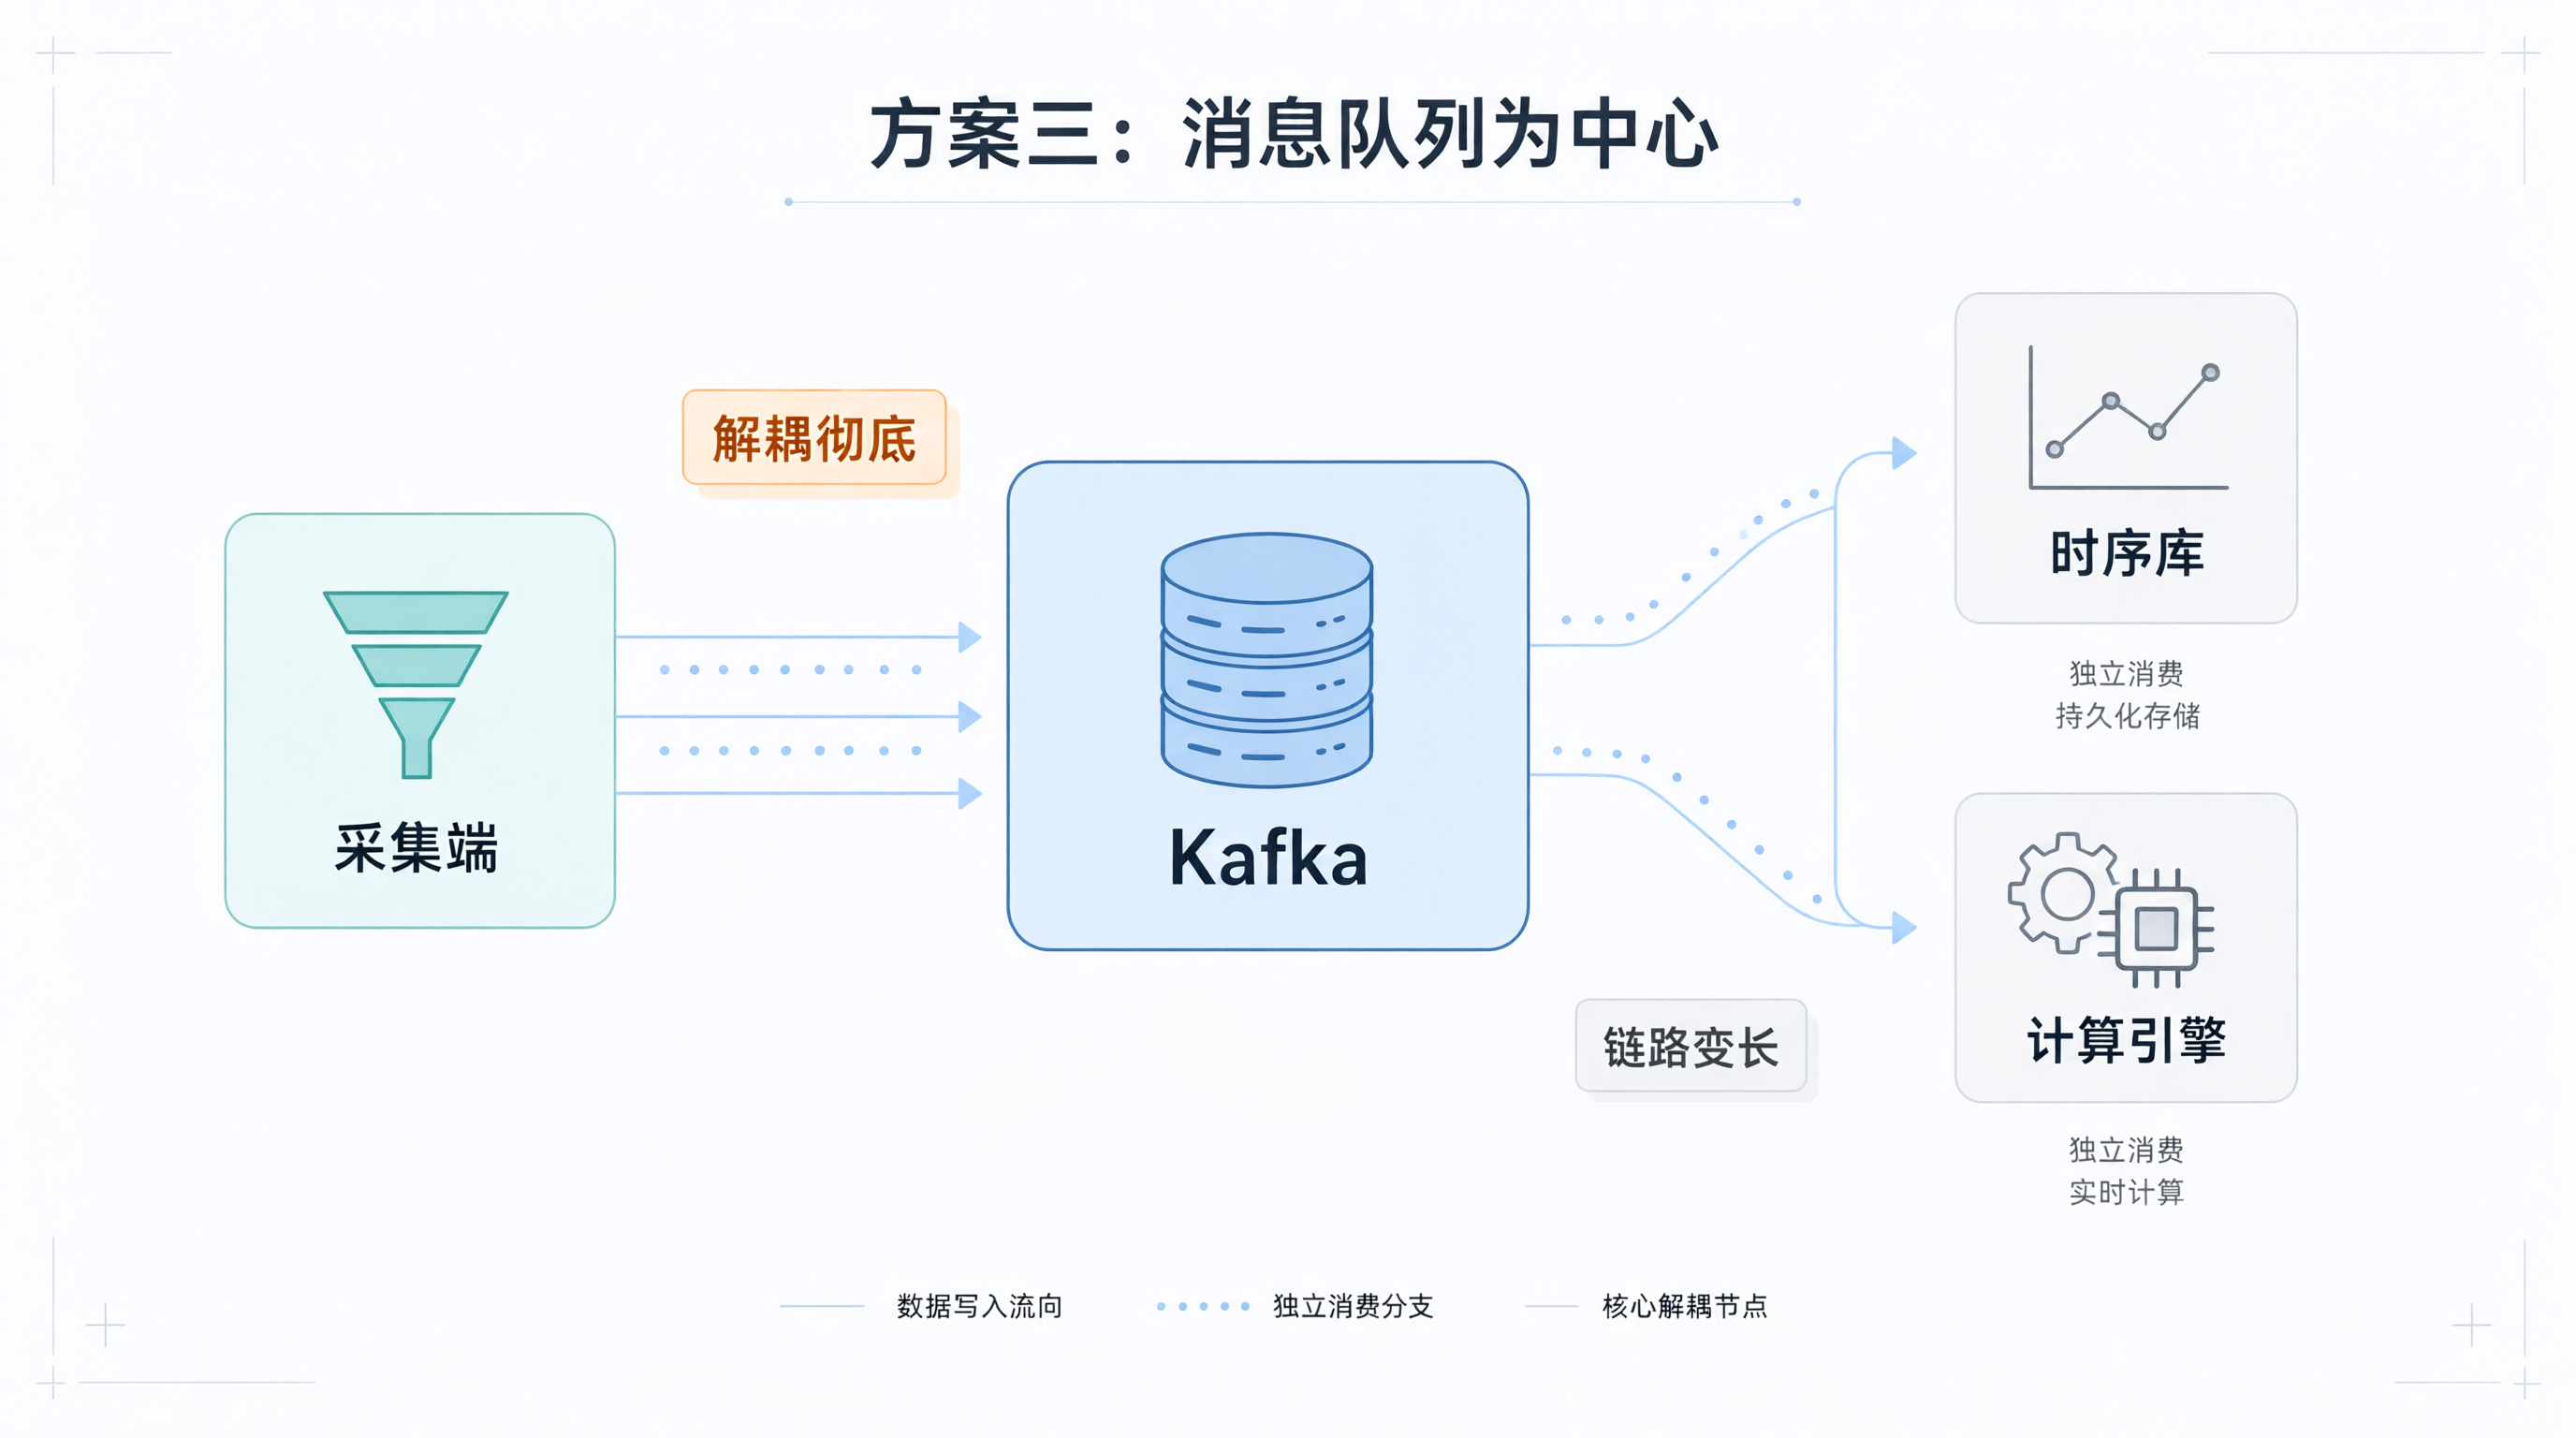
第三种思路是把消息队列(Kafka、Pulsar、EMQX 等)放在中心位置。采集端只往队列写,时序库和计算引擎都作为消费者,各自处理自己关心的部分。
这种架构的解耦性最好。时序库挂了不影响计算,计算逻辑改了不影响存储。工业场景里,设备协议五花八门,采集层经常要独立演进,这种解耦的价值其实很高。
代价是链路变长,端到端延迟会增加。而且消息队列本身也需要运维,多了一套要监控的东西。
下面用一个简单的 Python 消费者示例,模拟从 MQTT 订阅并分流到不同下游的场景。工业现场 MQTT 用得很多,这里用 paho-mqtt。
python
import json
import paho.mqtt.client as mqtt

# 简单分流:正常数据进时序库,异常数据额外告警
def on_message(client, userdata, msg):
    try:
        payload = json.loads(msg.payload.decode("utf-8"))
    except json.JSONDecodeError:
        return

    device_id = payload.get("device_id")
    temp = payload.get("temp")
    ts = payload.get("ts")

    if temp is None:
        return

    # 写入时序库(这里只打印,实际替换成写入调用)
    print(f"store: {device_id} {ts} {temp}")

    # 超限走另一条路径
    if temp > 70:
        print(f"alarm: {device_id} temp={temp}")


client = mqtt.Client()
client.on_message = on_message
client.connect("localhost", 1883, 60)
client.subscribe("factory/sensor/#")
client.loop_forever()
这种写法的好处是逻辑直观,扩展容易。但要注意,Python 消费者在高吞吐下会成为瓶颈,实际生产里通常用多进程或者换成 Java/Go 实现。Python 更适合做原型验证和中小规模场景。
三种方案的对比
把上面的内容整理成一张表,方便对照。
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 时序库自带流计算 | 链路短,无额外组件,运维简单 | 计算能力受 SQL 限制,难做复杂状态 | 规则固定、规模中等、团队小 |
| 时序库 + Flink | 计算能力强,状态管理成熟,生态好 | 集成复杂,版本依赖敏感,运维成本高 | 计算逻辑复杂、需要多源关联 |
| 消息队列为中心 | 解耦彻底,各组件独立演进 | 链路长,延迟增加,多一套运维 | 采集层复杂、需要多下游消费 |
这张表只能作为起点。实际选型还要看你的数据量级、延迟容忍度、团队技术栈。
怎么选:几个判断维度
我不想给一个"选 X 就对了"的结论,因为工业场景差异太大。但有几个维度可以先想清楚:
数据规模和频率。如果每秒写入只有几千条,时序库自带流计算基本够用。如果到了几十万条每秒,Flink 的并行处理能力会更稳。
延迟要求。要求亚秒级响应,链路越短越好,方案一或方案三配合轻量消费者更合适。如果允许秒级甚至分钟级延迟,Flink 的窗口聚合完全没问题。
计算复杂度。纯阈值判断和滑动窗口,SQL 能表达,方案一足够。涉及状态机、跨流关联、外部模型调用,方案二更合适。
团队能力。如果团队主要写 Python 和 SQL,没有专职流计算开发,硬上 Flink 会拖慢进度。方案一和方案三的 Python 实现更容易维护。
运维预算。每多一个组件,就多一套监控、告警、升级流程。方案三虽然解耦好,但消息队列本身也是要人管的。
一点个人判断
从我这几年接触的工业项目看,很多团队其实高估了自己的计算需求。真正需要 Flink 级别能力的场景,比例并不高。大量所谓"实时计算",本质就是阈值判断和简单聚合,用时序库自带的流计算完全能覆盖。
反过来,也有团队低估了解耦的价值。采集层一旦和计算逻辑耦合太紧,后面设备协议变了、采集频率调了,改动就会牵一发动全身。
我的倾向是:先用最简单的方案跑通,把链路和数据质量验证清楚,再根据实际瓶颈决定要不要引入更重的组件。一上来就搭 Flink 集群,很多时候是在为想象中的需求买单。
【注意】本文涉及的 TDengine、Flink、Kafka、MQTT 相关代码均为思路演示,具体 API 参数、连接器配置、版本兼容性请以你实际使用的版本官方文档为准。我没有在文中声称任何具体版本号或性能数据,因为这些和部署环境强相关。
如果你正在做类似选型,建议先拿一条真实产线的数据做小规模验证,重点看端到端延迟和异常恢复表现,而不是只看压测数字。
=备用标题=
- 工业时序数据实时计算:三种一体化架构的落地对比
- 时序库自带流计算够用吗?工业实时计算方案选型分析
- 从采集到告警:工业数据库实时计算一体化方案怎么选
- 工业场景下时序库与流计算框架的组合方式与取舍
- Python 视角下的工业时序数据实时计算架构对比