开篇介绍:
hello 大家,本篇博客我们来学习Redis中的list类型数据。
Redis List(列表)作为五大基础数据类型(String、Hash、List、Set、Zset)中专门处理有序可重复集合 的类型,是 Redis 中最灵活的线性数据结构之一。它支持对列表两端的高效插入 / 弹出操作,也能通过索引访问指定元素,既能充当栈 又能实现队列,还能基于阻塞命令实现轻量级消息队列,是互联网开发中处理「有序序列数据」的首选方案。
一、Redis List 核心概念:搞懂「有序可重复」的线性结构
学习 Redis List 的核心,首先要理解其数据结构本质 和核心特性,这是后续用好命令、选对场景的基础。
1.1 什么是 Redis List?
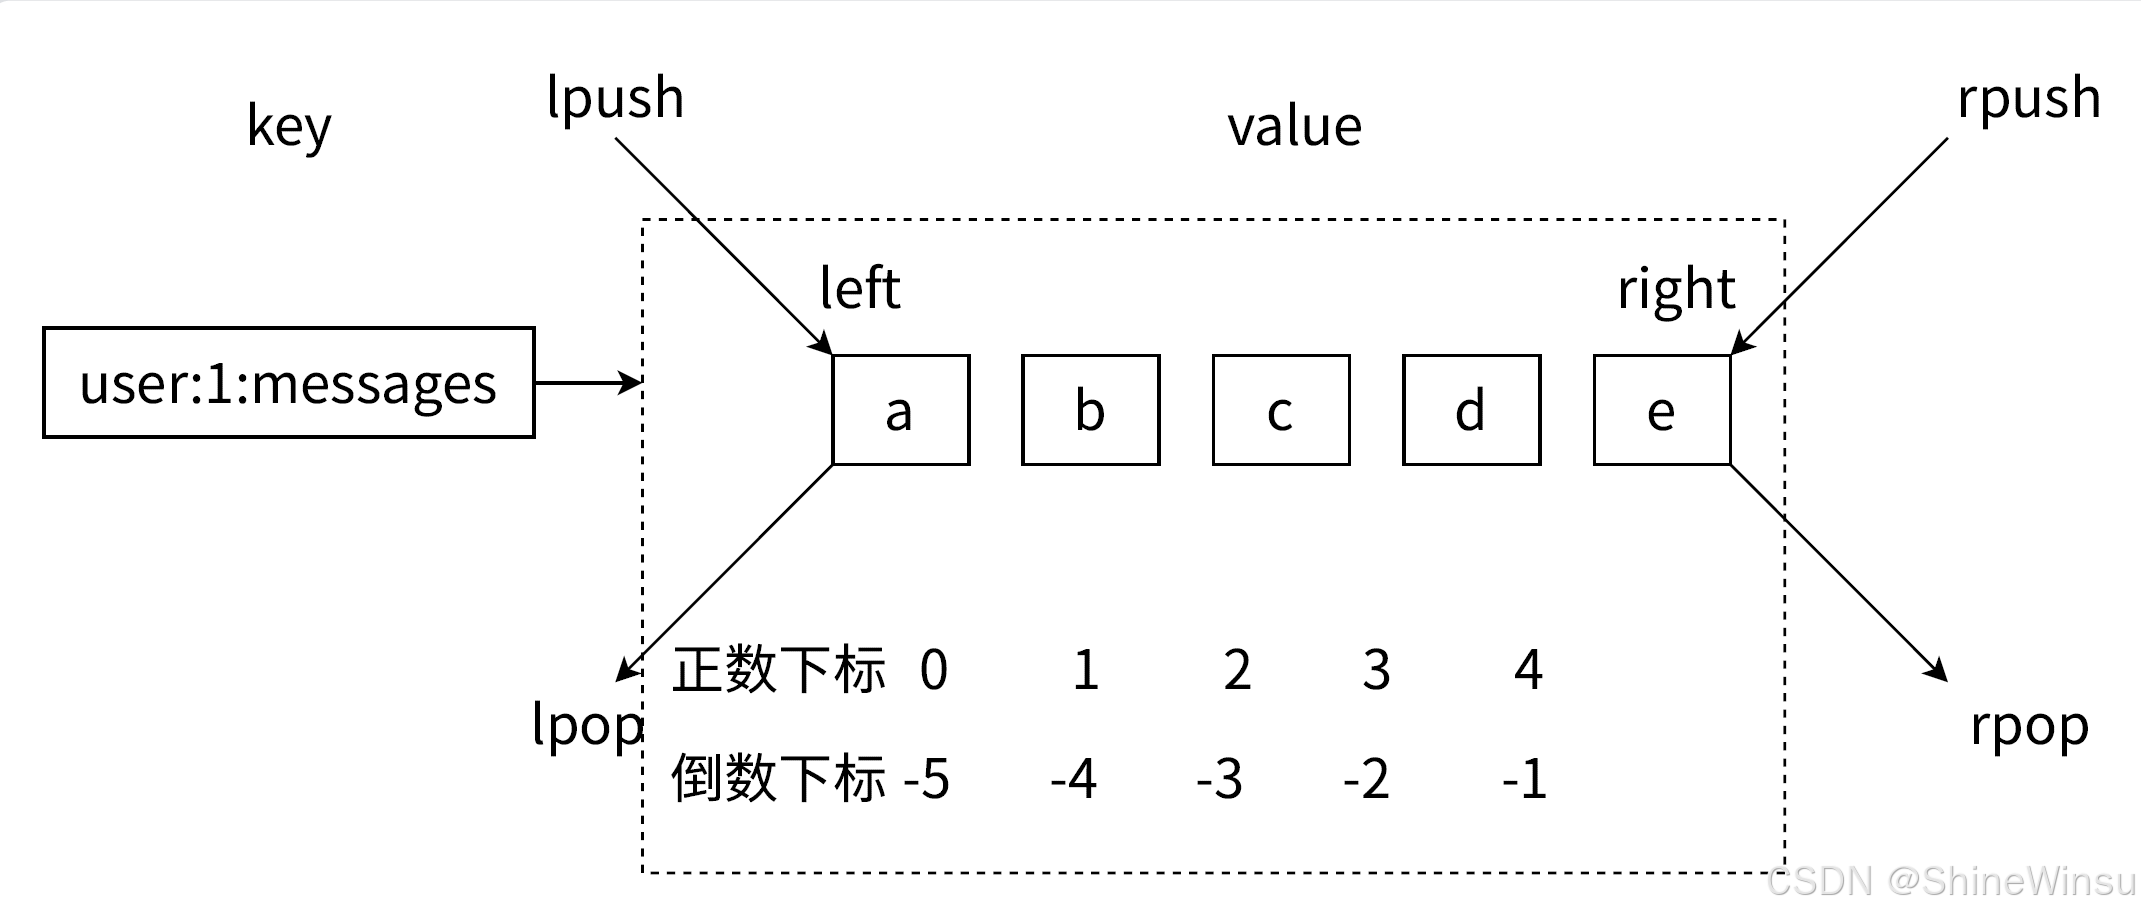
Redis List 是用于存储多个有序字符串的线性数据结构,列表中的每个字符串称为元素(element),元素按照「插入顺序」排列,形成一个有序的序列。Redis List 的底层是双向链表(结合压缩列表优化),因此天然支持 ** 表头(左侧)和表尾(右侧)** 的高效操作,这也是其核心设计优势。
一个 Redis List 的结构可以简单描述为:Redis Key = 列表名,Redis Value = [element1, element2, ..., elementN],元素之间有序且可重复,一个列表最多可以存储2^32 - 1个元素(约 42 亿),满足几乎所有业务的存储需求。
1.2 Redis List 的三大核心特性
这是 List 与其他 Redis 数据类型最核心的区别,也是其适用场景的基础,必须牢牢掌握:
特性 1:元素有序,支持索引访问
List 的元素按插入顺序 排序,Redis 为 List 提供了双向索引机制:
- 正数索引 :从表头(左侧)开始,第一个元素索引为
0,第二个为1,依次递增; - 倒数索引 :从表尾(右侧)开始,最后一个元素索引为
-1,倒数第二个为-2,依次递减。
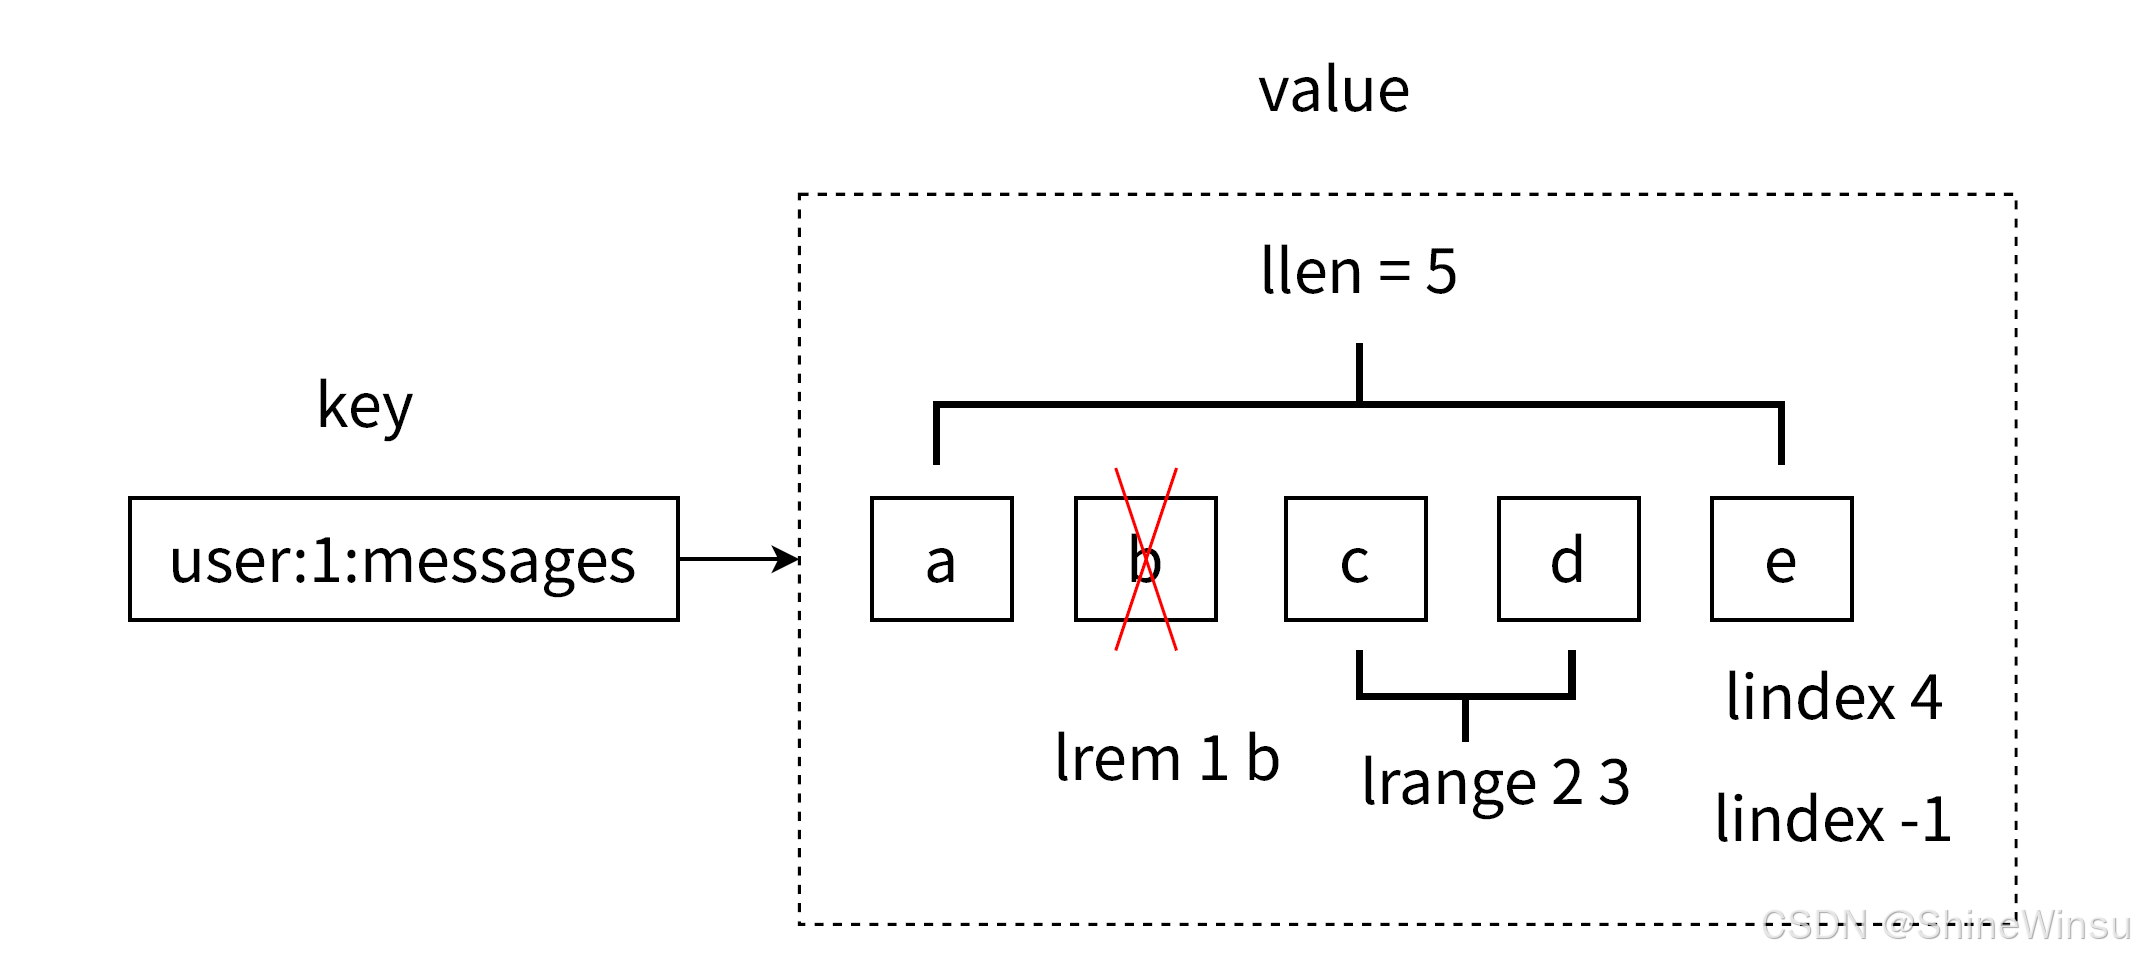
例如列表[a, b, c, d, e],a的索引是0,e的索引是4或-1,c的索引是2或-3。通过索引可以直接获取指定位置的元素,或获取指定索引范围的元素集合。
注意:List 的有序是 **「插入顺序」的有序 **,而非「元素值大小」的有序(Zset 是按分数大小有序),这是与 Zset 的核心区别。
特性 2:元素可重复,允许存储相同值
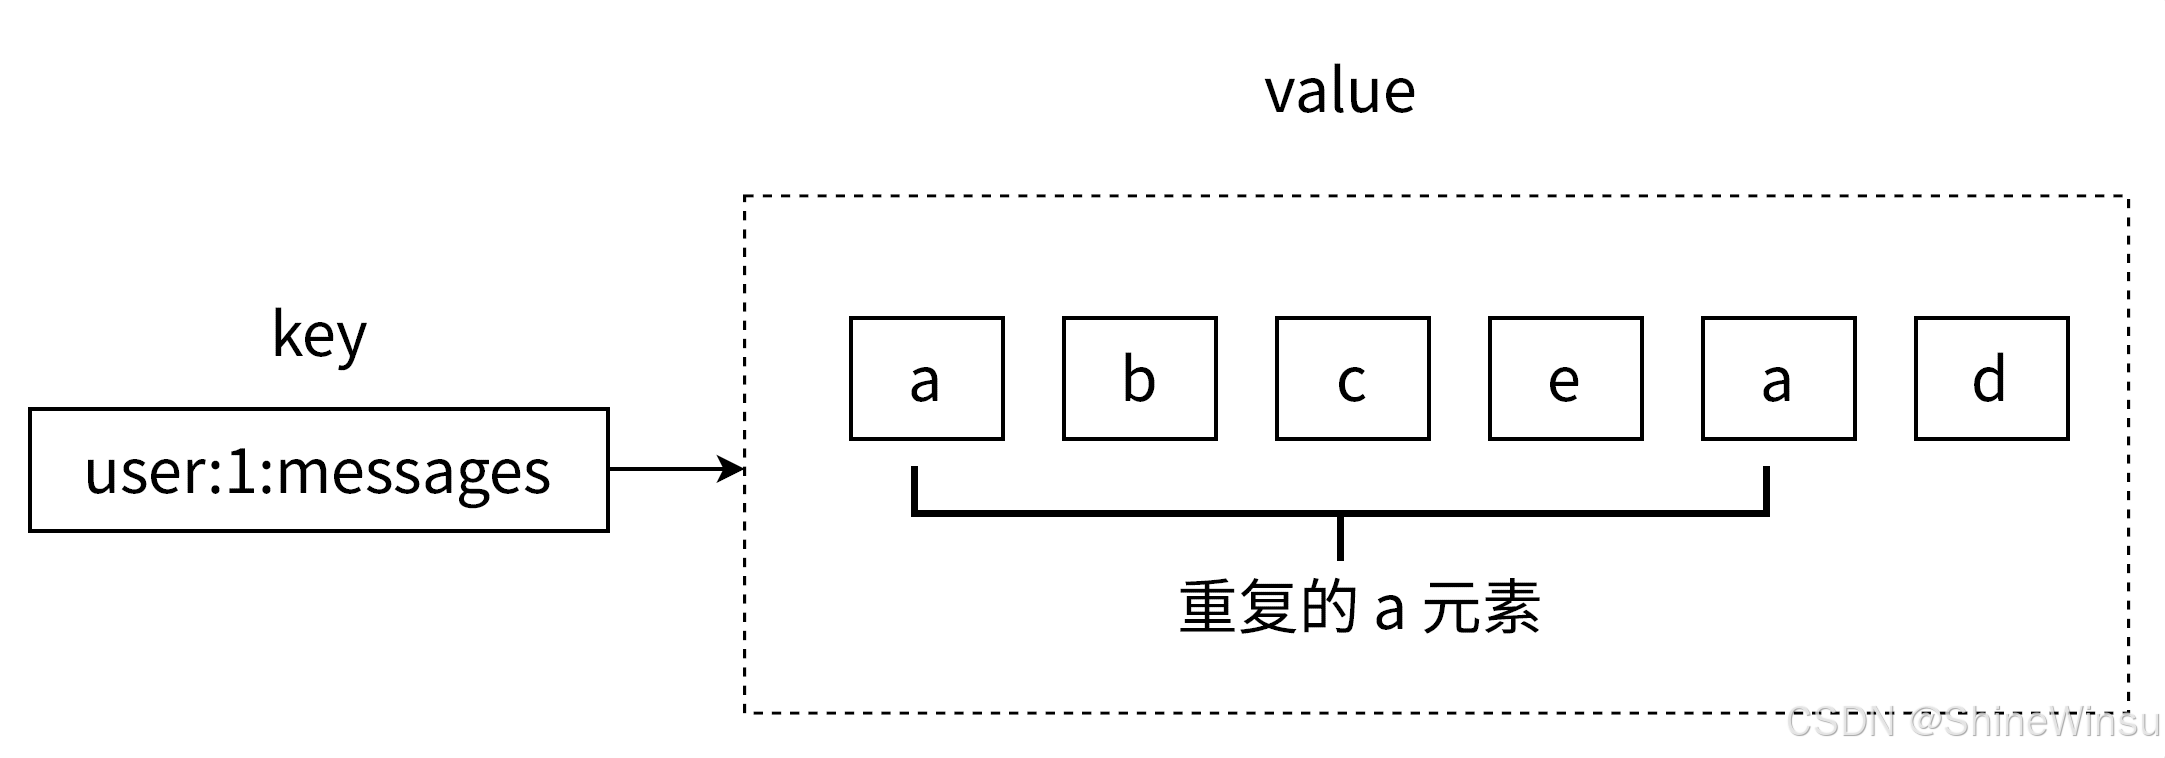
**List 对元素的唯一性没有要求,同一个值可以多次插入到列表中,形成重复元素。**例如执行LPUSH mylist a a b,列表结果为[a, a, b],这一特性与 Set(元素唯一)形成鲜明对比。
特性 3:两端操作高效,中间操作性能较差
由于 List 的底层是双向链表(+ 压缩列表),表头和表尾的插入 / 弹出操作 的时间复杂度为O(1),无论列表有多少元素,两端操作的速度都极快;而中间位置的插入 / 删除 / 索引操作 需要遍历链表,时间复杂度为O(N)(N 为元素个数),元素越多性能越差。
这一特性决定了:Redis List 的最佳实践是「仅操作两端,尽量避免操作中间」。
1.3 容易混淆的两个核心区别
区别 1:获取元素 vs 删除元素
获取元素(如LINDEX、LRANGE)只是读取列表中的数据,不会改变列表的长度和元素分布;而删除元素(如LPOP、RPOP、LREM)会移除列表中的数据,直接改变列表的长度和元素分布。
例如对列表[a, b, c, d]执行LINDEX 1,仅获取值b,列表仍为[a, b, c, d];若执行LREM 1 b,会删除 1 个b,列表变为[a, c, d],长度从 4 变为 3。
区别 2:Redis List vs 编程语言中的列表
Java 的ArrayList、Python 的list是动态数组 ,随机索引操作高效(O(1)),尾部插入高效但中间插入低效;而 Redis List 是双向链表 + 压缩列表 ,两端操作高效 ,随机索引操作低效(O(N))。
两者的设计优化方向完全不同,切勿用编程语言中列表的使用习惯来操作 Redis List。
1.4 Redis List 实现栈和队列
利用 List 的两端操作特性,可以轻松实现栈 和队列这两种经典的数据结构,这也是 List 的基础应用场景:
- 栈(先进后出,LIFO) :同侧存取 ,即「表头插入 + 表头弹出」(
LPUSH + LPOP)或「表尾插入 + 表尾弹出」(RPUSH + RPOP); - 队列(先进先出,FIFO) :异侧存取 ,即「表头插入 + 表尾弹出」(
LPUSH + RPOP)或「表尾插入 + 表头弹出」(RPUSH + LPOP)。
Redis 官方推荐使用LPUSH + RPOP实现队列,这也是后续实现消息队列的基础。
二、Redis List 核心命令全解析
Redis List 提供了 20 余个命令,核心常用命令约 15 个,其中阻塞版本的 BLPOP/BRPOP是生产环境的核心高频命令。
2.1 基础插入命令:向列表中添加元素
这是 List 最基础的命令,用于向列表表头(左侧)或 表尾(右侧)插入元素,包含 4 个核心命令:LPUSH、LPUSHX、RPUSH、RPUSHX,核心区别是插入位置 和是否要求 Key 存在。
2.1.1 LPUSH:表头插入单个 / 多个元素(核心命令)
功能 :向指定列表的表头(左侧)插入一个或多个元素,若列表的 Redis Key 不存在,则创建新的空列表 后再插入;若插入多个元素,按从后到前 的顺序插入(如LPUSH list a b c,结果为[c, b, a])。
语法 :LPUSH key element [element ...]
命令有效版本:1.0.0+
时间复杂度 :插入 1 个元素为O(1),插入 N 个元素为O(N)(N 为插入元素个数)
返回值 :插入后列表的总长度。
实操示例:
bash
# 1. Key不存在,创建列表并插入单个元素,返回长度1
redis> LPUSH mylist world
(integer) 1

# 2. Key已存在,表头插入单个元素,返回长度2
redis> LPUSH mylist hello
(integer) 2

# 3. 插入多个元素,按从后到前顺序插入(java->python->go)
redis> LPUSH lang go python java
(integer) 5

# 4. 查看列表(LRANGE后续讲解,0 -1表示获取所有元素)
redis> LRANGE mylist 0 -1
1) "hello"
2) "world"
3) "java"
4) "python"
5) "go"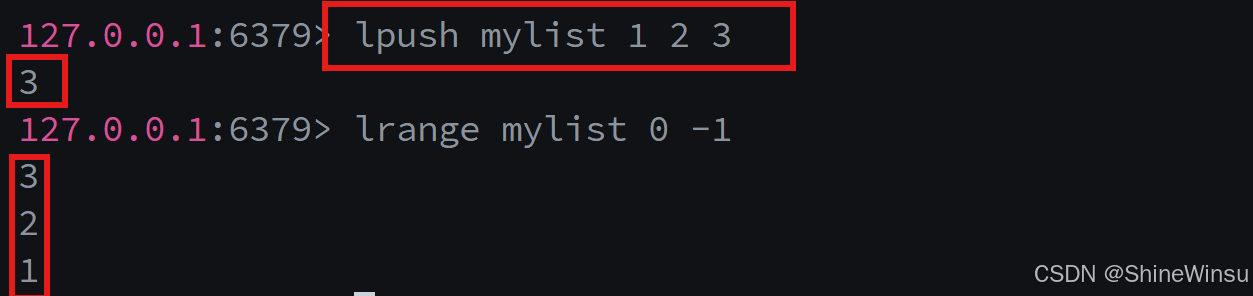
使用注意事项:
- 插入多个元素时,Redis 会按命令中元素的逆序插入到表头,这是 Redis 的设计逻辑,需注意元素顺序;
- 若需要向表头插入元素且不关心 Key 是否存在 ,优先使用
LPUSH,这是最通用的表头插入命令。
2.1.2 LPUSHX:仅当 Key 存在时,表头插入元素
功能 :向列表的 ** 表头(左侧)** 插入一个或多个元素,仅当 Redis Key 存在且为列表类型时才执行,若 Key 不存在则直接返回 0,不创建新列表。
语法 :LPUSHX key element [element ...]
命令有效版本:2.0.0+
时间复杂度 :插入 1 个元素为O(1),插入 N 个元素为O(N)
返回值:插入后列表的总长度;若 Key 不存在,返回 0。
实操示例:
bash
# 1. Key存在,表头插入元素,返回长度3
redis> LPUSHX mylist redis
(integer) 3

# 2. Key不存在,插入失败,返回0
redis> LPUSHX mylist2 test
(integer) 0

# 3. 查看结果,mylist2仍不存在
redis> LRANGE mylist2 0 -1
(empty array)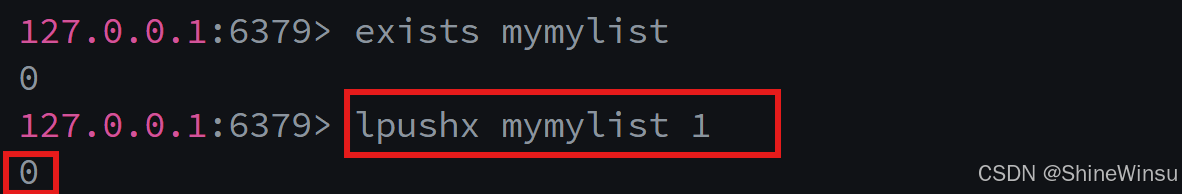
使用注意事项:
LPUSHX是LPUSH 的条件版本,核心作用是「避免创建新的空列表」,适用于「仅对已存在的列表添加元素」的场景;- 同样支持多元素插入,插入顺序与
LPUSH一致(逆序插入)。
2.1.3 RPUSH:表尾插入单个 / 多个元素(核心命令)
功能 :向指定列表的表尾(右侧)插入一个或多个元素,若 Key 不存在则创建新列表;若插入多个元素,按命令中的顺序 正常插入(如RPUSH list a b c,结果为[a, b, c])。
语法 :RPUSH key element [element ...]
命令有效版本:1.0.0+
时间复杂度 :插入 1 个元素为O(1),插入 N 个元素为O(N)
返回值:插入后列表的总长度。
实操示例:
bash
# 1. Key不存在,创建列表并插入单个元素,返回1
redis> RPUSH num 1
(integer) 1

# 2. 表尾插入多个元素,按顺序插入,返回4
redis> RPUSH num 2 3 4
(integer) 4

# 3. 查看列表,元素按插入顺序排列
redis> LRANGE num 0 -1
1) "1"
2) "2"
3) "3"
4) "4"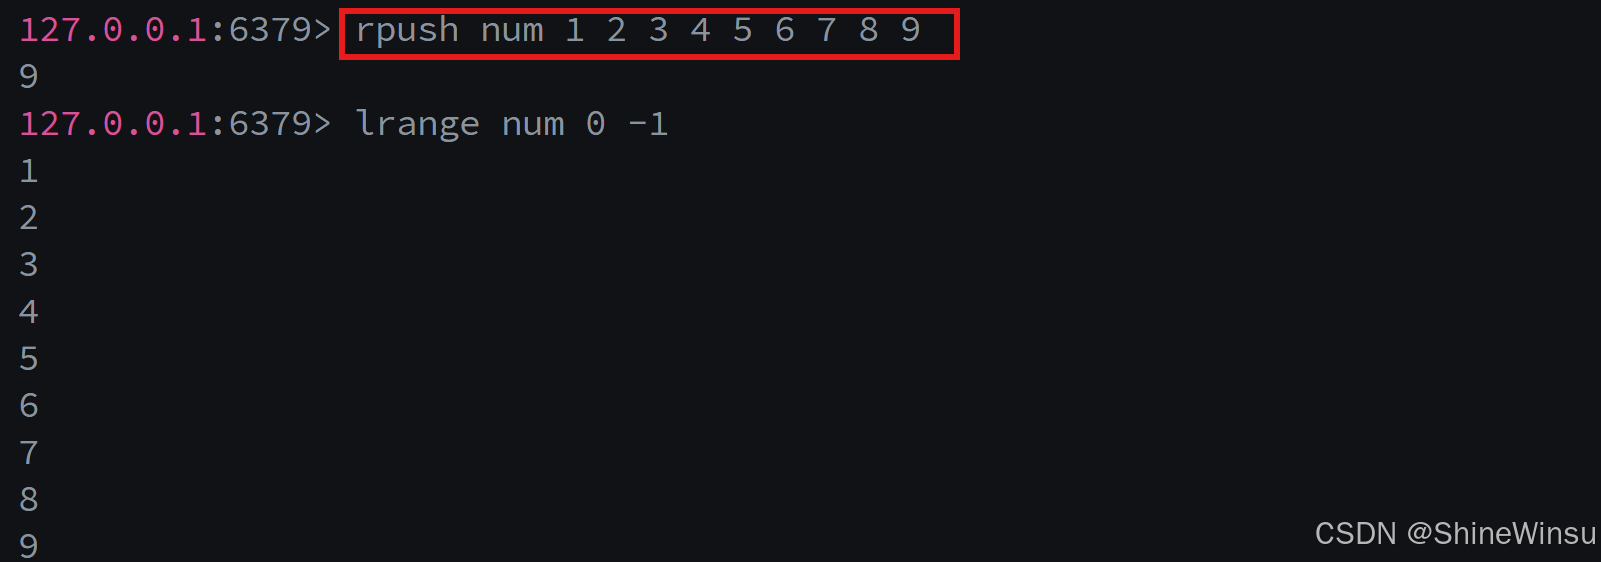
使用注意事项:
RPUSH是最通用的表尾插入命令 ,插入多个元素时顺序与命令一致,无需逆序,比LPUSH更符合直观的插入习惯;- 若需要实现「先进先出」的队列,优先使用
RPUSH做入队操作。
2.1.4 RPUSHX:仅当 Key 存在时,表尾插入元素
功能 :向列表的 ** 表尾(右侧)** 插入一个或多个元素,仅当 Key 存在且为列表类型时才执行,Key 不存在则返回 0。
语法 :RPUSHX key element [element ...]
命令有效版本:2.0.0+
时间复杂度 :插入 1 个元素为O(1),插入 N 个元素为O(N)
返回值:插入后列表的总长度;Key 不存在则返回 0。
实操示例:
bash
# 1. Key存在,表尾插入元素,返回5
redis> RPUSHX num 5
(integer) 5

# 2. Key不存在,插入失败,返回0
redis> RPUSHX num2 6
(integer) 0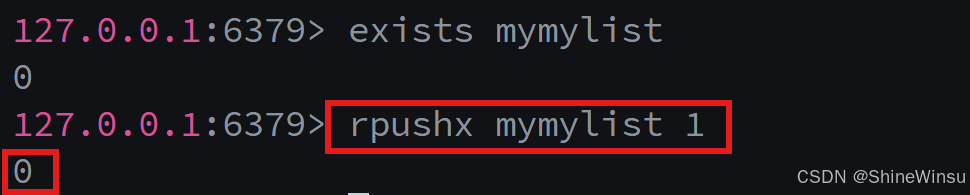
使用注意事项:
RPUSHX是RPUSH 的条件版本 ,与LPUSHX的设计初衷一致,避免创建空列表;- 生产环境中,若确定列表已存在,使用
LPUSHX/RPUSHX比LPUSH/RPUSH更严谨,可减少无效的 Key 创建。
2.2 基础弹出命令:从列表中删除并返回元素
「弹出(pop)」是 Redis List 的核心操作,指删除列表中指定位置的元素,并将该元素返回,包含 2 个核心非阻塞命令:LPOP、RPOP,时间复杂度均为O(1),是生产环境的高频命令。
2.2.1 LPOP:表头弹出单个元素
功能 :删除并返回列表 ** 表头(左侧)** 的第一个元素,若列表为空(或 Key 不存在),则返回nil。
语法 :LPOP key
命令有效版本:1.0.0+
时间复杂度 :O(1)
返回值 :弹出的元素;列表为空则返回nil。
实操示例:
bash
# 1. 列表非空,弹出表头元素hello,返回该值
redis> LPOP mylist
"hello"

# 2. 再次弹出,返回world
redis> LPOP mylist
"world"

# 3. 列表为空,弹出返回nil
redis> LPOP mylist2
(nil)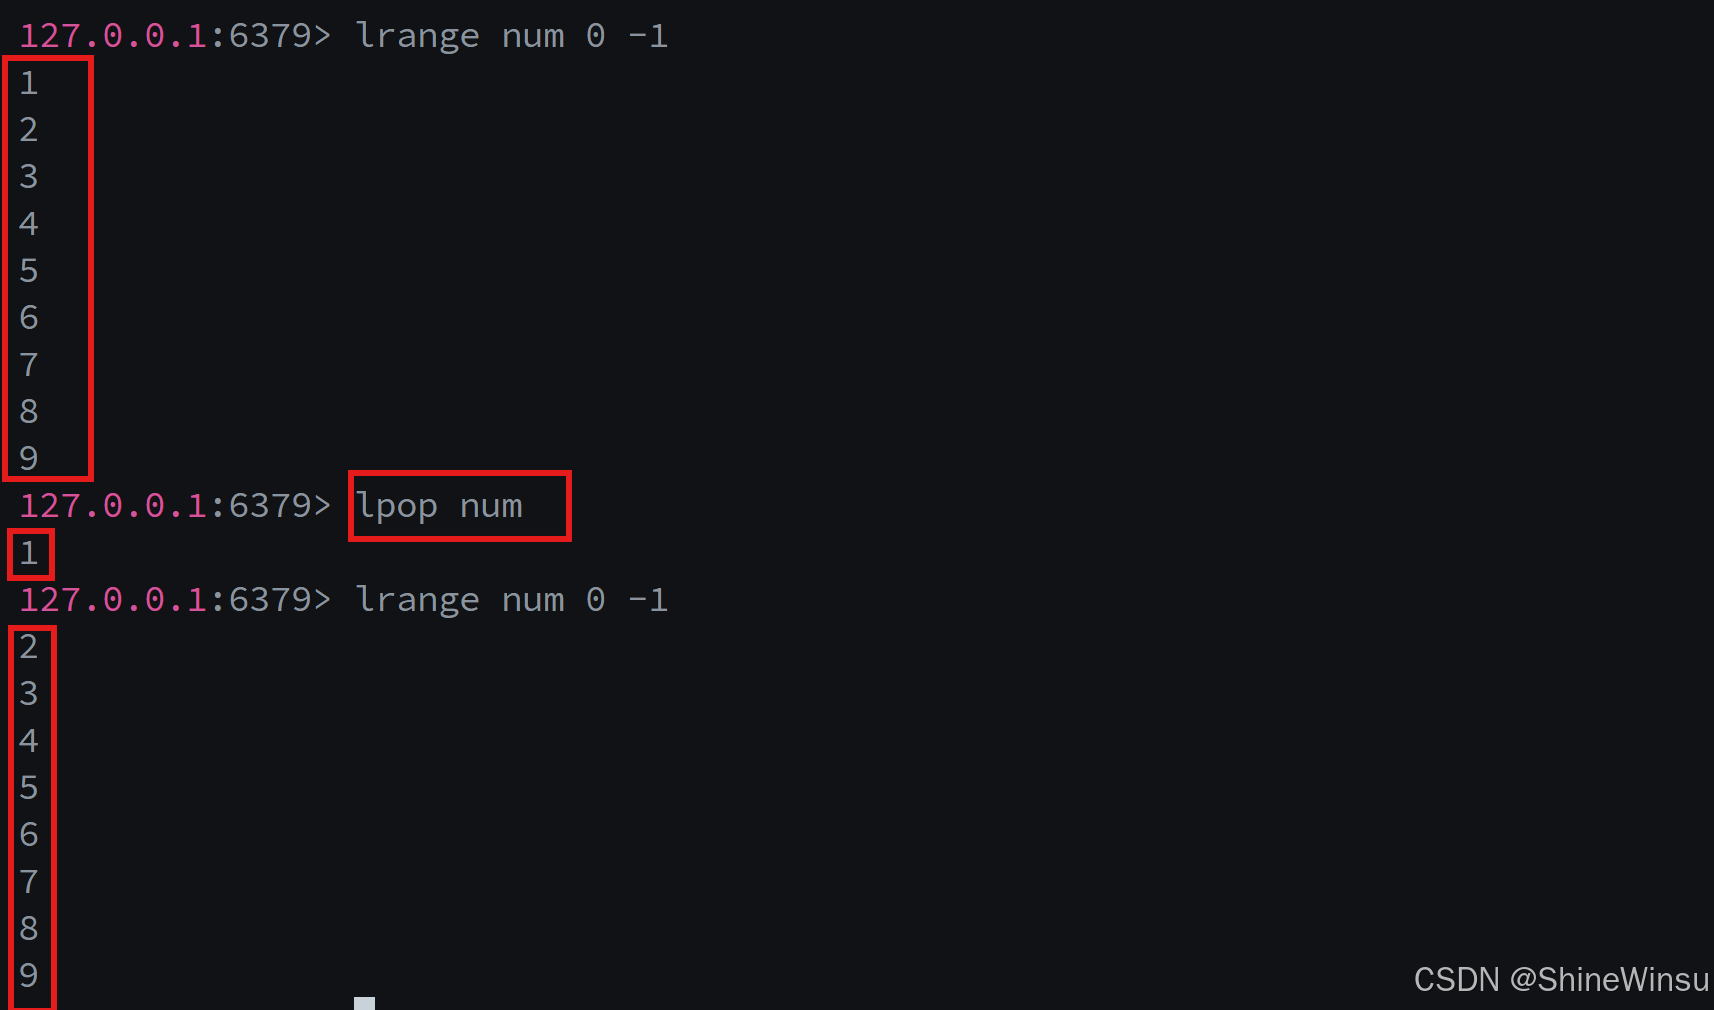
使用注意事项:
LPOP仅能弹出单个元素 (Redis 6.2 + 支持LPOP key count弹出多个元素,低版本不支持),若需要弹出多个元素,可多次执行或使用高版本的多元素弹出;- 结合
LPUSH使用可实现栈的「入栈 + 出栈」操作。
2.2.2 RPOP:表尾弹出单个元素
功能 :删除并返回列表 ** 表尾(右侧)** 的最后一个元素,若列表为空(或 Key 不存在),则返回nil。
语法 :RPOP key
命令有效版本:1.0.0+
时间复杂度 :O(1)
返回值 :弹出的元素;列表为空则返回nil。
实操示例:
bash
# 1. 列表非空,弹出表尾元素5,返回该值
redis> RPOP num
"5"

# 2. 再次弹出,返回4
redis> RPOP num
"4"

# 3. 结合LPUSH实现队列:LPUSH入队,RPOP出队
redis> LPUSH queue a b c
(integer) 3
redis> RPOP queue
"a"
redis> RPOP queue
"b"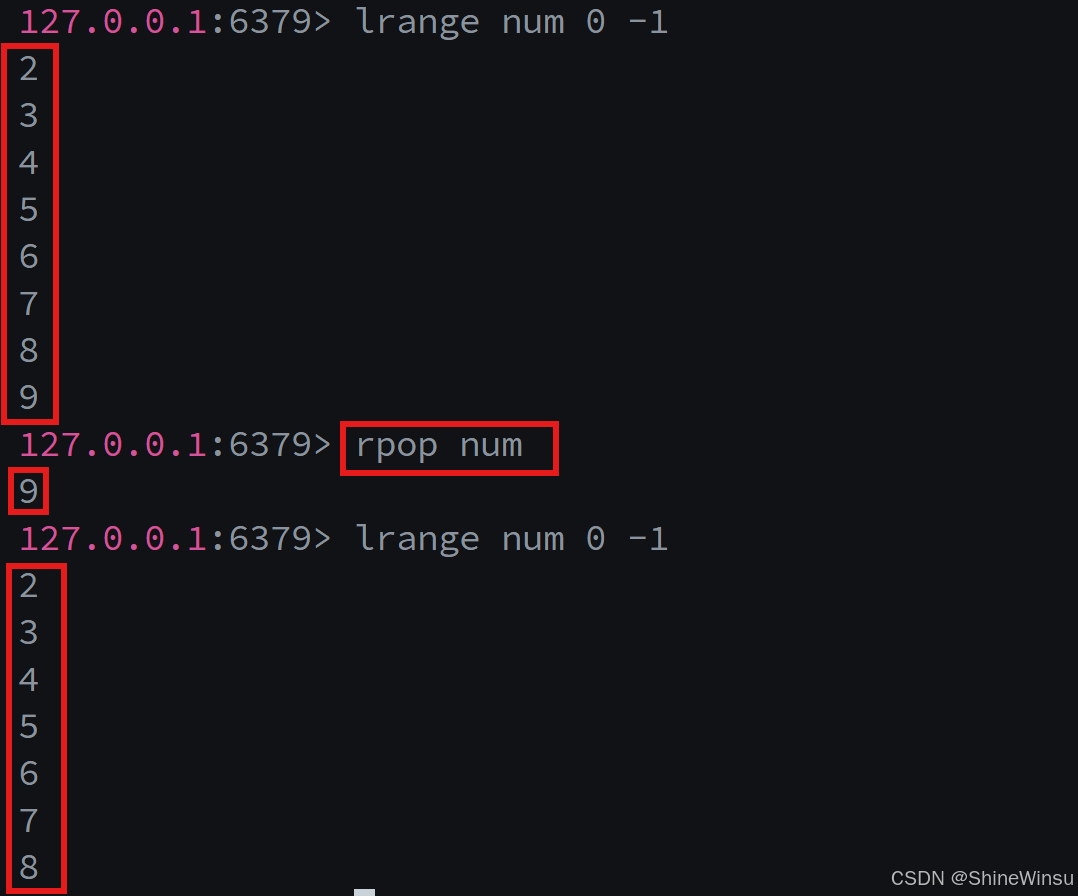
使用注意事项:
RPOP是实现队列和消息队列 的核心弹出命令,与LPUSH配合形成「先进先出」的经典组合;- 非阻塞版本的
RPOP在列表为空时会立即返回nil,生产环境中一般不直接使用,而是使用阻塞版本的BRPOP。
2.3 索引与范围查询:读取列表中的元素
这一模块的命令仅用于读取 列表中的元素,不修改列表,核心包括LRANGE(范围查询)和LINDEX(单个索引查询),是获取列表数据的主要方式,需重点注意性能陷阱。
2.3.1 LRANGE:获取指定索引范围的所有元素(核心查询命令)
注意这里的l,不是left的l,而是list的l哦
功能 :获取列表中从start到end索引范围内的所有元素 ,左闭右闭区间,支持正数和倒数索引,若索引超出列表范围,会自动截断为列表的实际边界,list的下标以及是从0开始的哦,而最后一个元素的下标,是为-1哦,数字前面带-号的话,就代表是倒数第几个
语法 :LRANGE key start stop
命令有效版本:1.0.0+
时间复杂度 :O(S+N),S 为start索引的偏移量,N 为start到end的元素个数
返回值 :指定范围内的元素列表;若start > end或列表为空,返回空列表。
实操示例:
bash
# 1. 初始化列表,RPUSH插入1-5
redis> RPUSH nums 1 2 3 4 5
(integer) 5

# 2. 获取0-2的元素(第1-3个),左闭右闭
redis> LRANGE nums 0 2
1) "1"
2) "2"
3) "3"

# 3. 用倒数索引,获取-3到-1(最后3个)
redis> LRANGE nums -3 -1
1) "3"
2) "4"
3) "5"

# 4. 索引超出范围,自动截断为实际边界(0-4)
redis> LRANGE nums 0 10
1) "1"
2) "2"
3) "3"
4) "4"
5) "5"

# 5. start > end,返回空列表
redis> LRANGE nums 3 2
(empty array)

# 6. 获取所有元素,固定写法:0 -1
redis> LRANGE nums 0 -1
1) "1"
2) "2"
3) "3"
4) "4"
5) "5"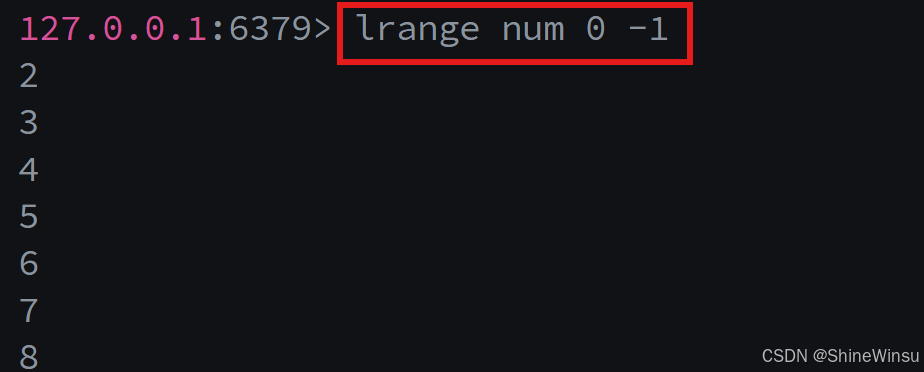
使用注意事项:
- 获取列表所有元素的固定写法:
LRANGE key 0 -1,这是 Redis 官方推荐的方式,无需计算列表长度; - 性能陷阱 :若
start偏移量过大(如获取百万元素列表的中间 100 个元素),S会非常大,命令执行时间会急剧增加,甚至阻塞 Redis; - 分页查询的最佳实践 :仅对小列表 做分页查询,大列表分页应避免使用
LRANGE,可结合LTRIM裁剪列表。
2.3.2 LINDEX:获取指定索引的单个元素
注意这里的l,不是left的l,而是list的l哦
功能 :获取列表中指定索引位置的单个元素,支持正数和倒数索引,若索引超出范围(或列表为空),返回nil,list的下标以及是从0开始的哦,而最后一个元素的下标,是为-1哦,数字前面带-号的话,就代表是倒数第几个
语法 :LINDEX key index
命令有效版本:1.0.0+
时间复杂度 :O(N),N 为索引的偏移量
返回值 :指定索引的元素;索引越界或列表为空则返回nil。
实操示例:
# 1. 获取正数索引2的元素,返回3
redis> LINDEX nums 2
"3"

# 2. 获取倒数索引-2的元素,返回4
redis> LINDEX nums -2
"4"

# 3. 索引越界,返回nil
redis> LINDEX nums 10
(nil)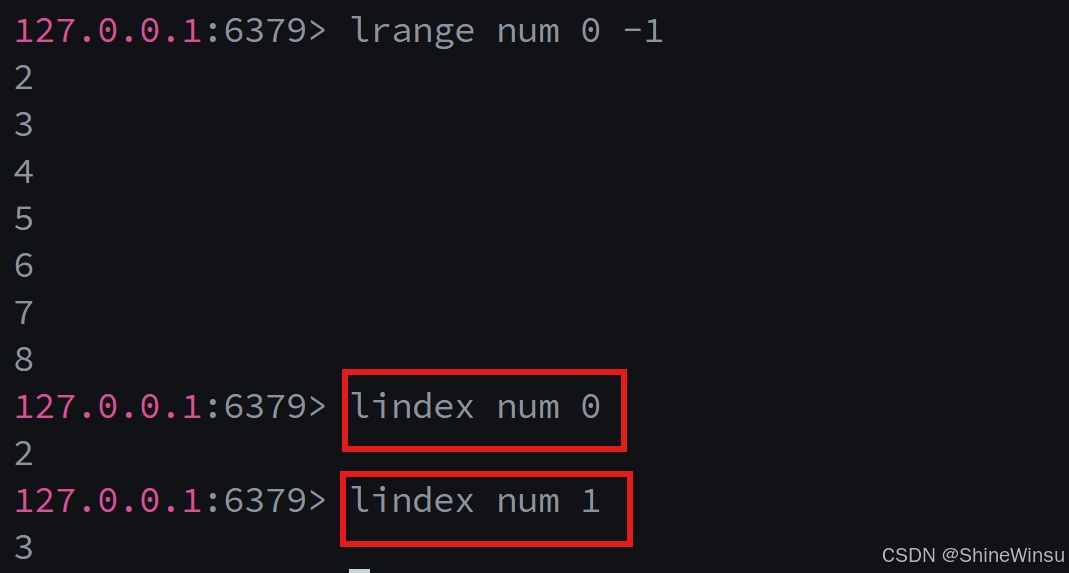
使用注意事项:
- 核心性能陷阱 :
LINDEX的时间复杂度为O(N),绝对不要对大列表使用 LINDEX (如对百万元素的列表执行LINDEX 500000),会遍历半个列表,直接阻塞 Redis; - 仅对小列表 (元素个数≤100)使用
LINDEX,大列表应避免任何索引操作。
2.4 长度统计与插入:辅助操作命令
这一模块包含 2 个常用辅助命令:LLEN(统计列表长度)和LINSERT(中间插入元素),其中LLEN是O(1)高性能命令,LINSERT是O(N)低性能命令,生产环境中需谨慎使用。
2.4.1 LLEN:统计列表的元素个数(核心统计命令)
注意这里的l,不是left的l,而是list的l哦
功能 :获取指定列表的元素总个数,若 Key 不存在(或为空列表),返回 0。
语法 :LLEN key
命令有效版本:1.0.0+
时间复杂度 :O(1)
返回值:列表的元素个数;Key 不存在返回 0。
实操示例:
bash
# 1. 统计非空列表的长度,返回5
redis> LLEN nums
(integer) 5

# 2. 执行LPOP后,长度变为4
redis> LPOP nums
"1"
redis> LLEN nums
(integer) 4

# 3. 统计不存在的Key,返回0
redis> LLEN nums2
(integer) 0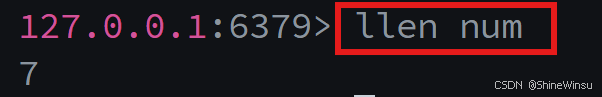
使用注意事项:
LLEN是高性能统计命令,Redis 会缓存列表的长度,无需遍历元素,因此无论列表多大,执行速度都极快;- 判断列表是否为空的最佳方式:
LLEN key == 0,比LRANGE key 0 -1更高效。
2.4.2 LINSERT:在指定元素前后插入新元素
注意这里的l,不是left的l,而是list的l哦
功能 :在列表中 ** 第一个匹配的指定元素(pivot)的 前面(BEFORE)或 后面(AFTER)** 插入新元素;若 Key 不存在、pivot 不存在,或列表为空,插入失败并返回-1,注意这里的指定元素,可不是指的下标,而是实打实的元素哦,如果有多个重复元素的话,redis会在从前往后第一个找到的指定元素进行insert哦
语法 :LINSERT key BEFORE|AFTER pivot element
命令有效版本:2.2.0+
时间复杂度 :O(N),N 为 pivot 到列表头尾的距离
返回值 :插入后列表的总长度;插入失败返回-1。
实操示例:
bash
# 1. 初始化列表,RPUSH插入a b c d
redis> RPUSH list a b c d
(integer) 4

# 2. 在b后面插入x,返回长度5
redis> LINSERT list AFTER b x
(integer) 5

# 3. 查看结果,b后新增x
redis> LRANGE list 0 -1
1) "a"
2) "b"
3) "x"
4) "c"
5) "d"

# 4. 在不存在的pivot(y)前插入,返回-1
redis> LINSERT list BEFORE y z
(integer) -1

# 5. 对不存在的Key插入,返回-1
redis> LINSERT list2 AFTER a b
(integer) -1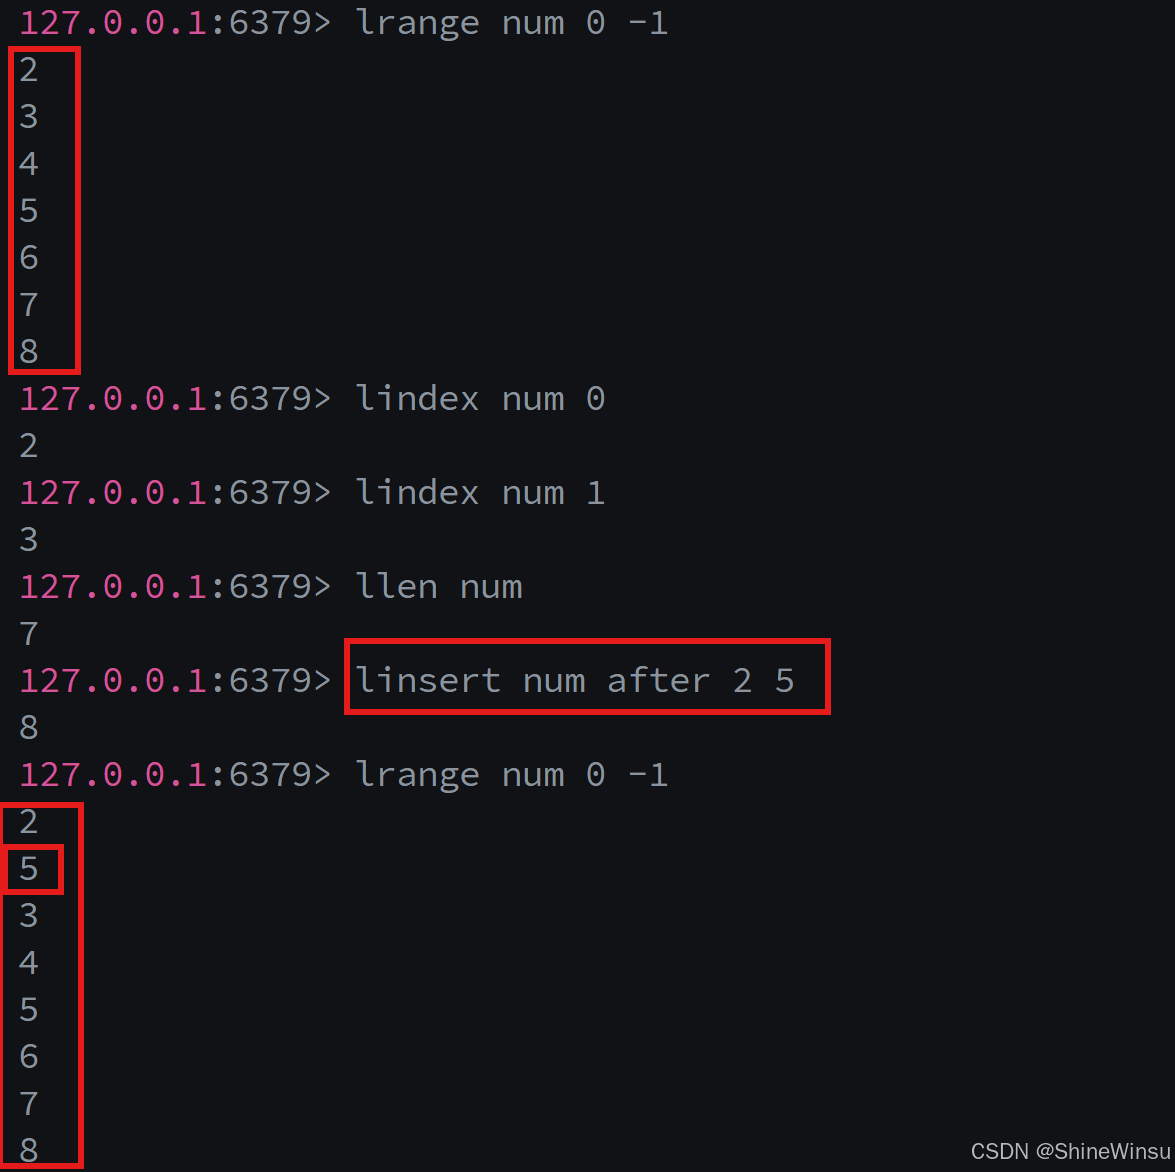
使用注意事项:
- 性能极低 :
LINSERT需要先遍历列表找到 pivot,再执行插入,大列表中执行会严重阻塞 Redis,生产环境中尽量避免使用; - 仅能匹配第一个pivot 元素,无法对所有匹配的 pivot 执行插入;
- 若需要向列表中插入元素,优先使用
LPUSH/RPUSH(两端插入),而非LINSERT(中间插入)。
2.5 阻塞版本命令:BLPOP & BRPOP(生产环境核心)
BLPOP和BRPOP是LPOP和RPOP的阻塞版本 ,也是 Redis List 最核心的生产级命令,主要用于实现阻塞式消息队列 。非阻塞版本的弹出命令在列表为空时会立即返回nil,而阻塞版本会在列表为空时阻塞客户端,直到列表有新元素插入或超时,彻底解决了「轮询查询列表」的性能问题。
2.5.1 阻塞命令的三大核心特性
在学习具体命令前,必须掌握阻塞版本的通用特性,这是使用的基础:
- 条件阻塞:列表非空时,阻塞命令与非阻塞命令表现一致,立即弹出元素;列表为空时,客户端进入阻塞状态,不再向 Redis 发送新命令。
- 多 Key 遍历:命令支持传入多个 Key,Redis 会从左到右遍历这些 Key,一旦某个 Key 对应的列表非空,立即从该列表弹出元素并返回,不会阻塞后续 Key。
- 客户端公平性:若多个客户端同时对同一个 Key 执行阻塞弹出命令,Redis 会按照客户端执行命令的先后顺序,将新插入的元素分配给第一个客户端,保证「先到先得」的公平性,避免单个客户端独占元素。
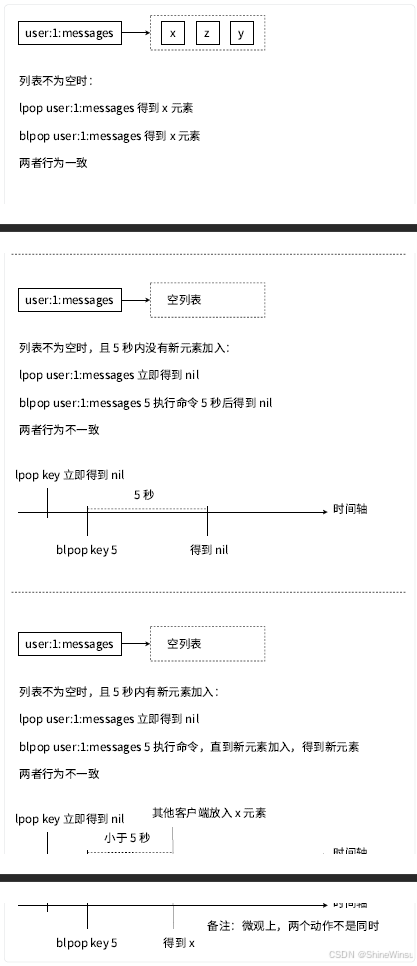
2.5.2 BLPOP:表头阻塞弹出元素
功能 :LPOP的阻塞版本,从指定列表的表头 弹出元素;列表为空时,阻塞客户端指定的超时时间(timeout),超时后返回nil;支持多 Key 遍历。
语法 :BLPOP key [key ...] timeout
参数说明:
key [key ...]:一个或多个列表的 Key,按从左到右顺序遍历;timeout:阻塞超时时间,单位为秒;0表示永久阻塞,直到列表有新元素。
命令有效版本:1.0.0+
时间复杂度 :O(1)
返回值 :数组形式 ,第一个元素为弹出元素的 Key ,第二个元素为弹出的元素 ;超时后返回nil。
实操示例:
bash
# 场景1:列表非空,立即弹出,返回[key, element]
redis> BLPOP nums 5
1) "nums"
2) "2"

# 场景2:列表为空,阻塞客户端(开两个客户端演示)
# 客户端1:执行BLPOP,列表为空,进入阻塞状态
redis1> BLPOP msg 10
# 客户端2:向msg列表LPUSH一个元素hello
redis2> LPUSH msg hello
(integer) 1
# 客户端1:立即解除阻塞,返回结果
redis1> 1) "msg"
2) "hello"

# 场景3:多Key遍历,第一个Key为空,第二个Key非空,立即弹出第二个Key的元素
redis> BLPOP msg1 msg2 5
1) "msg2"
2) "world"

# 场景4:超时阻塞,10秒内无新元素,返回nil
redis> BLPOP empty 10
(nil)
(10.01s) # 耗时10秒左右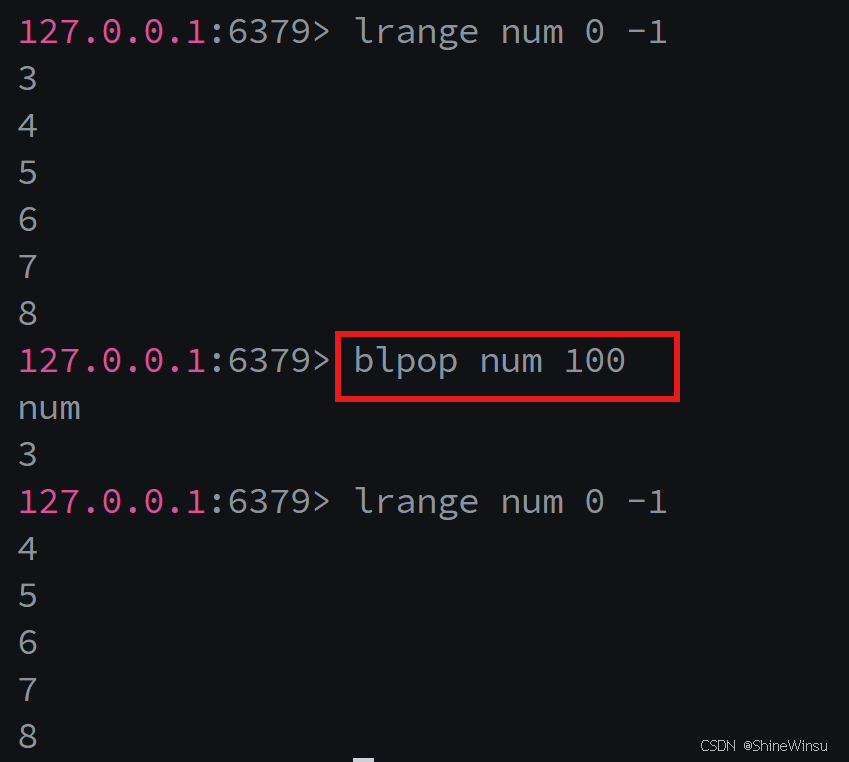
使用注意事项:
- 返回值是数组,包含 Key 和元素,这是与非阻塞版本的核心区别(非阻塞仅返回元素),需注意客户端的解析逻辑;
- 避免设置永久阻塞(timeout=0):若 Redis 服务重启或网络中断,客户端会一直阻塞,建议设置合理的超时时间(如 30 秒);
- 阻塞仅针对当前客户端,不影响 Redis 的其他操作,Redis 仍可处理其他客户端的命令。
2.5.3 BRPOP:表尾阻塞弹出元素
功能 :RPOP的阻塞版本,从指定列表的表尾 弹出元素;特性、语法、返回值与BLPOP完全一致,唯一区别是弹出位置为表尾。
语法 :BRPOP key [key ...] timeout
命令有效版本:1.0.0+
时间复杂度 :O(1)
返回值 :数组形式,[key, element];超时返回nil。
实操示例:
bash
# 1. 列表非空,立即弹出表尾元素
redis> BRPOP nums 5
1) "nums"
2) "5"

# 2. 列表为空,阻塞后插入新元素,解除阻塞
redis1> BRPOP queue 0
redis2> RPUSH queue test
(integer) 1
redis1> 1) "queue"
2) "test"使用注意事项:
BRPOP是实现阻塞式消息队列 的核心命令 ,与LPUSH配合形成「生产者 LPUSH 入队,消费者 BRPOP 阻塞出队」的经典模型;- 生产环境中,消息队列的消费者优先使用
BRPOP,而非RPOP,避免轮询带来的 CPU 和网络开销。
2.6 其他常用命令:LREM & LTRIM & LSET
除了上述核心命令,Redis List 还提供了LREM(删除指定元素)、LTRIM(裁剪列表)、LSET(修改指定索引元素)等命令,虽使用频率稍低,但在特定场景下不可或缺,此处补充讲解核心细节。
2.6.1 LREM:删除列表中指定个数的匹配元素
功能:从列表中删除前 count 个匹配value的元素,count 的正负决定遍历方向:
count > 0:从表头到表尾遍历,删除前 count 个匹配元素;count < 0:从表尾到表头遍历,删除前 | count | 个匹配元素;count = 0:删除所有匹配元素。- 注意这里的value也不是下标哦,而是元素本身
语法 :LREM key count value
时间复杂度 :O(N),N 为列表元素个数
返回值:实际删除的元素个数。
实操示例:
bash
# 初始化列表:a b a c a
redis> RPUSH list a b a c a
(integer) 5

# 1. count=2,从左到右删除2个a,返回2
redis> LREM list 2 a
(integer) 2
# 列表变为:b c a
redis> LRANGE list 0 -1
1) "b"
2) "c"
3) "a"

# 2. count=-1,从右到左删除1个a,返回1
redis> LREM list -1 a
(integer) 1
# 列表变为:b c
redis> LRANGE list 0 -1
1) "b"
2) "c"

# 3. count=0,删除所有b,返回1
redis> LREM list 0 b
(integer) 1使用注意事项:
LREM需要遍历整个列表,大列表中执行性能极差,仅对小列表使用;- 若需要删除列表的所有元素,优先使用
DEL key(删除整个 Key),而非LREM key 0 value,前者更高效。
2.6.2 LTRIM:裁剪列表为指定索引范围
功能 :将列表裁剪 为start到end的索引范围,仅保留该范围的元素,删除范围外的所有元素,是实现「列表定长」的核心命令,依旧是左闭右闭区间,这里的就是下标,而不是元素
语法 :LTRIM key start stop
时间复杂度 :O(N),N 为被删除的元素个数
返回值 :裁剪成功返回OK。
实操示例:
bash
# 初始化列表:1 2 3 4 5
redis> RPUSH nums 1 2 3 4 5
(integer) 5

# 1. 裁剪为0-2,保留前3个元素,返回OK
redis> LTRIM nums 0 2
OK
# 列表变为:1 2 3
redis> LRANGE nums 0 -1
1) "1"
2) "2"
3) "3"

# 2. 实现列表定长(固定保留最后10个元素)
# 插入元素后立即裁剪,仅保留-10到-1
redis> RPUSH log msg1
(integer) 4
redis> LTRIM log -10 -1
OK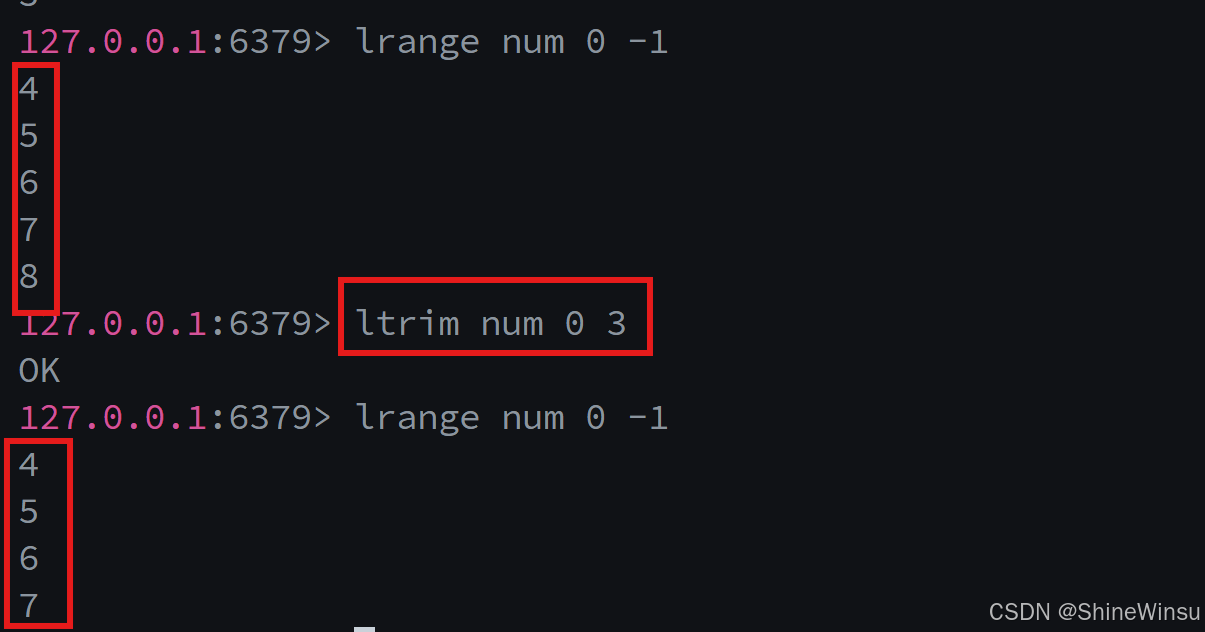
使用注意事项:
LTRIM是实现定长列表的最佳方案 (如最新 100 条日志、最新 50 条消息),配合LPUSH/RPUSH使用,插入后立即裁剪,保证列表长度不超限;- 若裁剪的范围是
0 -1,列表无变化,相当于空操作。
2.6.3 LSET:修改指定索引的元素值
功能 :将列表中指定索引位置的元素值修改为新的value;若索引越界、Key 不存在或列表为空,返回错误,这里的也是下标
语法 :LSET key index value
命令有效版本:1.0.0+
时间复杂度 :O(N),N 为索引的偏移量
返回值 :修改成功返回OK;失败返回错误信息。
实操示例:
bash
# 初始化列表:a b c
redis> LPUSH list a b c
(integer) 3

# 1. 修改索引1的元素为x,返回OK
redis> LSET list 1 x
OK
# 列表变为:a x c
redis> LRANGE list 0 -1
1) "a"
2) "x"
3) "c"

# 2. 索引越界,返回错误
redis> LSET list 10 y
(error) ERR index out of range使用注意事项:
LSET的时间复杂度为O(N),大列表中执行性能极差,生产环境中尽量避免使用;- 若需要修改列表的元素,优先考虑「删除旧元素 + 插入新元素」,或直接重新创建列表。
2.7 核心命令小结:按使用频率 & 性能排序
为了方便快速掌握,将 Redis List 的核心命令按使用频率从高到低 、性能从优到差排序,标注核心用途和注意事项,优先掌握前 10 个命令即可满足 90% 以上的开发需求:
| 命令 | 核心功能 | 时间复杂度 | 使用频率 | 核心注意事项 |
|---|---|---|---|---|
| LPUSH | 表头插入元素 | O(1)/O(N) | ★★★★★ | 多元素逆序插入 |
| RPUSH | 表尾插入元素 | O(1)/O(N) | ★★★★★ | 多元素顺序插入,推荐用于队列入队 |
| BRPOP | 表尾阻塞弹出元素 | O(1) | ★★★★★ | 生产环境消息队列核心,避免永久阻塞 |
| LRANGE | 范围查询元素 | O(S+N) | ★★★★☆ | 0 -1 获取所有元素,大列表慎用 |
| LLEN | 统计列表长度 | O(1) | ★★★★☆ | 高性能,判断列表是否为空的最佳方式 |
| LPOP | 表头非阻塞弹出元素 | O(1) | ★★★☆☆ | 仅用于栈实现,大列表推荐 BLPOP |
| RPOP | 表尾非阻塞弹出元素 | O(1) | ★★★☆☆ | 列表非空时使用,空列表推荐 BRPOP |
| BLPOP | 表头阻塞弹出元素 | O(1) | ★★★☆☆ | 与 LPUSH 配合实现栈的阻塞弹出 |
| LINDEX | 单个索引查询元素 | O(N) | ★★☆☆☆ | 大列表严禁使用 |
| LTRIM | 裁剪列表为指定范围 | O(N) | ★★☆☆☆ | 实现定长列表的核心命令 |
| LPUSHX/RPUSHX | 条件插入元素 | O(1)/O(N) | ★★☆☆☆ | 避免创建空列表 |
| LINSERT | 中间插入元素 | O(N) | ★☆☆☆☆ | 性能极差,生产环境尽量避免 |
| LREM/LSET | 删除 / 修改指定元素 | O(N) | ★☆☆☆☆ | 大列表严禁使用 |
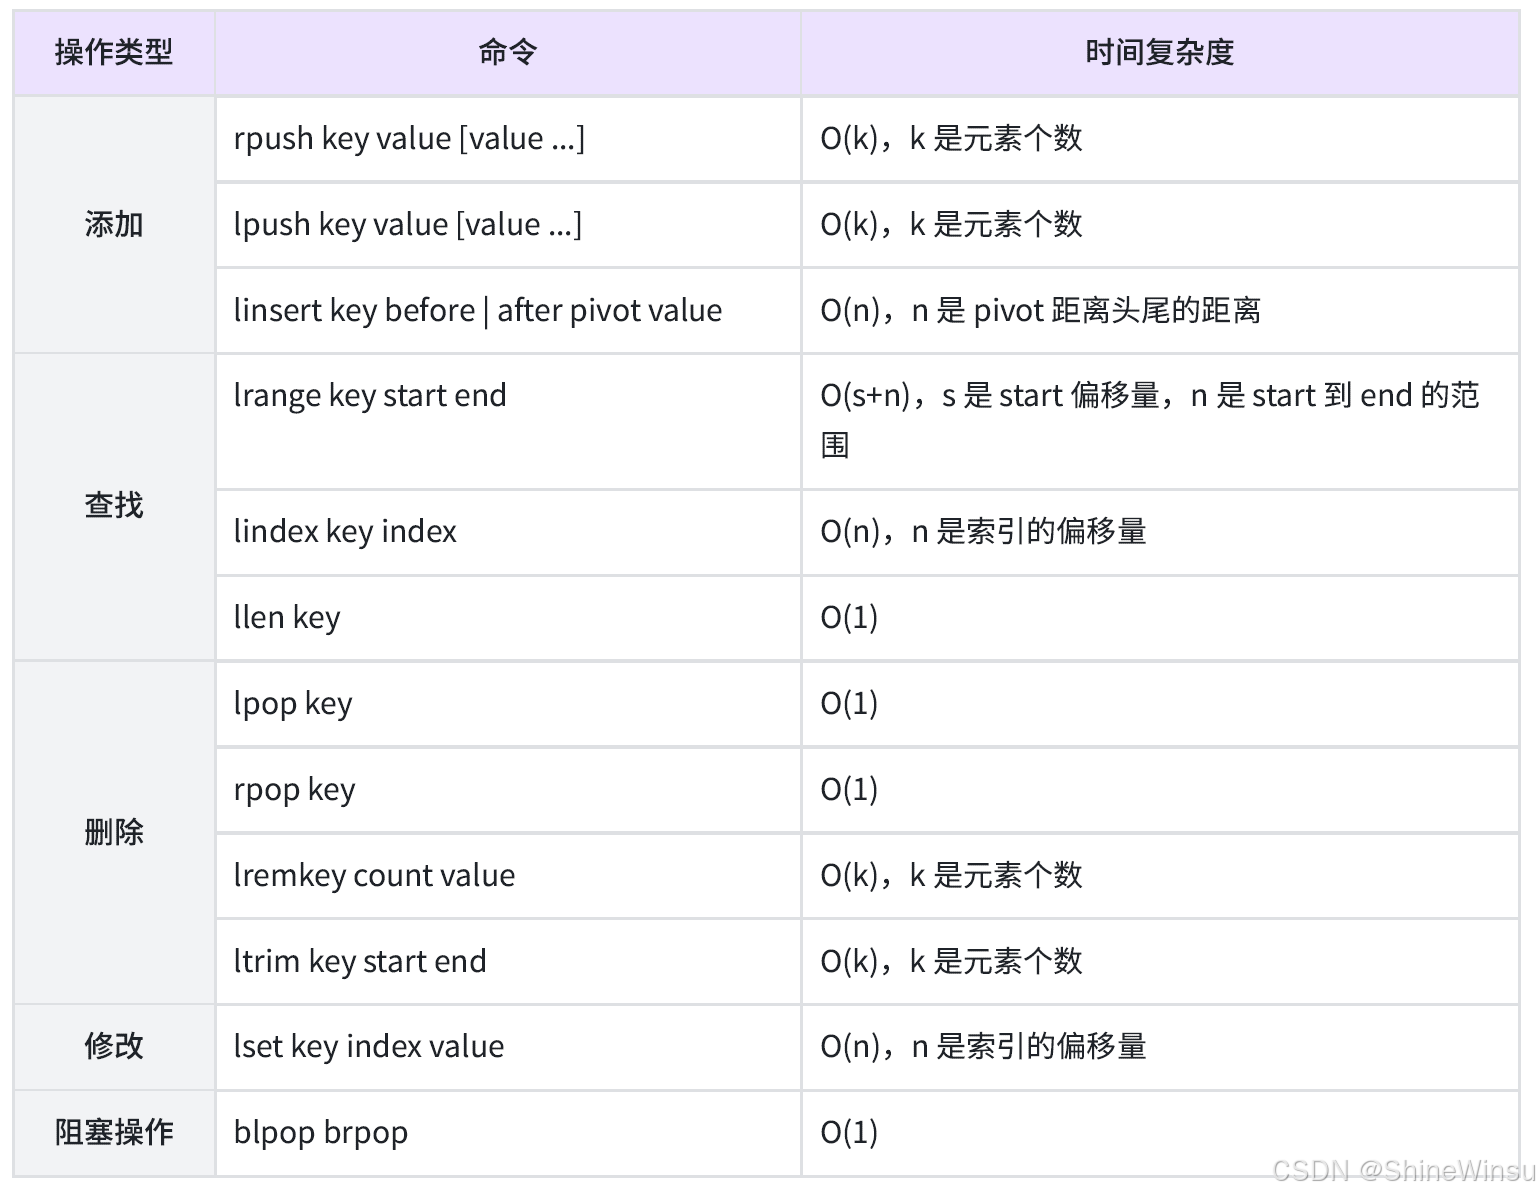
核心原则 :优先使用 O (1) 的两端操作命令,尽量避免使用 O (N) 的中间操作命令。
三、Redis List 内部编码深度剖析:内存与性能的平衡
与 Redis Hash 类似,List 也有两种内部编码 ,Redis 会根据列表的元素个数 和单个元素的长度 自动选择编码,设计初衷是平衡内存占用和读写性能:小列表用紧凑编码省内存,大列表用链表编码保性能。
3.1 内部编码的基础认知
- 编码对开发者透明:内部编码是 Redis 的底层实现,开发者只需使用 List 的命令,Redis 会自动选择和切换编码,无需手动干预;
- 编码可通过命令查看 :使用
object encoding key命令可查看指定列表的内部编码; - 编码转换单向不可逆 :List 的编码只能从ziplist(压缩列表)转为linkedlist(链表),即使后续删除元素使列表满足 ziplist 的条件,编码也不会反向转换。
3.2 List 的两种内部编码
Redis List 的内部编码仅有 **ziplist(压缩列表)和 linkedlist(双向链表)** 两种,Redis 7.0 + 版本用listpack替代了 ziplist,本质是 ziplist 的优化版,触发条件和特性一致,本文以主流的 ziplist 为例讲解。
3.2.1 ziplist(压缩列表)------ 内存优先
核心定位 :为小列表 设计的紧凑存储编码,以牺牲少量读写性能为代价,大幅节省内存。
结构特点 :ziplist 是一种连续的内存块,将列表的所有元素按顺序紧凑存储,没有双向链表的指针、节点等元数据开销,内存利用率极高。
性能特点 :两端操作的时间复杂度仍为O(1),但由于是连续内存,中间操作需要移动内存块,性能比 linkedlist 更差;
触发条件:同时满足以下两个默认配置条件时,Redis 使用 ziplist 作为 List 的内部编码:
- 列表的元素个数 ≤ list-max-ziplist-entries(默认 512 个);
- 列表中每个元素的字节数 ≤ list-max-ziplist-value(默认 64 字节)。
上述配置可在redis.conf中修改,建议保持默认,无需手动调整(修改可能导致内存或性能问题)。
3.2.2 linkedlist(双向链表)------ 性能优先
核心定位 :为大列表 设计的高效读写编码,以牺牲少量内存为代价,保证两端操作的极致性能,同时提升中间操作的遍历效率。
结构特点 :底层是双向链表,每个元素是一个独立的节点,节点包含「前驱指针、后继指针、元素值」,节点之间通过指针连接,无需连续内存。
性能特点 :两端操作的时间复杂度为O(1),性能稳定;中间操作需要遍历链表,但由于是指针连接,无需移动内存块,比 ziplist 的中间操作性能更高;
内存特点:每个节点都有指针等元数据开销,内存利用率远低于 ziplist,相同的列表数据,linkedlist 的内存占用可能是 ziplist 的数倍;
触发条件 :只要满足以下任一条件,Redis 会将 List 的编码从 ziplist 转为 linkedlist:
- 列表的元素个数 > 512 个;
- 列表中任意一个元素的字节数 > 64 字节;
- 执行写命令(如 LPUSH、RPUSH)时触发上述任一条件。
3.3 内部编码的实际演示:看得到的转换过程
通过 Redis 实际命令,演示 List 内部编码的初始状态 和两种转换场景,直观感受编码的切换(基于 Redis 默认配置):
3.3.1 初始状态:小列表使用 ziplist
创建元素个数少、元素长度小的列表,编码为 ziplist:
# 1. 插入3个短元素,列表长度3 ≤ 512
redis> RPUSH list key1 key2 key3
OK

# 2. 查看内部编码,为ziplist
redis> object encoding list
"ziplist"
3.3.2 转换场景 1:元素个数超过 512,转为 linkedlist
向列表中插入 513 个元素,触发编码转换(此处省略批量插入命令,仅演示结果):
# 1. 批量插入513个短元素,总个数516 > 512
redis> RPUSH list key4 key5 ... key516
OK

# 2. 查看内部编码,已转为linkedlist
redis> object encoding list
"linkedlist"

# 3. 删除多余元素,剩余512个,编码仍为linkedlist(单向不可逆)
redis> LTRIM list 0 511
OK
redis> object encoding list
"linkedlist"
3.3.3 转换场景 2:单个元素长度超过 64 字节,转为 linkedlist
新建小列表,插入一个超过 64 字节的长元素,触发编码转换:
# 1. 插入1个短元素,编码为ziplist
redis> RPUSH newlist short
OK
redis> object encoding newlist
"ziplist"

# 2. 插入1个65字节的长元素(超过64字节)
redis> RPUSH newlist "12345678901234567890123456789012345678901234567890123456789012345"
OK

# 3. 查看内部编码,已转为linkedlist
redis> object encoding newlist
"linkedlist"
3.4 两种编码的核心对比
为了更直观的理解,将 ziplist 和 linkedlist 的核心维度做对比,明确各自的适用场景:
| 对比维度 | ziplist(压缩列表) | linkedlist(双向链表) |
|---|---|---|
| 内存占用 | 极低,连续内存无元数据开销 | 较高,节点指针有元数据开销 |
| 两端操作性能 | O (1),性能略低(需操作连续内存) | O (1),性能稳定(仅修改指针) |
| 中间操作性能 | O (N),性能极差(需移动内存块) | O (N),性能略高(仅遍历指针) |
| 适用场景 | 元素≤512 个、所有元素≤64 字节的小列表 | 元素 > 512 个或任意元素 > 64 字节的大列表 |
| 编码转换 | 初始默认编码,可转为 linkedlist | 一旦转换,无法转回 ziplist |
核心结论 :尽量让 Redis List 保持 ziplist 编码,这是 List 内存优化的核心,通过控制元素个数和元素长度,避免编码转为 linkedlist,减少内存浪费。
四、Redis List 经典使用场景实战
Redis List 的核心优势是两端操作高效 和阻塞弹出 ,基于这些特性,其经典使用场景主要集中在消息队列 、有序序列展示 、定长数据存储三大方向
4.1 场景 1:阻塞式生产者 - 消费者消息队列(最核心场景)
4.1.1 需求分析
几乎所有分布式系统都有消息队列的需求,核心需求:
- 生产者向队列中发送消息,消费者从队列中获取消息并消费;
- 消费者需阻塞等待新消息,避免轮询查询带来的 CPU 和网络开销;
- 支持多个消费者争抢消息,实现消费的负载均衡;
- 消息按发送顺序消费,保证先进先出(FIFO)。
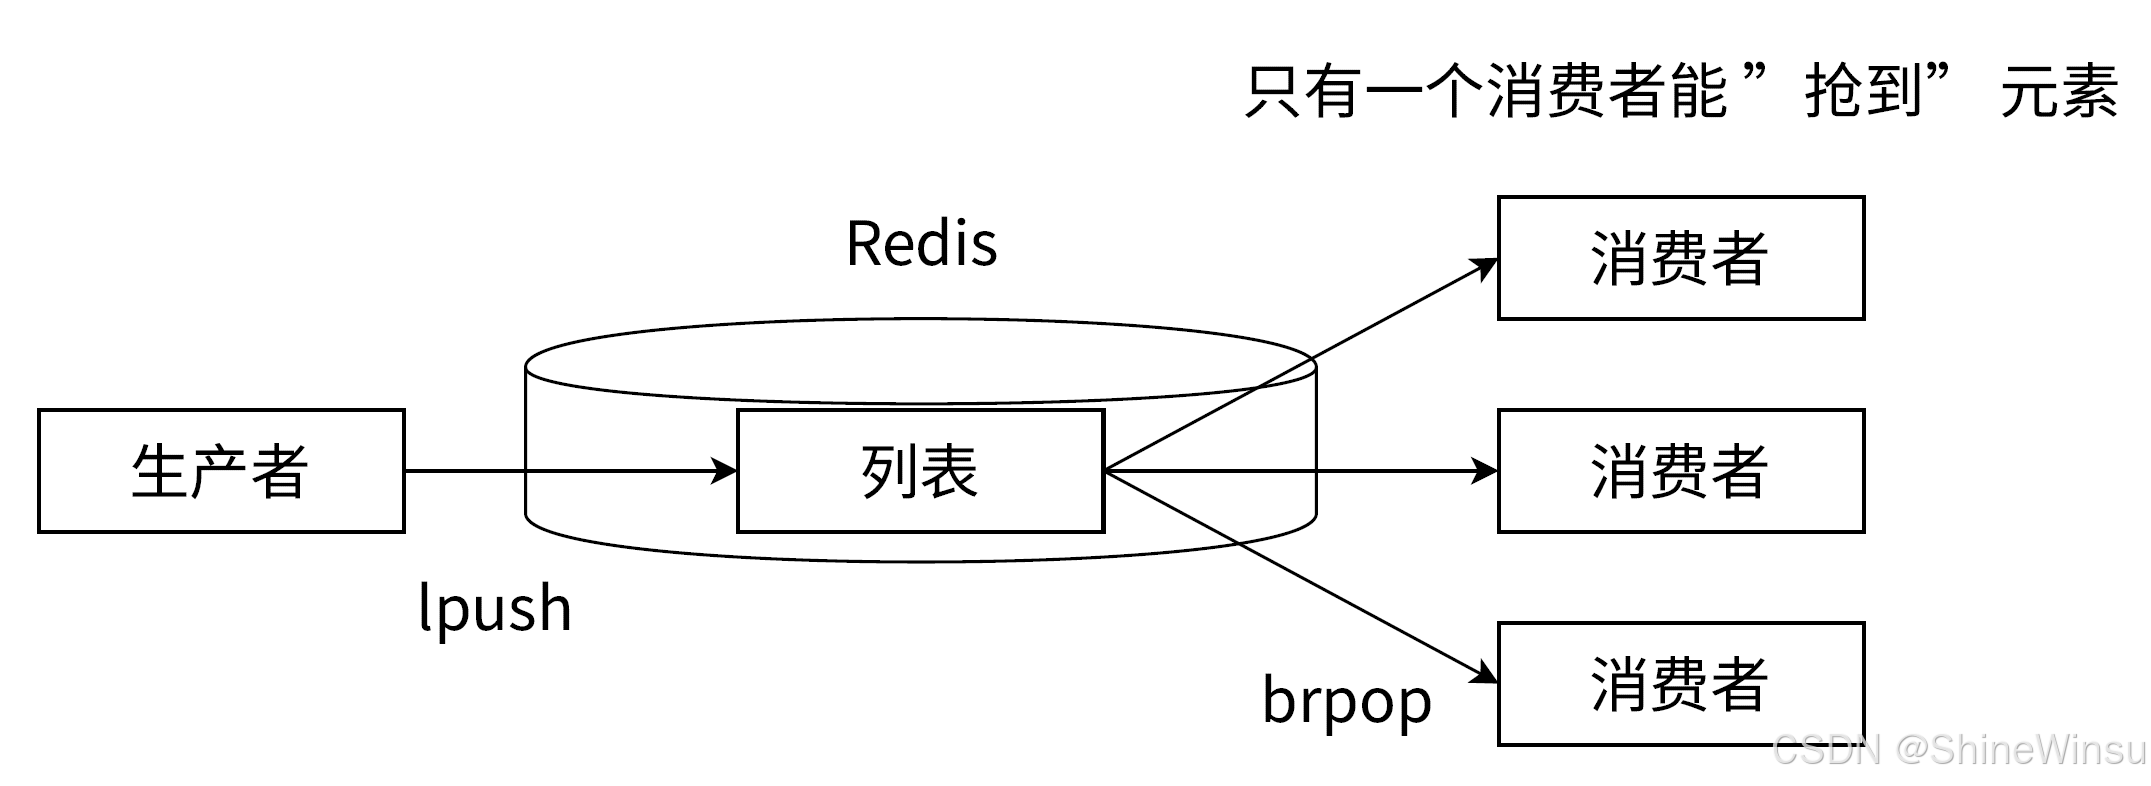
4.1.2 实现方案
利用 Redis List 的LPUSH + BRPOP经典组合实现阻塞式消息队列,这是 Redis 最经典的轻量级消息队列方案,无需搭建专门的 MQ 中间件(如 RocketMQ、Kafka),适合轻量级业务场景:
- 生产者 :使用
LPUSH向列表表头 插入消息(入队),Key 命名为mq:{业务名}(如mq:order、mq:log); - 消费者 :使用
BRPOP从列表表尾阻塞弹出消息(出队),设置合理的超时时间(如 30 秒); - 消息格式:消息内容序列化为 JSON 字符串,包含「消息 ID、业务数据、发送时间」,保证消息的唯一性和可解析性;
- 多消费者负载均衡 :启动多个消费者进程,同时对同一个 Key 执行
BRPOP,Redis 会按客户端顺序公平分配消息,实现争抢消费。
4.1.3 核心 Redis 命令演示
bash
# 生产者操作:向订单消息队列插入2条消息(JSON字符串)
redis> LPUSH mq:order '{"msgId":"1001","orderId":"OD20251001","content":"订单创建","time":"2025-10-01 10:00:00"}'
(integer) 1
redis> LPUSH mq:order '{"msgId":"1002","orderId":"OD20251002","content":"订单支付","time":"2025-10-01 10:05:00"}'
(integer) 2

# 消费者操作:阻塞弹出消息,超时时间30秒
redis> BRPOP mq:order 30
1) "mq:order"
2) "{\"msgId\":\"1001\",\"orderId\":\"OD20251001\",\"content\":\"订单创建\",\"time\":\"2025-10-01 10:00:00\"}"

# 再次执行,弹出第二条消息
redis> BRPOP mq:order 30
1) "mq:order"
2) "{\"msgId\":\"1002\",\"orderId\":\"OD20251002\",\"content\":\"订单支付\",\"time\":\"2025-10-01 10:05:00\"}"

# 队列空,消费者进入阻塞状态,等待新消息
redis> BRPOP mq:order 30
# 生产者插入新消息后,消费者立即弹出
4.1.4 伪代码实现(Java)
java
/**
 * 基于Redis List的阻塞式消息队列
 */
public class RedisMQ {
    private static final JedisPool JEDIS_POOL = new JedisPool(new JedisPoolConfig(), "127.0.0.1", 6379);
    private static final String MQ_KEY = "mq:order";
    private static final int TIMEOUT = 30; // 阻塞超时时间30秒

    // 生产者:发送消息
    public static void sendMessage(String msg) {
        try (Jedis jedis = JEDIS_POOL.getResource()) {
            jedis.lpush(MQ_KEY, msg);
        }
    }

    // 消费者:阻塞获取消息
    // 消费者:阻塞获取消息
    public static String consumeMessage() {
        try (Jedis jedis = JEDIS_POOL.getResource()) {
            // BRPOP返回List,第一个元素是Key,第二个是消息
            List<String> result = jedis.brpop(TIMEOUT, MQ_KEY);
            if (result == null || result.size() < 2) {
                return null;
            }
            return result.get(1);
        }
    }

    public static void main(String[] args) {
        // 启动一个消费者线程(实际生产可多开)
        new Thread(() -> {
            while (true) {
                String msg = consumeMessage();
                if (msg != null) {
                    System.out.println("消费消息:" + msg);
                    // 执行业务逻辑:订单处理、日志落库、异步任务...
                }
            }
        }).start();

        // 主线程模拟生产者发送2条消息
        sendMessage("{\"msgId\":\"1001\",\"orderId\":\"OD20251001\",\"type\":\"create\"}");
        sendMessage("{\"msgId\":\"1002\",\"orderId\":\"OD20251002\",\"type\":\"pay\"}");
    }
}
4.1.5 为什么是 LPUSH + BRPOP,而不是其他组合?
Redis List 实现消息队列有四种组合方式:
LPUSH + LPOP:栈(LIFO),不适合消息队列RPUSH + RPOP:栈(LIFO),不适合消息队列RPUSH + LPOP:队列(FIFO),但非阻塞,需要轮询- LPUSH + BRPOP:队列(FIFO),阻塞、高性能、无空轮询
生产环境唯一推荐:LPUSH + BRPOP
- 左边进、右边出,严格先进先出
- BRPOP 阻塞等待,不消耗 CPU 空转
- 多消费者公平争抢,天然负载均衡
4.2 场景 2:分频道、多主题消息队列
在实际业务中,我们往往不只需要一个队列,而是需要按业务拆分队列(订单、支付、物流、积分、日志等),类似 MQ 的 Topic/Queue 机制。
4.2.1 实现思路
-
不同业务使用不同 List Key ,例如:
mq:order:createmq:order:paymq:user:loginmq:log:app
-
消费者可以同时监听多个 Key ,一旦任意一个队列有消息就消费:
BRPOP mq:order:create mq:order:pay mq:user:login 30 -
返回结果会带上具体是哪个 Key 弹出的消息,消费者可根据 Key 区分业务。
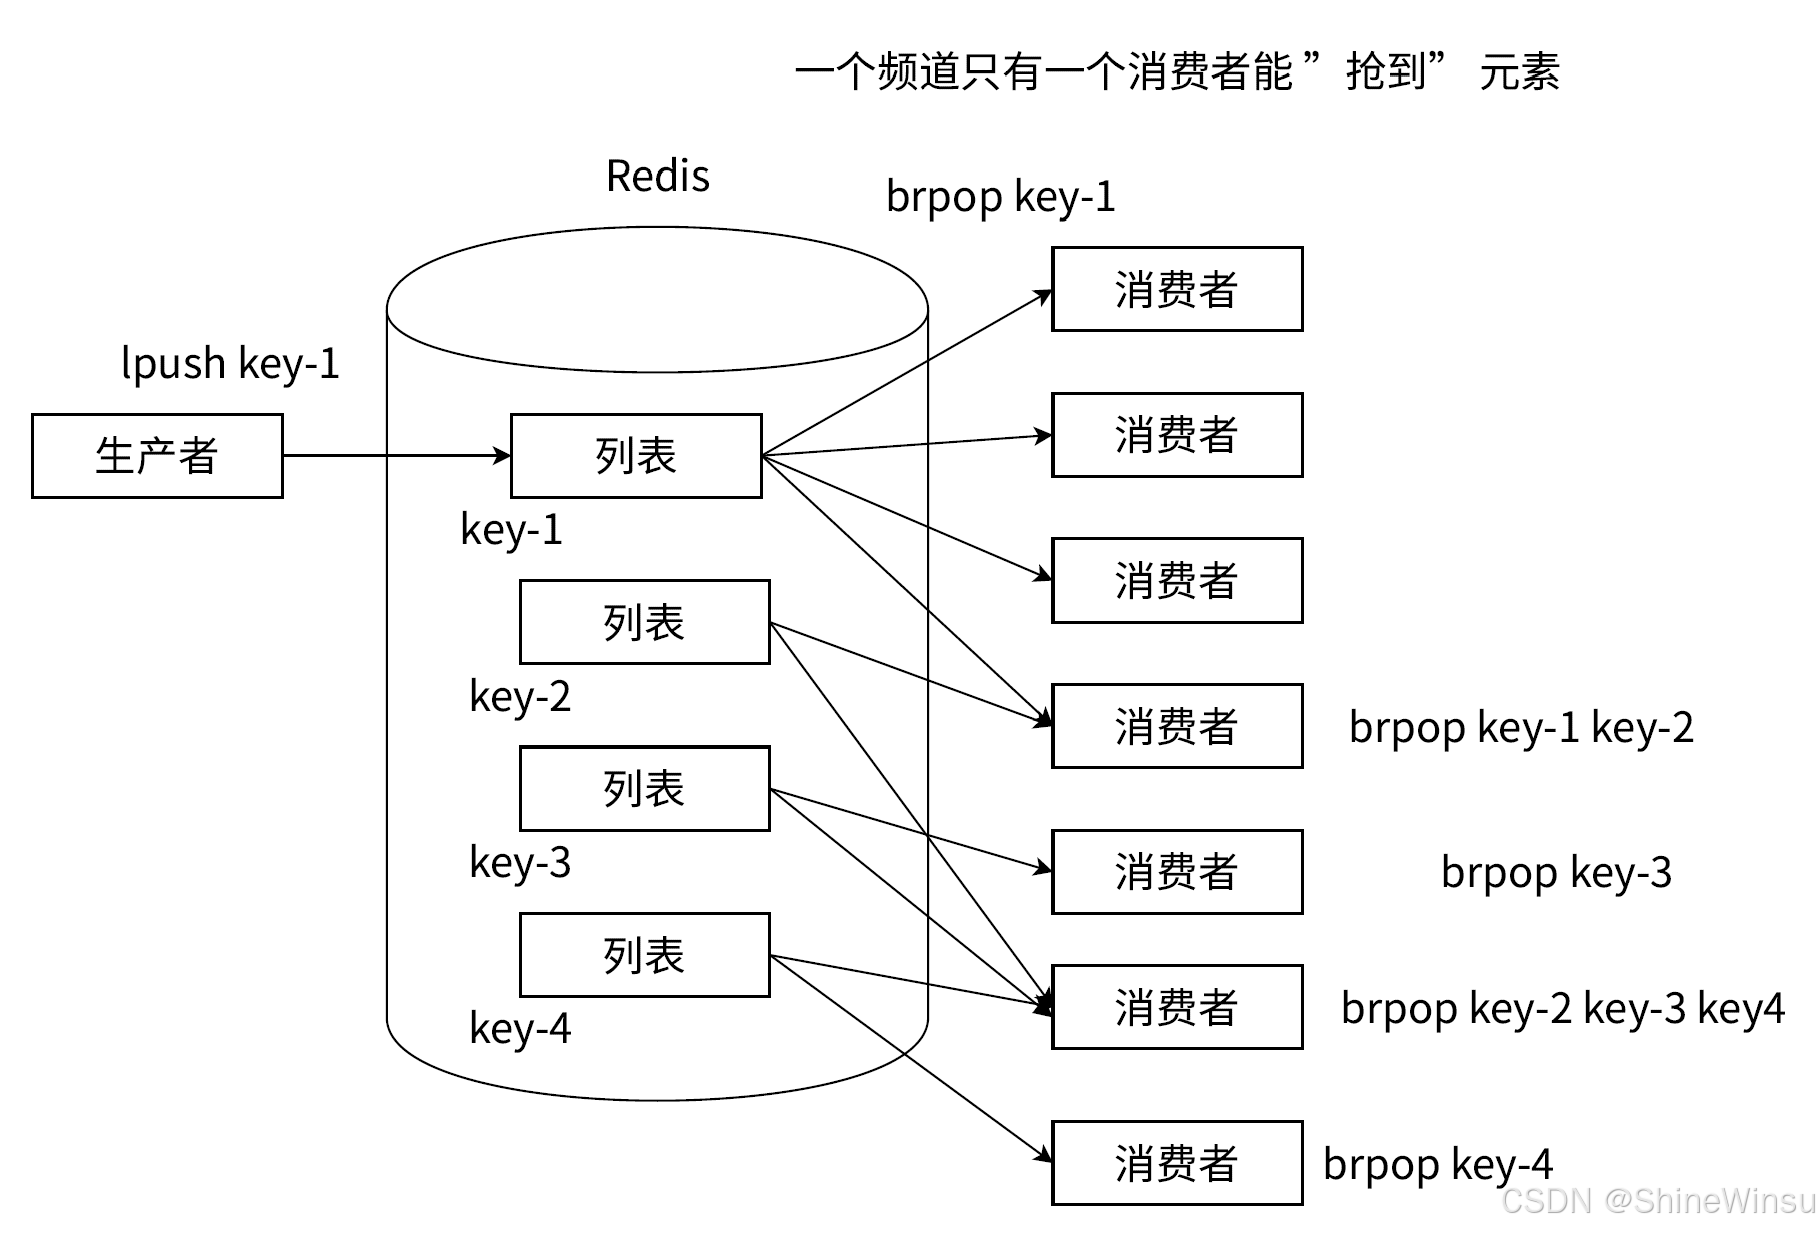
4.2.2 命令示例
# 生产者分别往不同频道写消息
LPUSH mq:order:create '{"orderId":1001}'
LPUSH mq:order:pay   '{"orderId":1001,"payAmount":999}'
LPUSH mq:user:login  '{"userId":10001,"ip":"1.2.3.4"}'

# 消费者同时监听多个队列,哪个有消息消费哪个
BRPOP mq:order:create mq:order:pay mq:user:login 30
返回示例:
1) "mq:order:pay"
2) "{\"orderId\":1001,\"payAmount\":999}"消费者通过第一个返回值(队列名) 就可以路由到不同业务逻辑,实现类似 "多主题订阅" 模型。
4.3 场景 3:微博 / 首页 Timeline 流(Feed 流)
微博、知乎、抖音、小红书等产品的个人主页、关注页、最新列表 ,本质都是有序、可翻页、按时间倒序的 Feed 流,Redis List 是最经典实现方案之一。
4.3.1 需求特点
- 每个用户有自己的微博列表
- 新微博插入头部,保证最新在前
- 支持分页加载(下拉刷新、上拉加载更多)
- 只需要保留最近 N 条(例如 500/1000 条)
4.3.2 实现方案
- 每条微博用 Hash / String 存储完整内容(
mblog:1、mblog:2...) - 用户 Timeline 用 List 只存微博 ID :
- Key =
user:100:mblogs - Value = mblog:1001, mblog:1002, mblog:1003 ...
- Key =
- 发微博:
LPUSH user:100:mblogs mblog:1005 - 分页:
LRANGE user:100:mblogs 0 9(第 1 页)、LRANGE 10 19(第 2 页) - 控制长度:
LTRIM user:100:mblogs 0 499(只保留最新 500 条)
4.3.3 命令示例
# 发微博(先存内容,再推ID到个人Timeline)
HSET mblog:1005 title "今天Redis学List" content "..." timestamp 1735689000
LPUSH user:100:mblogs mblog:1005

# 分页获取前10条微博ID
LRANGE user:100:mblogs 0 9

# 只保留最新500条,自动淘汰旧微博
LTRIM user:100:mblogs 0 499
4.3.4 优点
- 有序、倒序、分页天然支持
- List 只存 ID,内存占用极低
- 新微博插入头部 O (1),性能极高
- 配合 LTRIM 自动实现 "保留最新 N 条"
4.3.5 注意事项(经典坑)
- LRANGE 在列表中间位置性能差 :
- 列表非常大时(百万级),不要翻很深的页(如 10000~10010)
- 解决方案:限制最大翻页深度、拆分成多个 List、热点用户单独存储
- 1 + N 查询问题 :
- 先 LRANGE 得到一批 ID,再循环 HGETALL,会产生大量 IO
- 优化:使用 Pipeline 批量获取,或把微博存为 String 用 MGET
4.4 场景 4:最新列表 / 最新日志 / 最新通知
需求:只保留最近 N 条记录,自动淘汰旧数据,按时间倒序展示。
典型场景:
- 系统最新操作日志
- 用户最新通知
- 商品最近浏览记录
- 接口最近请求记录
4.4.1 实现套路(固定三板斧)
- 新数据从左边插入 :
LPUSH latest:log "2025-10-01 10:00:00 info user login" - 只保留最近 N 条 :
LTRIM latest:log 0 99(保留 100 条) - 展示最新 :
LRANGE latest:log 0 19(前 20 条)
4.4.2 命令示例
# 新增一条日志
LPUSH latest:log "2025-10-01 10:01:00 [INFO] user=10001 login"
# 立即裁剪,只保留最近100条
LTRIM latest:log 0 99
# 前端获取最新20条
LRANGE latest:log 0 19
优点:
- 实现极简单
- 性能极高
- 自动淘汰、无需额外清理任务
- 内存可控
4.5 场景 5:栈(Stack)与 队列(Queue)基础结构
Redis List 是少数能同时天然实现栈和队列的数据结构,这是面试高频考点。
4.5.1 栈(先进后出 LIFO)
同侧进、同侧出:
LPUSH + LPOPRPUSH + RPOP
示例:
LPUSH stack a b c
LPOP stack  # c
LPOP stack  # b
LPOP stack  # a
适用场景:
- 函数调用栈模拟
- 撤销 / 回退操作
- 临时逆序处理
4.5.2 队列(先进先出 FIFO)
异侧进、异侧出:
LPUSH + RPOPRPUSH + LPOP
示例:
LPUSH queue a b c
RPOP queue  # a
RPOP queue  # b
RPOP queue  # c
适用场景:
- 普通任务队列
- 异步解耦
- 削峰
五、List 内部编码再深入
5.1 两种编码回顾
-
ziplist(压缩列表)
- 元素少、元素小
- 连续内存、紧凑、省内存
- 默认条件:
- 元素个数 <
list-max-ziplist-entries(默认 512) - 每个元素大小 <
list-max-ziplist-value(默认 64 字节)
- 元素个数 <
-
linkedlist(链表)
- 元素多 或 有大元素
- 双向链表、前后指针、每个节点独立
- 读写两端 O (1)
- 内存开销更大
5.2 编码转换规则
- 满足 ziplist 条件 → 使用 ziplist
- 任一条件不满足 → 转换为 linkedlist
- 转换是单向、不可逆:一旦变成 linkedlist,即使再删到只剩 1 个元素,也不会变回 ziplist
5.3 如何查看编码
OBJECT ENCODING key示例:
RPUSH list a b c
OBJECT ENCODING list  # ziplist

RPUSH list big_value_xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx
OBJECT ENCODING list  # linkedlist
5.4 生产优化建议
- 尽量让 List 保持 ziplist
- 控制单个元素大小 < 64 字节
- 控制列表长度 < 512(或业务可接受的合理值)
- 超长列表拆分为多个小 List(例如按天 / 按小时 / 按用户分桶)
六、List 命令完整小结
6.1 操作分类总表
6.1.1 添加
| 命令 | 作用 | 时间复杂度 |
|---|---|---|
| LPUSH key ele ele... | 左边插入 | O (k),k = 元素个数 |
| LPUSHX key ele ele... | key 存在才左边插 | O(k) |
| RPUSH key ele ele... | 右边插入 | O(k) |
| RPUSHX key ele ele... | key 存在才右边插 | O(k) |
| LINSERT key BEFORE/AFTER pivot ele | 在某个元素前后插入 | O(n) |
6.1.2 查询
| 命令 | 作用 | 时间复杂度 |
|---|---|---|
| LRANGE key start stop | 获取 start,end 所有元素 | O(s+n) |
| LINDEX key index | 获取下标 index 元素 | O(n) |
| LLEN key | 获取列表长度 | O(1) |
6.1.3 删除
| 命令 | 作用 | 时间复杂度 |
|---|---|---|
| LPOP key | 左边弹出 | O(1) |
| RPOP key | 右边弹出 | O(1) |
| LREM key count value | 删除 count 个 value | O(n) |
| LTRIM key start stop | 只保留 start,end | O(n) |
6.1.4 修改
| 命令 | 作用 | 时间复杂度 |
|---|---|---|
| LSET key index value | 修改下标 index 元素 | O(n) |
6.1.5 阻塞操作
| 命令 | 作用 | 时间复杂度 |
|---|---|---|
| BLPOP key key... timeout | 阻塞左弹出 | O(1) |
| BRPOP key key... timeout | 阻塞右弹出 | O(1) |
七、List 最容易踩的 10 个生产坑
7.1 坑 1:用 LINDEX / LRANGE 深度偏移遍历大列表
- LINDEX 50000 → O (n) 遍历到第 5 万位
- LRANGE 10000 10010 → 同样要从头遍历到偏移位置
- 结果:Redis 阻塞、CPU 飙升、线上雪崩
严禁对长度 > 1000 的 List 使用深度下标访问。
7.2 坑 2:空列表轮询 RPOP / LPOP
- 不断 RPOP,返回 nil,再循环
- CPU 100%,网络暴增
解决方案:一律用 BRPOP / BLPOP 阻塞等待
7.3 坑 3:BRPOP 超时时间设 0(永久阻塞)
- 网络闪断、Redis 重启、主从切换
- 客户端永久挂起不返回
- 线程耗尽、应用假死
规范:至少设 1~30 秒超时,循环重试
7.4 坑 4:消息队列不做重试、不做死信处理
Redis List 不是专业 MQ:
- 没有 ACK
- 没有重试
- 没有死信队列
- 消费失败直接丢失
生产必须:
- 消费失败重新塞回队列
- 失败超过 N 次转入死信 List
- 关键业务用专业 MQ(Kafka/RocketMQ/RabbitMQ)
7.5 坑 5:List 存超大元素(> 64 字节)
- 自动从 ziplist 转为 linkedlist
- 内存暴涨数倍
- 大量大列表可直接打满 Redis 内存
7.6 坑 6:LREM / LSET / LINSERT 在大列表频繁使用
全部 O (n),高并发下直接堵死 Redis。
7.7 坑 7:以为 List 是 "数组",随机修改频繁
Redis List 是链表结构,不是数组,不要当 ArrayList 用。
7.8 坑 8:LRANGE 0 -1 查询超长大列表
一次返回几十万元素,网络 IO 爆炸、客户端内存爆炸。
7.9 坑 9:不控制 List 长度,无限增长
- 内存只增不减
- 最终 OOM 或 淘汰热点 Key
必须配合 LTRIM 控制长度
7.10 坑 10:多客户端并发 push/pop 不了解竞争规则
- 并发 BLPOP/BRPOP 是公平队列:先到先得
- 不是负载均衡,不是广播,是争抢模式
- 一条消息只会被一个客户端拿到
八、Redis List 适用场景总结
你可以直接用下面的判断逻辑选择是否用 List:
- 需要有序、可重复、按插入顺序保存 → List
- 需要两端快速插入 / 弹出 → List
- 需要栈、队列、阻塞队列 → List
- 需要 Feed/Timeline/ 最新列表 → List
- 需要定长列表、自动淘汰旧数据 → List
- 需要随机下标访问、中间频繁插入 → 不要用 List
- 需要去重 → 不要用 List(用 Set)
- 需要按权重 / 分数排序 → 不要用 List(用 ZSet)
结语
Redis List 作为 Redis 五大基础数据类型中最具「线性结构灵活性」的存在,其核心价值始终围绕「有序可重复」的特性和「两端操作高效」的设计优势展开 ------ 它既可以化身轻量级阻塞消息队列支撑分布式系统的异步解耦,也能作为 Feed 流、最新列表的存储载体满足业务的有序展示需求,还能轻松实现栈、队列等经典数据结构,是中小规模有序序列场景下的首选方案。
回顾整个学习过程,我们从核心概念入手,拆解了 List 的有序性、可重复性和性能特点,逐一解析了从基础插入 / 弹出到阻塞命令的全量核心操作,深入理解了 ziplist 与 linkedlist 两种内部编码的切换逻辑,也落地到消息队列、Timeline 流等经典场景,更梳理了生产环境中极易踩坑的 10 个关键问题。这些内容层层递进,本质上是想传递一个核心认知:用好 Redis List 的关键,是「顺应其设计逻辑」------ 优先操作两端、控制列表大小、规避中间操作,让它在擅长的场景里发挥极致性能。
当然,我们也需要清晰认知 Redis List 的边界:它并非万能的,比如无法高效支持随机下标访问、没有原生的消息确认(ACK)和死信机制、不支持元素去重,这些场景下我们需要转向 Hash、Set、ZSet 甚至 Redis Stream(Redis 5.0+ 推出的专门消息队列结构)或专业 MQ 中间件。学习 Redis 数据类型的本质,就是理解每种类型的「设计初衷」和「性能边界」,在合适的场景选择合适的工具。
希望这篇内容能帮你真正吃透 Redis List------ 不仅记住命令和用法,更能理解底层逻辑、掌握实践原则、规避生产陷阱。Redis 的学习从来不是死记硬背命令,而是「知其然,更知其所以然」,愿你在后续的实践中,能把 List 的特性和业务场景精准结合,写出高性能、高可靠的 Redis 代码。