前言
关注 Feed 流解决的是一个连续推送问题:用户发布探店笔记后,关注他的粉丝可以在自己的关注页面看到这篇笔记,并且通过不断下拉获取更早或更新的内容。黑马点评使用 Redis 保存粉丝收件箱,发布时写入,查询时按发布时间倒序读取。
这条链路包含两个关键点:发布笔记时如何把消息送到粉丝收件箱,以及 Feed 流不断插入新数据后如何稳定分页。后者决定了用户下拉时会不会出现重复数据或漏数据。
一、Feed 流的两种常见排序方式
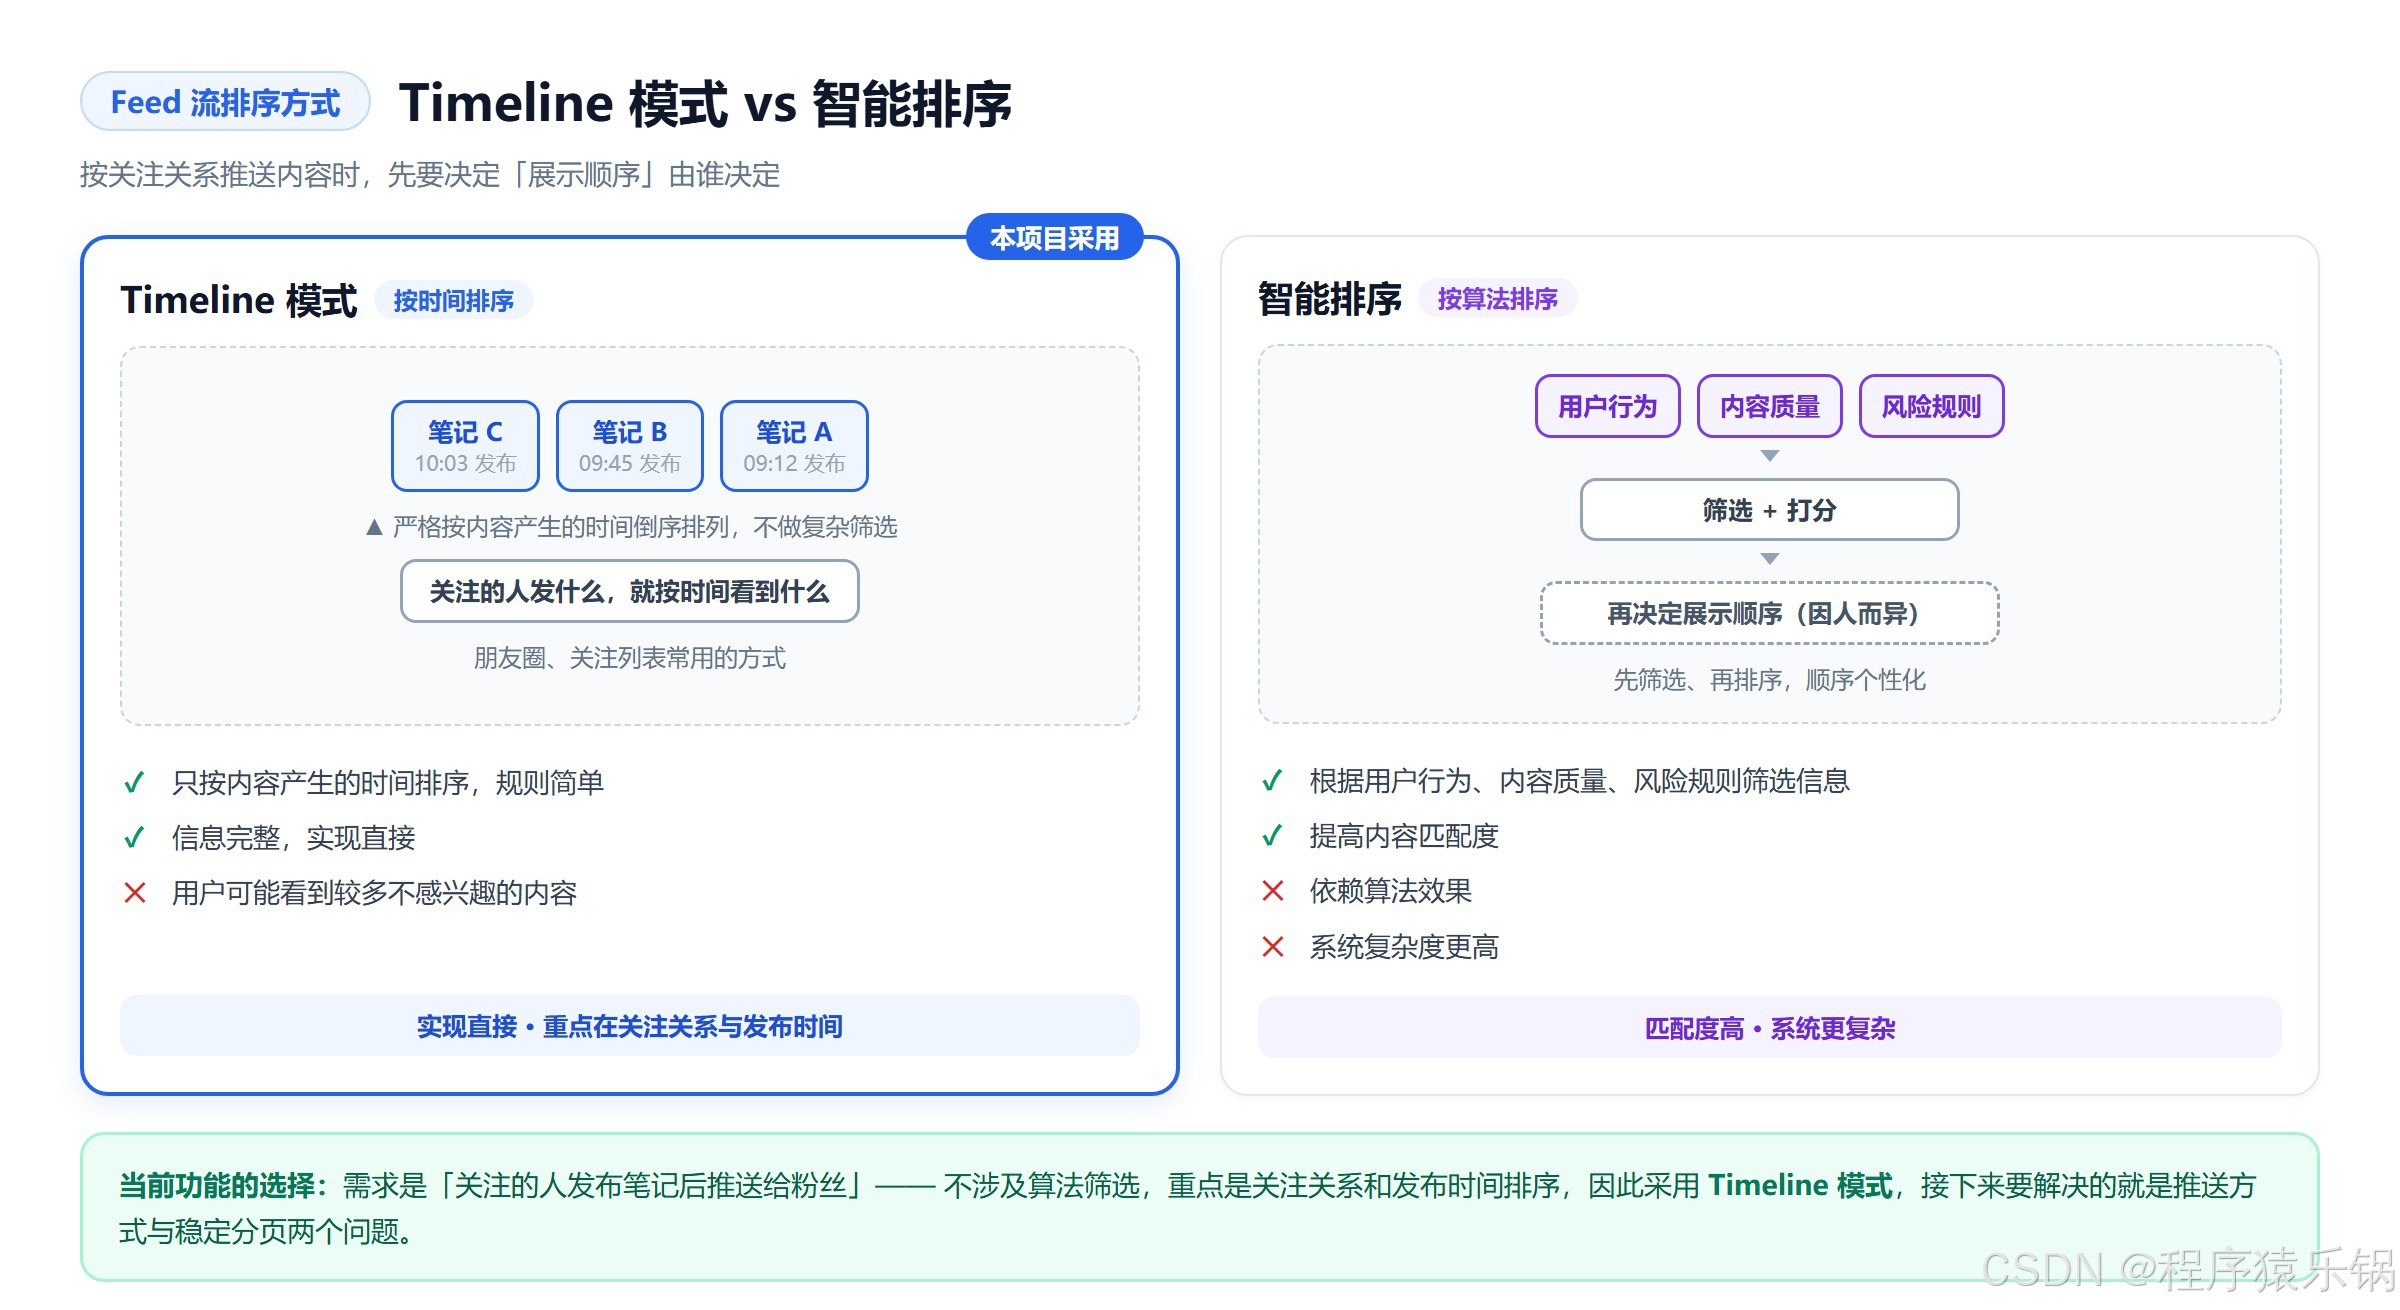
Feed 流可以按关注关系推送,也可以通过算法筛选内容。
Timeline 模式只按照内容产生的时间排序,不对内容做复杂筛选。朋友圈、关注列表常用这种方式。它的信息比较完整,实现也直接,但用户可能会看到较多不感兴趣的内容。
智能排序会根据用户行为、内容质量和风险规则筛选信息,再决定展示顺序。它能提高内容匹配度,但依赖算法效果,系统复杂度也更高。
当前功能是"关注的人发布笔记后推送给粉丝",因此采用 Timeline 模式,重点放在关注关系和发布时间排序上。
二、Timeline 的推送模式
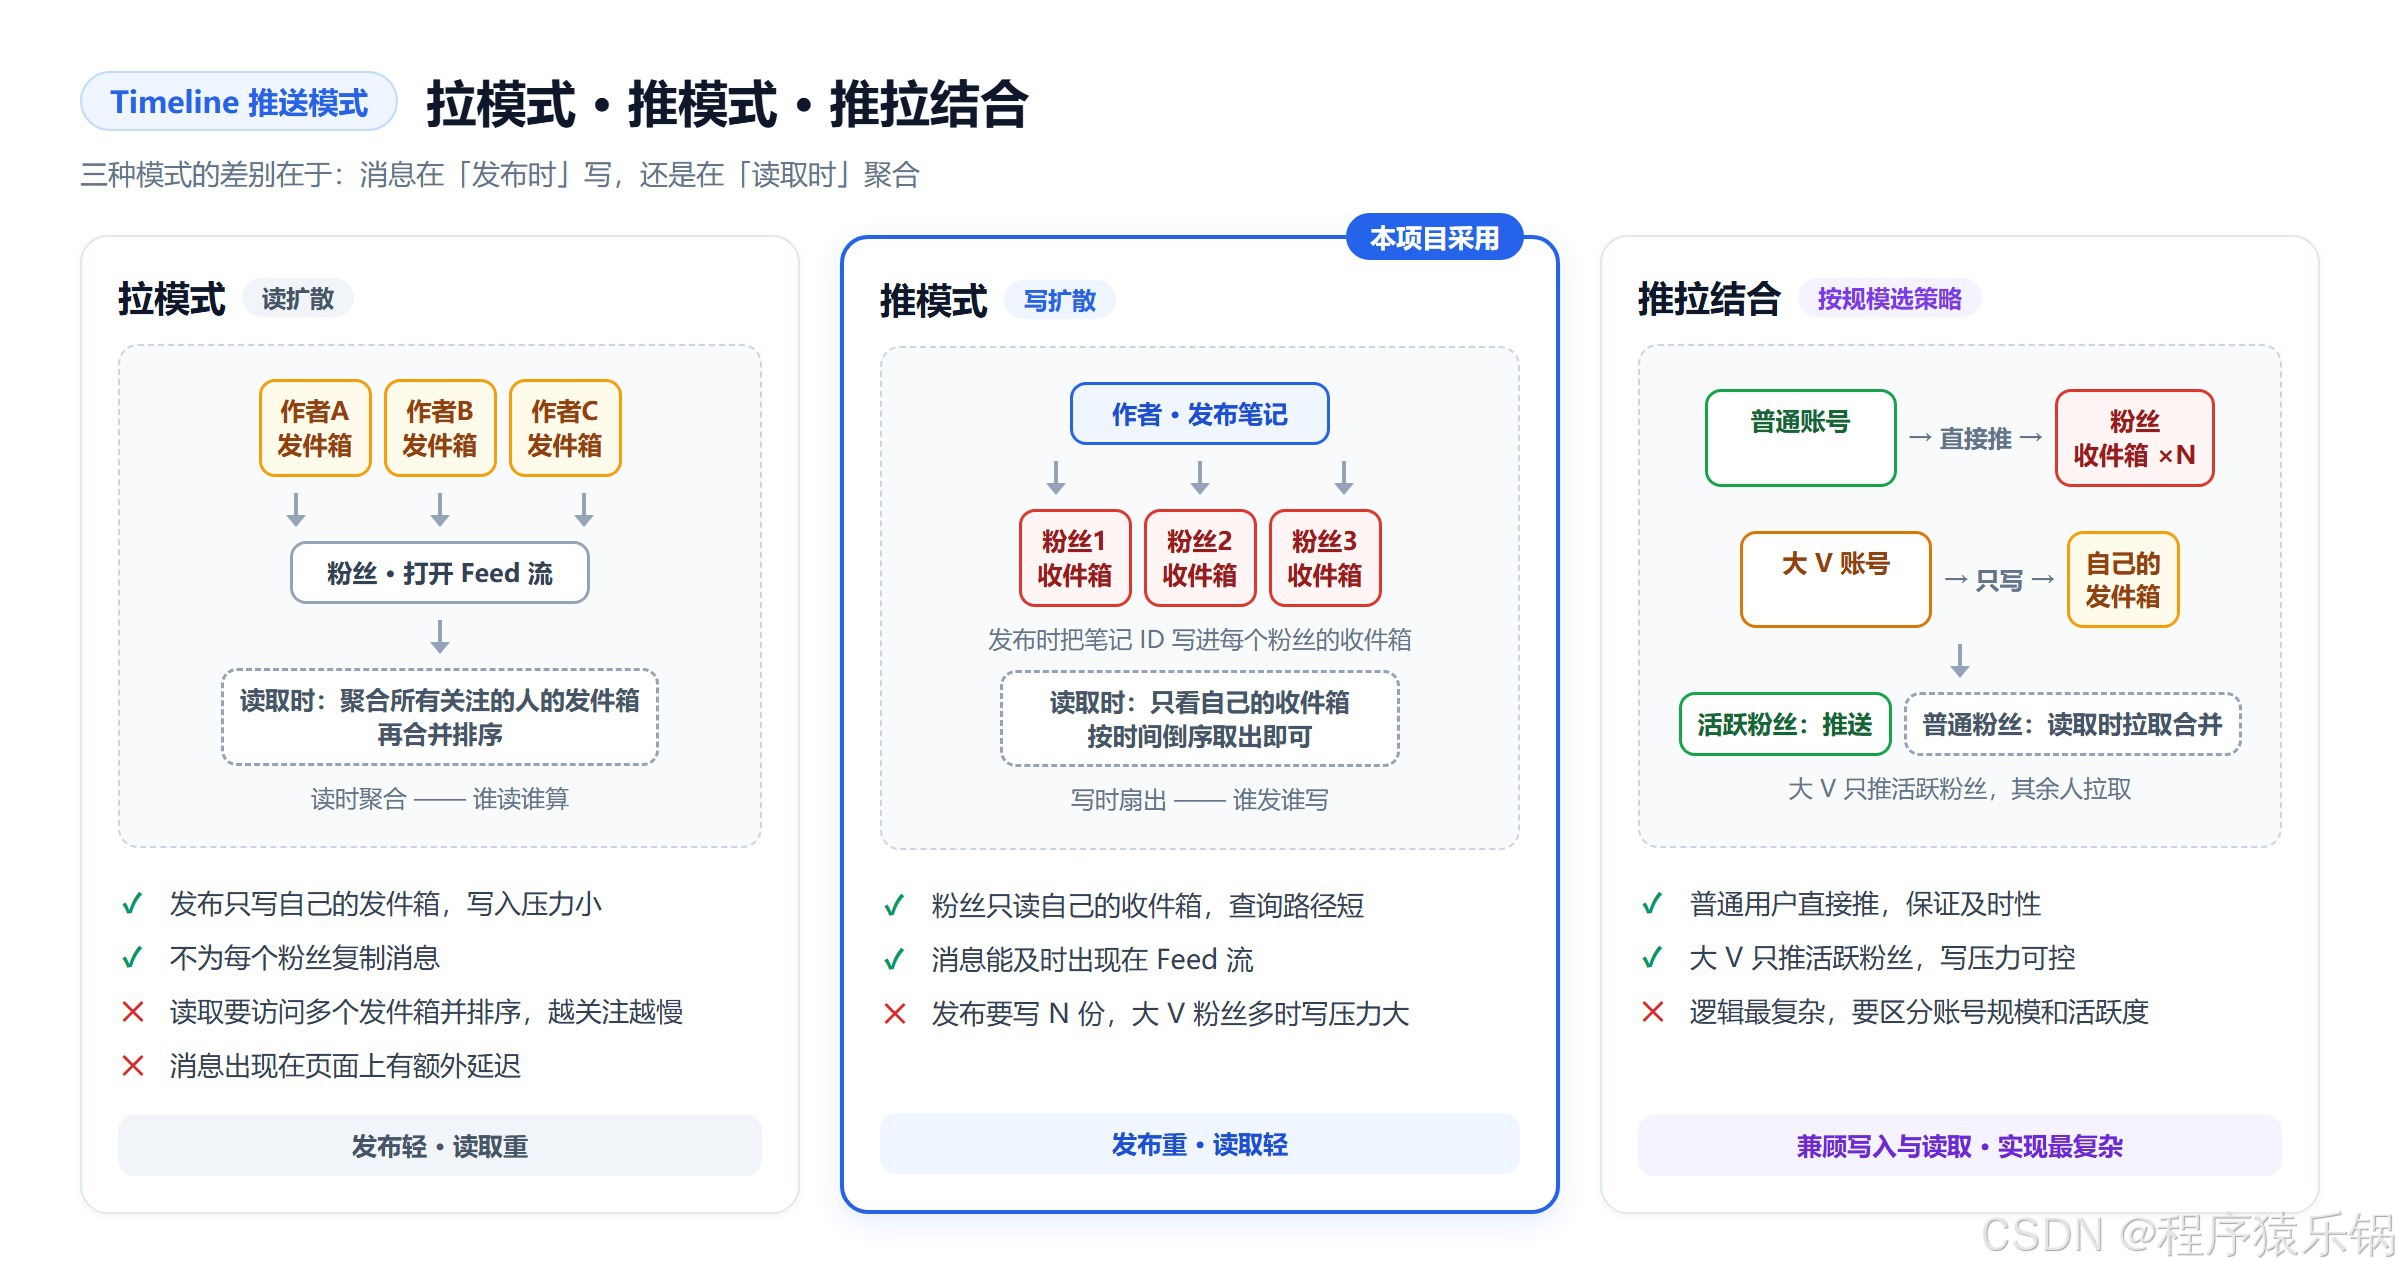
Timeline 通常有拉模式、推模式和推拉结合模式。
1. 拉模式
拉模式也叫读扩散。作者发布内容时只保存自己的发件箱,粉丝打开 Feed 流后,再从所有关注用户的发件箱中读取内容并合并排序。
这种方式写入压力较小,也不会为每个粉丝复制一份消息,但读取时需要访问多个发件箱。关注人数越多,读取和排序的成本越高,消息到达用户页面也会有额外延迟。
2. 推模式
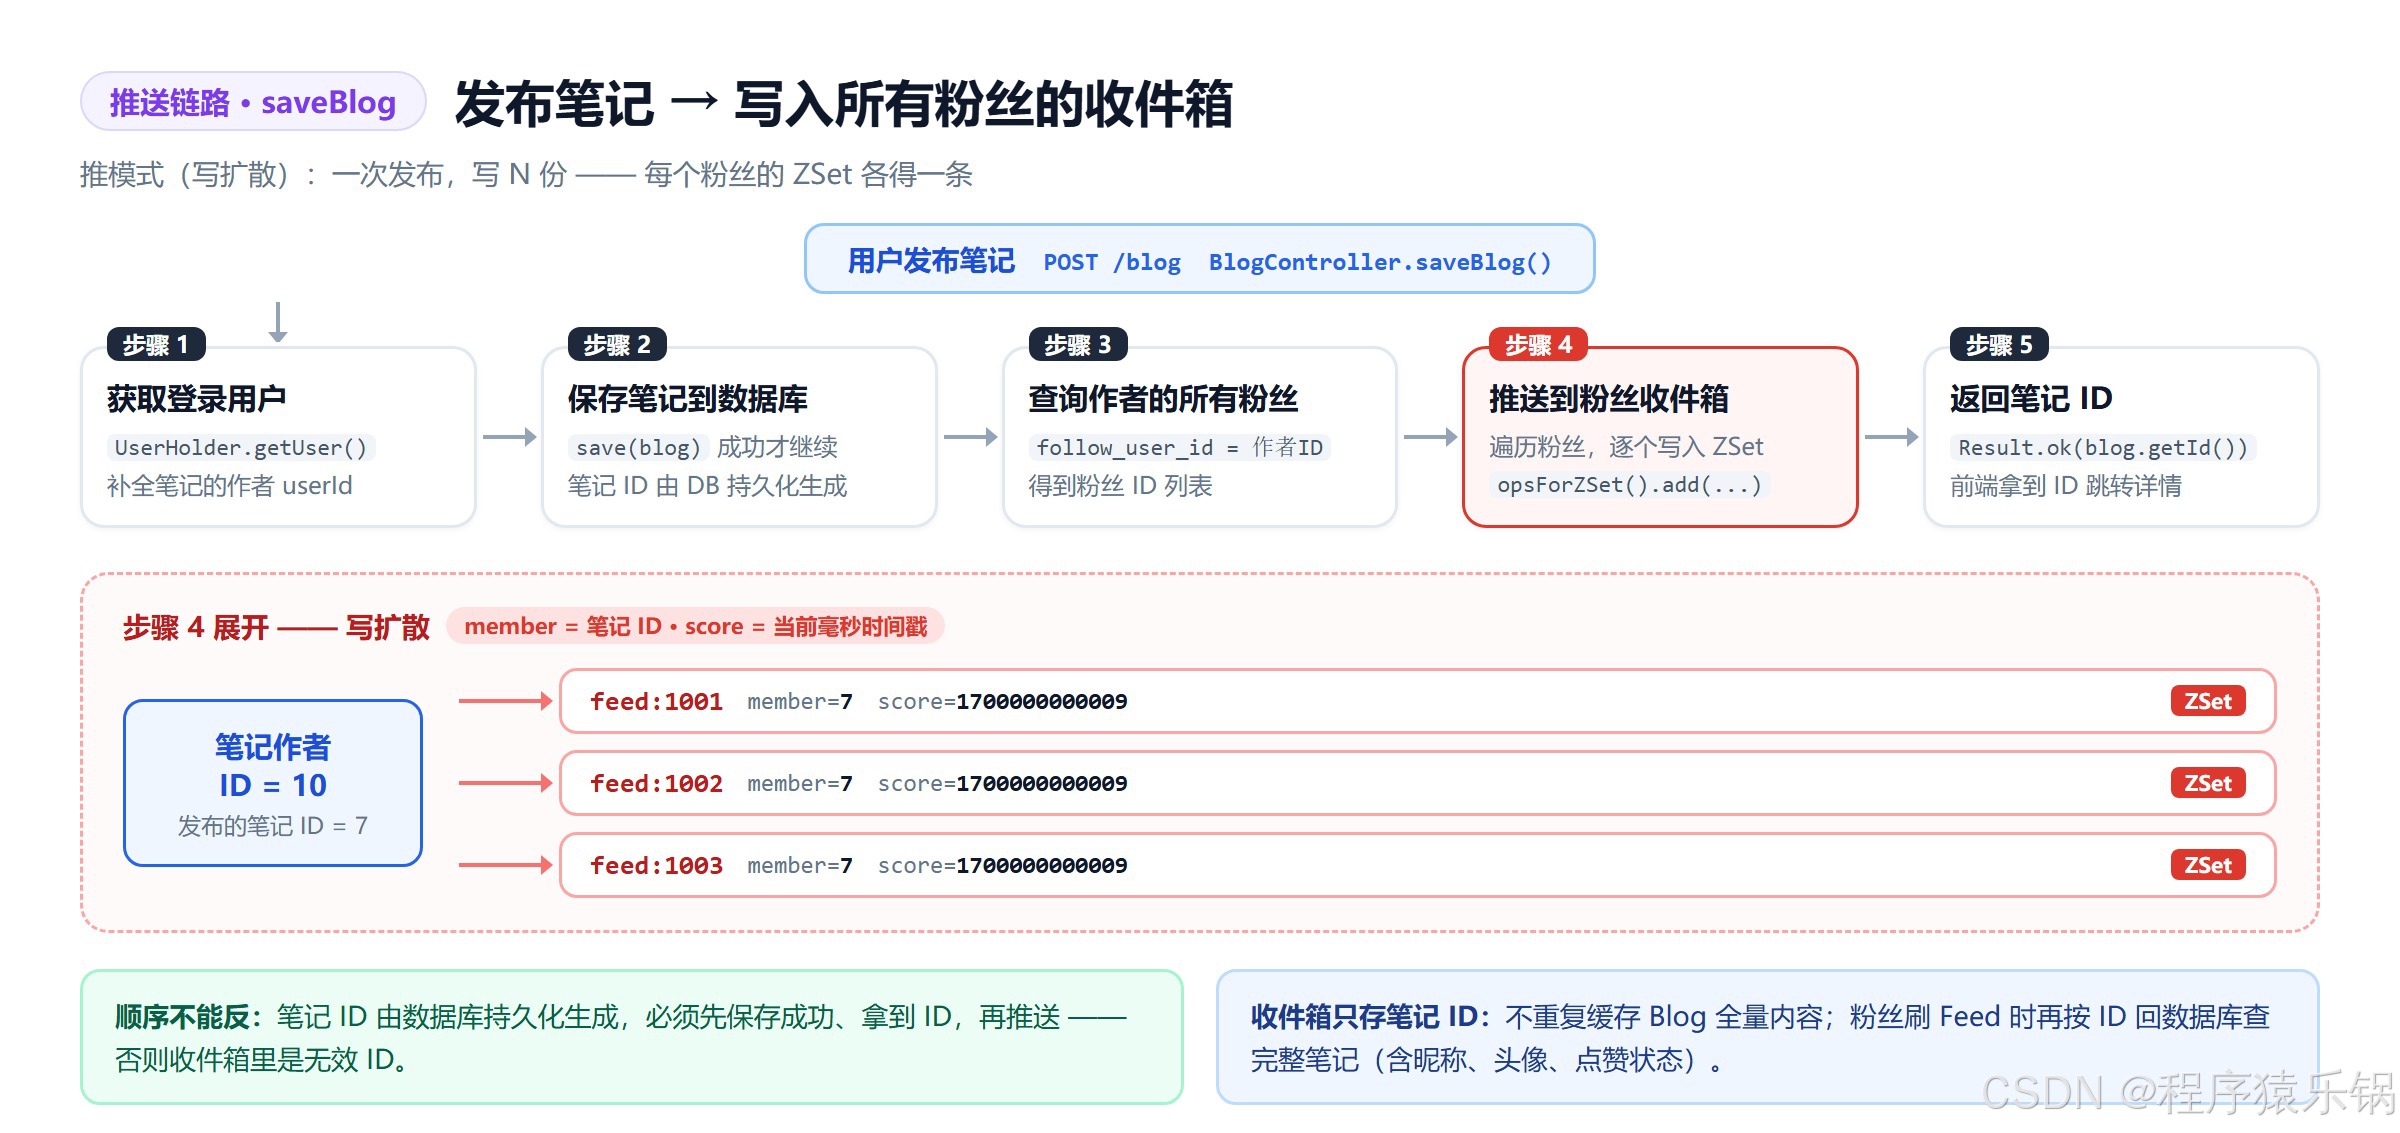
推模式也叫写扩散。作者发布笔记后,系统查出所有粉丝,把笔记 ID 写入每个粉丝自己的收件箱。
粉丝读取时只需要访问自己的收件箱,查询路径短,消息能够及时出现。代价是发布操作的写入次数会随着粉丝数增长,粉丝特别多的账号会带来较大的写压力。
3. 推拉结合模式
推拉结合模式会根据账号规模选择策略。普通用户的粉丝数量较少,可以直接推送到粉丝收件箱;粉丝很多的账号保留自己的发件箱,只给活跃粉丝推送,其他粉丝读取时再拉取。
本项目实现的是关注 Feed 流的基础版本,使用推模式即可满足需求:发布笔记时查出粉丝,将笔记 ID 写入每个粉丝的 Redis 收件箱。
三、为什么不能直接使用传统分页
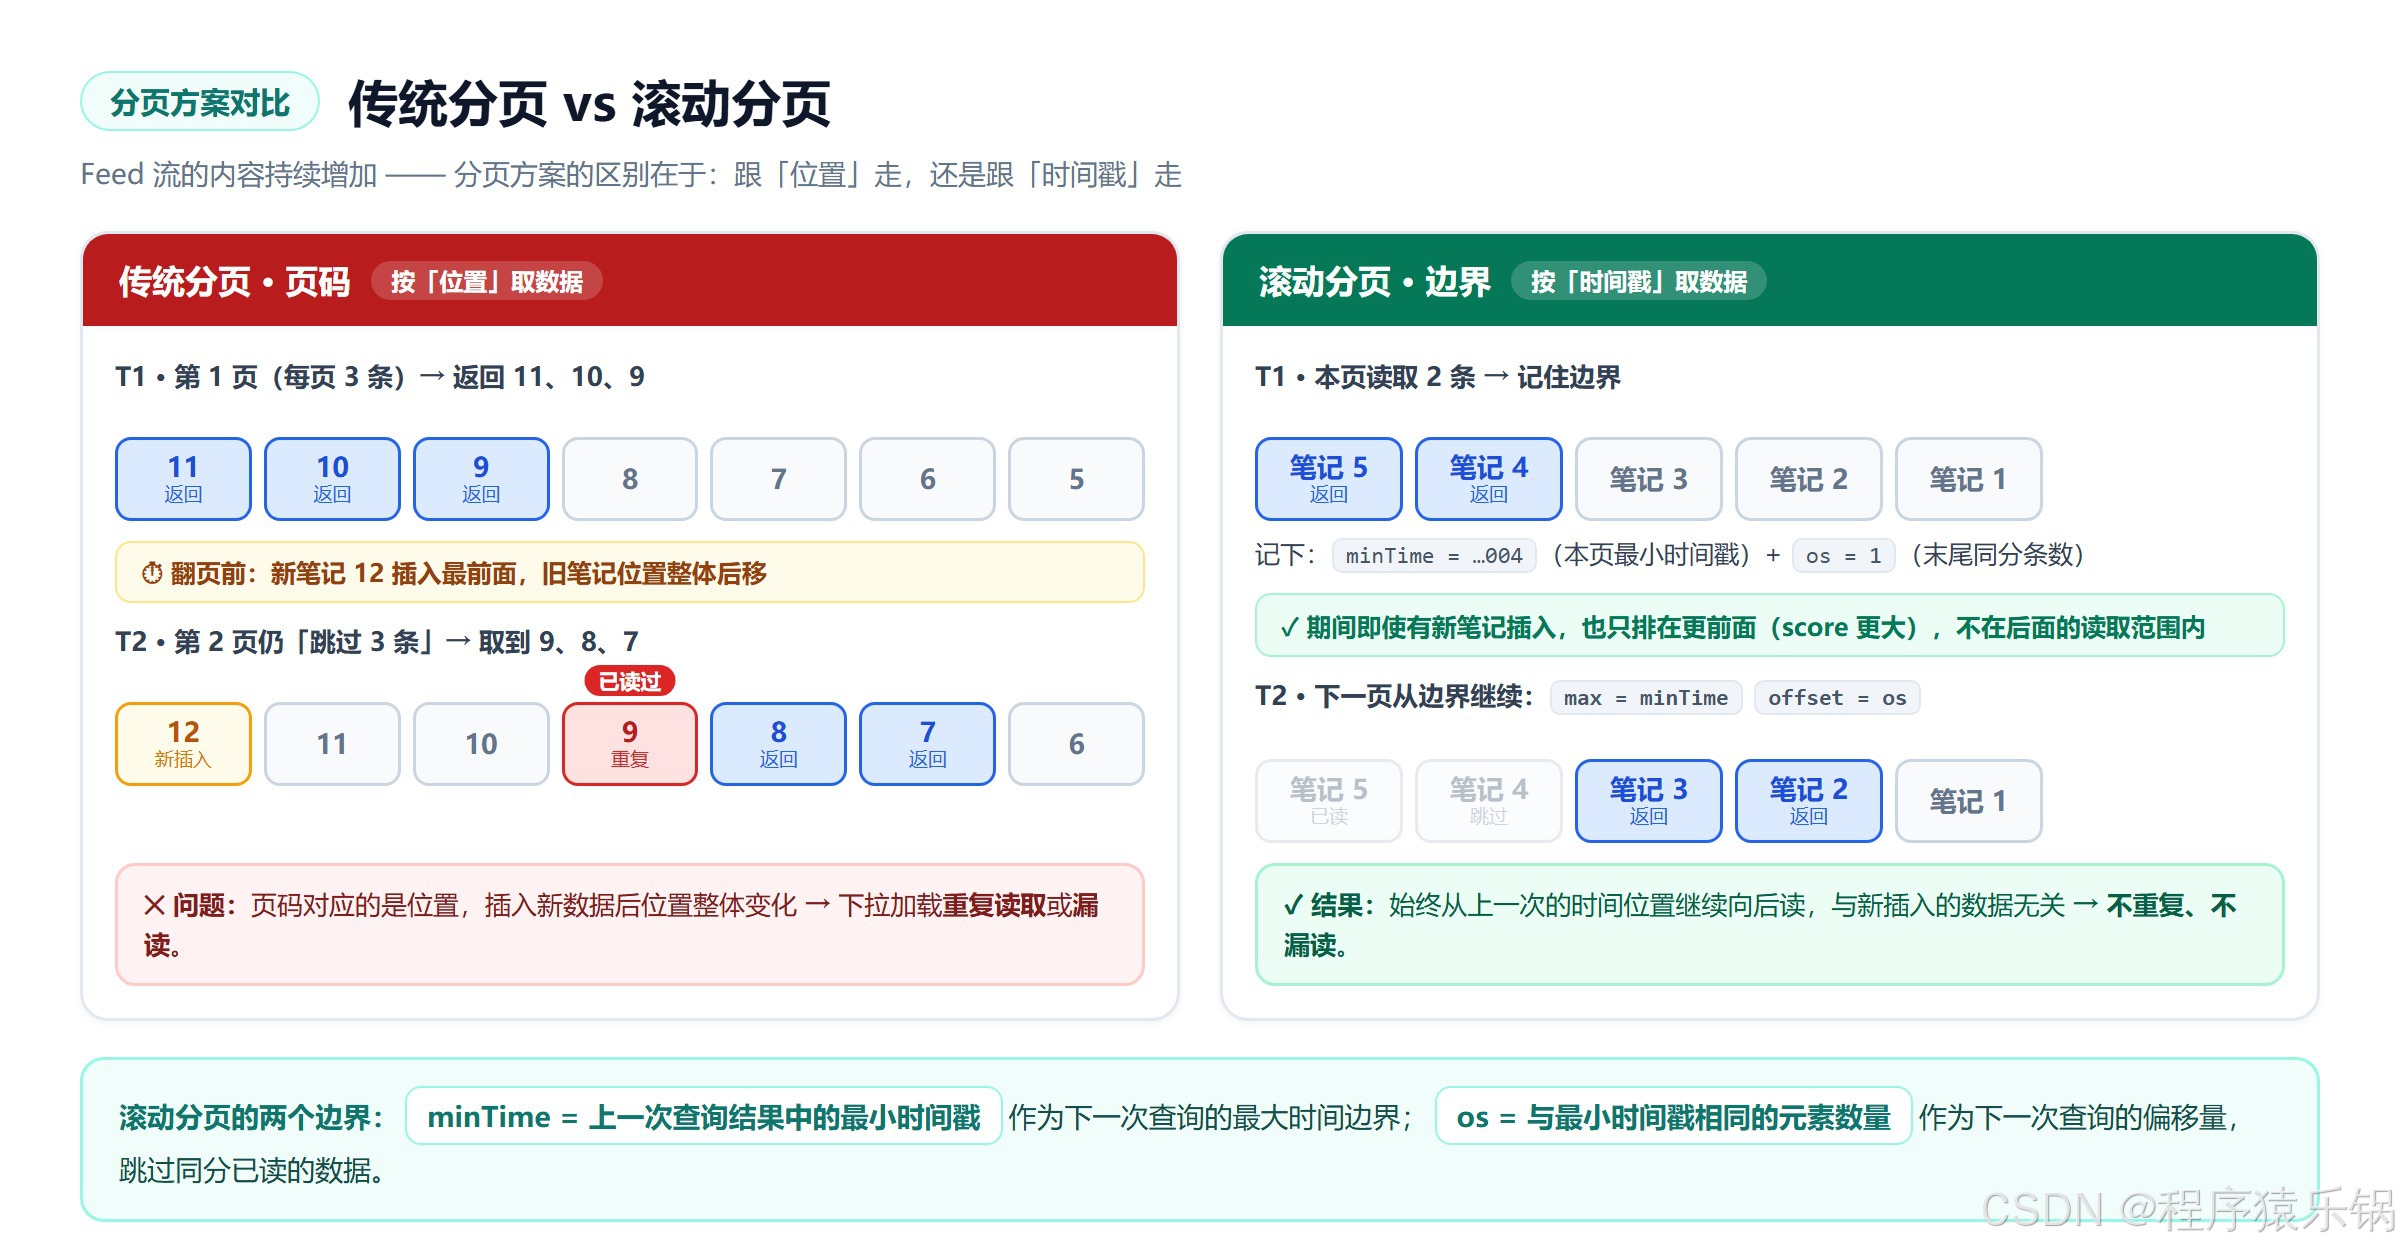
传统分页依赖页码。例如第一次查询第一页,返回第 11、10、9 条数据;在用户查询下一页之前,如果有一条新笔记插入并排在最前面,第二页按页码计算时可能从第 8 条开始,导致原来的第 9 条被重复读取,或者某条数据被跳过。
Feed 流的内容会持续增加,页码对应的数据位置会不断变化。因此查询下一页时不能只依赖"第几页",需要记录上一页的边界。
滚动分页使用两个边界信息:
- 上一次查询结果中的最小时间戳,作为下一次查询的最大时间边界;
- 上一次结果中与这个最小时间戳相同的元素数量,作为下一次查询的偏移量。
这样即使中间有新笔记写入,下一次查询仍然从上一次的时间位置继续向后读取。
四、使用 Redis Sorted Set 保存收件箱
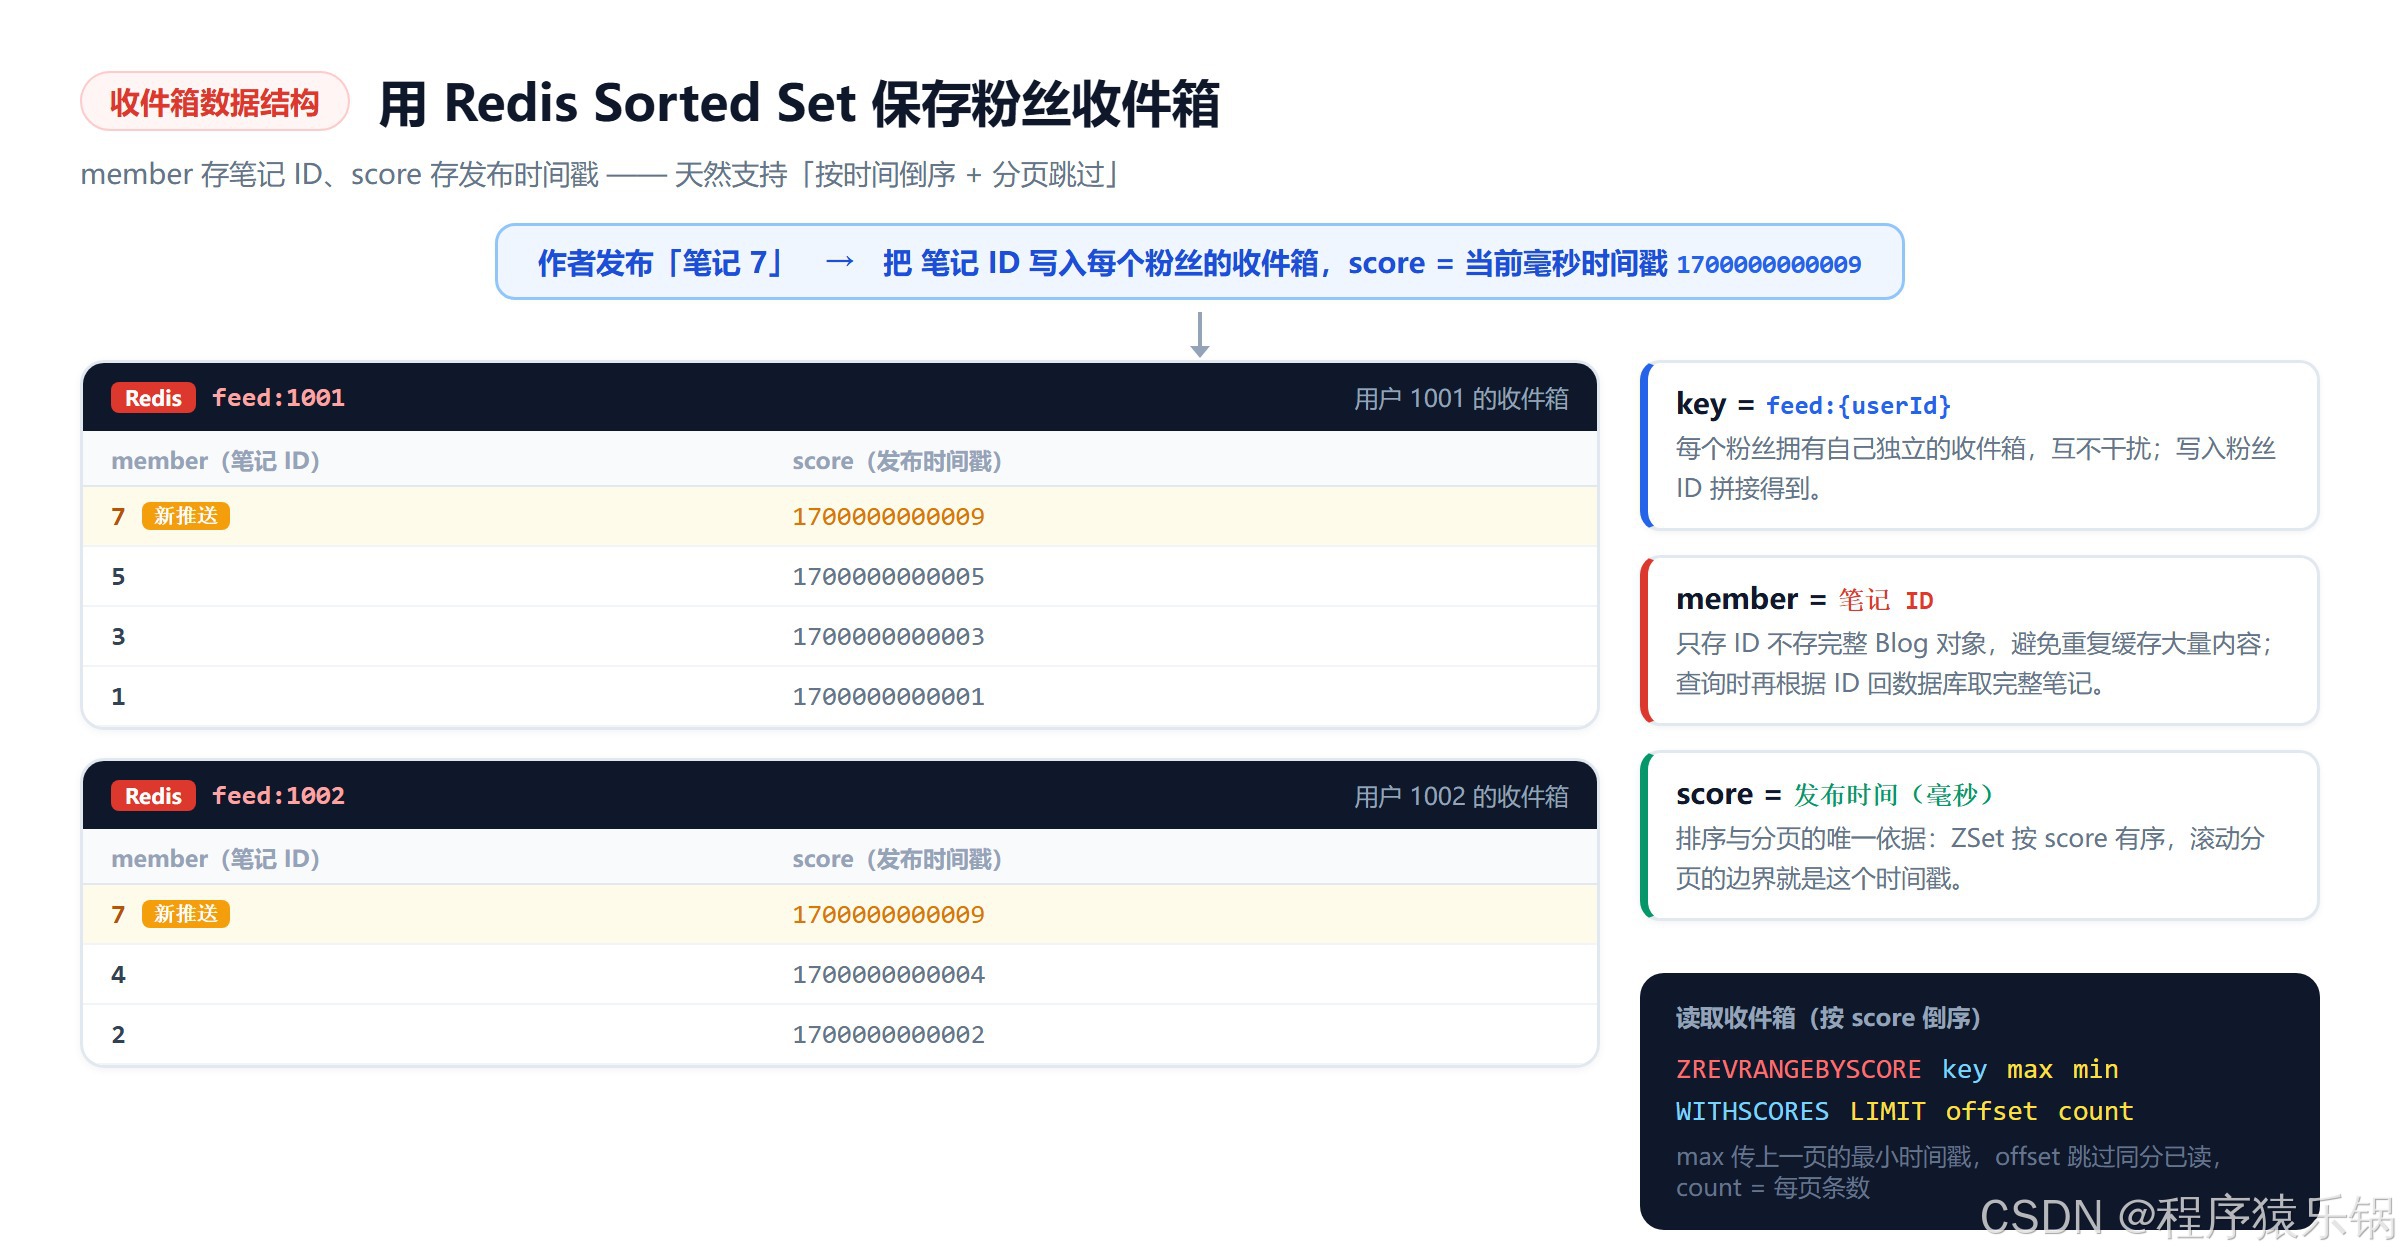
Redis 的 Sorted Set 同时保存成员和分数,适合表示"笔记 ID + 发布时间"的关系:
- key:
feed:{userId},每个用户拥有自己的收件箱; - member:笔记 ID;
- score:发布笔记时的毫秒时间戳。
读取时使用按分数倒序查询的命令:
text
zrevrangebyscore key max min withscores limit offset count其中 max 是本次查询允许的最大时间戳,min 通常设置为 0;offset 用于跳过同一时间戳下已经读取的成员;count 表示本次读取的数量。项目中每次读取 2 条数据,因此 count 设置为 2。
五、发布笔记时推送到粉丝收件箱
新增笔记的请求由 BlogController 接收,业务处理在 BlogServiceImpl 的 saveBlog 方法中完成:
java
@PostMapping
public Result saveBlog(@RequestBody Blog blog) {
    return blogService.saveBlog(blog);
}
Service 先补充当前登录用户,再保存笔记。保存成功后,根据 follow_user_id 查询关注当前用户的记录,Follow.userId 就是粉丝 ID。随后将笔记 ID 写入每个粉丝的 ZSet:
java
@Override
public Result saveBlog(Blog blog) {
    // 1.获取登录用户
    UserDTO user = UserHolder.getUser();
    blog.setUserId(user.getId());

    // 2.保存探店博文
    boolean isSuccess = save(blog);
    if (!isSuccess) {
        return Result.fail("保存失败");
    }

    // 3.查询笔记作者的所有粉丝
    List<Follow> follows = followService.query()
            .eq("follow_user_id", user.getId()).list();

    // 4.推送笔记 id 给所有粉丝
    for (Follow follow : follows) {
        Long userid = follow.getUserId();
        String key = "feed:" + userid;
        stringRedisTemplate.opsForZSet().add(
                key,
                blog.getId().toString(),
                System.currentTimeMillis()
        );
    }

    // 5.返回笔记 id
    return Result.ok(blog.getId());
}
保存笔记时,数据库中的笔记 ID 由持久化操作生成,只有保存成功后才能推送。ZSet 的 score 使用当前毫秒时间戳,因此同一个粉丝的收件箱可以按发布时间排序。
收件箱 key 的格式是 feed:{userId},例如 feed:1001。当前保存逻辑直接使用 feed: 前缀拼接粉丝 ID;项目中的 RedisConstants.FEED_KEY 也定义了相同的前缀。收件箱只保存笔记 ID,不保存完整 Blog 对象,这样可以避免重复缓存大量内容,查询时再根据 ID 从数据库读取完整笔记。
六、使用滚动分页查询关注 Feed 流
Controller 暴露关注 Feed 流接口:
java
@GetMapping("/of/follow")
public Result queryBlogofFollow(
        @RequestParam("latId") Long max,
        @RequestParam(value = "offset", defaultValue = "0") Integer offset) {
    return blogService.queryBlogofFollow(max, offset);
}
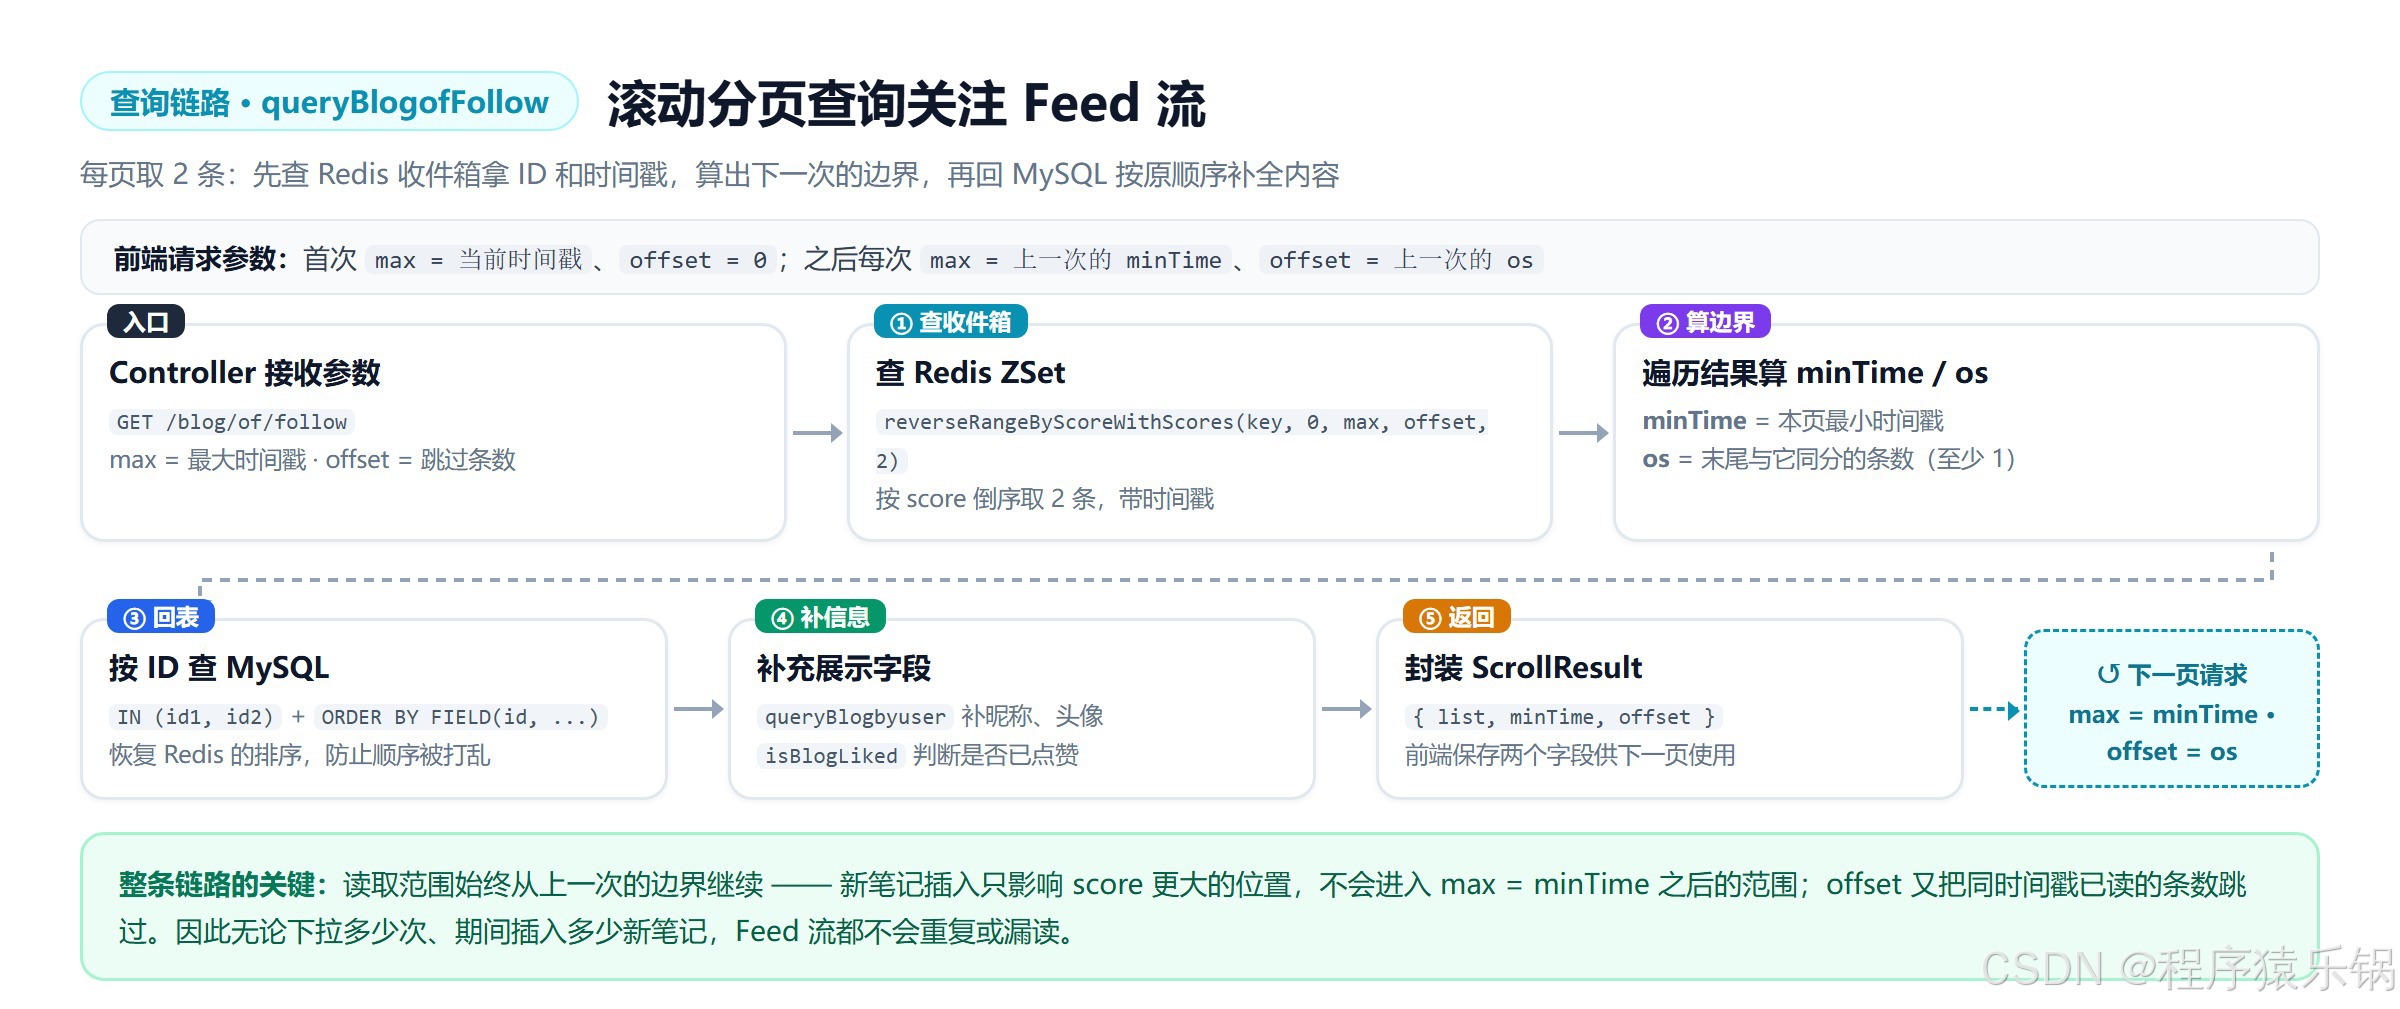
max 表示本次查询的最大时间戳,offset 表示相同时间戳数据的跳过数量。第一次请求时,前端传入当前时间戳和 0;后续请求使用上一次结果中的 minTime 和 offset。
Service 使用 Redis 的 reverseRangeByScoreWithScores 查询收件箱:
java
@Override
public Result queryBlogofFollow(Long max, Integer offset) {
    Long userId = UserHolder.getUser().getId();
    String key = RedisConstants.FEED_KEY + userId;

    Set<ZSetOperations.TypedTuple<String>> typedTuples =
            stringRedisTemplate.opsForZSet()
                    .reverseRangeByScoreWithScores(key, 0, max, offset, 2);

    if (typedTuples == null || typedTuples.isEmpty()) {
        return Result.ok(Collections.emptyList());
    }

    List<Long> ids = new ArrayList<>(typedTuples.size());
    long minTime = 0;
    int os = 1;

    for (ZSetOperations.TypedTuple<String> tuple : typedTuples) {
        ids.add(Long.valueOf(tuple.getValue()));

        long time = tuple.getScore().longValue();
        if (time == minTime) {
            os++;
        } else {
            minTime = time;
            os = 1;
        }
    }

    String idStr = StrUtil.join(",", ids);
    List<Blog> blogs = query()
            .in("id", ids)
            .last("ORDER BY FIELD(id," + idStr + ")")
            .list();

    for (Blog blog : blogs) {
        queryBlogbyuser(blog);
        isBlogLiked(blog);
    }

    ScrollResult result = new ScrollResult();
    result.setList(blogs);
    result.setOffset(os);
    result.setMinTime(minTime);
    return Result.ok(result);
}
1. 查询 Redis 收件箱
reverseRangeByScoreWithScores(key, 0, max, offset, 2) 会按照 score 从大到小返回数据,并且保留每条数据的 score。这里的 score 就是笔记发布时间,返回结果中既有笔记 ID,也有对应时间戳。
2. 计算下一次查询的边界
遍历结果时,minTime 记录本页最小时间戳。os 用来统计结果末尾有多少条数据共享这个时间戳。
例如本页最后两条数据的 score 都是 1700000000000,那么下一页仍然要从这个 score 开始查询,并跳过已经读取的两条数据。只保存最小时间戳而不保存 offset,会导致相同时间戳的数据重复出现。
3. 按 Redis 顺序查询数据库
Redis 返回的是有序的笔记 ID 集合,MySQL 使用 in 查询时不保证按照传入 ID 的顺序返回。因此代码通过 ORDER BY FIELD(id, ...) 恢复 Redis 的排序结果,避免页面上的时间顺序被数据库默认顺序打乱。
查询完成后,代码继续补充笔记作者的昵称和头像,并判断当前用户是否已经点赞,最后将笔记列表、最小时间戳和偏移量封装到 ScrollResult:
java
@Data
public class ScrollResult {
    private List<?> list;
    private Long minTime;
    private Integer offset;
}
前端下一次请求需要携带 minTime 和 offset,这样 Feed 流就能沿着上一次结果的末尾继续读取。
七、总结
关注 Feed 流的核心链路是:发布笔记后查询粉丝,将笔记 ID 和发布时间写入每个粉丝的 Redis ZSet;查询时按时间戳倒序读取,再用最小时间戳和重复时间戳数量完成滚动分页。
这个方案把"消息推送"和"稳定分页"拆成了两个明确问题:ZSet 负责收件箱排序,滚动分页负责应对新内容持续插入。理解这两个边界,就能在朋友圈、订阅列表、消息流等类似场景中复用同样的设计。