llumina Connected Multiomics最新版本发布:拓展多组学发现与研究证据挖掘能力
Illumina Connected Multiomics v1.3版本新增功能助力科研团队,在更加一体化的发现工作流中完成配对多组学分析、Correlation Engine证据挖掘、私有分子特征留存,以及受管控的研究项目访问权限管理。
#MOFA #SNF #亚型发现 #自然语言查询 #元分析 #相关性 #受控协作 #多组学整合分析 #分子特征 #云平台
多组学研究能够揭示仅依靠单一数据类型难以检出的模式。但当研究者整合转录组、蛋白质组、甲基化组及其他分子层面数据时,解析工作往往会被割裂在相互独立的分析工具、证据来源和研究记录中。
Illumina Connected Multiomics v1.3将更多研究工作流整合至同一环境,以此解决上述碎片化问题。研究者可挖掘整合后的分子模式,将分子特征与经过整理的Correlation Engine证据进行比对,保存私有结果供后续复用,并管理共享团队的研究项目访问权限,无需将上述各项操作作为独立步骤分别执行。
在多组学层面挖掘生物学模式
当分子差异分布于多个组学层面,而非集中于单一检测实验时,整合亚型发现可发挥最大效用。仅在RNA数据中区分度较弱的亚型,在联合分析基因组、转录组、蛋白质组、甲基化组模式时会变得更加显著。
Illumina Connected Multiomics现已支持通过Multi‑Omics Factor Analysis (MOFA)与Similarity Network Fusion (SNF)实现整合亚型发现,允许研究者在同一研究内对配对组学数据层开展联合分析。将基因组、转录组、蛋白质组、甲基化组数据联合查看时,研究团队可探究在单一组学层面表现微弱的模式,在配对多组学图谱中是否具备更高参考价值;例如蛋白质组模式能否优化基于甲基化的样本分组,或是揭示跨多个分子层的潜在关联。
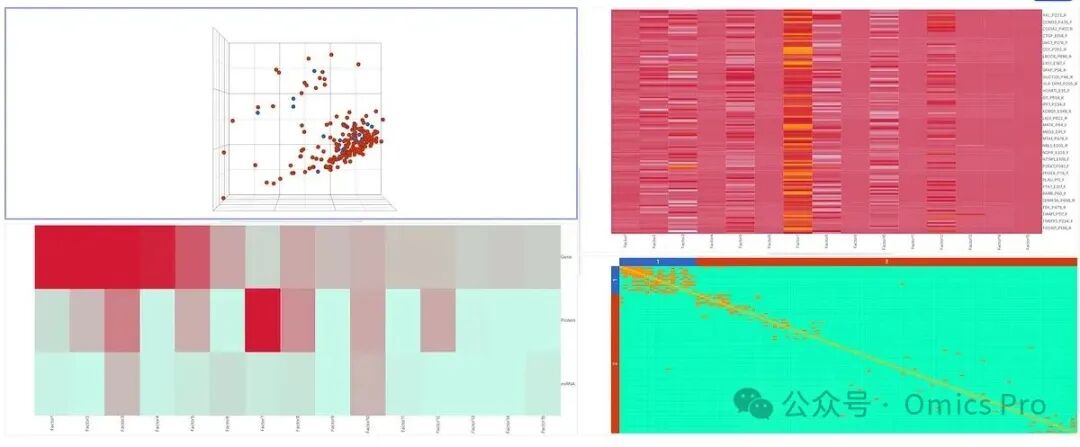
MOFA可整合同一研究中的2项或更多组学检测数据,识别能够解释共有变异与检测实验特有变异的潜在因子。(上排第1列)3维散点图坐标轴展示样本‑因子矩阵的前3个潜在因子;(上排第2列)每项检测均包含特征权重,可用于识别驱动因子变异的特征,结果以热图呈现;(下排第1列)热图展示各因子在每项检测中解释的方差占比;(下排右侧)SNF将多项检测得到的样本相似性网络融合为统一网络,图中为样本‑样本相似性矩阵热图。
使用自然语言将分子特征与Correlation Engine证据比对
得到分子特征仅是研究的开端。在确定进一步探究哪些结果前,研究者通常需要确认同类模式是否已在其他研究、生物学场景、扰动实验或疾病模型中被报道。
依托增强的Correlation Engine集成能力,研究者可通过2种互补途径挖掘外部证据。在v1.2版本引入的图谱分析任务基础上,v1.3新增自然语言查询、元分析、数据集‑数据集相关性任务,拓展相关生物学场景、数据集、分子特征及经过整理的Correlation Engine证据的检索方式。研究者可将自身分子特征与经过整理的Correlation Engine证据比对,并基于比对结果指导结果解析或后续分析。
为核心实验室、CRO及共享研究团队提供受控协作能力
现代多组学项目常涉及多名研究者、多个团队与服务机构协同开展相关研究。但宽泛的工作组访问权限或研究副本重复创建,会提升研究项目参与人员管理、监督及工作连续性维护的难度。
该版本新增受控的研究项目级访问控制,拓展协作能力。大型核心实验室、CRO与共享研究团队可在同一工作组内开展工作,同时借助研究项目隔离机制管控特定研究的参与人员。承接多项科研项目的服务实验室可在同一操作环境下工作,同时对研究参与权限设置更清晰的边界。
该版本实现的能力
对于开展大规模多组学项目的科研团队,v1.3版本的价值并不局限于某一项分析步骤。该版本打通亚型发现、证据挖掘、机构知识复用与受控协作环节,使研究结果能够更顺畅地从初步分析过渡到广度解析。
团队无需将特征比对、证据检索、研究访问管理与历史结果处理作为独立任务,可在统一环境下完成上述工作,让多组学研究具备更强的连通性、可复用性与协作能力。
仅用于研究用途,不可用于诊断流程。M‑GL‑04761
详细总结
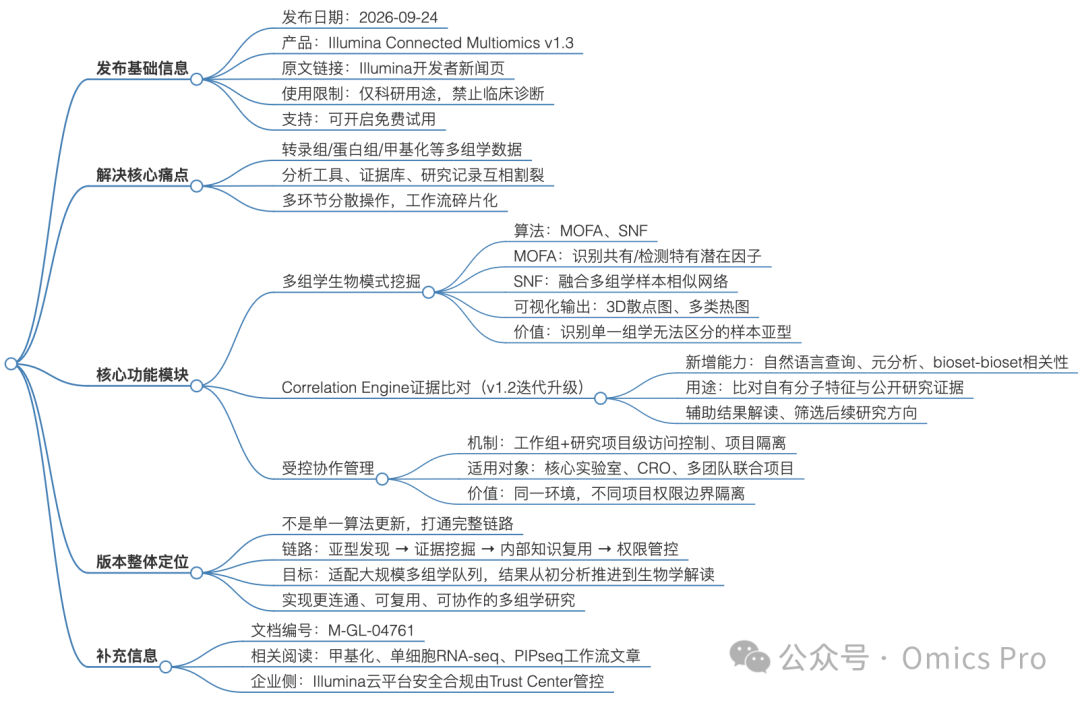
思维导图
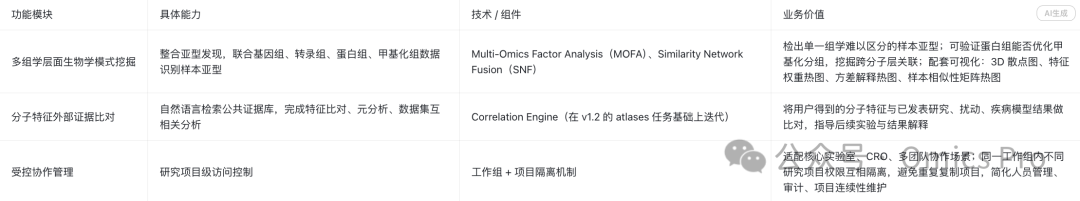
核心新增功能总览
参考
Latest Release of Illumina Connected Multiomics Expands Multiomic Discovery and Research Evidence Exploration
注:AI辅助创作,如有不当欢迎指出。内容仅供参考,不构成任何建议。