为什么分词值得单独拿出来讲
很多人调模型时把注意力都放在网络结构、学习率、数据量上,分词往往被当成一个"跑通就行"的预处理步骤。但实际做下来会发现,分词方案选错了,后面很多问题都会跟着来:中文被切成单字导致序列过长、英文专有名词被拆得七零八落、词表膨胀到几万维、推理时遇到没见过的词直接变成 [UNK]。
Transformer本身不处理字符串,它只认整数ID。分词器就是字符串和整数ID之间的翻译层。这一层的设计直接影响了:
- 序列长度(影响显存和推理速度)
- 词表大小(影响embedding参数量)
- OOV概率(影响模型对生僻词、新词的处理能力)
- 多语言支持(影响跨语言迁移效果)
目前主流大模型用的分词方案基本集中在三类:BPE、WordPiece、SentencePiece。它们不是互相独立的三套东西,SentencePiece更像是一个"封装框架",内部可以跑BPE或Unigram。下面我按实际使用顺序把它们拆开讲。
三种方案的核心差异
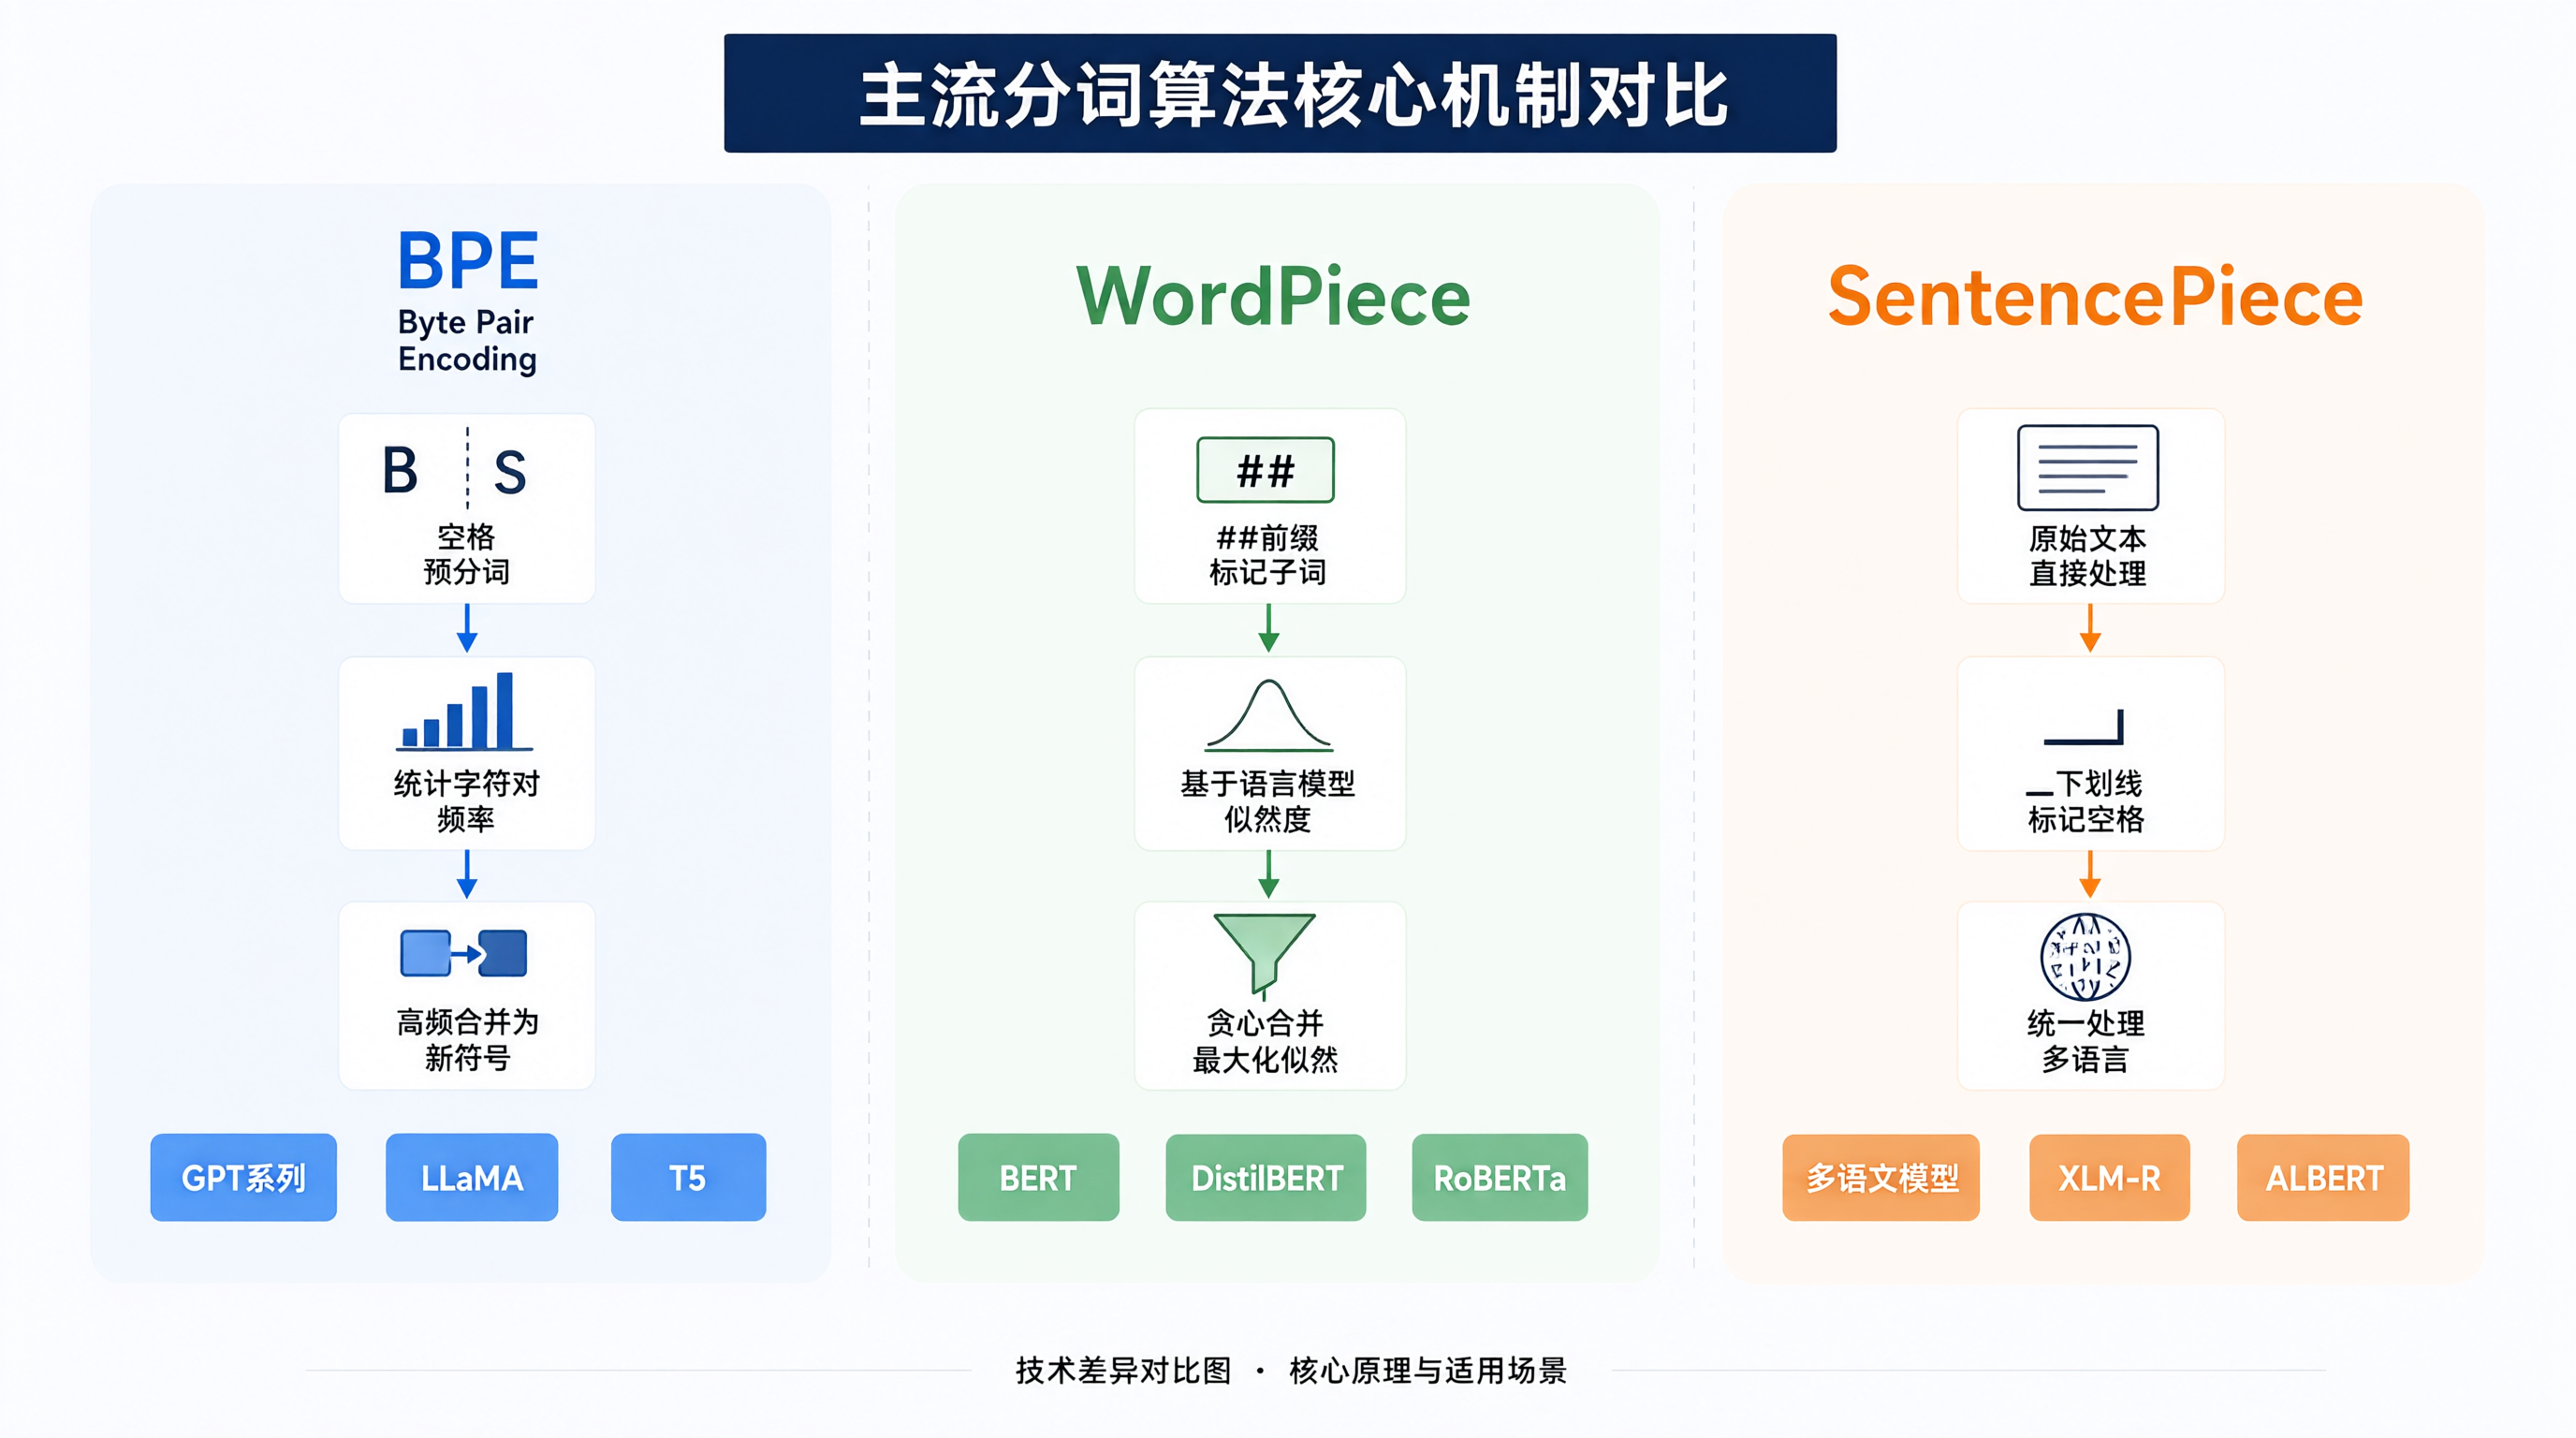
先给一个整体判断,后面再展开。
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| BPE | 实现简单,子词切分直观,对英文压缩率高 | 依赖预分词(空格切分),中文/日文等无空格语言效果打折 | GPT系列、英文为主的语料 |
| WordPiece | 对未登录词处理更细,配合##前缀可还原原词 |
训练用贪心合并,实现比BPE复杂;同样依赖预分词 | BERT系列、多语言BERT |
| SentencePiece | 不依赖预分词,直接吃原始文本,天然支持中英日韩 | 词表可读性差(带▁符号),需要额外解码步骤 |
T5、ALBERT、LLaMA、多语言模型 |
BPE:从字符开始,反复合并最高频的pair
BPE(Byte Pair Encoding)最早是数据压缩算法,2016年被Sennrich等人引入NMT。核心流程只有两步:
- 把每个词拆成字符序列,词尾加
</w>标记 - 统计所有相邻字符对的频率,把频率最高的一对合并成一个新符号,重复直到达到目标词表大小
用一个小例子就能看清。假设语料只有这几个词(带频次):
low: 5
lower: 2
newest: 6
widest: 3
初始拆成字符:
l o w </w>
l o w e r </w>
n e w e s t </w>
w i d e s t </w>统计相邻pair,e s出现频率最高(6+3=9),先合并成es。下一轮再统计,依此类推。最终得到类似low、lower、newest、widest这样的合并结果。
关键点:BPE的合并是无条件的,只看频率,不看语义。所以它可能把跨词素的字符合并到一起,这在英文里问题不大,在中文里就比较尴尬------因为中文没有空格,预分词这一步就得先做,而中文预分词本身又是一个有争议的问题。
WordPiece:用似然而不是频率来决定合并
WordPiece是BERT用的方案。整体思路和BPE接近,也是从字符开始合并,但选择pair的标准不同:
- BPE:选频率最高的pair
- WordPiece:选能让语料似然提升最大的pair
具体来说,WordPiece计算的是score = freq(pair) / (freq(left) * freq(right)),倾向于合并那些"单独出现少、一起出现多"的组合。这个设计让WordPiece更倾向于合并有实际搭配意义的子词,而不是单纯高频的字符组合。
另一个区别是WordPiece用##前缀标记"这是词的中间部分"。比如playing可能被切成play + ##ing。解码时把##去掉再拼回去,就能还原原词。
WordPiece的公开实现不多,Google的原始代码是TensorFlow的,HuggingFace的tokenizers库里有Python实现,实际用的时候直接调就行。
SentencePiece:把预分词也干掉了
前面两种方案都有一个隐含前提:文本能用空格预分词。英文可以,中文、日文、泰文就不行。SentencePiece的核心创新就是把输入当成原始字节流或Unicode字符流,不做任何预分词。
它把空格也当成一个普通字符,用▁(U+2581)表示。比如Hello world在SentencePiece内部是▁Hello▁world,解码时把▁换成空格即可。这样中英文混合、代码、URL都能统一处理,不需要为每种语言写不同的预分词规则。
SentencePiece支持两种子词算法:
--model_type=bpe:内部跑BPE--model_type=unigram:用Unigram语言模型,从大词表开始逐步裁剪
T5、ALBERT、LLaMA用的是unigram或bpe变体。实际选哪个,一般看训练语料规模和语言分布。语料大、语言多的时候unigram更稳,英文为主的时候bpe也够用。
用Python手写一个最小BPE
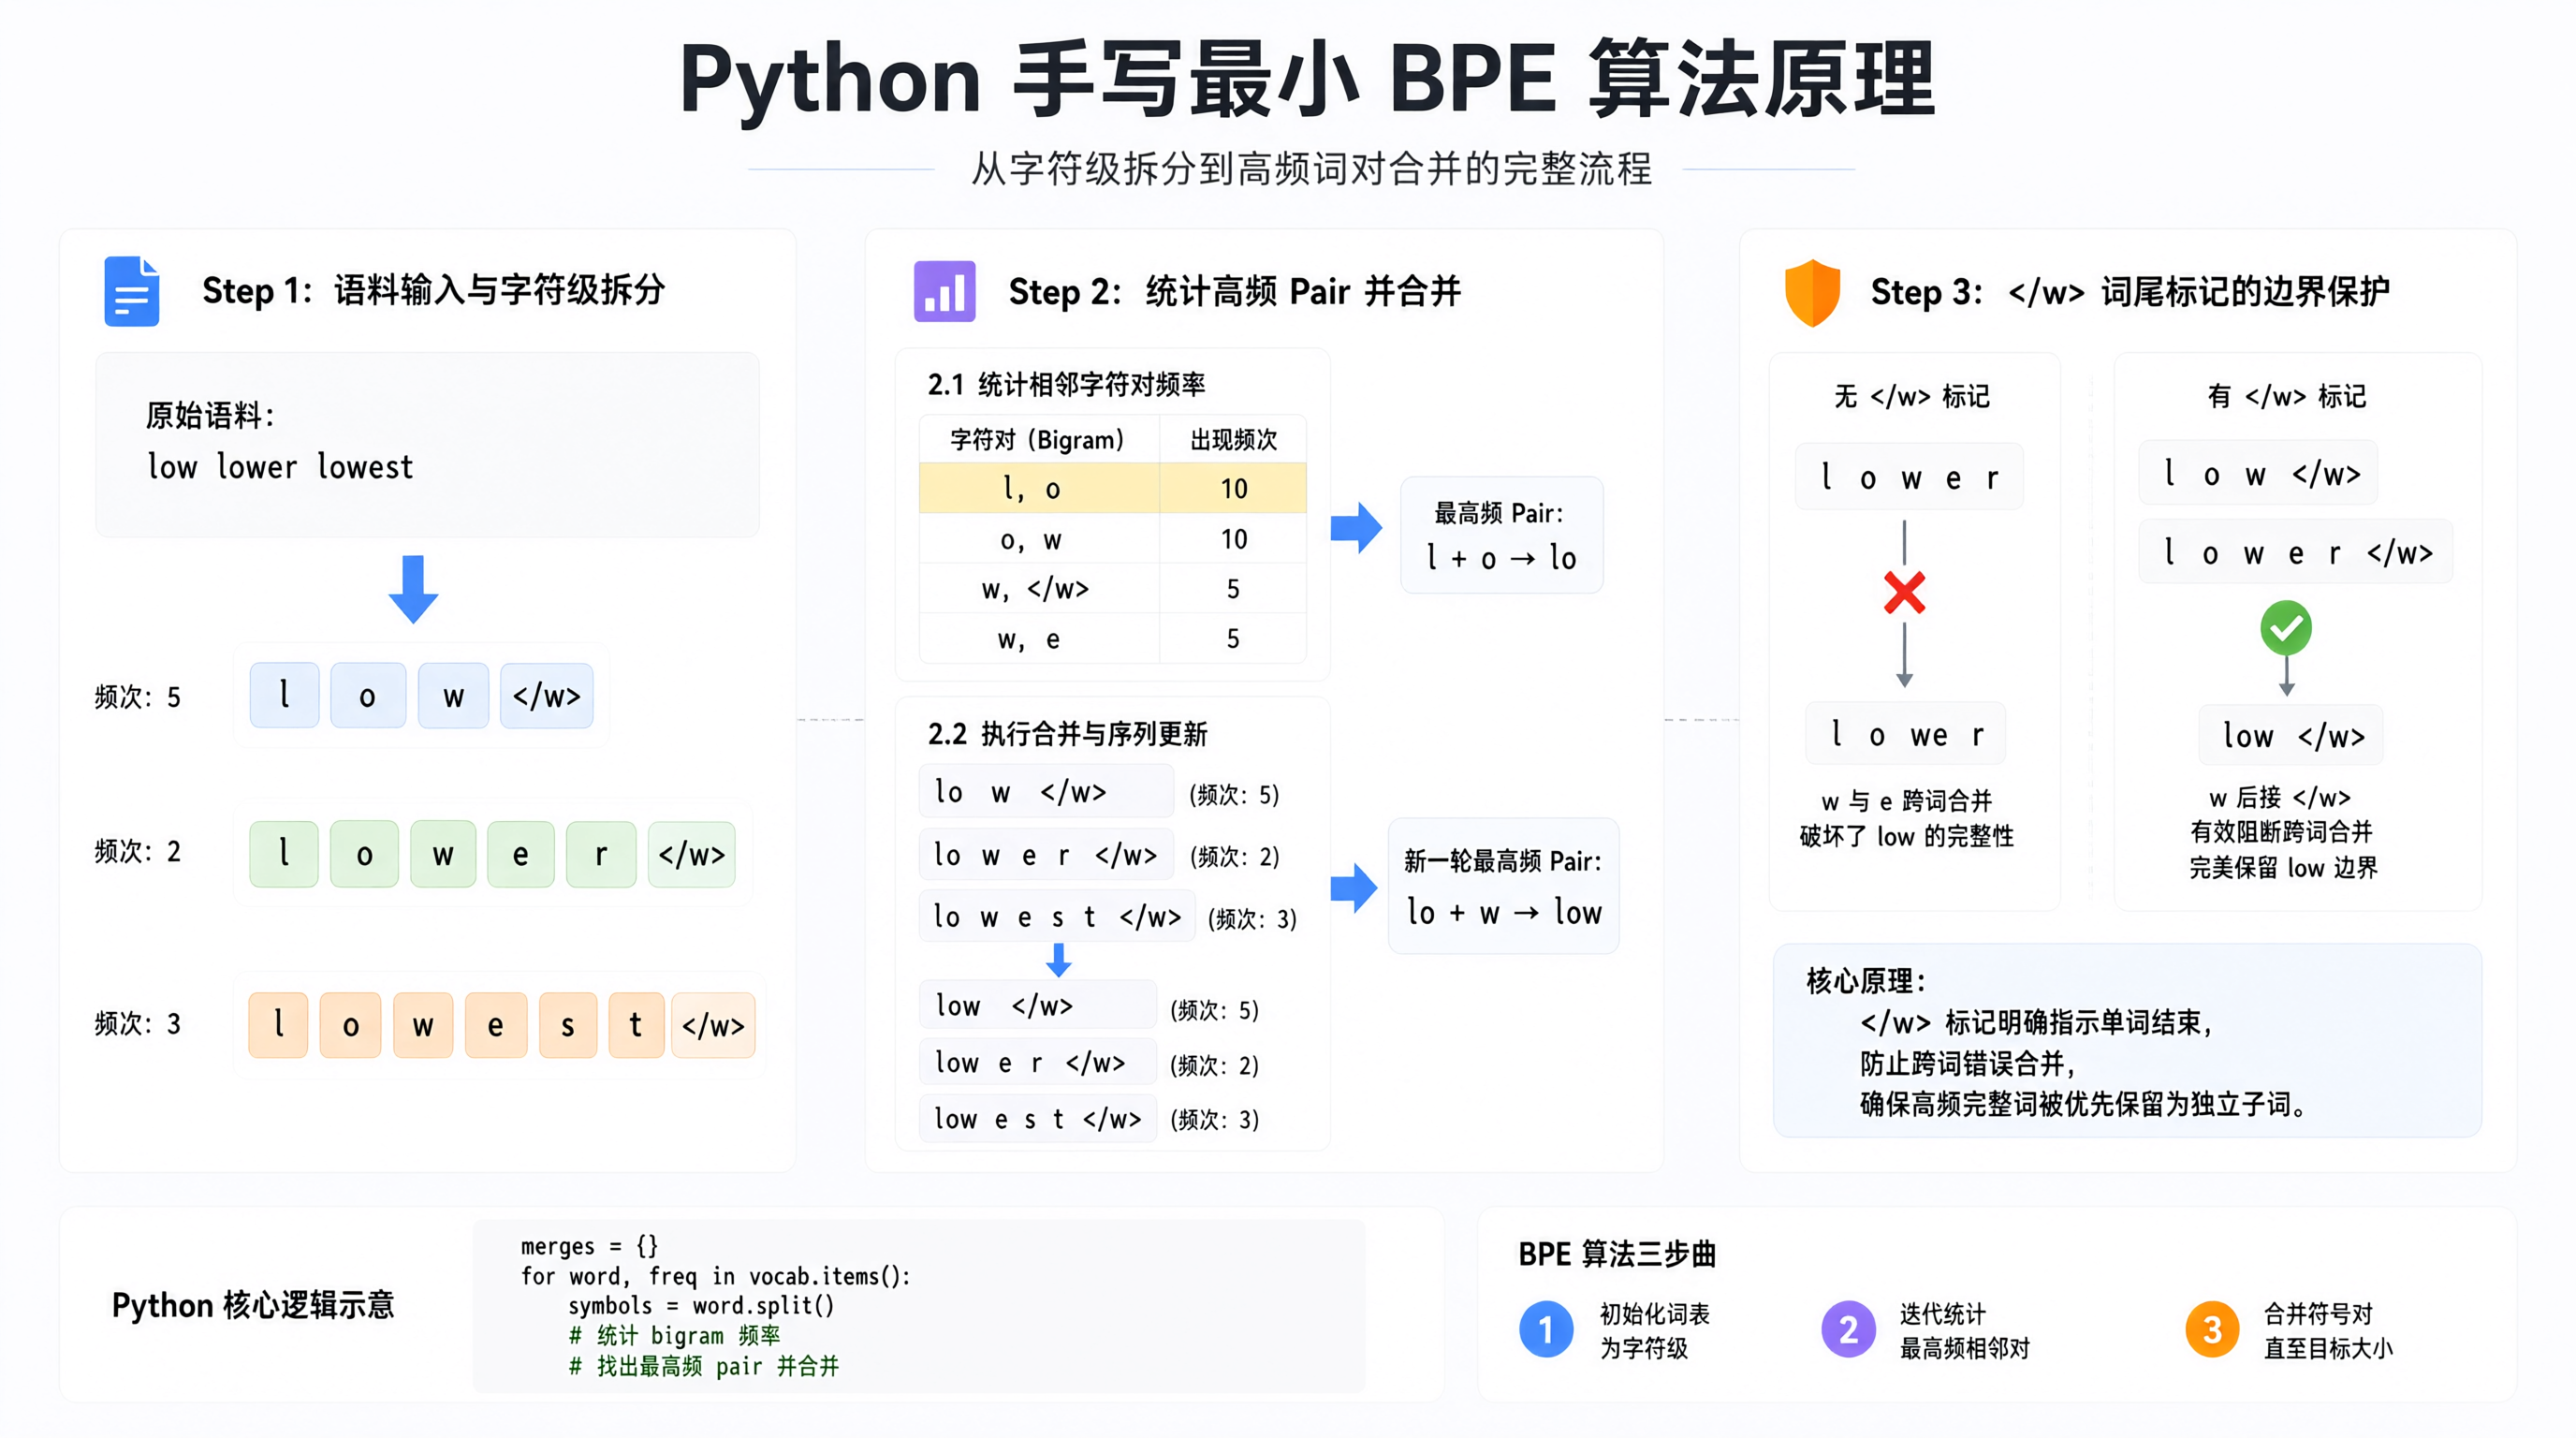
理论讲完,手写一遍最清楚。下面这个实现只处理英文,目的是把合并逻辑跑通,不追求性能。
python
# Python 3.10
from collections import Counter

def get_stats(vocab):
    """统计所有相邻符号对的频率"""
    pairs = Counter()
    for word, freq in vocab.items():
        symbols = word.split()
        for i in range(len(symbols) - 1):
            pairs[(symbols[i], symbols[i + 1])] += freq
    return pairs

def merge_vocab(pair, vocab):
    """把指定pair合并成一个新符号"""
    new_vocab = {}
    bigram = " ".join(pair)
    replacement = "".join(pair)
    for word, freq in vocab.items():
        new_word = word.replace(bigram, replacement)
        new_vocab[new_word] = freq
    return new_vocab

# 初始语料,词尾加 </w> 标记
raw = {
    "l o w </w>": 5,
    "l o w e r </w>": 2,
    "n e w e s t </w>": 6,
    "w i d e s t </w>": 3,
}

vocab = raw
num_merges = 10

for i in range(num_merges):
    pairs = get_stats(vocab)
    if not pairs:
        break
    best = max(pairs, key=pairs.get)
    vocab = merge_vocab(best, vocab)
    print(f"merge {i+1}: {best} -> {''.join(best)}")
    print(f"  vocab: {list(vocab.keys())}")
跑出来大致是这样(不同实现细节会有差异,但合并顺序一致):
merge 1: ('e', 's') -> es
merge 2: ('es', 't') -> est
merge 3: ('est', '</w>') -> est</w>
merge 4: ('l', 'o') -> lo
merge 5: ('lo', 'w') -> low
...
这段代码解释几个容易忽略的点:
word.split()依赖初始语料里字符之间用空格分开,这是BPE实现的标准做法</w>标记词尾很重要,否则low和lower里的low会被当成同一个符号,丢失边界信息- 合并是顺序敏感的,先合并的pair会影响后续统计,这也是BPE对语料顺序敏感的原因
【踩坑提醒】实际训练时,num_merges不是拍脑袋定的。它直接决定词表大小:初始字符集大小 + num_merges = 最终词表大小。词表太小会导致序列过长,太大则embedding参数浪费。GPT-2的词表是50257,LLaMA是32000,都是根据语料规模调出来的。
SentencePiece实战:训练一个中英混合分词器
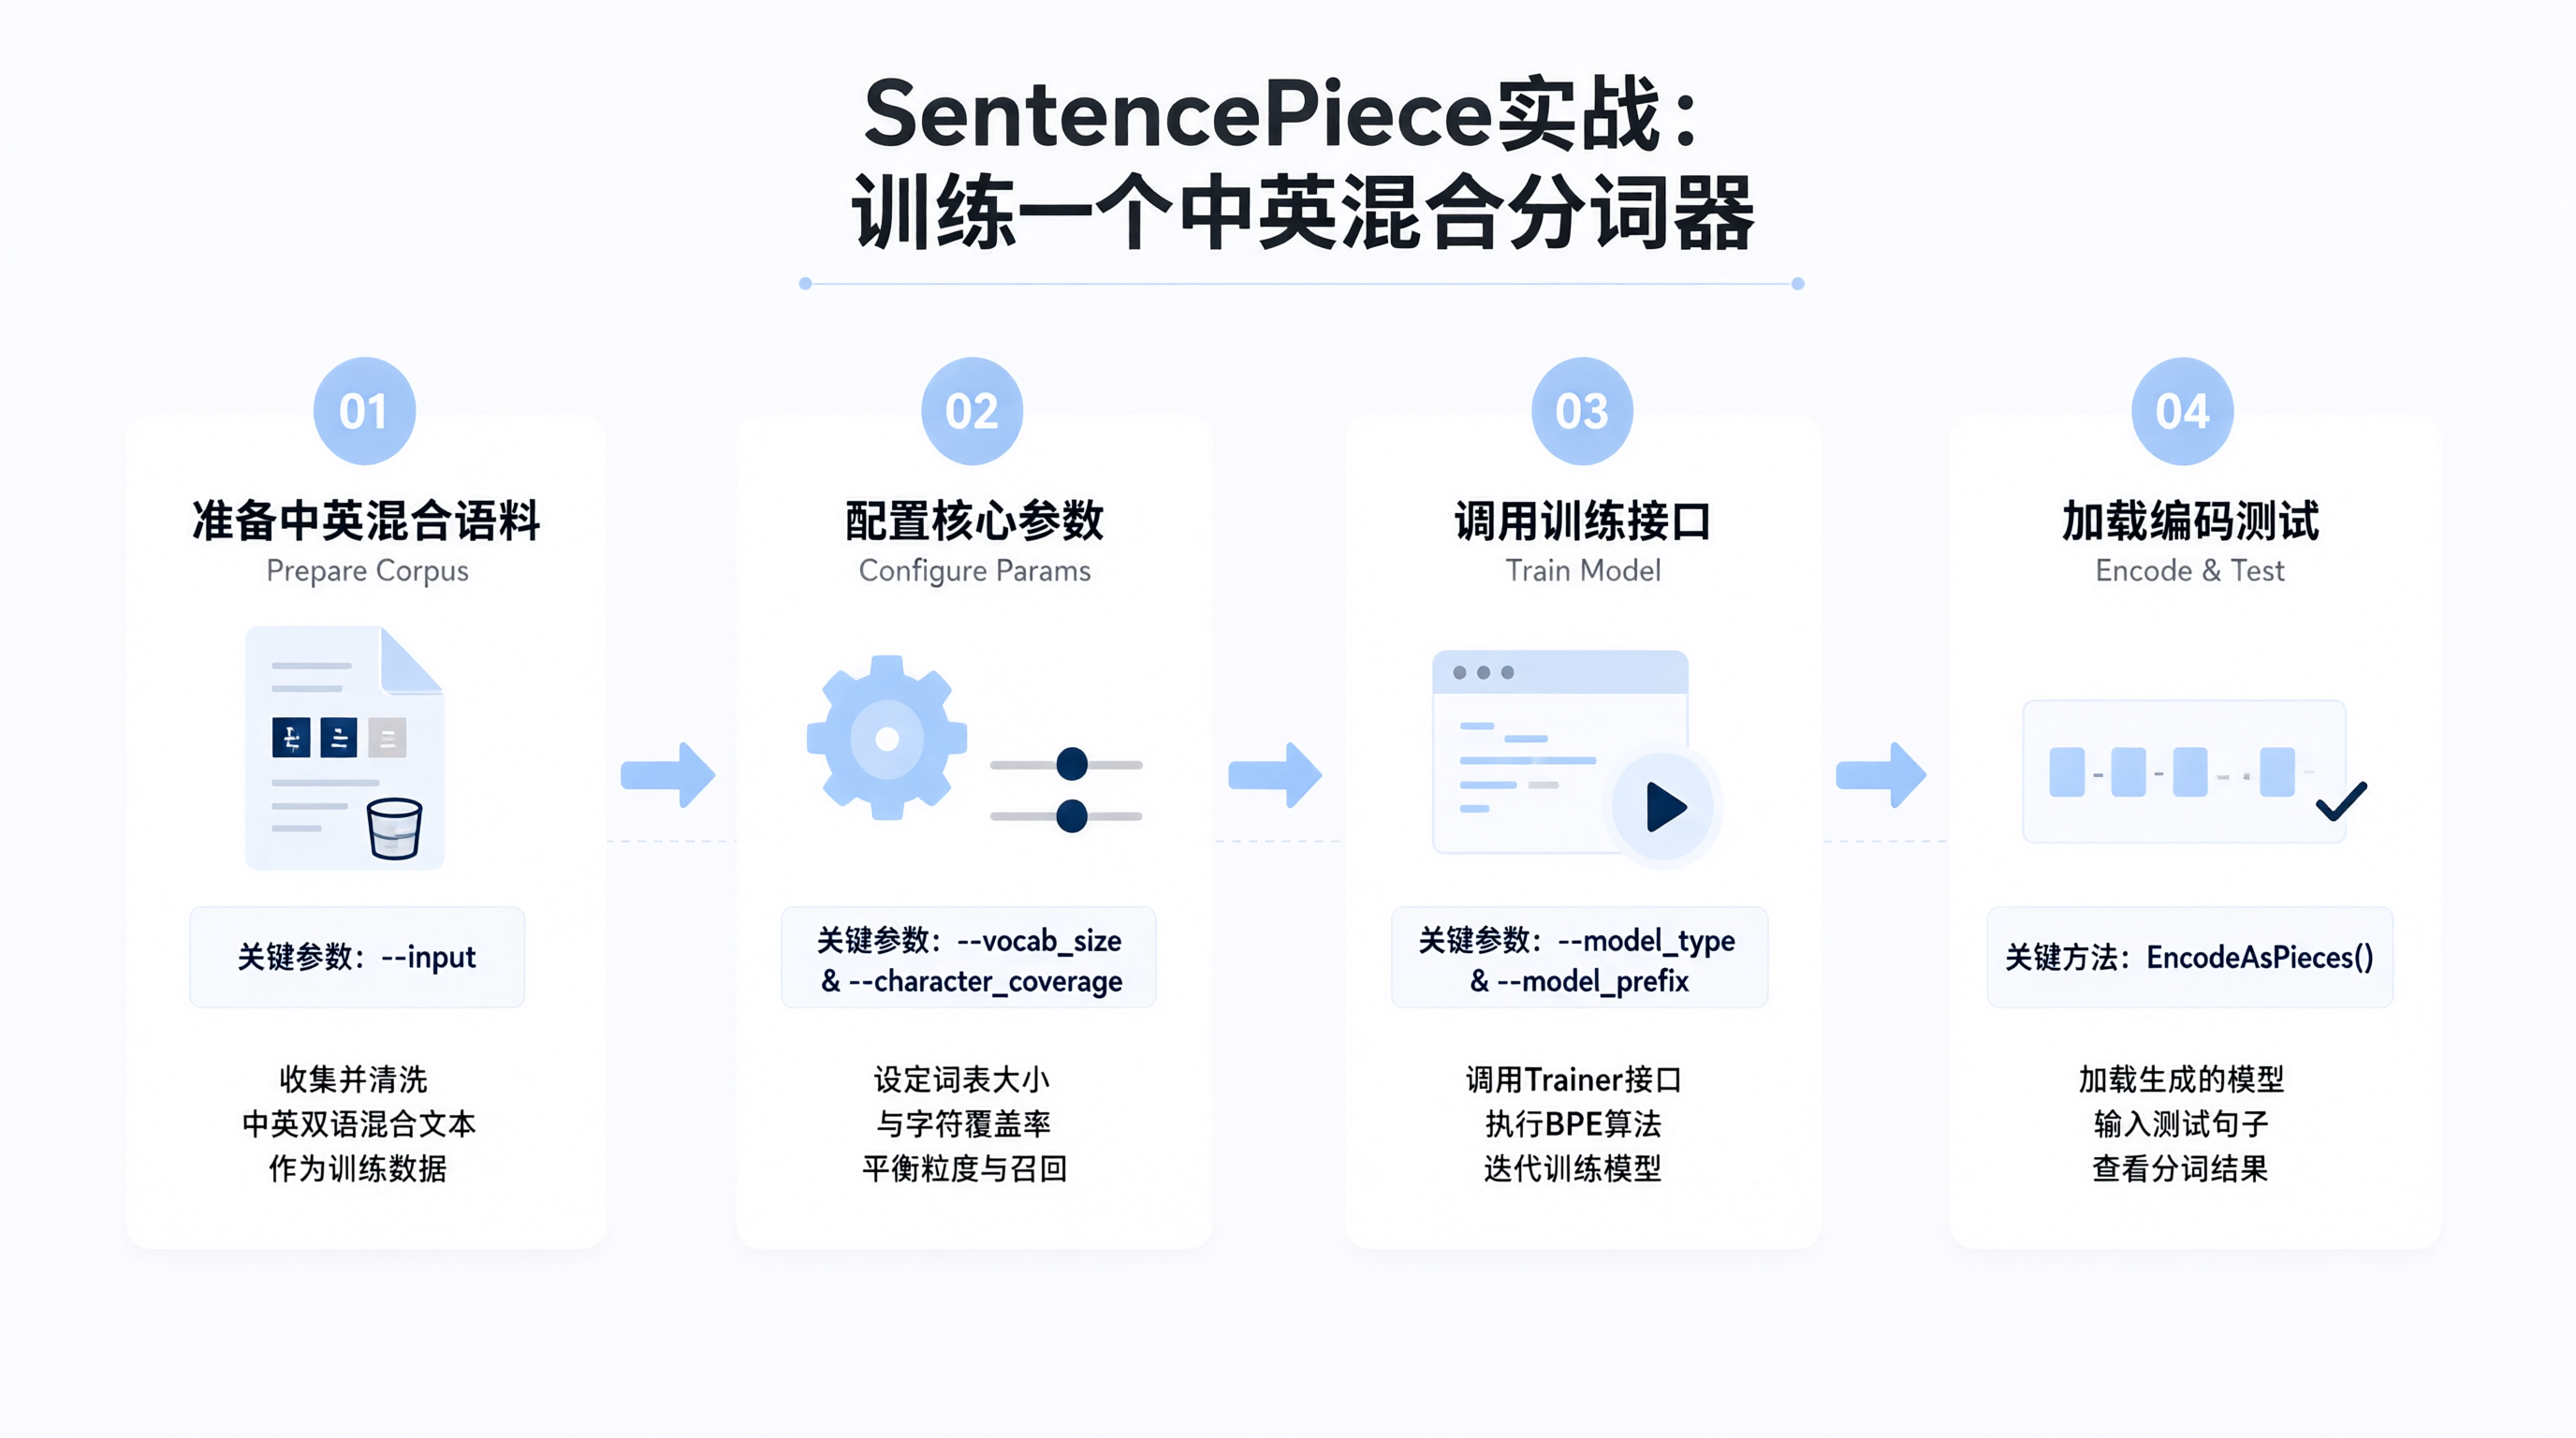
手写BPE只是理解原理,真正做项目还是用SentencePiece。它的Python包叫sentencepiece,安装:
bash
pip install sentencepiece==0.2.0训练一个中英混合分词器的完整流程:
python
# Python 3.10, sentencepiece 0.2.0
import sentencepiece as spm

# 1. 准备训练语料,每行一句
corpus = [
    "自然语言处理是人工智能的重要方向",
    "Transformer改变了NLP的格局",
    "Tokenization is the first step of NLP pipeline",
    "BPE and WordPiece are two popular subword algorithms",
    "大模型的上下文长度越来越长",
    "SentencePiece supports Chinese and English without pre-tokenization",
]

with open("corpus.txt", "w", encoding="utf-8") as f:
    for line in corpus:
        f.write(line + "\n")

# 2. 训练分词器
spm.SentencePieceTrainer.train(
    input="corpus.txt",
    model_prefix="sp_mix",
    vocab_size=200,
    model_type="unigram",      # 也可以选 "bpe"
    character_coverage=1.0,    # 覆盖所有字符,中文字符多建议设 0.9995~1.0
    num_threads=4,
)

# 3. 加载并测试
sp = spm.SentencePieceProcessor()
sp.load("sp_mix.model")

texts = [
    "自然语言处理",
    "Tokenization",
    "Transformer模型",
]

for t in texts:
    pieces = sp.encode(t, out_type=str)
    ids = sp.encode(t, out_type=int)
    print(f"{t!r} -> {pieces}")
    print(f"  ids: {ids}")
print(f" 解码还原: {sp.decode(ids)!r}")character_coverage这个参数容易被忽略。它表示词表要覆盖语料中多少比例的字符,默认0.9995。对于中文这种字符种类多的语言,设低了会把生僻字直接映射成<unk>,设高了词表会被低频字符占满。做中英混合时我一般设1.0,代价是词表稍微大一点。
【注意】vocab_size不能设得比语料里不同字符数还小,否则训练会报错。上面这个玩具语料字符种类少,200够用;真实项目里中英混合语料通常要32000以上。
同一批文本,三种方案的实际差异
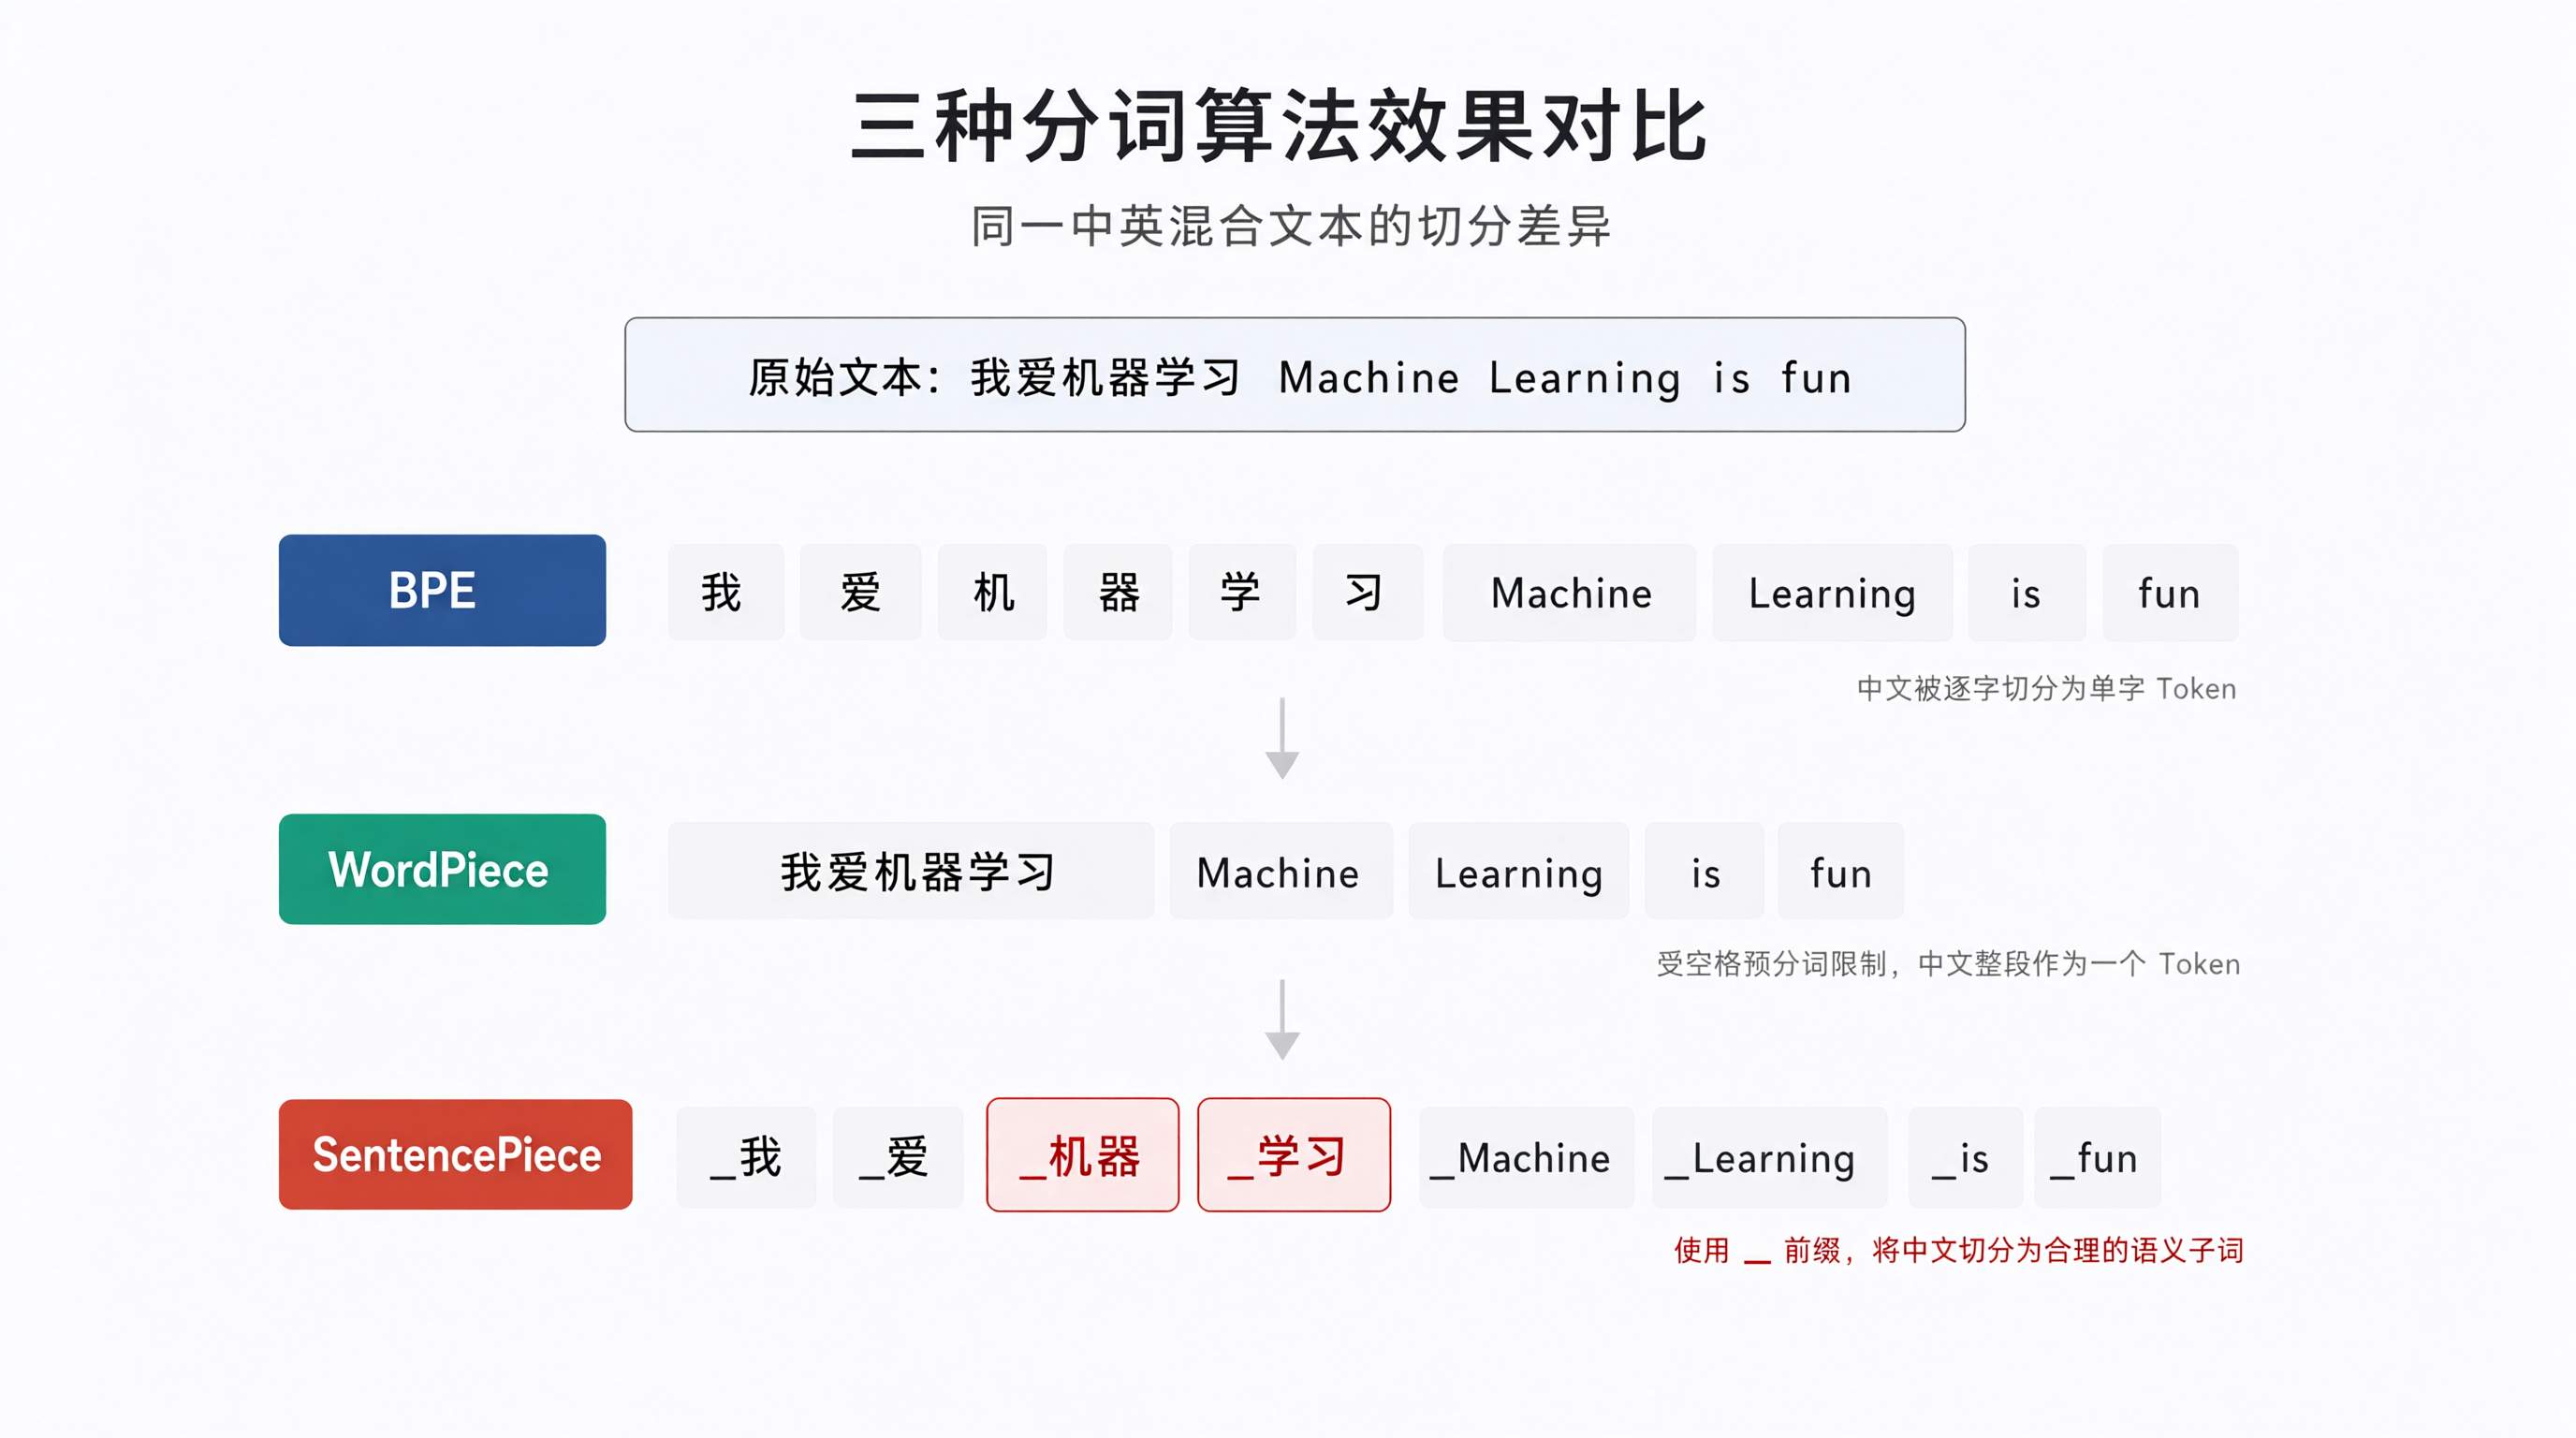
光讲原理不够,用同一批文本跑一遍更直观。下面用HuggingFace的tokenizers库对比BPE和WordPiece,SentencePiece用上面的结果。
先装依赖:
bash
pip install tokenizers==0.20.0 transformers==4.45.0对比代码:
python
# Python 3.10
from tokenizers import Tokenizer
from tokenizers.models import BPE, WordPiece
from tokenizers.trainers import BpeTrainer, WordPieceTrainer
from tokenizers.pre_tokenizers import Whitespace

corpus_file = "corpus.txt"

# BPE
bpe_tok = Tokenizer(BPE(unk_token="[UNK]"))
bpe_tok.pre_tokenizer = Whitespace()
bpe_trainer = BpeTrainer(vocab_size=200, special_tokens=["[UNK]", "[PAD]"])
bpe_tok.train([corpus_file], bpe_trainer)

# WordPiece
wp_tok = Tokenizer(WordPiece(unk_token="[UNK]"))
wp_tok.pre_tokenizer = Whitespace()
wp_trainer = WordPieceTrainer(vocab_size=200, special_tokens=["[UNK]", "[PAD]"])
wp_tok.train([corpus_file], wp_trainer)

test = "Tokenization自然语言处理"
print("BPE:      ", bpe_tok.encode(test).tokens)
print("WordPiece:", wp_tok.encode(test).tokens)
跑出来的结果会因语料和随机种子略有不同,但规律是稳定的:
- 英文部分:BPE和WordPiece都能把
Tokenization切成Token+ization这类子词,压缩效果接近 - 中文部分:因为用了
Whitespace预分词,整段中文被当成一个"词",BPE和WordPiece只能从字符开始合并,效果明显不如SentencePiece - SentencePiece:中文能切成
自然+语言+处理这样的语义单元,序列长度更短
这也是为什么做中文模型时,直接用BERT的WordPiece分词器(基于字)虽然能用,但序列长度会比SentencePiece方案长不少。
选型时真正要看的几个指标
不看广告看疗效,实际选型时我会看这几个数:
- 平均序列长度:同一批文本,不同分词器切出来的token数。直接影响显存和推理成本
- OOV率 :在测试集上出现
[UNK]的比例。WordPiece和BPE的OOV率取决于词表大小,SentencePiece理论上可以做到0(因为能拆到字符) - 词表利用率:词表里有多少token在测试集上真正被用到。太低说明词表浪费
- 解码可逆性 :
decode(encode(text))能不能还原原文本。SentencePiece因为带▁,需要正确处理空格
用一段代码可以快速统计前两个:
python
def avg_len_and_oov(tokenizer, texts, unk_id):
    total_len = 0
    total_unk = 0
    total_tokens = 0
    for t in texts:
        ids = tokenizer.encode(t).ids
        total_len += len(ids)
        total_unk += ids.count(unk_id)
        total_tokens += len(ids)
    return total_len / len(texts), total_unk / total_tokens

# 假设 texts 是测试集,unk_id 是 [UNK] 对应的id
print(avg_len_and_oov(bpe_tok, texts, bpe_tok.token_to_id("[UNK]")))
这里的判断标准因任务而异。做生成任务时序列长度更敏感,做分类任务时OOV率更关键。
几个容易踩的坑
预分词和训练分词器不一致 。训练时用了Whitespace,推理时忘了设,结果切分方式对不上。这类问题不会报错,但效果会悄悄变差。
SentencePiece的▁符号 。很多人第一次看到▁自然会以为模型出问题了,其实这是正常表示。解码时用sp.decode(ids)会自动处理,但如果你手动拼token,记得把▁换成空格。
中文character_coverage设太低。默认0.9995对英文够用,中文语料里生僻字多,设低了会丢字。做中文任务建议设1.0,代价是词表稍微大一点。
BPE的</w>和WordPiece的##不能混用。两套分词器训练出来的模型不能直接交换词表,embedding对不上。
词表大小和模型维度要匹配。词表32000配hidden_size 768是BERT-base的配置,如果词表翻倍到64000,embedding层参数会显著增加,小模型上可能不划算。
写在最后
分词这块没有"最好"的方案,只有"适合当前任务"的方案。英文为主、追求实现简单,BPE够用;要做多语言或者中文占比高,SentencePiece基本是默认选择;如果直接用BERT系列预训练模型,那WordPiece是绑定的,换不了。
真正值得花时间的是:拿到一个新语料时,先跑一遍不同分词器的平均序列长度和OOV率,用数据决定,而不是凭感觉选。这一步花不了多少时间,但能避免后面训练到一半发现序列太长、显存爆掉的尴尬。
如果要做更细的调优,可以研究SentencePiece的--split_by_whitespace、--byte_fallback这些参数,它们在处理代码、URL、emoji时影响不小。这部分我还没有系统验证过,等有实际项目数据再单独写一篇。