我曾经把右表的过滤条件写进 WHERE,一个 LEFT JOIN 在线上悄悄退化成 INNER JOIN,运营报表里「零订单用户」整列消失,整整三天都没人发现。
这篇用一套电商 users/orders 数据,把三种 JOIN 的结果差异、ON 与 WHERE 的区别、笛卡尔积坑逐个跑给你看,照着写就能避开。
一、场景:数据为什么非得拆成多张表
真实业务里,把用户、商品、订单全塞进一张大宽表,看似省事,代价是同一个用户下多次订单,姓名、手机号要重复存几十遍;改一次手机号,就得更新几十上百行,稍有遗漏就是数据不一致。
| 做法 | 数据存储 | 改一条信息 | 一致性风险 |
|---|---|---|---|
| 全塞一张大宽表 | 大量重复 | 要改很多行 | 高 |
| 一事一表 + 外键关联 | 每个主题只存一次 | 只改一行 | 低 |
数据库设计因此遵循「一事一表」,把不同主题拆开,用外键(Foreign Key)建立表与表的关联;查询时再按关联关系把多张表「拼」成一个结果集(Result Set)。
表拆开容易,拼的时候新问题随之而来:两张表里「对不上」的那些行,到底留还是不留?
二、踩坑:三个让结果集悄悄变样的写法
我在写多表查询时踩过的坑,SQL 都不会报错,出错的是结果行数。
| 现象 | 触发写法 | 后果 |
|---|---|---|
| 数据量瞬间爆炸 | FROM users, orders 漏写连接条件 |
退化成笛卡尔积,行数相乘 |
| 主体行莫名消失 | LEFT JOIN 后用 WHERE 过滤右表 | 退化成 INNER,NULL 行被滤掉 |
| 该保留的行被丢 | 没搞清谁是基准表,用错 JOIN | 左表或右表的行被误删 |
最隐蔽的是第二个。我当时盯着报表核了半天,SQL 没有语法错误,执行也正常返回,只是该出现的那批用户整列没了。
为什么一个关键字、一个条件位置的差别,结果行数能差这么多?得先回到 JOIN 的本质。
三、原理:连接只干两件事
连接(JOIN)的本质,是按匹配条件把两张表中满足条件的行组合成新行。它一共只做两件事,而三种 JOIN 的分水岭就在第二件。
latex
                  JOIN 连接做的两件事
+----------------------------------------------------+
| 1. 按匹配条件找行          ON u.id = o.user_id       |
| 2. 匹配不上的行怎么处理                              |
|       +--> 丢弃            -> INNER JOIN(内连接)     |
|       +--> 保左表补 NULL   -> LEFT JOIN(左外连接)    |
|       +--> 保右表补 NULL   -> RIGHT JOIN(右外连接)   |
+----------------------------------------------------+
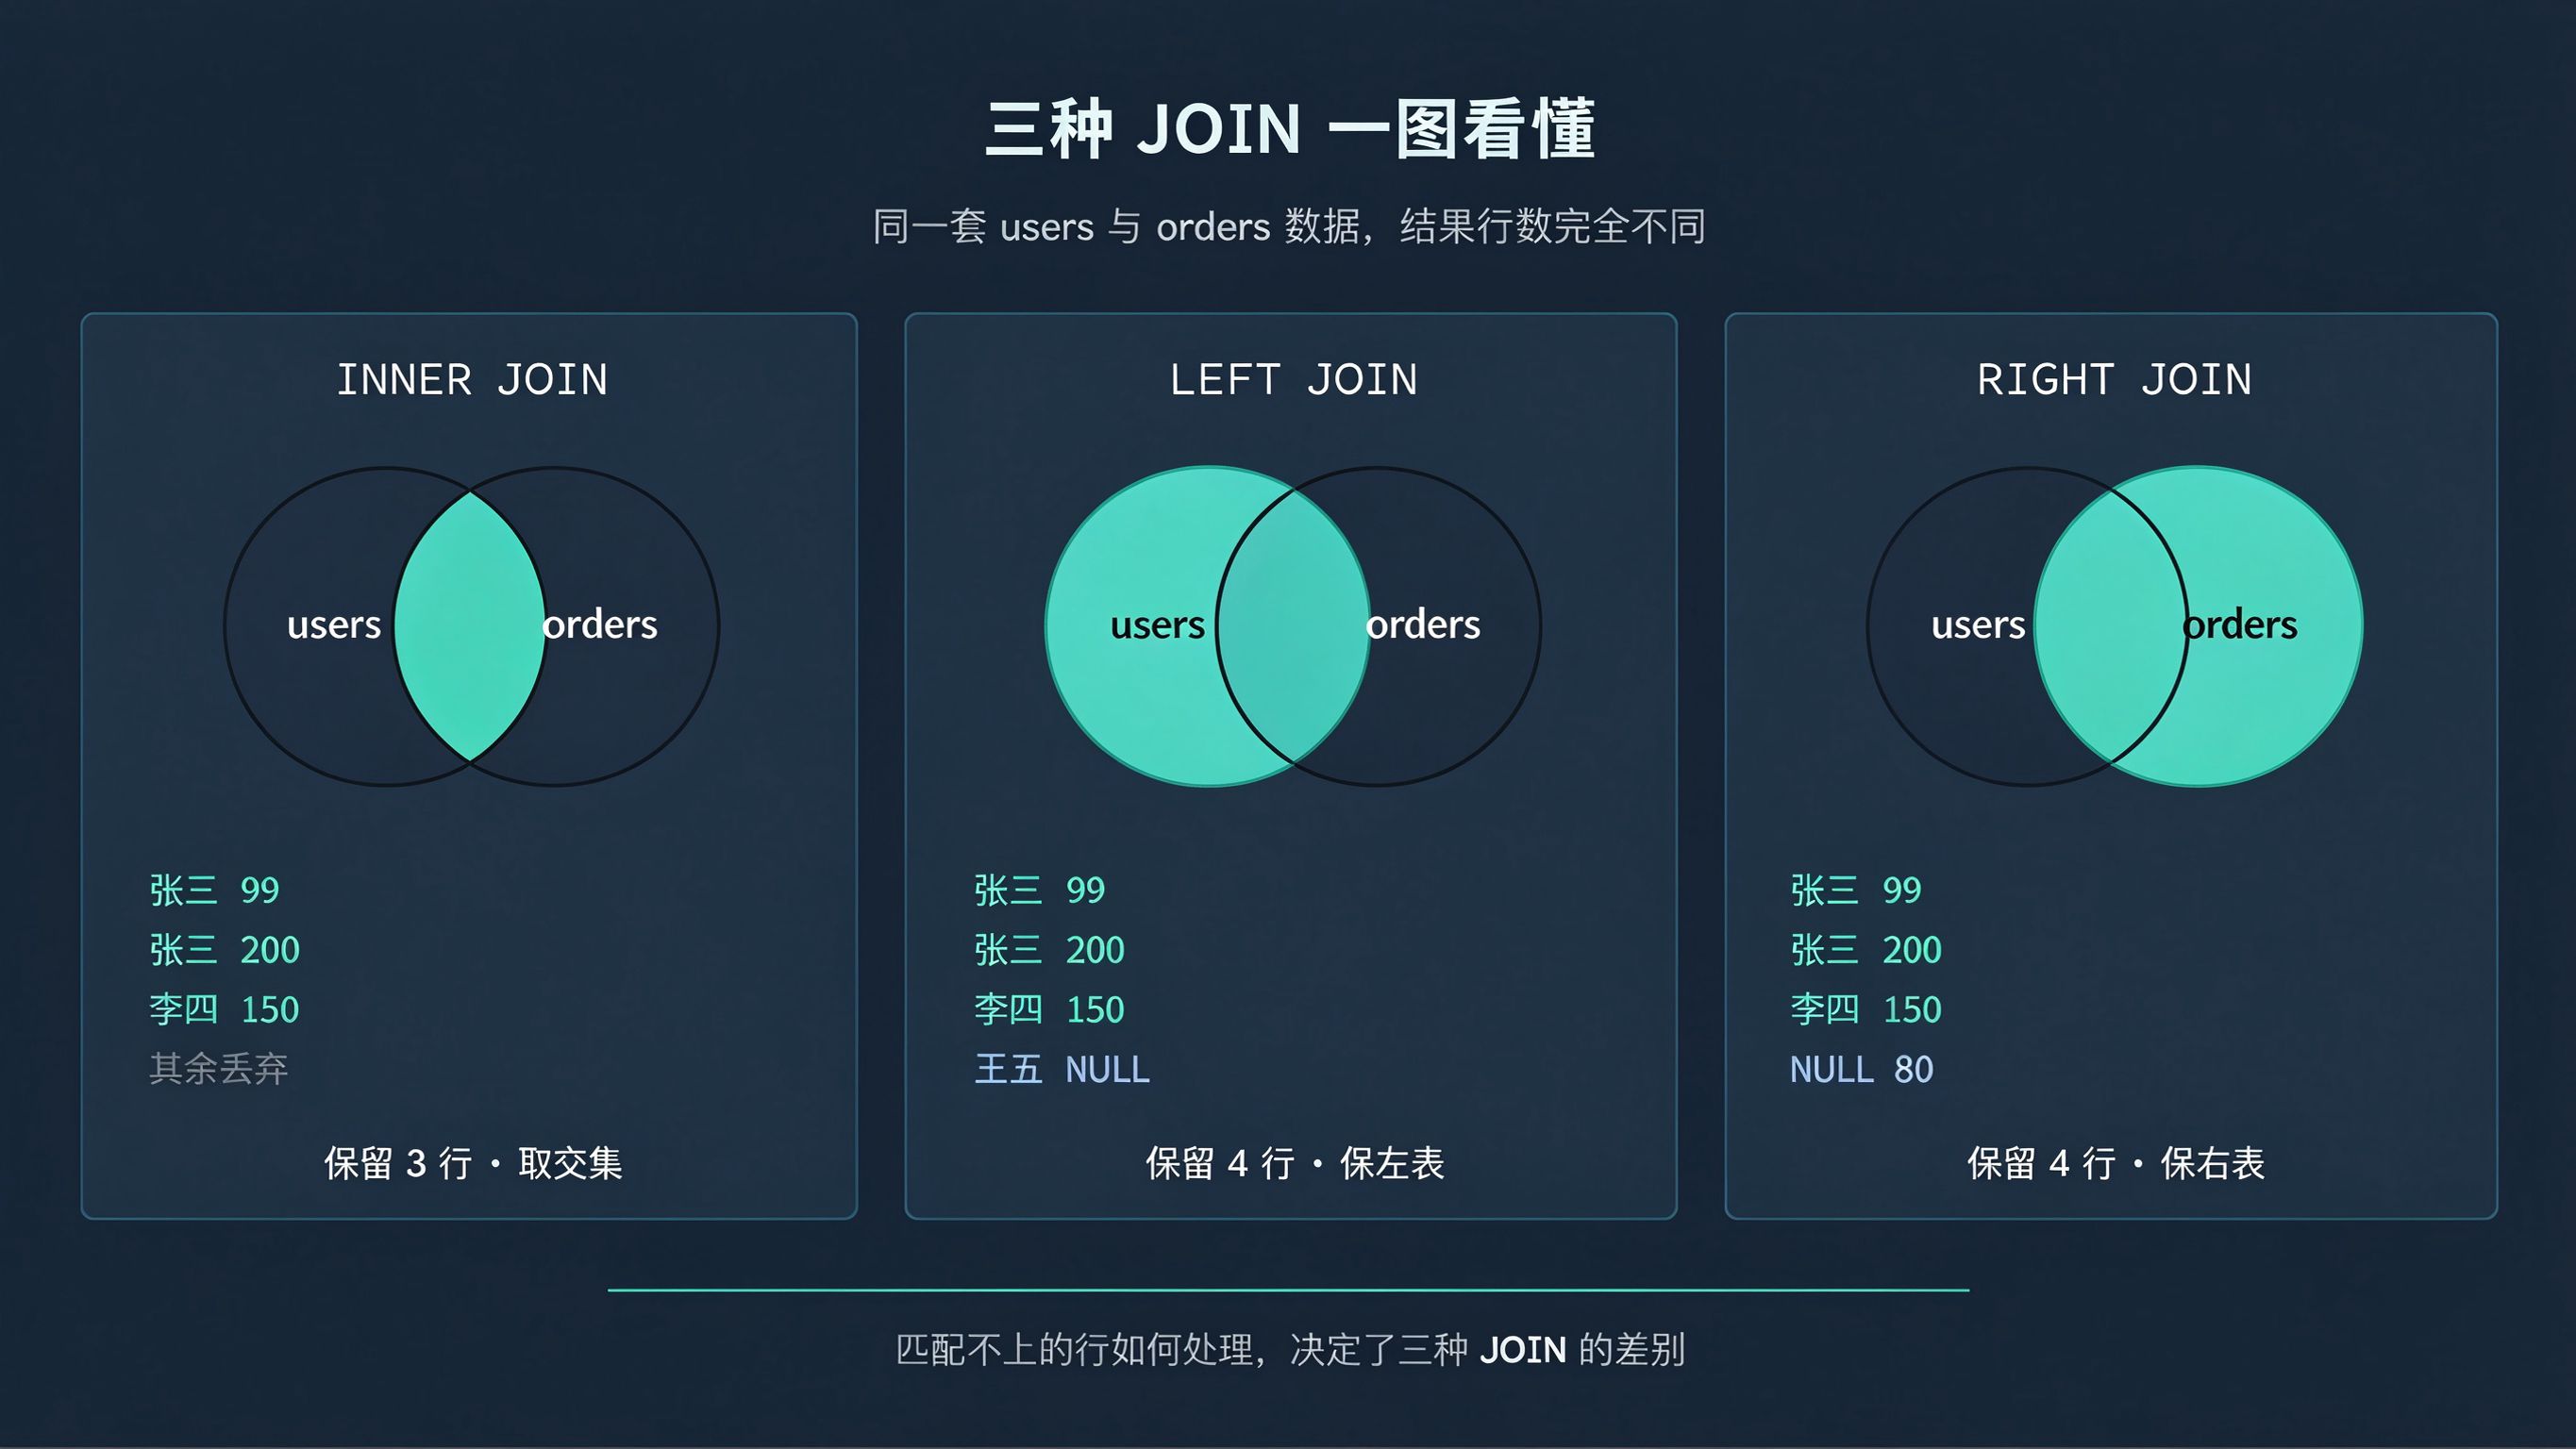
匹配条件决定「哪些行能对上」,第二件事决定「对不上的行留不留」:INNER 直接丢弃,LEFT 保左表,RIGHT 保右表。
注意:连接 = 匹配条件 + 匹配不上的行怎么处理,三种 JOIN 的差别只在第二步。
四、方案:三种 JOIN 各自保留谁
先把同一套测试数据建出来,后面所有结果都基于它,你可以直接复制执行。
sql
DROP TABLE IF EXISTS orders;
DROP TABLE IF EXISTS users;

CREATE TABLE users (
  id   INT PRIMARY KEY,
  name VARCHAR(20)
);

CREATE TABLE orders (
  id      INT PRIMARY KEY,
  user_id INT,
  amount  INT
);

INSERT INTO users (id, name) VALUES
  (1, '张三'),
  (2, '李四'),
  (3, '王五');

INSERT INTO orders (id, user_id, amount) VALUES
  (101, 1, 99),
  (102, 1, 200),
  (103, 2, 150),
  (104, 9, 80);
4.1 INNER JOIN:取交集,两边都对得上才留
sql
SELECT u.name, o.amount
FROM users u
INNER JOIN orders o ON u.id = o.user_id;| name | amount |
|---|---|
| 张三 | 99 |
| 张三 | 200 |
| 李四 | 150 |
王五没有订单,被排除;订单 104 的 user_id 是 9,在 users 里找不到对应用户,也被排除。只有「两边都对得上」的组合才保留。
INNER JOIN 适合你只关心「两边都存在」的数据:下过订单的用户及金额、有成绩记录的学生及分数、有库存记录的商品及仓库;缺失一边的数据本就不在分析范围内。
4.2 LEFT JOIN:左表全保留,右表匹配不上补 NULL
sql
SELECT u.name, o.amount
FROM users u
LEFT JOIN orders o ON u.id = o.user_id;| name | amount |
|---|---|
| 张三 | 99 |
| 张三 | 200 |
| 李四 | 150 |
| 王五 | NULL |
王五出现了,因为他是左表 users 的行,即使没有订单也保留。订单 104 依然不出现------它属于右表,右表匹配不上的行 LEFT JOIN 不保。
LEFT JOIN 是最常用的外连接,因为很多分析都要以某个主体为基准:查所有用户及其订单、没订单的也要列出,查所有商品及其销量、没卖出的显示为 0 或 NULL,查所有部门及其员工、空部门也要列出。
4.3 RIGHT JOIN:右表全保留,左表匹配不上补 NULL
sql
SELECT u.name, o.amount
FROM users u
RIGHT JOIN orders o ON u.id = o.user_id;| name | amount |
|---|---|
| 张三 | 99 |
| 张三 | 200 |
| 李四 | 150 |
| NULL | 80 |
订单 104 出现了,王五不出现。RIGHT JOIN 保留右表全部行,左表按需匹配。它完全可以由 LEFT JOIN 替代,只要交换两张表的位置:
sql
SELECT u.name, o.amount
FROM orders o
LEFT JOIN users u ON u.id = o.user_id;
多数团队约定只用 LEFT JOIN:阅读习惯从左到右,左表为基准更符合直觉;RIGHT JOIN 要求读者先跳到右边看基准表,认知负担更大。
三种结果放在一起对比:
| 连接 | 保留范围 | 结果行数 | 匹配不上的行 |
|---|---|---|---|
| INNER JOIN | 两表交集 | 3 | 丢弃 |
| LEFT JOIN | 左表全部 | 4 | 右表补 NULL |
| RIGHT JOIN | 右表全部 | 4 | 左表补 NULL |
注意:INNER 取交集、缺一边就丢行,LEFT 保左表、RIGHT 保右表。
4.4 ON 与 WHERE:右表条件放错位置,语义就变了
LEFT JOIN 有一个高频出错点:同一个条件写在 ON 和写在 WHERE,结果完全不同。
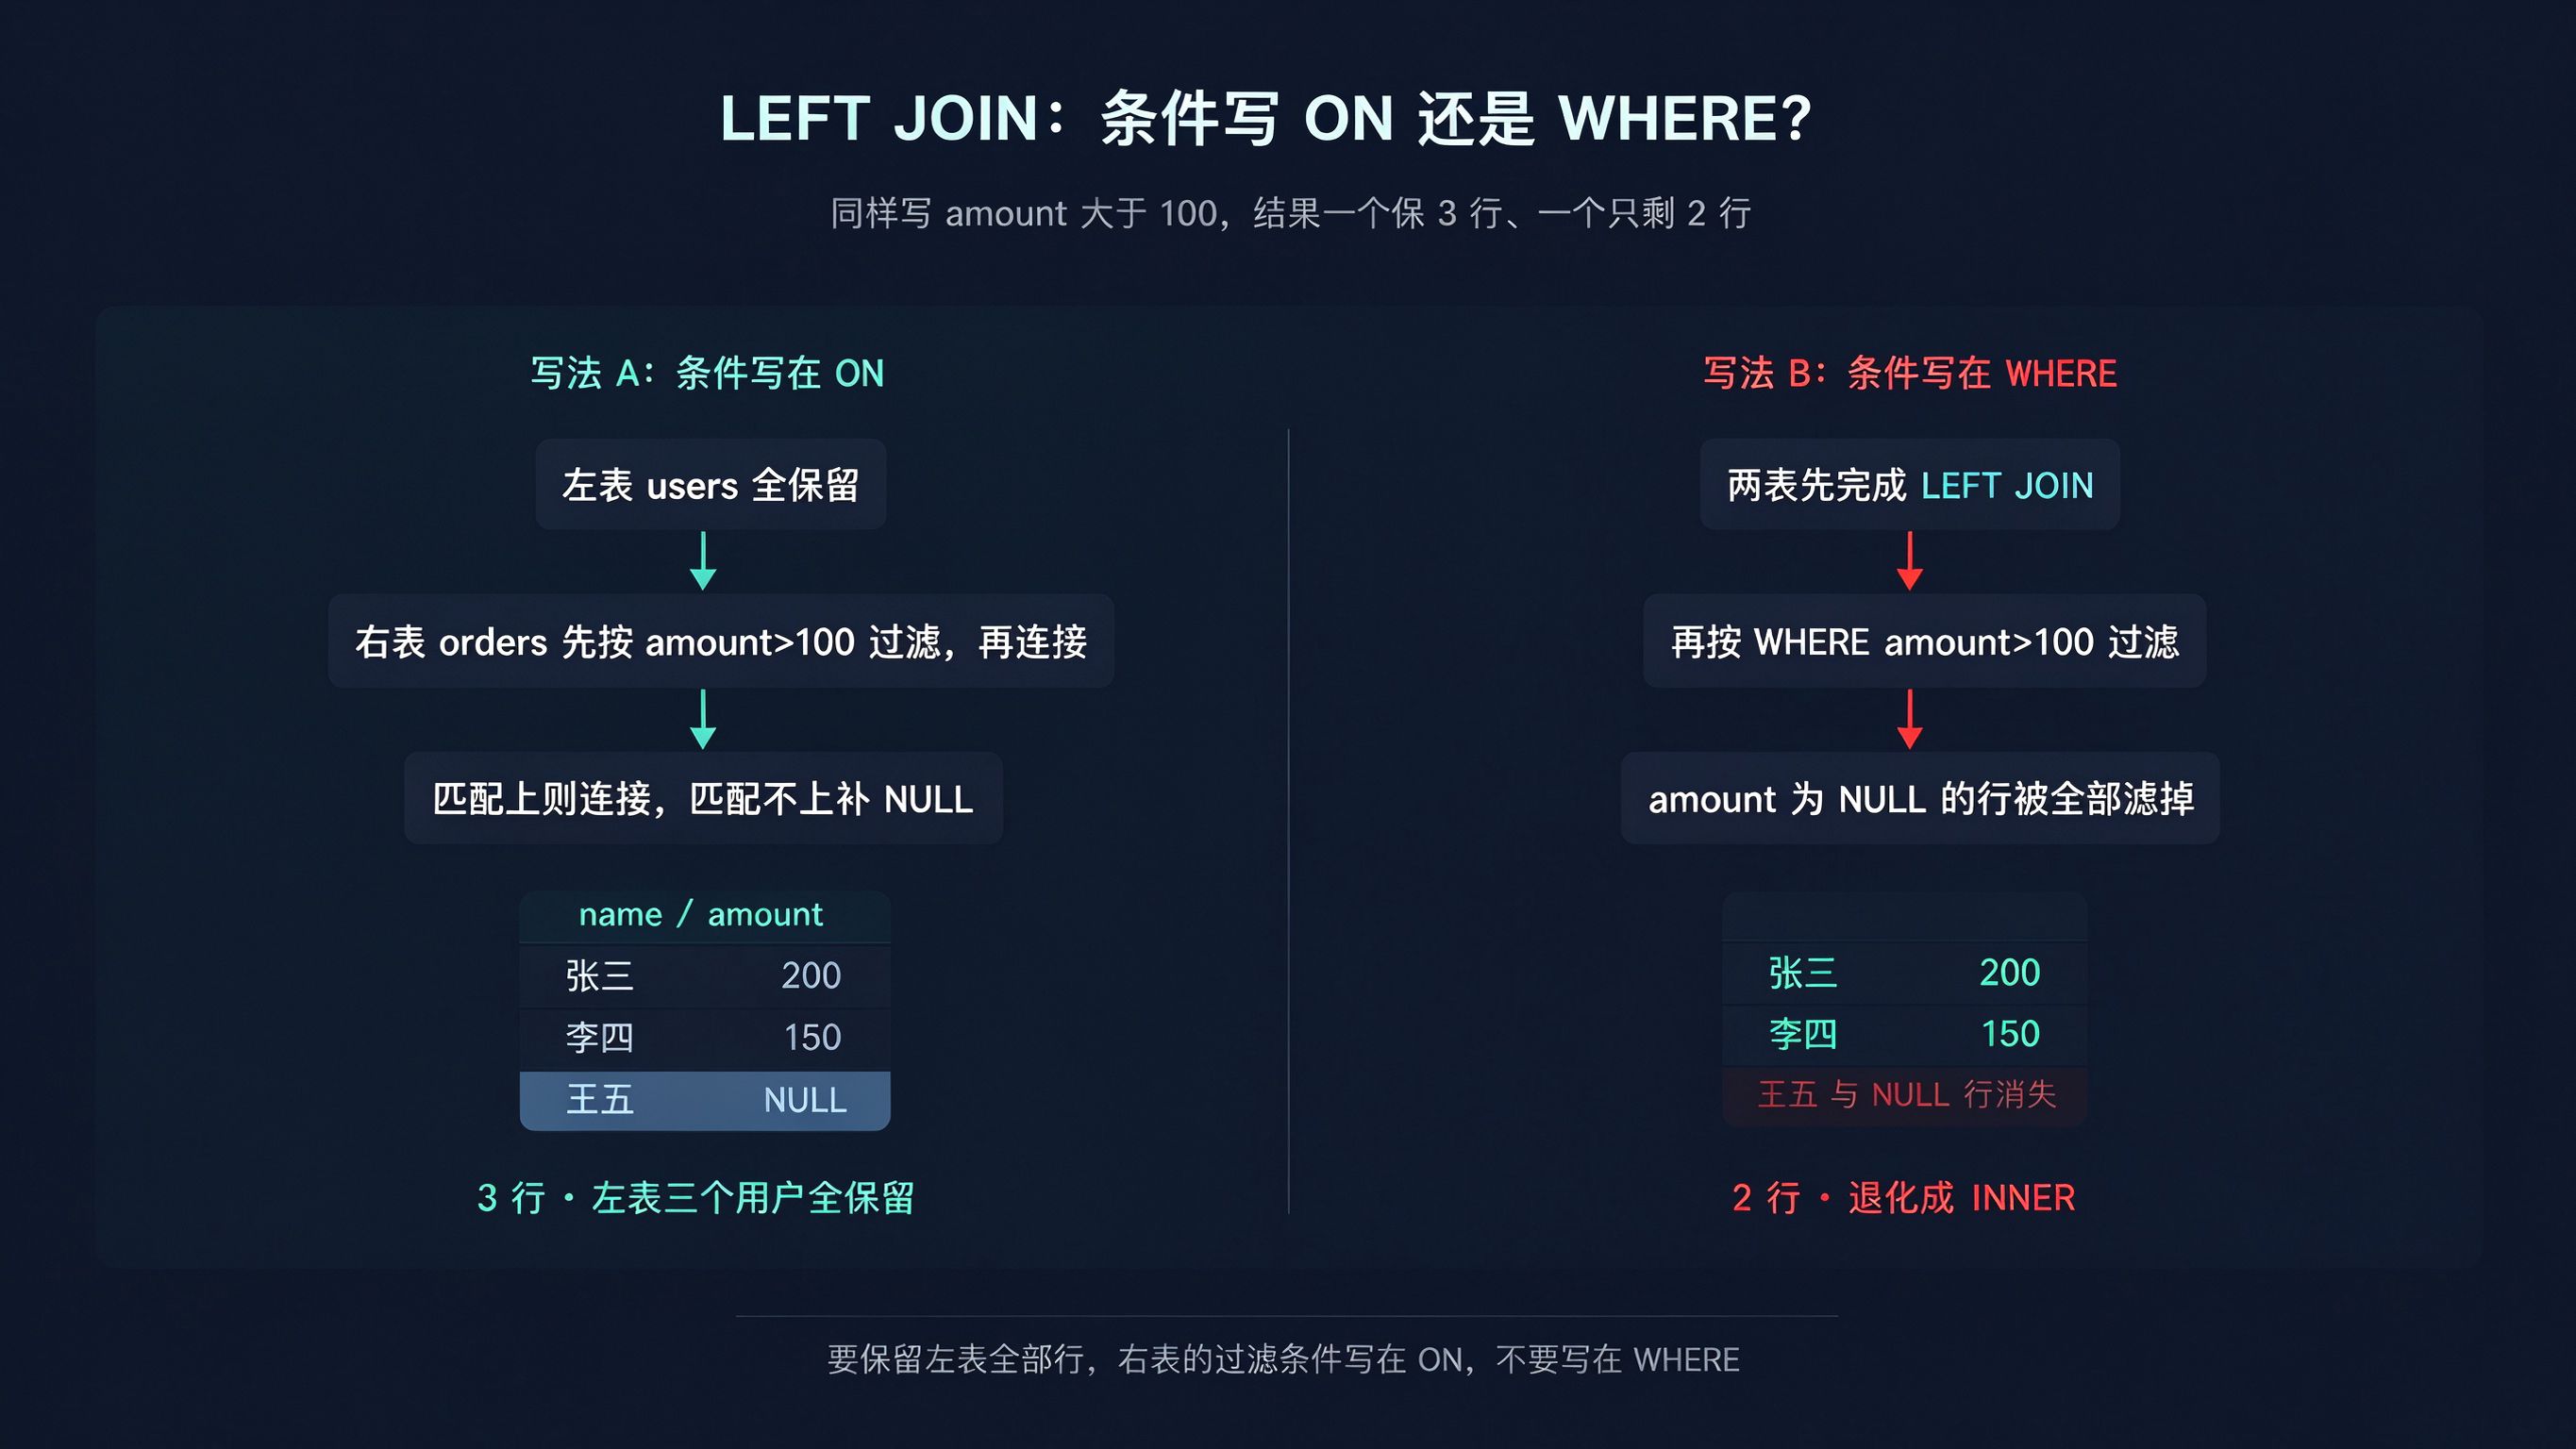
写法 A,条件写在 ON:
sql
SELECT u.name, o.amount
FROM users u
LEFT JOIN orders o
  ON u.id = o.user_id
AND o.amount > 100;| name | amount |
|---|---|
| 张三 | 200 |
| 李四 | 150 |
| 王五 | NULL |
写法 B,条件写在 WHERE:
sql
SELECT u.name, o.amount
FROM users u
LEFT JOIN orders o ON u.id = o.user_id
WHERE o.amount > 100;| name | amount |
|---|---|
| 张三 | 200 |
| 李四 | 150 |
两者的执行时机不同:
- ON 在连接时生效,右表先按条件过滤再连接,匹配不上的左表行仍然保留,只是补 NULL,所以左表一条不少。
- WHERE 在连接完成后生效,对整个结果集过滤;NULL 参与比较结果是 unknown 而不是 true,amount 为 NULL 的行被全部滤掉,左表保留行随之消失。
注意:要保留主体表全部行,右表的过滤条件写在 ON;写在 WHERE 会滤掉 NULL 行,悄悄改成 INNER。
五、验证:你跑一遍,看行数怎么变
把第四节的脚本整体执行,再对照下表核对,就能验证你是否真的理解了。
| 连接写法 | 预期行数 | 必现 / 必隐的行 |
|---|---|---|
| INNER JOIN | 3 | 王五与订单 104 都不出现 |
| LEFT JOIN | 4 | 王五 NULL 必现 |
| RIGHT JOIN | 4 | NULL 80 必现 |
| LEFT + 条件在 ON | 3 | 左表用户全在,王五 NULL 保留 |
| LEFT + 条件在 WHERE | 2 | 王五与 NULL 行消失 |
再用两个小动作亲手验证边界:
- 故意漏写连接条件,你会拿到 12 行(3 × 4),这就是笛卡尔积:
sql
SELECT u.name, o.amount
FROM users u, orders o;- 给关联字段建好索引后跑 EXPLAIN,确认连接是否真正命中索引:
sql
EXPLAIN
SELECT u.name, o.amount
FROM users u
LEFT JOIN orders o ON u.id = o.user_id;
正确:条件在 ON,结果 3 行,左表用户全保留。
错误:条件在 WHERE,结果 2 行,NULL 行被误滤、语义被改变。
六、总结:怎么选不踩坑
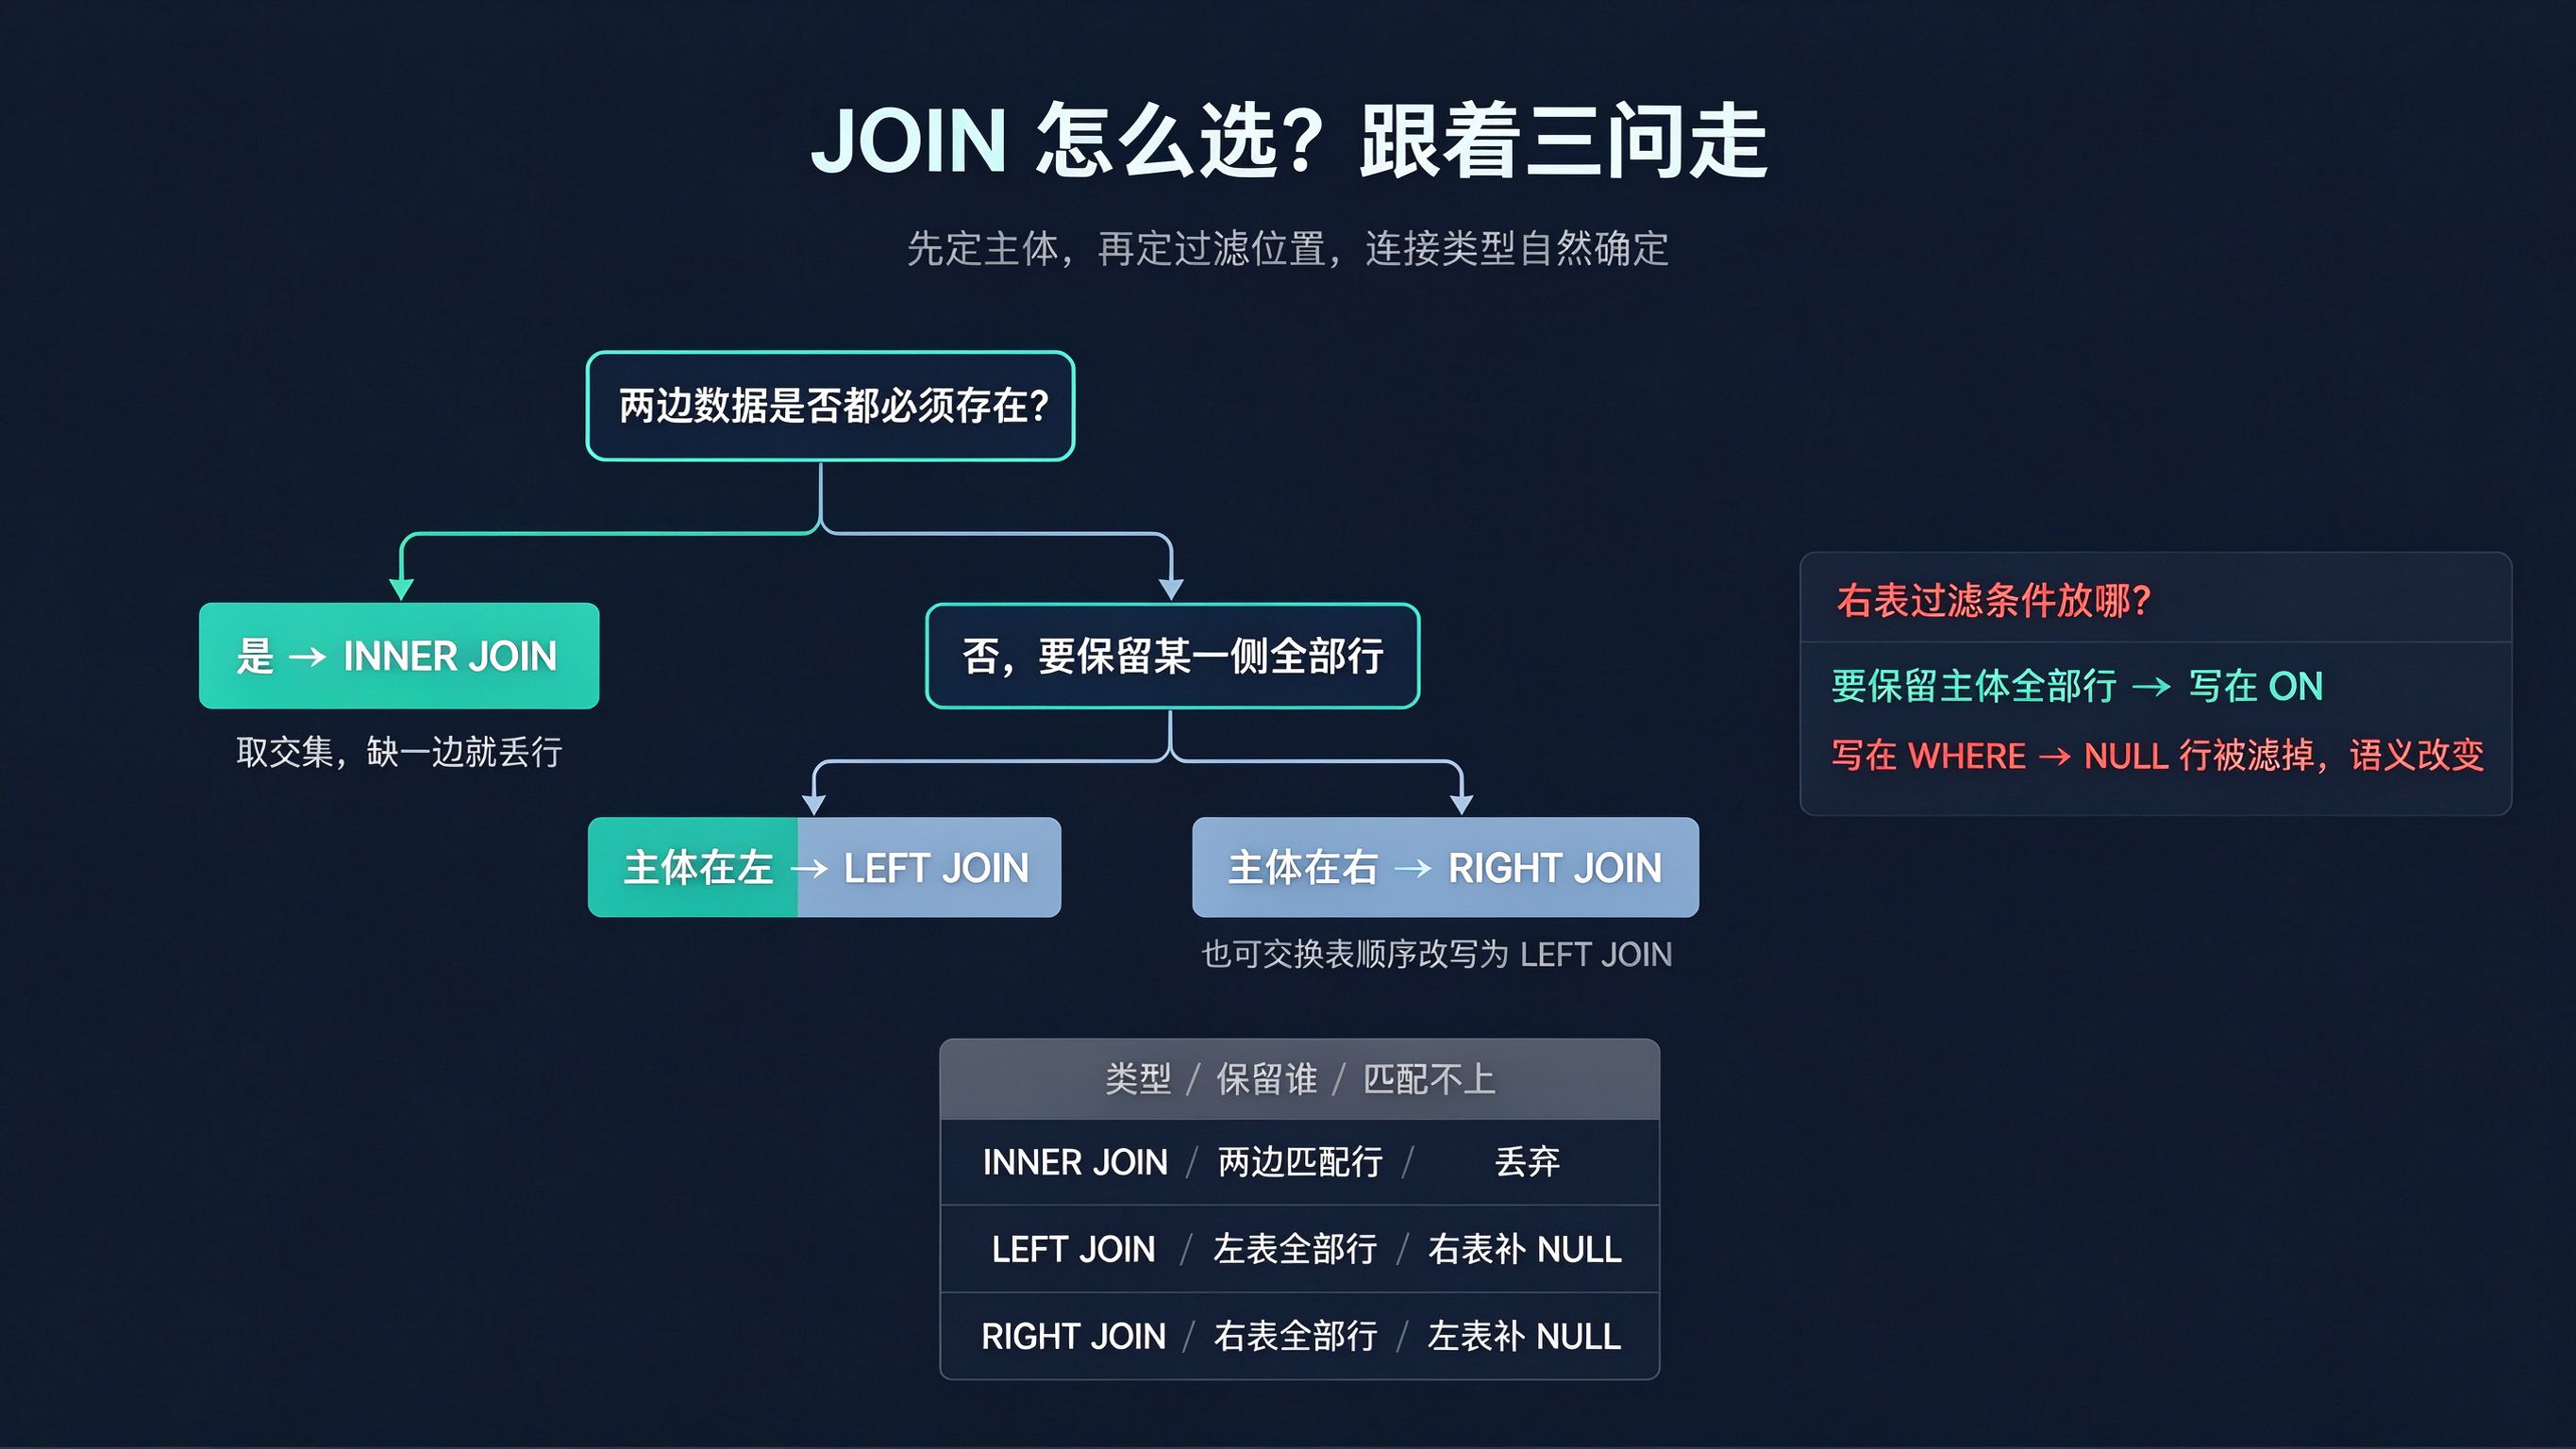
动手前先问自己三个问题:
- 我只关心「两边都有」,还是「某一边全都要」?只取匹配成功的用 INNER;要保留某一侧全部行的用外连接。
- 谁是主体表?主体在左用 LEFT,在右用 RIGHT,或者交换表顺序统一写成 LEFT。
- 关联表的过滤条件放哪?要保留主体全部行就放 ON;放 WHERE 可能滤掉 NULL 行,改变连接语义。
「LEFT JOIN 一定比 INNER JOIN 慢」是误区。真正决定性能的是连接字段有没有索引、条件能否命中索引、是否产生笛卡尔积。INNER 结果集更小往往更快,但不能一概而论,用 EXPLAIN 看执行计划再下结论。
注意:先定谁是主体、谁允许缺失,再选 JOIN,最后用 EXPLAIN 验证,别凭感觉。
术语速查表
| 术语 | 英文 | 含义 |
|---|---|---|
| 连接 | JOIN | 按匹配条件把多张表的行组合成新行 |
| 内连接 | INNER JOIN | 只返回两表匹配的交集行 |
| 左外连接 | LEFT JOIN | 保留左表全部行,右表匹配不上补 NULL |
| 右外连接 | RIGHT JOIN | 保留右表全部行,左表匹配不上补 NULL |
| 外键 | Foreign Key | 建立并约束两表关联关系的字段 |
| 空值 | NULL | 表示值未知或缺失,不等于 0 或空字符串 |
| 结果集 | Result Set | 查询执行后返回的行集合 |
| 笛卡尔积 | Cartesian Product | 漏连接条件时两表行数相乘得到的结果 |
参考链接
- MySQL 8.4 参考手册 · JOIN 语法:https://dev.mysql.com/doc/refman/8.4/en/join.html
- MySQL 8.4 参考手册 · 外连接简化:https://dev.mysql.com/doc/refman/8.4/en/outer-join-simplification.html
- PostgreSQL 官方教程 · 表之间的连接:https://www.postgresql.org/docs/17/tutorial-join.html