C++ 二叉搜索树:查找、插入和删除为什么这样写
前言
假设要维护一组编号:新编号随时加入,旧编号可能移除,还要经常判断某个编号是否存在。用数组保存,查找时可以逐个比较;先把数组排好序,又能使用二分查找。但数据一旦频繁增删,维持数组有序就需要搬动元素。
学到二叉搜索树时,我觉得最值得弄清楚的是:怎样利用结点之间的大小关系,把查找范围缩到一条路径上,并在插入、删除之后继续保住这种关系。
查找和插入比较容易顺着代码读懂,删除却有一个转折:结点有两个孩子时,为什么不能直接接上某一个孩子?为什么又偏偏选左子树的最大值或右子树的最小值来替换?这篇文章会用同一棵树把这些问题串起来,再给出能编译运行的实现。
文章目录
- 先确定规则:有序的是整棵子树
- 查找:一次比较,排除一边
- 插入:把查找走到的空位置接上
- 删除:先接孩子,再考虑替换
Node*&:修改的是哪一根指针- 把操作放进一份可运行代码
- 析构与拷贝:树结点到底归谁
- 从 key 到 key/value,哪些数据可以修改
- 复杂度取决于树高
- 常见错误和复习自测
一、先确定规则:有序的是整棵子树
二叉树的结点最多有两个孩子,二叉搜索树还要对左右两边的值作出约束。本篇先采用不保存重复关键字的版本:
- 左子树里所有结点的关键字,都小于当前结点的关键字。
- 右子树里所有结点的关键字,都大于当前结点的关键字。
- 左右子树也分别满足这套规则。
空树同样是一棵二叉搜索树。后面写查找、插入时,都要从这个边界开始处理。
这里不能只看左右孩子。比如根是 40,左孩子是 20,如果把 50 放到 20 的右边,它虽然大于自己的父结点 20,却仍处在 40 的左子树中,违反了整棵子树的范围约束。
我复习时会把判断补全为:每个结点既要满足眼前的父子关系,也要满足一路经过的祖先所限定的范围。
课件还讨论了允许重复值的版本。两种设计都可以,但规则要事先约定好,例如等值统一向右插入,查找时再明确返回任意一个匹配项,还是有序序列里的第一个匹配项。本文遇到重复值直接返回 false,避免先把重复处理和删除混在一起。
中序遍历为什么能得到有序结果
中序遍历按照"左子树、当前结点、右子树"的顺序访问。左边所有值都小于当前值,右边所有值都大于当前值,再对每棵子树重复这个过程,就能得到升序序列。
后面会按下面的顺序插入数据:
text
40, 20, 60, 10, 30, 50, 70, 55插入顺序决定树的形状。建好树后,中序遍历的结果是:
text
10 20 30 40 50 55 60 70这两个序列分别回答"树怎样长出来"和"怎样按大小访问",不要把它们当作同一件事。
二、查找:一次比较,排除一边
在这棵树中查找 55,从根 40 开始:
55 > 40,左子树不可能有55,转向右孩子60。55 < 60,转向60的左孩子50。55 > 50,转向50的右孩子55。- 关键字相等,查找成功。
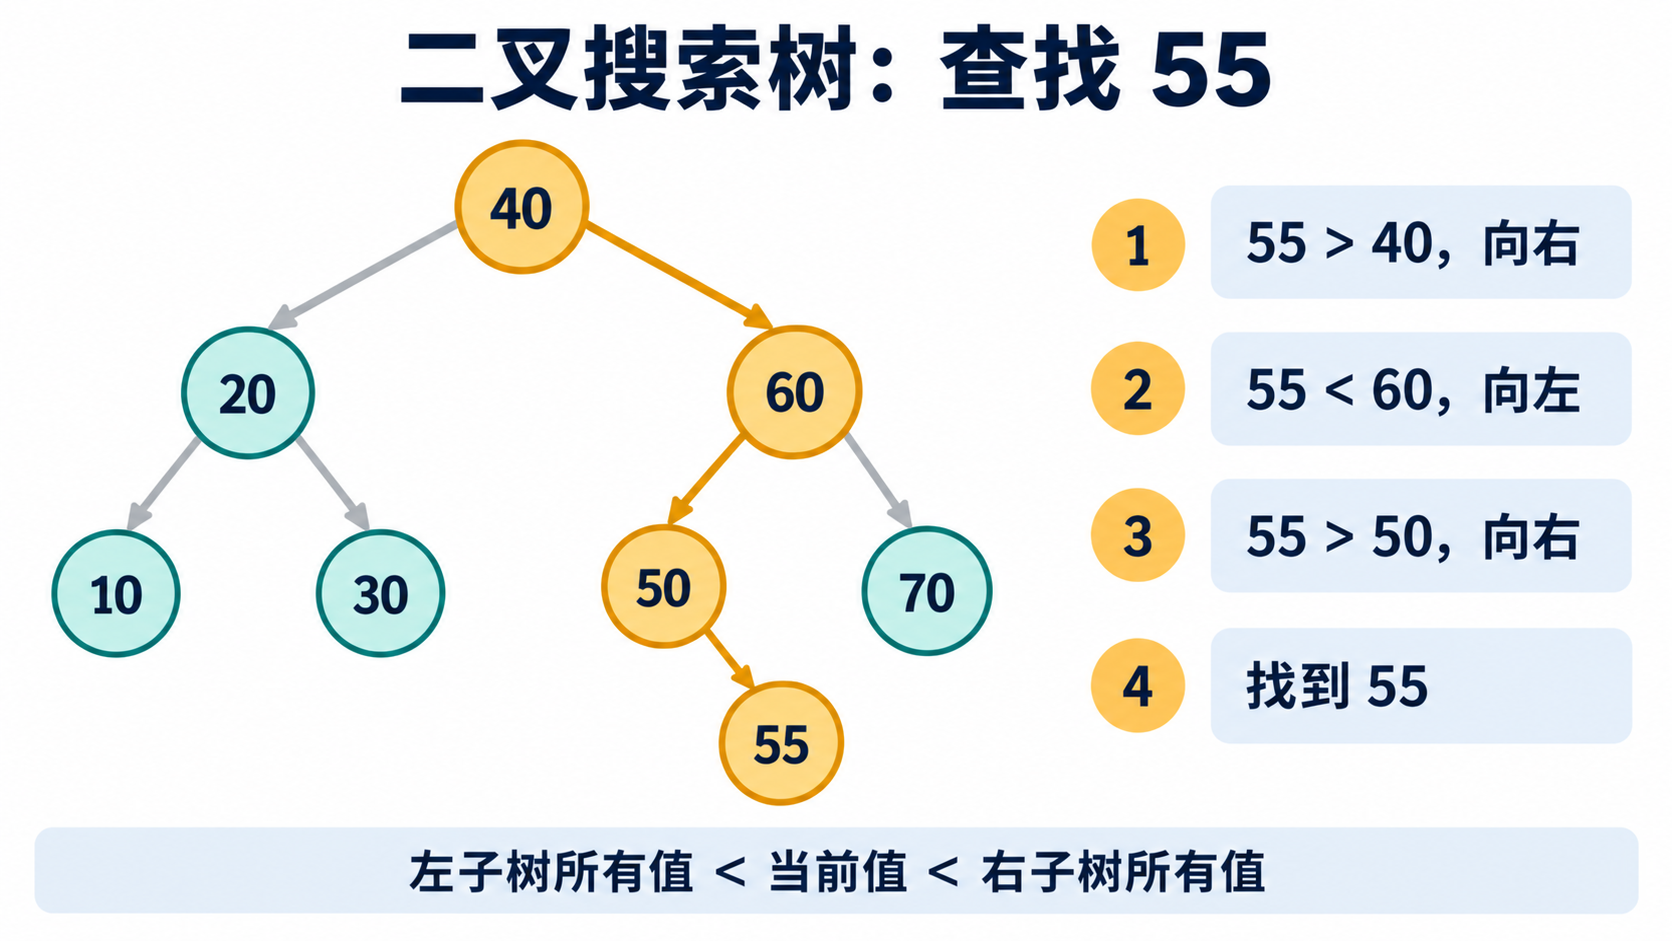
图 1:橙色路径是实际比较过的结点,其余分支在比较后被排除。查找只沿一条路径向下走。
如果目标值不存在,就会走到空指针。例如查找 56,经过 55 后继续向右,发现没有结点,返回失败。
下面是完整实现中的查找函数,root_ 是根指针:
cpp
bool contains(const K& key) const {
    const Node* node = root_;
    while (node) {
        if (key < node->key) {
            node = node->left;
        } else if (node->key < key) {
            node = node->right;
        } else {
            return true;
        }
    }
    return false;
}
node 只负责观察和移动,没有修改任何树结点,因此函数带有 const。循环条件也顺便处理了空树。
这份模板只使用 <:如果 key < node->key 和 node->key < key 都不成立,就把两者视为同一个关键字。对于这里的整数,就是数值相等;对于自定义类型,比较规则需要满足严格弱序,不能让比较结果前后矛盾。入门时可以先用 int 和 std::string 验证。
三、插入:把查找走到的空位置接上
插入和查找用的是同一套比较规则,区别在于走到空位置之后的动作。
比如插入 25:从 40 向左到 20,再向右到 30,最后向左走到空位置。在这里创建新结点,令 30 的左孩子指向它。一路比较已经确定了 20 < 25 < 30,也满足根结点限定的 25 < 40,所以不需要再调整其他结点。
cpp
static bool insertImpl(Node*& link, const K& key) {
    if (!link) {
        link = new Node(key);
        return true;
    }
    if (key < link->key) {
        return insertImpl(link->left, key);
    }
    if (link->key < key) {
        return insertImpl(link->right, key);
    }
    return false;
}这段代码是完整类的成员函数节选。Node*& 让函数能够修改传进来的那根指针:空树时改的是根指针,递归向下后改的是某个结点的孩子指针。第五节会专门拆开这一点。
插入的退出情况只有两个:找到空位置,创建结点并返回 true;遇到等价关键字,保持原树并返回 false。不要遇到相等值后继续随意向左或向右走,否则实现的就不是约定好的"不重复"版本了。
四、删除:先接孩子,再考虑替换
删除的前半段仍然是查找。找到目标以后,真正要处理的是:原来指向它的那根指针,接下来应该指向谁?
| 目标结点的情况 | 原来的连接改为 | 删除后需要保留什么 |
|---|---|---|
| 没有孩子 | nullptr |
没有子树需要保留 |
| 只有左孩子 | 左孩子 | 整棵左子树 |
| 只有右孩子 | 右孩子 | 整棵右子树 |
| 两个孩子都有 | 用前驱或后继替换关键字,再删除替代结点 | 左右子树的大小关系 |
4.1 没有孩子和只有一个孩子,可以合并处理
没有孩子时,把连接清空;只有一个孩子时,让那个孩子接替当前位置。这两个动作可以写进同一段代码:
cpp
Node* old = link;
link = old->left ? old->left : old->right;
delete old;
这段代码只在"至少一个孩子为空"的分支中执行。如果两个孩子都为空,表达式得到的自然是 nullptr。
old 保存待释放结点。先把 link 改为它的孩子,再释放 old,这样子树就接回去了,也不会在释放之后继续读取 old->left 或 old->right。
如果删除的是根结点,道理完全一样:原来那根连接就是 root_,不能只修改一个临时变量后就结束。
4.2 两个孩子都有时,为什么选前驱或后继
如果直接用左孩子替换目标,原来的右子树还需要重新安放;只用右孩子也有同样的问题。更方便的办法,是寻找一个替换后仍能保住顺序的关键字。
两个候选分别是:
- 前驱:左子树的最大值,从左孩子开始一直向右走。
- 后继:右子树的最小值,从右孩子开始一直向左走。
我们采用后继。删除根 40 时,右子树的最小值是 50。它大于左子树中的所有值,又小于右子树中其余所有值,因此把根的关键字改为 50 后,左右两边仍然满足搜索树的规则。
但原来那个 50 还在树中,必须继续删除。它是右子树的最小结点,所以一定没有左孩子,但可能有右孩子 。本例故意让它带有右孩子 55,删除原 50 时,要把 60 的左孩子接到 55,不能直接置空。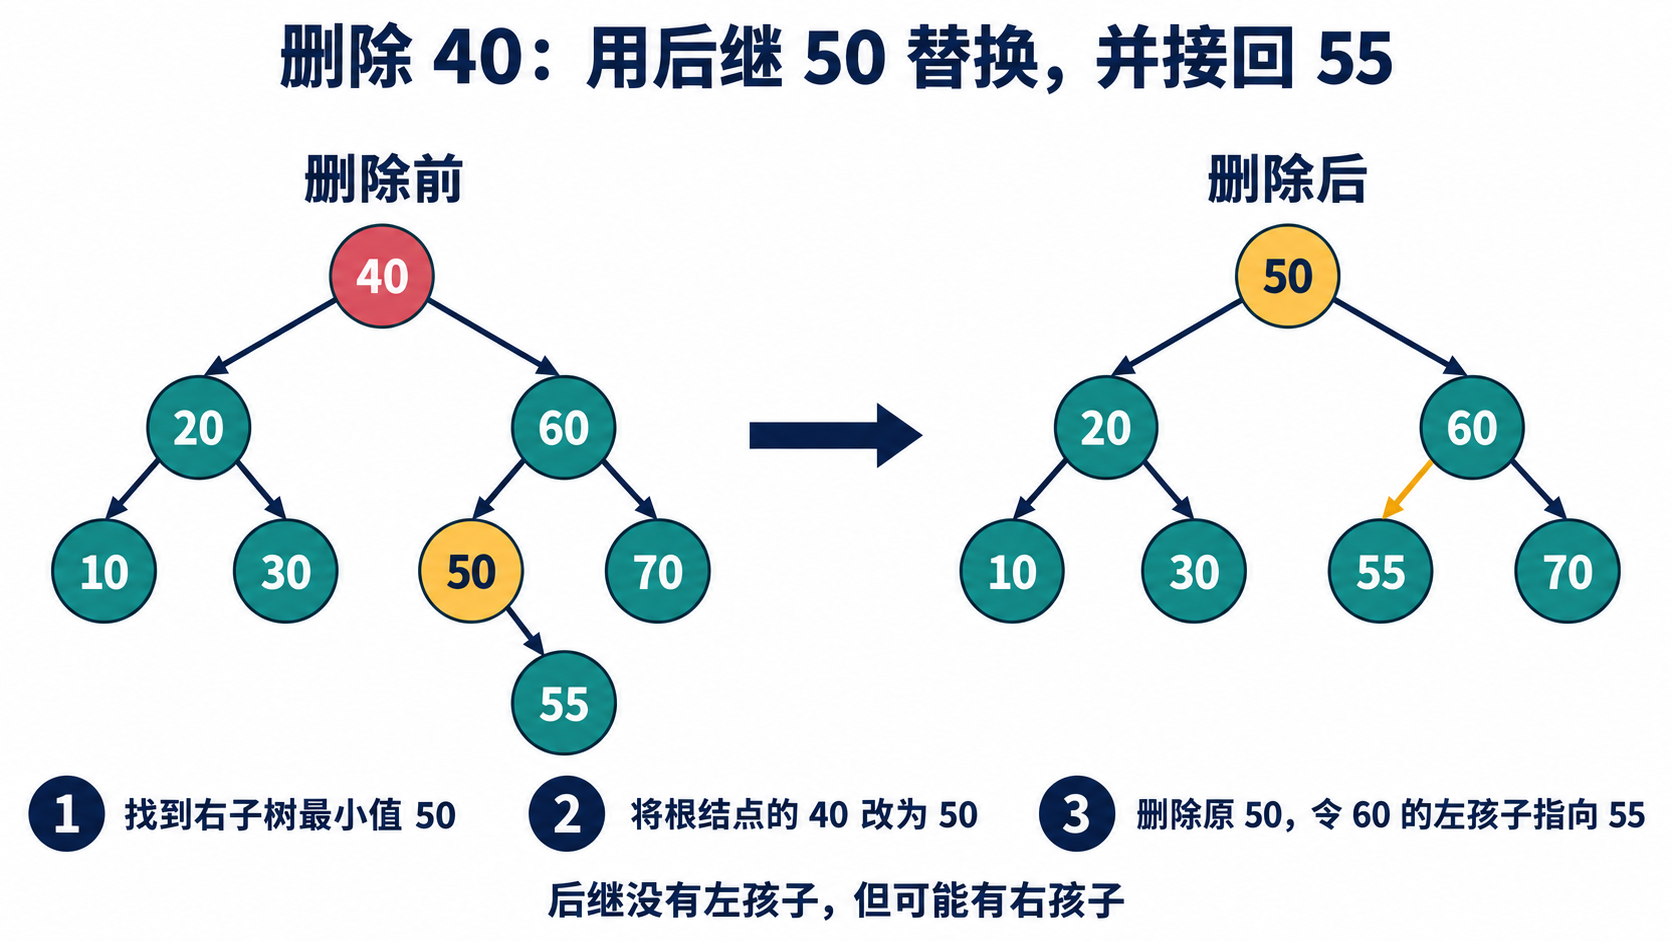
!外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(https://img-hom
图 2:根位置保留下来,关键字从 40 改为 50;真正释放的是右子树中原来的 50 结点,55 接回 60 的左侧。
这里的替换是"复制后继的关键字,再删除后继结点",没有移动整棵子树。也可以采用搬移结点的实现,但连接处理会不同,不要把两种实现的步骤拼在一起。
4.3 完整的删除函数
cpp
static bool eraseImpl(Node*& link, const K& key) {
    if (!link) {
        return false;
    }
    if (key < link->key) {
        return eraseImpl(link->left, key);
    }
    if (link->key < key) {
        return eraseImpl(link->right, key);
    }

    if (!link->left || !link->right) {
        Node* old = link;
        link = old->left ? old->left : old->right;
        delete old;
        return true;
    }

    Node* successor = link->right;
    while (successor->left) {
        successor = successor->left;
    }
    link->key = successor->key;
    return eraseImpl(link->right, link->key);
}
前两个比较分支负责找到目标;"孩子不全"的分支负责真正解除连接并释放结点;最后一段则把双孩子问题转换为删除后继的问题。
最后一次递归必须从 link->right 开始。如果从当前 link 重新查找,就会先找到刚刚替换过关键字的当前结点,再次处理它,找错了删除对象。
后继恰好是右孩子时,这段代码也成立。它不需要另写"后继的父结点是不是当前结点"的分支,因为递归中的 Node*& 会直接绑定到对应的孩子指针。
删除后得到的中序结果应该是:
text
10 20 30 50 55 60 7040 消失,55 仍然保留。这是检查"后继有右孩子"时有没有丢失子树的一组简单数据。
五、Node*&:修改的是哪一根指针
刚看这类代码时,我容易只盯着 Node*,以为函数拿到了结点地址,就一定能改好连接。后来把两种参数放到一起看,才分清了"修改结点"和"修改指针变量"是两回事。
cpp
void changeLocal(Node* p) {
    p = nullptr;
}

void changeCaller(Node*& p) {
    p = nullptr;
}
两者都能通过 p 访问非空结点,但重新给 p 赋值时,效果不同:changeLocal 修改的是传入指针的一份副本,changeCaller 修改的是调用方的那根指针。这里假设 Node 已有定义,函数只用于说明参数语义。
放回树中,绑定关系是:
| 调用方式 | link 绑定到谁 |
给 link 赋值的效果 |
|---|---|---|
insertImpl(root_, key) |
树的根指针 | 改变根结点 |
insertImpl(link->left, key) |
当前结点的左孩子指针 | 接上或替换左子树 |
eraseImpl(link->right, key) |
当前结点的右孩子指针 | 接上或替换右子树 |
因此,根结点和普通结点可以使用同一套增删逻辑。课件中的非递归实现会记录父结点,再判断应该修改它的左指针还是右指针;本文改用指针引用,把"谁指向当前结点"交给参数表达。两种写法维护的是同一组连接关系。
六、把操作放进一份可运行代码
下面实现的是保存唯一关键字的 BSTree<K>。代码包含查找、插入、删除、中序遍历,以及结点销毁和深拷贝,便于直接保存运行。
示例使用 C++17,不依赖第三方库。K 需要能够复制,并且提供一致的 < 比较。这里的双孩子删除会给关键字赋值,主要面向 int、std::string 这类常用类型;如果自定义关键字的赋值可能抛异常,需要另行设计删除的异常保证,不能直接把这份学习实现当作通用容器。
cpp
#include <iostream>
#include <utility>
#include <vector>

template <class K>
class BSTree {
    struct Node {
        K key;
        Node* left = nullptr;
        Node* right = nullptr;

        explicit Node(const K& value) : key(value) {}
    };

    Node* root_ = nullptr;

    static bool insertImpl(Node*& link, const K& key) {
        if (!link) {
            link = new Node(key);
            return true;
        }
        if (key < link->key) {
            return insertImpl(link->left, key);
        }
        if (link->key < key) {
            return insertImpl(link->right, key);
        }
        return false;
    }

    static bool eraseImpl(Node*& link, const K& key) {
        if (!link) {
            return false;
        }
        if (key < link->key) {
            return eraseImpl(link->left, key);
        }
        if (link->key < key) {
            return eraseImpl(link->right, key);
        }

        if (!link->left || !link->right) {
            Node* old = link;
            link = old->left ? old->left : old->right;
            delete old;
            return true;
        }

        Node* successor = link->right;
        while (successor->left) {
            successor = successor->left;
        }
        link->key = successor->key;
        return eraseImpl(link->right, link->key);
    }

    static void inorderImpl(const Node* node, std::vector<K>& result) {
        if (!node) {
            return;
        }
        inorderImpl(node->left, result);
        result.push_back(node->key);
        inorderImpl(node->right, result);
    }

    static void destroy(Node* node) {
        if (!node) {
            return;
        }
        destroy(node->left);
        destroy(node->right);
        delete node;
    }

    static Node* clone(const Node* node) {
        if (!node) {
            return nullptr;
        }
        Node* copy = new Node(node->key);
        try {
            copy->left = clone(node->left);
            copy->right = clone(node->right);
        } catch (...) {
            destroy(copy);
            throw;
        }
        return copy;
    }

public:
    BSTree() = default;

    ~BSTree() {
        destroy(root_);
    }

    BSTree(const BSTree& other) : root_(clone(other.root_)) {}

    BSTree& operator=(const BSTree& other) {
        if (this != &other) {
            BSTree copy(other);
            std::swap(root_, copy.root_);
        }
        return *this;
    }

    bool insert(const K& key) {
        return insertImpl(root_, key);
    }

    bool contains(const K& key) const {
        const Node* node = root_;
        while (node) {
            if (key < node->key) {
                node = node->left;
            } else if (node->key < key) {
                node = node->right;
            } else {
                return true;
            }
        }
        return false;
    }

    bool erase(const K& key) {
        return eraseImpl(root_, key);
    }

    std::vector<K> inorder() const {
        std::vector<K> result;
        inorderImpl(root_, result);
        return result;
    }
};

void printKeys(const std::vector<int>& keys) {
    for (std::size_t i = 0; i < keys.size(); ++i) {
        if (i != 0) {
            std::cout << ' ';
        }
        std::cout << keys[i];
    }
    std::cout << '\n';
}

int main() {
    BSTree<int> tree;
    for (int key : {40, 20, 60, 10, 30, 50, 70, 55}) {
        tree.insert(key);
    }

    std::cout << "before: ";
    printKeys(tree.inorder());
    std::cout << std::boolalpha;
    std::cout << "insert duplicate 30: " << tree.insert(30) << '\n';
    std::cout << "contains 55: " << tree.contains(55) << '\n';
    std::cout << "contains 99: " << tree.contains(99) << '\n';

    BSTree<int> snapshot(tree);
    std::cout << "erase 40: " << tree.erase(40) << '\n';
    std::cout << "after: ";
    printKeys(tree.inorder());
    std::cout << "snapshot still has 40: " << snapshot.contains(40) << '\n';
}前几节的函数在这里组合成了完整类。Node 私有,调用方只能通过接口操作树,避免拿到结点后随手修改关键字。inorder() 返回一份有序关键字序列,便于打印和验证。
保存为 bst_demo.cpp 后,可以使用 GCC 编译:
bash
g++ -std=c++17 -Wall -Wextra -pedantic bst_demo.cpp -o bst_demo编译命令开启了常用警告。在 Linux 或 macOS 上运行:
bash
./bst_demo如果在 Windows 的 PowerShell 中使用 MinGW,编译结果为 bst_demo.exe,运行:
powershell
.\bst_demo.exe这份命令和代码的预期输出为:
text
before: 10 20 30 40 50 55 60 70
insert duplicate 30: false
contains 55: true
contains 99: false
erase 40: true
after: 10 20 30 50 55 60 70
snapshot still has 40: true
重复插入没有增加结点;查找区分了存在和不存在;删除 40 后,排序关系和 55 都保留下来。最后一行还说明:删除原树的结点,没有影响之前复制出的 snapshot。
本文配套的 完整源码 与上面的实现一致。除了这组输出,代码还检查了空树、删除根、单孩子、后继就是右孩子、后继带右孩子等情况,并把 10,000 次随机操作的返回值与有序结果和 std::set<int> 对照。
七、析构与拷贝:树结点到底归谁
插入用了 new,树对象就要负责回收结点。只在删除函数里写 delete 还不够:程序结束时,树里通常仍有剩余结点。
7.1 销毁时先处理孩子,再处理当前结点
完整实现的 destroy 使用后序顺序:先销毁左子树,再销毁右子树,最后释放当前结点。如果先释放当前结点,再读取它的孩子指针,就已经在访问释放后的内存。
~BSTree() 从 root_ 开始调用 destroy,每个结点都被释放一次。这里使用裸指针,是为了直接观察连接和释放过程,所有权始终属于树对象,不应让调用方再释放其中的结点。
7.2 默认拷贝只会复制根指针
如果不编写拷贝操作,两个树对象会保存同一个根地址,共用一批结点。这样不仅改一棵树会影响另一棵树,还会在各自析构时重复释放相同内存。
完整代码中的 clone 为每个原结点创建新结点,再递归复制左右子树。拷贝后的关键字和形状相同,结点地址各自独立,这就是深拷贝。
clone 里的 try/catch 用于清理复制到一半的子树:如果后续分配或关键字复制失败,就销毁已经创建的部分,再继续抛出异常。不会用半棵树冒充一份成功的副本。
赋值操作先建立完整副本,再交换根指针。交换后,临时对象持有目标原来的树,离开作用域时把旧树释放。这样复制失败时,目标原来的内容仍然保留;自赋值也能正确处理。
如果暂时不想实现深拷贝,也可以明确禁用拷贝构造和拷贝赋值。重要的是让接口表达真实的所有权规则,不能保留默认浅拷贝后指望调用方"别碰巧复制"。
八、从 key 到 key/value,哪些数据可以修改
目前树里只保存关键字,回答的是"这个编号在不在"。课件把它称为 key 模型。如果还要按编号找到对应的数据,就需要 key/value 模型。
| 模型 | 结点保存的内容 | 查找想得到什么 | 示例场景 |
|---|---|---|---|
| key | 唯一编号 | 是否存在 | 判断一个任务是否已登记 |
| key/value | 编号与任务信息 | 编号对应的数据 | 按任务编号取得标题、状态等信息 |
扩展结点时,可以这样理解数据布局:
cpp
template <class K, class V>
struct EntryNode {
    K key;
    V value;
    EntryNode* left = nullptr;
    EntryNode* right = nullptr;
};
这是结点模型示意,不是前面完整类的新增接口。查找、插入、删除仍然根据 key 比较,value 不参与树的排序。
因此,任务状态可以修改,但不能拿到结点后直接把编号从 20 改为 80。结点仍在原来的位置,却已经不满足祖先限定的范围。若确实需要改编号,通常应先移除旧关键字,再按新关键字重新插入,同时考虑新编号冲突时的处理。
还有一个容易漏的细节:key/value 模型采用替换删除时,要连同 value 一起替换。 如果只把后继的编号复制过来,却留下目标结点原来的任务信息,编号和数据就配错了。
在"不重复关键字"的映射中,遇到已有 key 时,可以拒绝插入,也可以更新对应 value,取决于接口约定。这个决定与"是否允许保存多个相同 key 的结点"不同。
这些规则会接到后续 set、map 的使用。本文先把模型分清,下一讲再讨论标准容器的具体接口。
九、复杂度取决于树高
我一开始容易把二叉搜索树和二分查找联系起来,顺手写成 O(log n)。但搜索树只保证左右大小关系,没有保证每次排除的结点数量接近一半。
设树高为 h,按从根到最深叶子经过的结点数计。对于非空树,查找、插入和删除最坏都只沿有限条向下路径处理,所以时间复杂度是 O(h)。删除双孩子结点时,寻找后继以及随后删除后继会重复经过一段路径,仍然是 O(h)。
这里按一次关键字比较、赋值为常数时间计算。如果关键字是很长的字符串,还要计入比较和复制关键字的代价。
| 树的形状 | 高度 | 查找、插入、删除的最坏时间 |
|---|---|---|
| 高度受控、接近平衡 | O(log n) |
O(log n) |
| 普通搜索树退化成单链 | O(n) |
O(n) |
例如依次插入 10、20、30、40、50,每个新值都沿右边插入,树会变成一条向右的链。查找 50 时,前面的结点几乎一个都不能跳过。
中序遍历和销毁要访问每个结点,时间都是 O(n)。这份递归实现使用的调用栈空间为 O(h);inorder() 还保存了一个包含全部关键字的结果数组,需要 O(n) 空间。树很深时,递归也可能耗尽调用栈,不能只考虑比较次数。
课件的 O(n) 对应普通二叉搜索树的最坏情况。随机顺序插入不同关键字时,可以讨论期望效率,但它不是对任意输入的保证;教材也明确把随机模型与树高相关的最坏界分开讨论。见 Algorithms 第 4 版配套的 Binary Search Trees。
和有序数组放在一起比较
| 结构 | 查找 | 插入、删除 | 需要注意什么 |
|---|---|---|---|
| 有序数组 | 二分查找 O(log n) |
通常需要移动元素,最坏 O(n) |
数据连续,适合较少修改的有序数据 |
| 普通二叉搜索树 | O(h) |
O(h) |
插入顺序影响高度,可能退化 |
| 平衡二叉搜索树 | O(log n) |
O(log n) |
通过额外规则与调整维护高度 |
搜索树避免了维持数组顺序时的大批量搬移,但普通搜索树还没有解决高度问题。后面的 AVL 树、红黑树,重点就是在增删过程中继续约束高度。
标准有序关联容器对关键查找操作有对数复杂度要求,但标准并没有规定只能用红黑树实现。这里先理解"有序关系"和"平衡保证"是两层要求,不把本文的普通搜索树直接等同于标准库容器。复杂度要求可核对 C++ 标准草案的关联容器要求。
十、常见错误和复习自测
| 容易写错的地方 | 会发生什么 | 检查方法 |
|---|---|---|
| 只比较当前结点和孩子 | 深层结点可能违反祖先的范围 | 按整棵子树的范围判断 |
传入 Node* 后只改指针副本 |
新根或新孩子没有接回树 | 确认修改的是根或孩子指针本身 |
直接 delete 目标,不改连接 |
父结点继续指向已释放内存 | 先接回子树,再释放目标 |
| 把后继当成一定没有孩子 | 后继的右子树丢失 | 用本文带 55 的例子检查 |
| 替换关键字后从当前结点继续删 | 再次命中替换后的目标结点 | 从原来的右子树删除后继 |
| key/value 只替换 key | 关键字和业务数据错配 | 成对处理 key 与 value |
| 根指针保留默认拷贝 | 多棵树共用结点,重复释放 | 深拷贝或禁用拷贝 |
把普通搜索树固定写成 O(log n) |
忽略退化与递归深度 | 先写 O(h),再判断树高 |
如果想检查自己是否真的理解,可以先不看代码回答四个问题:
- 查找
56,具体经过哪些结点,在哪一步失败? - 删除根
40时,为什么选50可以保住左右顺序,而随意选60不行? - 原来
50的右孩子55,删除后应该接到哪里? - 两棵树的中序结果相同,是否就意味着查找效率相同?
对应答案是:40 → 60 → 50 → 55 → 空;50 是右子树最小值,而把 60 放到根位置会让右侧剩余的 50、55 小于新根;55 接到 60 的左侧;相同关键字可以形成不同树形,中序结果相同也不代表高度相同。
收尾
二叉搜索树的几个操作看起来各有一套代码,其实始终在维护同一件事:每棵左子树比根小,每棵右子树比根大。查找利用这个关系选择方向,插入把新结点接在合适的空位置,删除则重新处理连接,并在必要时找一个顺序合适的替代值。
对我来说,复习删除时最有用的动作,是在纸上先标出"谁指向目标、目标还连着谁"。连接关系画清楚后,Node*&、根结点处理和后继接回都能对上代码。再问一句"这棵树有多高",也就能看出为什么下一步还需要学习平衡搜索树。
参考资料
- Algorithms 第 4 版配套的 Binary Search Trees:辅助核对后继删除与复杂度的适用条件。
- C++ 标准草案:关联容器要求:辅助核对标准库容器的有序关系和复杂度约定。