✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
本系统《基于大数据的单位招聘岗位信息分析与可视化》面向计算机专业本科毕业设计场景,以Hadoop分布式文件系统(HDFS)作为底层数据存储底座,承载从各大招聘渠道采集的原始岗位信息数据,利用Spark计算引擎对海量招聘数据进行清洗、转换与聚合运算,借助Spark SQL模块完成结构化查询与多维度统计,结合Pandas与NumPy进行辅助数据预处理与数值计算。系统后端提供基于Django(Python版)或Spring Boot(Java版)的API接口服务,前端采用Vue框架配合ElementUI组件库构建管理界面,使用ECharts图表库实现岗位分布、薪酬水平、区域布局、用工结构、企业招聘、招聘周期及岗位画像等分析维度的可视化展示。系统整体采用"大数据存储+分布式计算+前后端分离"的架构模式,旨在为本科生提供一个完整落地的大数据开发实践范例,帮助其理解从原始数据到业务指标的全链路处理流程。
选题背景
临近本科毕业,大部分计算机专业学生虽然学过Hadoop、Spark等大数据课程,但真正动手做一个完整的大数据项目的机会并不多。招聘网站上每天产生海量的岗位信息,这些数据天然适合用大数据技术来处理,拿来做毕设课题既贴近真实业务场景,又不至于太脱离课堂上学过的东西。本课题就是用Hadoop存数据、用Spark算指标,把招聘信息里那些散乱的岗位名称、薪资范围、公司地域、学历要求这些东西给规整出来,再做成图表展示。这么一来,数据量大了不怕存不下,算得快不快也交给Spark分布式去解决,整个流程走下来,课堂上那些抽象的概念就变成了能跑通的代码,也算是对大学四年大数据方向学习的一个实际检验。
选题意义
从个人能力锻炼的角度看,做完这个系统,至少能把HDFS的读写操作、Spark的RDD和DataFrame编程、Spark SQL的聚合查询这些技能实实在在地练一遍,比光看书做题要管用得多。从毕设答辩的角度看,这个题目天然带有"大数据"标签,功能点也够清晰,岗位分布、薪酬水平、招聘周期这些分析模块做出来都是实打实的可视化图表,评委问起来每个功能都能说清楚用了什么技术、怎么算的。从代码量的角度,前后端加起来有将近两千行,HDFS存文件、Spark跑任务、Vue画图表,每个环节都有东西可展示,毕业设计的基本工作量是能够满足的。总体来讲,这就是一个老老实实把大数据技术栈从头到尾串起来的项目,没有什么花哨的东西,但对于本科阶段来说,能把这条路走通就已经达到毕业设计的预期目标了。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
- 基于大数据的单位招聘岗位信息分析与可视化界面展示:
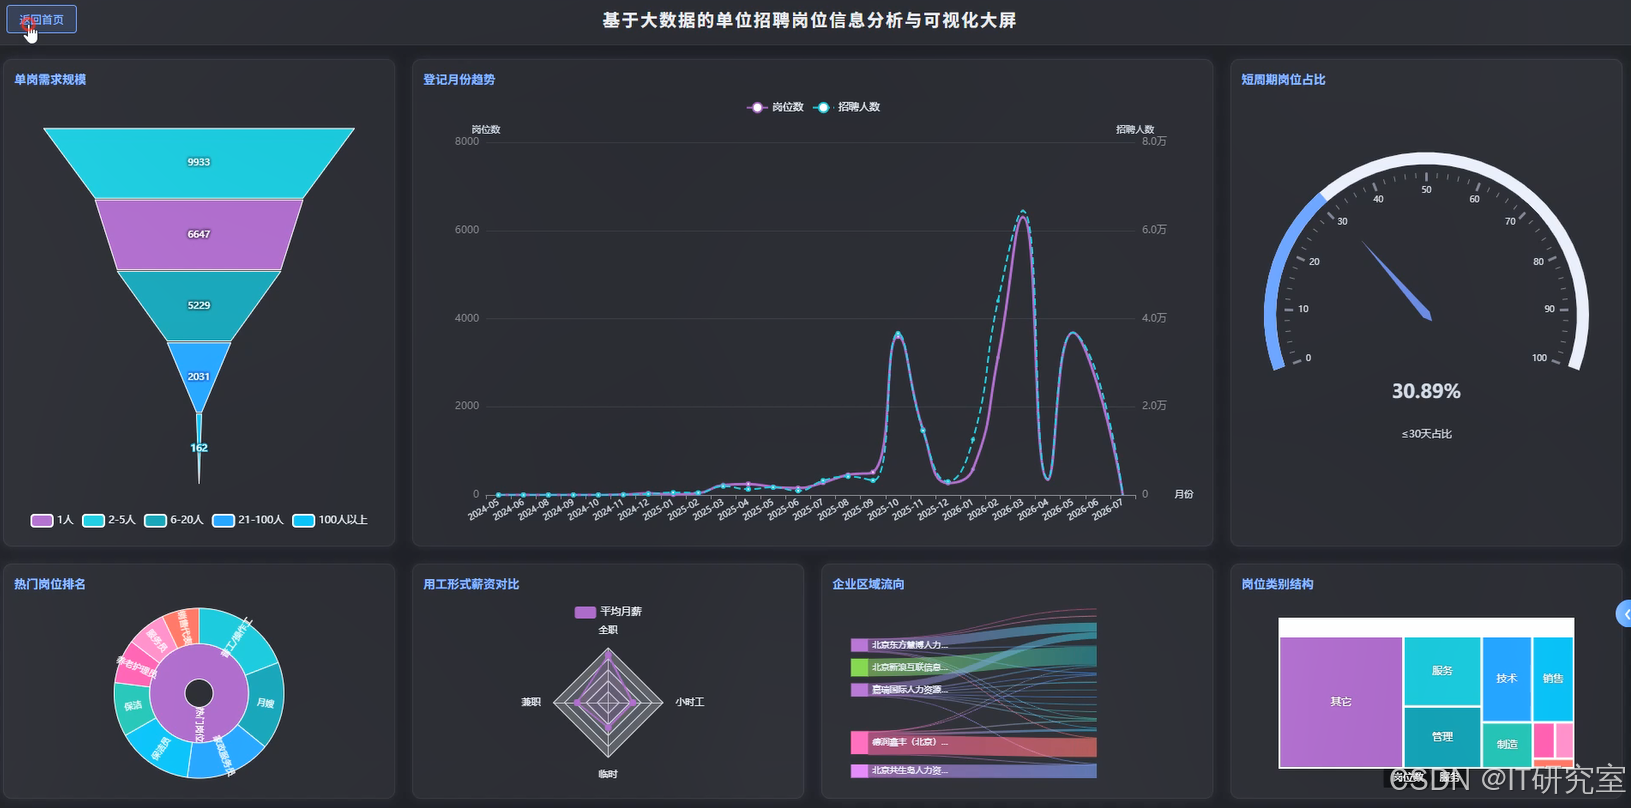
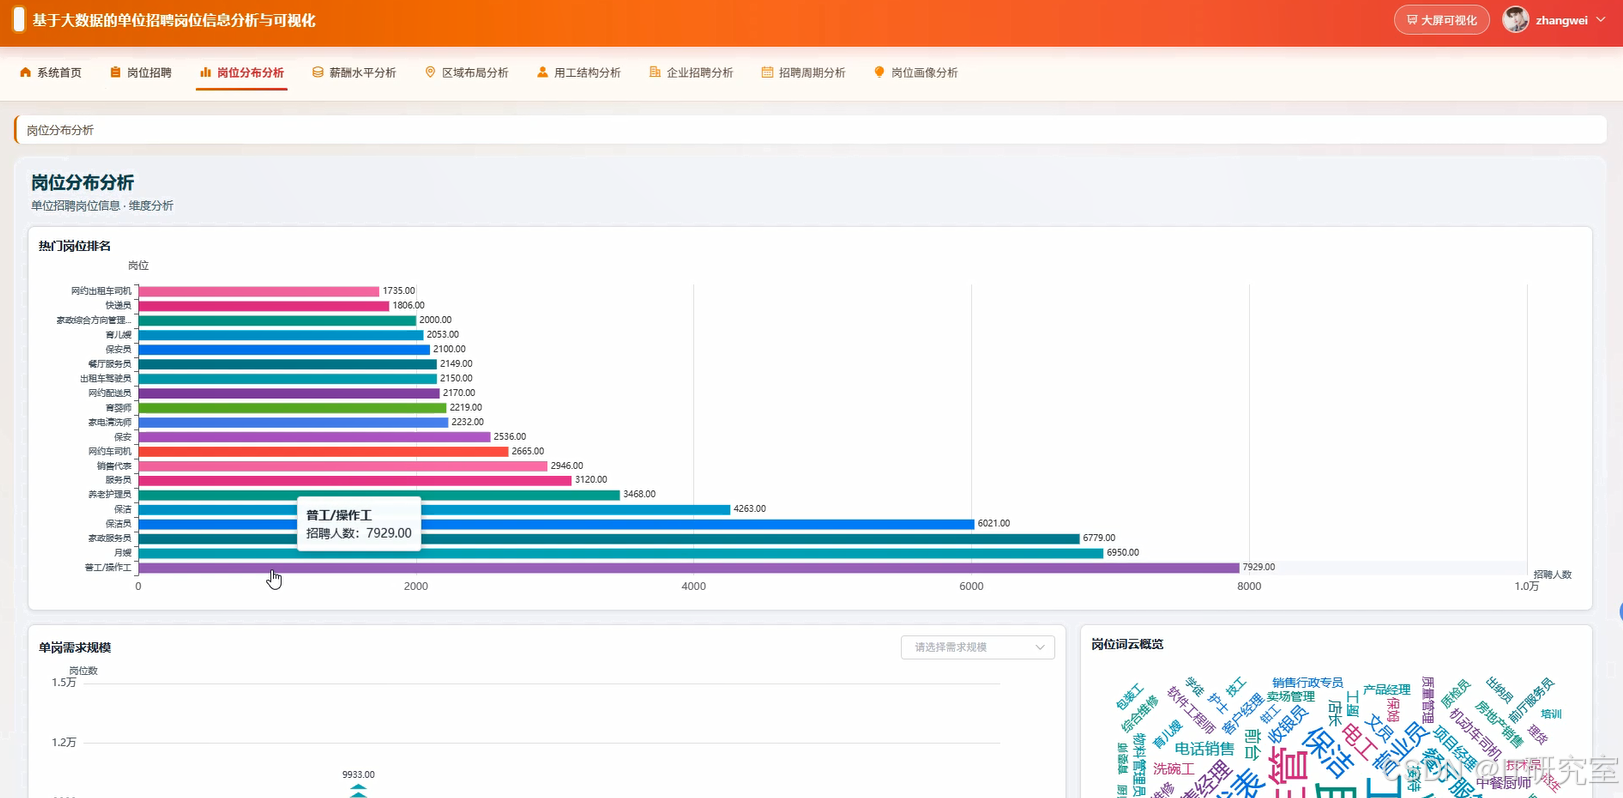
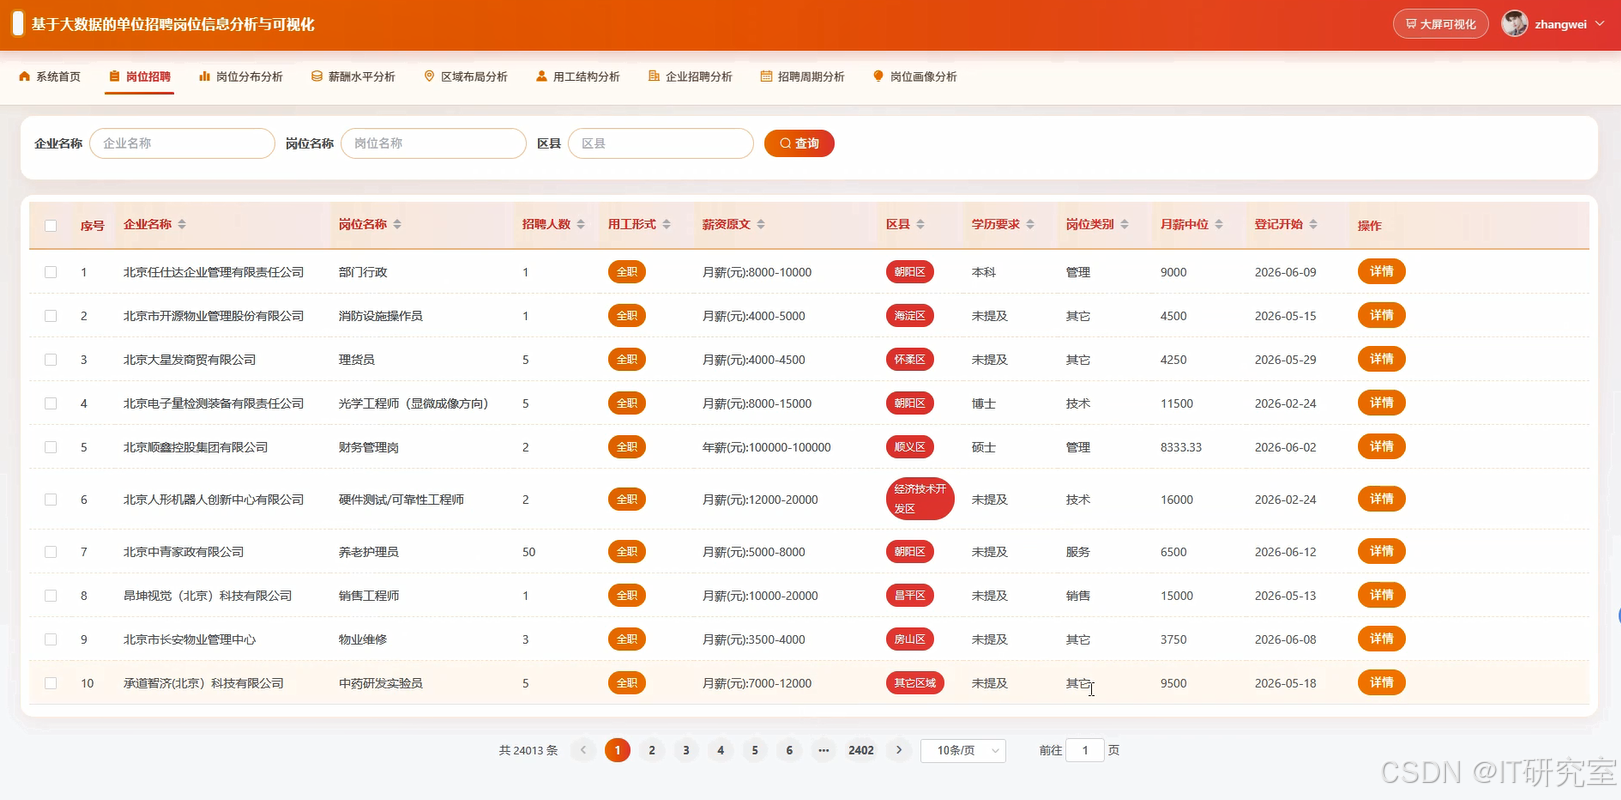
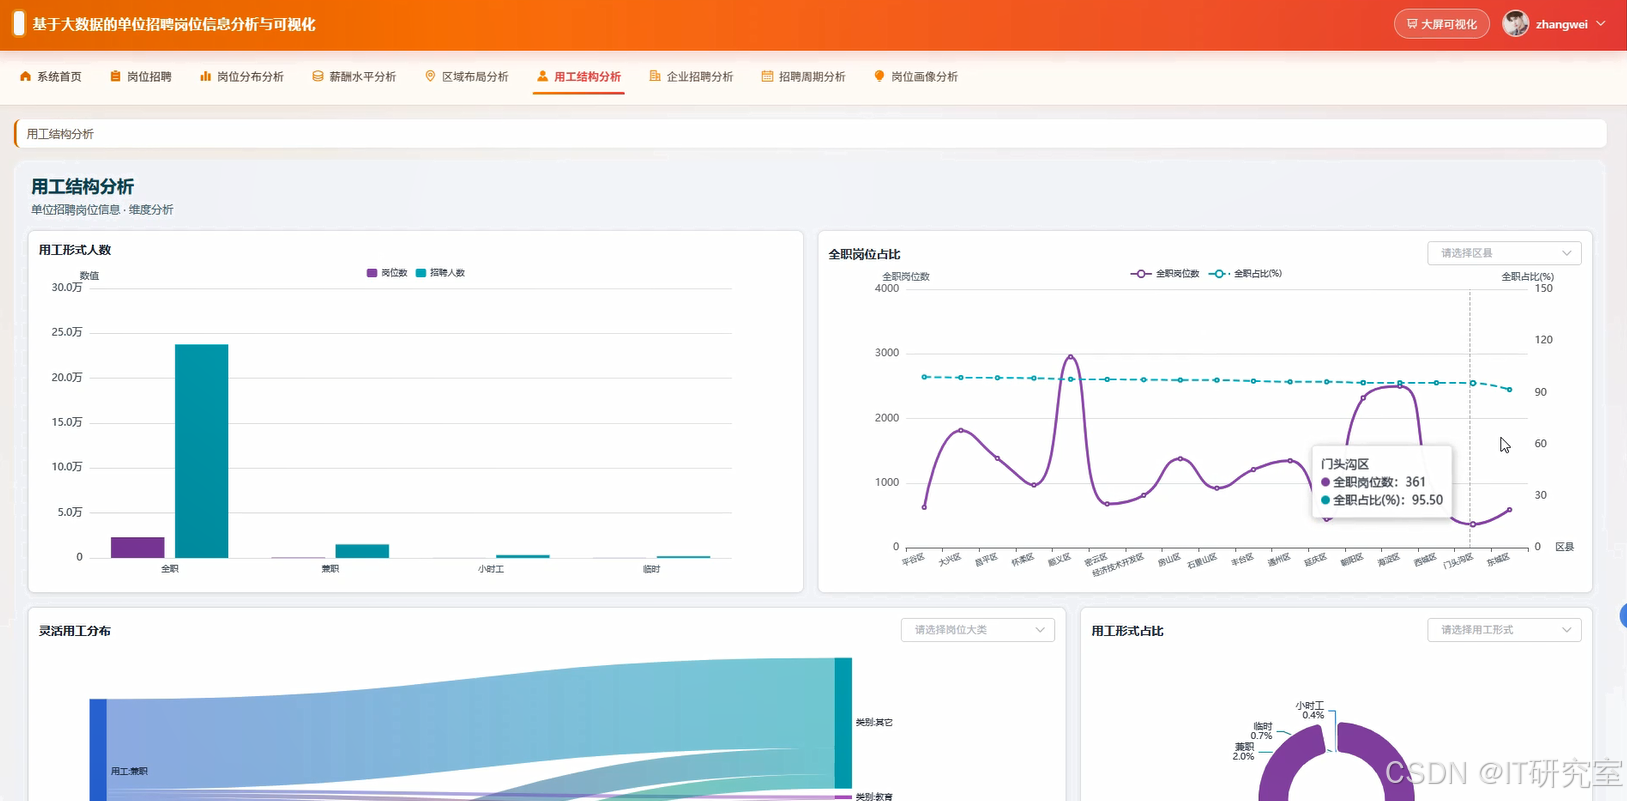
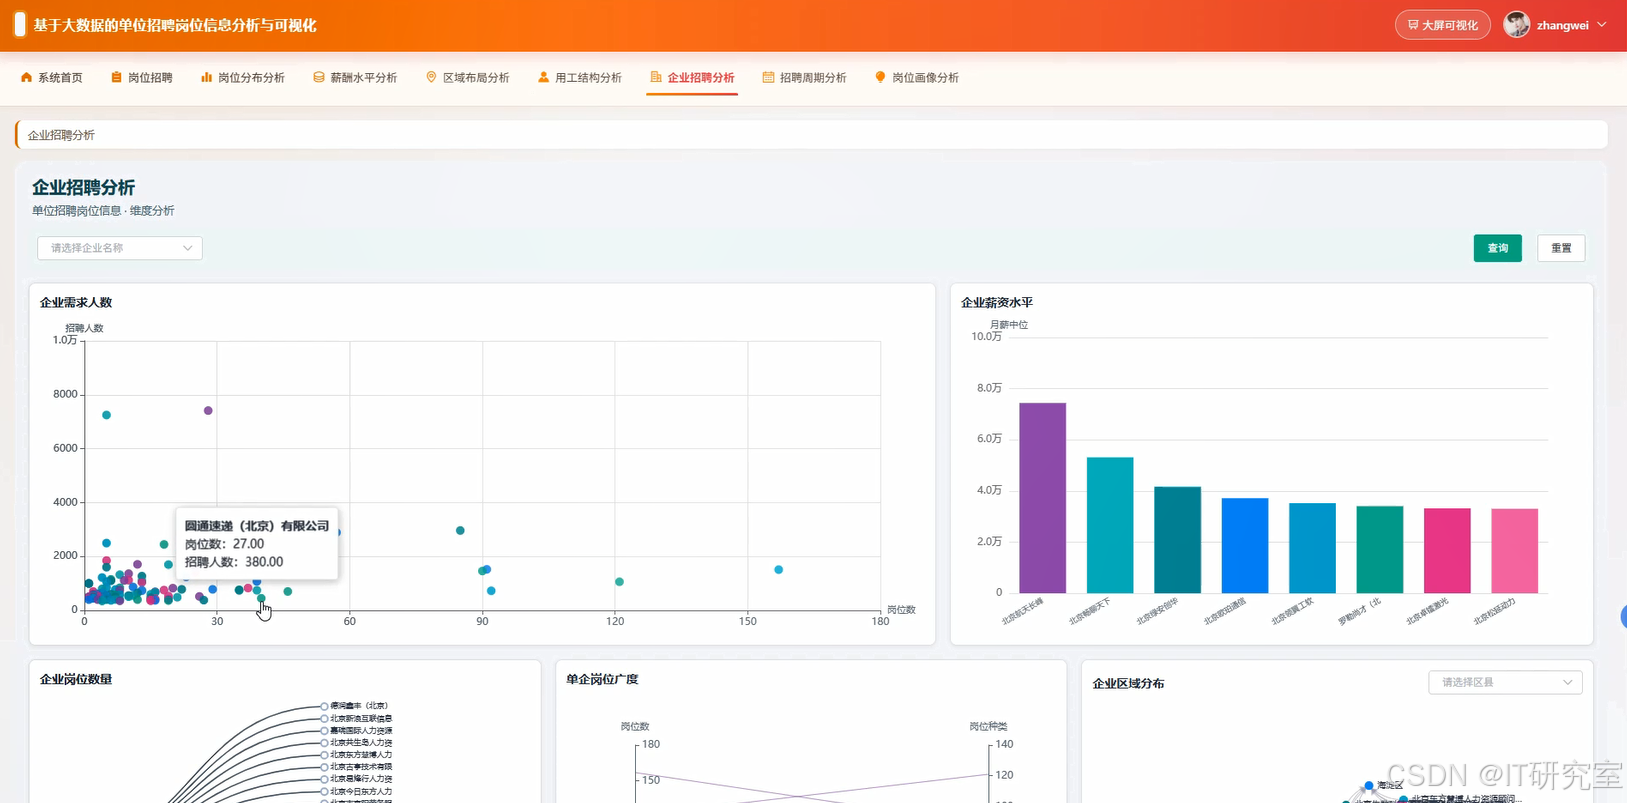
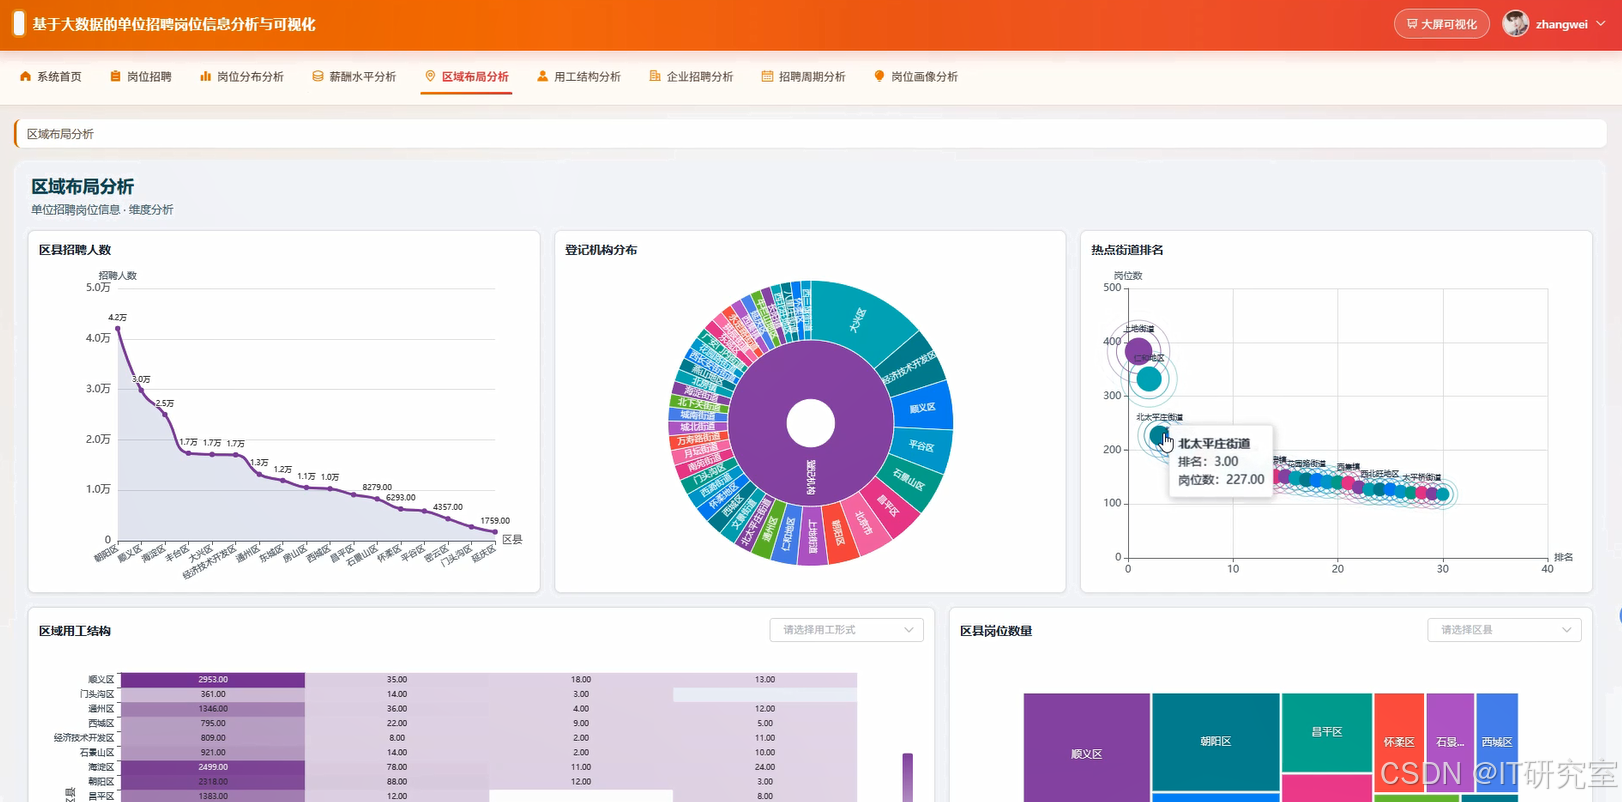
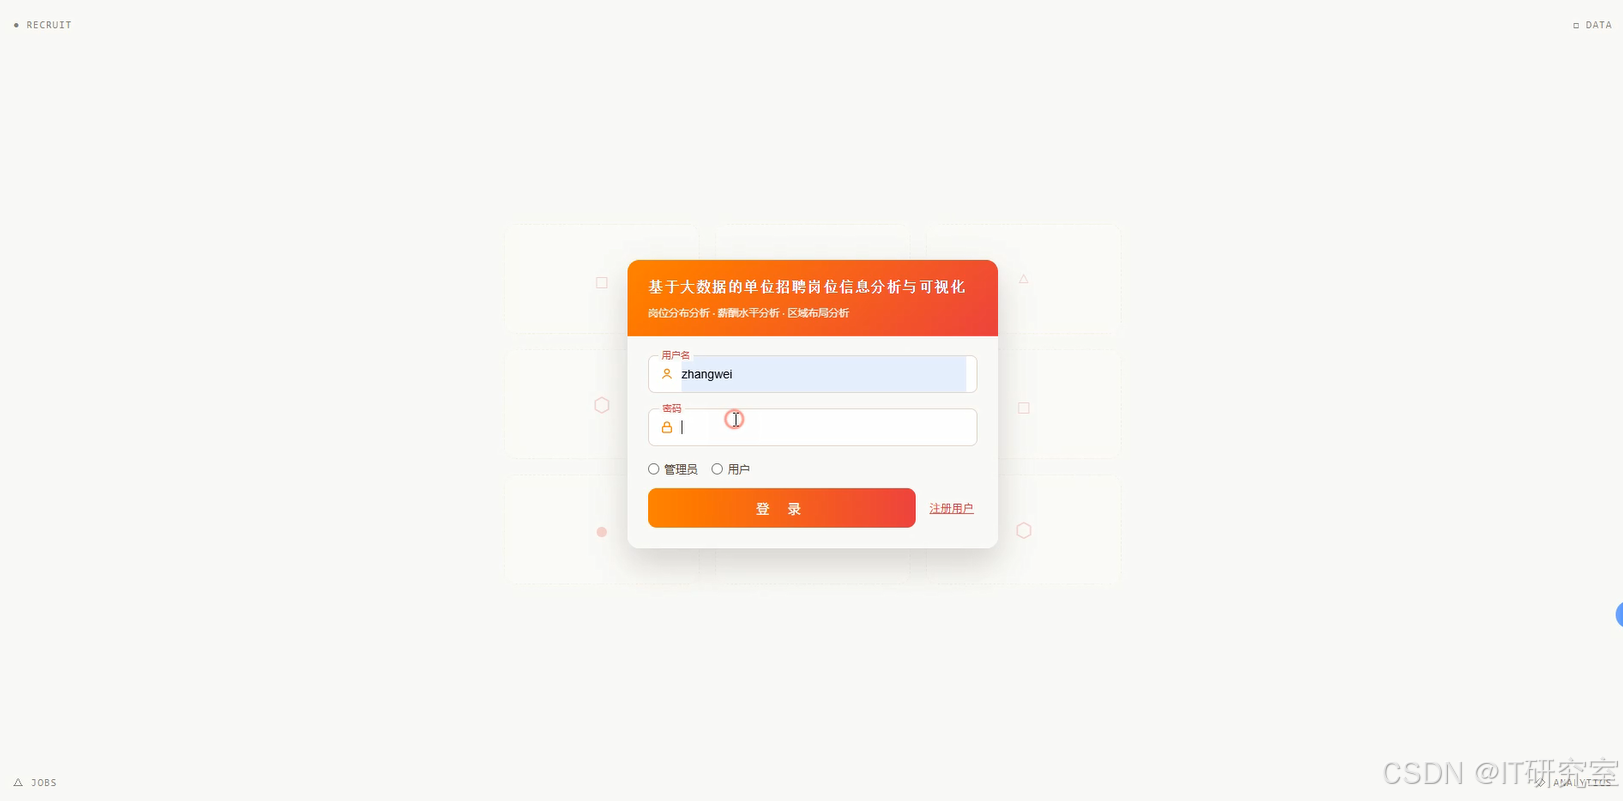
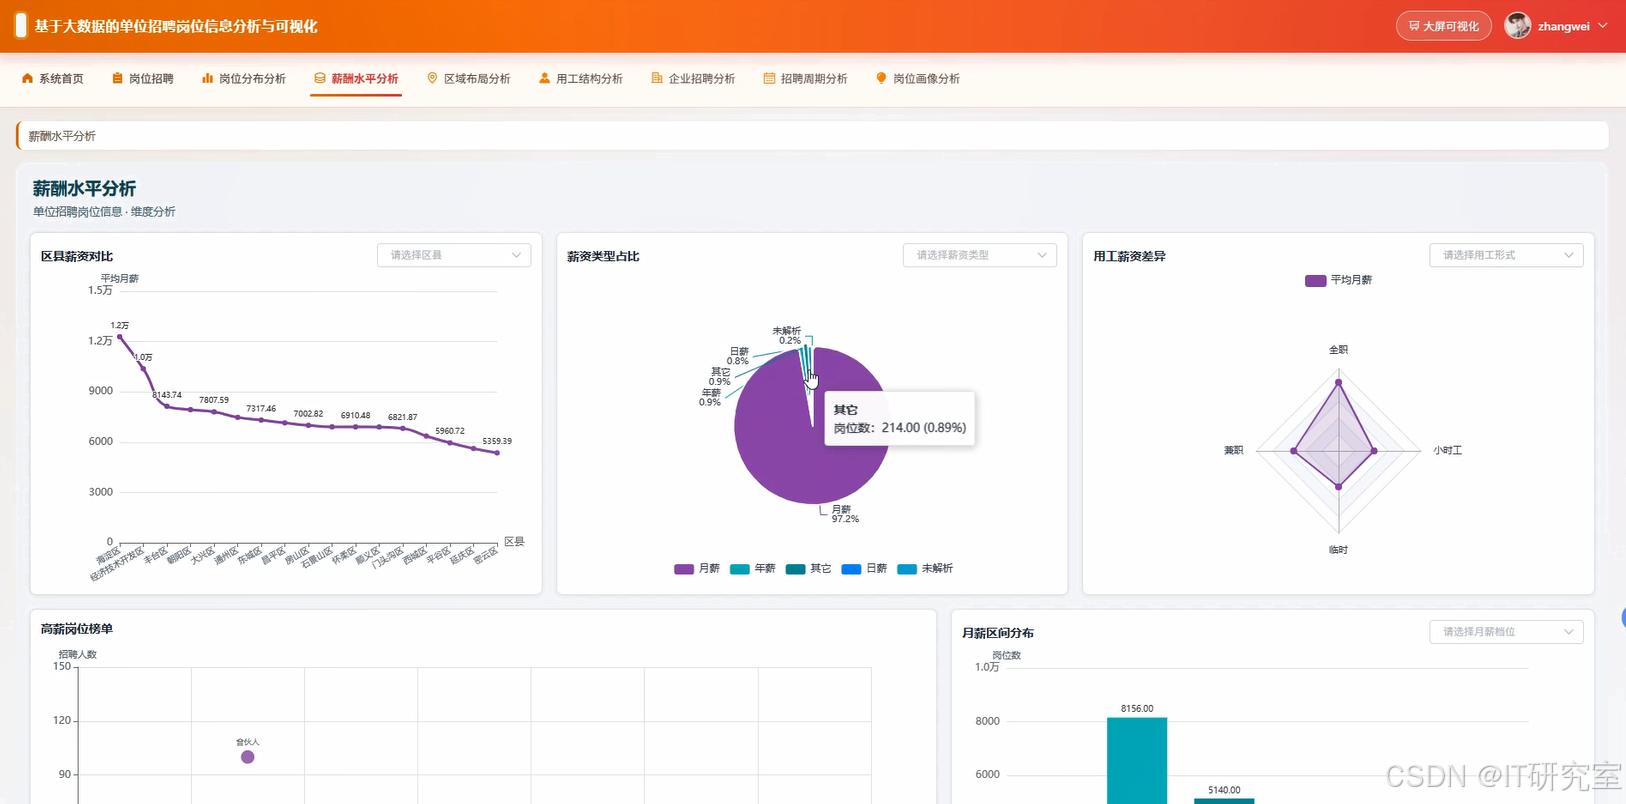
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, regexp_extract, avg, max, min, count, when, year, month, to_date, round as spark_round
from pyspark.sql.types import IntegerType, DoubleType

spark = SparkSession.builder.appName("RecruitmentAnalysis").config("spark.sql.adaptive.enabled", "true").config("spark.sql.adaptive.coalescePartitions.enabled", "true").getOrCreate()

df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/recruitment/raw_data/*.csv")

df_clean = df.filter(col("job_name").isNotNull() & col("salary").isNotNull() & col("city").isNotNull() & col("publish_date").isNotNull())

# ===== 功能1:岗位分布分析 =====
job_distribution = df_clean.groupBy("city").agg(count("job_id").alias("job_count")).orderBy(col("job_count").desc())
job_distribution_result = job_distribution.withColumn("percentage", spark_round(col("job_count") / df_clean.count() * 100, 2))

# ===== 功能2:薪酬水平分析 =====
df_salary = df_clean.withColumn("salary_low", regexp_extract(col("salary"), r"(\d+)", 1).cast(IntegerType()))
df_salary = df_salary.withColumn("salary_high", regexp_extract(col("salary"), r"(\d+)k?$", 1).cast(IntegerType()))
df_salary = df_salary.withColumn("salary_avg", (col("salary_low") + col("salary_high")) / 2)
salary_stats = df_salary.groupBy("city").agg(avg("salary_avg").alias("avg_salary"), max("salary_avg").alias("max_salary"), min("salary_avg").alias("min_salary"))
salary_stats_result = salary_stats.withColumn("avg_salary", spark_round(col("avg_salary"), 1))

# ===== 功能3:招聘周期分析 =====
df_cycle = df_clean.withColumn("publish_date", to_date(col("publish_date"), "yyyy-MM-dd"))
df_cycle = df_cycle.withColumn("publish_year", year(col("publish_date")))
df_cycle = df_cycle.withColumn("publish_month", month(col("publish_date")))
monthly_trend = df_cycle.groupBy("publish_year", "publish_month").agg(count("job_id").alias("job_count")).orderBy("publish_year", "publish_month")
weekly_cycle = df_cycle.withColumn("weekday", when(date_format(col("publish_date"), "u") <= 5, "工作日").otherwise("周末")).groupBy("weekday").agg(count("job_id").alias("count"))

spark.stop()
五、系统视频
基于大数据的单位招聘岗位信息分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的单位招聘岗位信息分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇