💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
目录
- 基于大数据的电商销售数据可视化分析系统介绍
- 基于大数据的电商销售数据可视化分析系统演示视频
- 基于大数据的电商销售数据可视化分析系统演示图片
- 基于大数据的电商销售数据可视化分析系统代码展示
- 基于大数据的电商销售数据可视化分析系统文档展示
基于大数据的电商销售数据可视化分析系统介绍
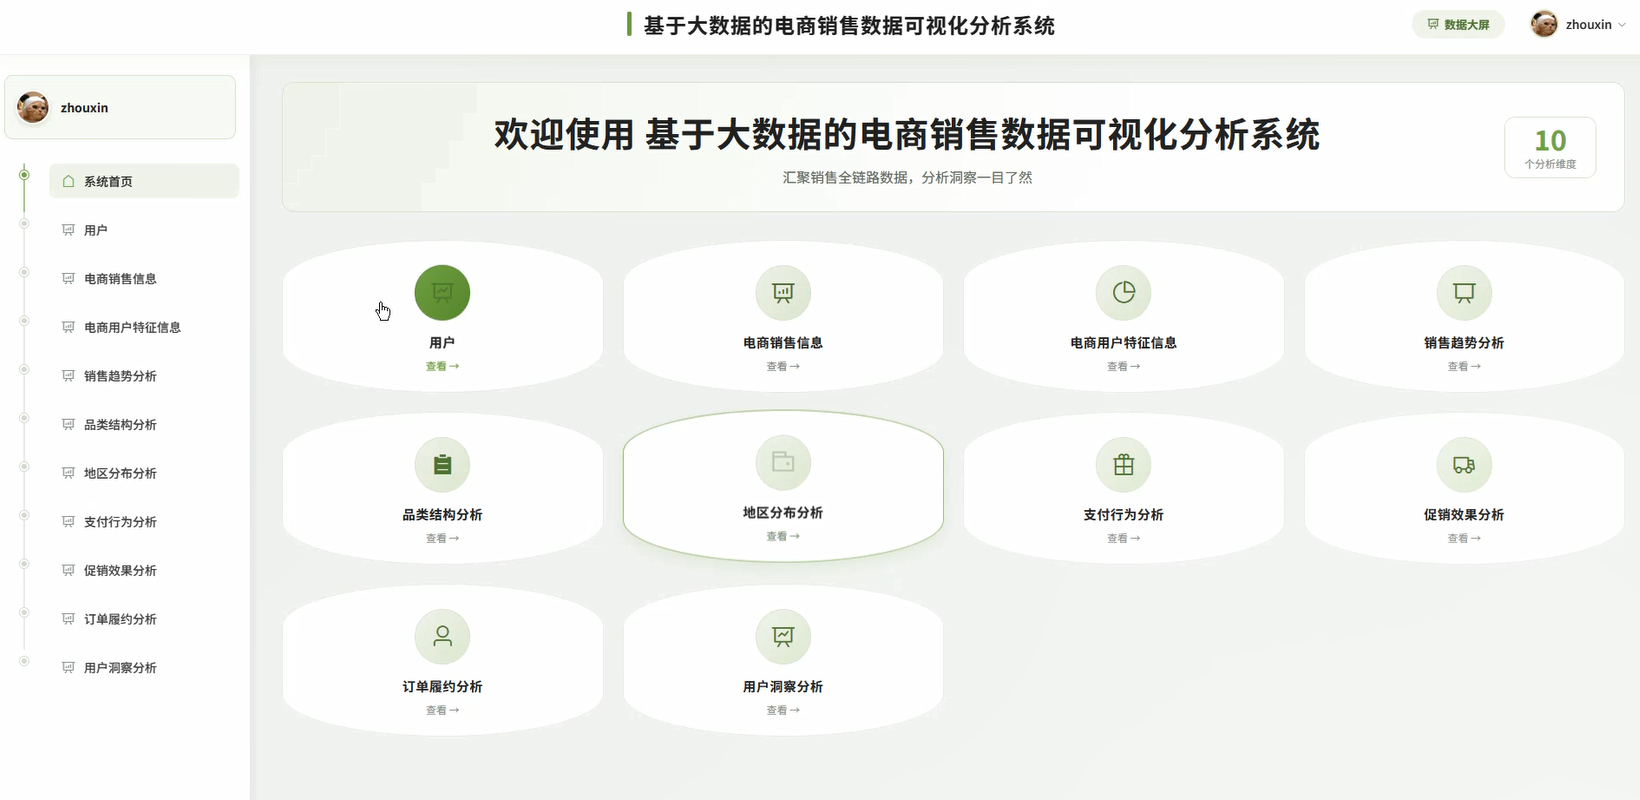
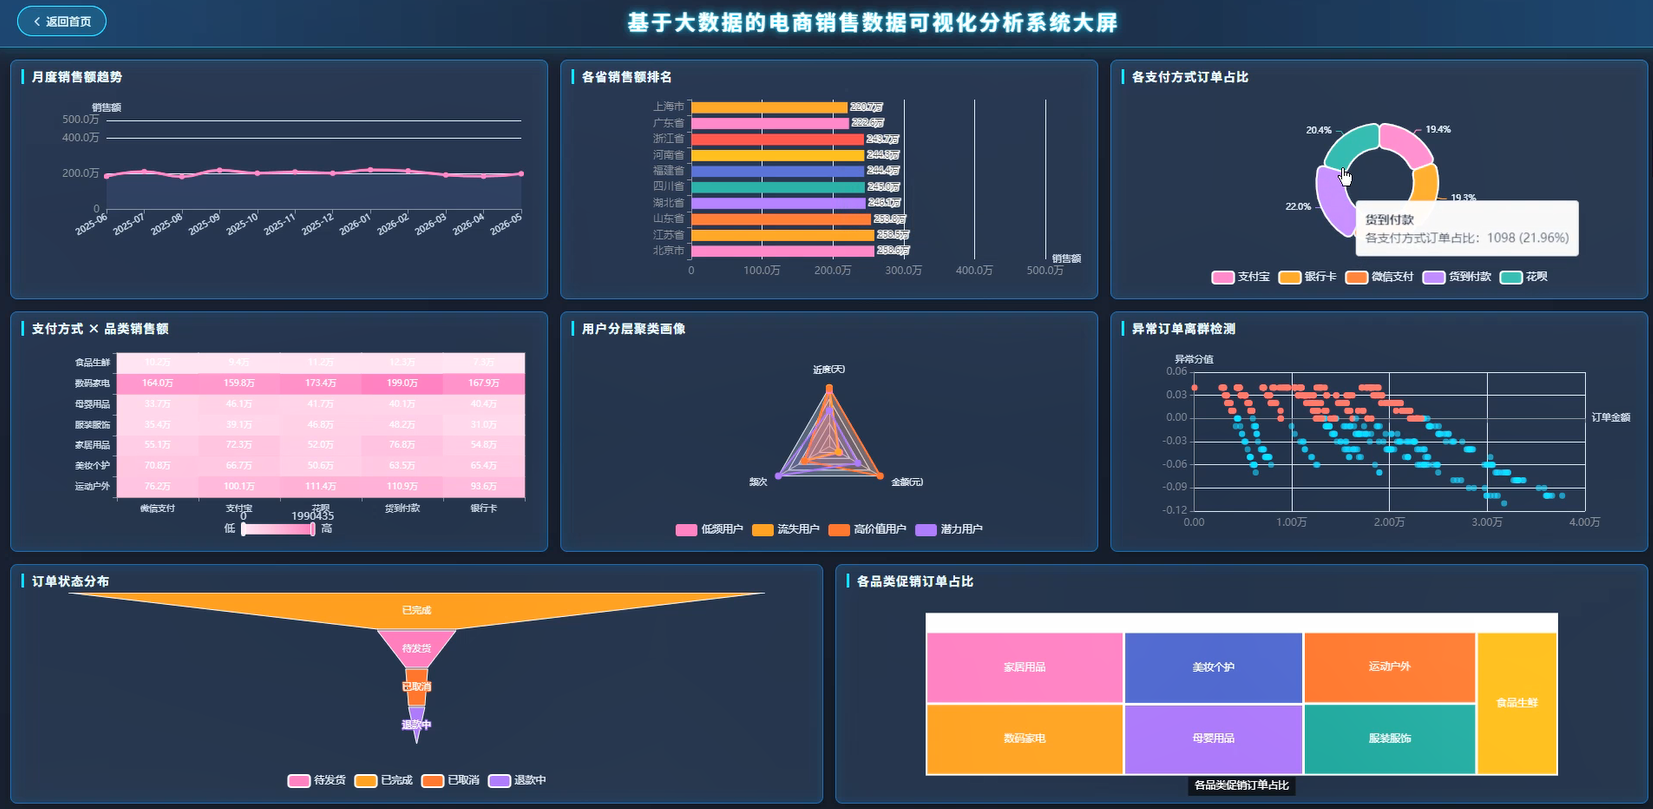
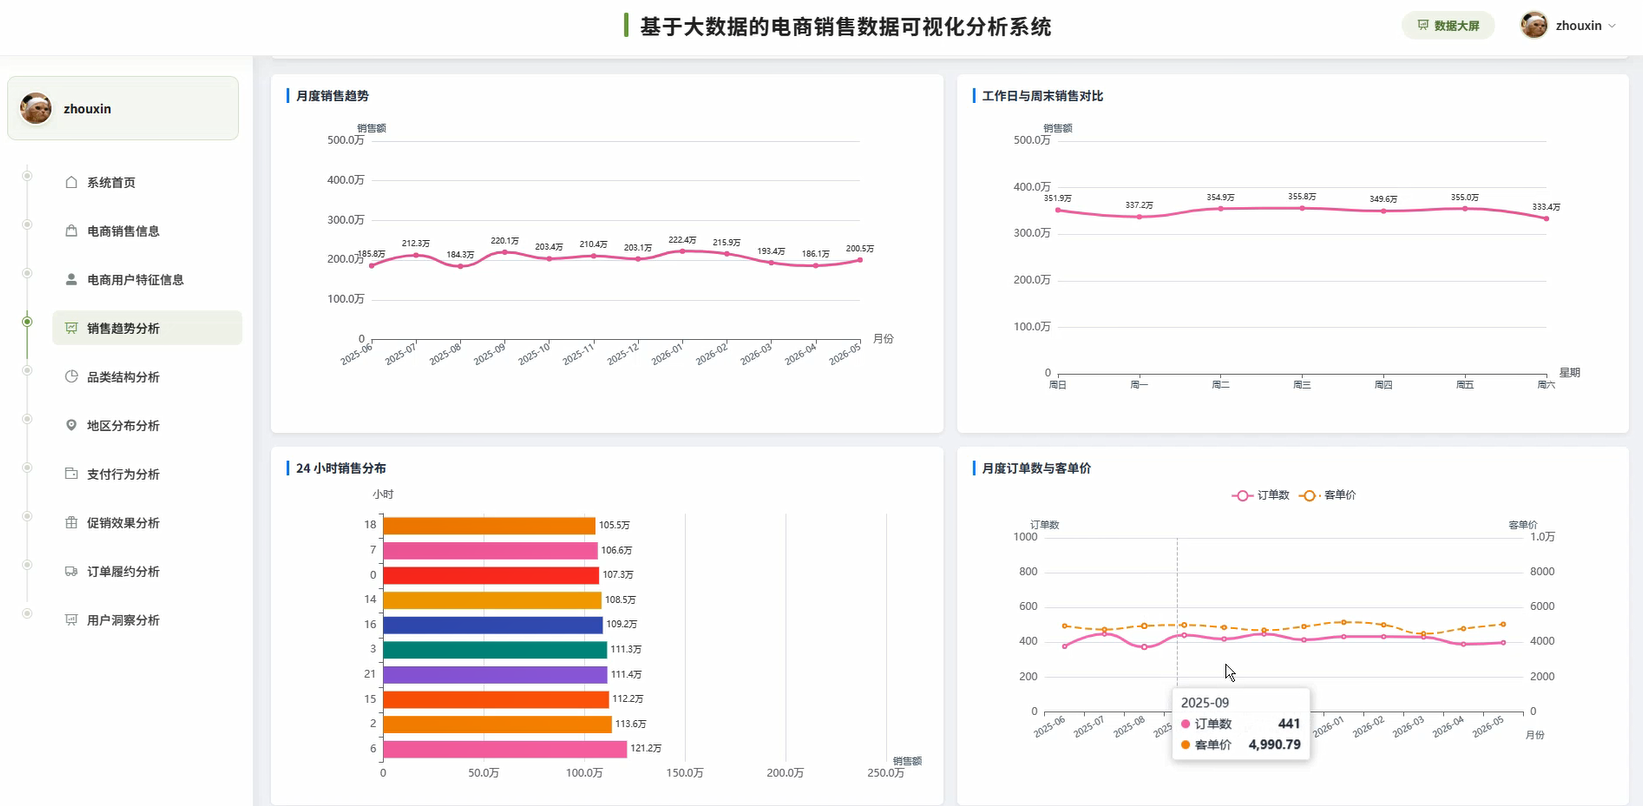
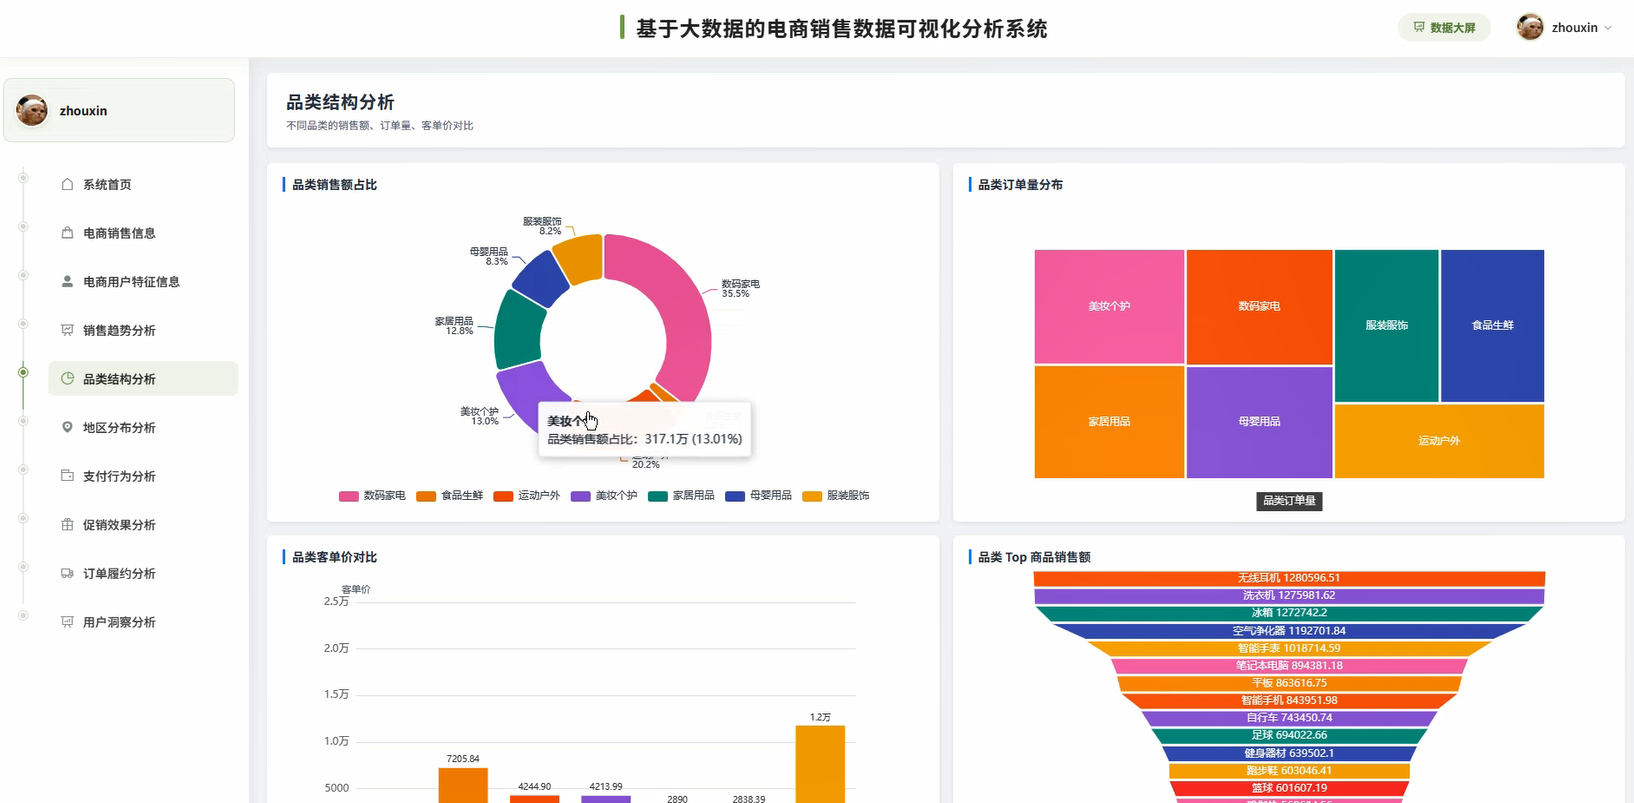
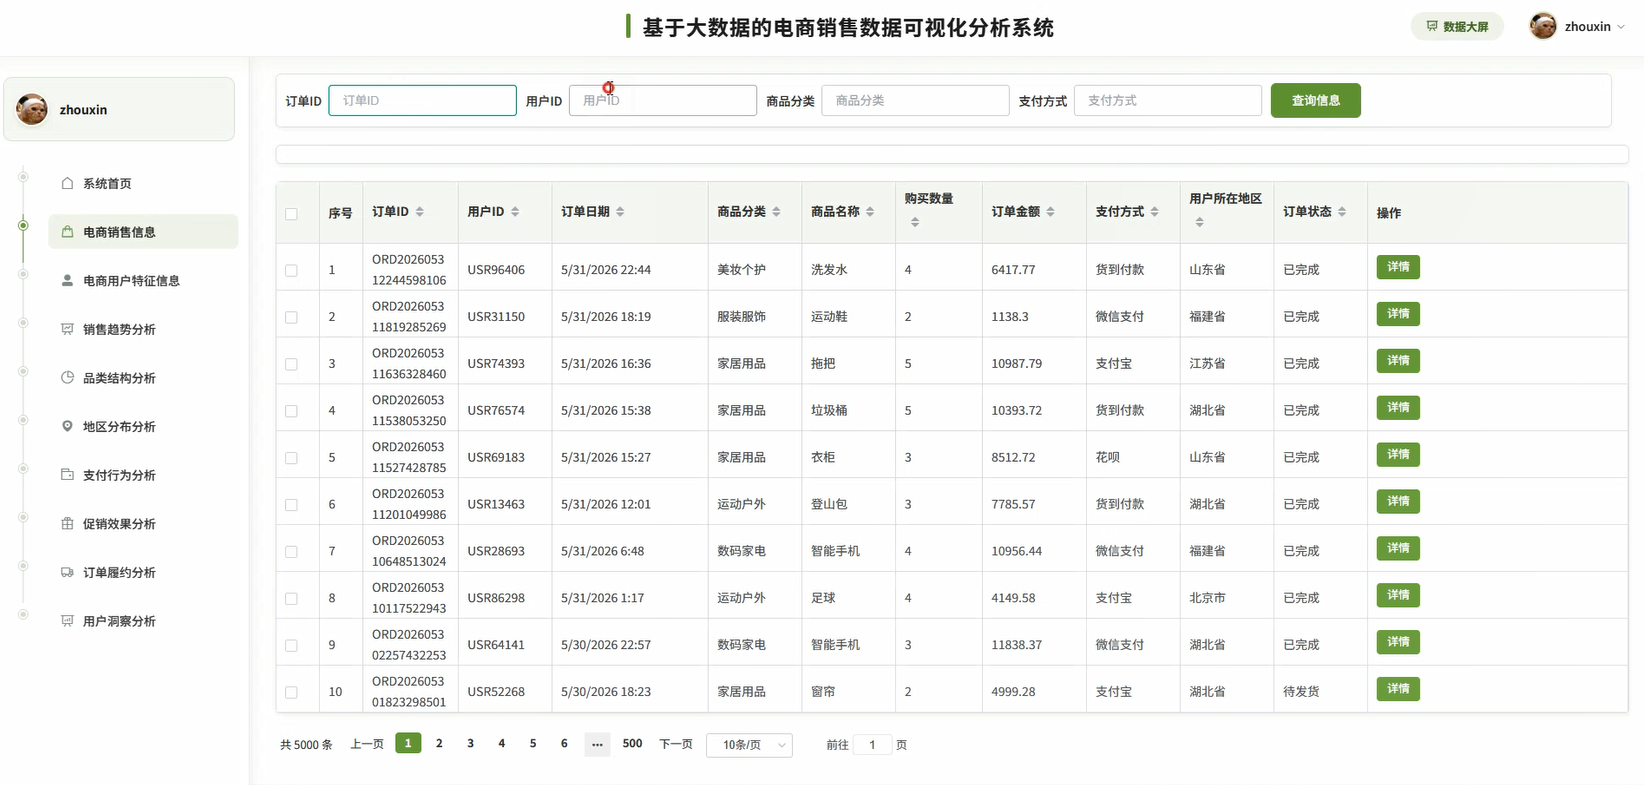
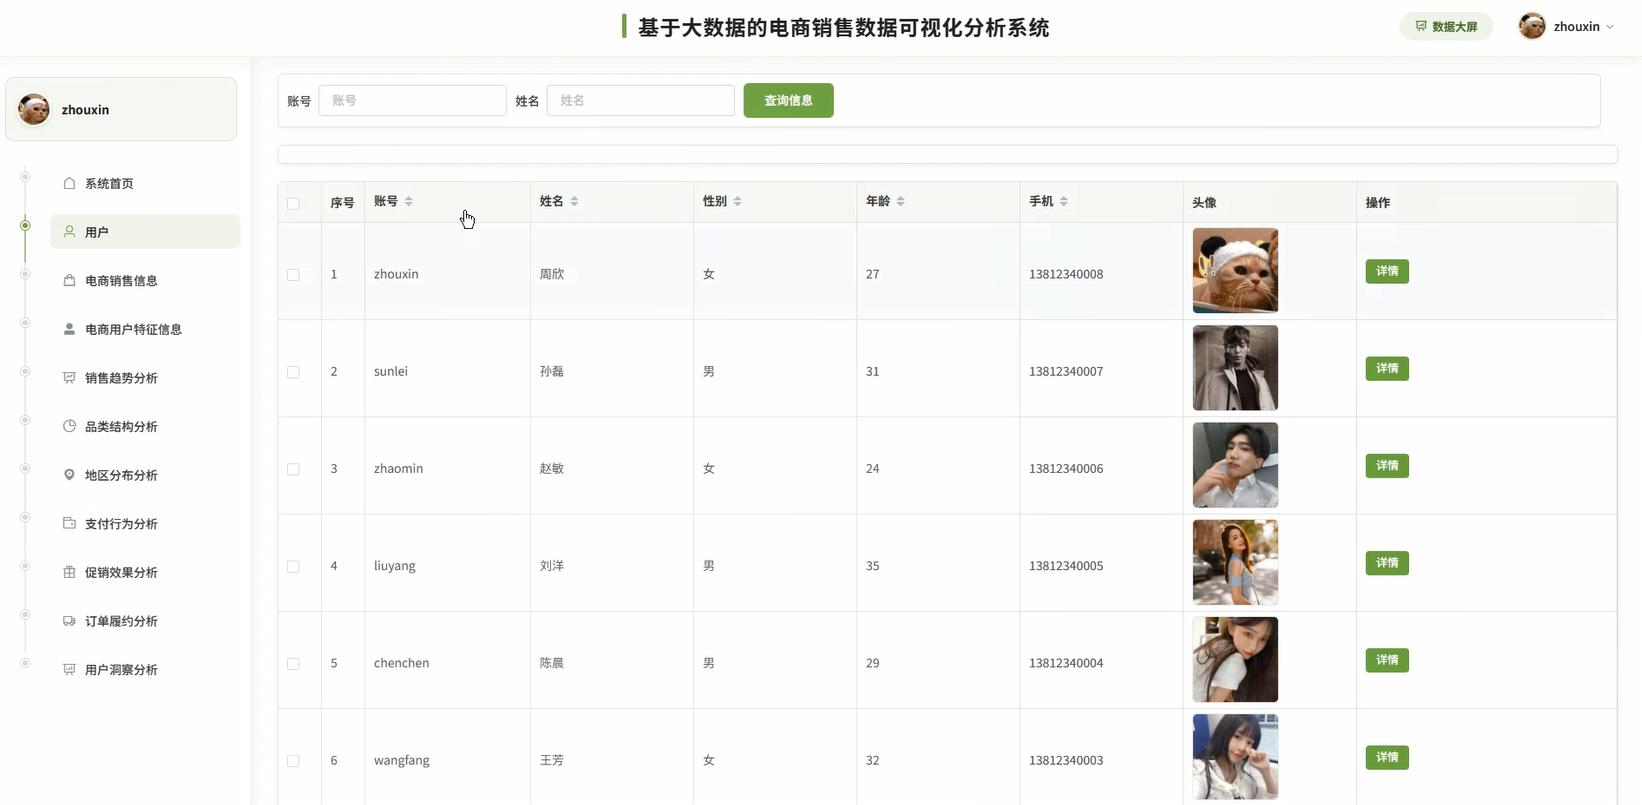
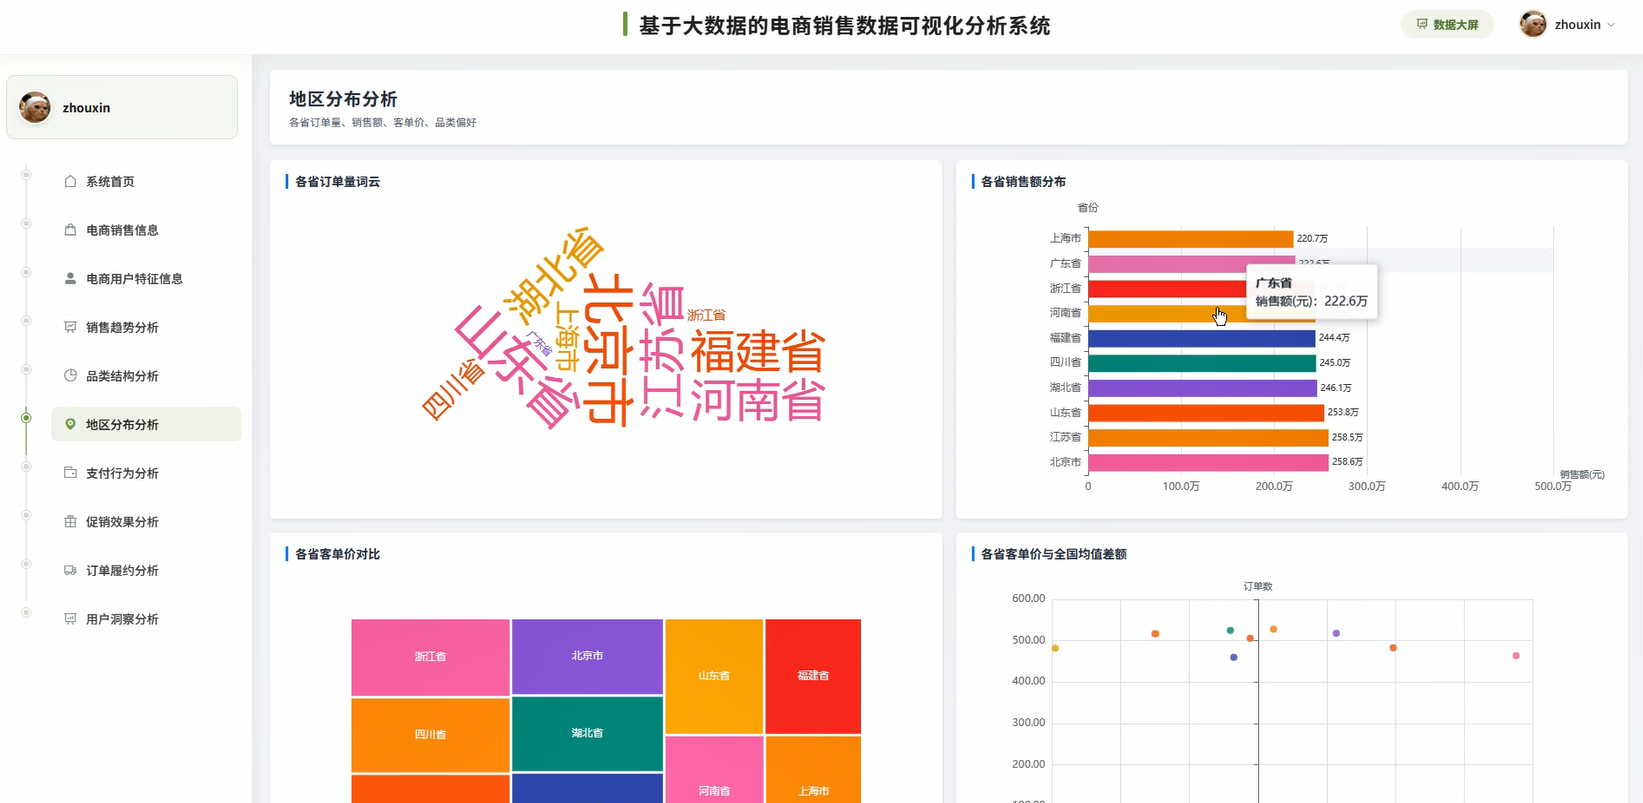
基于大数据的电商销售数据可视化分析系统是一套面向电商销售场景的数据分析平台,整体采用Hadoop与Spark作为大数据处理框架,配合HDFS完成数据存储,通过Spark SQL与Pandas、NumPy完成数据清洗、统计与指标计算,后端提供Django与SpringBoot两个版本,前端使用Vue、ElementUI、Echarts结合HTML、CSS、JavaScript与jQuery完成页面呈现,数据库采用MySQL。系统围绕电商销售业务链条进行功能组织,包含系统首页、电商销售信息、电商用户特征信息、销售趋势分析、品类结构分析、地区分布分析、支付行为分析、促销效果分析、订单履约分析以及用户洞察分析等模块。系统首页用于汇总整体销售概况与关键指标,电商销售信息模块用于查看订单层面的明细数据,电商用户特征信息模块用于呈现用户属性分布,销售趋势分析用于观察不同时间粒度下的销售额与订单量变化,品类结构分析用于比较各品类的销售占比,地区分布分析用于展示不同区域的销售差异,支付行为分析用于统计各支付方式的使用情况,促销效果分析用于对比促销前后的销售变化,订单履约分析用于跟踪订单发货与完成情况,用户洞察分析用于从消费频次、消费金额等角度刻画用户群体,整体形成一个从数据存储、数据处理到可视化展示的完整链路,帮助使用者较为直观地了解电商销售运行情况。
基于大数据的电商销售数据可视化分析系统演示视频
基于大数据的电商销售数据可视化分析系统演示图片
基于大数据的电商销售数据可视化分析系统代码展示
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum, count, avg, desc, date_format, when, round
import pandas as pd
import numpy as np
spark = SparkSession.builder.appName("EcommerceSalesAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
def sales_trend_analysis(start_date, end_date, time_granularity):
    df = spark.read.format("csv").option("header", True).option("inferSchema", True).load("hdfs://localhost:9000/ecommerce/order_sales.csv")
    df_filtered = df.filter((col("order_date") >= start_date) & (col("order_date") <= end_date))
    if time_granularity == "day":
        df_grouped = df_filtered.groupBy(date_format(col("order_date"), "yyyy-MM-dd").alias("time_point")).agg(sum("order_amount").alias("total_sales"), count("order_id").alias("order_count"), avg("order_amount").alias("avg_order_amount"))
    elif time_granularity == "month":
        df_grouped = df_filtered.groupBy(date_format(col("order_date"), "yyyy-MM").alias("time_point")).agg(sum("order_amount").alias("total_sales"), count("order_id").alias("order_count"), avg("order_amount").alias("avg_order_amount"))
    else:
        df_grouped = df_filtered.groupBy(date_format(col("order_date"), "yyyy").alias("time_point")).agg(sum("order_amount").alias("total_sales"), count("order_id").alias("order_count"), avg("order_amount").alias("avg_order_amount"))
    df_result = df_grouped.orderBy("time_point")
    pandas_df = df_result.toPandas()
    pandas_df["total_sales"] = pandas_df["total_sales"].round(2)
    pandas_df["avg_order_amount"] = pandas_df["avg_order_amount"].round(2)
    pandas_df["growth_rate"] = pandas_df["total_sales"].pct_change().replace(np.nan, 0).round(4)
    result_list = pandas_df.to_dict(orient="records")
    return {"code": 200, "msg": "销售趋势分析完成", "data": result_list}
def category_structure_analysis(category_level, top_n):
    df = spark.read.format("csv").option("header", True).option("inferSchema", True).load("hdfs://localhost:9000/ecommerce/order_sales.csv")
    df_valid = df.filter(col("order_status") != "已取消")
    if category_level == "first":
        df_grouped = df_valid.groupBy("first_category").agg(sum("order_amount").alias("category_sales"), count("order_id").alias("category_order_count"), sum("quantity").alias("category_quantity"))
    else:
        df_grouped = df_valid.groupBy("second_category").agg(sum("order_amount").alias("category_sales"), count("order_id").alias("category_order_count"), sum("quantity").alias("category_quantity"))
    df_sorted = df_grouped.orderBy(desc("category_sales")).limit(top_n)
    pandas_df = df_sorted.toPandas()
    total_sales = pandas_df["category_sales"].sum()
    pandas_df["sales_ratio"] = (pandas_df["category_sales"] / total_sales).round(4)
    pandas_df["category_sales"] = pandas_df["category_sales"].round(2)
    result_list = pandas_df.to_dict(orient="records")
    return {"code": 200, "msg": "品类结构分析完成", "data": result_list}
def user_insight_analysis(min_order_count, min_total_amount):
    df = spark.read.format("csv").option("header", True).option("inferSchema", True).load("hdfs://localhost:9000/ecommerce/user_orders.csv")
    df_user = df.groupBy("user_id").agg(count("order_id").alias("order_count"), sum("order_amount").alias("total_amount"), avg("order_amount").alias("avg_amount"), date_format(col("order_date"), "yyyy-MM-dd").alias("last_order_date"))
    df_user = df_user.withColumn("user_level", when(col("total_amount") >= 10000, "高价值用户").when(col("total_amount") >= 3000, "中价值用户").otherwise("普通用户"))
    df_filtered = df_user.filter((col("order_count") >= min_order_count) & (col("total_amount") >= min_total_amount))
    df_result = df_filtered.orderBy(desc("total_amount"))
    pandas_df = df_result.toPandas()
    pandas_df["total_amount"] = pandas_df["total_amount"].round(2)
    pandas_df["avg_amount"] = pandas_df["avg_amount"].round(2)
    level_summary = pandas_df.groupby("user_level").agg(user_count=("user_id", "count"), avg_total_amount=("total_amount", "mean")).reset_index()
    level_summary["avg_total_amount"] = level_summary["avg_total_amount"].round(2)
    result_list = pandas_df.to_dict(orient="records")
    level_list = level_summary.to_dict(orient="records")
    return {"code": 200, "msg": "用户洞察分析完成", "data": result_list, "level_summary": level_list}
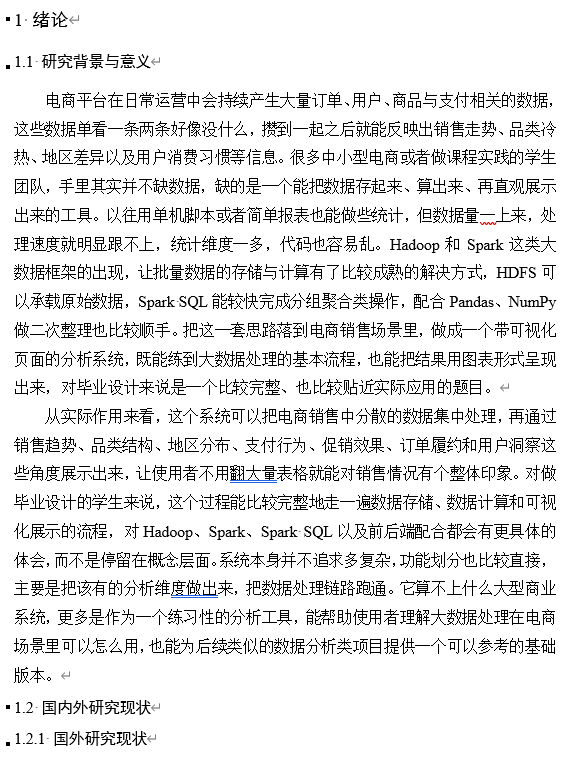
基于大数据的电商销售数据可视化分析系统文档展示
💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜